Eligible Leader Replicas (ELR) Kafka 4.1-ում. էականը
KIP-966-ի և Apache Kafka 4.1-ի Eligible Leader Replicas-ի (ELR) մանրամասն ակնարկ։ Տեսեք, թե ինչպես in-sync replica-ների և առանց վտանգի leader դառնալու ընդունակ replica-ների տարբերակումը փակում է Last Replica Standing եզրային դեպքը և կանխում տվյալների կորուստը broker-ների ոչ սահուն անջատումներից հետո։
Բաշխված համակարգերում եզրային դեպքեր ամենուր կան, և Kafka-ն բացառություն չէ. եղել է իրադարձությունների չափազանց քիչ հավանական հաջորդականություն, որի դեպքում կարող էին կորչել նույնիսկ committed հաղորդագրությունները։ Սա KIP-966-ին դրդեց ներդնել Eligible Leader Replicas (ELR)՝ մեխանիզմ, որը լուծում է leader-ի իրավասության հարցը՝ տարբերակելով «in-sync replica-ները» «առանց վտանգի leader դառնալու ընդունակ replica-ներից»։ Նայենք ավելի մոտիկից։
Ինչպես Kafka-ն կարող էր կորցնել committed տվյալները
Այստեղ ենթադրում եմ, որ դուք գիտեք Kafka-ի հիմունքները և հասկանում եք նրա դիմացկունության երաշխիքը (durability guarantee)։
KIP-966-ը անդրադառնում է ծայրահեղ եզրային դեպքի, որը իսկապես կարող էր խախտել Kafka-ի դիմացկունության երաշխիքները։ Նույնիսկ ճիշտ կոնֆիգուրացիայի և producer-ի ամենախիստ կարգավորման՝ acks=all-ի դեպքում, committed հաղորդագրությունները դեռ կարող էին կորչել, երբ ոչ սահուն անջատումը (unclean shutdown) համընկնում էր last replica standing խնդրի հետ։ Հենց այս հաջորդականությանը հանդիպելու հավանականությունը շատ փոքր է, բայց ռիսկը բավական լուրջ էր Kafka-ի failover տրամաբանության բարելավումը արդարացնելու համար։ Հասկանալու համար, թե ինչն է առաջ մղել KIP-966-ը, մանրամասն անցնենք հետևյալ սցենարներով՝
Ոչ սահուն անջատման սցենարը
Սահուն անջատման ժամանակ Kafka-ն flush է անում իր վիճակը՝ սկավառակի վրա գրելով հիշողության և օպերացիոն համակարգի page cache-ի մեջ բուֆերավորված ցանկացած տվյալ, և մաքուր ազատում է բոլոր ռեսուրսները։ Ոչ սահուն անջատումը, ընդհակառակը, տեղի է ունենում, երբ broker-ը կտրուկ դադարեցվում է, օրինակ՝ հոսանքի անջատումից կամ սերվերային մեքենայի խափանումից։ Այդ դեպքում որոշ գրառումներ կարող են գտնվել Kafka-ի օպերացիոն համակարգի page cache-ում՝ առանց սկավառակի վրա պահպանված լինելու։ Kafka-ն սկավառակի վրա flush չի անում՝ նախքան հաղորդագրությունը committed համարելը. դա չափազանց թանկ կլիներ, փոխարենը այն flush է անում ասինխրոն՝ խմբաքանակներով։ Գոյություն ունեն այնպիսի կարգավորումներ, ինչպիսին log.flush.interval.messages կամ log.flush.interval.ms-ն է, բայց լռելյայն խորհուրդը դրանք չսահմանելն է և հենվել օպերացիոն համակարգի ֆոնային flush-ի վրա, քանի որ դա ավելի արդյունավետ է։
Արդյունքում ոչ սահուն անջատումից և հետագա վերականգնումից հետո broker-ը կարող է վերադառնալ խափանումից առաջվա համեմատ ավելի կարճ log-ով։
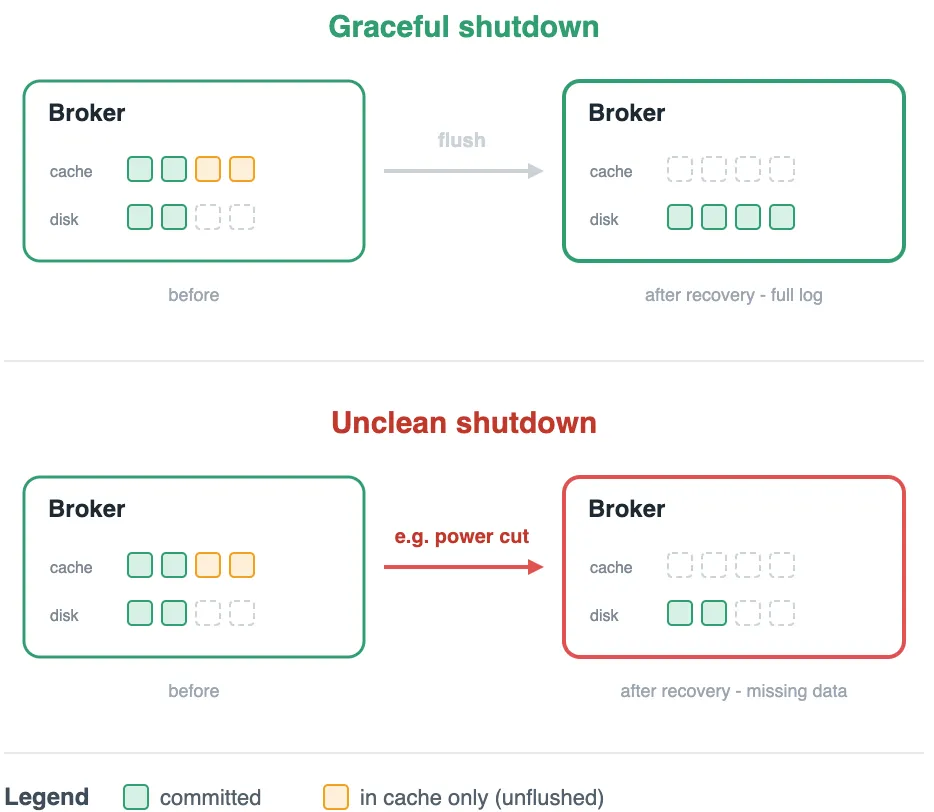
Սովորական աշխատանքի ժամանակ՝ երբ broker-ը ունի այլ առողջ, in-sync replica-ներ (ISR), Kafka-ն սա սահուն լուծում է՝ leader դարձնելով մնացած առողջ in-sync replica-ներից (ISR) մեկին։ Երբ խափանված broker-ը նորից միանում է կլաստերին, նրա log segment-ները ավտոմատ համաժամեցվում են ընթացիկ leader-ի վիճակին։
Last Replica Standing խնդիրը
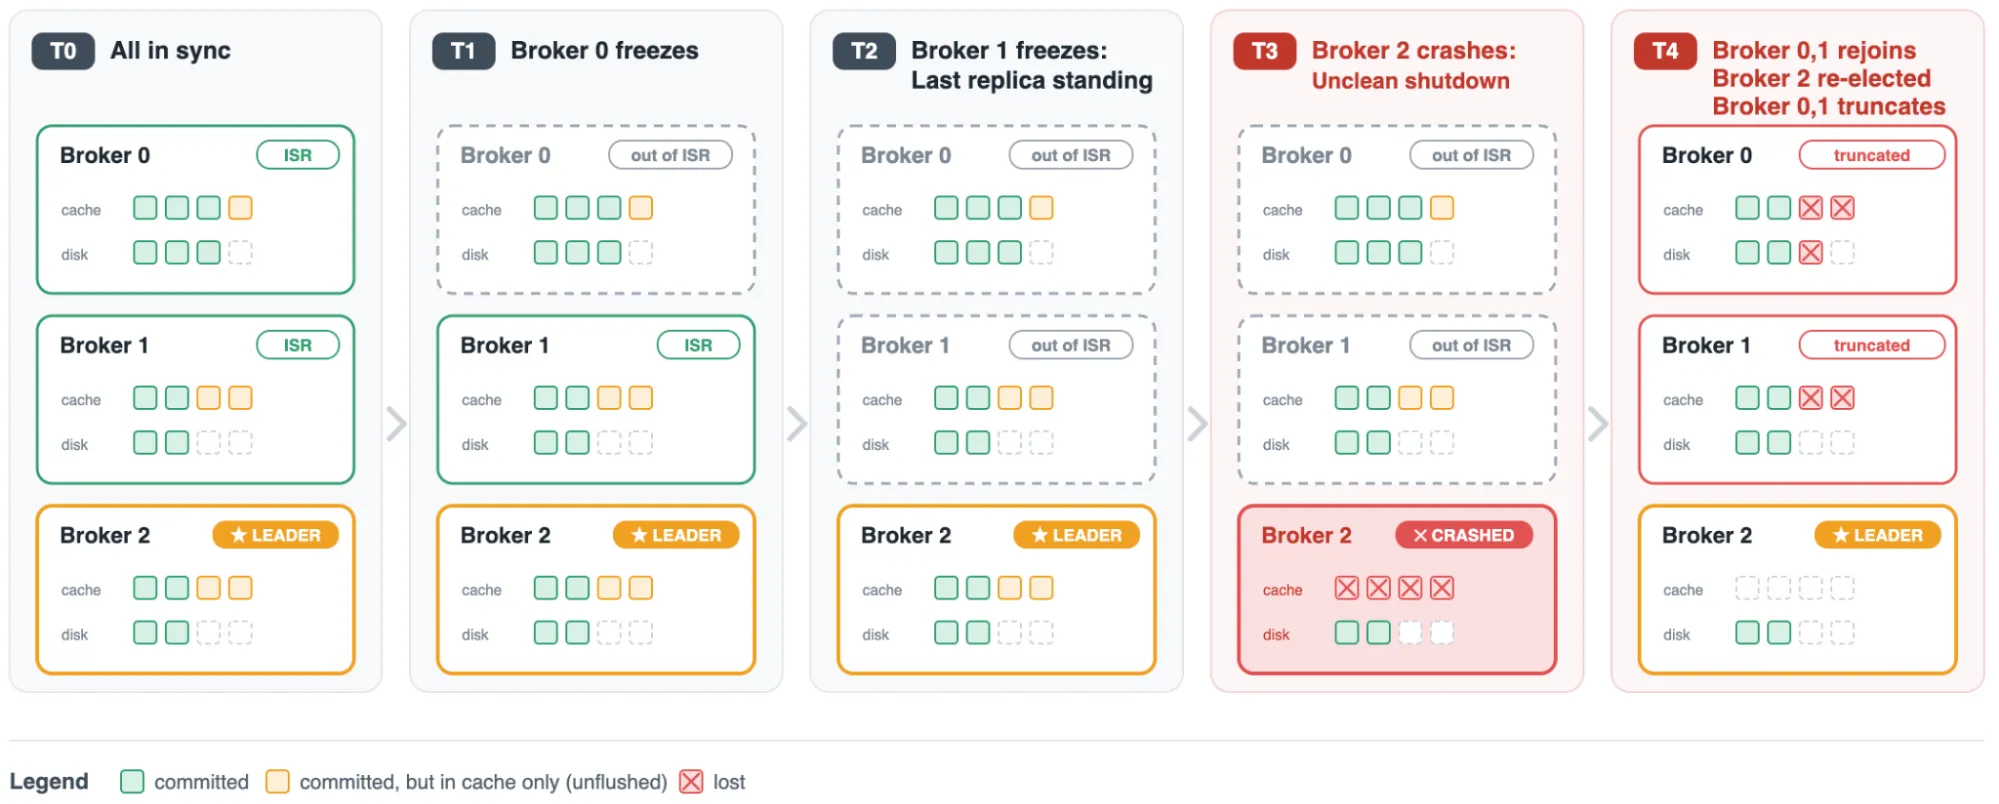
Ոչ սահուն անջատման դեպքում կա մեկ ծայրահեղ եզրային դեպք, որում committed տվյալները կարող են կորչել։ Այն տեղի է ունենում Last Replica Standing (LRS) վիճակում՝ երբ ոչ սահուն անջատումից տուժած broker-ը պահում է ISR-ում մնացած միակ replica-ն։ Սա կարող է պատահել, երբ մյուս replica-ները մեկը մյուսի հետևից դուրս են մնում շատ կարճ ժամանակում, օրինակ՝ ցանցային խնդիրների պատճառով։
Կարող եք մտածել. «acks=all-ի դեպքում հաստատ սահմանում ենք նաև min.insync.replicas պարամետրը, ուստի երբ in-sync է մնացել ընդամենը 1 replica, Kafka-ն պետք է հրաժարվի տվյալներ ընդունել»։ Դա ճիշտ է, բայց միայն նոր տվյալների համար։ Իրական խնդիրը վերաբերում է այն տվյալներին, որոնք արդեն committed էին և հաստատված (երբ բոլոր broker-ները առողջ էին), բայց դեռ սկավառակի վրա flush չէին արված։
Kafka-ի հին վարքագիծը երբեք թույլ չի տալիս ISR ցանկին դատարկ դառնալ, ուստի այստեղ, երբ ամբողջ կլաստերը նորից առցանց է, հենց նոր խափանված leader-ը (վերջին մնացած replica-ն) դեռևս համարվում է ճշմարտության միակ վավեր աղբյուրը և նորից ընտրվում է leader։ Քանի որ այն ոչ սահուն անջատման ժամանակ կորցրել է իր page cache-ը, առողջ replica-ները, որոնք իրականում ունեն ամբողջական, անվնաս committed տվյալները՝ ապահով պահված սկավառակի վրա, ստիպված են կրկնօրինակել նրանից և կտրել (truncate) սեփական ճիշտ log-երը։
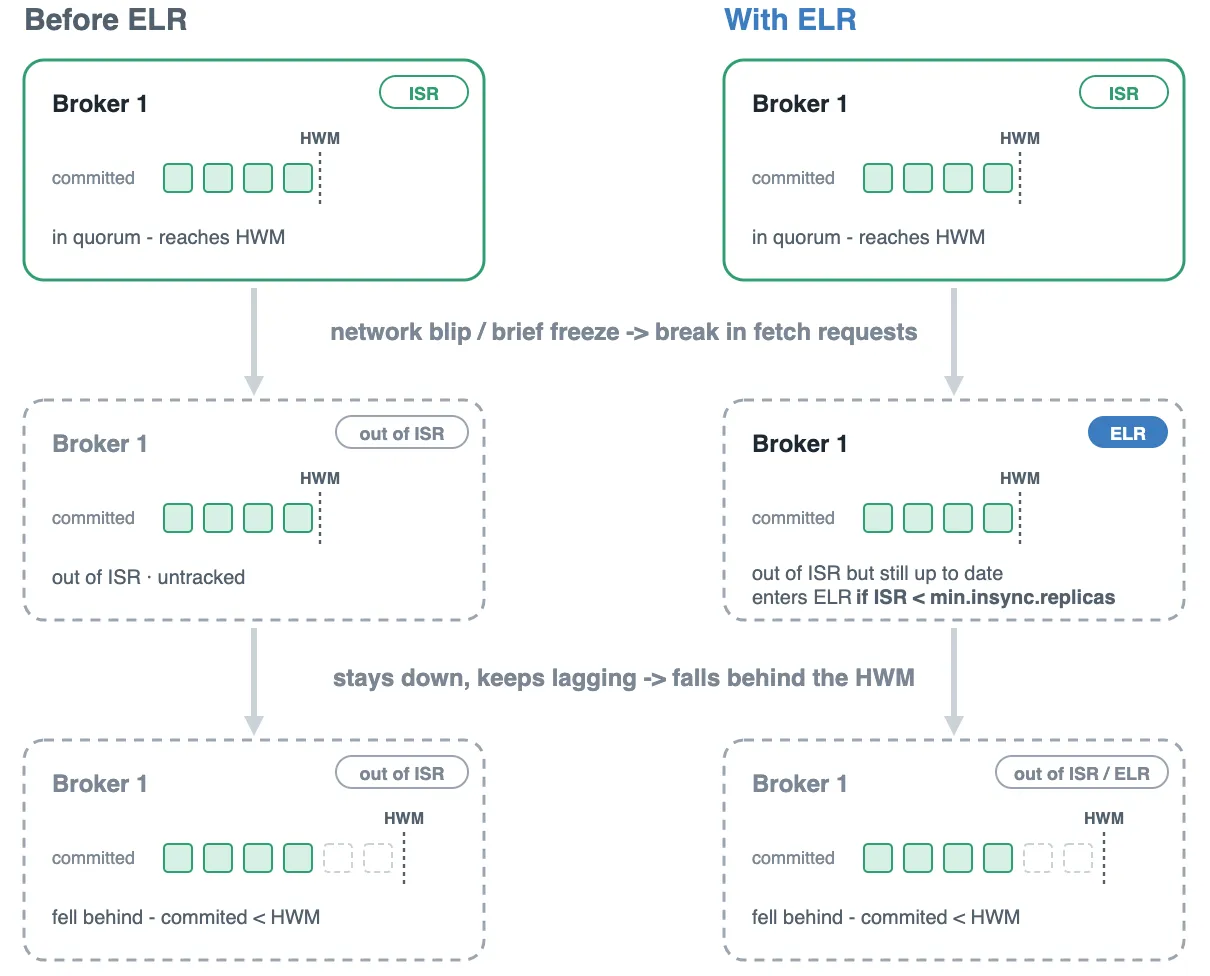
Ինչպե՞ս կարող է replica-ն լիովին արդի լինել և այնուհանդերձ ISR-ից դուրս մնալ։ Replica-ն ISR-ից կարող է դուրս մնալ ոչ միայն հետ մնալով, այլև ժամանակավորապես անհասանելի լինելով՝ ցանցային խնդիրների, JVM garbage collector-ի երկար դադարների, սկավառակի I/O կարճ կանգառների և այլնի պատճառով։ Սրանցից ցանկացածը կարող է ընդհատել leader-ին ուղարկվող fetch հարցումները։ Եթե follower replica-ն fetch հարցում չի ուղարկում replica.lag.time.max.ms-ով սահմանված պատուհանի ընթացքում, leader-ը այն հեռացնում է ISR-ից՝ ակտիվ կրկնօրինակման քվորումը առողջ պահելու համար, թեև replica-ի log-ը լիովին հասել է։
Եվս մեկ անգամ շեշտելու համար՝ սա ծայրահեղ եզրային դեպք է։ Նման գլոբալ տվյալների կորուստ տեղի ունենալու համար ամեն ինչ պետք է միաժամանակ խափանվի՝
- Ցանցային խնդիրները broker-ներին մեկ-մեկ դուրս են գցում, մինչև մնում է միայն մեկը (սա կարող է տևել միլիվայրկյաններ)։
- Հենց այդ վերջին broker-ը (LRS վիճակում) ենթարկվում է ոչ սահուն անջատման՝ նախքան իր cache-ը սկավառակի վրա flush անելը (սա տևում է վայրկյաններ)։
- Առողջ broker-ները վերադառնում են կլաստերին, բայց ստիպված են դեն նետել իրենց ճիշտ տվյալները՝ փչացած leader-ի վիճակին համապատասխանելու համար։
Հաշվի առնելով Kafka-ի այս կոնկրետ կարգավորումը՝
- երեք replica (broker-ներ 0, 1, 2)
min.insync.replicas=2- producer-ները կարգավորված
acks=all.-ով
հաջորդականությունը կարող է այսպես երևալ՝
KIP-966-ի հիմնական փոփոխությունները
«Last replica standing» խնդիրը լուծելու համար KIP-966-ը բաժանում է նախկին In-Sync Replicas (ISR) ցանկի պարտականությունները։ Սակայն նախքան replica-ների նոր վիճակներին նայելը, պետք է անդրադառնանք մի էական նախապայմանի՝ Kafka-ի High Watermark մեխանիզմի պարտադիր շտկմանը։
High watermark-ի առաջընթացի շտկումը
KIP-966-ը փոքր շտկում է բերում այն բանին, թե ինչպես է Kafka-ն առաջ տանում High Watermark-ը (HWM)՝ բոլոր in-sync replica-ներում committed վերջին offset-ը։ Օրինակ՝ consumer-ները օգտագործում են HWM-ը՝ համոզվելու համար, որ երբեք չեն կարդում այնպիսի տվյալներ, որոնք դեռ անվտանգ կերպով չեն կրկնօրինակվել։
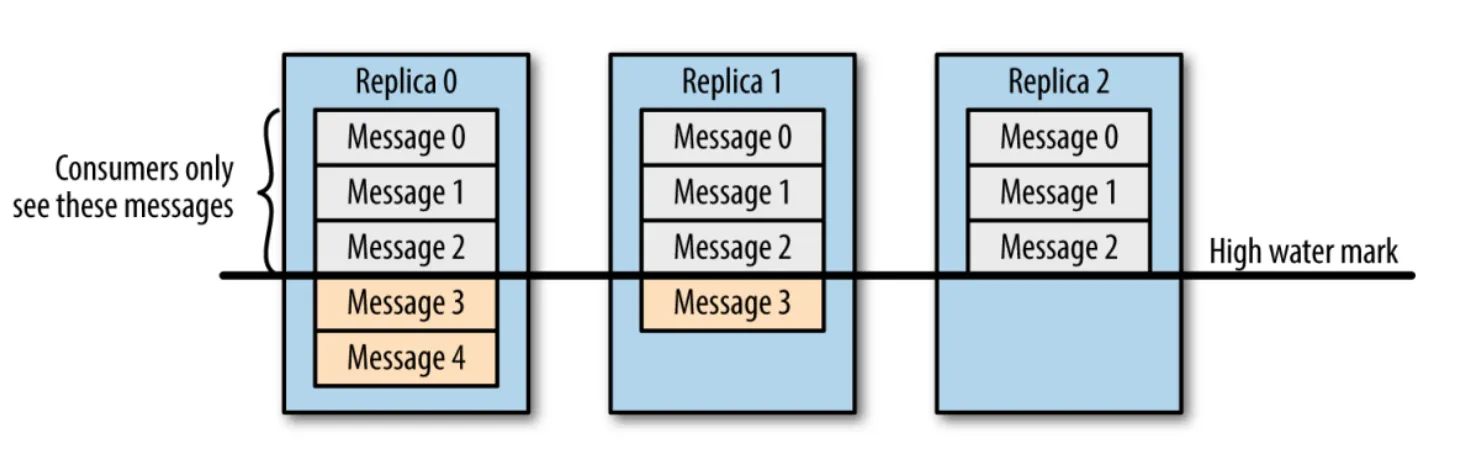
Աղբյուր. Kafka The Definitive Guide
KIP-966-ից սկսած՝ High Watermark-ը կարող է առաջ գնալ միայն երբ ISR-ի չափը >= min.insync.replicas։
Պատճառն այն է, որ Kafka-ն topic-ը չի սահմանափակում որևէ կոնկրետ acks կոնֆիգուրացիայով. acks-ը producer-ի կարգավորում է, այլ ոչ broker-ի։ Մի քանի client-ներ կարող են միաժամանակ գրել նույն Kafka topic-ում՝ տարբեր կոնֆիգուրացիաներով։
Այս փոփոխությունից առաջ, երբ topic-ի ISR-ը իջնում էր min.insync.replicas-ից ցածր՝
acks=allօգտագործող producer-ները արգելափակվում էին։acks=0 or 1օգտագործող producer-ները կարող էին շարունակել գրել։
Մեր «last replica standing» սցենարում սա նշանակում էր, որ միայնակ leader-ը շարունակում էր ընդունել acks=1 գրառումներ և High Watermark-ը առաջ տանել ոչ անվտանգ տվյալների վրա։ Եթե Kafka-ն հետագայում փորձեր ընտրել առողջ պահեստային broker՝ acks=all տվյալները պաշտպանելու համար, այդ պահեստայինը չէր ունենա վերջին acks=1 հաղորդագրությունները, ուստի HWM-ը ստիպված կլիներ հետ գնալ՝ կոտրելով consumer-ներին։
KIP-966-ը սա լուծում է՝ min.insync.replicas-ը դարձնելով գլոբալ կանոն High Watermark-ի համար՝ անկախ producer-ի օգտագործած acks կարգավորումից։ Այս HWM կանոնը լռելյայն է Kafka v4.0-ից սկսած։
Eligible Leader Replicas
Eligible Leader Replicas-ից առաջ Kafka replica-ն կարող էր լինել ընդամենը երկու վիճակում՝ ISR-ի ներսում (վստահելի) կամ դրանից դուրս (ոչ վստահելի)։
ELR-ը գտնվում է այս երկուսի միջև։ Այն հայտնվեց որպես փորձարարական հնարավորություն Kafka v4.0-ում և դարձավ լռելյայն v4.1-ում (և հետևաբար կիրառվում է միայն KRaft-ի համար, ոչ թե ZooKeeper-ի). սա replica-ների երկրորդական ցանկ է, որոնք հեռացվել են ISR-ից, երբ քվորումը min.insync.replicas-ից ցածր էր։ Սա սովորաբար տեղի է ունենում ցանցային partition-ների կամ fencing-ի պատճառով. դա անվտանգության մեխանիզմ է, որը մեկուսացնում է չարձագանքող broker-ին, որպեսզի այն չկարողանա հակասող թարմացումներ կատարել։ Թեև դրանք ISR-ում չեն, այս replica-ներն ունեցել են տվյալներ մինչև high watermark-ը այն պահին, երբ ավելացվել են ELR-ին։
KIP-966-ի խոսքերով՝
«Այն, ինչ մենք ի վերջո ուզում ենք, leader ընտրելու հնարավորությունն է՝ առանց տվյալներ կորցնելու կամ HWM-ը հետ տանելու, քանի դեռ կա առավելագույնը min.ISR-1 ոչ սահուն անջատում»։
Ամփոփելով՝ սկզբնական ISR-ի պարտականությունները այժմ բաժանված են, և յուրաքանչյուր replica գտնվում է այս վիճակներից մեկում՝
- ISR (In-Sync Replicas). ինչպես նախկինում,
acks=all-ի դեպքում ծառայում է որպես տվյալների կրկնօրինակման ակտիվ քվորում։ High Watermark-ը առաջ է գնում միայն մինչև այն կետը, որը գրել է ISR-ի յուրաքանչյուր անդամ։ - ELR (Eligible Leader Replicas). ծառայում է որպես պահեստային ցանկ leader-ի ընտրության համար՝ պահելով այն replica-ները, որոնք հայտնի են որպես անվտանգ leader թեկնածուներ սառեցված High Watermark-ի նկատմամբ։
- ISR/ELR-ից դուրս. ոչ վստահելի replica-ներ, որոնք հետ են մնում և չեն կարող ընտրվել leader՝ առանց տվյալների կորստի ռիսկի։
Արժե կրկին շեշտել. ELR գոյություն ունի միայն երբ ISR < min.insync.replicas։ Մնացած բոլոր դեպքերում ELR ցանկը մաքրվում է և մնում դատարկ։
KIP-966-ի հետագա բարելավումները
Նայենք ավելի մոտիկից մյուս բարելավումներին։
Ոչ սահուն անջատման ճանաչումը
KIP-966-ը նաև Kafka-ին ավելի լավ է դարձնում սահուն անջատումը ոչ սահունից տարբերելու հարցում։ Ներկայումս սահուն անջատման ժամանակ broker-ը flush է անում իր log-երը և սկավառակի վրա գրում CleanShutdownFile՝ փոքր JSON ֆայլ, որը պահում է broker-ի ընթացիկ epoch-ը։ Հաջորդ գործարկման ժամանակ broker-ը կարդում է այս ֆայլը և պահված epoch-ը ներառում է KRaft controller-ին ուղղված իր գրանցման հարցման մեջ։ Եթե epoch-ը համընկնում է controller-ի գրառմանը, անջատումը սահուն է եղել։ Եթե ֆայլը բացակայում է կամ epoch-ը տարբեր է, controller-ը անջատումը համարում է ոչ սահուն։
Ինչո՞ւ է սա կարևոր ELR-ի համար։ Երբ broker-ը գրանցվում է ոչ սահուն անջատումից հետո, controller-ը այն հանում է և՛ ISR-ից, և՛ ELR-ից՝ նախքան կլաստեր թույլ տալը։ Սա ապահովում է, որ broker-ը, որը կարող էր կորցնել page-cache տվյալները, չմնա լուռ կերպով վստահելի leader թեկնածու։
Partition leader-ի նոր ընտրությունը
ELR-ը միացրած՝ controller-ը նախ ISR-ում փնտրում է անվտանգ leader, ապա՝ ELR-ում։ Եթե ոչ մեկն էլ հասանելի թեկնածու չի առաջարկում, հաջորդը որոշում է գոյություն ունեցող unclean.leader.election.enable կարգավորումը՝
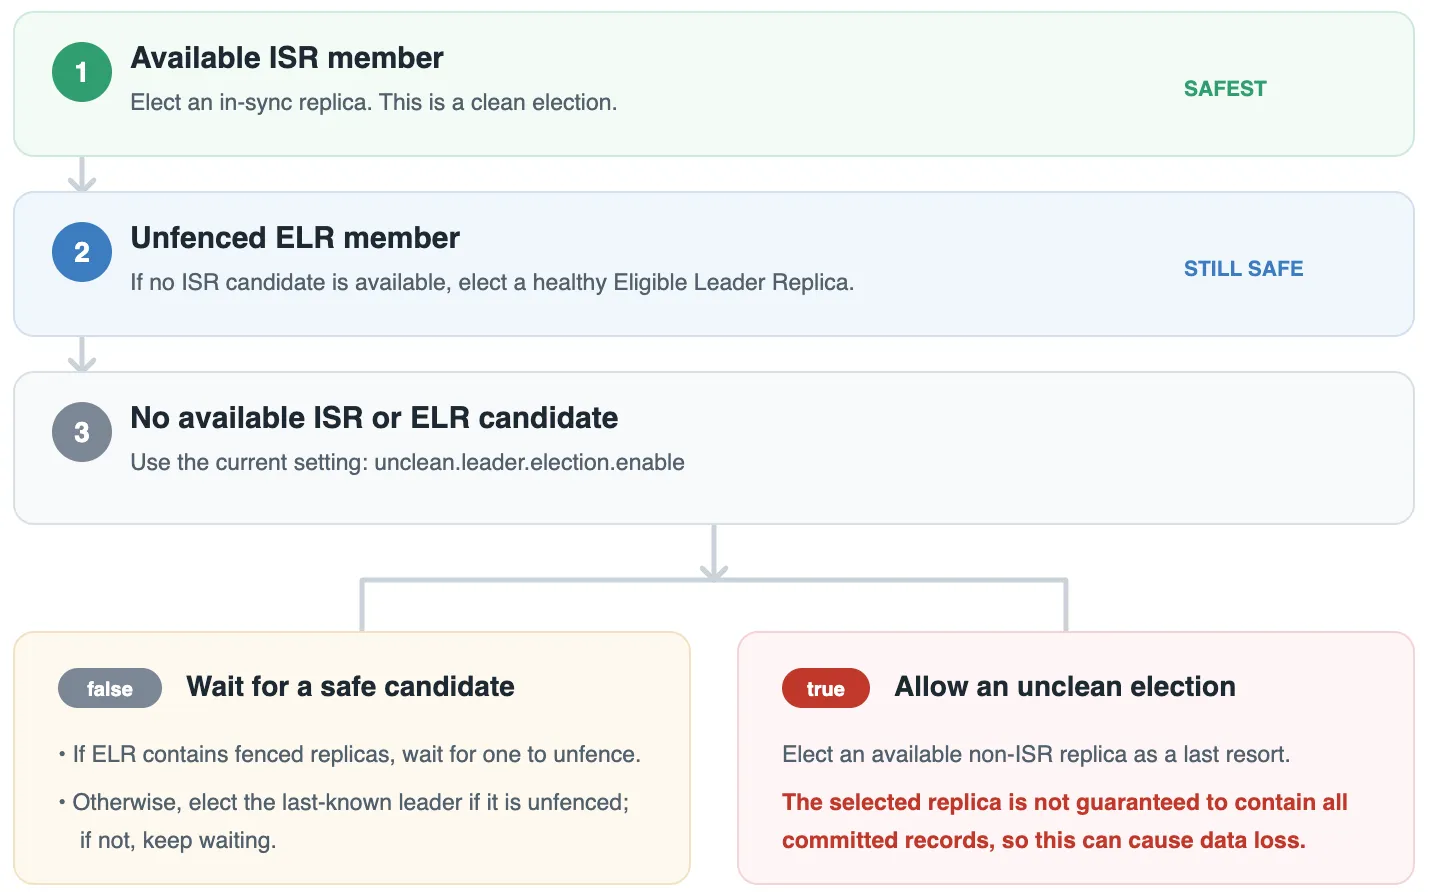
KIP-966-ը նախատեսում է նաև նոր unclean.recovery.strategy՝ Aggressive, Balanced և None տարբերակներով, բայց այն դեռ իրականացված չէ (Kafka 4.3-ի դրությամբ այսօր) և թիրախային թողարկման տարբերակ չունի, ուստի առայժմ մի կողմ կթողնենք։
ISR-ը այժմ կարող է դատարկ լինել
Kafka-ի հին վարքագիծը թույլ չէր տալիս ISR-ին դատարկ դառնալ։ KIP-966-ը թույլ է տալիս դատարկ ISR։ Երբ ISR-ը հասնում է զրոյի, ELR-ը կարող է պարունակել replica-ներ, որոնք հայտնի են որպես High Watermark-ը ներառյալ բոլոր committed տվյալների կրողներ։ Այդ դեպքում leader-ի ընտրությունը կարող է ընտրել դրանցից մեկը՝ փոխանակ հենվելու broker-ի վրա, որը եղել է ISR-ի վերջին անդամը, բայց կարող էր ոչ սահուն անջատման ժամանակ կորցնել flush չարված տվյալները։
ELR-ի և KIP-966-ի ազդեցությունը
KIP-966-ը հիմնականում ներքին դիմացկունության շտկում է, բայց բերում է վարքագծային փոփոխություններ, որոնք կարող եք նկատել։ Քննենք դրանք Kafka-ի մի քանի տեսանկյունից՝
Producer-ի տեսանկյունից
acks=all-ով producer-ները աշխատում են ինչպես նախկինում. նրանք արգելափակվում են, երբ ISR-ը իջնում է min.insync.replicas-ից ցածր։ Նշանակալի փոփոխությունը վերաբերում է acks=0-ին և acks=1-ին. քանի որ դրանք անտեսում են min.insync.replicas պարամետրը, leader-ը դեռ ընդունում է նրանց գրառումները, բայց HWM-ը դադարում է առաջ գնալ, քանի դեռ ISR-ը նվազած է։ Եթե տարբեր acks կարգավորումներով producer-ները գրում են նույն topic-ում, սա փակում է այն բացը, որի միջով acks=1 տրաֆիկը նախկինում կարող էր HWM-ը առաջ տանել թերի ISR-ի վրա՝ հակասելով acks=all-ի դիմացկունության սպասումներին։
Broker-ի տեսանկյունից
Broker-ները հիմնականում տեղյակ չեն ELR-ի մասին. KRaft controller-ը այն ամբողջությամբ պահում է partition-ի մետատվյալներում, և կրկնօրինակումը դեռ հետևում է ISR-ին՝ ինչպես նախկինում։
Փոխվողը Kafka-ի կողմից broker-ների վերագործարկումների մշակման եղանակն է։ Սահուն անջատման ժամանակ broker-ը flush է անում իր log-երը և իր epoch-ը պահում CleanShutdownFile-ում։ Երբ այն նորից գործարկվում է, controller-ը օգտագործում է այդ epoch-ը՝ որոշելու, թե արդյոք անջատումը սահուն է եղել։ Եթե հայտնաբերում է ոչ սահուն վերագործարկում, այդ broker-ը հանում է և՛ ISR-ից, և՛ ELR-ից։
Consumer-ի տեսանկյունից
Consumer-ները այն client-ներն են, որոնք փոփոխությունն ամենաակնհայտ կերպով զգում են։ Նրանք կարող են տեսնել միայն HWM-ից ներքև գտնվող հաղորդագրությունները։ Երբ ISR-ի չափը իջնում է min.insync.replicas-ից ցածր, HWM-ը սառչում է. ուստի նույնիսկ նոր արտադրված acks=0/1 հաղորդագրությունները մնում են HWM-ից վերև և չեն կարող կարդացվել, մինչև ISR-ը վերականգնվի։ KIP-966-ից առաջ consumer-ները կարող էին շարունակել կարդալ նոր հաղորդագրություններ replica-ների մասնակի խափանումների ժամանակ։ KIP-966-ով նվազած ISR-ը փաստացի դադարեցնում է այն, ինչ consumer-ները կարող են տեսնել, այլ ոչ միայն producer-ների գրածի դիմացկունությունը։
Last Replica Standing խնդիրը՝ ELR-ով
Նորից անցկացնենք սցենարը սկզբից՝ Kafka-ի նույն կարգավորմամբ, այս անգամ ELR մեխանիզմը միացրած՝
- երեք replica (broker-ներ 0, 1, 2)
min.insync.replicas=2- producer-ները կարգավորված
acks=all-ով
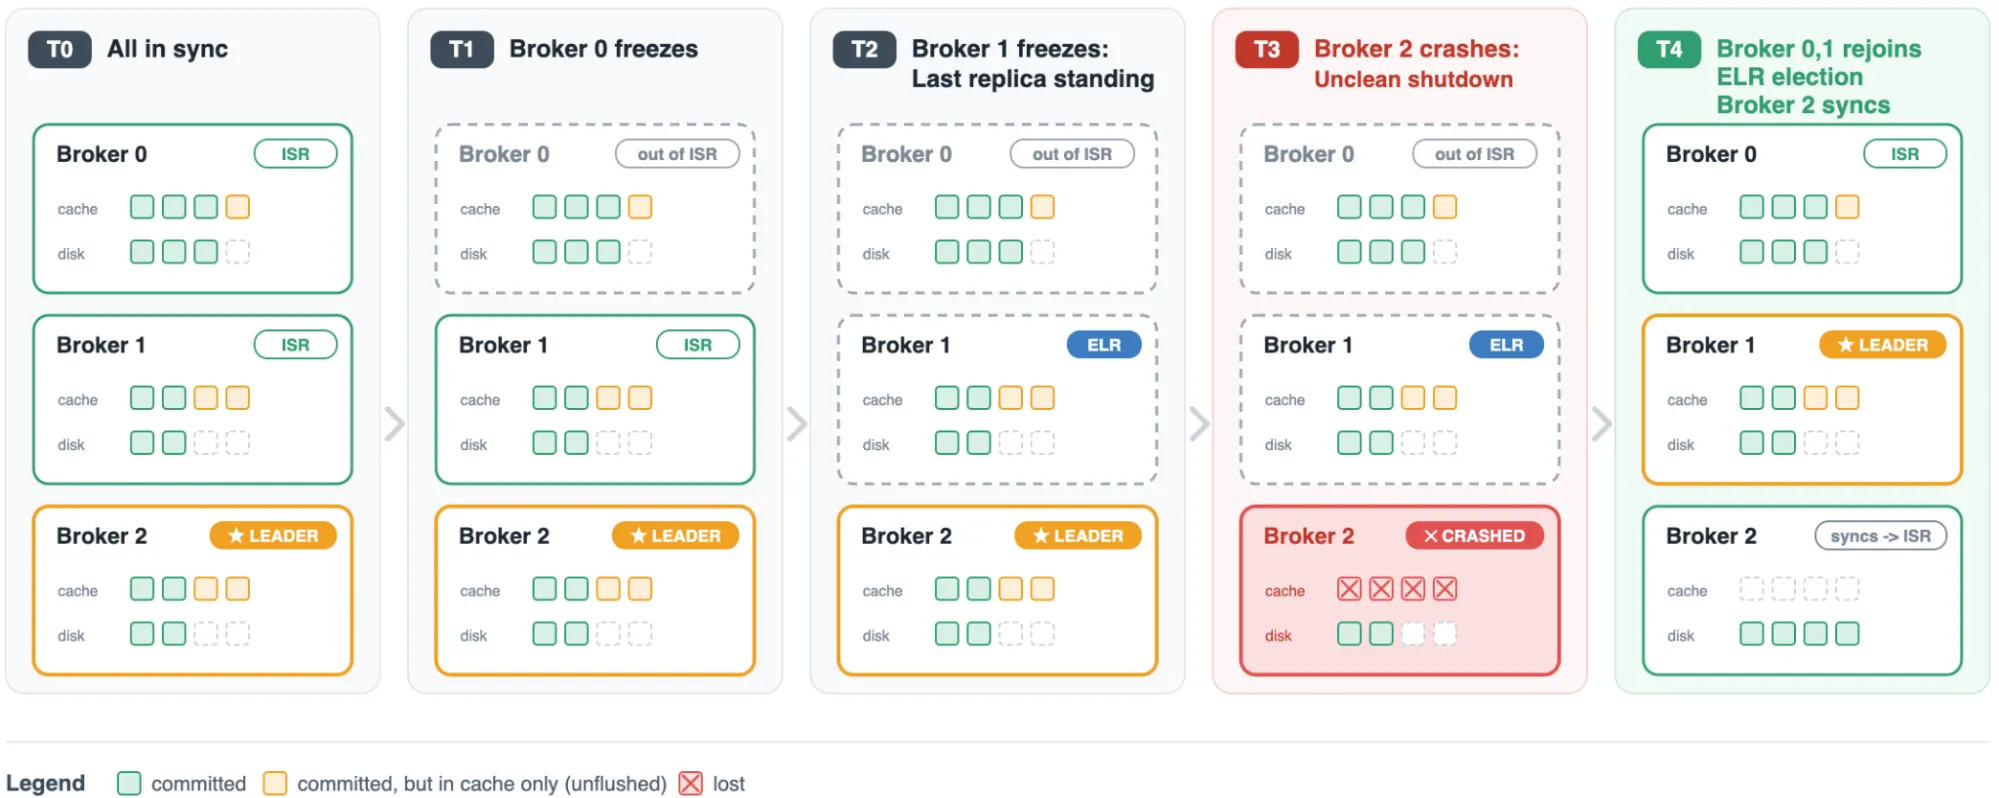
Հին վարքագծի դեպքում Kafka-ն broker 2-ը պահում էր ISR-ում, ուստի վերագործարկումից հետո այն նորից դարձավ leader։ Broker-ներ 0-ը և 1-ը՝ ճիշտ պատճեններ պահելով, ստիպված էին truncate անել իրենց log-երը՝ փչացած leader-ին համապատասխանելու համար։
ELR-ի դեպքում ամեն ինչ այլ կերպ է ընթանում՝
Երբ broker 0-ը դուրս է մնում ISR-ից, min.insync.replicas=2 պայմանը դեռ բավարարված է, ուստի այն չի ավելացվում ELR-ին։ Թեև այն հեռանալու պահին կրկնօրինակել էր մինչև HWM-ը, ISR-ի մնացածը կարող է շարունակել HWM-ը առաջ տանել, ուստի Kafka-ն այլևս չի կարող վստահ լինել, որ broker 0-ը պահում է ամեն ինչ մինչև HWM-ի հետագա արժեքը։
ISR: [0, 1, 2] → [1, 2]
ELR: [] → []
Երբ broker 1-ը դուրս է մնում, ISR-ը իջնում է min.insync.replicas-ից ցածր, և HWM-ը դադարում է շարժվել։ Kafka-ն գիտի, որ broker 1-ը պահում է յուրաքանչյուր գրառում մինչև այս սառեցված HWM-ը, ուստի այն ավելացնում է ELR-ին։
ISR: [1, 2] → [2]
ELR: [] → [1]
Երբ broker 2-ը խափանվում է և fence է արվում, ISR-ը կարող է դատարկ դառնալ։ Երբ ցանցային partition-ը լուծվում է և broker-ներ 0-ը և 1-ը unfence են արվում, controller-ը ELR-ից leader է ընտրում broker 1-ը և այն վերադարձնում ISR։ Երբ broker 2-ը ավելի ուշ նորից միանում է, controller-ը նկատում է նրա ոչ սահուն անջատումը և համաժամեցնում այն ընթացիկ leader-ի՝ broker 1-ի հետ։
Նույնիսկ այս ծայրահեղ, բազմաշերտ եզրային դեպքում Kafka-ն վերականգնվում է, և committed acks=all տվյալները պահպանվում են։
Ամփոփում
KIP-966-ը հետաքրքիր է նրանով, որ ոչ արագացնում է Kafka-ն, ոչ էլ ավելացնում նոր տեսանելի հնարավորություն, որի հետ օգտատերերը գործ ունենան ամեն օր։ Օգտատերերի մեծ մասը երբեք չի հանդիպի Last Replica Standing սցենարին արտադրական միջավայրում, սակայն այն դեռ կարող էր կոտրել Kafka-ի ամենաուժեղ դիմացկունության երաշխիքները։
ELR-ը լուռ փակում է ծայրահեղ եզրային դեպքը և Kafka-ում ներմուծում է կարևոր տարբերակում. replica-ին պարտադիր չէ ակտիվորեն մասնակցել կրկնօրինակմանը՝ leader-ի համար ամենաանվտանգ ընտրությունը լինելու համար։
Սա ևս մեկ քայլ է դեպի այն, որ Kafka-ի դիմացկունության երաշխիքները գործեն ոչ միայն առօրյա աշխատանքում, այլև խափանումների ամենահազվադեպ համակցությունների դեպքում։