Pytorch, TensorFlow, JAX և Flax. համեմատություն ML ինժեների աչքերով
Այս բլոգ գրառման և դրան կից օրինակների շնորհիվ տարբեր ֆրեյմվորքների առանձնահատուկ թակարդներն ու թույլ կողմերը հեշտ է հասկանալ։
Խորը ուսուցման որ ֆրեյմվորքն է առաջատար։
ML աշխարհ մտնելիս կարող եք շփոթվել ընտրելու համար գրադարանների քանակից. ճամբարները բաժանված են ինչպես քաղաքական կուսակցությունները կամ կրոնները (գրեթե front-end ֆրեյմվորքների չափով)։ Բազմաթիվ տարբերակներից մի քանիսը առանձնանում են որպես ամենահայտնիները՝ Pytorch, Tensorflow (+ Keras), Pytorch Lightning, և ավելի վերջերս՝ JAX (իր NN ֆրեյմվորքի՝ Flax-ի հետ միասին)։ Դրանցից յուրաքանչյուրը կարելի է օգտագործել աբստրակցիայի տարբեր մակարդակում. Pytorch Lightning-ը և Keras-ը գտնվում են ավելի վերևում, Tensorflow-ն, PyTorch-ը և Flax-ն ավելի շատ վերահսկողություն են տալիս, իսկ JAX-ը աշխատում է ամենացածր մակարդակում։
Այս բլոգ գրառման մեջ ես ուզում եմ ներկայացնել որակական օրինակներ, որոնք օգնում են համեմատել այս ֆրեյմվորքների ուժեղ և թույլ կողմերը, որպեսզի դրանց արժանիքներն ու թերությունները ավելի հեշտ հասկացվեն։
Tensorflow + Keras
TensorFlow-ը ստեղծվել է Google Brain-ի կողմից և թողարկվել 2015 թվականին։ Ֆրեյմվորքը ընդգրկում է մեքենայական ուսուցման խնդիրների լայն շրջանակ՝ պարզ գծային ռեգրեսիայից մինչև բարդ խորը ուսուցման ճարտարապետություններ, և ապահովում է ցածր մակարդակի վերահսկողություն մոդելի ճարտարապետության վրա։
Ավելի բարձր մակարդակի վերահսկողությունը, ընդհակառակը, հասանելի է Keras-ի միջոցով, որը դարձավ Tensorflow-ի հիմնական բաղադրիչ՝ սկսած 2-րդ տարբերակից)։ Սակայն Keras 3.0-ն կրկին հեռանում է միայն Tensorflow-ի համար լինելուց և աջակցում է մի քանի backend՝ JAX, Tensorflow և Pytorch։
Tensorflow-ը հայտնի է նաև իր թիրախավորած հարթակների լայն շրջանակով. բջջային սարքեր (Tensorflow Lite), խոշորամասշտաբ բաշխված համակարգեր (Tensorflow Serving), արտադրական մակարդակի տեղակայում (TFX – Tensorflow Extended) և վեբ տեղակայում (Tensorflow.js՝ Node.js-ում մոդելներ գործարկելու համար)։
Pytorch
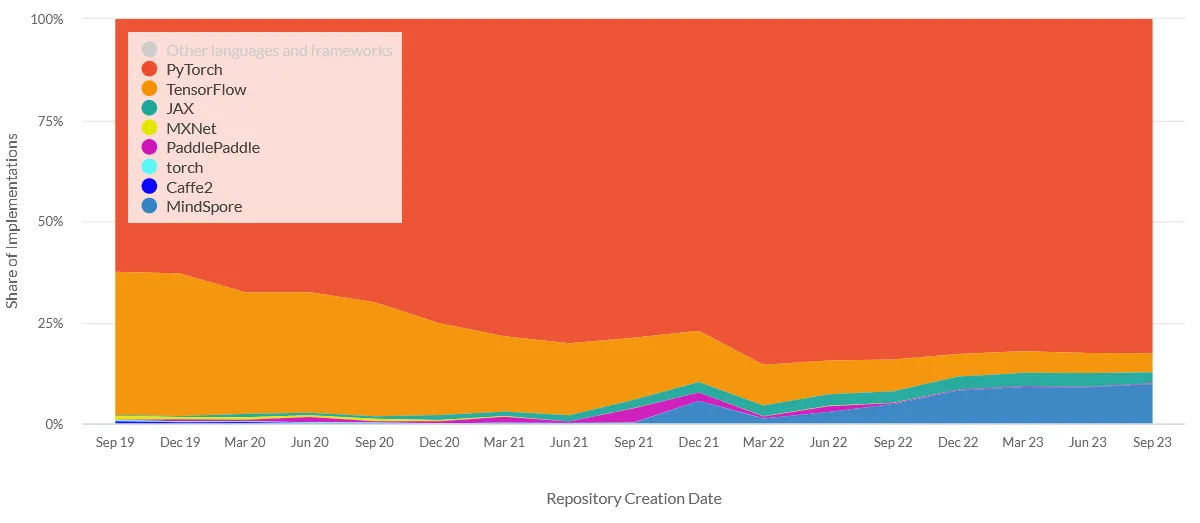
Որքան հայտնի են ֆրեյմվորքները մեքենայական ուսուցման նոր հոդվածներում, աղբյուր՝ visio.ai
Pytorch-ը թողարկվել է 2016 թվականին Facebook-ի AI հետազոտական լաբորատորիայի (FAIR) կողմից և արագ գրավեց հետազոտողներին ու մշակողներին։ Սա հիմնականում պայմանավորված էր իր դինամիկ հաշվարկային գրաֆով և օգտագործման հեշտությամբ, որոնք Tensorflow-ին դուրս մղեցին այն կայուն դիրքից, որ նա այդ ժամանակ ուներ։
Թոքաբորբի մոդելի մեր խորքային վերլուծության ժամանակ մոդելը վարժեցրինք և գնահատեցինք PyTorch-ով։
Նրա Dynamic Computation Graph-ը (գրաֆը կառուցվում է ընթացքում) այն ժամանակ հեղափոխական էր՝ զգալիորեն հեշտացնելով ցանցի վրիպազերծումը և աշխատանքի ընթացքում փոփոխությունները։ Այս ճարտարապետությունն ու API-ն ավելի լավ էին համապատասխանում Pythonic ոճի մշակմանը, քան մյուս ֆրեյմվորքները (օր.՝ Caffe)։ Մյուս կարևոր առավելությունը գրադիենտների ավտոմատ հաշվարկի ամուր աջակցությունն էր, որը զգալիորեն պարզեցրեց մեքենայական ուսուցման մոդելների իրականացումը։ PyTorch-ը թույլ է տալիս նաև կոդը կառուցել ճկուն, մոդուլային եղանակով, ինչը այն չափազանց ժողովրդական դարձրեց R&D-ում։
Ժամանակի ընթացքում, երբ նրա ժողովրդականությունը մշակողների համայնքում աճեց, Pytorch-ի էկոհամակարգը զգալիորեն ընդլայնվեց՝ գերազանց փաստաթղթերով, մասնագիտացված գործիքներով և գրադարաններով (որոնք ընդգրկում են տարբեր ոլորտներ՝ աուդիո, computer vision կամ տեքստ/nlp, ինչպես նաև տեղակայում, օր.՝ edge տեղակայում), ինչպես նաև ավելի նեղ նշանակության գրադարաններով՝ բժշկական computer vision գրադարանը Monai, GenAI diffusion գրադարանը Diffusers, կամ 3d կետային ամպի տվյալների համար՝ Pytorch Geometrics և Pytorch3D։ Դրան գումարած՝ fast.ai-ի նման գրադարանները հնարավորություն են տալիս արագ սկսել իմաստալից, ունակ լուծումների կառուցումը՝ հեշտ հասանելիություն տալով հետազոտական աշխարհի նորագույն գաղափարներին։
Pytorch Lightning
Pytorch Lightning-ը Pytorch-ի վրա կառուցված բարձր մակարդակի ֆրեյմվորք է, որը պարզեցնում է խորը ուսուցման մոդելների մշակումն ու վարժեցումը։ Այն թաքցնում է բարդ գործողություններ, որոնք նախկինում պետք էր ձեռքով գրել (օր.՝ վարժեցման ցիկլերը և վալիդացիայի քայլերը), թույլ տալով հետազոտողներին կենտրոնանալ մոդելի մշակման էական մասերի վրա։
Ֆրեյմվորքի հիմնական առավելությունները.
- պարզ մասշտաբավորում մի քանի GPU-ների և հանգույցների վրա,
- սովորական առաջադրանքների ավտոմատ մշակում, ինչպիսիք են checkpointing-ը, լոգավորումը կամ վաղ կանգառը (early stopping),
- էլ ավելի մոդուլային կառուցվածք, որը կոդը դարձնում է ավելի հեշտ կարդացվող և պահպանվող։
JAX +Flax
JAX-ը Google-ի ստեղծած բաց կոդով գրադարան է թվային հաշվարկների համար, որը զուգակցում է Python-ի ճկունությունը սարքավորման արագացման հետ։ Նրա հիմնական առավելությունները.
- ավտոմատ դիֆերենցիացիա, որն աշխատում է բնիկ կերպով Python-ի և NumPy-ի հետ։
- Just-In-Time Compilation (JIT), որն արագացնում է Python ֆունկցիաները՝ դրանք վերածելով օպտիմիզացված մեքենայական կոդի, որը աշխատում է CPU-ի, GPU-ի և TPU-ի վրա։
- լայն վեկտորիզացիա և զուգահեռություն, որը թույլ է տալիս կոդին արդյունավետ աշխատել տարբեր սարքավորման հարթակներում։
Flax-ը, իր հերթին, JAX-ի վրա կառուցված բարձր մակարդակի նեյրոնային ցանցերի գրադարան է, որը նույնպես մշակվել է Google-ի կողմից։ Նրա հիմնական նպատակը մոդուլային նախագծումն է, որը հեշտ է հարմարեցնել։ Այն կառուցվածքային եղանակով կառավարում է մոդելի պարամետրերը, վիճակը և պատահականությունը, ինչը թույլ է տալիս մոդելի տրամաբանությունը անջատել վարժեցման տրամաբանությունից և կոդը դարձնում է ավելի հեշտ վրիպազերծվող։
JAX-ի և Flax-ի համադրությունը հիմնական գործիքն է և՛ Deepmind-ի, և՛ Google AI-ի համար։
Վերլուծություն
Մենք անդրադարձանք յուրաքանչյուր ֆրեյմվորքի ընդհանուր նախապատմությանն ու մոտիվացիային, բայց ուզում ենք նաև որակական համեմատություններ, ինչպիսին է ժողովրդականությունը, ինչպես նաև UX և արտադրողականության չափումներ, ինչպիսիք են կատարման ժամանակը, գրելու հեշտությունը և այլն։ Հաջորդ բաժինը ավելի հստակ պատկերացում է տալիս, թե որ ֆրեյմվորքն ինչ խնդրի համար է ամենահարմարը։
Ժողովրդականություն
Հայացք GitHub աստղերից
Ստորև բերված է ընտրված ֆրեյմվորքների ժողովրդականության համեմատությունը GitHub-ում։
Ժողովրդականությունը GitHub-ում
Pytorch-ը հստակ առաջատար է (81 հազ. աստղ), Tensorflow-ը (74 հազ. աստղ) մոտ հետևում է, ապա հաջորդում է նրա հետ սերտորեն կապված ֆրեյմվորքը՝ Keras-ը (61 հազ.)։ JAX-ը (29 հազ. աստղ) և Pytorch Lightning-ը (28 հազ. աստղ) ավելի նոր գրադարաններ են, իսկ Flax-ը (6 հազ. աստղ) ամենաքիչ հայտնին է՝ լինելով բոլորից ամենանորը։
Հետազոտական հայացք
Ավելին՝ եթե նայենք, թե որ ֆրեյմվորքն են օգտագործում նոր հոդվածները, Pytorch-ը հստակ գերակշռում է հետազոտական համայնքում (խորը ուսուցման նոր հոդվածների ավելի քան 75%-ը հենվում է Pytorch-ի վրա)։ Սա ի վերջո ցույց է տալիս, որ մարդիկ ավելի հակված են նոր մոդելներն օգտագործել Pytorch-ում. այդուհանդերձ, ագրեգատորները, ինչպիսին է Hugging Face-ի Transformer-ը, հաճախ հնարավորություն են տալիս մնալ մոդելի նկատմամբ ագնոստիկ՝ առանց մոդելները ձեռքով փոխարկելու։
Համակարգչային տեսողության պարզ օրինակ
Փորձի կարգավորումը
Այս լուծման համար մենք կենտրոնանում ենք պարզ օրինակի վրա, որն օգտագործում է.
- 5 Conv շերտերից բաղկացած նեյրոնային ցանց՝ Batch Normalization-ով (քանի որ այն վարժեցման և թեստավորման փուլերը վարվել է տարբեր կերպ)
- Imagenette տվյալների հավաքածուն, որը ներառում է ImageNet-ի 10 ամենահասանելի դասերը և տալիս է 9472 օրինակ։
- Adam օպտիմիզատորը՝ 0.001 պարզ ուսուցման արագությամբ։
Արտադրողականություն
Այս բաժինը քննարկում է մեքենայական ուսուցման իրականացման երկու հիմնական ոճ. մեկը՝ խոշոր տվյալների հավաքածուների համար հարմար, որն աշխատում է հոսքային եղանակով, և մյուսը՝ ավելի փոքր տվյալների հավաքածուների համար, որոնք ամբողջությամբ տեղավորվում են GPU-ի հիշողության մեջ։
Out-of-the-box իրականացում (հոսքի վրա հիմնված)
| Pytorch | Pytorch lightning | Tensorflow + Keras | JAX |
| 232s (180s՝ բնիկ loader-ով) | 180s | 64s | 84s |
Այստեղ տվյալները բեռնվում են հոսքային եղանակով, այսինքն՝ յուրաքանչյուր պատկեր վերցվում է data loader-ի միջոցով միայն այն ժամանակ, երբ անհրաժեշտ է։ Յուրաքանչյուր կարգավորում կարելի է էլ ավելի լավացնել բազմաթիվ եղանակներով, բայց մեր նպատակը պարզ, out-of-the-box իրականացումն է։ Արդյունքները ցույց են տալիս, որ Tesorflow-ն ու JAX-ն ավելի արագ են, իսկ Pytroch-ն ու Pytorch lightning-ը՝ ավելի դանդաղ։ Բացատրությունը պարզ է. Pytorch-ը և Pytorch lightning-ը պատկերները բեռնում են PIL-ով, մինչդեռ Tensorflow-ն ու FLAX-ը հենվում են բնիկ TF իրականացման վրա։ Pytorch-ի համար հատուկ Dataloader-ով փորձարկելով (torchvision.io.read_image() օգտագործմամբ)՝ մեզ հաջողվեց մշակման ժամանակը կրճատել 22%-ով (մինչև 180s)։ Դա դեռ զգալիորեն ավելի դանդաղ է, քան TF մշակումը (որը ներքուստ օգտագործում է խիստ օպտիմիզացված tf.io.read_file())։
Ամբողջը հիշողության մեջ իրականացում (հիշողության վրա հիմնված)
Ի տարբերություն նախորդ կարգավորման՝ այստեղ մենք օգտագործեցինք 3/10 դասերի ենթաբազմություն հիշողության սահմանափակումների պատճառով) և ամբողջ տվյալների հավաքածուն տեղադրեցինք GPU-ի վրա (նվազեցնելով ավելի դանդաղ DataLoader-ների ազդեցությունը)։ Այս կարգավորմամբ Pytorch-ը թվում է զգալիորեն ավելի արագ, քան այլընտրանքները, PyTorch Lightning-ն ու JAX-ը ցույց են տալիս համադրելի ժամանակներ, իսկ Tensorflow-ը ամենադանդաղն է։ Սա կարող է հուշել, որ Pytorch Lightning-ը և Keras-ը իրենց լրացուցիչ հնարավորությունների պատճառով ունեն որոշ լրացուցիչ ծախս (overhead)։
Երկու օրինակները (հոսքի վրա և հիշողության վրա հիմնված) Imagenette տվյալների հավաքածուի պարզ փորձեր են։ Այն փոխարեն, որ ապացուցեն, թե որ ֆրեյմվորքն է լավագույնը, դրանք գեղեցիկ կերպով ընդգծում են հիմնական API-ի հետևում թաքնված որոշ թակարդներ։ Այդ թակարդներից մի քանիսին, որոնց արդեն անդրադարձել ենք (օրինակ՝ տվյալների բեռնում), կբացատրվեն, իսկ մյուսները կքննարկվեն հաջորդ բաժնում։
Կոդավորման UX և վերլուծություն
Յուրաքանչյուր օրինակ օգտագործում է համադրելի լռելյայն կարգավորում՝ բեռնելով Imagenet-ի ենթաբազմություն, որը կոչվում է Imagenette (ImageNet-ի 10 ամենահասանելի դասերը)՝ 9472 օրինակով։ Ստորև բերված է կոդի տողերի քանակի (LOC) համեմատություն՝ բացառելով import-ները և կարգավորումը, որը պետք է սահմանվի։
LOC-ների համեմատություն տարբեր ֆրեյմվորքների իրականացումներում
Pytorch-ն ու Tensorflow-ը պահանջում են ամենաշատ տողերը, իսկ JAX-ը ամենակոմպակտն է (թեև կարող է պահանջել որոշ համակարգային փոփոխականների սահմանում)։ Այստեղ աչքի ընկնող պետք է լինեն յուրաքանչյուր ֆրեյմվորքի առանձնահատկությունները։ Pytorch-ը հնարավորություն է տալիս կոդի բազայի ուժեղ մոդուլյարիզացիա (մոդելներ կառուցելու OOP մոտեցմամբ), իսկ Pytorch Lightning-ը մեկ քայլ առաջ է գնում՝ նման մոտեցում կիրառելով տվյալների հարթության վրա։ Արդյունքը շատ ավելի մաքուր կոդ է, որը ավելի հեշտ է հասկանալ։
Tensorflow-ը սկսել է ավելի ֆունկցիոնալ ոճով, բայց հետո անցել է subclassed API-ի (ոգեշնչված Pytorch-ի հաջողությամբ), որը նույնպես դա հնարավոր է դարձնում։ Այդ ֆրեյմվորքում datasets-ը և dataloader-ները, սակայն, դեռ ավելի հաճախ գրվում են ֆունկցիոնալ ոճով։
Flax-ի և JAX-ի փիլիսոփայությունն այն է, որ մոդելի ճարտարապետությունը և վարժեցման բնութագրերը մնան միմյանցից անկախ։ Համապատասխանաբար, սպասվում է, որ դուք կստեղծեք TrainingState, որը հասանելիություն ունի մոդելի պարամետրերին, ընտրված օպտիմիզատորին և ուսուցման արագությանը՝ առանց մոդելի ճշգրիտ ճարտարապետությանը դիպչելու։
Արժե նշել, որ Tensorflow-ը տարիների ընթացքում կուտակել է որոշ տեխնիկական պարտք, որը երևում է խախտող փոփոխություններում (և, փաստորեն, Keras 3.0-ի ու TF2-ի միջև թույլ աջակցության և համատեղելիության մեջ)
Ֆրեյմվորքների միջև հետաքրքիր տարբերություններ
Տարբեր initializer-ներ
Ֆրեյմվորքների միջև մեկ այլ նկատելի տարբերություն այն է, թե ինչպես են դրանք լռելյայն սկզբնավորում կշիռները.
- Tensorflow-ը կշիռները սկզբնավորում է Xavier Uniform-ով,
- Pytorch-ը կշիռները սկզբնավորում է Kaiming Uniform-ով,
- Flax-ը կշիռները սկզբնավորում է LeCun Normal-ով.
Սկզբնական կշիռների բաշխման համեմատություն Xavier, Kaming և LeCun սկզբնավորումների համար
Kaming-ը հաշվի է առնում շերտի մուտքային միավորների քանակը (կոնվոլյուցիոն շերտի համար՝ մուտքային ալիքների քանակը բազմապատկած միջուկի չափով), մինչդեռ Xavier սկզբնավորումը հաշվի է առնում նաև ելքային միավորները (fan_out)։ LeCun սկզբնավորումը (Xavier սկզբնավորման տարբերակ) ավելի լավ է աշխատում tanh ակտիվացիայով շերտերի համար։
Դրանք բոլորը կարող են նման թվալ, բայց տարբեր initializer-ները կարող են խիստ ազդել այն բանի վրա, թե ինչպես են մոդելները սկսում վարժեցումը և ինչ ուղղություն են վերցնում, ուստի այդպիսի մանրամասներին ուշադրություն դարձնելը կարող է մեծ տարբերություն ստեղծել կոդը նոր ֆրեյմվորք փոխադրելիս։
Տարբեր մշակման backend-ներ
Ինչպես նշվեց արտադրողականության բաժնում, կան որոշ տարբերություններ այն հարցում, թե ինչպես են մշակվում պատկերները, և հետևաբար՝ տվյալների աուգմենտացիան։ Pytorch-ը հենվում է PIL-ի վրա, մինչդեռ Tensorflow-ն ու JAX-ը օգտագործում են ավելի բնիկ լուծումներ։ Սա երկսայրի է. PIL-ի վրա հիմնված պատկերների աուգմենտացիաներն ավելի հեշտ են կատարվում, բայց կարող են ավելի քիչ օպտիմիզացված լինել, քան բնիկ լուծումները, և ի վերջո երկարացնել նախամշակումը (ինչպես պատահեց մեր հոսքի վրա հիմնված օրինակում)։
GPU հիշողության բաշխման տարբեր ալգորիթմներ
Pytorch-ը և Pytorch Lightning-ը հիշողությունը բաշխում են աստիճանաբար՝ ավելի շատ վերցնելով, երբ անհրաժեշտություն է առաջանում։ Tensorflow-ն ու JAX-ը, ընդհակառակը, բաշխում են ագահաբար, ինչը կարող է հանգեցնել տարօրինակ սխալների, երբ դրանք օգտագործվում են նույն scope-ում։ Այս հայտնի խնդիրը նկարագրված է JAX-ի կայքում և կարող է շտկվել մի քանի տող կոդով։
Այս տարբեր ռազմավարությունները կարող են ազդել մշակման ժամանակի վրա, բայց կարող են նաև ավելի շատ հիշողություն զավթել, երբ անհրաժեշտ է, թույլ չտալով GPU-ն օգտագործել այլ բաղադրիչներին, որոնց դա կարող է պետք լինել։
Առկա մոդելների աջակցություն
Ամբողջ վերլուծությունը ցույց է տալիս, որ JAX-ը հետևողականորեն հուսալի և ընթեռնելի ընտրություն է։ Քանի որ այն ամենանորն է և դեռ լայնորեն չի ընդունվել, այնուամենայնիվ, դեռ ավելի շատ մոդելներ վարժեցված կշիռներով են պետք։ Սա կարելի է շրջանցել HuggingFace-ի և նրա transformer գրադարանի օգտագործմամբ, բայց դա կարող է իդեալական չլինել, երբ ցանկանում եք կախվածությունները հասցնել նվազագույնի։
Եզրակացություններ
Այս բլոգ գրառման և դրան կից օրինակների շնորհիվ տարբեր ֆրեյմվորքների առանձնահատուկ թակարդներն ու թույլ կողմերը հեշտ է հասկանալ։ Ոմանք հասուն են (ինչպես Pytorch-ը), ոմանք կրում են նախորդ լուծումներից ժառանգված տեխնիկական պարտք (ինչպես Tensorflow-ը), իսկ ոմանք դեռ պետք է ապացուցեն իրենց զգալի ներուժը, մինչ նրանց համայնքը օրըստօրե աճում է, օր.՝ JAX + Flax։