Գեներատիվ LLM-ների խելամիտ բիզնես կիրառում
Այս հոդվածը ձեզ ավելի հստակ պատկերացում կտա, թե ինչ կարող են իրատեսորեն անել գեներատիվ մեծ լեզվական մոդելները և ինչ ռիսկեր են դրանց հետ կապված։
Քանի որ AI-ի վրա հիմնված գեներատիվ գործիքները, ինչպիսիք են այժմ արդեն հայտնի ChatGPT-ն, Midjourney-ն և այլն, այնքան հեշտ են օգտագործման մեջ, AI-ի նկատմամբ հետաքրքրությունն ու դրա ժողովրդականությունը աճել են երկրաչափական պրոգրեսիայով։ Սովորական մարդիկ արհեստական բանականության մասին խոսում են գնումներ անելիս, տաքսիով գնալիս կամ փողոցով քայլելիս, մինչդեռ տեսլականներ ունեցողները նկարագրում են, թե ինչպես է արհեստական բանականությունը փոխելու աշխարհը և բիզնեսների աշխատելու ձևը։ FOMO-ով համակված ընկերություններն ձգտում են հնարավորինս շուտ ներդնել գեներատիվ AI, որպեսզի նոր հաճախորդների համար մրցակցության մեջ չհետ մնան։
Ես հավատում եմ, որ մենք շարժվում ենք դեպի արտադրողականությունը բարձրացնող AI-օգնական գործիքների լայն կիրառում։ Այդուհանդերձ, պետք է հիշել, որ արհեստական բանականությունը կախարդական փայտիկ չէ, որը կարող է լուծել մեր ունեցած բոլոր խնդիրները։ Իրատեսական սպասումներ ձևավորելու համար պետք է հասկանալ, թե ինչ կարող են և ինչ չեն կարող անել այսօրվա գեներատիվ AI համակարգերը։
Կարդացեք, որպեսզի իմանաք, թե որ խնդիրները գեներատիվ մեծ լեզվական մոդելները լավ են լուծում, որոնցում են դժվարանում և ինչպես դրանք կարող են կիրառվել AI-ով աշխատող արտադրանքներում։ Այս հոդվածում ես կենտրոնանում եմ գեներատիվ նեյրոնային ցանցային մոդելների, և ավելի ճշգրիտ՝ ChatGPT-ի նման գեներատիվ լեզվական մոդելների վրա։
Գեներատիվ LLM-ների հնարավորությունները
Գեներատիվ մեծ լեզվական մոդելները խորը ուսուցման մոդելներ են, որոնք վերապատրաստման ընթացքում բախվել են ինտերնետի մեծ մասի, անթիվ գրքերի, գիտական հոդվածների և այլնի հետ։ Այդ նյութից նրանք սովորել են հասկանալ լեզուն, եզրակացություններ անել և վերարտադրել այդ տեքստերում հանդիպող օրինաչափությունները։ Այս փուլում խորը ուսուցման մոդելը անգիր է անում որոշակի օրինաչափություններ և հատվածներ, որոնք հետո հեշտությամբ վերադարձնում է օգտատիրոջը՝ հարցերին պատասխանելիս և հրամաններ կատարելիս։ Այս փուլում ձեռք բերածի շնորհիվ գեներատիվ մեծ լեզվական մոդելները կարող են պատասխանել այն թեմաների լայն սպեկտրի վերաբերյալ հարցերին, որոնց հանդիպել են ուսուցման ժամանակ։ Հենց այստեղ են հիմնարար (foundation) մոդելները ձեռք բերում գիտելիք աշխարհի մասին և սովորում փաստեր, բայց նաև ընդունում են կողմնապահություններ։ Քանի որ ուսուցման տվյալները աղտոտված են թունավոր արտահայտություններով և ռասայի, սեռի և այլնի վերաբերյալ նախապաշարմունք պարունակող ինտերնետային տեքստերով, մոդելը նույն վարքը կվերարտադրի իր ստեղծած պատասխաններում։ Դա, անշուշտ, այն բովանդակությունը չէ, որին կուզենայինք, որ մեր արտադրանքի օգտատերերը հանդիպեն։
Երբ հրահանգներին հետևելու խնդրի վրա վերապատրաստվում են, այս մոդելները կարող են մեկնաբանել օգտատիրոջ տված հրամանը և ստեղծել այն տեքստը, որը, մոդելի գնահատմամբ, լավագույնս համապատասխանում է դրան։ Այս փուլը կարող ենք պատկերացնել որպես այնպիսին, որտեղ հիմնարար մոդելները սովորում են դատողություն անել հրամանների շուրջ և հասկանալ դրանք, որոնք հետո փորձում են կատարել։
Լավը, վատը և տգեղը
Մեր ML ինժեներներից մեկը մանրամասն վերլուծել է, թե որ խնդիրները գեներատիվ մեծ լեզվական մոդելները կատարում են փայլուն, և որոնց դեմ լիովին տապալվում են։
Կարճ ասած՝ նրա եզրակացությունն այն է, որ ChatGPT-ի նման գեներատիվ մոդելները գերազանցում են «ջուր» (fluff) ստեղծելու մեջ, այսինքն՝ գեղեցիկ գրված տեքստ, որը միշտ չէ, որ շատ տեղեկատվություն է փոխանցում։ Սա ուղղակիորեն բխում է մոդելների ուսուցման եղանակից և նրանց բնորոշ հատկանիշ է։ Նրանց թույլ կողմերն են՝ ավելի բարդ հրամանները պատշաճ ընկալելը, աշխարհի մասին դատողությունը, երբ համատեքստային տեղեկատվություն չի տրվում, որոշակի թեմայի վերաբերյալ ստուգված տեղեկատվություն տրամադրելը, և խորամանկորեն կառուցված օգտատիրոջ հարցման պատասխանում վնասակար բովանդակություն ստեղծելու ռիսկը։
Հղկված, ընթեռնելի տեքստ ստեղծելու կարողությունը այս մոդելների մեծ ուժն է, սակայն գեներատիվ մոդելների հալյուցինացիաները լրջորեն սահմանափակում են դրանց օգտակարությունը բիզնես լուծումներում։ Ոչ ոք չի ուզում համակարգ, որը կարող է թունավոր և անվստահելի պատասխաններ տալ, քանի որ դրանք գալիս են մոդելի կշիռներում կոդավորված գիտելիքից, այլ ոչ թե վստահելի աղբյուրներից։ Նման մոդելների հետ աշխատելը նշանակում է տեղեկատվության ստուգում հուսալի գիտելիքի աղբյուրների դեմ՝ կա՛մ մոդելի պատասխաններին վստահելու, կա՛մ նրա սուտը բռնելու համար։ Եթե միայն կարողանայինք օգտվել այն բանից, ինչ գեներատիվ մեծ լեզվական մոդելներն ամենալավն են անում, այն է՝ ընթեռնելի տեքստեր գրելը, և միաժամանակ լուծեինք հալյուցինացիաների խնդիրը…
Որոնմամբ ընդլայնված հարց ու պատասխան
Սպիտակ ձիով ներս է մտնում գիտելիքների բազայի վրա հիմնված մոտեցումը՝ որոնմամբ ընդլայնված հարց ու պատասխանը (retrieval-augmented question answering)։
Հալյուցինացիաների դեմ պայքարի եղանակներից մեկն է գիտելիքների բազան որպես համատեքստ տրամադրելը, որպեսզի լեզվական մոդելը հրամանը կատարելիս հենվի բացառապես դրա վրա։ Սա թույլ է տալիս շրջանցել այն խառնաշփոթ գիտելիքը, որը մոդելը կլանել է ուսուցման ժամանակ։ Փոխարենը մենք օգտագործում ենք հաստատված փաստաթղթերի տվյալների բազա՝ զուգակցված AI մոդելի՝ «ջուր» ստեղծելու հմտության հետ։
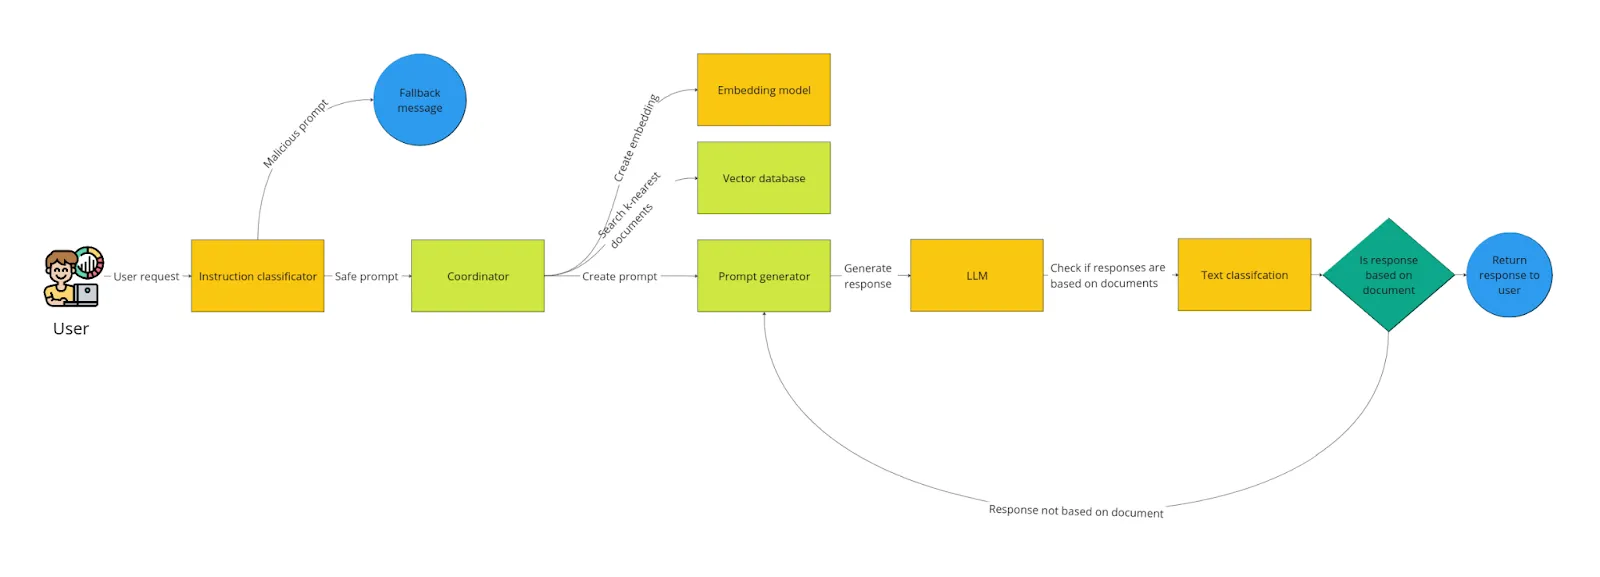
Գիտելիքների բազա և հարցումների դասակարգիչ ունեցող հարց ու պատասխան համակարգի ճարտարապետություն։
Առաջարկվող լուծումը կառուցված է գիտելիքների բազայի, հարցումների դասակարգիչի և պատասխանի շուրջ։
Գիտելիքների բազան բաժանվում է ավելի փոքր հատվածների։ Երբ օգտատերը հարցում է ուղարկում, համակարգը գիտելիքների բազայից առբերում է փաստաթղթերի հատվածների մի շարք, որոնք ամենամոտն են այդ հարցմանը։ Այս քայլը հենվում է տեքստային embedding-ների և վեկտորային նմանության վրա՝ իմաստային առումով առնչվող փաստաթղթերը գտնելու համար։ Այստեղ մենք օգտագործում ենք վեկտորային գիտելիքների բազաներ՝ առբերման բարձր որակի և ավելի արագ հաշվարկի հասնելու համար։ Այնուհետև փաստաթղթերը և հաճախորդի հարցումը զետեղվում են հատուկ կառուցված prompt-ի մեջ, որտեղ գիտելիքների բազայի փաստաթղթերը ծառայում են որպես համատեքստ, որը գեներատիվ մեծ լեզվական մոդելն օգտագործում է հաճախորդի հրամանը կատարելու համար։
Ավելին, ստեղծված յուրաքանչյուր նախադասության համար կարող ենք նշել այն աղբյուրը, որի վրա հիմնվել է պատասխանը։ Դրա համար կարող ենք կառուցել ավելի պարզ տեքստային դասակարգիչ նեյրոնային ցանցային մոդել, որը համեմատում է մոդելի պատասխանի ստեղծված նախադասությունը գիտելիքների բազայի ընտրված հատվածների հետ։ Եթե տեղեկատվության աղբյուր գտնել չի հաջողվում, կարող ենք դա դիտարկել որպես մոդելի հալյուցինացիա։ Այնուհետև կարող ենք հալյուցինացիան հեռացնել պատասխանից կամ մեծ լեզվական մոդելին հարցում ուղարկել, որտեղ ասվում է, որ այն սխալ է թույլ տվել և պետք է ուղղի իր պատասխանը1։ Նման ավելի պարզ և ճշգրիտ հրահանգի դեպքում մոդելը շատ ավելի հավանական է, որ կհասկանա հրամանը և կուղղի պատասխանը։
Մեկ այլ բաղադրիչ՝ լրացուցիչ, բայց անհրաժեշտ, կլինեն օգտատերերի չարամիտ հարցումները չեզոքացնող մեխանիզմները։ Այս տեսակի հրահանգները կարող են համակարգին ստիպել անպատշաճ, սպառնացող կամ վիրավորական պատասխան տալ։ Մենք ուզում ենք կանխել դա և՛ օգտատերերի անվտանգությունն ապահովելու, և՛ ընկերության հեղինակությունը պաշտպանելու համար։ Դրան հասնելու համար տեքստային դասակարգիչ նեյրոնային ցանցը կարող է որոշել՝ արդյոք օգտատիրոջ հարցումը չարամիտ է։
Եթե այո, օգտատերը կստանա հաղորդագրություն, որ հարցումը չի բավարարում համակարգի պահանջները։ Եթե ոչ, հարցումը կփոխանցվի համակարգին՝ մշակման և պատասխանի համար։
Օգտատերերի չարամիտ հրամանների և թունավոր պատասխանների հետ գործ ունենալու այլ մոտեցումներ նույնպես կան։ Մեծ լեզվական մոդելների ժողովրդականության ալիքի վրա NVIDIA-ն թողարկել է չարամիտ prompt-երը չեզոքացնելու բաց կոդով գրադարան՝ NeMo-Guardrails, որը կարելի է կիրառել այս խնդրի համար։
Վերը նկարագրված մեթոդով կառուցված արտադրանքը կպահանջի ամբողջ համակարգի մոնիթորինգ, որը կազմված է բազմաթիվ մասերից՝ մեծ լեզվական մոդելից, տեքստային դասակարգիչից և պատրաստված prompt-երից։ Կարևոր կլինի ստուգել, թե պատասխանները որքանով են հիմնավորված գիտելիքների բազայի փաստաթղթերով2, որքան կողմնապահություն և թունավորություն են պարունակում, և որքան զգայուն է համակարգը հատուկ կազմված հարցումների նկատմամբ, որոնք թունավոր մոդելային պատասխաններ են հրահրում3։ Տեքստային դասակարգիչի դեպքում կարևորն այն է հետևել, թե որքան լավ է այն հայտնաբերում հալյուցինացիաները ստեղծված պատասխաններում, իսկ պատրաստված prompt-երի դեպքում հետևվող մետրիկան այն է, թե որքան ճշգրիտ է համակարգը կատարել օգտատիրոջ հրահանգները։ Այս բոլոր պարամետրերը պահանջում են անընդհատ մոնիթորինգ, և երբ խնդիրներ են առաջանում, համակարգը պետք է վերանորոգվի։
Մոդելի դեգրադացիան ժամանակի ընթացքում
Ձեռնարկության մակարդակի լուծումների հաճախորդները ակնկալում են կանխատեսելի և կայուն աշխատանք։ Ինչպես հոդվածի4 հեղինակները ցույց տվեցին, միայն համակարգի յուրաքանչյուր բաղադրիչի նկատմամբ լիարժեք վերահսկողությունը կարող է երաշխավորել նման հատկություններ. նրանք ցույց տվեցին, թե ինչպես է GPT4 մոդելը վատացել 2023 թվականի մարտի և հունիսի միջև։
Հոդվածի համաձայն՝ API-ի պատի հետևում թաքնված մոդելները, որոնք կարող ենք օգտագործել NLG-ի վրա հիմնված համակարգեր կառուցելու համար, ենթարկվում են փոփոխությունների, որոնք մենք չենք կարող վերահսկել և որոնց մասին նույնիսկ չենք տեղեկացվում։ Արդյունքում մեր կառուցած լուծումը կարող է զգալիորեն վատանալ, առանց մեզ համար արձագանքելու հնարավորության։ Սեփական մեծ լեզվական մոդելի համանման իրավիճակում մենք միշտ կարող ենք պահուստավորել ընթացիկ մոդելը, փոփոխություններ մտցնել և, եթե ինչ-որ բան կոտրվի կամ վատանա, վերադառնալ նախորդ, պատշաճ աշխատող տարբերակին։ Արտաքին API-ների դեպքում դա կարող է հնարավոր չլինել։ Այդ դեպքում լուծման մատակարարը ստիպված կլինի գտնել մեծ լեզվական մոդելի այլ մատակարար կամ շտապ կերպով ստեղծել սեփական մոդել, որի որակը համապատասխանի սկզբնական լուծմանը։ Իմ կարծիքով՝ ավելի խելամիտ է այս ռիսկից նախապես պաշտպանվել և ձեր օգտատերերին խնդիրներից հեռու պահել։ Ինչ ճանապարհ էլ ընտրեք, ձեզ անհրաժեշտ կլինեն մոդելի որակը ժամանակի ընթացքում հետևելու գործիքներ։
Բիզնես կիրառություն
Ձեռնարկության մակարդակի հաճախորդները հույս են դնում կանխատեսելի և կայուն աշխատանքի վրա։ Հոդվածի [^5] հեղինակները, որոնք ցույց տվեցին, թե ինչպես է GPT4 մոդելը վատացել 2023 թվականի մարտի և հունիսի միջև, ապացուցեցին, որ միայն համակարգի բոլոր բաղադրիչների նկատմամբ լիարժեք վերահսկողությունը կարող է ապահովել այդ հատկությունները։
Հոդվածը բացահայտում է, որ API-ի պատի հետևում գտնվող մոդելները, որոնք կարող են հիմք ծառայել NLG-ի վրա հիմնված համակարգերի համար, փոխվում են այնպես, որ մենք չենք կարող վերահսկել և նույնիսկ առանց մեզ տեղեկացնելու։ Սա կարող է լրջորեն վատացնել մեր կառուցած լուծումը՝ թողնելով մեզ առանց արձագանքելու հնարավորության։ Սեփական մեծ լեզվական մոդել ունենալու համանման դեպքում մենք միշտ կարող ենք պահել ընթացիկ մոդելի կրկնօրինակ, փոփոխություններ կիրառել և, եթե ինչ-որ բան ձախողվի կամ վատանա, վերադառնալ ավելի վաղ, պատշաճ աշխատող տարբերակին։ Արտաքին API-ները կարող են դա թույլ չտալ։ Այդ դեպքում լուծման մատակարարը ստիպված կլինի կա՛մ փնտրել մեծ լեզվական մոդելի մեկ այլ մատակարար, կա՛մ խելահեղորեն ստեղծել սեփական մոդել, որը որակով համընկնում է սկզբնական լուծմանը։ Իմ կարծիքով՝ ավելի լավ է այս ռիսկից նախապես ապահովագրվել և ձեր օգտատերերին հեռու պահել խնդիրներից։ Ինչ ճանապարհ էլ ընտրեք, մոդելի որակը ժամանակի ընթացքում մոնիթորինգի ենթարկելու գործիքներ կպահանջվեն։
Եկեք հիմա դիտարկենք, թե որ բիզնես կիրառությունները կարող են օգուտ քաղել նման լուծումից։ Որոնմամբ ընդլայնված հարց ու պատասխանի վրա կառուցված արտադրանքը լավ է աշխատում որպես ընթացիկ համակարգերի ընդլայնում, որոնք հենվում են հիմնաբառերով որոնման և վեկտորային իմաստային նմանության մեթոդների վրա։ Դասական որոնողական համակարգերից տարբերվելով՝ այստեղ օգտատիրոջ հրահանգները կարող են խնդրել համակարգին կատարել գործողություն, վերլուծություն կամ ագրեգացիա։ Այն կարող է ունենալ չատբոտի տեսք՝ թույլ տալով փոխազդեցություն սեսիայի շրջանակում, հրամանների ճշգրտում և ցանկալի արդյունքի ավելի մանրամասն նշում։
Նման համակարգերի օգտատերերի համար փոխվում է միայն հարցումների և ստացվող որոնման արդյունքների ձևաչափը, որը կլինի բնական լեզվով։ Դրանից բացի՝ օգտատերերը կիմանան, թե կոնկրետ որ փաստաթղթերից կամ փաստաթղթերի հատվածներից է ստեղծվել պատասխանը։ Ավելի մանրամասն հրամաններով կարող ենք սպասել, որ որոնումները ավելի լավ կաշխատեն և, հետևաբար, համակարգի օգտատերերը ավելի արդյունավետ կդառնան։
Պատկերացրեք համակարգ, որը վերլուծում է հրապարակայնորեն առևտրվող ընկերությունների ֆինանսական հաշվետվությունները։ Հիմնաբառերի կամ փաստաթղթերի և հարցումների միջև իմաստային նմանության վրա հենվող սովորական համակարգերը կարող են միայն վերադարձնել համապատասխան փաստաթղթային հատվածները։ Իսկ գեներատիվ մեծ լեզվական մոդելով աշխատող չատբոտ համակարգը, ընդհակառակը, կարող է, օրինակ, համեմատել ֆինանսական արդյունքները մի քանի տարիների կտրվածքով։ Եթե օգտատերը գոհ չէ պատասխանի ձևաչափից, նա կարող է խնդրել համեմատական աղյուսակ՝ կարճ տեքստային նկարագրությամբ։ Նման համակարգը կգործի որպես մի տեսակ օգնական, որը կարող է կատարել պարզ խնդիրներ։ Նրա վերլուծական կարողությունները լիովին կախված են մեծ լեզվական մոդելից, ուստի դրանք կարելի է հարմարեցնել կոնկրետ բիզնեսին և կիրառությանը։
Ամփոփում
Հուսով եմ, որ այս հոդվածը ձեզ ավելի հստակ պատկերացում է տվել, թե ինչ կարող են իրատեսորեն անել գեներատիվ մեծ լեզվական մոդելները և ինչ ռիսկեր են դրանք բերում։ Հաշվի առնելով դրանց թերությունները՝ նրանց անհրաժեշտ են բազմաթիվ անվտանգության ցանցեր՝ վնասակար վարքը, ինչպիսին հալյուցինացիաներն են կամ թունավոր պատասխանները, հայտնաբերելու և չեզոքացնելու համար։ Այդուհանդերձ, հրամաններ կատարելու և լավ գրված պատասխաններ ստեղծելու նրանց կարողությունը հնարավորություն է տալիս դրանք օգտագործել և բարձրացնել նման համակարգերն օգտագործող մարդկանց արտադրողականությունը՝ տալով նրանց թվային օգնական, որը, ինչպես «Շեղբի վրայով վազող» ֆիլմի համակարգիչը, ստանձնում է ձանձրալի խնդիրները և գործն ավելի արագ է ավարտում։
- Xiang Yue, Boshi Wang, Kai Zhang, Ziru Chen, Yu Su, & Huan Sun. (2023). Մեծ լեզվական մոդելներով վերագրման ավտոմատ գնահատում (Automatic Evaluation of Attribution by Large Language Models)։ ↩
- Nelson F. Liu, Tianyi Zhang, & Percy Liang. (2023). Evaluating Verifiability in Generative Search Engines. ↩
- https://haystack.deepset.ai/blog/how-to-prevent-prompt-injections ↩
- https://arxiv.org/abs/2307.09009 ↩