تطبيق تجاري معقول لنماذج اللغة التوليدية الكبيرة
ستمنحك هذه المقالة صورة أوضح عما تستطيع نماذج اللغة التوليدية الكبيرة فعله واقعيًا وما المخاطر التي ترافقها.
لأن أدوات الذكاء الاصطناعي التوليدية مثل ChatGPT وMidjourney المعروفتين اليوم سهلة الاستخدام، فقد ازداد الاهتمام بالذكاء الاصطناعي وشعبيته بشكل هائل. يتحدث الناس العاديون عن الذكاء الاصطناعي أثناء التسوق وفي سيارات الأجرة وأثناء المشي في الشارع، بينما يرسم أصحاب الرؤى كيف سيغيّر الذكاء الاصطناعي العالم وطريقة عمل الشركات. وتتحمس الشركات التي يسيطر عليها الخوف من تفويت الفرصة (FOMO) لتبني الذكاء الاصطناعي التوليدي في أسرع وقت، كي لا تتخلف في المنافسة على العملاء الجدد.
أعتقد أننا نتجه نحو تبنٍّ واسع لأدوات مدعومة بالذكاء الاصطناعي ترفع الإنتاجية. ومع ذلك علينا أن نتذكر أن الذكاء الاصطناعي ليس عصا سحرية قادرة على حل كل مشكلاتنا. ولوضع توقعات واقعية، علينا أن نفهم ما تستطيع أنظمة الذكاء الاصطناعي التوليدي الحالية فعله وما لا تستطيع.
تابع القراءة لتعرف المهام التي تتعامل معها نماذج اللغة التوليدية الكبيرة جيدًا، وتلك التي تتعثر فيها، وكيف يمكن تطبيقها في المنتجات المعتمدة على الذكاء الاصطناعي. أركّز في هذه المقالة على نماذج الشبكات العصبية التوليدية، وبالتحديد على نماذج اللغة التوليدية الشبيهة بـ ChatGPT.
قدرات نماذج اللغة التوليدية الكبيرة
نماذج اللغة التوليدية الكبيرة هي نماذج تعلّم عميق تعرضت أثناء تدريبها لجزء كبير من الإنترنت وعدد لا يُحصى من الكتب والأوراق العلمية وغيرها. ومن هذه المواد تعلمت فهم اللغة والاستدلال وإعادة إنتاج الأنماط الموجودة في تلك النصوص. في هذه المرحلة يحفظ نموذج التعلم العميق أنماطًا ومقاطع بعينها، يعيدها بسهولة إلى المستخدم عند الإجابة عن الأسئلة وتنفيذ الأوامر. وبفضل ما تمتصه في هذه المرحلة، تستطيع نماذج اللغة التوليدية الكبيرة الرد على الأسئلة في طيف واسع من المواضيع التي صادفتها أثناء التدريب. وهنا تكتسب النماذج التأسيسية معرفة بالعالم وتتعلم الحقائق، لكنها تلتقط أيضًا التحيزات. ولأن بيانات التدريب مشوبة بعبارات مسيئة ونصوص إنترنت تحمل أحكامًا مسبقة بشأن العرق والجنس وغيرهما، فإن النموذج سيعيد إنتاج السلوك نفسه في الردود التي يولّدها. وهذا بالتأكيد ليس نوع المحتوى الذي نريد أن يصادفه مستخدمو منتجنا.
بعد تدريبها على مهمة اتباع التعليمات، تستطيع هذه النماذج تفسير الأمر الذي يقدمه المستخدم وإنتاج النص الذي يراه النموذج الأنسب له. يمكننا اعتبار هذه المرحلة تلك التي تتعلم فيها النماذج التأسيسية التفكير في الأوامر وفهمها، ثم تحاول تنفيذها.
الجيد والسيئ والقبيح
حلّل أحد مهندسي تعلّم الآلة لدينا بالتفصيل المهام التي تؤديها نماذج اللغة التوليدية الكبيرة ببراعة، وتلك التي تفشل فيها تمامًا.
باختصار، استنتاجه أن النماذج التوليدية مثل ChatGPT تتفوق في إنتاج الحشو، أي نص مكتوب بشكل جميل لا ينقل دائمًا كثيرًا من المعلومات. وهذا ينبع مباشرة من طريقة تدريب النماذج وهو سمة أصيلة فيها. أما نقاط ضعفها فهي: الفهم الصحيح للأوامر الأكثر تعقيدًا، والاستدلال حول العالم حين لا تُقدَّم معلومات سياقية، وتقديم معلومات موثقة عن موضوع معين، وخطر إنتاج محتوى ضار استجابةً لطلب مستخدم مصاغ بذكاء.
القدرة على إنتاج نص متقن مقروء ميزة كبرى لهذه النماذج، لكن هلوسات النماذج التوليدية تقيّد جدواها في الحلول التجارية تقييدًا شديدًا. لا أحد يريد نظامًا قد يعطي إجابات مسيئة وغير موثوقة، لأنها تأتي من معرفة مشفرة في أوزان النموذج لا من مصادر جديرة بالثقة. والعمل مع هذه النماذج يعني التحقق من المعلومات مقابل مصادر معرفة موثوقة، إما لنثق بإجابات النموذج أو لنكشف أكاذيبه. ليتنا نستطيع الاستفادة مما تجيده نماذج اللغة التوليدية الكبيرة، أي كتابة نصوص مقروءة، وفي الوقت نفسه حل مشكلة الهلوسة…
الإجابة عن الأسئلة المعززة بالاسترجاع
وهنا يدخل، على حصان أبيض، نهج مبني على قاعدة معرفة: الإجابة عن الأسئلة المعززة بالاسترجاع (retrieval-augmented question answering).
إحدى طرق معالجة الهلوسة هي تقديم قاعدة المعرفة كسياق، بحيث يعتمد نموذج اللغة عليها وحدها عند تنفيذ الأمر. وهذا يتيح لنا تجاوز المعرفة الفوضوية التي امتصها النموذج في التدريب. وما نستخدمه بدلًا من ذلك هو قاعدة بيانات من المستندات المعتمدة مقترنة بموهبة نموذج الذكاء الاصطناعي في توليد الحشو.
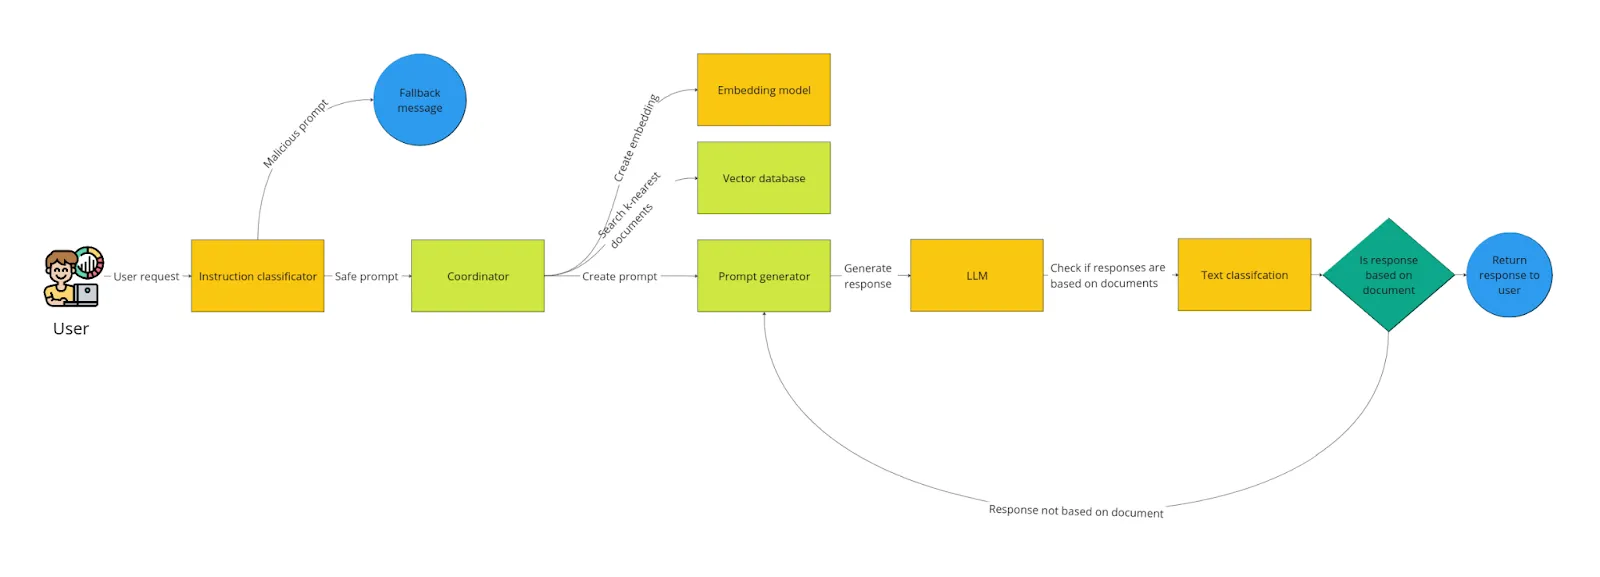
بنية نظام أسئلة وأجوبة يضم قاعدة معرفة ومصنِّف طلبات.
يُبنى الحل المقترح حول قاعدة معرفة ومصنِّف طلبات ورد.
تُقسَّم قاعدة المعرفة إلى أجزاء أصغر. وكلما أرسل مستخدم طلبًا، يسترجع النظام من قاعدة المعرفة مجموعة من أجزاء المستندات الأقرب إلى ذلك الطلب. وتعتمد هذه الخطوة على تضمينات النصوص وتشابه المتجهات لتحديد المستندات المرتبطة دلاليًا. نستخدم هنا قواعد معرفة قائمة على المتجهات لتحقيق جودة استرجاع عالية وحساب أسرع. بعد ذلك تُدرج المستندات وطلب العميل في موجّه (prompt) مصمم لهذا الغرض، حيث تعمل مستندات قاعدة المعرفة كسياق يستخدمه نموذج اللغة التوليدي الكبير لتنفيذ أمر العميل.
علاوة على ذلك، يمكننا أن نشير لكل جملة مولَّدة إلى المصدر الذي بُني عليه الرد. ولفعل ذلك يمكننا بناء نموذج شبكة عصبية بسيط لتصنيف النصوص يطابق الجملة المولَّدة من إجابة النموذج مع مقاطع مختارة من قاعدة المعرفة. وإن لم يوجد مصدر للمعلومة، يمكننا اعتبارها هلوسة من النموذج. عندئذ يمكننا إزالة الهلوسة من الرد أو إرسال طلب إلى نموذج اللغة الكبير يفيد بأنه أخطأ وعليه تصحيح إجابته1. ومع تعليمات أبسط وأدق كهذه، يكون النموذج أكثر ترجيحًا لفهم الأمر وتصحيح الرد.
مكوّن آخر، إضافي لكنه ضروري، هو آليات تبطل طلبات المستخدمين الخبيثة. فمثل هذه التعليمات قد تجعل النظام يرد بطريقة غير لائقة أو تهديدية أو مسيئة. نريد منع ذلك حفاظًا على سلامة المستخدمين وسمعة الشركة معًا. ولتحقيق ذلك يمكن لشبكة عصبية لتصنيف النصوص أن تقرر ما إذا كان طلب المستخدم خبيثًا.
إن كان كذلك، يتلقى المستخدم رسالة تفيد بأن الطلب لا يستوفي متطلبات النظام. وإن لم يكن، يُمرَّر الطلب إلى النظام لمعالجته والرد عليه.
توجد مقاربات أخرى للتعامل مع أوامر المستخدمين الخبيثة والردود المسيئة. وركوبًا لموجة شعبية نماذج اللغة الكبيرة، أصدرت NVIDIA مكتبة مفتوحة المصدر لإبطال الموجّهات الخبيثة هي NeMo-Guardrails، ويمكن استخدامها لهذه المهمة.
سيتطلب أي منتج مبني على الطريقة الموصوفة أعلاه مراقبة النظام بأكمله، المؤلف من أجزاء عديدة: نموذج لغة كبير ومصنِّف نصوص وموجّهات معدّة مسبقًا. وسيكون من المهم فحص مدى استناد الردود إلى مستندات من قاعدة المعرفة2، ومقدار ما تحويه من تحيز وإساءة، ومدى قابلية النظام للتأثر بالاستعلامات الملغومة التي تستفز النموذج لإنتاج ردود مسيئة3. وبالنسبة لمصنِّف النصوص، فالمهم تتبع مدى جودة كشفه للهلوسات في الردود المولَّدة، أما بالنسبة للموجّهات المعدّة مسبقًا فالمقياس الواجب مراقبته هو مدى دقة تنفيذ النظام لتعليمات المستخدم. تحتاج كل هذه المعاملات إلى مراقبة مستمرة، ومتى ظهرت مشكلات ينبغي إصلاح النظام.
تدهور النموذج مع مرور الوقت
يتوقع عملاء الحلول من فئة المؤسسات أن يكون التشغيل متوقعًا ومستقرًا. وكما أثبت مؤلفو المقالة4، فإن السيطرة الكاملة على كل مكوّن في النظام وحدها تضمن مثل هذه الصفات؛ فقد بيّنوا كيف تدهور نموذج GPT4 بين مارس ويونيو 2023.
وفقًا للمقالة، فإن النماذج المحجوبة خلف جدار واجهة برمجية (API)، والتي قد نستخدمها لبناء أنظمة قائمة على توليد اللغة الطبيعية (NLG)، تخضع لتغييرات لا نستطيع التحكم بها ولا نُخطَر بها حتى. ونتيجة لذلك قد يتدهور الحل الذي نبنيه تدهورًا كبيرًا دون أن نملك وسيلة للرد. أما في حالة مشابهة مع نموذج لغة كبير خاص بنا، فيمكننا دائمًا نسخ النموذج الحالي احتياطيًا، وإدخال التغييرات، والرجوع إلى النسخة السابقة التي كانت تعمل جيدًا إذا تعطل شيء أو تدهور. ومع الواجهات الخارجية قد لا يكون هذا خيارًا. وسيتعين على مزود الحل حينئذ البحث عن مزود نموذج لغة كبير آخر أو الإسراع المحموم إلى بناء نموذجه الخاص بجودة تضاهي الحل الأصلي. في رأيي، من الأحكم الاحتماء من هذا الخطر مسبقًا وتجنيب المستخدمين المتاعب. وأيًّا كان الطريق الذي تسلكه، ستحتاج إلى أدوات لتتبع جودة النموذج مع الوقت.
حالة استخدام تجارية
يعتمد عملاء فئة المؤسسات على تشغيل متوقع ومستقر. وقد أثبت مؤلفو المقالة [^5]، الذين بيّنوا كيف تدهور نموذج GPT4 بين مارس ويونيو 2023، أن السيطرة الكاملة على جميع مكونات النظام وحدها قادرة على توفير هذه الصفات.
تكشف المقالة أن النماذج خلف جدار واجهة برمجية، التي يمكن أن تكون أساسًا لأنظمة قائمة على NLG، تتغير بطرق لا نستطيع التحكم بها ودون أن نُبلَّغ بها حتى. وقد يؤدي ذلك إلى تدهور الحل الذي نبنيه تدهورًا خطيرًا، فلا نستطيع الرد. وفي الحالة المماثلة التي نملك فيها نموذج لغة كبيرًا خاصًا بنا، يمكننا دائمًا الاحتفاظ بنسخة احتياطية من النموذج الحالي وتطبيق التغييرات، ومتى فشل شيء أو تدهور نعود إلى النسخة السابقة التي تعمل جيدًا. وقد لا تسمح الواجهات الخارجية بذلك. وسيضطر مزود الحل حينئذ إما إلى البحث عن مزود نموذج لغة كبير آخر أو إلى بناء نموذجه الخاص على عجل بحيث يطابق الحل الأصلي في الجودة. في رأيي، الأفضل تأمين نفسك ضد هذا الخطر مسبقًا وإبعاد مستخدميك عن المشكلات. وأيًّا كان الطريق الذي تختاره، ستكون هناك حاجة إلى أدوات لمراقبة جودة النموذج مع مرور الوقت.
لننظر الآن في حالات الاستخدام التجارية التي يمكن أن تستفيد من مثل هذا الحل. المنتج المبني على الإجابة عن الأسئلة المعززة بالاسترجاع يعمل جيدًا كامتداد للأنظمة الحالية التي تعتمد على البحث بالكلمات المفتاحية وطرق التشابه الدلالي بالمتجهات. وعلى خلاف أنظمة البحث الكلاسيكية، يمكن هنا لتعليمات المستخدم أن تطلب من النظام تنفيذ عملية أو تحليل أو تجميع. ويمكن أن يكون ذلك على شكل روبوت محادثة، يتيح التفاعل ضمن جلسة وتحسين الأوامر وتحديد النتيجة المرغوبة بمزيد من التفصيل.
بالنسبة لمستخدمي هذه الأنظمة، الشيء الوحيد الذي يتغير هو صيغة الاستعلامات ونتائج البحث التي يتلقونها، وستكون بلغة طبيعية. وفوق ذلك، سيعرف المستخدمون المستندات أو أجزاء المستندات التي وُلِّدت منها الإجابة. ومع أوامر أكثر تفصيلًا، يمكننا توقع أداء أفضل للبحث، وبالتالي زيادة إنتاجية مستخدمي النظام.
تخيّل نظامًا يحلل القوائم المالية للشركات المدرجة في البورصة. الأنظمة التقليدية التي تعتمد على الكلمات المفتاحية أو على التشابه الدلالي بين المستندات والاستعلامات لا تستطيع سوى إرجاع أقسام المستندات ذات الصلة. أما نظام روبوت المحادثة المدعوم بنموذج لغة توليدي كبير، فيستطيع مثلًا مقارنة النتائج المالية عبر عدة سنوات. وإذا لم يكن المستخدم راضيًا عن صيغة الإجابة، يمكنه طلب جدول مقارنة مع وصف نصي موجز. سيعمل مثل هذا النظام كنوع من المساعد القادر على التعامل مع المهام البسيطة. وتعتمد قدراته التحليلية كليًا على نموذج اللغة الكبير، ولذلك يمكن تكييفها مع عمل تجاري وتطبيق معينين.
الخلاصة
آمل أن تكون هذه المقالة قد أعطتك صورة أوضح عما تستطيع نماذج اللغة التوليدية الكبيرة فعله واقعيًا وما المخاطر التي تجلبها. ونظرًا لأوجه قصورها، فهي تحتاج إلى شبكات أمان كثيرة لكشف السلوكيات الضارة كالهلوسة أو الردود المسيئة وإبطالها. ومع ذلك فإن قدرتها على تنفيذ الأوامر وإنتاج ردود حسنة الصياغة تتيح تسخيرها ورفع إنتاجية الأشخاص الذين يستخدمون هذه الأنظمة، بمنحهم مساعدًا رقميًا يتولى المهام الشاقة وينجز العمل بشكل أسرع، تمامًا كحاسوب من فيلم Blade Runner.
-
Xiang Yue, Boshi Wang, Kai Zhang, Ziru Chen, Yu Su, & Huan Sun. (2023). Automatic Evaluation of Attribution by Large Language Models. ↩
-
Nelson F. Liu, Tianyi Zhang, & Percy Liang. (2023). Evaluating Verifiability in Generative Search Engines. ↩
-
المصدر (https://haystack.deepset.ai/blog/how-to-prevent-prompt-injections) ↩