Diffusion մոդելների ուղղորդումն առանց դասակարգչի
Իմացեք, թե ինչու է classifier-free guidance-ը օգտագործվում diffusion մոդելներում և ինչպես կիրառել այն։
Պատկերների գեներացիան կարող է լինել պայմանավորված չլինող կամ պայմանավորված դասերի embedding-ներով կամ ազատ տեքստով։ Պայմանավորված պատկերներ գեներացնելիս կարող ենք ուզել կարգավորել, թե որքան ուժեղ է կիրառվում պայմանը։ Diffusion մոդելներում guidance scale-ը նույն դերն է խաղում, ինչ temperature-ը Large Language մոդելներում. այն կարգավորում է ստեղծագործականության և կանխատեսելիության հավասարակշռությունը։ Ավելի բարձր guidance scale-ը մոդելին ստիպում է ավելի սերտ հետևել նկարագրությանը, իսկ ավելի ցածր scale-ը ստացված պատկերը դարձնում է ավելի պատահական։
Նկար 1. Stable diffusion մոդելի արդյունքները նույն prompt-ի համար տարբեր guidance scale-երի դեպքում։ Prompt՝ ”yellow dog chasing a cat in the rain”, գեներացված է huggingface.co-ով
Large Language մոդելներում temperature-ը հնարավորություն է տալիս հարթեցնել կամ սրել նմուշառվող token-ների հավանականային բաշխումը։ Stable diffusion-ը temperature նմուշառման համարժեք չունի։ Պարզ մոտեցումները, ինչպես մոդելի score վեկտորների մասշտաբավորումը կամ diffusion նմուշառման ժամանակ ավելացվող Գաուսյան աղմուկի քանակի նվազեցումը, լավ արդյունքներ չեն տալիս։ Այդ պատճառով առաջարկվել են տարբեր մեթոդներ diffusion մոդելից «ցածր temperature» նմուշներ ստանալու համար։ Առաջինը classifier guidance-ն էր, որը diffusion մոդելին կցում էր դասակարգման ցանց՝ ուղղորդելու, թե որքան ուժեղ է ելքային պատկերը համապատասխանում դասին։ Սակայն այդ մեթոդը չի ընդհանրանում չտեսնված դասերի վրա և ներմուծում է լրացուցիչ վարժեցման ծախս։ Ուստի առաջարկվեց ավելի լավ մոտեցում՝ classifier-free guidance։ Այն լրացուցիչ ցանց չի պահանջում և մոդելին չի սահմանափակում իր տեսած դասերով։
Նախապատմություն
Բարձր մակարդակում diffusion մոդելները պատկեր են գեներացնում աղմուկից։ Մոդելը աստիճանաբար հեռացնում է աղմուկը սկզբնական աղմկոտ պատկերից, մինչև հասնում է թիրախային բարձր որակի պատկերին։ Որքան փոքր են աղմկահանման ժամանակ արվող քայլերը (այսինքն՝ որքան շատ քայլեր), այնքան լավ է ստացված պատկերը։
Նմուշառումը ընթանում է T ժամանակից մինչև 0։ Այն սկսվում է Գաուսյան աղմուկ x_T-ից և ստեղծում է ավելի ու ավելի քիչ աղմկոտ նմուշներ x_T −1, x_T −2, … մինչև հասնում է վերջնական նմուշին՝ x_0, որտեղ t-ն ցույց է տալիս timestep-ը։ X_t-ն կարելի է դիտել որպես x0 ազդանշանի և որոշ աղմուկի խառնուրդ, ընդ որում ազդանշան-աղմուկ հարաբերակցությունը որոշվում է t timestep-ով։
Նկար 2. Diffusion գործընթացի պատկերում։ Յուրաքանչյուր քայլ նախորդ պատկերից հեռացնում է մի փոքր աղմուկ, մինչև հասնում է բարձր որակի պատկերի։ Աղբյուր՝ wikipedia: Diffusion_model
Diffusion մոդելը վարժեցնելու համար պետք է նմուշառել x0 պատկեր, t timestep և սկզբնական աղմուկ։ Դրանցից կարող ենք հաշվել աղմկոտ x_t նմուշը t timestep-ում։ Diffusion մոդելը սովորում է կանխատեսել աղմուկը երկու հարևան timestep-երի միջև։ θ(xt, t)-ն նշանակում է x_t նմուշին t timestep-ում ավելացված աղմուկը։ Կանխատեսված θ(xt, t) աղմուկը x_t-ից հանելով ստանում ենք x_t-1-ը։ Ցանցը վարժեցվում է միջին քառակուսային սխալի նպատակային ֆունկցիայով իրական և կանխատեսված աղմուկի միջև ||θ(xt, t) − θ||2։
Classifier-free guidance-ի վարժեցումը
Ինչպես բացատրված է վերևում, հիմնական diffusion մոդելը գեներացնում է պայմանավորված չլինող պատկերներ։ Այլ կերպ ասած՝ գեներացված պատկերը լիովին պատահական է, և մենք վերահսկողություն չունենք, թե ինչ է այն ցույց տալու։ Գեներացված պատկերը օգտատիրոջ մուտքով պայմանավորելու համար Alex Nichol և Prafulla Dhariwal 2021-ը առաջարկեցին timestep embedding e_t-ին ավելացնել v_i դասի embedding և այս embedding-ը տալ մոդելի բոլոր residual բլոկներին։ Այսօրվա diffusion մոդելներում այդ residual բլոկները attention շերտեր են, և մոդելը տեքստով պայմանավորվում է տեքստային embedding-ների միջոցով, այլ ոչ թե դասերի embedding-ների։
Նկար 3. Ինչպես են զարգացել diffusion մոդելները։ 1. Diffusion մոդել առանց դասի embedding-ի։ 2. Diffusion մոդել դասի embedding-ով։ 3. Classifier-guided diffusion մոդել։ 4. Classifier-free diffusion մոդել։
Պարզ դարձավ, որ դասով պայմանավորված diffusion մոդելները հավատարմության (fidelity) խնդիրներ ունեն. նրանց գեներացրած պատկերները այնքան էլ համահունչ չեն դասին։ Սահմանափակված diffusion մոդելները էլ ավելի բարելավելու համար Prafulla Dhariwal, Alex Nichol 2021-ը ներկայացրեցին classifier guidance-ը։ Նրանք diffusion մոդելի կողքին տեղադրեցին դասակարգման ցանց և աղմկահանման ընթացքում օգտագործեցին դասի գրադիենտը՝ մոդելը թիրախային դասի ուղղությամբ ուղղորդելու համար։ Թեև մեթոդը լավ աշխատեց և բազմազանությունը փոխանակեց հավատարմության հետ, այն ուներ թերություններ։ Ամենամեծն այն էր, որ մոդելը չէր կարող ընդհանրանալ վարժեցման ժամանակ բացակայող դասերի վրա։ Մեկ այլ խնդիր այն էր, որ դասակարգիչը պետք է վարժեցվեր աղմկոտ նմուշների վրա, ինչը բացառում էր նախապես վարժեցված ընդհանուր նշանակության դասակարգիչ միացնելը։
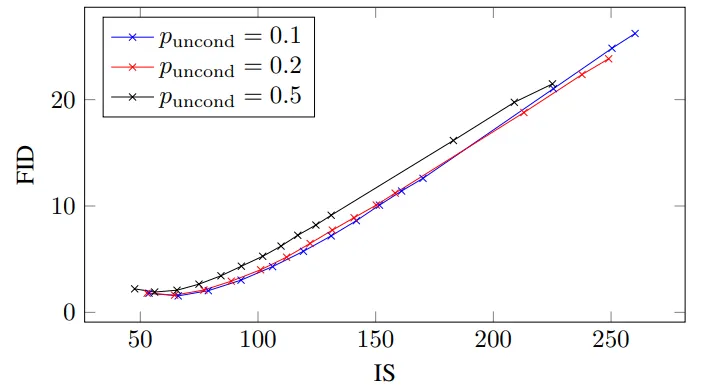
Նկար 4. Fréchet inception distance/Inception score՝ գծագրված guidance-ի ուժի համեմատ։ Յուրաքանչյուր կոր համապատասխանում է մոդելի՝ p_uncond անպայման վարժեցման հավանականությամբ, և յուրաքանչյուր կետ՝ տարբեր guidance scale-ի։ Ավելի ուժեղ guidance-ը հանգեցնում է ավելի բարձր FID/IS գնահատականի։ Ավելի ցածր FID գնահատականը ավելի լավ է, և ավելի բարձր IS գնահատականը ավելի լավ է։ Գծապատկերը պարզ է դարձնում, որ guidance-ի ուժը FID-ը փոխանակում է IS-ի հետ։ FID-ը տուգանում է բազմազանության բացակայությունը։ IS-ը, ընդհակառակը, չափում է, թե որքան լավ է մոդելը ընդգրկում ImageNet դասերի ամբողջ բաշխումը՝ միաժամանակ գեներացնելով առանձին նմուշներ մեկ դասի համար ցածր էնտրոպիայով։ Այս չափանիշի թուլությունն այն է, որ այն չի խրախուսում ամբողջ բաշխման ընդգրկումը կամ դասի ներսում բազմազանության գրավումը, ուստի ամբողջական տվյալների հավաքածուի փոքր մասը անգիր անող մոդելները դեռ բարձր IS են ստանում։ Աղբյուր՝ arxiv.org
Այս խնդիրները լուծելու համար Jonathan Ho և Tim Salimans-ը ներկայացրեցին classifier-free diffusion guidance-ը։ Նրանք ցույց են տալիս, որ պայմանավորված և անպայման diffusion մոդելը միասին վարժեցնելը և ստացված պայմանավորված ու անպայման score-երը համադրելը հնարավորություն է տալիս նմուշի որակը փոխանակել բազմազանության հետ։ Մասնավորապես, t timestep-ում θ(xt, t, c) աղմուկը վարժեցվում է և՛ դասի պայմանով, և՛ առանց դրա։ Անպայման մոդելում c դասի նույնացուցիչը փոխարինվում է null token ∅-ով (θ(xt, t, c = ∅))։ Պայմանավորված և անպայման երկու մոդելները կարելի է վարժեցնել միասին՝ պատահականորեն c-ն դնելով ∅։ Classifier-free guidance-ում inference պարամետր w-ն որոշում է, թե որքան ուժեղ է պայմանը՝
θ_overall(xt, t, c) = (1 + w)θ(zt, t, c) − wθ(xt, t)
Հավասարումը կարդալու եղանակներից մեկն այն է, որ պատկերի բազմազանությունը հանվում է տվյալ դասի բաշխումից, ինչը էլ ավելի է ամրապնդում այդ դասի բաշխումը։
Նկար 5. Ինչպես է guidance-ի ուժը ազդում երեք Գաուսյանների խառնուրդի վրա, որոնցից յուրաքանչյուրը ներկայացնում է տարբեր դաս։ Առանց guidance-ի դասերը որոշ չափով համընկնում են, ուստի մեկ դասից նմուշառելը կարող է տալ այլ դասերին պատկանող նմուշներ։ Guidance-ի ուժը մեծացնելը դասերն ավելի հստակ է բաժանում, ինչը մեծացնում է հավատարմությունը։ Աղբյուր՝ arxiv.org
Ամփոփում
Այս հոդվածում մենք բացատրեցինք, թե ինչու է classifier-free guidance-ը օգտագործվում diffusion մոդելներում և ինչպես է այն աշխատում։ Պատկերներ գեներացնելիս ուզում ենք վերահսկել, թե ինչ է գեներացվում, ինչը պահանջում է պայմանավորված diffusion մոդելներ։ Սակայն պարզ պայմանավորված diffusion մոդելները հավատարմության և դասի համահունչության պակաս ունեն, ուստի հավատարմության դիմաց պետք է զիջել որոշ բազմազանություն։ Ահա թե ինչու սկզբում առաջարկվեց classifier guidance-ը, իսկ դրանից հետո՝ բարելավված classifier-free guidance-ը՝ որպես բազմազանությունն ընդդեմ հավատարմության վերահսկելու եղանակներ։ Diffusion մոդելները կարելի է պայմանավորել նաև այլ ազդանշաններով, օրինակ՝ այլ պատկերներով։ Սակայն diffusion վերահսկողության այս ձևը հիմնվում է տարբեր մեխանիզմների վրա. կառավարող պատկերները ուղղակիորեն ազդում են convolutional շերտերի վրա, ուստի ո՛չ classifier, ո՛չ classifier-free diffusion guidance-ը պետք չեն։ Եվ եթե diffusion մոդելները ձեզ հետաքրքրում են, diffusion մոդելի գնահատման չափանիշների և min-SNR-ով diffusion մոդելի վարժեցումը արագացնելու մասին բլոգ գրառումները նույնպես կարող են արժանի լինել կարդալու։