توجيه نماذج الانتشار دون مصنِّف
اكتشف لماذا يُستخدم التوجيه دون مصنِّف (classifier-free guidance) في نماذج الانتشار وكيفية تطبيقه.
قد يكون توليد الصور غير مشروط، وقد يكون مشروطاً بتضمينات الفئات أو بنص حر. وعند توليد صور مشروطة، قد نرغب في ضبط مدى قوة تطبيق الشرط. وفي نماذج الانتشار (Diffusion Models)، يؤدي مقياس التوجيه (guidance scale) الدور نفسه الذي تؤديه درجة الحرارة في نماذج اللغة الكبيرة – فهو يحكم التوازن بين الإبداع وإمكانية التنبؤ. فمقياس التوجيه الأعلى يجعل النموذج أكثر التصاقاً بالوصف النصي، بينما المقياس الأدنى يجعل الصورة الناتجة أكثر عشوائية.
الشكل 1. مخرجات نموذج stable diffusion للمطالبة نفسها بمقاييس توجيه مختلفة. المطالبة: “yellow dog chasing a cat in the rain”، وُلّدت باستخدام huggingface.co
في نماذج اللغة الكبيرة، تتيح درجة الحرارة تسطيح التوزيع الاحتمالي على الرموز (tokens) التي تُؤخذ عيناتها أو تحديده. أما Stable diffusion فلا يملك ما يعادل أخذ العينات بدرجة الحرارة. والمناهج البسيطة، مثل تحجيم متجهات الدرجة (score vectors) في النموذج أو تقليل مقدار الضجيج الغاوسي المضاف أثناء أخذ عينات الانتشار، لا تعطي نتائج جيدة. ولهذا السبب طُرحت طرق مختلفة للحصول على عينات «منخفضة الحرارة» من نموذج الانتشار. وأولاها كانت classifier guidance، التي ألحقت شبكة تصنيف بنموذج الانتشار لتوجيه مدى مطابقة الصورة الناتجة لفئة ما. غير أن هذه الطريقة لا تعمّم على فئات لم تُرَ من قبل وتضيف عبئاً تدريبياً إضافياً. ولذلك اقتُرح نهج أفضل – classifier-free guidance. فهو لا يحتاج إلى شبكة إضافية ولا يقيّد النموذج بالفئات التي رآها.
الخلفية
على مستوى عام، تولّد نماذج الانتشار صورة من الضجيج. فيزيل النموذج الضجيج تدريجياً من الصورة الضجيجية الأولية حتى يصل إلى الصورة المستهدفة عالية الجودة. وكلما صغرت الخطوات المتخذة أثناء إزالة الضجيج (أي زاد عددها)، كانت الصورة الناتجة أفضل.
يسير أخذ العينات من الزمن T نزولاً إلى 0. ويبدأ بضجيج غاوسي x_T وينتج عينات أقل ضجيجاً تدريجياً x_T −1 وx_T −2 … حتى يصل إلى العينة النهائية x_0، حيث يشير t إلى الخطوة الزمنية. ويمكن النظر إلى X_t على أنه مزيج من إشارة x0 وبعض الضجيج، مع تحديد نسبة الإشارة إلى الضجيج بالخطوة الزمنية t.
الشكل 2. تصور لعملية الانتشار. تزيل كل خطوة قدراً من الضجيج من الصورة السابقة حتى تُبلغ صورة عالية الجودة. المصدر: wikipedia: Diffusion_model
يتطلب تدريب نموذج الانتشار أخذ عينة صورة x0 وخطوة زمنية t وضجيج أولي. ومن هذه يمكننا حساب العينة الضجيجية x_t عند الخطوة الزمنية t. ويتعلم نموذج الانتشار التنبؤ بالضجيج بين خطوتين زمنيتين متجاورتين. ويرمز θ(xt, t) إلى الضجيج المضاف إلى العينة x_t عند الخطوة الزمنية t. وطرح الضجيج المتنبأ به θ(xt, t) من x_t يعطي x_t-1. وتُدرَّب الشبكة بهدف متوسط مربع الخطأ بين الضجيج الفعلي والضجيج المتنبأ به ||θ(xt, t) − θ||2.
تدريب classifier-free guidance
كما شُرح أعلاه، يولّد نموذج الانتشار الأساسي صوراً غير مشروطة. وبعبارة أخرى، الصورة المولّدة عشوائية تماماً، وليس لدينا أي تحكم فيما ستعرضه. ولشرط الصورة المولّدة بمدخلات المستخدم، اقترح Alex Nichol وPrafulla Dhariwal 2021 إضافة تضمين فئة v_i إلى تضمين الخطوة الزمنية e_t وتغذية هذا التضمين إلى الكتل المتبقية (residual blocks) في أرجاء النموذج. وفي نماذج الانتشار الحالية، تكون هذه الكتل المتبقية طبقات انتباه (attention)، ويُشرَّط النموذج بالنص عبر تضمينات النص لا بتضمينات الفئات.
الشكل 3. كيف تطورت نماذج الانتشار. 1. نموذج انتشار دون تضمين فئة. 2. نموذج انتشار مع تضمين فئة. 3. نموذج انتشار موجَّه بمصنِّف. 4. نموذج انتشار دون مصنِّف.
اتضح أن نماذج الانتشار المشروطة بالفئة تعاني من مشكلات في الدقة (fidelity): فالصور التي تولّدها ليست متسقة جداً مع الفئة. ولتحسين نماذج الانتشار المقيَّدة أكثر، قدّم Prafulla Dhariwal وAlex Nichol 2021 classifier guidance. فقد وضعا شبكة تصنيف إلى جانب نموذج الانتشار واستخدما تدرج الفئة أثناء إزالة الضجيج لتوجيه النموذج نحو الفئة المستهدفة. ورغم أن الطريقة أدت أداءً جيداً وقايضت التنوع بالدقة، فقد جاءت مع عيوب. وأكبرها أن النموذج لم يستطع التعميم على فئات غائبة عن التدريب. ومشكلة أخرى أن المصنِّف احتاج إلى التدريب على عينات ضجيجية، مما حال دون توصيل مصنِّف عام مدرَّب مسبقاً.
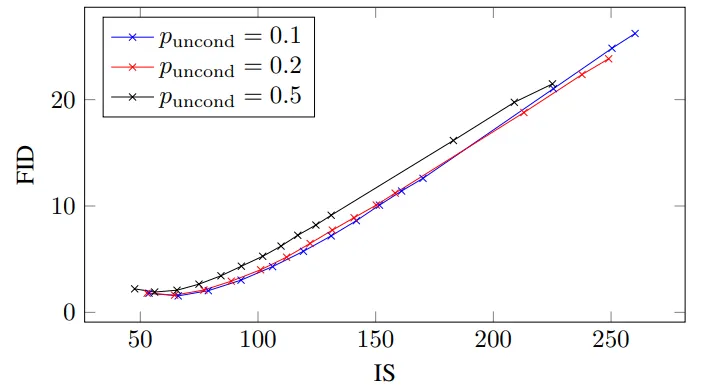
الشكل 4. Fréchet inception distance/Inception score مرسومةً مقابل قوة التوجيه. يقابل كل منحنى نموذجاً باحتمال تدريب غير مشروط p_uncond، وكل نقطة مقياس توجيه مختلفاً. تؤدي قوة التوجيه الأكبر إلى درجة FID/IS أعلى. وتكون درجة FID الأقل أفضل، ودرجة IS الأعلى أفضل. ويوضح الرسم أن قوة التوجيه تقايض FID بـ IS. فـ FID يعاقب على قلة التنوع. أما IS فيقيس، في المقابل، مدى التقاط النموذج لتوزيع فئات ImageNet بأكمله أثناء توليد عينات فردية بإنتروبيا منخفضة لفئة واحدة. ونقطة ضعف هذا المقياس أنه لا يكافئ تغطية التوزيع كله ولا التقاط التنوع داخل الفئة، ولذلك تحقق النماذج التي تحفظ جزءاً صغيراً من مجموعة البيانات الكاملة IS عالياً مع ذلك. المصدر: arxiv.org
ولمعالجة هذه المشكلات، قدّم Jonathan Ho وTim Salimans التوجيه دون مصنِّف لنماذج الانتشار. فقد أثبتا أن تدريب نموذج انتشار مشروط وآخر غير مشروط معاً ودمج الدرجتين الناتجتين، المشروطة وغير المشروطة، يتيح المقايضة بين جودة العينة وتنوعها. وتحديداً، يُدرَّب الضجيج عند الخطوة الزمنية t θ(xt, t, c) بوجود شرط الفئة وبدونه. وفي النموذج غير المشروط، يُستبدل معرّف الفئة c برمز فارغ ∅ (θ(xt, t, c = ∅)). ويمكن تدريب النموذجين المشروط وغير المشروط معاً بضبط c عشوائياً على ∅. وفي classifier-free guidance، يحدد معامل الاستدلال w مدى قوة الشرط:
θ_overall(xt, t, c) = (1 + w)θ(zt, t, c) − wθ(xt, t)
إحدى طرق قراءة المعادلة أن التنوع في الصورة يُطرح من توزيع فئة معينة، مما يعزز توزيع تلك الفئة تحديداً أكثر.
الشكل 5. كيف تؤثر قوة التوجيه في مزيج من ثلاثة توزيعات غاوسية، يمثل كل منها فئة مختلفة. دون توجيه، تتداخل الفئات إلى حد ما، بحيث قد يعطي أخذ عينة من فئة واحدة عينات تنتمي إلى فئات أخرى. ورفع قوة التوجيه يفصل الفئات بوضوح أكبر، مما يزيد الدقة. المصدر: arxiv.org
الملخص
شرحنا في هذه المقالة لماذا يُستخدم classifier-free guidance في نماذج الانتشار وكيف يعمل. فعند توليد الصور، نريد التحكم فيما يُولَّد، وهذا يستدعي نماذج انتشار مشروطة. لكن نماذج الانتشار المشروطة البسيطة تفتقر إلى الدقة واتساق الفئة، ولذلك لا بد من التخلي عن بعض التنوع مقابل الدقة. ولهذا اقتُرح classifier guidance أولاً، ثم classifier-free guidance المحسّن، كطريقتين للتحكم في التنوع مقابل الدقة. ويمكن أيضاً شرط نماذج الانتشار بإشارات أخرى، مثل صور أخرى. غير أن هذا الشكل من التحكم في الانتشار يعتمد آليات مختلفة: فصور التحكم تؤثر مباشرة في الطبقات الالتفافية، ولذلك لا حاجة إلى توجيه الانتشار بمصنِّف ولا بدونه. وإذا كانت نماذج الانتشار تهمك، فقد تستحق القراءة أيضاً مقالات المدونة عن مقاييس تقييم نماذج الانتشار وعن تسريع تدريب نماذج الانتشار بـ min-SNR.