Hibernate-ը՝ Exposed-ի դեմ. Kotlin-ի համար լավագույն persistence գործիքի ընտրությունը – 3-րդ փուլ
Համեմատեք Hibernate-ը և Exposed-ը տվյալների ստացման, batching-ի և Kotlin-ին համապատասխանության տեսանկյունից և ընտրեք ձեզ ամենահարմար persistence գործիքը։
Սա Hibernate-ի և Exposed-ի մրցակցության երրորդ և վերջին փուլն է. բարի գալուստ։
Եթե կարդացել եք շարքը հենց սկզբից, հուսով եմ՝ բավական շատ բան եք սովորել, օրինակ.
- Hibernate-ի և Exposed-ի հիմունքները, դրանք տարբեր միջավայրերում կարգավորելու եղանակները և այն, թե ինչպես կարելի է դրանցից յուրաքանչյուրով մոդելավորել ձեր տվյալները։
- Երկու ֆրեյմվորքներով տվյալներ ստեղծելու, թարմացնելու, ջնջելու և հարցելու տարբեր եղանակները, ինչպես նաև այն, թե ինչպես են սահմանվում և կարգավորվում տրանզակցիաները։
Այս վերջին հոդվածը ձեզ տանում է ավելի առաջադեմ թեմաների՝ հատկապես հարցումների արտադրողականության, յուրաքանչյուր ֆրեյմվորքի մի քանի նրբությունների և թակարդների, և այն մասին, թե նրանցից յուրաքանչյուրը որքանով է տեղավորվում Kotlin էկոհամակարգում։
Հաճելի ընթերցում։
Արտադրողականության նկատառումներ
Քանի որ տվյալների բազայի հետ փոխազդեցությունները I/O գործողություններ են, դրանք կարող են վերածվել լուրջ արտադրողականության խցանումների և նկատելիորեն ազդել մեր հավելվածների ուշացման և թողունակության վրա։ Այդ իսկ պատճառով այդքան կարևոր է ուշադիր օպտիմիզացնել մեր տվյալների բազայի հարցումների արտադրողականությունը։ Persistence ֆրեյմվորքները այստեղ կարող են շատ օգնել, բայց, ցավոք, դրանք կարող են նաև իրենց սեփական լրացուցիչ խնդիրները բերել, հիմնականում այն պատճառով, որ մենք սխալ ենք օգտագործում դրանք կամ սխալ ենք հասկանում դրանց աշխատանքը։
Այս բաժինը ներկայացնում է persistence ֆրեյմվորքների հետ կապված արտադրողականության ամենահաճախ հանդիպող մի քանի խնդիրներ, և ես կփորձեմ բացատրել, թե ինչպես կարող են Hibernate-ը և Exposed-ը յուրաքանչյուրն օգնել մեզ դրանց հետ գործ ունենալիս կամ խանգարել։
Տվյալների ստացում (Data fetching)
Տվյալների ստացումը ճիշտ կազմակերպելը հավելվածի արտադրողականության բանալին է։ Persistence ֆրեյմվորքները՝ հատկապես նրանք, որոնք թաքցնում են տվյալների բազայի հարցումների բարդությունը, սովորաբար տրամադրում են տվյալների բեռնման ռազմավարությունների և մեխանիզմների լայն շարք՝ ավտոմատ կամ կիսաավտոմատ։ Այս մոտեցումները ձեզ՝ մշակողիդ, տալիս են վերահսկողության տարբեր աստիճաններ այն հարցում, թե ինչպես և երբ են բեռնվում տվյալները։
Lazy loading-ը տվյալների ստացման հետ կապված ամենահայտնի հնարավորություններից է, հատկապես ORM ֆրեյմվորքներում։ Դա այնպիսի մեխանիզմ է, որը կարող է կամ օգնել ձեզ, կամ վնասել։ Թեև դրա նպատակը բազմաթիվ կապերով entity-ներ ստանալիս բեռնվող տվյալների քանակը նվազեցնելն է, այն հեշտությամբ կարող է խնդիրներ առաջացնել, որոնց թվում է տխրահռչակ N+1 հարցումների խնդիրը։ Այն կարող է նաև հանգեցնել runtime բացառությունների, որոնք առաջին հայացքից չէիք սպասի։
Սակայն lazy loading-ը միակ հնարավորությունը չէ, որը սխալ օգտագործելիս կարող է խայթել։ Eager loading-ը նույնպես կարող է արտադրողականության խնդիրներ առաջացնել, հատկապես երբ entity-ներն ունեն չափազանց շատ կապեր կամ ստացման ռազմավարությունները սխալ են կարգավորված։
Դա անշուշտ կարող է գլխացավանք առաջացնել։ Սակայն մի անհանգստացեք. այս բաժինը բացատրում է, թե ինչպես են Hibernate-ը և Exposed-ը մոտենում տվյալների ստացմանը, և խորանում է դրանց մեխանիզմների մանրամասների մեջ։
Տվյալների ստացում – Hibernate
Hibernate-ում տվյալների ստացումը բավական բարդ, բազմակողմանի թեմա է։ Ստացման ռազմավարությունները կարելի է սահմանել, վերասահմանել և վերագրել մի քանի եղանակով։ Թեման իրականում այնքան ընդարձակ է, որ արժանի է առանձին բլոգ հոդվածի։ Ուստի այստեղ ես միայն կդիպչեմ մակերեսին և նկարագրությունը կպահեմ հնարավորինս կարճ։
Hibernate-ում տվյալների ստացման մասին խոսելիս պետք է հաշվի առնել երկու հիմնական հարթություն.
- Ժամանակ (Timing) – երբ են ստացվում առնչվող տվյալները.
- Eager loading. բեռնվում են անմիջապես՝ հիմնական entity-ի հետ միասին
- Lazy loading. բեռնվում են ավելի ուշ՝ դիմելիս
- Շրջանակ (Scope) – որտեղ է սահմանվում ստացումը.
- Ստատիկ. նշվում է entity-ի mapping-ում
- Դինամիկ. նշվում է runtime-ում՝ կոնկրետ հարցման համար
Այս հարթությունները մտքում պահելով՝ տեսնենք, թե ինչպես է Hibernate-ում սահմանվում ստացման ժամանակը տարբեր շրջանակներում։
Ստացման ռազմավարությունների ստատիկ հայտարարում
Ստացումը ամենից հաճախ սահմանվում է կապերի FetchType-ը ստատիկ կերպով հայտարարելով հենց entity դասում.
@Entity
@Table(name = "board_games")
open class BoardGame(
// other properties ommited for brevity
) {
    @OneToMany(mappedBy = "boardGame", fetch = FetchType.LAZY)
    @Fetch(FetchMode.SUBSELECT)
    open var ratings: MutableSet<Rating> = mutableSetOf()
// ...
}

@Entity
@Table(name = "ratings")
open class Rating(
// other properties ommited for brevity
) {
    @ManyToOne(fetch = FetchType.LAZY)
    @Fetch(FetchMode.SELECT)
    @JoinColumn(name = "board_game_id", nullable = false, updatable = false)
    open val boardGame: BoardGame

// ...
}
Վերը բերված օրինակը սահմանում է @OneToMany կապ BoardGame entity-ից դեպի նրա Ratings-ը։ Մենք այն բացահայտ նշում ենք որպես lazy, թեև այստեղ դա իրականում պետք չէ. Hibernate-ը լռելյայն ամեն @OneToMany և @ManyToMany կապ դարձնում է lazy։
Հետո կա Rating entity-ն, որը սահմանում է @ManyToOne կապ՝ հետ դեպի BoardGame։ Սա մենք բացահայտ նշում ենք որպես lazy, քանի որ Hibernate-ը լռելյայն @ManyToOne և @OneToOne կապերը դարձնում է eager։
FetchType-ի սահմանումից բացի, հնարավոր է նկատել եք լրացուցիչ @Fetch annotation-ը։ FetchType-ը JPA ստանդարտի մաս է և որոշում է, թե երբ են ստացվում առնչվող entity-ները, մինչդեռ @Fetch annotation-ը հատուկ է Hibernate-ին և որոշում է, թե ինչպես է կատարվում ստացումը։
@Fetch-ը առաջարկում է երեք տարբերակ.
- SELECT – Աշխատում է և՛ eager, և՛ lazy կապերի հետ։ Այս ստացման ռեժիմում առնչվող entity-ները բեռնվում են երկրորդային հարցմամբ (որը կատարվում է հիմնականից հետո)։ Սա լռելյայն է այն կապերի համար, որոնք eager չեն, և ենթակա է N+1 հարցումների խնդրին։
- JOIN – Աշխատում է միայն eager կապերի հետ։ Այն Hibernate-ին ասում է առնչվող entity-ները բեռնել հիմնական հարցման ներսում՝ JOIN-ի միջոցով։ Սա eager կապերի լռելյայն ստացման ռեժիմն է։
- SUBSELECT – Աշխատում է և՛ eager, և՛ lazy կապերի հետ, բայց միայն collection-ների դեպքում։ Ինչպես SELECT տիպը, այն հենվում է երկրորդային հարցման վրա, բայց յուրաքանչյուր ծնող entity-ի համար մեկ հարցում կատարելու փոխարեն սկզբնական SELECT-ը ներդնում է IN clause-ի մեջ, որպեսզի բոլոր առնչվող entity-ները բեռնվեն միանգամից։ Այդպիսով խուսափում ենք N+1 խնդրից։
Կանգ առնենք մի պահ և տեսնենք, թե երբ կարող է առաջանալ տխրահռչակ N+1 հարցումների խնդիրը։
Պատկերացրեք, որ մենք անտեսում ենք BoardGame.ratings property-ի վրայի @Fetch(FetchMode.SUBSELECT) annotation-ը և վերաբերվում ենք դրան որպես սովորական lazy կապի՝ լռելյայն FetchMode.SELECT-ով։
Հետո նայեք այս կոդին.
val boardGames = session.byMultipleIds(BoardGame::class.java).multiLoad(boardGameIds)

boardGames.forEach { boardGame ->
   println("Found board game: ${boardGame.title}")
   println("Found board game ratings: ${boardGame.ratings}") // N + 1 queries!
}
Այստեղ boardGame.ratings-ին յուրաքանչյուր դիմում առաջացնում է առանձին SQL հարցում։
Սակայն եթե ստացման ռազմավարությունը փոխեք FetchType.EAGER-ի, խնդիրը կվերանա, քանի որ FetchType.EAGER-ի լռելյայն ստացման ռեժիմը JOIN-ն է։ Այդ դեպքում սեղանի խաղերն ու դրանց գնահատականները կբեռնվեն միասին՝ մեկ հարցմամբ, JOIN-ի միջոցով։
ԱՅՍՈՒՀԱՆԵՐՁ, եթե eager կապի վրա բացահայտ դնեք @Fetch(FetchMode.SELECT), N+1 խնդիրը կվերադառնա։ Եվ այստեղ այն կհայտնվի նույնիսկ ավելի շուտ, քան lazy տարբերակում՝ հենց հիմնական հարցումը կատարվելուց հետո։
Ստացման ռազմավարությունների դինամիկ հայտարարում
Նախորդ բաժինը ցույց տվեց, թե ինչպես կարելի է ստացման ռազմավարությունները հայտարարել ստատիկ կերպով։ Սակայն, ինչպես նշվել է ավելի վաղ, Hibernate-ը թույլ է տալիս նաև դինամիկ ստացման ռազմավարություններ սահմանել՝ այսինքն՝ ստացման կարգավորումներ, որոնք կիրառվում են runtime-ում տվյալ հարցման համար։ Հիշեք, որ դինամիկ ռազմավարությունները միշտ առաջնահերթ են ձեր entity-ների վրա սահմանված ցանկացած ստատիկ ստացման կոնֆիգուրացիայի նկատմամբ։
Տեսնենք, թե ինչ է առաջարկում այստեղ Hibernate-ը։
Hibernate-ը ստացման ռազմավարությունները դինամիկ սահմանելու համար տալիս է երեք հիմնական մեխանիզմ.
- Հարցումներ (HQL և Criteria API)
HQL-ը (Hibernate Query Language) և Criteria API-ը երկուսն էլ թույլ են տալիս որոշել, թե որ կապերը ստացվեն eager կերպով։ Դա կարելի է անել հետևյալով.
- HQL-ում
JOIN FETCHclause-ով, - Criteria API-ում
Root.fetch()մեթոդով։
Ստորև բերված է մեր սեղանի խաղերի խանութի հավելվածից վերցված օրինակ, որում մենք ուզում ենք BoardGame-ը բեռնել իր բոլոր Ratings-ի հետ միասին՝ eager կերպով.
// HQL
val boardGame = session.createQuery(
   "FROM BoardGame bg LEFT JOIN FETCH bg.ratings WHERE bg.title = :title",
   BoardGame::class.java)
   .setParameter("title", "Dune: Imperium")
   .singleResult

// Criteria API
val criteriaBuilder = session.criteriaBuilder
val query = criteriaBuilder.createQuery(BoardGame::class.java)
val root = query.from(BoardGame::class.java)

root.fetch<BoardGame, Rating>("ratings", JoinType.LEFT)

query.select(root).where(
   criteriaBuilder.equal(root.get<String>("title"), "Dune: Imperium")
)

val boardGame = session.createQuery(query).singleResult
Սա մի տեղ է, որտեղ N+1 հարցումների խնդիրը կարող է աննկատ սողոսկել, եթե ուշադիր չլինեք։
Ենթադրենք, BoardGame.ratings property-ն հայտարարված է FetchType.EAGER-ով՝ կա՛մ անուղղակի (առանց @Fetch annotation-ի), կա՛մ բացահայտ՝ @Fetch(FetchMode.JOIN)-ով։
Համեմատենք սեղանի խաղն իր ID-ով բեռնելու երկու եղանակ.
// direct entity find by ID
val boardGameByFind = session.find(BoardGame::class.java, boardGameId)
   ?: throw EntityNotFoundException()

println("Board game ${boardGameByFind.title} has the following ratings: ${boardGameByFind.ratings}")

// HQL query
val boardGameByHQL = session.createQuery(
   "FROM BoardGame WHERE id = :id",
   BoardGame::class.java
)
.setParameter("id", boardGameId)
.singleResult

println("Board game ${boardGameByHQL.title} has the following ratings: ${boardGameByHQL.ratings}")
Դուք հավանաբար սպասում եք, որ երկու մոտեցումներն էլ BoardGame-ի ratings-ը eager կբեռնեն հիմնական հարցման JOIN clause-ի միջոցով, այնպես չէ՞։
Ոչ ամբողջովին։
Առաջին դեպքում (session.find(...)) FetchMode.JOIN-ը հաշվի է առնվում, և մեկ հարցումը բեռնում է ամեն ինչ։
Երկրորդ դեպքում (HQL-ով), ընդհակառակը, ստատիկ @Fetch(FetchMode.JOIN) annotation-ը անտեսվում է, և Hibernate-ը ratings-ը բեռնելու համար կատարում է առանձին SELECT։
Պատճառն այն է, որ դինամիկ ստացումը միշտ առաջնահերթ է ստատիկ հայտարարությունների նկատմամբ։ HQL-ի դեպքում սա նշանակում է. եթե բացահայտ չօգտագործեք JOIN FETCH, ոչ մի join չի կատարվի՝ ինչ էլ entity-ն հայտարարած լինի։ Այնպես որ, եթե HQL հարցումներ օգտագործելիս հենվում եք @Fetch(FetchMode) annotation-ների վրա, հիշեք այս նրբությունը։
- JPA Entity Graphs
JPA-ի entity graph-ների օգնությամբ կարող եք կառուցել սեփական ստացման գրաֆ՝ բացահայտ թվարկելով, թե որ կապերը պետք է ստացվեն։ Այդպիսի գրաֆերին կարելի է անուն տալ և նորից օգտագործել, և դրանք կարող են նույնիսկ պարունակել ենթագրաֆեր ներդրված կապերի համար։
Ահա պարզ entity graph, որը ստանում է BoardGame-ը իր Ratings-ի հետ.
@NamedEntityGraph(
   name = "BoardGame.ratings",
   attributeNodes = [NamedAttributeNode("ratings")]
)
@Entity
@Table(name = "board_games")
open class BoardGame(
Եվ ահա թե ինչպես է այդպիսի գրաֆը օգտագործվում հարցման մեջ.
val boardGame = session.find(
   BoardGame::class.java,
   boardGameId,
   mapOf("jakarta.persistence.fetchgraph" to session.getEntityGraph("BoardGame.ratings")))
Այսպես կարգավորելիս Hibernate-ը Ratings-ը eager բեռնում է JOIN-ով՝ նույնիսկ երբ ratings property-ն entity դասում հայտարարված է որպես FetchType.LAZY։
Կարևոր զգուշացում. entity graph-ի դեպքում գրաֆում թվարկված յուրաքանչյուր կապ դիտվում է որպես FetchType.EAGER, մինչդեռ մնացած յուրաքանչյուր կապ (որ գրաֆում թվարկված չէ) դիտվում է որպես FetchType.LAZY՝ ինչ էլ ստատիկ annotation-ները ասեն։
- Hibernate Fetch Profiles
Fetch profile-ները JPA entity graph-ների Hibernate-յան համարժեքն են։ Դրանք հատկապես օգտակար են այնտեղ, որտեղ entity graph-ները չեն աջակցվում՝ օրինակ՝ natural ID-ով ստանալիս։ Entity graph-ները և fetch profile-ները չեն կարող համակցվել։ Երբ երկուսն էլ սահմանված են, հաղթում են entity graph-ները։
Ենթադրենք, title դաշտը հայտարարված է որպես BoardGame entity-ի @NaturalId։ Այդ դեպքում fetch profile-ը կարող ենք սահմանել և կիրառել այսպես.
@FetchProfile(
   name = "BoardGame.ratings",
   fetchOverrides = [
       FetchOverride(
           entity = BoardGame::class,
           association = "ratings",
           mode = FetchMode.JOIN
       )
   ]
)
@Entity
@Table(name = "board_games")
open class BoardGame(
   @NaturalId
   @Column(name = "title", nullable = false)
   open var title: String,
Եվ հետո այն կիրառել հարցման մեջ այսպես.
session.enableFetchProfile("BoardGame.ratings")

val boardGame = session.bySimpleNaturalId(BoardGame::class.java)
   .load("Dune: Imperium")
Այսպիսով, մենք Hibernate-ին ասացինք BoardGame-ի ratings-ը eager բեռնել մեկ հարցման ներսում՝ JOIN-ով։
Նկատեք, որ Fetch Profile-ը ընդունում է FetchOverrides-ի ցանկ։ Այսպես, ինչպես հուշում է դրա անունը, Fetch Profile-ը վերագրում է միայն ձեր ընտրած կոնկրետ կապերի ստացման ռազմավարությունները, մինչդեռ մյուսները պահպանում են իրենց լռելյայն կամ ստատիկ հայտարարված FetchTypes-ը։ Սա հակառակն է Fetch Graph-ի վերը նկարագրված վարքին, որը վերագրում է տվյալ entity-ի բոլոր կապերը։
Lazy initialization բացառության թակարդը
Կա ևս մեկ խնդիր, որը ուզում եմ նշել։ Ինչպես նշեցի Data Fetching բաժնի սկզբում, lazy loading-ը իսկապես կարող է օգնել ձեր հարցումներն ավելի արագ դարձնել, բայց այն նաև շատ հեշտ է սխալ օգտագործել, ինչը կարող է հանգեցնել runtime սխալների։ Թույլ տվեք ցույց տալ, թե ինչ նկատի ունեմ։
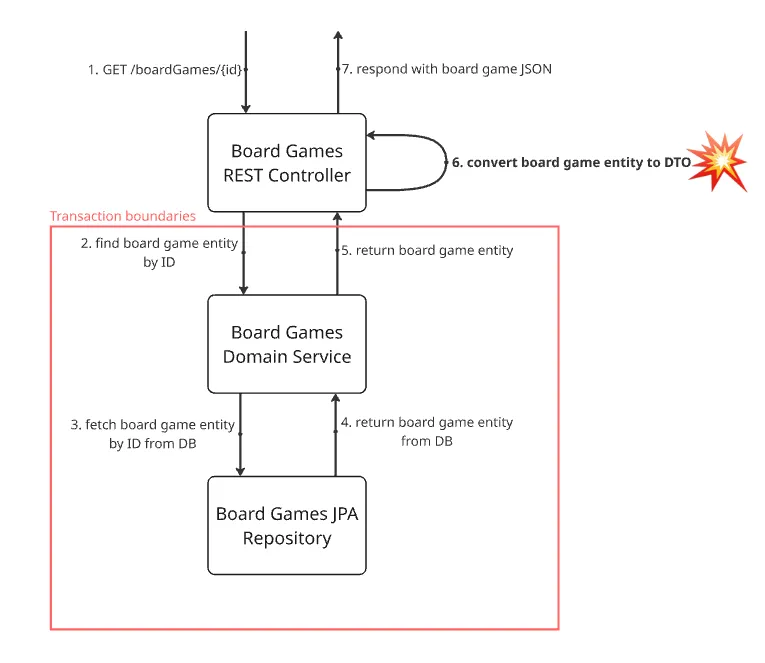
Պատկերացրեք REST endpoint, որը BoardGame-ը ստանում է իր ID-ով։ Այդպիսի հարցումը մշակելու համար ձեր հավելվածը նախ դիմում է REST Controller-ին, որը կանչում է Domain Service, իսկ սա էլ BoardGame entity-ն բեռնելու համար հենվում է JPA Repository-ի վրա։ Երբ entity-ն հասնում է ձեր Controller-ին, այն արտապատկերվում է DTO-ի, որն օգտագործում է entity-ի բոլոր դաշտերը, այդ թվում՝ ratings-ը, որոնք հայտարարված են FetchType.LAZY-ով։ Տրանզակցիան փաթաթված է Service մեթոդի շուրջ։
Ստորև բերված դիագրամը ցույց է տալիս նոր նկարագրված հոսքը և «մեղմորեն» ընդգծում է հոսքի այն կետը, որտեղ կարելի է բացառություն սպասել.
Ահա թե ինչպես կարող է դա տեսք ունենալ կոդում.
// BoardGamesService
@Transactional(readOnly = true)
open fun findBoardGame(id: Long): BoardGame {
   val game = boardGamesRepository.findById(id).orElseThrow { EntityNotFoundException() }
   // some additional business logic here
   return game
}

// BoardGamesController
val boardGame = boardGameService.findBoardGame(boardGameId)
val boardGameDto = BoardGameDto(
   ratings = boardGame?.ratings?.map { RatingDto(it.rating) } ?: emptyList() // BOOM!
   // other properties omitted
)
Այս սցենարում դուք կստանաք org.hibernate.LazyInitializationException։ Hibernate-ը այն նետում է, որովհետև փորձում եք դիմել BoardGame entity-ի ratings property-ին, որը, իր FetchType.LAZY-ի պատճառով, դեռ չի բեռնվել։ Եվ քանի որ դա տեղի է ունենում տրանզակցիայի սահմաններից դուրս, Hibernate-ն այլևս չի կարողանում ratings-ը բեռնել տվյալների բազայից, այդ իսկ պատճառով էլ runtime-ում ձախողվում է։
Վստահ եմ՝ դուք գիտեք այս խնդրի մասին և սովորաբար ձեր կոդում խուսափում եք նման իրավիճակներից։ Ցավոք, ոչ բոլորը գիտեն, և այս խնդիրը դեռ հանդիպում է բազմաթիվ արտադրական հավելվածների կոդային բազաներում։ Այդ պատճառով որոշեցի այս բաժնում այն քննարկել մի քիչ ավելի մանրամասն։
Սա եզրափակում է Hibernate-ում տվյալների ստացումը։ Այս թեմայով ձեզ անհրաժեշտ ամեն ինչ, ավելի խորը, քան ես եմ լուսաբանել այստեղ, կգտնեք Hibernate-ի փաստաթղթերի Fetching բաժնում։
Տվյալների ստացում – Exposed
Տվյալների ստացումը Exposed-ում շատ ավելի պարզ է, քան Hibernate-ում, ուստի այս բաժինը զգալիորեն ավելի կարճ կլինի։
Սկզբից նշեմ, որ այս բաժինը վերաբերում է միայն Exposed DAO-ին, քանի որ Exposed DSL-ը, ըստ էության, SQL հարցումների բարակ պատյան է։ Exposed-ը բեռնում է միայն այն տվյալները, որոնք դուք բացահայտ պահանջում եք ձեր DSL հարցման մեջ. այստեղ lazy loading չկա։
Eager և lazy loading Exposed DAO-ում
Իրենց թեթև ORM մոդուլի՝ Exposed DAO-ի համար Exposed-ի հեղինակները ընտրել են պարզ ենթադրություն։ Նրանք որոշել են Exposed entity-ների յուրաքանչյուր կապ լռելյայն դարձնել lazy-loaded։ Սակայն դա չի նշանակում, որ Exposed-ը ձեզ սահմանափակում է միայն lazy-loaded կապերով։ Կարող եք ընտրել որոշակի առնչվող entity-ներ eager բեռնել runtime-ում՝ յուրաքանչյուր հարցման համար առանձին։
Նախ հիշեցնեմ, թե ինչպես են կապերը սահմանվում Exposed DAO entity-ներում՝ որպես օրինակ վերցնելով մեր BoardGame և Rating entity-ները.
class BoardGame(id: EntityID<Long>): LongEntity(id) {
   companion object: EntityClass<Long, BoardGame>(BoardGamesTable)

   val ratings by Rating referrersOn RatingsTable.boardGameId
    // other properties omitted for brevity
}

class Rating(id: EntityID<Long>) : LongEntity(id) {
   companion object : LongEntityClass<Rating>(RatingsTable)

   var boardGame by BoardGame referencedOn RatingsTable.boardGameId
   // other properties omitted as well
}
Կնկատեք, որ կապ սահմանելու համար կան երկու տարբեր infix ֆունկցիաներ.
referencedOn– հայտարարում է կապը կապի տերի կողմում գտնվող entity-ում (երեխա)։ Այստեղ տերի կողմը Rating entity-ն է, որը արտապատկերված է RatingsTable-ին, որտեղ իրականում պահվում էboardGameIdսյունակը։referrersOn– հայտարարում է կապը դրա հակադիր կողմում գտնվող entity-ում (ծնող)։ Վերը բերված օրինակումBoardGameentity-ն է այդ հակադիր կողմը, քանի որ նրա հիմքում ընկած աղյուսակը կապի մասին որևէ տեղեկություն չի պարունակում։ Նկատեք, որBoardGameentity-ում կապը բացահայտ ցույց է տալիսRatingsTable.boardGameIdսյունակը որպես referrer։
Սա հաշվի առնելով՝ ահա թե ինչպես կարող եք BoardGame-ը բեռնել իր բոլոր Ratings-ի հետ միասին՝ eager կերպով.
// Eagerly loading ratings for a single board game
val boardGame = BoardGame.findById(1L)?.load(BoardGame::ratings)
println(boardGame)
println(boardGame?.ratings?.toList())

// Eagerly loading ratings for multiple board games
val boardGames = BoardGame.all().with(BoardGame::ratings)
boardGames.forEach {
   println(it)
   println(it.ratings.toList())
}
Անցնենք վերը բերված կոդի կատարածի միջով։
Այն ցույց է տալիս Exposed DAO-ում eager loading-ի երկու տարբեր օրինակ։ Առաջինում մենք փնտրում ենք մեկ BoardGame entity և արդյունքի վրա կանչում ենք load(BoardGame::ratings) ֆունկցիան, որպեսզի այս BoardGame-ի բոլոր ratings-ը անմիջապես բեռնվեն։ Կուլիսներում Exposed-ը կատարում է առանձին SQL հարցում, որը բեռնում է յուրաքանչյուր առնչվող Rating entity՝ հենց հիմնական հարցումը BoardGame-ը վերադարձնելուն պես։ load() կանչի բացակայության դեպքում այդ նույն SQL հարցումը կկատարվեր ավելի ուշ՝ BoardGame.ratings property-ին առաջին անգամ դիմելիս։
Երկրորդ օրինակը ցույց է տալիս, թե ինչպես eager բեռնել մի քանի BoardGame entity-ների առնչվող ratings-ը՝ այստեղ ստացված all() ֆունկցիայով։ Այս անգամ մենք վերադարձված BoardGames collection-ի վրա կանչեցինք with(BoardGame::ratings) ֆունկցիան՝ դրա յուրաքանչյուր BoardGame օրինակի բոլոր Ratings-ը eager բեռնելու համար։ Այնուհետև Exposed-ը կատարում է ընդամենը մեկ լրացուցիչ SQL հարցում՝ բոլոր առնչվող Ratings-ը բեռնելու համար, IN clause-ով, որն արգումենտ է վերցնում բոլոր BoardGame ID-ները։ with() ֆունկցիայի բացակայության դեպքում յուրաքանչյուր BoardGame-ի ratings-ը կբեռնվեր առանձին՝ առաջին դիմելիս, ինչը կհանգեցներ N+1 հարցումների խնդրին։
Գուցե նկատել եք, որ Exposed DAO-ն հնարավորություն չի տալիս հիմնական entity-ն բոլոր առնչվող entity-ների հետ eager բեռնել մեկ հարցմամբ JOIN clause-ի միջոցով, ինչպես Hibernate-ը անում է FetchMode.JOIN-ով։ Exposed-ը միշտ պահանջում է երկրորդային հարցում։
Կապերի օգտագործումը տրանզակցիայից դուրս
Կա ևս մեկ կետ, որը արժե նշել։ Քանի որ յուրաքանչյուր բեռնված կապ (lazy թե eager) պահվում է տրանզակցիայի քեշում, այն հասանելի է միայն transaction բլոկի ներսում։ Կապերը տրանզակցիայից դուրս օգտագործելու համար պետք է DatabaseConfig-ում սահմանել keepLoadedReferencesOutOfTransaction.
val db = Database.connect(
   url = "jdbc:h2:mem:test;DB_CLOSE_DELAY=-1",
   driver = "org.h2.Driver",
   databaseConfig = DatabaseConfig {
       keepLoadedReferencesOutOfTransaction = true // this option allows to use associations outside of transaction block
   })

val boardGame = transaction {
   BoardGame.findById(1L)?.load(BoardGame::ratings)
}

println(boardGame)
println(boardGame?.ratings?.toList())
Առանց այդ կարգավորման, վերը բերված օրինակում boardGame?.ratings?.toList() կանչը բացառություն կնետեր։
Այս իրավիճակը խիստ նման է Hibernate-ի LazyInitializationException-ին, որը քննարկվեց ավելի վաղ։ Այստեղ, սակայն, ազդվում են նաև eager բեռնված կապերը։
Lazy և eager loading-ի մասին լրացուցիչ մանրամասներ կարելի է գտնել Exposed-ի փաստաթղթերի Relationships բաժնում։
Batching
Batching-ը ևս մեկ գործոն է, որն ազդում է ռելացիոն տվյալների բազաների հետ աշխատող հավելվածների արտադրողականության վրա։ JDBC դրայվերներն ունեն ներկառուցված batching, որը թույլ է տալիս batch-ված SQL հարցումները տվյալների բազայի սերվերին ուղարկել միանգամից՝ առանձին-առանձին փոխարեն։ Սա կարող է նվազեցնել հավելվածի և տվյալների բազայի սերվերի միջև ցանցային շրջանցումների քանակը։
Այս բաժինը ցույց է տալիս, թե ինչպես է երկու persistence ֆրեյմվորքներից յուրաքանչյուրն օգտագործում JDBC batching-ը։
Batching – Hibernate
Լռելյայն Hibernate-ը batching չի անում և ամեն հարցում ուղարկում է առանձին։ Սակայն դա հեշտությամբ կարելի է փոխել՝ սահմանելով այս property-ն (օրինակ՝ hibernate.properties-ում).
hibernate.jdbc.batch_size=20Այս կարգավորումը Hibernate-ին հրահանգում է օգտագործել JDBC batching և մեկ batch-ում մինչև 20 հարցում ուղարկել տվյալների բազայի սերվերին։
Պարամետրը կարելի է սահմանել նաև յուրաքանչյուր session-ի համար առանձին.
sessionFactory.inTransaction { session ->
   session.jdbcBatchSize = 10
   // ...
}
Սա վերագրում է hibernate.jdbc.batch_size property-ն։
Այս պահից կարող եք պարզապես նոր entity-ներ տեղադրել ցիկլով, և Hibernate-ը հարցումները կուլիսներում կբաժանի batch-երի.
sessionFactory.inTransaction { session ->
   val batchSize = session.properties.getOrDefault("hibernate.jdbc.batch_size", 10) as Int

   for (i in 0..99) {
       if (i > 0 && i % batchSize == 0) {
           session.flush()
           session.clear()
       }

       session.persist(BoardGame("BoardGame$i", 1, i, 10 * i))
       println("BoardGame$i created")
   }
}
Հավանաբար նկատել եք կոդը, որը պարբերաբար flush և clear է անում session-ը batchSize փոփոխականի հիման վրա։ Այս փոքրիկ boilerplate-ը persistence context-ի օգտագործած հիշողությունը պահում է հնարավորինս փոքր։ Այստեղ դա կարող է խիստ անհրաժեշտ չլինել, քանի որ մենք ստեղծում ենք ընդամենը 100 BoardGame entity, բայց ընդհանուր առմամբ դա խորհուրդ տրվող պրակտիկա է։
hibernate.jdbc.batch_size-ը կարգավորված լինելու դեպքում update հարցումները նույնպես կարող են օգտագործել JDBC batching։ Նայեք այս օրինակին.
sessionFactory.inTransaction { session ->
   val batchSize = session.properties.getOrDefault("hibernate.jdbc.batch_size", 10) as Int

   val scrollableResults = session.createQuery("FROM BoardGame", BoardGame::class.java)
       .scroll()

   var count = 0
   while (scrollableResults.next()) {
       val boardGame = scrollableResults.get()
       boardGame.title = boardGame.title + "_new"

       if (count++ % batchSize == 0) {
           session.flush()
           session.clear()
       }
   }
}
Վերը բացատրած session.flush() և session.clear() կանչերից բացի, Hibernate թիմը նաև խորհուրդ է տալիս batch update-ների համար տվյալներ բեռնելիս օգտագործել ScrollableResults։ Օրինակում դա արվում է session.createQuery()-ի վրա scroll() կանչելով։ Գաղափարն այն է՝ օգտագործել server-side cursor-ներ այն հարցումների համար, որոնք կարող են վերադարձնել շատ տողեր։
Այս բաժինը փակելուց առաջ ուզում եմ կիսվել ևս մեկ կարևոր կետով։ Հիշեք, որ Hibernate-ը ավտոմատ և լուռ անջատում է JDBC batching-ը IDENTITY նույնացուցիչի գեներատորն օգտագործող entity-ների համար։ Այնպես որ, եթե ձեր entity-ի առաջնային բանալու property-ն ունի հետևյալ annotation-ը, batching-ը չի աշխատի.
@GeneratedValue(strategy = GenerationType.IDENTITY)Batching – Exposed
Exposed-ը նույնպես կարող է օգտվել JDBC batch insert-ներից, ինչը արվում է Table DSL-ի միջոցով։ board_games աղյուսակում մի քանի տող ավելացնելը Exposed-ով այսպես կլիներ.
val boardGamesToCreate = (0..99).map {
   BoardGameData(title = "BoardGame$it", minPlayers = 1, maxPlayers = 4, playTime = 60)
}

BoardGamesTable.batchInsert(data = boardGamesToCreate, shouldReturnGeneratedValues = false) {
   this[BoardGamesTable.title] = it.title
   this[BoardGamesTable.minPlayers] = it.minPlayers
   this[BoardGamesTable.maxPlayers] = it.maxPlayers
   this[BoardGamesTable.playTimeInMinutes] = it.playTime
}BoardGamesTable.batchInsert()-ը ընդունում է մի շարք պարամետրեր, որոնցից հիմնական, պարտադիրներն են.
data– արժեքների collection, որն օգտագործվում է batch insert-ի մարմնում,body– ֆունկցիա, որը պատասխանատու է data պարամետրի մեկ գրառումը Exposed Table-ի նոր տողի վերածելու համար։
Այս երկուսից բացի, վերը բերված օրինակն օգտագործում է ևս մեկ պարամետր.
shouldReturnGeneratedValues– որոշում է՝ արդյոք ֆունկցիան վերադարձնում է նոր տողերի ավտոմատ գեներացված արժեքները (օրինակ՝ auto-increment ID-ները)։ Եթե այդ արժեքները պետք չեն, այն false դնելը ավելի լավ է արտադրողականության համար։
Batch update-ները նույնպես հնարավոր են Exposed-ում, թեև դրանք ավելի դժվար է գտնել և ավելի քիչ մանրակրկիտ են փաստաթղթավորված, քան batch insert-ները։ Table DSL-ը հարմար batchUpdate() ֆունկցիա չի առաջարկում (առնվազն այս գրելու պահին)։ Այնուամենայնիվ, դա կարելի է անել այսպես.
BatchUpdateStatement(BoardGamesTable).apply {
   boardGamesForUpdate.forEach { boardGameRow ->
       addBatch(boardGameRow[BoardGamesTable.id])

       this[BoardGamesTable.title] = "Updated ${boardGameRow[BoardGamesTable.title]}"
   }

   execute(TransactionManager.current())
}
Այստեղ boardGamesForUpdate-ը ունի List<ResultRow> տիպը, բայց ցանկացած տվյալների collection կբավարարի։ BatchUpdateStatement-ի հիմնական մասն այն է, որ թարմացվող կոնկրետ տողի ID-ն addBatch() ֆունկցիային փոխանցվում է թարմացվող իրական արժեքների հետ միասին։
Հստակ է, որ Exposed-ը batching-ը մշակում է Hibernate-ից փոքր-ինչ այլ կերպ։ Exposed-ը batch_size կարգավորում չունի. դրա փոխարեն այն առաջարկում է batch գործողությունները գործարկելու բացահայտ եղանակ։ Արդյունքում դուք ինքներդ պետք է որոշեք, թե որտեղ է տեղի ունենում batching-ը՝ օգտագործելով հատուկ API, բայց դրա դիմաց ստանում եք ավելի շատ վերահսկողություն և թափանցիկություն։
Տարօրինակ է, բայց Exposed-ը batching-ի վերաբերյալ պաշտոնական, մանրամասն փաստաթղթեր չունի, թեև որոշ տեղեկություն կարելի է գտնել CRUD գործողություններին նվիրված բաժնում՝ հատկապես batch insert-ների մասին։
Ինտեգրացիա Kotlin-ի հնարավորությունների հետ
Քանի որ այս հոդվածը ամբողջությամբ Kotlin-ի մասին է, բնական է հարցնել, թե այստեղ քննարկվող երկու ֆրեյմվորքներից յուրաքանչյուրն ինչպես է օգտագործում Kotlin-ի բնիկ հնարավորությունները, և որքան հեշտ ու հաճելի է դրանցով Kotlin կոդ գրելը։ Դիտարկենք յուրաքանչյուրը հերթով։
Hibernate
Ակնկալելիորեն, Hibernate-ը ստեղծվել է բացառապես Java-ի համար՝ միայն Java-ն մտքում ունենալով։ Սա դժվար թե որևէ մեկի մեղքը լինի. Hibernate-ը իրականում շատ ավելի հին է, քան Kotlin-ը, և հավանաբար ավելի հին է նաև JVM-ի մյուս ոչ Java լեզուների մեծ մասից։ Սա Hibernate-ը դարձնում է խիստ հասուն, փորձված ֆրեյմվորք, բայց նաև այնպիսին, որն սերտորեն կապված է Java-ի շարահյուսությանը, ուստի այլ լեզուներում այն փոքր-ինչ պակաս բնական է զգացվում։
Ինչ վերաբերում է Kotlin-ի հնարավորություններին, Hibernate-ը չի տրամադրում հատուկ ինտեգրացիա, API-ներ, DSL-ներ կամ նման որևէ բան։ Այն միանգամայն օգտագործելի է Kotlin նախագծերում, բայց դա պայմանավորված է Kotlin-ի Java-ի հետ փոխգործելիությամբ, այլ ոչ թե հենց Hibernate-ով։ Kotlin-ի շարահյուսական շաքարը կարելի է օգտագործել Hibernate-ի entity-ներում կամ հարցումների API-ներում ճիշտ այնպես, ինչպես ցանկացած այլ զուտ Java գրադարանի հետ։
Որոշակիորեն ավելի մտահոգիչ է այն, որ JPA սպեցիֆիկացիայի որոշ առանձնահատուկ և խիստ պահանջների պատճառով Hibernate-ը մեզ ստիպում է հրաժարվել Kotlin-ի որոշ հարմարություններից, ինչը հանգեցնում է էլ ավելի շատ boilerplate-ի։ Ես այդ խնդիրների մեծ մասը արդեն լուսաբանել եմ Mapping & Schema Definition բաժնում՝ Hibernate entity-ների մասին խոսելիս։ Ամփոփելով՝ սրանք են JPA-ի այն սահմանափակումները, որոնք հիմնականում նկատի ունեմ.
- entity դասը պետք է տրամադրի առանց արգումենտների կոնստրուկտոր,
- entity դասը չի կարող լինել final,
- entity դասի ոչ մի մեթոդ կամ persistent փոփոխական չի կարող լինել final։
Դրանց պատճառով դուք կամ պետք է ձեռքով open դարձնեք յուրաքանչյուր entity դաս և դրա property-ները, ավելացնեք լռելյայն կոնստրուկտորներ և հրաժարվեք data class-ներից ու անփոփոխելիությունից, կամ հենվեք երրորդ կողմի build plugin-ների վրա, որոնք փոփոխում են ձեր bytecode-ը։
Exposed
Քանի որ Exposed-ը գրված է Kotlin-ով և Kotlin-ի համար, բնականաբար սպասում եք, որ այն շատ ավելի լավ ինտեգրվի Kotlin-ի բնիկ հնարավորությունների հետ, և հենց այդպես էլ կա։
Թույլ տվեք կենտրոնանալ Kotlin-ի մի քանի կոնկրետ իդիոմների վրա և ցույց տալ, թե ինչպես է Exposed-ը դրանք օգտագործում՝ հարմարություն ստեղծելու և մշակողի փորձը բարելավելու համար.
- data class-ներ – Հետաքրքիր է, որ Exposed-ը բացահայտ չի հենվում data class-ների վրա, որոնք Kotlin-ի ամենաշատ սիրվող հնարավորություններից են (անձնական կարծիքի զգուշացում)։ Exposed DSL Table-ները հայտարարվում են որպես object-ներ, իսկ Exposed DAO entity դասերը կառուցված են այնպես, որ դրանք որպես data class սահմանելը դժվար է։ Բայց դա ձեզ չի խանգարում data class-ներ օգտագործել Exposed-ի հետ աշխատող կոդում։ Ընդհակառակը, անշուշտ կարող եք, և դա շատ բնական ու պարզ է զգացվում։ Սա հատկապես օգտակար է
ResultRows-ը domain օբյեկտների վերածելիս.
val boardGames = BoardGamesTable.selectAll().map {
   BoardGameData(
       it[BoardGamesTable.id].value,
       it[BoardGamesTable.title],
       it[BoardGamesTable.minPlayers],
       it[BoardGamesTable.maxPlayers],
       it[BoardGamesTable.playTimeInMinutes]
   )
}- infix ֆունկցիաներ – Infix ֆունկցիաներն իսկապես արդարացնում են իրենց Exposed DSL հարցումներում։
eq, greater, lessEq, like, and, or, etc.նման infix ֆունկցիաներովwhereարտահայտություններում պայմանները կարդացվում են ավելի բնական և դառնում են ավելի ընթեռնելի.
BoardGamesTable.selectAll()
   .where { (BoardGamesTable.maxPlayers lessEq 4) and (BoardGamesTable.title like "Aeon's End%") }
.toList()- extension ֆունկցիաներ – Exposed-ը լայնորեն օգտագործում է extension ֆունկցիաներ (տե՛ս, օրինակ, org.jetbrains.exposed.sql փաթեթի բազմաթիվ ֆունկցիաները)։ Այն նաև խրախուսում է մշակողներին իրենց կոդում օգտագործել extension ֆունկցիաներ՝ հարցումները հարմարեցնելու և կրկին օգտագործելու համար։ Օրինակ՝ կարող եք գրել ձեր սեփական extension ֆունկցիաները
ResultRow-ի համար, որոնք այն կոկիկ կերպով վերածում են ձեր domain օբյեկտների.
fun ResultRow.toBoardGameData() = BoardGameData(
   id = this[BoardGamesTable.id].value,
   title = this[BoardGamesTable.title],
   minPlayers = this[BoardGamesTable.minPlayers],
   maxPlayers = this[BoardGamesTable.maxPlayers],
   playTime = this[BoardGamesTable.playTimeInMinutes]
)- receiver-ով lambda-ներ – Kotlin-ի հնարավորությունը՝ lambda արտահայտությունը որպես պարամետր փոխանցել հիմնական պարամետրերի ցանկից դուրս, իր ճանապարհը գտել է նաև Exposed. receiver-ով lambda-ները Exposed DSL հարցումները դարձնում են շատ ավելի արտահայտիչ, կոմպակտ և ընթեռնելի.
BoardGamesTable.insert {
   it[title] = "Champions of Midgard"
   it[minPlayers] = 2
   it[maxPlayers] = 4
   it[playTimeInMinutes] = 90
}

BoardGamesTable.selectAll()
   .where { BoardGamesTable.playTimeInMinutes lessEq 90 }
   .forEach {
       // ...
}- տիպային անվտանգություն – Exposed DSL-ը ամբողջությամբ առաջ է քաշվում որպես SQL-ին նման type-safe շարահյուսություն։ Սա իսկապես օգնում է Exposed հարցումներ գրելիս, քանի որ տիպիկ SQL հարցման յուրաքանչյուր մաս (օրինակ՝ SELECT, JOIN, WHERE), այդ clause-ների արգումենտների հետ միասին, ստուգվում է compile ժամանակ և ձեր IDE-ում ստանում է շարահյուսության լրացում.
BoardGamesTable.innerJoin(RatingsTable)
   .select(BoardGamesTable.title, RatingsTable.rating.avg())
   .groupBy(BoardGamesTable.title)
   .where { BoardGamesTable.title like "Aeon's End%" }
   .forEach {
       println("Average rating of ${it[BoardGamesTable.title]} is ${it[RatingsTable.rating.avg()]}")
}- nullability-ի մշակում – Ես կասեի, որ Kotlin-ի nullability-ի մշակումը լավագույնն է սխեման հայտարարելիս, այսինքն՝ Exposed աղյուսակների այն property-ներում, որոնք ներկայացնում են տվյալների բազայի սյունակները։ Exposed-ը սյունակները չի սահմանում annotation-ներով կամ այլ կարգավորման մեխանիզմներով. դուք դա անում եք զուտ Kotlin կոդով։ Արդյունքում ձեր property-ների և՛ տիպը, և՛ nullability-ն ստուգվում են compile ժամանակ.
object RatingsTable: LongIdTable("ratings") {
   val rating: Column<Int> = integer("rating")
val comment: Column<String?> = varchar("comment", 256).nullable() // actual nullable type- coroutines – Թեև այսօր JDBC դրայվերների մեծ մասով տվյալների բազայի հասանելիությունը մնում է արգելափակող (blocking), coroutine-ները աստիճանաբար իրենց ճանապարհն են գտնում նաև Exposed.
newSuspendedTransaction()ևwithSuspendTransaction()նման ֆունկցիաները թույլ են տալիս Exposed-ի հետ աշխատելsuspendբլոկներում՝CoroutineContextփոխանցելով, իսկsuspendedTransactionAsync()-ը թույլ է տալիս Exposed-ի որոշ կոդ կատարել ասինխրոն և դրա արդյունքին սպասել ձեր կոդում ավելի ուշ.
suspend fun findBoardGame(id: Long): BoardGameData? = newSuspendedTransaction(Dispatchers.IO) {
   BoardGamesTable.selectAll().find { it[BoardGamesTable.id].value == id }?.toBoardGameData()
}

suspend fun getAllBardGames(): Deferred<List<BoardGameData>> = suspendedTransactionAsync(Dispatchers.IO) {
   BoardGamesTable.selectAll().map { it.toBoardGameData() }
}
Ամփոփում. Hibernate թե՞ Exposed
Արագ ամփոփենք այսօրվա թեմաները (արտադրողականության նկատառումներ և Kotlin ինտեգրացիա)։ Դրանից հետո գալիս է վերջնական վճիռը, որը եզրափակում է ամբողջ շարքը։
Արտադրողականության նկատառումներ
Երկուսն էլ աջակցում են lazy loading, eager loading և batching՝ յուրաքանչյուրն իր հարմարություններով և թակարդներով։
Hibernate-ն առաջարկում է ավելի շատ տարբերակներ (օրինակ՝ fetch profile-ներ, entity graph-ներ), ինչպես նաև ավելի շատ հնարավորություններ սեփական ոտքին կրակելու համար։
Exposed-ը ավելի պարզ է և կանխատեսելի՝ հատկապես նրանց համար, ովքեր նախընտրում են բացահայտ տվյալների ստացում և ավելի բարակ աբստրակցիաներ։
Kotlin ինտեգրացիա
Շատերի համար սա կարող է կշեռքը թեքել։
Hibernate-ը աշխատում է Kotlin-ի հետ, բայց երբեք չի ստեղծվել դրա համար։ Տարբեր սահմանափակումների պատճառով այն երբեմն նույնիսկ կարող է խանգարել Kotlin-ի որոշակի իդիոմների օգտագործմանը։
Exposed-ը, ընդհակառակը, լիովին ընդունում է Kotlin-ի իդիոմները, ինչպիսիք են extension ֆունկցիաները, DSL-ները, receiver-ով lambda-ները, coroutine-ների աջակցությունը և ավելին։ Եթե ձեզ համար ամենակարևորը իդիոմատիկ, արտահայտիչ Kotlin գրելն է, Exposed-ը հավանաբար ավելի բնական կզգացվի։
Վերջնական մտքեր
Երբ կառուցում եք Spring-ի վրա հիմնված ձեռնարկության հավելված, որը պահանջում է JPA համապատասխանություն, հասուն գործիքակազմ և ոլորտի աջակցություն, Hibernate-ը անվտանգ և հզոր տարբերակ է (հատկապես եթե արդեն լավ գիտեք այն)։ Պարզապես հիշեք դրա շատախոսությունը (verbosity) և Kotlin-ի հետ շփման կետերը։
Երբ կառուցում եք թեթև Kotlin հավելված, հատկապես Ktor-ով կամ այլ ժամանակակից ստեկերով, և կարևորում եք վերահսկողությունը, հակիրճությունը և Kotlin-first API-ները, Exposed-ը հավանաբար ավելի լավ կհամապատասխանի ձեզ։
Հակիրճ ասած՝ Hibernate-ը փայլում է, երբ պետք են աբստրակցիա և համատեղելիություն։ Exposed-ը փայլում է, երբ ձգտում եք հստակության և Kotlin-բնիկ մշակողի փորձի։
Որն էլ ընտրեք, իմացեք փոխզիջումները, ընդունեք ձեր ստեկի իդիոմները և թույլ մի տվեք, որ ձեր persistence ֆրեյմվորքը թելադրի ձեր ճարտարապետությունը։