Ինչպե՞ս արագացնել JVM-ի վրա հիմնված հավելվածների գործարկումը
Այս բլոգ գրառման մեջ կողք կողքի դրված են JVM-ի գործարկման ժամանակը կրճատելու մի քանի եղանակներ։
Այս բլոգ գրառումը կողք կողքի դնում է JVM-ի գործարկման ժամանակը կրճատելու մի քանի եղանակներ։ Սկսեմ բացատրելով, թե ինչ նկատի ունեմ գործարկման ժամանակ ասելով։ Դա JVM պրոցեսը գործարկելու և այն պահի միջև ընկած ժամանակահատվածն է, երբ այն կարող է սկսել կատարել այն աշխատանքը, որի համար նախատեսված է։ Թե ինչն է համարվում այդ «նախատեսված աշխատանքը»՝ տարբերվում է մի հավելվածից մյուսը։
JVM-ը հզոր գործիք է, որը հայտնի է իր «write once, run anywhere» խոստումով։ Սակայն այն ունի նաև թերություններ, այդ թվում՝ դասերի հետ կապված ամեն ինչ կարգավորելու համար անհրաժեշտ ժամանակը, ինչպիսիք են.
- բեռնումը (loading),
- ստուգումը (verifying),
- սկզբնավորումը (initializing),
- կապակցումը (linking),
և այլն։
Դրա պատճառով JVM-ը հաճախ քննադատվում է C++, Rust և Go նման տեխնոլոգիաներից ավելի դանդաղ լինելու համար։ Այնուամենայնիվ, JVM համայնքը մշակել է խնդիրը լուծելու մի շարք ռազմավարություններ։
Ես կտամ հասանելի մի քանի տարբերակների համառոտ նկարագրություն և համեմատություն, այն է.
- Class Data Sharing - CDS
- Application Class Data Sharing - AppCDS
- GraalVM
- Coordinated Restore at Checkpoint - CRaC
- Project Leyden
Ես կներկայացնեմ benchmark-ներ, որոնք կատարվել են պարզ Netty սերվեր հավելվածի վրա։ Benchmark-ը չափում է JVM պրոցեսի գործարկումից մինչև Netty սերվերի լիովին բարձրանալն ու HTTP հարցումներ սպասարկելու ունակ դառնալն ընկած ժամանակը։
Class Data Sharing - CDS
Class Data Sharing-ը (CDS) առաջին անգամ հայտնվեց JDK 5-ում։ Երբ JVM instance է ստեղծվում, այն պետք է JDK-ի հիմնական դասերի bytecode-ը վերածի իր համար օգտագործելի ներքին ներկայացման։ CDS-ից առաջ այս փոխակերպումը կրկնվում էր ամեն անգամ, երբ նույն host մեքենայի վրա գործարկվում էր JVM instance։
CDS-ը նշանակում է, որ այս աշխատանքը կատարվում է ընդամենը մեկ անգամ՝ JVM հավելվածի առաջին գործարկման ժամանակ։ Այդ առաջին գործարկումից հետո կարելի է ստեղծել այս տվյալները պարունակող արխիվային ֆայլ, որն այնուհետև JVM-ի հաջորդ գործարկումների ժամանակ ուղղակիորեն map է արվում հիշողության մեջ։ Թեև CDS-ը գալիս է դեռ JDK 5-ից, այն լռելյայն միացված է միայն JDK 12-ից։ Այդ թողարկումից սկսած JDK-ն արխիվային ֆայլը գալիս է ներկառուցված, ինչից օգուտ են քաղում շատ մշակողներ, որոնք գուցե նույնիսկ չգիտեն դրա առկայության մասին։
Հիշեք, որ CDS-ը կարելի է անջատել ցանկացած պահի՝ JVM-ը գործարկելիս այս տարբերակը փոխանցելով. -Xshare:off։ CDS-ն անջատող օրինակային հրամանը կարող է այսպիսի տեսք ունենալ.
java -Xshare:off -jar myapp.jarԱռավելություններ.
- միացված է լռելյայն JDK 12-ից։
Թերություններ.
- գործարկման շահումը բավականին համեստ է։
Application Class Data Sharing - AppCDS
JDK 10-ում ներդրված այս գաղափարը հիմնվում է CDS-ի վրա։ Եթե արխիվ կարելի է ստեղծել JDK-ի հիմնական դասերից, ապա ինչու չանել նույնը հավելվածի սեփական դասերի հետ։ Սակայն դա պետք է արվի գիտակցաբար։ JDK 19-ից հին տարբերակների դեպքում դա պահանջում է երկու առանձին հրաման։
Հավելվածի առաջին գործարկման ժամանակ պետք է ավելացնել այս տարբերակը. -XX:ArchiveClassesAtExit=myapp.jsa։
Հաջորդ գործարկումների ժամանակ JVM-ին պետք է ասել, թե որ արխիվային ֆայլն օգտագործի, ինչը կատարվում է այս տարբերակն ավելացնելով.
-XX:SharedArchiveFile=myapp.jsa։
Այսպիսով, JDK 19-ից հին տարբերակների դեպքում առաջին հրամանը կարող է այսպիսի տեսք ունենալ.
java -XX:ArchiveClassesAtExit=myapp.jsa -jar myapp.jarՀաջորդ հրամանները կարող են այսպիսի տեսք ունենալ.
java -XX:SharedArchiveFile=myapp.jsa -jar myapp.jarJDK 19-ից սկսած ամեն ինչ էլ ավելի է պարզվում, քանի որ կարելի է յուրաքանչյուր գործարկման ժամանակ օգտագործել նույն հրամանը, որը ներառում է այս երկու տարբերակները.
-XX:+AutoCreateSharedArchive, -XX:SharedArchiveFile=myapp.jsa։
Հրամանը կարող է այսպիսի տեսք ունենալ.
java -XX:+AutoCreateSharedArchive -XX:SharedArchiveFile=myapp.jsa -jar myapp.jarԱյսպիսի հրամանով արխիվը ստեղծվում է ամեն անգամ, երբ այն բացակայում է կամ վնասված է։ Հիշեք, որ հին մոտեցումը շարունակում է աշխատել JDK 19-ում և հետագա տարբերակներում։
Առավելություններ.
- դեռ շատ պարզ է օգտագործման համար,
- գործարկման ժամանակի ավելի մեծ շահում, քան CDS-ի դեպքում։
Թերություններ.
- դեռ շատ տեղ կա բարելավման համար։
GraalVM
JVM-ը bytecode-ը կոմպիլյացնում է մեքենայական կոդի, որը աշխատում է կոնկրետ սարքավորման վրա։ Սա նկատի ունենալով՝ ինչու չտեղափոխել կոմպիլյացիան runtime-ից build ժամանակ։ Հենց այդ մոտեցումն է օգտագործում GraalVM-ը։ Այն օգտագործում է ahead-of-time (AOT) կոմպիլյացիա՝ ստանալու մեքենայական կոդ, որը կարող է աշխատել առանց լրացուցիչ քայլերի։ Առաջին հայացքից սա խիստ խոստումնալից է թվում։ Այն տալիս է արագ գործարկում և լավ արտադրողականություն պրոցեսի հենց սկզբից։ Երբեմն դա կարող է բավարար լինել։ Սակայն այս մոտեցումն էլ ունի իր թերությունները։
Առաջին դժվարությունն այն է, որ GraalVM-ով native image կառուցելը կարող է բարդ լինել, հատկապես ավելի բարդ կոդային բազաների դեպքում։ AOT կոմպիլյատորը պետք է նախապես իմանա, թե որ դասերը կպահանջվեն runtime-ում, ներառյալ այն դասերը, որոնք կարող են դինամիկ կերպով բեռնվել reflection-ի միջոցով։ Բարեբախտաբար, GraalVM JDK բաշխումները գալիս են Java agent-ով, որը ստեղծում է կոնֆիգուրացիոն ֆայլեր հենց այդ նպատակով։
Java agent-ն օգտագործելու համար գործարկեք ձեր հավելվածը այս տարբերակով. -agentlib:native-image-agent=config-output-dir=./native-config։
Ելքային ուղին կարելի է հարմարեցնել ձեր կարիքներին։ Առաջին հրամանը կարող է այսպիսի տեսք ունենալ.
java -agentlib:native-image-agent=config-output-dir=./native-config -jar myapp.jarՀամոզվեք, որ անցնում եք ձեր հավելվածի բոլոր, կամ գոնե հիմնական use case-երով, որպեսզի Java agent-ը կարողանա հավաքել այն ամենը, ինչ իրեն պետք է։ Սա բաց թողնելը կարող է սխալների հանգեցնել native image-ով կառուցված հավելվածը գործարկելիս։ Ավելին, կոնֆիգուրացիոն ֆայլերը միայն կարող են բավարար չլինել, քանի որ native image կառուցելիս կարող եք հանդիպել սխալների մի ամբողջ շարքի։ Թե որ սխալների կհանդիպեք՝ կախված է ձեր հավելվածից։
Native image-ի կառուցման եղանակը կախված է ձեր օգտագործած տեխնոլոգիայից։ Օրինակ, քանի որ իմ օրինակային նախագիծը գրված էր Scala-ով, ես օգտագործեցի sbt plugin-ը sbt-native-packager։ Այնուամենայնիվ, Maven-ի կամ Gradle-ի համար համանման լուծումներ գտնելը պետք է հեշտ լինի։ Native image-ը հիմնականում գործարկվող ֆայլ է, որը կարող եք գործարկել ձեր օպերացիոն համակարգի ցանկացած այլ գործարկվող ֆայլի նման։
Երկրորդ խնդիրն այն է, որ դուք կորցնում եք JVM-ի cross-platform աջակցությունը։ Յուրաքանչյուր միջավայրի համար պետք է առանձին native image, ուստի պետք է կառուցել տարբեր native image-ներ Linux-ի, Windows-ի և macOS-ի համար։
Վերջին խնդիրն այն է, որ ձեր հավելվածը հազվադեպ է հասնում օպտիմալ արտադրողականության։ JVM-ում JIT կոմպիլյատորը պրոֆիլավորում և օպտիմալացնում է հավելվածը՝ ըստ այն բանի, թե ինչպես է այն իրականում օգտագործվում։ AOT կոմպիլյացիային անցնելը խլում է այդ հնարավորությունը։
Կցանկանայի ընդգծել, որ ես GraalVM-ի դեմ չեմ։ Կարծում եմ՝ այն բավականին հետաքրքիր է և լավ է համապատասխանում որոշակի use case-երի։ Այդուհանդերձ, դրա սահմանափակումները իմանալը էական է, եթե ուզում եք ընտրել այն, ինչը լավագույնս համապատասխանում է ձեր կոնկրետ կարիքներին։
Առավելություններ.
- շատ արագ գործարկում,
- կայուն, բարձր արտադրողականություն հենց սկզբից։
Թերություններ.
- native image կառուցելը կարող է խնդրահարույց լինել, երբեմն՝ պարզապես անհնար. երբ գրում էի այս բլոգ գրառումը և փորձարկում այս լուծումը (2025 թվականի հունվարի վերջ – փետրվարի սկիզբ), GraalVM-ը դեռ չէր աջակցում virtual threads-ին GR-59499,
- յուրաքանչյուր միջավայրի համար պետք է կառուցել առանձին գործարկվող ֆայլ,
- այն հազվադեպ է հասնում հնարավոր լավագույն արտադրողականությանը։
Coordinated Restore at Checkpoint - CRaC
JVM հավելվածը պարզապես ձեր host մեքենայի վրա աշխատող պրոցես է։ Սա նկատի ունենալով՝ ինչու չանել պրոցեսի snapshot և հետո այն վերսկսել ճիշտ այդ կետից։ Հենց դա է անում CRaC-ը։ Ներսում այն հենվում է CRIU-ի (Checkpoint/Restore in Userspace) վրա՝ դա հնարավոր դարձնելու համար։
2024-ի վերջից աջակցվում է նաև WARP անունով լրացուցիչ checkpoint շարժիչ, թեև ես փորձարկել եմ միայն CRIU տարբերակը։ Հիշեք, որ CRIU-ը Linux-ին հատուկ նախագիծ է։ Արդյունքում CRaC-ի լիարժեք առավելությունները ստանում եք միայն Linux օպերացիոն համակարգում։ Windows-ի և macOS-ի համար լուծումներ գոյություն ունեն, բայց դրանք հիմնականում նախատեսված են մշակման համար։ Նրանք կարող են ստեղծել checkpoint-ներ և անմիջապես վերականգնել հավելվածները, բայց չեն կարող այդ checkpoint-ները պահել սկավառակի վրա։
Ահա թե ինչպես է աշխատում CRaC-ը. այն անում է ձեր պրոցեսի snapshot և ստեղծում checkpoint, որից ձեր հավելվածը կարելի է վերականգնել հետագայում։ Թեև CRaC-ը կառուցված է CRIU-ի վրա, JVM-ի use case-երը որոշ ճշգրտումներ են պահանջում։ Checkpoint ստեղծելուց առաջ դուք՝ որպես մշակող, պետք է համոզվեք, որ ձեր հավելվածը անջատված է արտաքին միջավայրից։ Այլ խոսքով՝ չպետք է լինեն բաց socket-ներ, տվյալների բազայի կապեր կամ նմանատիպ ռեսուրսներ։
Դրանում օգնելու համար CRaC-ն առաջարկում է պարզ API։ Այն ներառում է Resource անունով ինտերֆեյս՝ երկու մեթոդով. beforeCheckpoint և afterRestore։ Նրանց անունները ինքնին խոսուն են, ուստի չեմ մանրամասնի։ Կարող եք գրանցել ցանկացած քանակի ռեսուրսներ։ Եթե, օրինակ, գրանցեք երկու ռեսուրս՝ A և B, beforeCheckpoint-ը նախ կկանչվի A-ի վրա, ապա B-ի։ afterRestore մեթոդը, մյուս կողմից, կկանչվի հակառակ հերթականությամբ՝ նախ B-ի, ապա A-ի վրա։ Յուրաքանչյուր դաս, որը պետք է տեղեկացվի checkpoint ստեղծվելիս, պետք է գրանցվի, օրինակ՝ դասը, որը բացում է տվյալների բազայի կապ։ Azul-ի փաստաթղթերը պարունակում են CRaC ռեսուրսների հետ աշխատելու մի քանի խորհուրդ և հնարք։
Սա կարող է պարզ թվալ, բայց սկզբնական կոդը փոխելը կարող է բարձրացնել սպասարկման ծախսերը։ Այդուհանդերձ, Spring Boot-ը, Micronaut-ը և Quarkus-ն աջակցում են CRaC-ին, ինչը մեղմացնում է այս խնդիրը։
Ես նաև պարզեցի, որ CRaC-ի հետ կապված յուրաքանչյուր հրաման լավագույնս աշխատեցնել որպես root օգտատեր, ինչը որոշ իրավիճակներում կարող է դժվարություններ առաջացնել։
Ահա թե ինչպես է օգտագործվում CRaC-ը. սկսեք հավելվածը գործարկելով -XX:CRaCCheckpointTo=/crac-image/ տարբերակով, որը JVM-ին ասում է, թե որտեղ պետք է գնան checkpoint ֆայլերը։ Ամբողջական հրամանն այսպիսին է.
java -XX:CRaCCheckpointTo=/crac-image/ -jar myapp.jarCheckpoint-ի գործընթացը կարելի է գործարկել առանձին terminal-ից կամ ծրագրային եղանակով՝ կոդից։ Պետք է իմանալ պրոցեսի ID-ն։ Դրա միջոցով checkpoint կարելի է ստեղծել jcmd հրամանով։
jcmd <pid> JDK.checkpointCheckpoint ստեղծվելուց հետո հավելվածը անջատվում է։ Checkpoint-ից վերականգնումն այնուհետև կատարվում է այս հրամանով.
java -XX:CRaCRestoreFrom=/crac-image/Հատկանշական է, որ CRaC-ը թույլ է տալիս մեր հավելվածը վերականգնել իր առավելագույն արտադրողականության մակարդակով։ Դրա համար մենք պետք է կատարենք training run, որի ընթացքում JIT կոմպիլյատորը կիրառում է բոլոր օպտիմալացումները, որոնք անհրաժեշտ են մեր հավելվածին։ Երբ դա արվի, կարելի է ստեղծել checkpoint։
Նշանակալի է նաև, որ AWS Lambda SnapStart-ը աշխատում է գրեթե նույն կերպ, ինչ CRaC-ը։ Մի քանի օգտակար հղում.
Առավելություններ.
- շատ արագ գործարկում,
- հավելվածը կարող է աշխատել առավելագույն արտադրողականությամբ հենց սկզբից,
- աջակցվում է Java-ի ամենախոշոր վեբ ֆրեյմվորքերի կողմից՝ Spring Boot, Micronaut, Quarkus։
Թերություններ.
- ավելի բարդ հավելվածները կոդի փոփոխություններ են պահանջում (եթե չեն օգտագործում Spring Boot, Micronaut, Quarkus),
- լիարժեք աջակցություն միայն Linux-ում,
- կախված նրանից, թե ինչ է օգտագործում ձեր հավելվածը, կարող եք հանդիպել հատուկ խնդիրների, օրինակ՝ իմ թեստային հավելվածը պարզ Netty սերվեր էր, և առաջին գործարկման ժամանակ checkpoint ստեղծելուց առաջ պետք էր ավելացնել այս տարբերակը.
-Dio.netty.native.deleteLibAfterLoading=false, - այս պահին այն աջակցում են միայն Zulu և Liberica OpenJDK բաշխումները։
Project Leyden
Ինչպես նշվեց վերևում, CDS-ը և AppCDS-ը գոյություն ունեն հիմնականում JVM-ին գործարկման ժամանակ անհրաժեշտ որոշ տեղեկատվություն քեշավորելու համար։ Այդ տեղեկատվությունը գտնվում է արխիվային ֆայլում, որը կարելի է map անել հիշողության մեջ։ Project Leyden-ը այս գաղափարը տանում է ավելի առաջ։ Նրա հիմնական նպատակն է լրացուցիչ տեղեկատվություն դնել արխիվում, որպեսզի արագանան և՛ JVM-ի գործարկման, և՛ տաքացման (warmup) փուլերը։ Project Leyden-ի շրջանակն ընդգրկում է երեք JEP (JDK Enhancement Proposals).
- JEP 483: Ahead-of-Time Class Loading & Linking,
- JEP draft: Ahead-of-Time Code Compilation,
- JEP draft: Ahead-of-Time Method Profiling։
Աշխատանքը շարունակվում է, քանի որ ավարտված է միայն առաջին մասը։ Այդուհանդերձ, հայեցակարգը շատ խոստումնալից է թվում։ Այս JEP-երը լուծում են CRaC-ի հետ գործ ունեցող խնդիրներին նման խնդիրներ, թեև փոքր-ինչ այլ կերպ։ Արտաքին գործիքներ ներգրավված չեն, քանի որ JDK-ն ամեն ինչ ինքն է կառավարում։ Սա ենթադրում է, որ տեխնիկան պետք է բավականին պարզ լինի օգտագործման համար, և այս ակնկալիքը ճիշտ է դուրս գալիս։ Project Leyden-ի բերածից օգուտ քաղելու համար մեզ միայն պետք է մեր հրամանին ավելացնել մեկ տարբերակ, ավելի քիչ, քան պահանջում է AppCDS-ը.
-XX:CacheDataStore=myapp.aot։ Թե՛ առաջին գործարկումը, թե՛ յուրաքանչյուր հաջորդը կարող է օգտագործել այսպիսի հրաման.
java -XX:CacheDataStore=myapp.aot -jar myapp.jarԱյսքանը։ Մի բան, որ պետք է հիշել, ինչպես CRaC-ի դեպքում, այն է, որ training run պետք է կատարվի արխիվը ստեղծելուց առաջ։ Քանի որ սա դեռ մշակման փուլում է, սպասում եմ վերջնական արդյունքներին։ Նույնիսկ հիմա շահումները հստակ երևում են, ինչպես ցույց կտամ հետագայում։
Առավելություններ.
- շատ պարզ օգտագործման համար,
- հնարավոր է՝ գերազանց արտադրողականություն հենց սկզբից։
Թերություններ.
- դեռ մշակման փուլում է. կարելի է օգտագործել միայն early access build-ներ։
Համեմատություն
Բոլոր տարբերակները դիտարկելուց հետո ժամանակն է դրանք համեմատել։ Այդ նպատակով ես հավաքեցի պարզ նախագիծ՝ հիմնված վեբ ծառայության template-ի վրա։ Ահա իմ ընտրած տարբերակները.
- Scala 3 (ճիշտ ասած՝ ես օգտագործում եմ Scala-ի 3.7.0-RC1-bin-20250207-d60a914-NIGHTLY տարբերակը, քանի որ այն համատեղելի է Project Leyden-ի հետ),
- sbt որպես build գործիք,
- Future որպես stack,
- Netty որպես սերվերի իրականացում։
Սկզբնական կոդն ունի չորս առանձին branch.
- main,
- graalvm,
- CRaC,
- project_leyden (այն գոյություն ունի միայն հարմարության համար՝ որոշակի անունով jar կառուցելու համար, քանի որ նրա սկզբնական կոդը նույնական է main branch-ին)։
CRaC-ի համար ես իրականացրի Resource ինտերֆեյս, որը համոզվում է, որ սերվերը կանգնեցված է checkpoint-ից առաջ և վերականգնումից հետո նորից գործարկվում է։
GraalVM-ի build կոնֆիգուրացիան տարբեր է, քանի որ ես պետք է ավելացնեի plugin՝ native image կառուցելու համար ճիշտ կոնֆիգուրացիայի հետ միասին։
Ահա Java-ի այն տարբերակները, որոնք օգտագործել եմ.
- Temurin-21.0.6+7 (build 21.0.6+7-LTS),
- Oracle GraalVM 21.0.6+8.1 (build 21.0.6+8-LTS-jvmci-23.1-b55),
- Zulu21.38+21-CRaC-CA (build 21.0.5+11-LTS),
- 24-leydenpremain 2025-03-18։
Ես գրեցի պարզ benchmark հավելված։ Այն գործարկում է տվյալ պրոցեսը և սպասում console հաղորդագրության, որ սերվերը պատրաստ է, այսինքն՝ կարող է ընդունել մուտքային HTTP հարցումներ, ապա այն կանգնեցնում է։ Յուրաքանչյուր չափում բաղկացած է 50 իտերացիայից։ Թեստերն անցկացրել եմ երկու տարբեր մեքենաների վրա.
- տեղական PC.
- Intel(R) Core(TM) i5-8500 CPU @ 3.00GHz
- 6 vCPU (6 միջուկ)
- 16 GB RAM
- Ubuntu 22.04-LTS
- Google Cloud-ում աշխատող վիրտուալ մեքենա.
- Intel(R) Xeon(R) CPU @ 2.20GHz
- 8 vCPU (4 միջուկ)
- 8 GB RAM
- Ubuntu 24.04-LTS
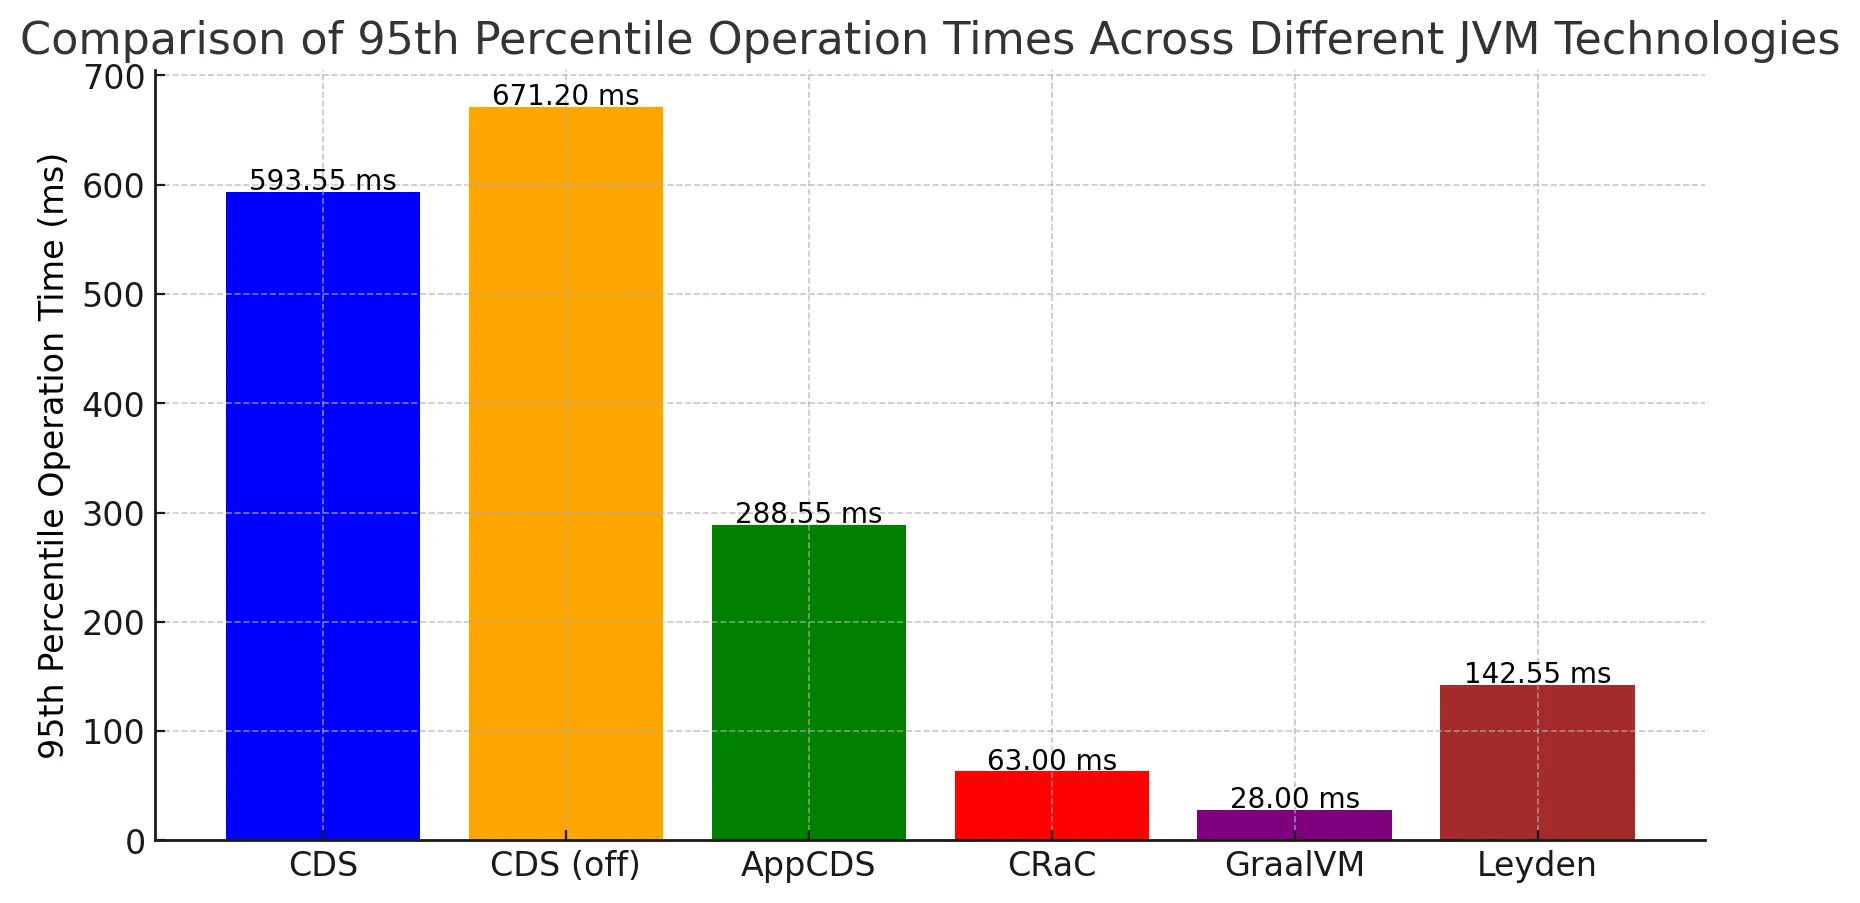
Ահա թե ինչ ցույց տվեցին իմ թեստերը.
- տեղական PC.
- վիրտուալ մեքենա Google Cloud-ում.
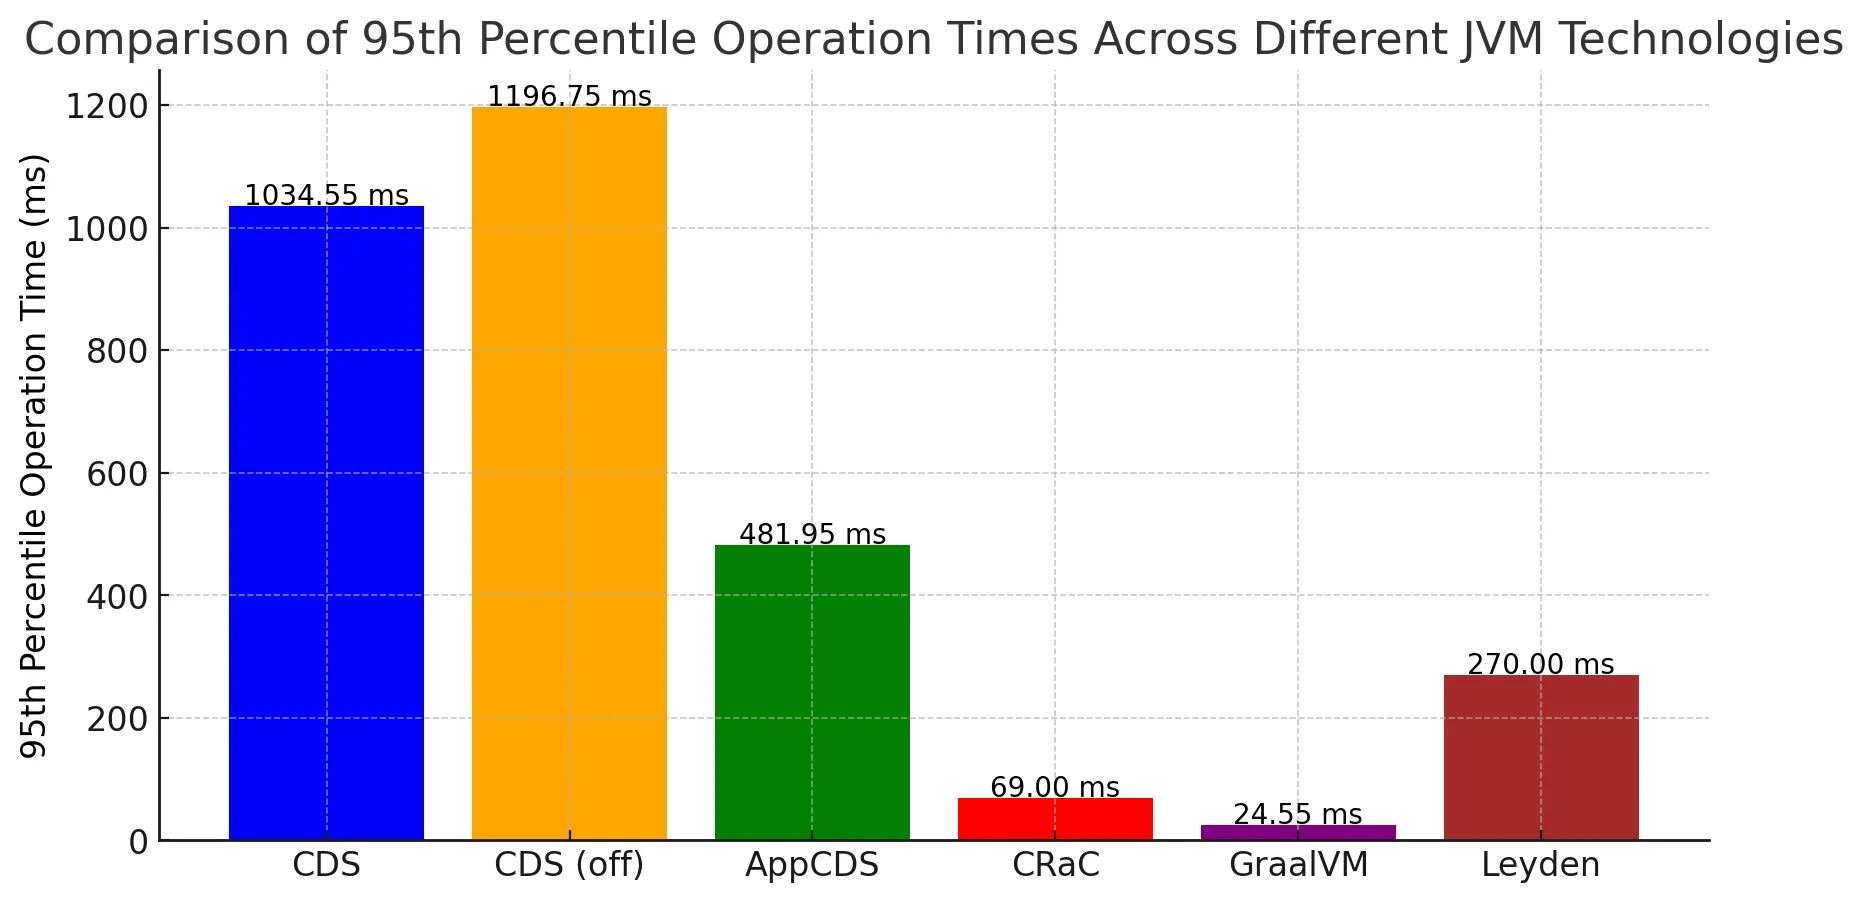
Համեմատությունը անակնկալներ չի պարունակում։ Եթե անտեսենք ժամանակային արժեքները, երկու գրաֆիկների սյուները շատ նման են։ CDS-ով տարբերակը՝ լռելյայն ավելի նոր JDK-ներում՝ 12-րդ տարբերակից սկսած, կարող է ծառայել որպես բազային գիծ։ Թեստերը ցույց տվեցին, որ CDS-ն անջատելը գործարկումն ավելի դանդաղ է դարձնում։ AppCDS-ը միացնելը երկու կարգավորումներում էլ գործարկման ժամանակը կրճատում է կեսից ավելի։ Այնուհետև CRaC-ը և GraalVM-ը ստացվեցին ամենաարագ տարբերակները։ Project Leyden-ը գտնվում է AppCDS-ի և CRaC/GraalVM-ի միջև, թեև հիշեք, որ այն դեռ մշակման փուլում է։ Հետաքրքիր կլինի տեսնել, թե ինչ տեսք կունենան այս գրաֆիկները, երբ Project Leyden-ն ավարտվի։
Եզրակացություն
JVM-ը կարելի է արագացնել մի քանի եղանակով, և թե որն է լավագույնը՝ կախված է կոնկրետ հավելվածից։ JDK-ի հին տարբերակների դեպքում (10 և ավելի վաղ) CDS-ը բարելավման միակ տարբերակն է։ Սակայն JDK-ի ավելի նոր տարբերակները մեզ ավելի շատ ընտրություն են տալիս՝ AppCDS, CRaC և GraalVM։
Ես կասեի, որ AppCDS-ը ամենապարզն է օգտագործման համար, թեև երեքից այն տալիս է ամենափոքր շահումը։ CRaC-ը լավ է համապատասխանում երկարատև աշխատող հավելվածներին, քանի որ թույլ է տալիս JVM-ին օպտիմալացնել runtime-ում։ GraalVM-ը, ընդհակառակը, կարող է ավելի հարմար լինել կարճատև հավելվածների համար, որտեղ արագ գործարկումը ավելի կարևոր է, քան առավելագույն արտադրողականությանը հասնելը, հատկապես երբ CRaC-ը չի կարող օգտագործվել։
Ինչպես միշտ, ոչ մի լուծում չի համապատասխանում բոլոր դեպքերին։ Հուսով եմ՝ այս բլոգ գրառումը կօգնի ձեզ ընտրել այն տարբերակը, որը լավագույնս համապատասխանում է ձեր կոնկրետ կարիքներին։