Ինտերիերի դիզայն stable diffusion-ով
Կարո՞ղ է stable diffusion-ը օգնել որևէ մեկին՝ նոր տեսք մտածել իր բնակարանի համար։ Համառոտ ակնարկ այն մասին, թե ինչ է stable diffusion-ը և ինչպես է այն աշխատում։
Կարո՞ղ է stable diffusion-ը օգնել մեզանից յուրաքանչյուրին՝ նոր դասավորություն մտածել մեր բնակարանի համար։ Հոդվածը սկսվում է համառոտ ակնարկով՝ ինչ է stable diffusion-ը և ինչպես է այն աշխատում։ Այնուհետև բացատրում եմ, թե ինչպես կարելի է կառավարել stable diffusion-ի ստեղծած ձևերը։ Վերջում ներկայացնում եմ փոքր փորձնական նախագիծ, որը ցույց է տալիս, թե ինչպես կարող է այս տեխնոլոգիան գաղափարներ առաջարկել սենյակի դիզայնի համար։
Stable Diffusion
Stable diffusion-ը գեներատիվ նեյրոնային ցանց է, որը տեքստային հարցումներից (prompt) և աղմուկից ստեղծում է ֆոտոռեալիստական պատկերներ։ 2022 թվականի օգոստոսին թողարկված սկզբնական մոդելն ունի 859 միլիոն պարամետր և որպես մուտք ընդունում է 512x512 պիքսել չափսի պատկերներ։ GAN-ների համեմատ stable diffusion-ը մարզվում է շատ ավելի կայուն, իսկ ստացվող պատկերների որակը նույնն է կամ ավելի լավը։ Նրա ճարտարապետությունը հետևում է U-Net դիզայնին՝ skip կապերով, իսկ տեքստային embedding-ները մոդել են մատակարարվում cross-attention շերտերի միջոցով։ Այս embedding-ները մոդելին կառավարելիություն են տալիս, ուստի օգտատերը կարող է պահանջել կոնկրետ պատկեր։ Պատկերը ստեղծվում է իտերատիվ ձևով. ցանցը կանխատեսում է պատկերում առկա աղմուկի փոքր մասը և հանում այն մուտքային պատկերից։ Հանման արդյունքը որպես հաջորդ մուտք նորից տրվում է մոդելին։ Այս ցիկլը շարունակվում է, մինչև ստացվի վերջնական, բարձրորակ պատկեր, ինչը սովորաբար պահանջում է մոտ 1000 ռեկուրսիվ կանչ։
Աղյուսակ 1. Stable diffusion-ի օրինակներ։ Մոդելը պատկերներ է ստեղծել օգտատիրոջ տրամադրած prompt-ներից։ Պատկերները վերցված են Stable Diffusion-ի պաշտոնական դեմոյից։
Ըստ իր կառուցվածքի՝ stable diffusion-ը ղեկավարվում է միայն տեքստային prompt-ով, բայց ճարտարապետությունը չի սահմանափակում այն դրանով։ Փոքր փոփոխություններից հետո այն կարելի է ուղղորդել նաև օգտատիրոջ ուրվագծերով, սեգմենտավորման դիմակներով կամ եզրագծերով։ Ես այստեղ կենտրոնանում եմ հատկապես stable diffusion մոդելի ուղղորդման վրա գծերի միջոցով, քանի որ դա թույլ է տալիս սենյակի մեկ լուսանկարից ստեղծել ինտերիերի դիզայնի բազմաթիվ տարբեր գաղափարներ։ Տեքստից բացի այլ մոդալությունների վրա մոդելը պայմանավորելու դժվարությունը մարզման ժամանակի և անհրաժեշտ ռեսուրսների մեջ է։ Սկզբնական stable diffusion մոդելը մարզվել է 2 միլիարդ պատկերների վրա՝ օգտագործելով 256 Nvidia A100 GPU, ինչը տևել է մոտ 150 000 ժամ։ Մարզման ընթացքում սպառված էլեկտրաէներգիան շուկայական գնով համապատասխանում է մոտավորապես $600 000-ի։ Մոդելի ճարտարապետությունը փոխելը և այն զրոյից նորից մարզելը թանկ է և շատերի համար անհասանելի։ Այստեղ օգնության է գալիս ControlNet-ը։ Նրա հեղինակները նախագծել են ճարտարապետություն, որը արդյունավետ կերպով կարգավորում է սկզբնական stable diffusion մոդելի պարամետրերը։ Մարզումը կարելի է կատարել ընդամենը մեկ RTX 3090-ի վրա, և լավ արդյունքներ երևում են 50 հազար պատկերից բաղկացած տվյալների բազայի վրա ընդամենը 16 ժամ մարզվելուց հետո։
ControlNet
ControlNet-ը կառուցված է Stable Diffusion մոդելի վրա։ Ինչպես երևում է Նկար 1-ում, U-Net մոդելը իր տեքստային և ժամանակային կոդավորիչներով (encoder) սկզբնական Stable Diffusion մոդելի ճշգրիտ պատճենն է։ Այն օգտագործում է նույն կշիռները, ինչ սկզբնականը, և դրանք մարզման ողջ ընթացքում մնում են սառեցված։ Դրա վրա ControlNet-ը ավելացնում է մարզվող կոդավորիչ, որը պատճենում է U-Net Stable Diffusion կոդավորիչը։ Այս մարզվող կոդավորիչը զբաղվում է ելքային պատկերի տարածական կառավարմամբ։ Այն որպես մուտք ստանում է աղմուկ և եզրագծեր, որտեղ եզրագծերը թիրախային պատկերի կոնտուրներն են։ Վերջում ControlNet-ը ներմուծում է զրոյական կոնվոլյուցիայի շերտեր, որոնք կապում են կառավարող կոդավորիչը stable diffusion-ի U-Net-ի հետ։ Zero-convolution տերմինը վերաբերում է կշիռների սկզբնավորմանը՝ զրոներով։ Հեղինակները իրենց հոդվածում ցույց են տալիս, որ կշիռները զրոյով սկզբնավորելը թույլ է տալիս կառավարող կոդավորիչի ազդեցությանը կառավարվող U-Net-ի վրա աճել սահուն։ Առաջին իտերացիայում կառավարող կոդավորիչը ընդհանրապես չի ազդում վերջնական արդյունքի վրա։ Մարզման ընթացքում այն ավելի ու ավելի մեծ ազդեցություն է ձեռք բերում, և մոդելի ելքը գնալով ավելի շատ է հետևում պայմանավորող ձևին։
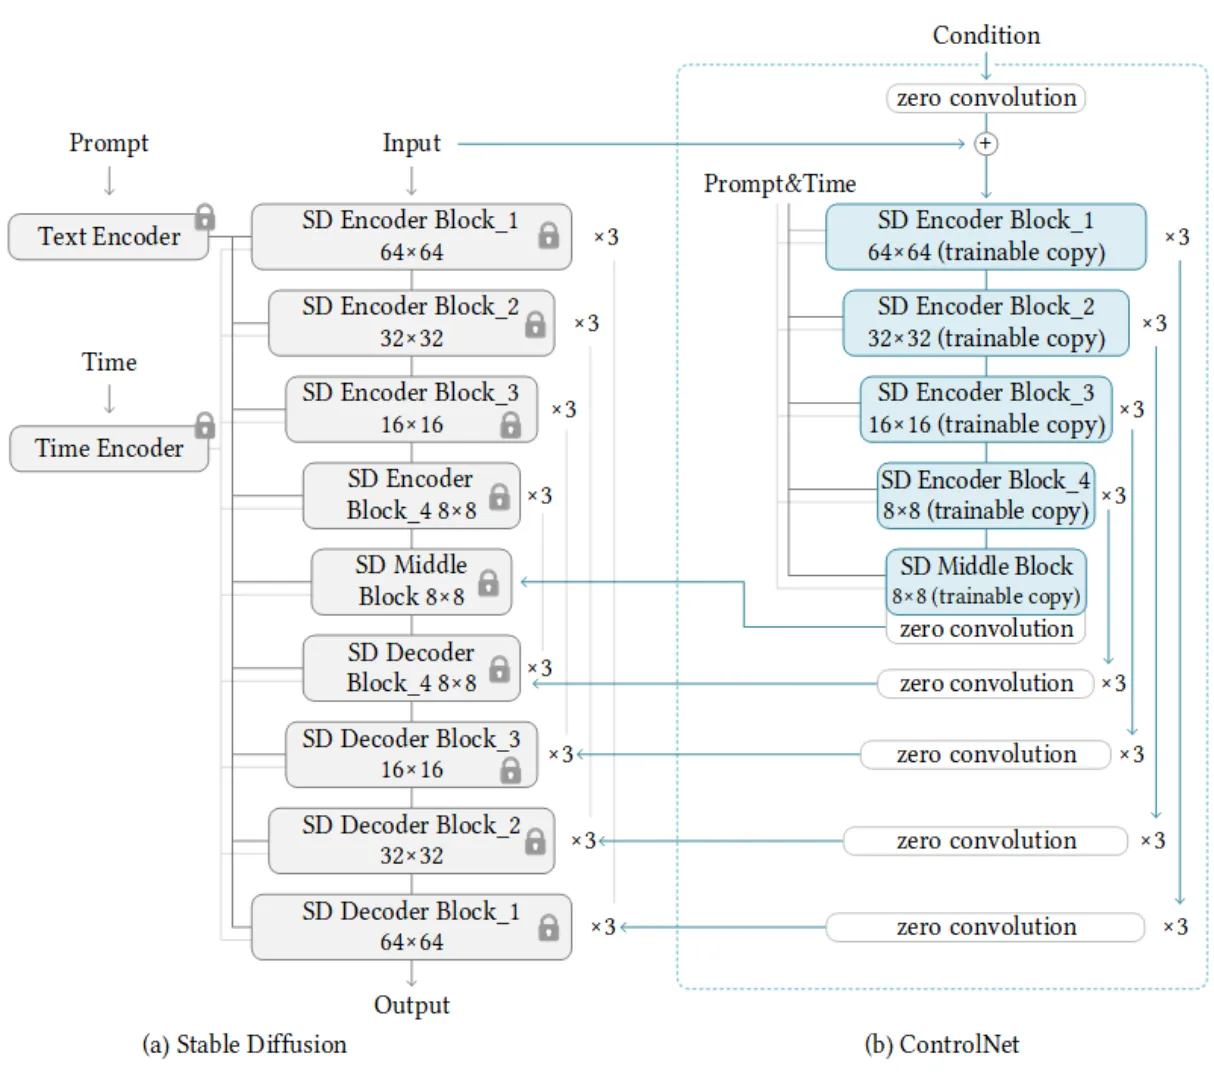
Նկար 1. ControlNet-ի ճարտարապետությունը։
ControlNet-ի օգտագործումը ինտերիերի դիզայնի համար
Այս նախագծի համար ես միավորեցի ինտերիերի դիզայնի մի քանի տվյալների բազա.
- IKEA Interior design dataset (298 պատկեր)
- Indoor Scene Recognition dataset (2809)
- House Roomsset (5250)
- GeoSynth: A Photorealistic Synthetic Indoor Dataset for Scene Understanding (170)
Ընդհանուր առմամբ ստացվեց 8527 պատկերից բաղկացած տվյալների բազա։ ControlNet-ի հոդվածի հեղինակները խորհուրդ են տալիս առնվազն 50 հազար պատկեր, բայց ես դժվարացա գտնել ինտերիերի դիզայնի ավելի շատ պատշաճ որակի պատկերներ։
Որոշ պատկերների լուծունակությունը 256x256 պիքսել է, մինչդեռ սկզբնական stable diffusion մոդելը մարզվել է 512x512 պիքսելանոց պատկերների վրա։ Որպեսզի սկզբնական ճարտարապետությունը անփոփոխ մնա, ես որոշեցի մեծացնել (upscale) յուրաքանչյուր պատկերը և կենտրոնից կտրել այն մինչև 512x512։
ControlNet-ի մարզման տվյալների բազան բաղկացած է սկզբնական պատկերից, պայմանավորող պատկերից (գծեր, եզրագծեր, դիմակներ) և տեքստային prompt-ներից։ Յուրաքանչյուր սկզբնական պատկերի համար պայմանավորող պատկերը ես ստեղծեցի Հաֆի ձևափոխությամբ (Hough transform)։ Սկզբում փորձեցի canny edge detector, բայց նրա ստեղծած պայմանավորող պատկերներում չափազանց շատ կոնտուրներ կային, և մոդելը դժվարանում էր նոր դիզայններ մտածել, որոնք համապատասխանեին այդքան անկառուցվածք եզրերին։ Հաֆի ձևափոխությունը վերադարձնում է պատկերի միայն ուղիղ գծերը, ինչը իդեալականորեն հարմար է ինտերիերի դիզայնի քարտեզագրման համար։
Վերջում յուրաքանչյուր պատկերին պետք էր տեքստային prompt։ Մեկ տարբերակն այն է, որ պարզապես օգտագործվի դատարկ prompt-պիտակ “”։ Սակայն քանի որ մոդելը սկզբում մարզվել է prompt-ներով, դա կարող է հանգեցնել թույլ արդյունքների։ Ես ընտրեցի նույն լռելյայն prompt-ը՝ “interior design”, բոլոր պատկերների համար։ Իդեալական դեպքում պատկերների ավտոմատ նկարագրության ցանցը, օրինակ՝ Bootstrapping Language-Image Pre-training (BLIP), կստեղծեր յուրաքանչյուր պատկերի համար հարմարեցված տեքստային prompt։ Այդ մոտեցումը թողնում եմ ապագա աշխատանքի համար։
Նկար 2. Ննջասենյակի դիզայնի գաղափարներ, որոնք ստեղծվել են RTX 3090-ի վրա 48 ժամ մարզված ControlNet-ով, batch size = 4։
Նկար 3. Ննջասենյակի դիզայնի գաղափարներ, որոնք ստեղծվել են RTX 3090-ի վրա 48 ժամ մարզված ControlNet-ով, batch size = 4։
Նկար 4. Հյուրասենյակի դիզայնի գաղափարներ, որոնք ստեղծվել են RTX 3090-ի վրա 48 ժամ մարզված ControlNet-ով, batch size = 4։
Նկար 5. Ննջասենյակի դիզայնի գաղափարներ, որոնք ստեղծվել են RTX 3090-ի վրա 48 ժամ մարզված ControlNet-ով, batch size = 4։
Ամփոփում
Նկար 2–5-ը ցույց են տալիս, որ ControlNet-ը բավարար արդյունքներ է տալիս նույնիսկ փոքր տվյալների բազայով։ Կառավարող կոդավորիչը հաջողությամբ ստիպում է ցանցին ստեղծել նման ձևերով պատկերներ։ Շնորհիվ նախապես մարզված stable diffusion մոդելում արդեն կոդավորված՝ տարածական աշխարհի տեսքի մասին լայն գիտելիքի, բարձրորակ պատկերներ հայտնվում են մարզման հենց սկզբից։ Քանի որ մարզվում է միայն Control-Net-ը, իսկ Stable Diffusion U-Net մոդելի կշիռները մնում են անձեռնմխելի, մոդելը սովորում է միայն նոր պատկերային պայմանը՝ պահպանելով աշխարհի մասին իր արդեն ունեցած գիտելիքը։
Ավելի լավ արդյունքների համար պետք է ստեղծել ավելի մեծ և բարձրորակ պատկերներից բաղկացած տվյալների բազա։ Տեքստային prompt-ները կարելի է բարելավել BLIP ցանցով, ինչը թույլ կտա յուրաքանչյուր պատկերի համար հարմարեցված prompt ունենալ և հետագայում բարձրացնել վերջնական մոդելի արդյունքները։ Հեղինակները նաև նշում են, որ մարզումը օգուտ է քաղում ավելի մեծ batch size-ից, մինչդեռ ավելի երկար մարզումը արդյունքները չի բարելավում։ Այդ մոտեցումը, սակայն, կպահանջի GPU կլաստեր, գրադիենտների կուտակում (gradient accumulation) կամ 24GB-ից ավելի VRAM ունեցող GPU։