تصميم الديكور الداخلي باستخدام stable diffusion
هل يمكن لـ stable diffusion أن يساعد أي شخص على ابتكار مظهر جديد لشقته؟ نظرة موجزة على ماهية stable diffusion وكيف يعمل.
هل يستطيع stable diffusion أن يساعد أيًّا منا على ابتكار تصميم جديد لشقته؟ يبدأ هذا المقال بنظرة موجزة على ماهية stable diffusion وكيف يعمل. ثم أشرح كيف يمكن التحكم في الأشكال التي ينتجها. وفي الختام أعرض مشروعًا تجريبيًا يوضح كيف تستطيع هذه التقنية توليد أفكار لتصميم الغرف.
Stable Diffusion
Stable diffusion هي شبكة عصبية توليدية لتحويل النص إلى صورة، تنتج صورًا واقعية من النصوص التوجيهية والضجيج. يضم النموذج الأصلي، الذي صدر في أغسطس 2022، 859 مليون معامل، ويقبل صور إدخال بحجم 512x512 بكسل. وبالمقارنة مع شبكات GAN، يتدرب stable diffusion بثبات أكبر بكثير مع إنتاج صور بالجودة نفسها أو أفضل. تتبع بنيته تصميم U-Net مع وصلات تخطٍّ، وتُغذّى تمثيلات النص في النموذج عبر طبقات الانتباه المتقاطع (cross-attention). تمنح هذه التمثيلات النصية النموذجَ قابلية التحكم، فيستطيع المستخدم طلب صورة محددة. تُنتج الصورة بالتكرار: تتنبأ الشبكة بكمية صغيرة من الضجيج الموجود في الصورة وتطرحها من صورة الإدخال. ثم يُعاد ناتج الطرح إلى النموذج بوصفه الإدخال التالي. تستمر هذه الحلقة إلى أن تظهر صورة نهائية عالية الجودة، وهو ما يستغرق عادةً نحو 1,000 استدعاء متكرر.
الجدول 1. أمثلة على stable diffusion. أنتج النموذج الصور من نصوص توجيهية قدّمها المستخدم. الصور مأخوذة من العرض التجريبي الرسمي لـ Stable Diffusion.
بحسب تصميمه، يوجَّه stable diffusion بالنص التوجيهي وحده، لكن بنيته لا تقتصر على ذلك. فبعد تعديلات بسيطة يمكن توجيهه أيضًا برسومات المستخدم أو أقنعة التجزئة أو الحواف. أركّز هنا تحديدًا على توجيه نموذج stable diffusion بالخطوط، لأن ذلك يتيح توليد كثير من مفاهيم الديكور الداخلي المختلفة انطلاقًا من صورة واحدة لغرفة. تكمن الصعوبة في ربط النموذج بأنماط بيانات غير النص في زمن التدريب والموارد اللازمة. فقد دُرّب نموذج stable diffusion الأصلي على 2 مليار صورة باستخدام 256 معالج رسوميات Nvidia A100، واستغرق ذلك نحو 150,000 ساعة. وتعادل الكهرباء المستهلكة أثناء التدريب سعرًا سوقيًا يقارب 600,000 دولار. إن تغيير بنية النموذج وإعادة تدريبه من الصفر مكلف وخارج متناول معظم الناس. وهنا يأتي دور ControlNet. فقد صمّم مؤلفوه بنية تضبط معاملات نموذج stable diffusion الأصلي بكفاءة. ويمكن إجراء التدريب على بطاقة RTX 3090 واحدة فقط، وتظهر نتائج جيدة بعد 16 ساعة فقط من التدريب على مجموعة بيانات من 50 ألف صورة.
ControlNet
يُبنى ControlNet فوق نموذج Stable Diffusion. وكما يوضح الشكل 1، فإن نموذج U-Net مع مرمّز النص ومرمّز الزمن نسخة طبق الأصل من نموذج Stable Diffusion الأصلي. يستخدم الأوزان نفسها، وتبقى مجمّدة طوال التدريب. وفوق ذلك يضيف ControlNet مرمّزًا قابلًا للتدريب ينسخ مرمّز U-Net في Stable Diffusion. يتولى هذا المرمّز القابل للتدريب التحكم المكاني في الصورة الناتجة. يتلقى الضجيج والحواف مُدخلات، والحواف هي ملامح الصورة المستهدفة. وأخيرًا يُدخل ControlNet طبقات التفاف صفرية (zero convolution) تربط مرمّز التحكم بنموذج U-Net الخاص بـ stable diffusion. يشير مصطلح الالتفاف الصفري إلى طريقة تهيئة الأوزان، أي بالأصفار. يبيّن المؤلفون في ورقتهم أن تهيئة الأوزان بالصفر تجعل تأثير مرمّز التحكم في نموذج U-Net الخاضع للتحكم ينمو بسلاسة. ففي التكرار الأول لا يؤثر مرمّز التحكم في الناتج النهائي إطلاقًا. ومع تقدم التدريب يكتسب تأثيرًا متزايدًا، ويتبع ناتج النموذج شكل الشرط بصورة متزايدة.
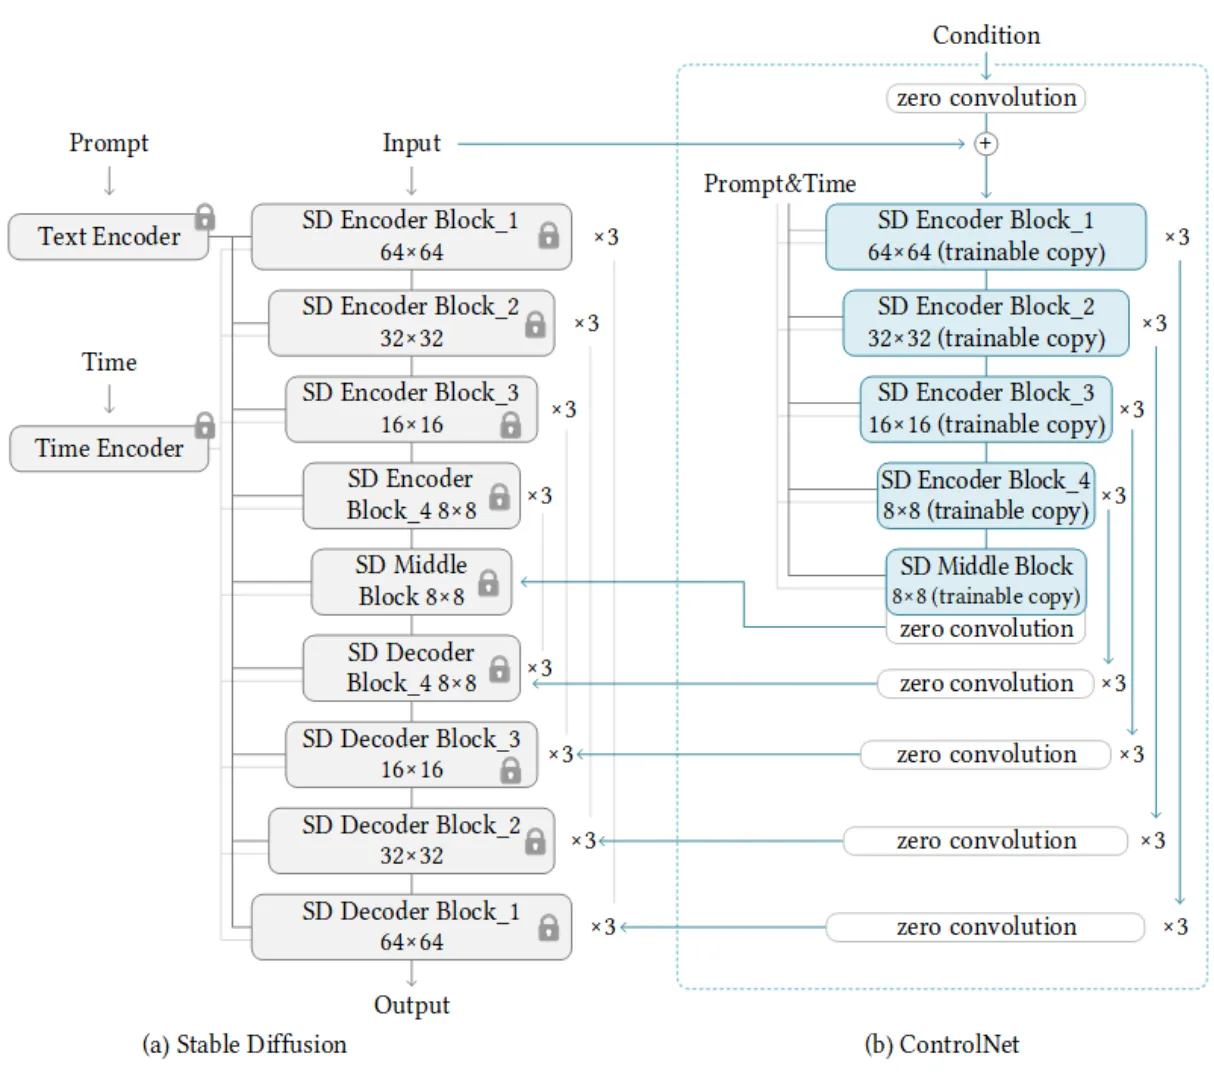
الشكل 1. بنية ControlNet.
استخدام ControlNet في الديكور الداخلي
في هذا المشروع جمعت عدة مجموعات بيانات للديكور الداخلي:
- مجموعة بيانات IKEA Interior design (298 صورة)
- مجموعة بيانات Indoor Scene Recognition (2,809)
- House Roomsset (5,250)
- GeoSynth: مجموعة بيانات داخلية اصطناعية واقعية لفهم المشاهد (170)
أثمر ذلك في المجموع مجموعة بيانات من 8,527 صورة. يوصي مؤلفو ورقة ControlNet بما لا يقل عن 50 ألف صورة، لكنني واجهت صعوبة في العثور على مزيد من صور الديكور الداخلي بجودة مناسبة.
بعض الصور بدقة 256x256 بكسل، بينما دُرّب نموذج stable diffusion الأصلي على صور 512x512 بكسل. وللإبقاء على البنية الأصلية دون مساس، اخترت تكبير كل صورة واقتطاعها من المنتصف إلى 512x512.
تتألف مجموعة بيانات تدريب ControlNet من الصورة الأصلية وصورة شرط (خطوط، حواف، أقنعة) ونصوص توجيهية. ولّدت صورة شرط لكل صورة أصلية بتحويل Hough. جرّبت في البداية كاشف الحواف canny، لكن صور الشرط الناتجة عنه احتوت على محيطات كثيرة جدًا، وواجه النموذج صعوبة في ابتكار تصاميم جديدة تلائم هذا العدد الكبير من الحواف غير المنظمة. أما تحويل Hough فيعيد الخطوط المستقيمة فقط في الصورة، وهذا يناسب رسم خرائط الديكور الداخلي تمامًا.
وأخيرًا احتاجت كل صورة إلى نص توجيهي. أحد الخيارات هو استخدام تسمية فارغة “”. لكن بما أن النموذج دُرّب أصلًا بنصوص توجيهية، فقد يؤدي ذلك إلى نتائج ضعيفة. اخترت النص الافتراضي نفسه، “interior design”، لكل الصور. من الأفضل مثاليًا أن تولّد شبكة توصيف تلقائي للصور مثل Bootstrapping Language-Image Pre-training (BLIP) نصًا توجيهيًا مخصصًا لكل صورة. وأترك هذا النهج لعمل مستقبلي.
الشكل 2. مفاهيم تصميم غرف النوم التي أنتجها ControlNet المدرَّب على RTX 3090، بحجم دفعة = 4، لمدة 48 ساعة.
الشكل 3. مفاهيم تصميم غرف النوم التي أنتجها ControlNet المدرَّب على RTX 3090، بحجم دفعة = 4، لمدة 48 ساعة.
الشكل 4. مفاهيم تصميم غرف المعيشة التي أنتجها ControlNet المدرَّب على RTX 3090، بحجم دفعة = 4، لمدة 48 ساعة.
الشكل 5. مفاهيم تصميم غرف النوم التي أنتجها ControlNet المدرَّب على RTX 3090، بحجم دفعة = 4، لمدة 48 ساعة.
الخلاصة
تُظهر الأشكال 2–5 أن ControlNet يقدّم نتائج معقولة حتى مع مجموعة بيانات صغيرة. ينجح مرمّز التحكم في إجبار الشبكة على إنتاج صور ذات أشكال متشابهة. وبفضل المعرفة الواسعة بشكل العالم المكاني المرمَّزة أصلًا في نموذج stable diffusion المدرَّب مسبقًا، تظهر صور عالية الجودة منذ بداية التدريب. ولأن Control-Net وحده هو الذي يُدرَّب وتبقى أوزان نموذج Stable Diffusion U-Net دون مساس، يتعلم النموذج الشرط الجديد للصورة فقط مع الاحتفاظ بمعرفته الحالية بالعالم.
يتطلب تحسين النتائج بناء مجموعة بيانات أكبر من الصور الأعلى جودة. ويمكن تحسين النصوص التوجيهية بشبكة BLIP، مما يتيح نصًا مخصصًا لكل صورة ويعزز نتائج النموذج النهائي أكثر. ويشير المؤلفون أيضًا إلى أن التدريب يستفيد من أحجام الدفعات الأكبر، بينما لا يحسّن التدريب الأطول النتائج. غير أن هذا النهج سيتطلب عنقود معالجات رسومية، أو تراكم التدرجات، أو معالج رسومي بذاكرة VRAM تتجاوز 24GB.