MLOps. ինչ է այն և ինչու է կարևոր
Այս հոդվածում բացատրվեցին MLOps-ը, դրա առավելություններն ու պրակտիկաները, և քայլ առ քայլ ցուցադրվեց, թե ինչպես է բաժնետոմսերի գնի կանխատեսման մոդելը հասարակ կարգավորումից առանց MLOps-ի վերածվում ամբողջական MLOps համակարգի։
AI-ի և ML-ի աճի հետ մեկտեղ հանրաճանաչ դարձավ նոր հապավում՝ MLOps։ MLOps-ը Machine Learning Operations-ի կրճատումն է։ Գաղափարի էությունն այն է, որ ML մոդելների ճանապարհը դեպի production լինի սահուն, անվտանգ և լավ կազմակերպված։
Դեռ 2019 թվականին Gap-ի ղեկավարները հայտարարել էին, որ տվյալագիտության նախագծերի 87%-ը երբեք չի հասնում production։ Գուցե հարցնեք՝ «Ինչպե՞ս է դա հնարավոր»։ Հիմնական պատճառն այն է, որ այն ժամանակ բացակայում էին լավ պրակտիկաները, և ընկերությունների մեծ մասում տեղակայումը քաոսային էր։ MLOps պրակտիկաները հայտնվեցին որպես պատասխան դրան։
MLOps-ը գտնվում է 3 հասկացությունների հատման կետում՝ Data Engineering, Machine Learning և DevOps։
Այս հոդվածում ես պարզ լեզվով կնկարագրեմ, թե ինչ է MLOps-ը, ինչպես է այն կիրառվում Machine Learning pipeline-ների համար և ինչու է կարևոր։ Հետո կանցնեմ MLOps պրակտիկաներին և դրանց կապին DevOps-ի հետ։ Վերջում կցուցադրեմ, թե ինչով է տարբերվում համակարգը, երբ այն կառուցված է MLOps-ով և առանց դրա։
Ի՞նչ է MLOps-ը
MLOps-ը պրակտիկաների համակարգ է, որն աջակցում է համագործակցությանը տվյալագետների և օպերացիոն մասնագետների միջև (այսինքն՝ նրանց միջև, ովքեր մոդելներ են կառուցում, և նրանց, ովքեր մոդելներն օգտագործում են որպես ծրագրային բաղադրիչներ)։ Այս պրակտիկաներին հետևելը՝
- բարձրացնում է լուծման որակը,
- պարզեցնում է կառավարումը,
- ավտոմատացնում է մոդելի տեղակայումը production միջավայրում,
- հեշտացնում է բիզնես նպատակներին և կանոնակարգերին համապատասխան մնալը։
Վերևի գծապատկերը ցույց է տալիս, թե ինչպես են Machine Learning ցիկլի տարբեր մասերը կապված իրար հետ։ Այն սկսվում է Data Sourcing-ից և Data Labelling-ից, որին հաջորդում են Experiment tracking-ը, Model Versioning-ը և Model Deployment-ը։ Վերջում մենք վերահսկում ենք կանխատեսումները՝ հետևելու համար, թե ինչպես է օգտագործվում մեր մոդելը։ Բարձր որակն ապահովելու համար MLOps-ը վերահսկում է Machine Learning գործընթացի յուրաքանչյուր հատված։ Հիմա քննարկենք, թե ինչու է դա անհրաժեշտ։
Ինչու է այն կարևոր
MLOps-ը տրամադրում է շրջանակ, որը հեշտացնում է մոդելների ուսուցումն ու տեղակայումը՝ միաժամանակ նվազեցնելով շահագործման ծախսերը։
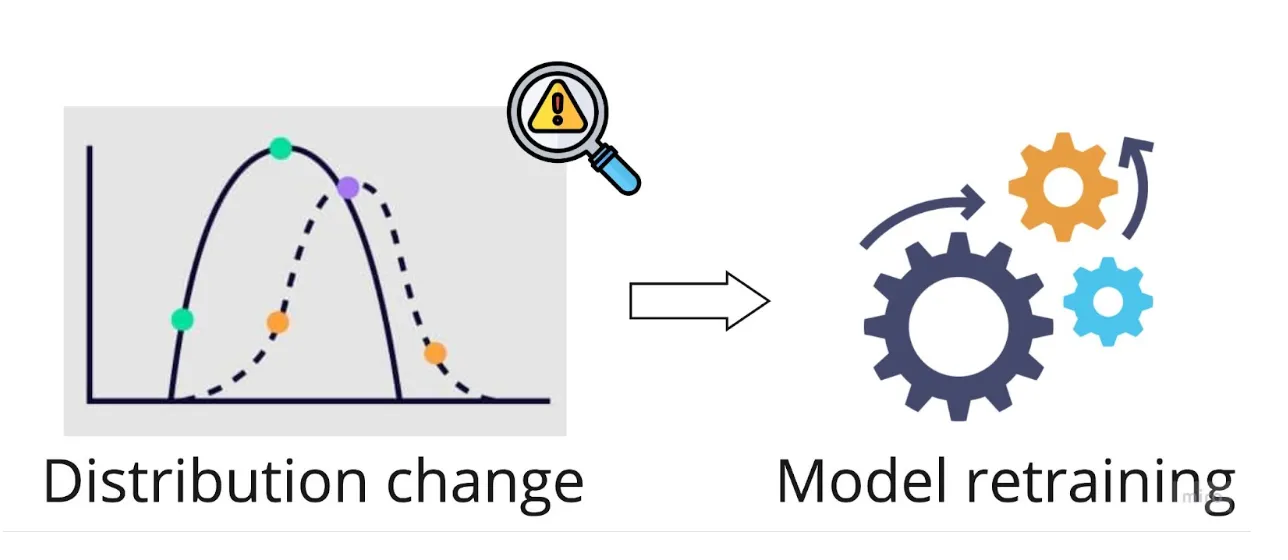
Քանի որ այն համալրված է մոնիթորինգի գործիքներով, կարող է զգալիորեն նվազեցնել ռիսկը։ Երբ մոնիթորինգը կարգավորված է, կարելի է հայտնաբերել բազմաթիվ խնդիրներ, օրինակ՝ data drift (երբ մուտքային տվյալները շեղվում են ուսուցման տվյալներից, և մոդելի արդյունավետությունը կտրուկ ընկնում է. COVID-19 համավարակի ժամանակ Machine Learning մոդելների մեծ մասը խափանվեց հենց այսպիսի անսպասելի անոմալիայից հետո)։
MLOps-ի առկայության դեպքում կարող եք նաև մասշտաբավորել ձեր լուծումը, երբ ավելի շատ տվյալներ եք հավաքում կամ պետք է սպասարկեք 10 անգամ ավելի շատ օգտատերերի։ Այն թույլ է տալիս մոդելի նոր տարբերակները թողարկել աստիճանաբար, թեստավորել դրանք (օրինակ՝ A/B թեստավորմամբ) կամ դինամիկ մասշտաբավորել ըստ անհրաժեշտության (ինչը նվազեցնում է շահագործման ծախսերը, երբ հարցումների ծավալը տատանվում է)։ Դրանից բացի, դուք պահպանում եք վերահսկողությունը տվյալների հավաքածուների և փորձարարական կարգավորումների փոփոխությունների նկատմամբ։
MLOps պրակտիկաներ
MLOps-ի ողջ պարադիգմը պտտվում է իր պրակտիկաների շուրջ։ Ստորև կնկարագրեմ, թե Machine Learning pipeline-ի որ կետերում են այդ պրակտիկաները գործի անցնում՝
- Exploratory data analysis – ուսումնասիրեք և պատրաստեք տվյալները մեքենայական ուսուցման համար՝ կառուցելով վերարտադրելի տվյալների հավաքածուներ, աղյուսակներ և վիզուալիզացիաներ։ Նպատակն է ավելի լավ հասկանալ այն տվյալները, որոնք մտադիր եք օգտագործել հետագա քայլերում։
- Տվյալների պատրաստում և Feature Engineering – իտերատիվ եղանակով կառուցեք feature-ներ փոխակերպված տվյալներից։ Այս փուլում ցանկանում եք կարգավորել feature store, այսինքն՝ ընդհանուր, հեշտ հասանելի պահոց, որը պահում է նախապես հաշվարկված feature-ներ։ Այսպիսի բաղադրիչը թույլ է տալիս թիմերին կիսվել feature-ներով միմյանց հետ։ Տվյալների հավաքածուի կամ feature-ների տարբերակավորումը նույնպես կարևոր է՝ տվյալների հետ աշխատելու լավ պրակտիկաներին հետևելու և դրա փոփոխությունները հետևելու համար։
- Մոդելի ուսուցում և հիպերպարամետրերի կարգավորում – ուսումնասիրեք բաց կոդով գրադարաններ, ինչպիսիք են Scikit Learn, PyTorch կամ TensorFlow։ Եթե ձեզ ավելի պարզ բան է պետք, AutoML-ը տարբերակ է։
- Մոդելի գնահատում և կառավարում – ուսումնասիրեք այնպիսի հարթակներ, ինչպիսին MLFlow-ն է, մոդելի արտեֆակտները, տարբերակները և մոդելի կյանքի ցիկլի անցումները կառավարելու համար։
- Մոդելի inference և սպասարկում – հետևեք inference-ի ժամանակներին, հարցումների հապաղումներին և production-ի հետ կապված QA այլ հարցերին։ Ավտոմատացրեք production-ի հետ կապված pipeline-ները CI/CD գործիքներով, ինչպիսիք են օրկեստրացիան և պահոցները։
- Մոդելի տեղակայում և մոնիթորինգ – ավտոմատացրեք թույլտվությունները, ուղղորդեք տրաֆիկը, մոդելը հասանելի դարձրեք REST API endpoint-ների միջոցով և դինամիկ մասշտաբավորեք ծառայությունը, երբ անհրաժեշտ է։
- Մոդելի ավտոմատ վերաուսուցում – երբ բոլոր շինանյութերն ու մոնիթորինգի գործիքները տեղում են, կարող եք մոդելի ավտոմատ վերաուսուցում ներդնել՝ ամեն անգամ, երբ նկատում եք տվյալների շեղում, մոդելի արդյունավետության անկում, կամ երբ հասանելի է դառնում տվյալների նոր փաթեթ։
MLOps և DevOps
MLOps-ը մեծ ոգեշնչում է քաղել DevOps-ից, դրա հաջողությունից և Software Engineering-ի վրա թողած դրական ազդեցությունից։ Ինչպես DevOps-ի սկզբունքները խթանում են հավելվածների կառուցման արագ և ինտերակտիվ եղանակը, այնպես էլ MLOps-ը նման կանոններ է կիրառում մեքենայական ուսուցման մոդելները production հասցնելու համար։
Միևնույն ժամանակ, MLOps-ը պետք է հաղթահարի լրացուցիչ մարտահրավերներ։ Նախ, MLOps-ն ավելի փորձարարական է, քանի որ ստացված մոդելը սահմանմամբ հավանականային չէ։ Հաշվի առնելով սա, վերարտադրելիությունն ավելի դժվար է ապահովել Machine Learning-ում, քան ծրագրերում։
Բացի այդ, ծրագրային թիմերը բաղկացած են ավելի քիչ տեխնիկական դերերից, ինչպիսիք են UI/UX-ը և PM-ները, ինչպես նաև ավելի տեխնիկական, կոդի վրա կենտրոնացած դերերից, ինչպիսիք են Software engineer-ները։ ML թիմերը ներառում են այս բոլորը, իսկ տեխնիկական անձնակազմը լրացվում է Data Scientist-ներով, Machine Learning Researcher-ներով և Machine Learning Engineer-ներով, որոնցից յուրաքանչյուրը կենտրոնանում է լուծման տարբեր մասի վրա՝ սերտորեն համագործակցելով մյուսների հետ։
Մոդելների թեստավորումը շատ ավելի դժվար է և պակաս կանխատեսելի, քան ծրագրերի թեստավորումը։ ML թեստեր նախագծելու համար դեռ չկա պաշտոնական մոտեցում, մինչդեռ ծրագրերում դա հասուն ոլորտ է՝ բաժանված առանձին շրջանակների (unit, integration, system և acceptance)։ ML համակարգերին լրացուցիչ անհրաժեշտ է մոդելի վալիդացիայի քայլ՝ ծրագրային բոլոր թեստերի վրա ավելի։
Տեղակայման ավտոմատացումն ML աշխարհում ավելի դժվար է, քան ծրագրերում՝ այն բազմաթիվ փոքր ընտրությունների պատճառով, որ Data Scientist-ները կատարում են մոդելի ուսուցման ժամանակ։ Ամբողջ գործընթացն ավտոմատացնելու համար պետք է կրկնօրինակել նրանց տրամաբանությունը և ավելացնել ինչ-որ մոնիթորինգ, որպեսզի կասկածելի որակի մոդելներ չթողարկվեն։
ML համակարգերի վրա կարող են ազդել սեզոնային փոփոխությունները կամ մուտքային տվյալների աստիճանական էվոլյուցիան, ինչը ծրագրային համակարգերում հազվադեպ է պատահում։ Մոդելի արդյունավետությունը կարող է վատանալ ավելի շատ եղանակներով, քան ծրագրային համակարգերում, ուստի սա պետք է հաշվի առնել դրանք նախագծելիս և շահագործելիս։ Մուտքային տվյալների շեղման այսպիսի խնդիրները կարող են առաջանալ հետևյալ պատճառներով՝
- ուսուցման տվյալների և production տվյալների նկատմամբ տարբեր վերաբերմունք։
- սեզոնային անհամապատասխանություն մոդելի ուսուցման և տեղակայման ժամանակների միջև (օրինակ՝ ամառային տվյալներով ուսուցանված մոդելը կարող է վատ աշխատել, երբ ձմեռային ձյունն ընկնի)։
- տվյալների կրկին հավաքման ժամանակ թույլ տրված սխալ ենթադրություններ, որոնք կողմնակալություն են մտցնում վերաուսուցանված մոդելի մեջ։
Մոնիթորինգն ավելի դժվար է, քան դասական ծրագրերում, քանի որ պետք է հետևել նաև մոդելի վարքագիծը նկարագրող բոլոր վիճակագրություններին, կարգավորել ահազանգեր՝ երբ արդյունավետությունն ընկնում է, ապահովել հետադարձ վերադարձ նախորդ տարբերակներին և սահմանել նոր մոդելի ուսուցման մեկնարկիչներ։
MLOps կամ առանց MLOps
Որպեսզի ավելի լավ պատկերացնենք MLOps-ի ազդեցությունը նախագծի վրա, դրա խնդիրներն ու սահմանափակումները, վերցնենք օրինակ, երբ ցանկանում եք կանխատեսել տեխնոլոգիական ընկերության բաժնետոմսի գինը՝ բաժնետոմսի գնի կանխատեսման մոդելով։
Ձեռքի տակ եղած տվյալների վրա ուսուցանված պարզ մոդելով մենք այն կարգավորում ենք թեստային տվյալների ֆիքսված հավաքածուի դեմ։ ML նախագծերը սովորաբար այսպիսի տեսք ունեն. դուք ունեք pipeline, որն աշխատում է ձեր Jupyter Notebook-ում։ Մեր դեպքում մենք ուսուցանեցինք լավ աշխատող մոդել, որը կարողանում է պատմական տվյալներից կանխատեսել Tesla-ի բաժնետոմսի գինը 2021-2022 թվականներին։ Ցավոք, այն չի կարելի օգտագործել ձեր Notebook-ից դուրս, քանի որ դեռ չի տեղակայվել ամպում։
MLOps-ի դեպքում գործընթացն ավելի բարդ է, բայց նաև շատ ավելի օգտակար։
- Ցանկանում եք տարբերակավորված տվյալների հավաքածուներ, քանի որ գիտեք, որ ձեր համակարգը կվարվի ինչպես կենդանի օրգանիզմ և ժամանակի ընթացքում կզարգանա, ուստի տվյալները տարբերակավորում եք։ Սա շատ կարևոր է մեր ML լուծման վերարտադրելիության համար. կարող ենք ցանկանալ ուսուցանել 122 մոդելը 08.2023-ի վերջը ներառյալ տվյալներով, իսկ հաջորդ ամիս այն ընդլայնել մինչև 09.2023-ի վերջ և ուսուցանել 123 մոդելը։ Առանց տվյալների տարբերակավորման 122 մոդելը վերարտադրելը դժվար կլիներ։
- Դուք հենվում եք experiment tracking գործիքի վրա, քանի որ փորձարկում եք հիպերպարամետրերի բազմաթիվ տարբեր համակցություններ։ Մեր օրինակում հիպերպարամետրերը ներառում են ուսուցման հետ կապված ամեն որոշում՝ ինչ ճարտարապետություն (XGBoost, SVR կամ autoregressive ցանց), ինչ learning rate, որքան ժամանակ ուսուցանել, ինչ augmentation կիրառել և այլն։ Վերջում ցանկանում եք բազմաթիվ փորձերից ընտրել լավագույն արդյունավետությամբ, կայուն լուծումը և այն պահել վերահսկողության տակ, ինչը պահանջում է experiment tracking։
- Օգտատերերին կամ այլ մշակողներին հասանելիություն է պետք ձեր մոդելին, ուստի ձեր բաժնետոմսերի կանխատեսման մոդելը տեղակայում եք ամպում (օրինակ՝ Google Cloud-ում կամ AWS-ում) որպես REST API։
- Ձեզ մոնիթորինգ է պետք այն դեպքերի համար, երբ ձեր մոդելի արդյունավետությունը կտրուկ ընկնում է, քանի որ վատ առևտրային որոշումները կարող են ձեզ գումար արժենալ։ Այդ դեպքում պետք է հետ վերադառնալ նախորդ տարբերակին կամ անցնել կանոնների վրա հիմնված համակարգի։
- Եթե մոդելը վատ է աշխատում, մտածեք այն ավելի թարմ տվյալներով վերաուսուցանելու մասին։ Դրա համար ավելացնում եք մոնիթորինգ, տվյալների հավաքածուի ավտոմատ ստեղծում, մոդելի ուսուցում և տեղակայում։ Ճիշտ արված դեպքում դա թույլ է տալիս մոդելին երկար ժամանակ շարունակել շատ լավ աշխատել։
Ամփոփում
Այս հոդվածում բացատրվեցին MLOps-ը, դրա առավելություններն ու պրակտիկաները, և քայլ առ քայլ ցուցադրվեց, թե ինչպես է բաժնետոմսերի գնի կանխատեսման մոդելը հասարակ կարգավորումից առանց MLOps-ի վերածվում ամբողջական MLOps համակարգի։