MLOps – ما هو ولماذا هو مهم
شرح هذا المقال MLOps ومزاياه وممارساته، واستعرض نموذجًا للتنبؤ بالأسهم يتطور من إعداد بسيط بلا MLOps إلى نظام MLOps متكامل.
مع نمو الذكاء الاصطناعي وتعلّم الآلة، اكتسب اختصار جديد شعبية – MLOps. وهو اختصار لعمليات تعلّم الآلة (Machine Learning Operations). وتتمحور الفكرة حول جعل مسار نماذج تعلّم الآلة إلى بيئة الإنتاج سلسًا وآمنًا ومنظمًا جيدًا.
في عام 2019 صرّح مسؤولون تنفيذيون في Gap بأن 87% من مشاريع علم البيانات لا تصل أبدًا إلى الإنتاج. وقد تتساءل: «كيف يمكن ذلك؟». السبب الرئيسي أن الممارسات الجيدة كانت غائبة آنذاك، وكان النشر في معظم الشركات فوضويًا. وظهرت ممارسات MLOps ردًّا على ذلك.
يقع MLOps عند التقاء 3 مفاهيم: هندسة البيانات (Data Engineering)، وتعلّم الآلة (Machine Learning)، وDevOps.
سأصف في هذا المقال بلغة مبسطة ما هو MLOps، وكيف ينطبق على خطوط معالجة تعلّم الآلة، ولماذا هو مهم. بعد ذلك سأستعرض ممارسات MLOps وصلتها بـ DevOps. وأخيرًا سأوضح كيف يختلف النظام عند بنائه مع MLOps وبدونه.
ما هو MLOps؟
MLOps مجموعة من الممارسات تدعم التعاون بين علماء البيانات ومختصي العمليات (أي بين من يبنون النماذج ومن يستخدمونها كمكوّنات برمجية). والالتزام بهذه الممارسات:
- يرفع جودة الحل،
- يجعل الإدارة أبسط،
- يؤتمت نشر النموذج في بيئة الإنتاج،
- يسهّل البقاء متوافقًا مع أهداف العمل واللوائح التنظيمية.
يوضح المخطط أعلاه كيف ترتبط أجزاء دورة تعلّم الآلة المختلفة ببعضها. تبدأ الدورة بمصدر البيانات (Data Sourcing) وتسمية البيانات (Data Labelling)، يليهما تتبّع التجارب (Experiment tracking)، وإصدارات النماذج (Model Versioning)، ونشر النموذج (Model Deployment). وفي النهاية نراقب التنبؤات لنتابع كيفية استخدام نموذجنا. ولضمان جودة عالية، يشرف MLOps على كل جزء من عملية تعلّم الآلة. لنناقش الآن سبب ضرورته.
لماذا هو مهم؟
يقدّم MLOps إطارًا يجعل تدريب النماذج ونشرها أسهل مع خفض تكاليف التشغيل.
ولأنه يأتي مع أدوات مراقبة، يمكنه أن يقلل المخاطر كثيرًا. فبمجرد إعداد المراقبة، يمكنك اكتشاف مشكلات كثيرة، مثل انجراف البيانات (data drift) (عندما تنحرف البيانات الواردة عن بيانات التدريب فينخفض أداء النموذج بشدة؛ ففي أثناء جائحة COVID-19، انهارت غالبية نماذج تعلّم الآلة بسبب شذوذ غير متوقع من هذا النوع تحديدًا).
ومع وجود MLOps، يمكنك أيضًا توسيع نطاق حلّك عندما تجمع بيانات أكثر أو تحتاج إلى خدمة عدد مستخدمين أكبر بعشر مرات. فهو يتيح لك إطلاق إصدارات جديدة من النموذج تدريجيًا، واختبارها (مثل اختبار A/B) أو توسيع النطاق ديناميكيًا حسب الحاجة (ما يخفض تكاليف التشغيل عندما يتذبذب حجم الطلبات). وفوق ذلك، تحتفظ بالتحكم في التغييرات التي تطرأ على مجموعات البيانات وإعدادات التجارب.
ممارسات MLOps
يدور نموذج MLOps بأكمله حول ممارساته. سأصف أدناه في أي نقاط من خط معالجة تعلّم الآلة تدخل هذه الممارسات حيّز التنفيذ:
- تحليل البيانات الاستكشافي – استقصاء البيانات وإعدادها لتعلّم الآلة ببناء مجموعات بيانات وجداول ورسوم بيانية قابلة لإعادة الإنتاج. والهدف هو فهم أفضل للبيانات التي تنوي استخدامها في الخطوات اللاحقة.
- إعداد البيانات وهندسة الخصائص (Feature Engineering) – بناء الخصائص من البيانات المحوّلة بطريقة تكرارية. وفي هذه المرحلة تريد إعداد مخزن خصائص (feature store)، أي تخزين مشترك سهل الوصول يحتوي على خصائص محسوبة مسبقًا. ومكوّن كهذا يتيح للفرق مشاركة الخصائص فيما بينها. كما أن ترقيم إصدارات مجموعة البيانات أو الخصائص ضروري أيضًا لاتباع ممارسات جيدة في التعامل مع مجموعات البيانات وتتبّع تغيّرها.
- تدريب النموذج وضبط المعاملات الفائقة (hyperparameters) – ابحث في المكتبات مفتوحة المصدر مثل Scikit Learn أو PyTorch أو TensorFlow. وإذا كنت تحتاج إلى شيء أبسط، فإن AutoML خيار متاح.
- تقييم النموذج وحوكمته – ابحث في منصات مثل MLFlow لإدارة عناصر النموذج (artifacts) وإصداراته وانتقالاته عبر دورة حياته.
- استدلال النموذج وتقديمه (inference and serving) – تتبّع أزمنة الاستدلال وتأخيرات الطلبات ومجموعة كبيرة من شواغل ضمان الجودة المتعلقة بالإنتاج. وأتمت خطوط المعالجة المتعلقة بالإنتاج بأدوات CI/CD مثل التنسيق (orchestration) والمستودعات.
- نشر النموذج ومراقبته – أتمت الصلاحيات، ووجّه حركة المرور، وأتح النموذج عبر نقاط نهاية REST API، ووسّع الخدمة ديناميكيًا كلما لزم.
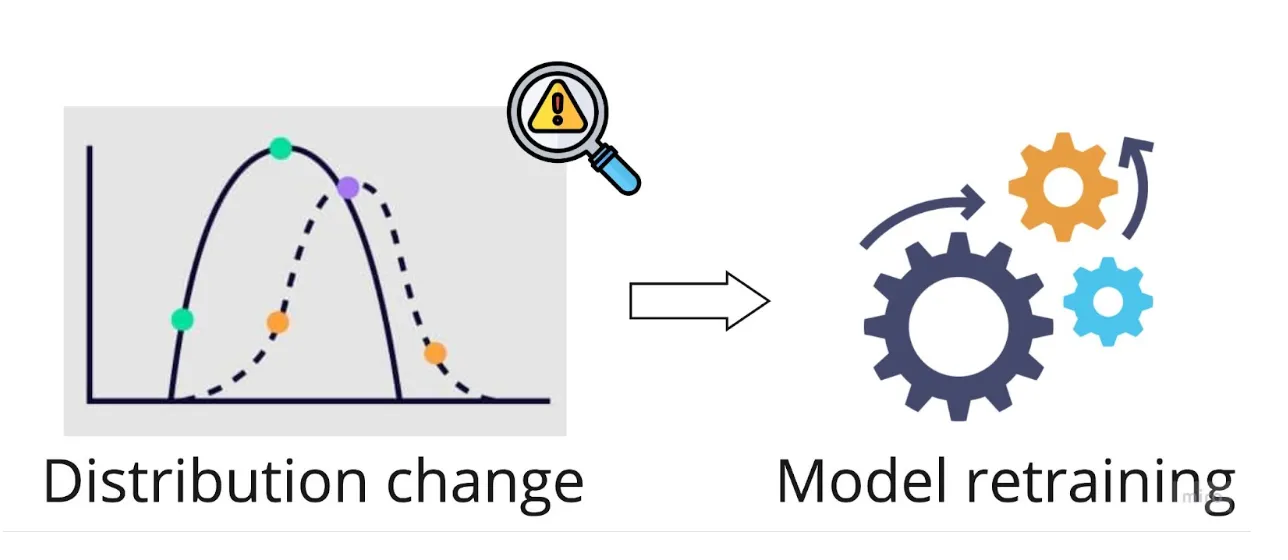
- إعادة تدريب النموذج آليًا – بمجرد توفر جميع اللبنات وأدوات المراقبة، يمكنك اعتماد إعادة تدريب تلقائية للنموذج كلما لاحظت تحولًا في البيانات، أو انخفاضًا في أداء النموذج، أو توفر دفعة جديدة من البيانات.
MLOps مقابل DevOps
استلهم MLOps كثيرًا من DevOps ومن نجاحه ومن أثره الإيجابي في هندسة البرمجيات. وكما تشجّع مبادئ DevOps على أسلوب سريع وتفاعلي لبناء التطبيقات، يطبّق MLOps قواعد مماثلة على إيصال نماذج تعلّم الآلة إلى الإنتاج.
وفي الوقت نفسه، على MLOps أن يتعامل مع تحديات إضافية. أولًا، MLOps أكثر تجريبية، لأن النموذج الناتج ليس احتماليًا بتعريفه. ولهذا يصعب ضمان إمكانية إعادة الإنتاج في تعلّم الآلة أكثر مما في البرمجيات.
وفضلًا عن ذلك، تتكون فرق البرمجيات من أدوار أقل تقنية مثل UI/UX ومديري المنتجات (PMs)، إضافة إلى أدوار أكثر تقنية وتوجهًا نحو الشيفرة مثل مهندسي البرمجيات. وتضم فرق تعلّم الآلة كل هؤلاء، مع توسّع الطاقم التقني بعلماء البيانات وباحثي تعلّم الآلة ومهندسي تعلّم الآلة، يركّز كل منهم على جزء مختلف من الحل مع العمل بتقارب مع البقية.
اختبار النماذج أصعب بكثير وأقل قابلية للتنبؤ من اختبار البرمجيات. فلا يزال لا يوجد نهج رسمي لتصميم اختبارات تعلّم الآلة، بينما هو في البرمجيات مجال ناضج مقسّم إلى نطاقات متمايزة (الوحدة، والتكامل، والنظام، والقبول). وتحتاج أنظمة تعلّم الآلة إضافة إلى ذلك إلى خطوة التحقق من النموذج فوق كل اختبارات البرمجيات.
أتمتة النشر أصعب في عالم تعلّم الآلة منها في البرمجيات بسبب الخيارات الصغيرة الكثيرة التي يتخذها علماء البيانات أثناء تدريب النموذج. ولأتمتة العملية كلها، تحتاج إلى محاكاة منطقهم وإضافة نوع من المراقبة حتى لا تُطلق نماذج مشكوكًا في جودتها.
قد تتأثر أنظمة تعلّم الآلة بالتغيرات الموسمية أو بالتطور التدريجي للبيانات الواردة، وهو أمر نادر الحدوث في أنظمة البرمجيات. وقد يتدهور أداء النموذج بطرق أكثر مما في أنظمة البرمجيات، لذا يجب أخذ ذلك في الحسبان عند تصميمها وتشغيلها. وقد تنتج مشكلات تغيّر البيانات الواردة هذه عن:
- معاملة بيانات التدريب وبيانات الإنتاج معاملة مختلفة.
- عدم تطابق موسمي بين وقت تدريب النموذج ووقت نشره. (مثلًا، قد يؤدي نموذج دُرّب على بيانات الصيف أداءً سيئًا عندما يحل ثلج الشتاء)
- افتراضات غير صحيحة عند جمع البيانات مرة أخرى، تُدخل تحيّزًا في نموذج أُعيد تدريبه.
المراقبة أصعب منها في البرمجيات الكلاسيكية، لأنك تحتاج أيضًا إلى تتبّع كل الإحصاءات التي تصف سلوك النموذج، وإعداد تنبيهات عند انخفاض أدائه، وتمكين التراجع إلى إصدارات سابقة، وتحديد المحفزات لتدريب نموذج جديد.
مع MLOps أو بدونه
لنوضح بصورة أفضل أثر MLOps في المشروع، مع مشكلاته وحدوده، لنأخذ مثالًا تريد فيه توقّع سعر سهم تقني بنموذج للتنبؤ بأسعار الأسهم.
مع نموذج بسيط دُرّب على البيانات المتاحة، نضبطه على مجموعة ثابتة من بيانات الاختبار. وتبدو مشاريع تعلّم الآلة عادةً هكذا: لديك خط معالجة يعمل في Jupyter Notebook. وفي حالتنا دربنا نموذجًا جيد الأداء قادرًا على توقّع سعر سهم Tesla في 2021-2022 انطلاقًا من البيانات التاريخية. للأسف، لا يمكن استخدامه خارج الـ Notebook، لأنه لم يُنشر في السحابة بعد.
مع MLOps تكون العملية أكثر تعقيدًا، لكنها أيضًا أكثر فائدة بكثير.
- تريد مجموعات بيانات ذات إصدارات، لأنك تعلم أن نظامك سيتصرف كالكائن الحي ويتطور مع الوقت، فتُرقّم إصدارات بياناتك. وهذا مهم جدًا لقابلية إعادة إنتاج حل تعلّم الآلة لدينا: فقد نرغب في تدريب النموذج 122 على بيانات حتى نهاية 08.2023، وفي الشهر التالي نمدّها حتى نهاية 09.2023 وندرّب النموذج 123. ودون ترقيم إصدارات البيانات سيصعب إعادة إنتاج النموذج 122.
- تعتمد على أداة لتتبّع التجارب، لأنك تختبر تركيبات كثيرة مختلفة من المعاملات الفائقة. وفي مثالنا تشمل المعاملات الفائقة كل قرار متعلق بالتدريب: أي بنية (XGBoost أو SVR أو شبكة انحدار ذاتي)، وأي معدل تعلّم، وكم مدة التدريب، وأي تعزيز بيانات (augmentation) نطبّق، وهكذا. وفي النهاية تريد اختيار الحل الأفضل أداءً والمستقر من بين تجارب كثيرة والإبقاء عليه تحت السيطرة، وهذا يتطلب تتبّع التجارب.
- يحتاج المستخدمون أو المطورون الآخرون إلى الوصول إلى نموذجك، فتنشر نموذج توقّع الأسهم في السحابة (مثل Google Cloud أو AWS) على هيئة REST API.
- تحتاج إلى مراقبة لحالة انخفاض أداء نموذجك بشدة، لأن قرارات التداول السيئة قد تكلّفك مالًا. وفي هذه الحالة تحتاج إلى التراجع إلى الإصدار السابق أو الرجوع إلى نظام قائم على القواعد.
- إذا كان أداء النموذج سيئًا، ففكّر في إعادة تدريبه على بيانات أحدث. ولذلك تضيف المراقبة وإنشاء مجموعات البيانات آليًا وتدريب النموذج والنشر. وإذا نُفّذ ذلك جيدًا، فإنه يتيح للنموذج مواصلة الأداء الممتاز لفترة طويلة.
الخلاصة
شرح هذا المقال MLOps ومزاياه وممارساته، واستعرض نموذجًا للتنبؤ بالأسهم يتطور من إعداد بسيط بلا MLOps إلى نظام MLOps متكامل.