Դիֆուզիոն մոդելի ավելի արագ ուսուցում Min-SNR-ով
Min-SNR-ը բարելավում է դիֆուզիոն մոդելի ուսուցումը բազմաառաջադրանքային ուսուցման և յուրաքանչյուր առաջադրանքի համար կորստի կշռման միջոցով՝ կոնվերգենցիան դարձնելով 3,4× ավելի արագ, իսկ պատկերի որակը՝ ավելի լավ։
Դիֆուզիոն գործընթացում սկզբնական աղմկոտ պատկերը քայլ առ քայլ մաքրվում է աղմուկից, մինչև ստացվում է մաքուր, բարձր որակի պատկեր։ Այդ սկզբնական աղմկոտ պատկերը պատահական Գաուսյան աղմուկ է։ Աղմկազերծումը կարող է տևել ընդամենը 15 քայլից մինչև հազարավոր քայլեր։ Որպես կանոն՝ ավելի շատ քայլերը տալիս են ավելի լավ պատկեր, թեև շատ մեծ քանակից հետո որակի աճը դառնում է աննշան։ Քանի որ դիֆուզիոնը գեներացնում է իտերատիվ կերպով, ուսուցումը դանդաղ է։ Efficient Diffusion Training via Min-SNR Weighting Strategy հոդվածի հեղինակները ցույց են տալիս, որ ուսուցման նպատակի փոփոխումը՝ բազմաառաջադրանքային ուսուցում օգտագործելու համար, մեծապես արագացնում է մոդելի կոնվերգենցիան՝ հասնելով նախորդ մեթոդներից 3,4× ավելի արագ կոնվերգենցիայի և միաժամանակ բարելավելով FID-ը։
Դանդաղ կոնվերգենցիա
Աղմկազերծող դիֆուզիոն մոդելների ստանդարտ մոտեցումը դանդաղ է կոնվերգենցվում, ուստի մոդելի ուսուցումը պահանջում է բազմաթիվ GPU ժամեր։ Min-SNR-ի հեղինակները ուսումնասիրեցին ուսուցման գործընթացը և գտան որոշ հետաքրքիր արդյունքներ. աղմկազերծման ֆունկցիայի օպտիմալացումը աղմուկի մեկ կոնկրետ մակարդակի (ուսուցման timestep) համար կարող է վնասակար լինել մյուս timestep-երի համար։
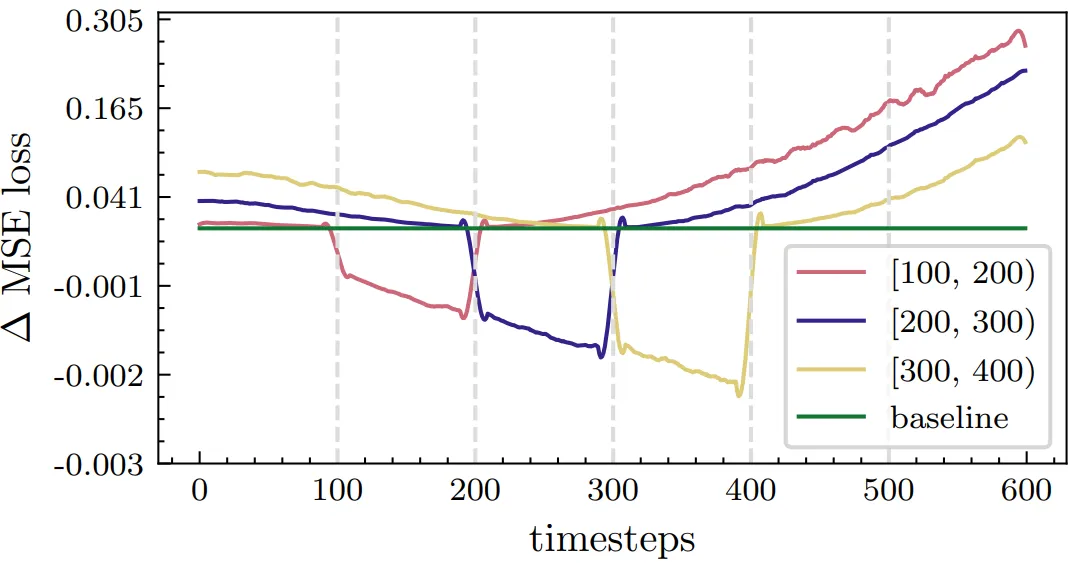
Նկար 1. Դիֆուզիոն-աղմկազերծման timestep-երը խմբավորվել են 100 timestep-ից բաղկացած կլաստերների։ Յուրաքանչյուր կլաստեր անմիջականորեն ճշգրտվել է (fine-tune) միայն իր պարունակած աղմկազերծման մակարդակների վրա։ Կորուստը բարելավվեց հենց կլաստերի և հարևան timestep-երի համար, բայց ճշգրտումը վնասեց ավելի հեռու քայլերին։ Աղբյուր
Նկար 1-ը ցույց է տալիս նախապես ուսուցանված դիֆուզիոն մոդել, որը ճշգրտվում է բացառապես ընտրված աղմկազերծման մակարդակների վրա։ Թեև կորուստը բարելավվում է ճշգրտված timestep-երի և դրանց մոտ գտնվողների համար, մոդելի արդյունավետությունը տուժում է այլ, ավելի հեռու timestep-երի վրա։ Հետազոտողների վարկածն այն է, որ տարբեր քայլեր ունեն տարբեր կարիքներ։ Աղմկազերծման ուժը տարբեր է դիֆուզիոն գործընթացի յուրաքանչյուր քայլում, և տարբեր timestep-եր օպտիմալացումը քաշում են հակասական ուղղություններով։ Հաշվի առնելով սա՝ դիֆուզիոնի բոլոր քայլերն անմիջականորեն հավասար ուժով օպտիմալացնելը հանգեցնում է բազմաթիվ գրադիենտային քայլերի ոչ օպտիմալ ուղղություններով, ինչը զգալիորեն երկարացնում է ուսուցման ժամանակը և մոդելի կոնվերգենցիան։ Առաջարկվող միջոցը բազմաառաջադրանքային ուսուցման մոտեցումն է։
Բազմաառաջադրանքային ուսուցում
Բազմաառաջադրանքային ուսուցման նպատակն է անմիջականորեն օպտիմալացնել մի քանի տարբեր առաջադրանք։ Առաջարկվել են տարբեր մոտեցումներ, այդ թվում՝
- Առաջադրանքների միջև կիսվող feature extractor
- Սովորել, թե ինչը պետք է կիսվի առաջադրանքների միջև
- Պարամետրերի կիսումը մանր մակարդակում
- Կորստի կշռումն ըստ առաջադրանքի՝ հակասական գրադիենտները կանխելու համար
Դիֆուզիոն մոդելն արդեն ունի բոլոր առաջադրանքների կողմից կիսվող մոդուլ՝ ամբողջ U-Net մոդելը։ Ակնհայտ հաջորդ քայլը այլ տեխնիկաները կիսվող մոդելի հետ համադրելն է։ Multi-task learning with deep neural networks: a survey աշխատանքը ամենահեռանկարային ուղղություն է անվանում MTL-ի համար առաջադրանքի ըստ կորստի կշռումը, և հենց այդ ուղղությամբ են գնում Min-SNR-ի հեղինակները։
Եթե աղմկազերծման յուրաքանչյուր մակարդակ դիտարկենք որպես առանձին առաջադրանք, Multi-Task Learning-ը կարելի է կիրառել դիֆուզիոն մոդելի ուսուցման վրա։ Դիֆուզիոն գործընթացի որոշ առաջադրանքներ ավելի դժվար են, քան մյուսները։ Օրինակ՝ վաղ աղմկազերծման մակարդակները բաղկացած են համարյա զուտ աղմուկից, ուստի աղմկազերծման ճիշտ ուղղությունը հստակ չէ, մինչդեռ վերջին աղմկազերծման քայլերն արդեն պարունակում են ձևավորված պատկեր և հիմնականում վերակառուցում են մուտքը։ Ուստի աղմուկի յուրաքանչյուր մակարդակը որպես առանձին առաջադրանք դիտարկելը թույլ է տալիս նրանց տալ տարբեր կարևորություն և համապատասխանաբար կշռել գրադիենտի թարմացումը։ Բոլոր առաջադրանքները միասին օպտիմալացնելը հնարավոր է դարձնում կշիռները ճիշտ ընտրել։ Դրանք ընտրվում են այնպես, որ մեկ մակարդակի գրադիենտային թարմացումը չվնասի մյուս մակարդակներին։ Մնում է գտնել այդ օպտիմալ կշիռները։
Min-SNR
Min-SNR-ը կշռի ուժը որոշում է աղմուկի յուրաքանչյուր մակարդակի Signal-to-Noise մակարդակից։ Ինտուիտիվ կերպով՝ SNR-ը չափում է, թե որքան օգտակար տեղեկատվություն (ազդանշան) է պարունակում պատկերը։
SNR(t) = αt2 /σt2
xt = αtx0 + σtϵ
αt = sqrt(1 − σt2)
, որտեղ ϵ-ն Գաուսյան N(0, I) բաշխումից վերցված աղմուկ է, σt-ն t timestep-ում x0 մաքուր տվյալներին ավելացված աղմուկի մեծությունն է, իսկ αt-ն կարող է կամ սովորվել ռեպարամետրիզացիայի միջոցով, կամ պահվել ֆիքսված՝ որպես հիպերպարամետր։
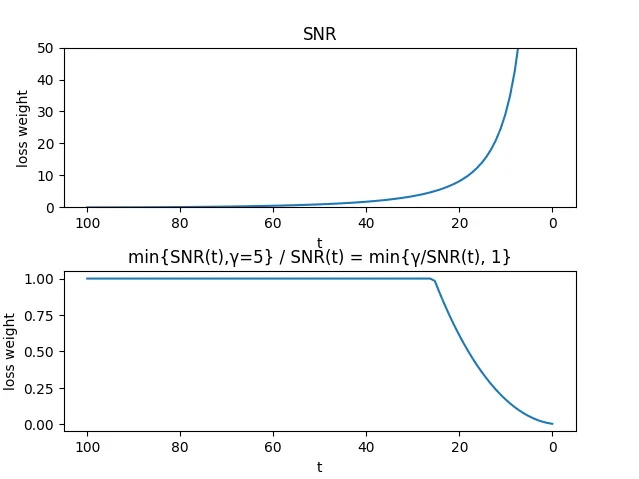
Նկար 2. Վերևի գրաֆիկը ցույց է տալիս 100 քայլի համար նախապես հաշվարկված SNR։ Երբ կիրառվում է min{SNR(t), γ} բանաձևը, այն կարող է ծառայել x ազդանշանը ելքագրող դիֆուզիոն մոդելի կորստի ֆունկցիան կշռելու համար։ Սակայն այս օրերին դիֆուզիոն մոդելների մեծ մասը փոխարենը կանխատեսում է ավելացված աղմուկը։ Ներքևի գրաֆիկը ցույց է տալիս ϵ աղմուկը կանխատեսող դիֆուզիոն մոդելի համար նախապես հաշվարկված կորստի կշիռը։ t=100 ժամանակը դիֆուզիոն գործընթացի առաջին քայլն է, իսկ t=0-ն՝ վերջինը։
Նկատեք, որ SNR-ը կարելի է նախապես հաշվարկել յուրաքանչյուր timestep-ի համար։ SNR-ը ցածր է վաղ աղմկազերծման քայլերի համար և բարձր՝ վերջին աղմկազերծման մակարդակների համար։ Սա ինտուիտիվ իմաստ ունի. վերջին աղմկազերծող շերտերը պատկերի որակը բարելավում են միայն քիչ՝ հիմնականում վերակառուցելով մուտքը, մինչդեռ վաղ աղմկազերծման մակարդակները շատ աղմկոտ են՝ առանց բարելավման հստակ ուղղության։ SNR կշռումը ապահովում է, որ այդ անորոշ վաղ առաջընթաց քայլերը թարմացվեն դանդաղ, իսկ վերջին քայլը, որի թարմացման ուղղությունը ավելի հստակ է, թարմացվի ավելի ուժեղ։
Նկար 3. Աղմուկի մակարդակը timestep-երի վրա։
min-SNR = min{SNR(t), γ}։ y = 5 սահմանելը կանխում է SNR կշռի չափազանց մեծանալը։ Ինչպես ցույց են տալիս հոդվածի հեղինակները և ինչպես երևում է Նկար 4-ում, min-SNR-ը մոդելին ստիպում է կոնվերգենցվել x3.4 անգամ ավելի արագ, քան աղմկոտ բոլոր քայլերը հավասարապես հավանական դիտարկող մոդելը, միաժամանակ բարելավելով FID գնահատականը։
Քանի որ այսօր դիֆուզիոն մոդելների մեծ մասը կանխատեսում է աղմուկը, այլ ոչ թե ազդանշանը, snr կշիռը պետք է շրջել.
wt = min{SNR(t),γ} / SNR(t) = min{ γ / SNR(t) , 1}.
, որտեղ wt-ն նշանակում է t timestep-ի կորստի կշիռը։
y = 5
loss_weight = np.stack([snr, y * np.ones_like(snr)], axis=1).min(axis=1) / snr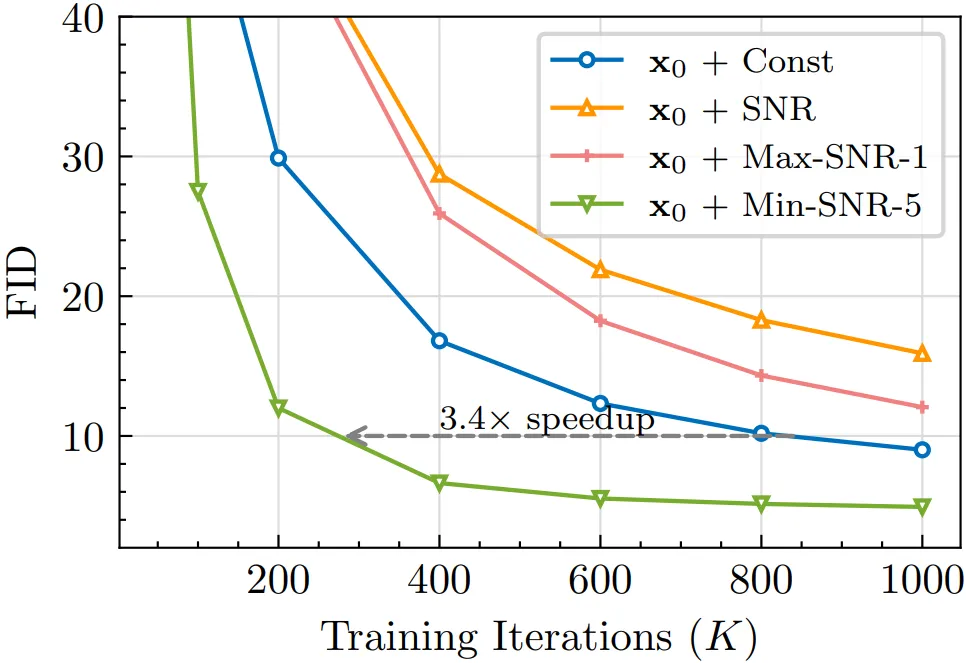
Նկար 4. Կոնվերգենցիայի արագությունը և FID գնահատականը՝ համեմատված ուսուցման տարբեր ռազմավարությունների միջև։ Այս կարգավորման մեջ y = 5-ով min-SNR-ը տալիս է լավագույն արդյունքները։ Աղբյուր
Ամփոփում
Այս բլոգի գրառումը ցույց տվեց, որ դիֆուզիոնի ստանդարտ ուսուցումը դանդաղ է, որովհետև աղմուկի տարբեր մակարդակների գրադիենտային թարմացումները ուղղված են հակասական ուղղություններով, ուստի մեկ մակարդակի թարմացումը կարող է վնասել մյուսներին։ Յուրաքանչյուր timestep-ը որպես առանձին ուսուցման առաջադրանք դիտարկելը թույլ է տալիս օգտագործել բազմաառաջադրանքային ուսուցման մեթոդներ՝ փորձելով կանխել գրադիենտային հակասությունները։ Յուրաքանչյուր առաջադրանքի կորստի կշռումը կարող է արդյունավետորեն հավասարակշռել ավելի դժվար և ավելի հեշտ աղմուկի մակարդակները և ապահովել, որ մեկ մակարդակը չվնասի մյուսներին։ Հոդվածի հեղինակները ցույց են տալիս, որ min-SNR-ը կորստի կշռման արդյունավետ ռազմավարություն է. այն կոնվերգենցիան դարձնում է 3.4x անգամ ավելի արագ և միաժամանակ բարելավում է FID-ը։