تدريب أسرع لنماذج الانتشار (Diffusion) باستخدام Min-SNR
يحسّن Min-SNR تدريب نماذج الانتشار عبر التعلّم متعدد المهام وترجيح الخسارة لكل مهمة، فيجعل التقارب أسرع بمقدار 3.4 مرة وجودة الصور أفضل.
في عملية الانتشار (diffusion)، تُزال الضوضاء من صورة أولية مشوشة خطوة بخطوة حتى تظهر صورة نظيفة عالية الجودة. وتلك الصورة الأولية المشوشة هي ضوضاء غاوسية عشوائية. وقد تستغرق إزالة الضوضاء من 15 خطوة فقط إلى آلاف الخطوات. وكقاعدة، تعطي الخطوات الأكثر صورة أفضل، وإن أصبح المكسب في الجودة ضئيلًا بعد عدد كبير جدًا من الخطوات. ولأن الانتشار يولّد الصور تكراريًا، فإن التدريب بطيء.. يبيّن مؤلفو الورقة Efficient Diffusion Training via Min-SNR Weighting Strategy أن تغيير هدف التدريب ليستخدم التعلّم متعدد المهام يسرّع تقارب النموذج كثيرًا، فيبلغ تقاربًا أسرع بمقدار 3.4 مرة من الطرق السابقة مع تحسين FID أيضًا.
التقارب البطيء
يتقارب النهج القياسي لنماذج الانتشار لإزالة الضوضاء ببطء، لذا يستغرق تدريب النموذج ساعات GPU كثيرة. فحص مؤلفو Min-SNR عملية التدريب ووجدوا نتائج مثيرة للاهتمام: تحسين دالة إزالة الضوضاء لمستوى ضوضاء معين (خطوة تدريب زمنية) قد يضر بالخطوات الزمنية الأخرى.
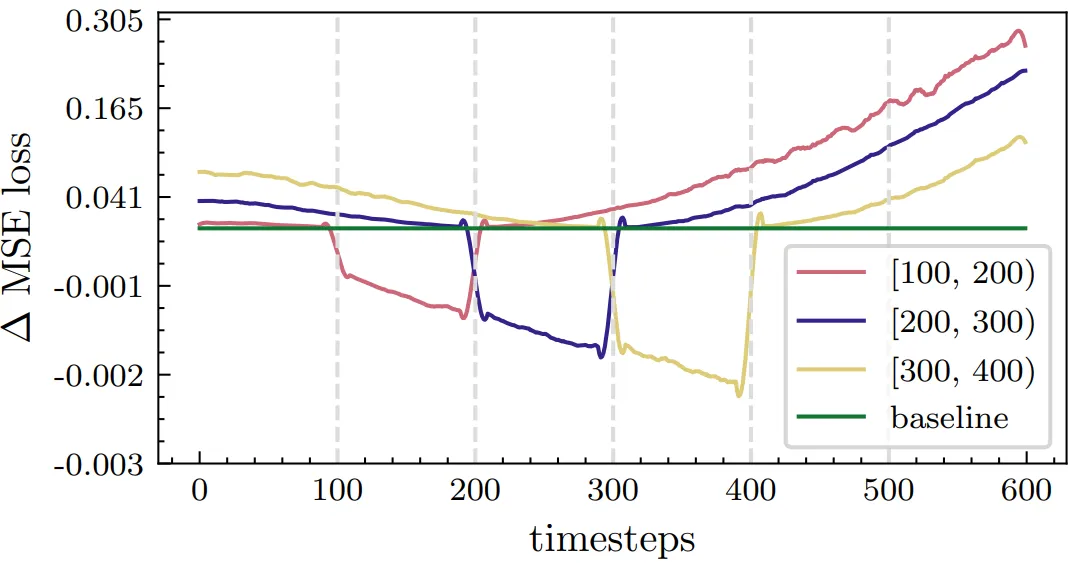
الشكل 1. جُمّعت خطوات الانتشار وإزالة الضوضاء الزمنية في عناقيد، كل منها 100 خطوة زمنية. وضُبط كل عنقود مباشرةً، وعلى مستويات إزالة الضوضاء التي يحتويها فقط. تحسنت الخسارة للعنقود نفسه وللخطوات الزمنية المجاورة، لكن الضبط أضر بالخطوات الأبعد. المصدر
يوضح الشكل 1 نموذج انتشار مدرَّبًا مسبقًا يُضبط حصريًا على مستويات إزالة ضوضاء مختارة. ورغم أن الخسارة تتحسن للخطوات الزمنية المضبوطة وتلك القريبة منها، فإن أداء النموذج يتضرر في خطوات زمنية أخرى أبعد. وفرضية الباحثين أن الخطوات المختلفة لها احتياجات مختلفة. فقوة إزالة الضوضاء تختلف في كل خطوة من عملية الانتشار، وتسحب الخطوات الزمنية المختلفة التحسين في اتجاهات متعارضة. وبناءً على ذلك، فإن تحسين كل خطوات الانتشار مباشرةً وبالقوة نفسها يؤدي إلى خطوات تدرّج كثيرة في اتجاهات دون المثلى، مما يطيل كثيرًا زمن التدريب وتقارب النموذج. والعلاج المقترح هو نهج التعلّم متعدد المهام.
التعلّم متعدد المهام
هدف التعلّم متعدد المهام هو تحسين عدة مهام مختلفة مباشرةً. وقد اقتُرحت نُهج متنوعة، منها:
- مستخرِج ميزات مشترك بين المهام
- تعلّم ما ينبغي مشاركته بين المهام
- مشاركة المعاملات على مستوى دقيق
- ترجيح الخسارة لكل مهمة لمنع التدرجات المتعارضة
يمتلك نموذج الانتشار أصلًا وحدة مشتركة بين كل المهام – نموذج U-Net بأكمله. والخطوة التالية الواضحة هي الجمع بين تقنيات أخرى والنموذج المشترك. تذكر Multi-task learning with deep neural networks: a survey أن ترجيح الخسارة لكل مهمة هو الاتجاه الأكثر واعدية لـ MTL، وهذا هو الاتجاه الذي يسلكه مؤلفو Min-SNR.
إذا عوملت كل مرحلة من مراحل إزالة الضوضاء كمهمة قائمة بذاتها، أمكن تطبيق التعلّم متعدد المهام (Multi-Task Learning) على تدريب نموذج الانتشار. بعض المهام في عملية الانتشار أصعب من غيرها. فمثلًا، تتكون مراحل إزالة الضوضاء الأولى من ضوضاء شبه خالصة، فلا يكون اتجاه إزالة الضوضاء الصحيح واضحًا، بينما تحتوي خطوات إزالة الضوضاء الأخيرة على صورة متشكلة جيدًا وتعيد بناء المدخل في الغالب. لذا فإن معاملة كل مستوى ضوضاء كمهمة منفصلة تتيح لنا منحها مستويات أهمية مختلفة وترجيح تحديث التدرج وفقًا لذلك. ويتيح تحسين كل المهام معًا اختيار الأوزان بشكل صحيح. وتُختار بحيث لا يضر تحديث التدرج عند مستوى ما بالمستويات الأخرى. ويبقى إيجاد تلك الأوزان المثلى.
Min-SNR
يحدد Min-SNR قوة الوزن من مستوى نسبة الإشارة إلى الضوضاء (Signal-to-Noise) لكل مستوى ضوضاء. وبشكل حدسي، يقيس SNR مقدار المعلومات المفيدة (الإشارة) التي تحتويها الصورة.
SNR(t) = αt2 /σt2
xt = αtx0 + σtϵ
αt = sqrt(1 − σt2)
حيث ϵ ضوضاء مسحوبة من التوزيع الغاوسي N(0, I)، وσt مقدار الضوضاء المضافة إلى البيانات النظيفة x0 عند الخطوة الزمنية t، ويمكن تعلّم αt عبر إعادة البَرمَتة أو إبقاؤه ثابتًا كمعاملات فائقة.
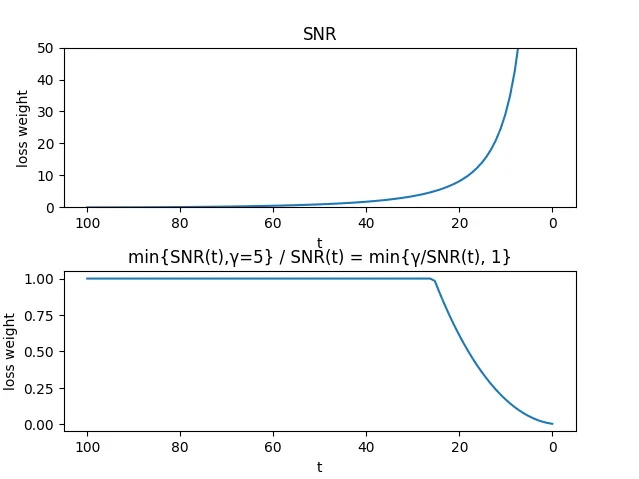
الشكل 2. يوضح الرسم العلوي SNR المحسوب مسبقًا لـ 100 خطوة. وبعد تطبيق الصيغة min{SNR(t), γ}، يمكن استخدامه لترجيح دالة الخسارة لنموذج انتشار يُخرج الإشارة x. لكن في هذه الأيام تتنبأ معظم نماذج الانتشار بالضوضاء المضافة بدلًا من ذلك. ويوضح الرسم السفلي وزن الخسارة المحسوب مسبقًا لنموذج انتشار يتنبأ بالضوضاء ϵ. الزمن t=100 هو الخطوة الأولى من عملية الانتشار، وt=0 هو الأخيرة.
لاحظ أنه يمكن حساب SNR مسبقًا لكل خطوة زمنية. SNR منخفض لخطوات إزالة الضوضاء الأولى ومرتفع لمستويات إزالة الضوضاء الأخيرة. وهذا منطقي حدسيًا: فطبقات إزالة الضوضاء الأخيرة تحسّن جودة الصورة قليلًا فقط، وتعيد بناء المدخل في الغالب، بينما مستويات إزالة الضوضاء الأولى مشوشة جدًا دون اتجاه واضح للتحسين. ويضمن ترجيح SNR أن تُحدَّث هذه الخطوات الأمامية الأولى غير المؤكدة ببطء، بينما تُحدَّث الخطوة الأخيرة، التي يكون اتجاه تحديثها أوضح، بقوة أكبر.
الشكل 3. مستوى الضوضاء عبر الخطوات الزمنية.
min-SNR = min{SNR(t), γ}. يمنع ضبط y = 5 وزن SNR من أن يصبح كبيرًا جدًا. وكما يبيّن مؤلفو الورقة، وكما يوضح الشكل 4، يجعل min-SNR النموذج يتقارب أسرع بمقدار x3.4 مرة من نموذج دُرّب بحيث تتساوى احتمالية كل خطوة مشوشة، مع تحسين درجة FID أيضًا.
ولأن معظم نماذج الانتشار اليوم تتنبأ بالضوضاء بدلًا من الإشارة، يجب عكس وزن snr:
wt = min{SNR(t),γ} / SNR(t) = min{ γ / SNR(t) , 1}.
حيث يشير wt إلى وزن الخسارة للخطوة الزمنية t.
y = 5
loss_weight = np.stack([snr, y * np.ones_like(snr)], axis=1).min(axis=1) / snr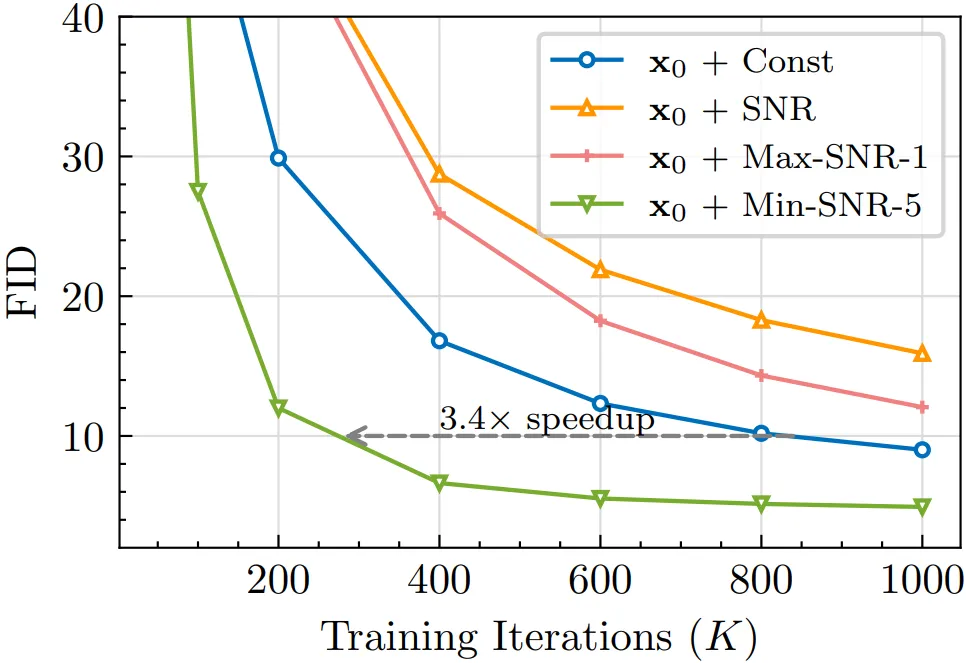
الشكل 4. مقارنة سرعة التقارب ودرجة FID عبر استراتيجيات التدريب. في هذا الإعداد، يعطي min-SNR مع y = 5 أفضل النتائج. المصدر
الخلاصة
أوضحت هذه التدوينة أن تدريب الانتشار القياسي بطيء لأن تحديثات التدرج لمستويات الضوضاء المختلفة تشير إلى اتجاهات متعارضة، فيمكن أن يضر تحديث مستوى ضوضاء واحد بالمستويات الأخرى. ومعاملة كل خطوة زمنية كمهمة تدريب منفصلة تتيح لنا استخدام طرق التعلّم متعدد المهام لمحاولة منع تعارض التدرجات. ويمكن لترجيح خسارة كل مهمة أن يوازن فعليًا بين مستويات الضوضاء الأصعب والأسهل ويضمن ألا يضر مستوى ضوضاء بالمستويات الأخرى. ويبيّن مؤلفو الورقة أن min-SNR استراتيجية ترجيح خسارة فعالة: فهي تجعل التقارب أسرع بمقدار 3.4 مرة وتحسّن FID في الوقت نفسه.