Threads, ThreadPools և Executors – զուգահեռ մշակում Java-ում
Խորը ակնարկ այն մասին, թե ինչպես են աշխատում Java-ի Executor ինտերֆեյսի տարբեր իրականացումները։
Զուգահեռականությունը (concurrency) այն խնդիրների շարքում է, որոնք մենք՝ ծրագրավորողներս, հանդիպում ենք ամենադժվարներից մեկի տեսքով մեր առօրյա աշխատանքում։ Դրան գումարած՝ այն նաև այն խնդիրներից է, որոնց մենք ամենից հաճախ ենք բախվում սովորական առաջադրանքներ կատարելիս։ Հենց դժվարության և հաճախականության այս համադրությունն է զուգահեռականությունն ու բազմաշղթայականությունը դարձնում ամենավտանգավոր ոլորտներից մեկը, որտեղ կարող է մտնել ծրագրային ապահովման ինժեները։
Ավելին՝ զուգահեռականության հետ ցածր մակարդակի աբստրակցիաներով գործ ունենալը կարող է մտավոր առումով հոգնեցուցիչ լինել և հակված է ծնելու բարդ, ոչ դետերմինիստական սխալներ։ Այդ պատճառով լեզուների մեծ մասը առաջարկում է ավելի բարձր մակարդակի աբստրակցիաներ, որոնք թույլ են տալիս զուգահեռականության հետ կապված խնդիրները լուծել բավականին հեշտությամբ՝ առանց ցածր մակարդակի «անջատիչների» հետ խաղալու վրա ժամանակ կորցնելու։
Այս հոդվածում ուզում եմ ավելի մանրամասն քննարկել Java-ի ստանդարտ գրադարանի այդպիսի աբստրակցիաներից մեկը՝ ExecutorService ինտերֆեյսը և նրա իրականացումները։ Հոդվածը նաև մտադիր եմ դարձնել մեկնարկային կետ իմ առաջիկա հոդվածի համար, որը վերաբերում է Java streams-ի բենչմարկինգին։
Բայց սկզբում՝ համառոտ հիշեցում պրոցեսների և թրեդների մասին
Ի՞նչ է պրոցեսը
Պրոցեսը ամենահիմնական միավորն է, որը մեր համակարգիչները կարող են անկախ կերպով գործարկել։ Պրոցեսները թույլ են տալիս մեր մեքենաների կատարած աշխատանքը բաժանել ավելի փոքր, ավելի մոդուլային և ավելի հեշտ կառավարվող մասերի։
Սա թույլ է տալիս առանձին մասերին լինել ավելի կենտրոնացված և, հետևաբար, ավելի արագ։ Նման բաժանումը նաև հնարավորություն է տալիս լիովին օգտագործել մեր պրոցեսորներում ներդրված բազմաթիվ միջուկները։
Ընդհանուր առմամբ՝ յուրաքանչյուր պրոցես որևէ կոնկրետ ծրագրի օրինակ է. օրինակ՝ աշխատող Java պրոցեսը JVM ծրագրի օրինակն է։
Բացի այդ, յուրաքանչյուր պրոցես գոյություն ունի օպերացիոն համակարգի ներսում և ունի ռեսուրսների, թույլտվությունների և վարքագծի (ծրագրային կոդի) սեփական առանձնացված հավաքածու՝ ճիշտ ինչպես մեր հավելվածների օգտատերերը։
Պրոցեսը կարող է պարունակել բազմաթիվ թրեդներ (գոնե օպերացիոն համակարգերի մեծ մասում), որոնք համագործակցում են՝ ավարտելու պրոցեսի իրենց հանձնարարած ընդհանուր առաջադրանքները։
Ի՞նչ է թրեդը
Թրեդը կարելի է պատկերացնել որպես մեր կոդի ճյուղ՝ իր սեփական հրահանգների հավաքածուով, որն աշխատում է զուգահեռաբար հավելվածի մնացած մասի հետ։ Թրեդները հնարավորություն են տալիս մեկ պրոցեսին միաժամանակ կատարել մի քանի հրահանգային հաջորդականություն։
Ծրագրային մակարդակում կարելի է տարբերել թրեդների երկու տեսակ.
- Միջուկի (համակարգային) թրեդներ
Այս թրեդները անմիջապես կառավարվում են օպերացիոն համակարգի կողմից։ Նրանց ստեղծումը, պլանավորումը և կառավարումը կատարում է օպերացիոն համակարգի միջուկը։ - Հավելվածի (օգտատիրոջ) թրեդներ
Այս թրեդները կառավարվում են օգտատիրոջ մակարդակում՝ թրեդների գրադարանի կամ կատարման միջավայրի կողմից՝ անկախ օպերացիոն համակարգից։ Օպերացիոն համակարգի միջուկը չի տեսնում դրանք, ուստի օպերացիոն համակարգը դրանց վերաբերվում է որպես միաթրեդ պրոցեսների։
Այս հոդվածում հիմնականում կենտրոնանում եմ Application թրեդների վրա։ Կանդրադառնամ նաև պրոցեսորի հետ կապված թրեդներին, այսինքն՝ ապարատային թրեդներին, որոնք մեր պրոցեսորների հատկությունն են։ Դրանց քանակը ցույց է տալիս, թե քանի թրեդ կարող է մեր պրոցեսորը միաժամանակ մշակել։
Սկզբունքորեն թրեդները ռեսուրսները կիսում են շատ ավելի թեթև ձևով, քան պրոցեսները։ Պրոցեսի ներսի յուրաքանչյուր թրեդ կարող է մուտք ունենալ իր ծնող պրոցեսին պատկանող բոլոր տվյալներին։
Բացի այդ, յուրաքանչյուր թրեդ կարող է պահել սեփական տվյալները, որոնք սովորաբար կոչվում են Thread local փոփոխականներ (կամ Java-ում՝ ավելի նոր և նախընտրելի ScopedValues)։ Թրեդների միջև փոխանցումը նաև շատ ավելի էժան է, քան պրոցեսների միջև փոխանցումը։
Ի՞նչ է Thread Pool-ը
Thread Pool-ը ավելի կոնկրետ հասկացություն է, քան թրեդը կամ պրոցեսը։ Այն վերաբերում է հավելվածի թրեդներին և նշանակում է մեր հավելվածում օգտագործման համար մատչելի այդպիսի թրեդների հավաքածու։
Նրա վարքագիծը շատ պարզ է. թրեդները pool-ից վերցնում ենք մեկ-մեկ՝ մինչև չմնան, և բոլորը սա է։ Սակայն կա մեկ լրացուցիչ ենթադրություն, այն է՝ որ թրեդները իրենց առաջադրանքն ավարտելուց հետո վերադառնում են pool։
Բնականաբար, հավելվածը կարող է ունենալ մի քանի thread pool, և որքան յուրաքանչյուր pool-ը մասնագիտացված է, այնքան լավ։ Այս մոտեցումը նվազեցնում է մրցակցությունը (contention) հավելվածի ներսում և վերացնում է ձախողման միակ կետերը։ Այսօրվա արդյունաբերական ստանդարտը այն է, որ տվյալների բազայի կապերի համար լինի առնվազն առանձին thread pool։
Threads, ThreadPools և Java
Java-ի ավելի հին տարբերակներում՝ Java 21-ից առաջ, հավելվածում օգտագործվող յուրաքանչյուր թրեդ կապված էր պրոցեսորի թրեդի հետ։ Արդյունքում թրեդները բավականին թանկ և ծանր էին։
Եթե Ձեր Java հավելվածում պատահաբար (կամ դիտավորյալ) ստեղծեք չափազանց շատ թրեդներ, օրինակ՝ կանչելով “new Thread()”, ռեսուրսները կարող եք սպառել շատ արագ, և հավելվածի արդյունավետությունը կտրուկ կընկնի՝ մասամբ այն պատճառով, որ պրոցեսորը ստիպված է լինում շատ կոնտեքստի փոխարկումներ կատարել։
Project Loom-ը, որը մատուցվեց Java 21 թողարկմամբ, նպատակ ուներ լուծել այս խնդիրը՝ Java-ի ստանդարտ գրադարանում ներմուծելով վիրտուալ թրեդներ՝ պրոցեսորի թրեդների հետ չկապված թրեդներ, որոնք հայտնի են նաև որպես green threads։
Java-ն thread pool-ի գաղափարն իրականացնում է ThreadPoolExecutor-ի միջոցով. սա վերջավոր չափի thread pool ներկայացնող դաս է, որի վերին սահմանը որոշվում է նրա կոնստրուկտորի maximumPoolSize պարամետրով։
Ի դեպ, այս Executor-ը ծառայում է նաև որպես ավելի բարդ executor-ների ներքին thread pool։
Executor, ExecutorService և Executors
Նախքան ThreadPoolExecutor-ի վրա հիմնված Executor ինտերֆեյսների ավելի առաջադեմ իրականացումները նկարագրելը՝ ուզում եմ պատասխանել ևս մեկ հարցի. ի՞նչ են հենց Executor-ը և ExecutorService-ը։
- Executor
Executor-ը ինտերֆեյս է՝ ընդամենը մեկ մեթոդով՝ execute, որի սիգնատուրան էvoid execute(Runnable command)։ Ինտերֆեյսը մոդելավորում է շատ պարզ գործողություն. ավելի ճշգրիտ՝ այն հայտարարում է, որ իրականացնող դասը ունակ է այն կատարել՝ գործարկել տրված runnable-ը։ Նրա նպատակը առաջադրանքը ներկայացնելու գործողությունը անջատելն է այն բանից, թե ինչպես է այդ առաջադրանքը կատարվում։ - ExecutorService
ExecutorService-ը մեկ այլ ինտերֆեյս է, որը ընդլայնում է Executor-ը։ Նրա պայմանագիրը շատ ավելի հարուստ է, քան Executor-ինը. եթե որոշենք իրականացնել այն, պետք կլինի վերասահմանել մոտ 13 մեթոդ։ Նրա հիմնական նպատակն է աջակցել ասինխրոն առաջադրանքների կառավարմանն ու գործարկմանը՝ դրանք փաթաթելով Java Future-ի մեջ։ ExecutorService-ը ընդլայնում է նաև Autocloseable ինտերֆեյսը, ուստի այն կարող ենք օգտագործել try-with-resource շարահյուսությամբ և փակել կարգավորված ձևով։ - Executors
Executors դասը, ընդհակառակը, օժանդակ (utility) դաս է։ Սա նոր executor օրինակներ ստեղծելու նախընտրելի եղանակն է. executor-ների մեծ մասի համար new բանալի բառի օգտագործումը խորհուրդ չի տրվում։ Այն նաև առաջարկում է մեթոդներ տարբեր տեսակի callable օրինակներ ստեղծելու համար, օրինակ՝ callable, որը վերադարձնում է ստատիկ արժեք։
Այս երեք հիմնարար հասկացությունները պարզաբանելուց հետո կարող ենք դիտարկել executor service-ի տարբեր իրականացումները։
Executor Services
Այս պահին Java-ի ստանդարտ գրադարանը առաջարկում է ExecutorService ինտերֆեյսի 4 հիմնական իրականացում, որոնցից յուրաքանչյուրն ունի քիչ թե շատ առանձնահատուկ հատկությունների հավաքածու։
Ահա դրանք.
- ThreadPoolExecutor
- ForkJoinPool
- ScheduledThreadPoolExecutor
- ThreadPerTaskExecutor
Բացի դրանցից՝ Executors.class-ը պարունակում է ExecutorService-ի երեք մասնավոր ստատիկ իրականացում.
- DelegatedExecutorService
- DelegatedScheduledExecutorService
- AutoShutdownDelegatedExecutorService
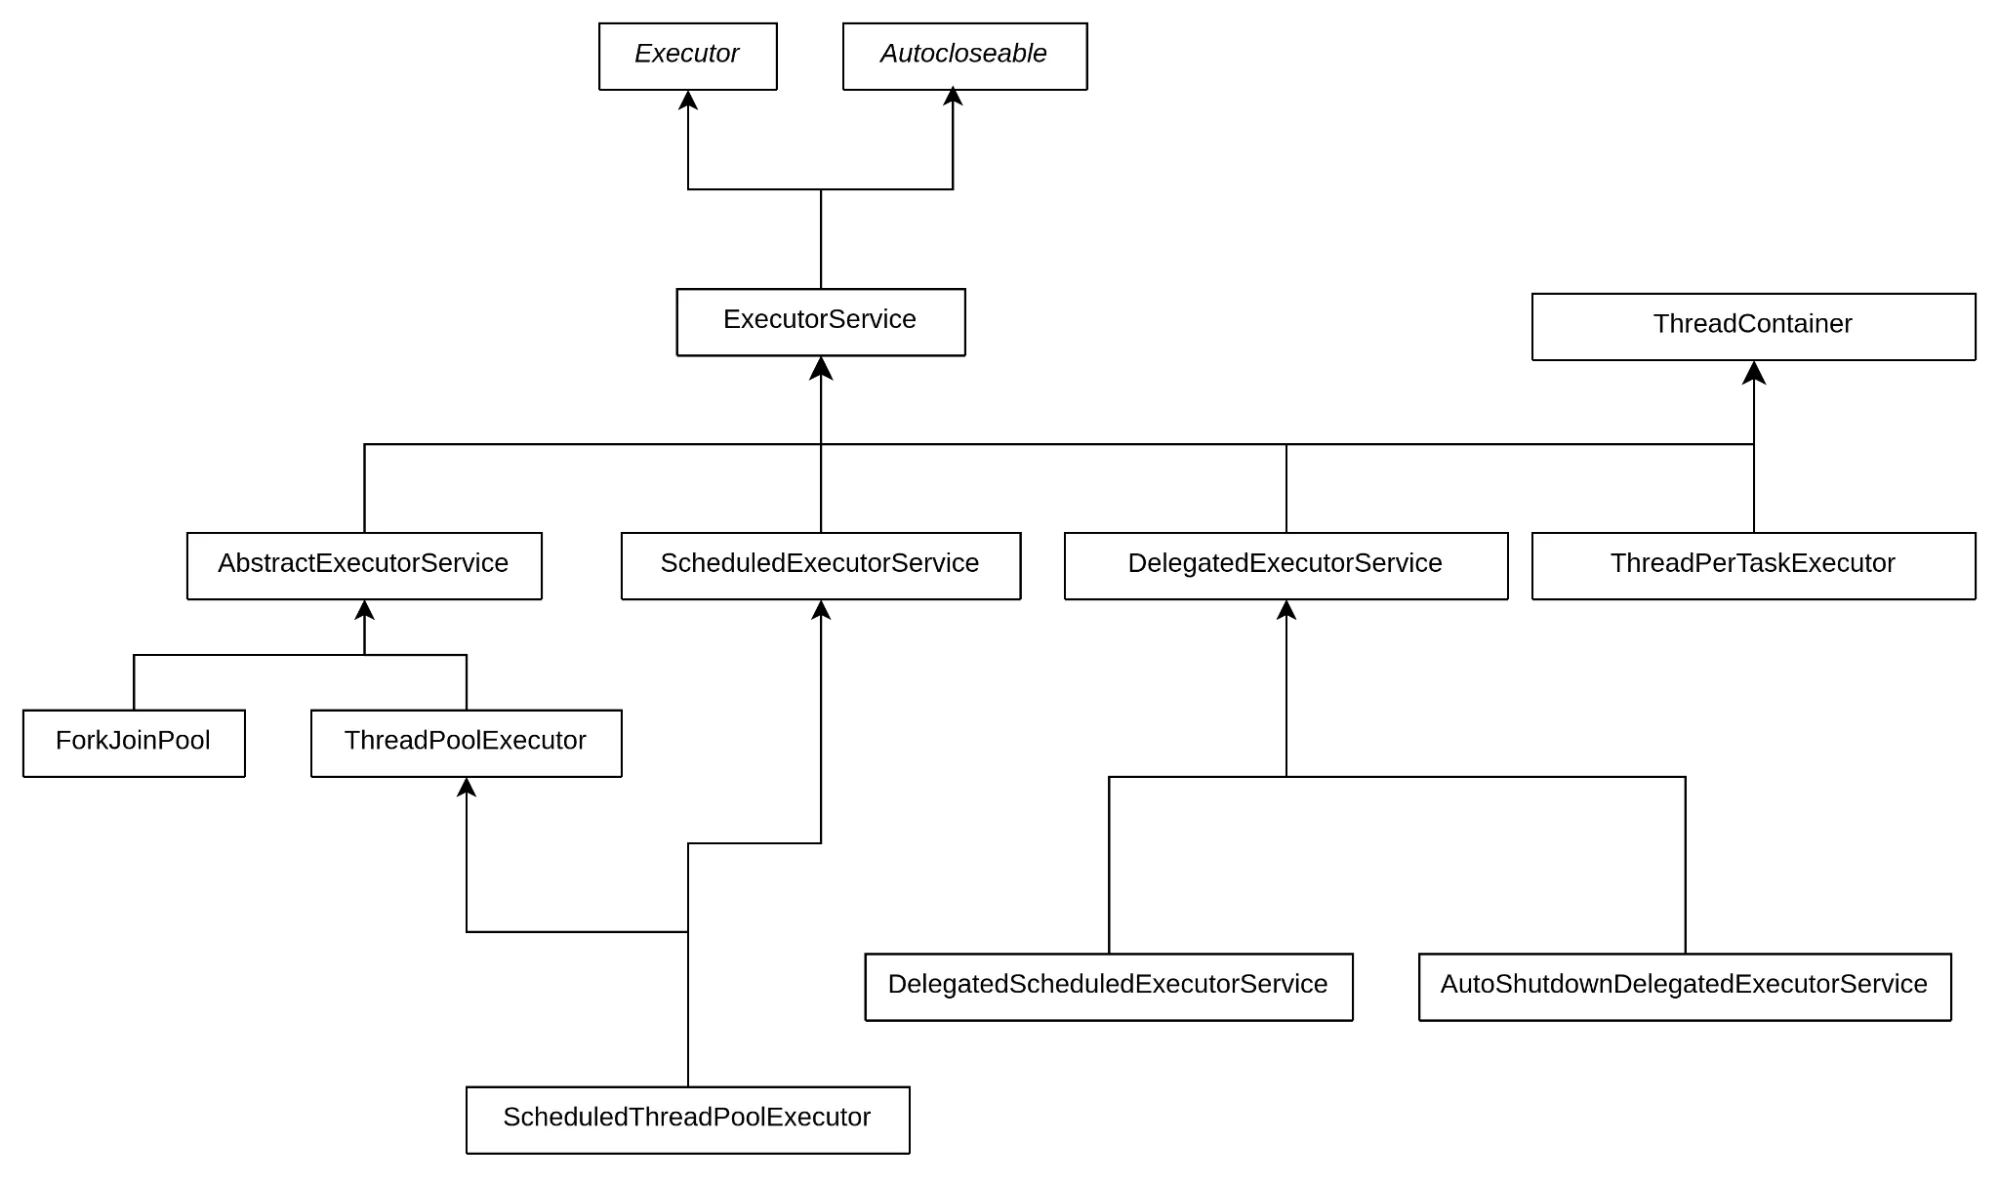
Ընդհանուր առմամբ, այս դասերի միջև կախվածությունները մոտավորապես հետևյալ տեսքն ունեն։
ThreadPoolExecutor
Ինչպես արդեն նշվեց, սա Java-ի իրականացումն է Thread Pool հասկացության։ Executor-ը ներկայացնում է սահմանափակ thread pool՝ փոփոխվող թվով թրեդներով։ Գործնականում սա նշանակում է, որ TheadPoolExecutor-ը աշխատում է թրեդների վերջավոր քանակով, և այդ քանակը երբեք չի կարող գերազանցել Pool-ը ստեղծելիս սահմանված սահմանը։
Այդ նպատակով ThreadPoolExecutor-ը հենվում է երկու փոփոխականի վրա՝ corePoolSize և maximumPoolSize։ Առաջինը՝ corePoolSize-ը, սահմանում է pool-ում թրեդների նվազագույն քանակը. pool-ը դրանք կենդանի է պահում նույնիսկ երբ նրանք պարապ են։
Երկրորդը՝ maximumPoolSize-ը, սահմանում է՝ ինչպես հավանաբար կռահեցիք, Pool-ի ունենալիք թրեդների առավելագույն քանակը։ Սա Pool-ի ներսի թրեդների վերին սահմանն է, և Pool-ը երբեք չի գերազանցի այս պարամետրի արժեքը։
ThreadPoolExecutor-ը նաև ներսում օգտագործում է BlockingQueue՝ մուտքային առաջադրանքներին հետևելու համար։
Ինչպես է վարվում ThreadPoolExecutor-ը
Լռելյայն, երբ ընթացքի մեջ գտնվող թրեդների քանակը ավելի քիչ է, քան corePoolSize-ը, execute մեթոդի կանչը ստեղծում է նոր թրեդ և նրան որպես առաջին աշխատանք հանձնում մուտքային առաջադրանքը՝ նույնիսկ եթե pool-ի որոշ թրեդներ պարապ են։ Եթե pool-ը ինչ-ինչ պատճառով չի կարող նոր Thread ավելացնել, այն անցնում է երկրորդ վարքագծին։
Երբ աշխատող թրեդների քանակը հավասար է corePoolSize-ին կամ գերազանցում է այն, կամ pool-ը չի կարողացել նոր Thread ստեղծել, execute-ի կանչը հանգեցնում է նոր առաջադրանքը հերթում տեղավորելու փորձի։
isRunning(c) && workQueue.offer(command)
Եթե pool-ը դեռ աշխատում է, նրան ավելացվում է նոր թրեդ՝ առանց առաջին առաջադրանքի. սա միակ իրավիճակն է, երբ թրեդը ստեղծվում է առանց որևէ առաջադրանքի։
addWorker(null, false);
Եթե, ընդհակառակը, pool-ն այլևս չի աշխատում, նոր հրամանը հեռացվում է հերթից
!isRunning(recheck) && remove(command)
և pool-ը հետո մերժում է հրամանը RejectedExecutionException-ով
reject(command);
Եթե առաջադրանքը ինչ-ինչ պատճառով հնարավոր չէ ավելացնել հերթին, pool-ը փորձում է նոր թրեդ գործարկել այդ առաջադրանքով՝ որպես նրա առաջինը։
else if (!addWorker(command, false))
Եթե սա նույնպես ձախողվում է, առաջադրանքը մերժվում է, և նետվում է RejectedExecutionException՝ մոտավորապես այսպիսի հաղորդագրությամբ։
Օրինակ՝ Task X rejected from java.util.concurrent.ThreadPoolExecutor@3a71f4dd[Running, pool size = 1, active threads = 1, queued tasks = 0, completed tasks = 0]
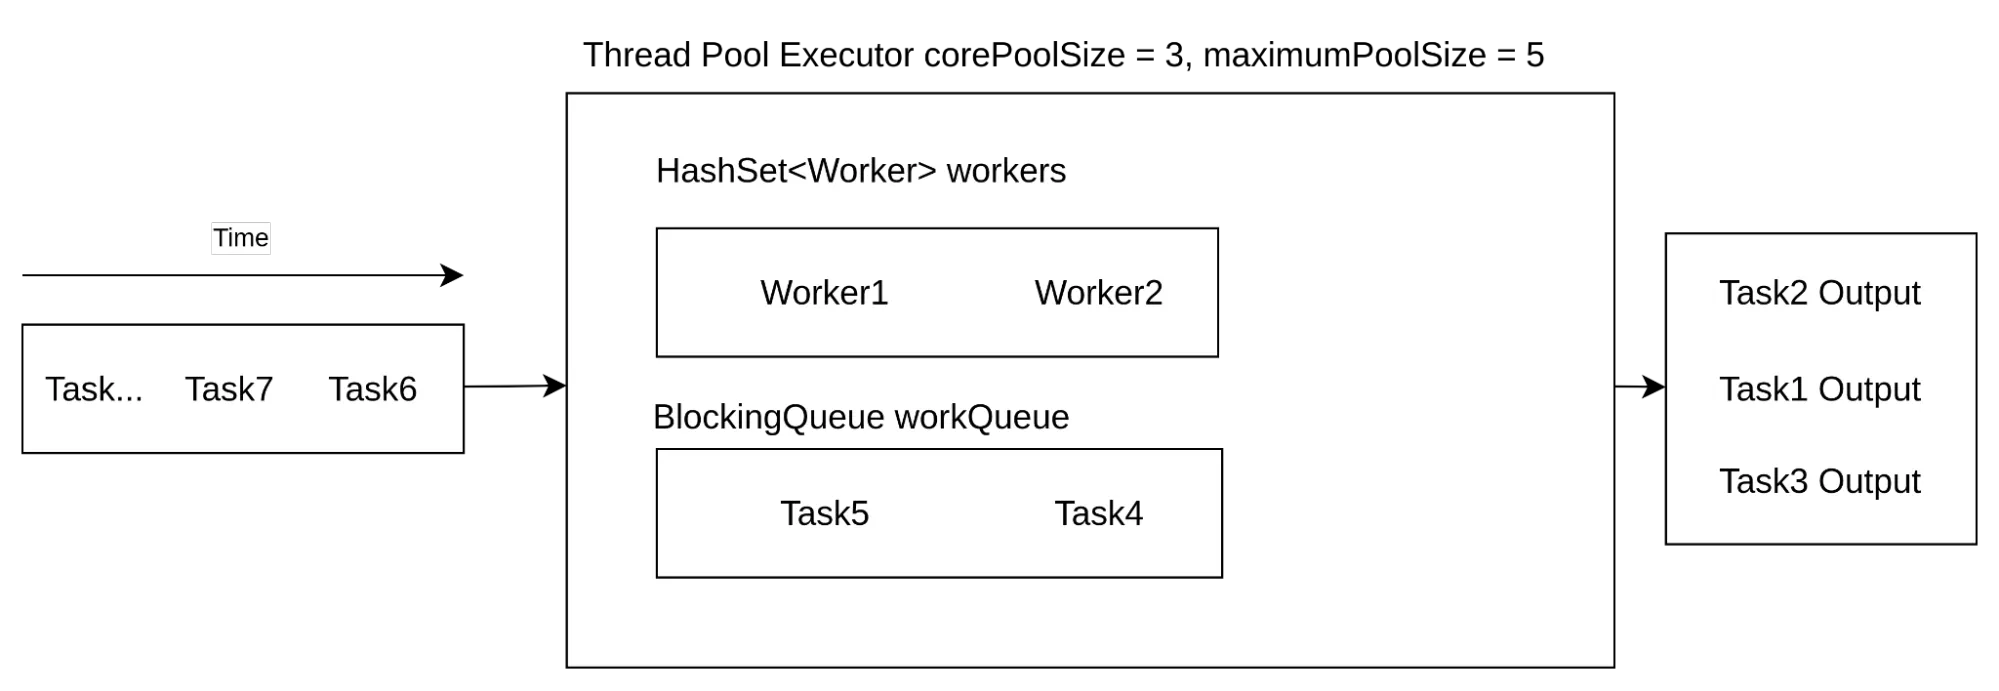
Վերևի նկարը ThreadPoolExecutor-ի ներքին վիճակի խիստ պարզեցված պատկերն է։ Այս կետից կարող է տեղի ունենալ երկու բանից մեկը. կամ Task4-ը (կամ Task5-ը) ավարտում է մշակումը մինչ Task6-ը pool ներկայացվելը, կամ Task6-ը ներկայացվում է մինչ Task4-ի (կամ Task5-ի) ավարտը։
Առաջին դեպքը բավականին ձանձրալի է, քանի որ Executor-ի տեսանկյունից ոչինչ չի փոխվում, ուստի չեմ կանգ առնի դրա վրա։
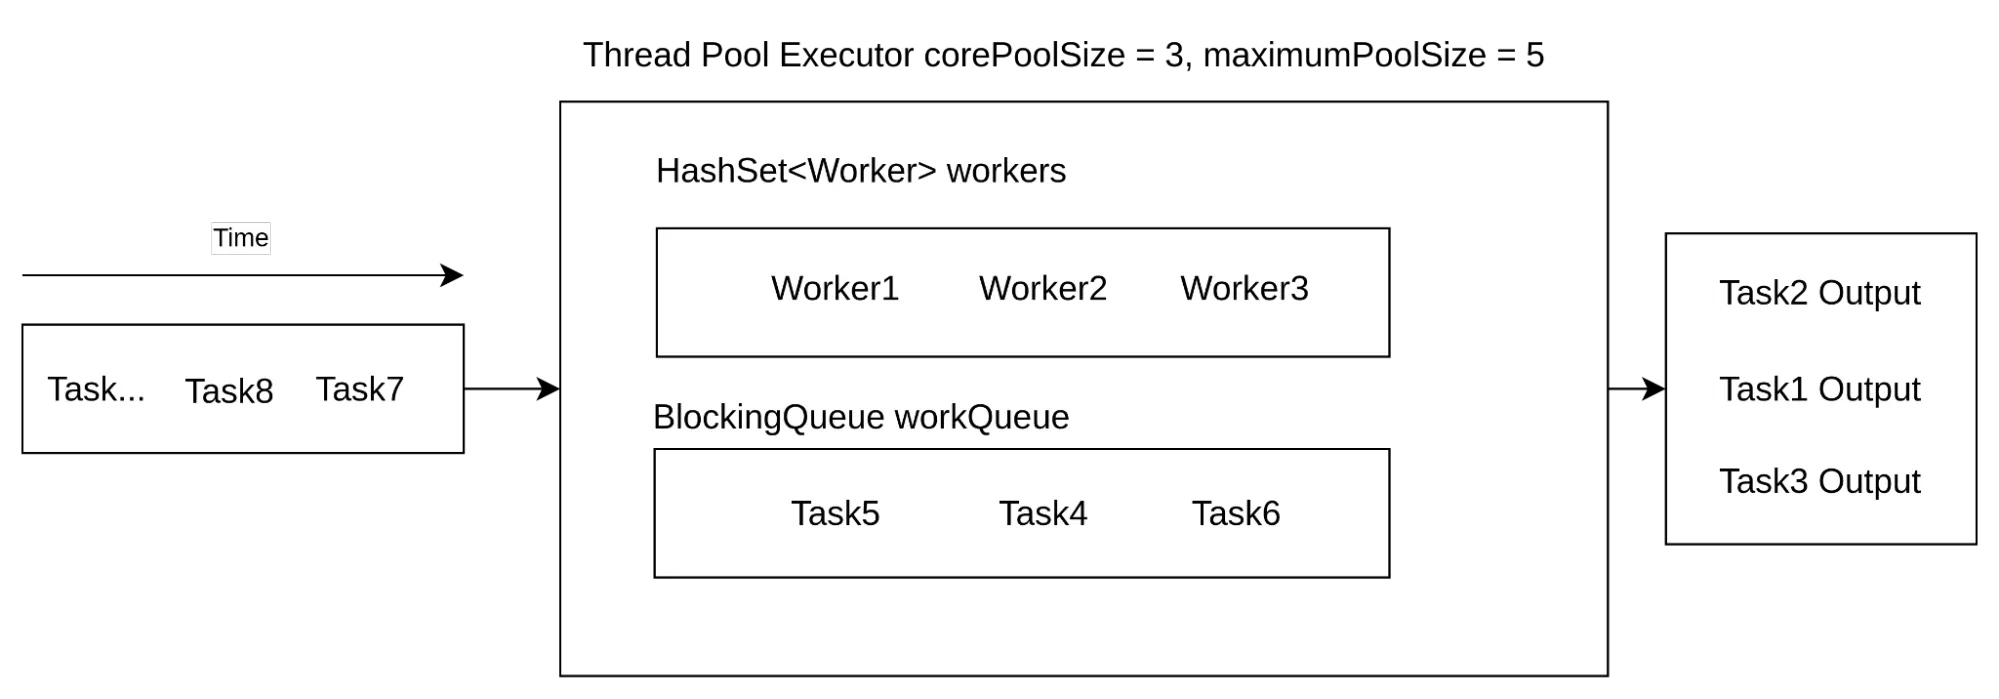
Երկրորդ դեպքը շատ ավելի հետաքրքիր է, քանի որ փոխում է Executor-ի վիճակը։ Քանի որ աշխատող թրեդների քանակը ավելի քիչ է, քան corePoolSize-ը, Task6-ը Executor-ին ներկայացնելը առաջացնում է նոր worker-ի ստեղծում նրա համար։ Ստացված վիճակը կունենա մոտավորապես ստորև բերվածի տեսքը։
ThreadPoolExecutor-ի pool-ի չափը
- Ֆիքսված չափի Pool
corePoolSize-ին և maximumPoolSize-ին նույն արժեքը տալը փաստացի ստեղծում է ֆիքսված չափի thread pool. pool-ի աշխատեցրած թրեդների քանակը երբեք չի իջնի այդ արժեքից ցածր և չի բարձրանա դրանից վեր՝ գոնե ոչ երկար ժամանակով։ - Անսահմանափակ Pool
maximumPoolSize-ը բավականաչափ մեծ արժեքի, օրինակ՝ Integer.MAX_VALUE-ի, դնելը pool-ը գործնականում դարձնում է անսահմանափակ։ ThreadPoolExecutor-ի իրականացումը գործնական սահման է դնում՝ մոտ 500 միլիոն ((2^29)-1) թրեդ, բայց վստահ եմ, որ Ձեր մեքենան շատ ավելի վաղ կկործանվի, քան այդ սահմանին կհասնեք։
Եթե ուզում եք հասկանալ, թե ինչու է հենց այս թիվը սահմանը, կա հիանալի JavaDoc, որը բացատրում է դա և տեղադրված է ThreadPoolExecutor դասի հայտարարությունից անմիջապես հետո։ Որպես ակնարկ՝ դա կապված է նրա հետ, թե ինչպես է ThreadPoolExecutor-ը պահում իր վիճակը։
ThreadPoolExecutor-ի ստեղծումը
Executors դասը ընդհանուր առմամբ առաջարկում է 6 մեթոդ ThreadPoolExecutor ստեղծելու համար։ Դրանք կանցնեմ զույգերով, քանի որ հենց այդպես են նախատեսված օգտագործվելու։
public static ExecutorService newFixedThreadPool(int nThreads)
public static ExecutorService newFixedThreadPool(int nThreads, ThreadFactory threadFactory)
Այս մեթոդները ստեղծում են ֆիքսված չափի thread pool, որտեղ core և max չափերը նույնն են։ Կարող եք նաև threadFactory տալ որպես արգումենտ, եթե չեք ուզում հենվել ստանդարտ գրադարանի լռելյայն factory-ի վրա։
Executors.newFixedThreadPool(2);
Executors.newFixedThreadPool(2, Executors.defaultThreadFactory());
Մեթոդների հաջորդ զույգը.
public static ExecutorService newCachedThreadPool()
public static ExecutorService newCachedThreadPool(ThreadFactory threadFactory)
Այս մեթոդները ստեղծում են փաստացի անսահմանափակ thread pool-եր, քանի որ maxPollSize-ը դրված է Integer.Max. ինչպես FixThreadPool-ի դեպքում, երկրորդ տարբերակը թույլ է տալիս փոխանցել սեփական ThreadFactory։
Executors.newCachedThreadPool();
Executors.newCachedThreadPool(Executors.defaultThreadFactory());
Եվ վերջին զույգը.
public static ExecutorService newSingleThreadExecutor()
public static ExecutorService newSingleThreadExecutor(ThreadFactory threadFactory)
Երկուսն էլ ստեղծում են մեկ թրեդով ապահովված Thread Pool։ Բացի այդ, դրանք ստեղծում են ThreadPoolExecutor-ներ՝ փաթաթված AutoShutdownDelegatedExecutorService-ի մեջ, որը բացահայտում է միայն ExecutorService-ի մեթոդները. ThreadPoolExecutor-ի հատուկ մեթոդներից ոչ մեկը մատչելի չէ։
Բացի այդ, shutdown մեթոդը վերասահմանվում է Cleanable-ի օգնությամբ և կանչվում է, երբ օբյեկտը դառնում է Phantom reachable։
ThreadPoolExecutor-ին նոր առաջադրանքներ ներկայացնելը
ThreadPoolExecutor-ին նոր առաջադրանքներ հանձնելու ստանդարտ եղանակը submit մեթոդի տարբերակներից մեկն է։ Որպես այլընտրանք՝ կարող եք անմիջապես կանչել Executor ինտերֆեյսի execute մեթոդը, թեև սա խորհուրդ տրվող մոտեցում չէ։
execute մեթոդը վերադարձնում է void, այլ ոչ թե Future, ինչը ավելի քիչ վերահսկողություն է տալիս առաջադրանքի կատարման վրա. որոշումը Ձերն է։ Ամեն դեպքում՝ երկու մոտեցումներն էլ անցնում են վերը նկարագրված thread pool-ի ողջ տրամաբանությունով։
Runnable task = () -> System.out.print("test");
Future<?> submit = executorService.submit(task);
ընդդեմ
executorService.execute(task);
ForkJoinPool
ForkJoinPool-ը ExecutorService-ի լիովին առանձին իրականացում է, և նրա գլխավոր առավելությունը work-stealing-ն է։
Work-stealing-ը բավականին բարդ գաղափար է, որը արժանի է առանձին բլոգային գրառման։ Սակայն աբստրակցիայի բավականաչափ բարձր մակարդակում այն կարելի է բացատրել շատ պարզ. pool-ի յուրաքանչյուր թրեդ փորձում է կատարել pool ներկայացված ցանկացած առաջադրանք՝ անկախ այն բանից, թե որ թրեդն է սկզբում ունեցել այն։
Այստեղից էլ անվանումը՝ work stealing. թրեդները միմյանցից «գողանում» են աշխատանքը։ Տեսականորեն սա պետք է նկատելի արդյունավետության աճ ապահովի, մասնավորապես երբ ներկայացված առաջադրանքները փոքր են կամ ստեղծում են հետագա ենթաառաջադրանքներ։
Մտադիր եմ մոտ Future-ում հրապարակել առանձին գրառում work-stealing-ի և ForkJoinFramework-ի մասին։ Մինչ այդ կարող եք work-stealing-ի մասին ավելին իմանալ այստեղ։
Ինչպես է վարվում ForkJoinPool-ը
Այս executor-ը պատկանում է Java ForkJoin framework-ին, որը ներմուծվել է Java 7-ում. սա դասերի հավաքածու է, որի նպատակը զուգահեռ առաջադրանքների մշակումը work stealing-ի միջոցով ավելի արդյունավետ դարձնելն է։ Այսօր framework-ը ակտիվորեն օգտագործվում է CompletableFuture-ի և Streams-ի համատեքստում։
ForkJoinPool-ից առավելագույնը քամելու համար խորհուրդ եմ տալիս սովորել ForkJoin framework-ը ամբողջությամբ, ապա հարմարեցնել նման առաջադրանքների մշակման ձևը, որպեսզի այն ավելի լավ համապատասխանի ForkJoin-ի պահանջներին։
Նախքան ForkJoin framework-ի մեջ գլխիվայր նետվելը՝ կատարեք բենչմարկներ և արդյունավետության թեստեր, քանի որ իրական շահույթը կարող է զիջել սպասելիքներին։
ForkJoinPool-ի Java docs-ը նաև պարունակում է աղյուսակ, որտեղ թվարկված են այն մեթոդները, որոնք պետք է օգտագործել ForkJoinPool-ի հետ փոխազդելիս՝ լավագույն արդյունքի հասնելու համար։
ForkJoinPool-ի հիմնական պարամետրը parallelism-ն է, որը սահմանում է, թե քանի worker թրեդ է օգտագործում pool-ը։ Լռելյայն այն հավասար է Ձեր պրոցեսորի հասանելի պրոցեսորների քանակին։ Սա գոնե համապատասխան կարգավորում է դեպքերի մեծ մասում, և խորհուրդ չեմ տա փոխել այն առանց պատշաճ արդյունավետության թեստավորման։
Հիշեք, որ Java-ի թրեդները CPU bound են, ուստի մենք կարող ենք արագ սպառել մեր առաջադրանքների առաջընթացի համար անհրաժեշտ հաշվողական հզորությունը։
ForkJoinPool օրինակների ստեղծումը
Executors դասը առաջարկում է ForkJoinPool օրինակներ ստեղծելու երկու մեթոդ
Executors.newWorkStealingPool();
Executors.newWorkStealingPool(2);
Առաջինը ստեղծում է forkJoinPoll՝ լռելյայն parallelism-ով, այսինքն՝ հասանելի պրոցեսորների քանակով, իսկ երկրորդը թույլ է տալիս parallelism-ի մակարդակը ընտրել ինքներս։
Ավելին՝ Executors-ը ստեղծում է ForkJoinPool՝ FIFO հերթով, մինչդեռ ForkJoinPool-ի սեփական լռելյայնը (օրինակ՝ new ForkJoinPool(2)-ի միջոցով) LIFO է։ LIFO-ն չի կարելի օգտագործել Executors-ի հետ։ Հիմքում ընկած հերթի տեսակը դեռ կարող եք փոխել ForkJoinPool դասի asyncMode կոնստրուկտորի պարամետրով։
FIFO կարգավորման դեպքում ForkJoinPool-ը կարող է ավելի հարմար լինել այն առաջադրանքների համար, որոնք երբեք չեն join արվում, օրինակ՝ callable-ների կամ runnable-ների հետ օգտագործելիս։
ScheduledThreadPoolExecutor
ScheduledThreadPoolExecutor-ը դասական ThreadPoolExecutor-ի վրա շերտ է կառուցում, որը թույլ է տալիս առաջադրանքներ պլանավորել։
Այն առաջարկում է պլանավորման երեք տեսակ.
- մեկ անգամ կատարել ֆիքսված հապաղումից հետո – schedule
- կատարել ժամանակի յուրաքանչյուր տրված միավորից հետո – scheduleAtFixedRate
- կատարել կատարումների միջև ֆիքսված հապաղումով – scheduleWithFixedDelay
Իհարկե, «սովորական» ExecutorService API-ն նույնպես հասանելի է։ Պարզապես հիշեք, որ այստեղ submit և execute մեթոդները համարժեք են schedule-ի կանչին՝ 0 հապաղումով, այսինքն՝ տրված առաջադրանքը կատարվում է անմիջապես։
Քանի որ ScheduledThreadPoolExecutor-ը ընդլայնում է ThreadPoolExecutor-ը, նրա իրականացման մի մասը համընկնում է դասական ThreadPoolExecutor-ի հետ։ Սակայն այն օգտագործում է առաջադրանքի իր սեփական իրականացումը՝ ScheduledFutureTask-ը, և իր սեփական հերթը՝ DelayedWorkQueue-ն։
Բացի այդ, ScheduledThreadPoolExecutor-ը որպես հիմքի thread pool միշտ օգտագործում է ֆիքսված չափի ThreadPoolExecutor, ինչը նշանակում է, որ corePoolSize-ը և MaxPoolSize-ը միշտ նույնն են։
Այդուհանդերձ, ScheduledThreadPoolExecutor-ի իրականացումը թաքցնում է մեկ-երկու թակարդ։
- Նախ՝ երբ երկու առաջադրանք պլանավորված են (կամ դառնում են պլանավորված) նույն պահի համար, դրանք կատարվում են FIFO կարգով՝ ըստ ներկայացման ժամանակի։
- Երկրորդ թակարդը տրամաբանորեն բխում է առաջինից. ոչինչ իրականում չի երաշխավորում, որ տրված առաջադրանքը կկատարվի որոշակի պահին. այն, օրինակ, կարող է խրված մնալ նախորդ կետում նկարագրված հերթում։
- Վերջապես, եթե երկու առաջադրանքների կատարումները ինչ-ինչ պատճառով համընկնեն, thread pool-ը երաշխավորում է, որ առաջինի կատարումը «happens before» է հետագայինի նկատմամբ։ Այլ կերպ ասած՝ FIFO կարգը գործում է նույնիսկ տարբեր թրեդներից ներկայացված առաջադրանքների համար։
ScheduledThreadPoolExecutor-ի ստեղծումը
Executors դասը առաջարկում է ScheduledThreadPoolExecutor ստեղծելու հինգ եղանակ, խմբավորված ThreadPoolExecutor-ի համար նախատեսվածների նման։
ScheduledThreadPoolExecutor՝ թրեդների ֆիքսված քանակով.
Executors.newScheduledThreadPool(2);
Executors.newScheduledThreadPool(2, Executors.defaultThreadFactory());
Առաջին մեթոդը ստեղծում է ScheduledThreadPoolExecutor՝ թրեդների տրված քանակով, իսկ երկրորդը լրացուցիչ թույլ է տալիս մեր ընտրած ThreadFactory տրամադրել։
ScheduledThreadPoolExecutor՝ մեկ թրեդով.
Executors.newSingleThreadScheduledExecutor();
Executors.newSingleThreadScheduledExecutor(Executors.defaultThreadFactory());
Սրանք ստեղծում են SingleThreadScheduledExecutor, որի հիմքի ThreadExecutorPool-ը պարունակում է ընդամենը մեկ թրեդ։ Իրականում ստանում ենք DelegatedScheduledExecutorService-ի օրինակ, որը պատվիրակում է ScheduledThreadPoolExecutor-ին, ուստի ի վերջո պատվիրակի հիմքի ThreadExecutorPool-ն ունի մեկ թրեդ։
ScheduledThreadPoolExecutor ստեղծելու վերջին եղանակը.
Executors.unconfigurableScheduledExecutorService(new DummyScheduledExecutorServiceImpl());Այս մեթոդը փաթաթում է ScheduledExecutorService ինտերֆեյսի Ձեր սեփական իրականացումը DelegatedScheduledExecutorService-ի մեջ՝ Executors-ի ներսի մասնավոր ստատիկ դասերից մեկի, որը բացահայտում է միայն ScheduledExecutorService ինտերֆեյսի մեթոդները։
Որոշակի իմաստով սա կարելի է դիտարկել որպես ինկապսուլյացիայի օգնական. Ձեր իրականացումը կարող է ունենալ բազմաթիվ public մեթոդներ, բայց պատվիրակի մեջ փաթաթվելուց հետո դրանք բոլորը թաքցվում են օգտատերերից։
Ինձ իրականում դուր չի գալիս ինկապսուլյացիայի այս մոտեցումը. դա պետք է լինի իրականացման հոգսը։ Թեև գուցե ես աչքաթող եմ անում պատվիրակների մեկ այլ կարևոր կիրառություն։
ThreadPerTaskExecutor
Սա Java-ի ստանդարտ գրադարանի և Executors դասի ամենավերջին լրացումներից մեկն է։ Այն ոչ թե thread pool-ի իրականացում է, այլ թրեդներ ծնող մեխանիզմ (thread spawner)։ Ինչպես անունն է հուշում, յուրաքանչյուր ներկայացված առաջադրանք ստանում է իր սեփական թրեդը՝ կապված նրա կատարման հետ, և այդ թրեդը սկսվում է, երբ առաջադրանքի մշակումը սկսվում է։
Սա աշխատեցնելու համար executor-ը օգտագործում է Future-ի իր սեփական իրականացումը՝ ThreadBoundFuture-ը։ Այս executor-ների ստեղծած թրեդների կյանքի ցիկլը մոտավորապես հետևյալն է.
- Թրեդը ստեղծվում է Future-ի հետ միաժամանակ,
- Թրեդը սկսում է աշխատել միայն այն ժամանակ, երբ Executor-ը ծրագրային եղանակով գործարկում է այն
- Թրեդը ընդհատվում է, երբ ընդհատվում է Future-ը
- Թրեդը կանգ է առնում, երբ Future-ը ավարտվում է
Բացի այդ, երբ Executor-ը չի կարողանում տրված առաջադրանքի համար նոր թրեդ գործարկել, և այդ ընթացքում բացառություն չի առաջանում, Executor-ը RejectedExecutionException կնետի։
ThreadPerTaskExecutor-ը նաև պահում է աշխատող թրեդների բազմություն։ Ամեն անգամ, երբ թրեդ է սկսվում, այն ավելացվում է բազմությանը, և ամեն անգամ, երբ թրեդը կանգ է առնում, հեռացվում է դրանից։
threadCount() մեթոդի միջոցով այս բազմությունը կարող եք օգտագործել՝ ստուգելու, թե Executor-ը տվյալ պահին քանի թրեդ է աշխատեցնում։
ThreadPerTaskExecutor-ի ստեղծումը
Executors դասը այս Executor-ը ստեղծելու երկու եղանակ է առաջարկում, և իմ կարծիքով մեկը մյուսից նախընտրելի է։ Սկսենք այն եղանակից, որը չեմ խորհուրդ տալիս։
Executors.newThreadPerTaskExecutor(Executors.defaultThreadFactory());
Այս մեթոդը ստեղծում է ThreadPerTaskExecutor՝ օգտագործելով տրված thread factory-ն։ Պատճառը, թե ինչու եմ ես գոնե խորհուրդ չեմ տալիս սա, այն է, որ ThreadPerTaskExecutor-ի այդպիսի օրինակը աշխատում է հին լավ CPU-bound Java թրեդների վրա։
Այդ իրավիճակում Executor-ի միջով բավականաչափ մեծ քանակությամբ առաջադրանքներ անցկացնելը շատ, շատ հեշտությամբ կարող է սպառել Ձեր հավելվածի հաշվողական հզորությունը։
Անշուշտ, ոչինչ չի խանգարում կիրառել հետևյալ «հնարքը» և այնուամենայնիվ օգտագործել վիրտուալ թրեդներ։
Executors.newThreadPerTaskExecutor(Thread.ofVirtual().factory());
Բայց դրա իմաստ չկա, երբ փոխարենը կարելի է պարզապես օգտագործել սա։
Executors.newVirtualThreadPerTaskExecutor();
ThreadPerTaskExecutor-ի այս օրինակը լիովին օգտագործում է Java 21-ի վիրտուալ թրեդները։ Այս կարգավորումը նաև պետք է էապես մեծացնի այն առաջադրանքների քանակը, որ Ձեր Executor-ը կարող է մշակել՝ մինչև հաշվողական հզորության սպառվելը։
Ամփոփում
Ինչպես ցույց տրվեց վերևում, Java-ն առաջարկում է executor-ների լայն տեսականի՝ ThreadPoolExecutor-ի դասական ThreadPool իրականացումից մինչև ավելի բարդ executor-ներ, ինչպես ThreadPerTaskExecutor-ը, որը լիովին օգտագործում է վիրտուալ թրեդները՝ Java 21-ի հնարավորություն։
Ավելին՝ յուրաքանչյուր Executor իրականացում ունի իր առանձնահատուկ բնութագիրը։
- ThreadPoolExecutor – դասական ThreadPool իրականացում
- ForkJoinPool – work-stealing
- ScheduledThreadPoolExecutor – պարբերական առաջադրանքների պլանավորում
- ThreadPerTaskExecutor – վիրտուալ թրեդների օգտագործում և յուրաքանչյուր առաջադրանքը իր կարճակյաց թրեդում կատարելու հնարավորություն։
Չնայած այս տարբերություններին՝ բոլոր executor-ները կիսում են մեկ սահմանող բնութագիր. յուրաքանչյուրը բացահայտում է API, որը շատ ավելի պարզ է դարձնում մեծ թվով առաջադրանքների զուգահեռ մշակումը։
Հուսով եմ՝ այս գիտելիքը Ձեզ օգտակար կլինի ինչ-որ պահի Future-ում։ Շնորհակալություն կարդալու համար։