TigerBeetle vs PostgreSQL արտադրողականություն. ինչպես ենք կարգավորել բենչմարկը և տեղական թեստերի արդյունքները
Այս հոդվածը բացատրում է, թե ինչպես են նախագծվել թեստերը, և ներկայացնում է առաջին տեղական, մեկ հանգույցով գործարկումների արդյունքները։
Որոշ ժամանակ առաջ մենք գրել էինք այն մասին, թե ինչն է TigerBeetle-ը դարձնում հետաքրքիր. դա կրկնօրինակվող, բարձր հասանելիության ֆինանսական տվյալների բազա է՝ ֆիքսված սխեմայով և արտադրողականության վրա կենտրոնացմամբ։ TigerBeetle-ը կայացնում է մի շարք հետաքրքիր նախագծային որոշումներ, որոնք բոլորը միտված են համակարգ կառուցելուն, որը տալիս է «1000x արտադրողականություն» և կարող է շարժիչ լինել ֆինանսական ծանրաբեռնվածությունների հաջորդ սերնդի համար։
Ժամանակն է ստուգել և՛ դիզայնը, և՛ այդ պնդումները։ Մենք կհամեմատենք TigerBeetle-ը PostgreSQL-ի հետ՝ ռելացիոն տվյալների բազայի, որին մարդկանց մեծ մասը դիմում է լռելյայն։ Այս հոդվածը բացատրում է, թե ինչպես են նախագծվել թեստերը, և ներկայացնում է առաջին տեղական, մեկ հանգույցով գործարկումների արդյունքները։ Շարունակության մեջ մենք կփորձարկենք տվյալների կրկնօրինակմամբ ամբողջական կլաստեր, որը կաշխատի մեկուսացված՝ հատուկ սերվերների վրա։
Թեստի նախագծում. PostgreSQL սխեմա
TigerBeetle-ի սխեման ֆիքսված է և աջակցում է (միայն) կրկնակի գրառմամբ հաշվապահությանը։ Այն պտտվում է երեք սուբյեկտի շուրջ՝ մատյաններ (ledgers), հաշիվներ և փոխանցումներ։ Յուրաքանչյուր փոխանցում դիպչում է երկու հաշվի – մեկը կրեդիտավորվում է, մյուսը՝ դեբետավորվում։ Փոխանցումներ ստեղծելը տվյալների բազայի հիմնական գործողությունն է, և հենց դա է կատարում այս բենչմարկը։
Արդար համեմատության համար մենք կկառուցենք PostgreSQL սխեմա՝ մոդելավորված TigerBeetle-ի վրա, թեև ինչ-որ չափով պարզեցված։ Այն պարունակում է միայն այն դաշտերը, որոնք թեստերն իրականում օգտագործում են (բաց թողնելով մատյանները, օգտատիրոջ տվյալները, timeout-ը, կոդերը, դրոշները և կապակցված փոխանցումները)՝
CREATE TABLE IF NOT EXISTS accounts (
    id BIGINT PRIMARY KEY,
    balance BIGINT NOT NULL DEFAULT 0,
    CONSTRAINT balance_non_negative CHECK (balance >= 0)
);

CREATE TABLE IF NOT EXISTS transfers (
    id BIGSERIAL PRIMARY KEY,
    source_id BIGINT NOT NULL REFERENCES accounts(id),
    dest_id BIGINT NOT NULL REFERENCES accounts(id),
    amount BIGINT NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT NOW(),
    CONSTRAINT amount_positive CHECK (amount > 0),
    CONSTRAINT different_accounts CHECK (source_id != dest_id)
);

CREATE INDEX IF NOT EXISTS idx_transfers_source ON transfers(source_id);
CREATE INDEX IF NOT EXISTS idx_transfers_dest ON transfers(dest_id);
CREATE INDEX IF NOT EXISTS idx_transfers_created_at ON transfers(created_at);
Հիշեք, որ մենք միշտ պարտադրում ենք ոչ բացասական մնացորդ. TigerBeetle-ում դա ընտրովի է, բայց մեր փոխանցումները կունենան միացված ստուգում (debits_must_not_exceed_credits դրոշը սահմանվում է հաշիվները ստեղծելիս)։
Փոխանցումները PostgreSQL-ում
Սխեման տեղում ունենալով՝ ժամանակն է մի քանի փոխանցում կատարել։ TigerBeetle-ին պետք է միայն create_transfer հարցում, մինչդեռ PostgreSQL-ում փոխանցման տրամաբանությունը պետք է գրել SQL-ով։
Մենք ունենք ընտրելու մի քանի ռազմավարություն, որոնցից յուրաքանչյուրը PostgreSQL-ի արգելափակումն օգտագործում է տարբեր կերպ՝ ճշտությունը երաշխավորելու համար. ինչ էլ ընտրենք, փողը երբեք չպետք է ստեղծվի ոչնչից։ PostgreSQL փոխանցումը բաղկացած է երեք գործողությունից՝
- Աղբյուր հաշվի մնացորդի նվազեցում
- Նպատակակետ հաշվի մնացորդի ավելացում
- Փոխանցում ավելացնել
transfersաղյուսակին
Ցանցային ծախսերը և round-trip-երը կրճատելու համար փոխանցումները իրականացվում են որպես stored procedure։ Այսպես յուրաքանչյուր փոխանցում տվյալների բազայի մեկ ցանցային կանչ է, որը իր կողմից կատարում է բոլոր երեք քայլերը։
Առաջին մոտեցումը հենվում է բացահայտ արգելափակման վրա։ Մենք սկսում ենք SELECT … FOR UPDATE-ով, որը արգելափակում և կարդում է աղբյուր և նպատակակետ հաշիվների մնացորդները (ճիշտ հերթականությամբ՝ deadlock-ները կանխելու համար), հետո UPDATE ենք անում accounts-ը նոր արժեքներով, և վերջում INSERT ենք անում նոր փոխանցում։ Այն կգտնեք transfer ֆունկցիայում։
Երկրորդ մոտեցումը օգտագործում է անուղղակի արգելափակում UPDATE … SET … WHERE-ի միջոցով և ստուգում է ազդված տողերի քանակը (այսինքն՝ արդյոք փոխանցումն անցել է)։ Եթե անցել է, մենք INSERT ենք անում նոր փոխանցում։ Սա գտնվում է transfer_atomic ֆունկցիայում։
Բնականաբար, երկու դեպքում էլ stored procedure-ը աշխատում է գործարքի բլոկի ներսում։ Սա երաշխավորում է, որ փոխանցումը կա՛մ ամբողջությամբ գրանցվում է, կա՛մ մերժվում (երբեք մասնակի չի կիրառվում)։ Մենք օգտագործում ենք բավական թույլ READ COMMITTED գործարքի մեկուսացման մակարդակը, որը բավարար է այս ծանրաբեռնվածության համար։ (Ընդհանուր առմամբ սա տարբերվում է TigerBeetle-ի խիստ սերիալիզացվելիությունից, բայց PostgreSQL իրականացումը այդքան ուժեղ երաշխիքների կարիք չունի։)
Փոխանցումների խմբավորում PostgreSQL-ում
Այս երկու ռազմավարությամբ մենք կարող ենք իրականացնել բեռնվածության թեստեր, որոնցում TigerBeetle-ն ու PostgreSQL-ը կատարում են համադրելի աշխատանք, երբ հաճախորդը ստեղծում է նոր փոխանցում. պարզապես կանչեք համապատասխան ֆունկցիան։
Երկու տվյալների բազաները այդպես միամիտ համեմատելը, սակայն, կարող է մոլորեցնող լինել, քանի որ TigerBeetle հաճախորդները վարվում են այլ կերպ, քան SQL հաճախորդները։
SQL տվյալների բազայի դեպքում սովորաբար ունենում եք նախապես հաստատված կապերի pool։ Հարցում ուղարկել ցանկացող հաճախորդը վերցնում է բաց կապ (եթե ազատ է) կամ սպասում է, մինչև մեկը ազատվի, կատարում է գործողությունը և կապը վերադարձնում է pool։ transfer stored procedure-ները կանչող բազմաթիվ զուգահեռ հաճախորդներով բեռնվածության թեստը նույն կերպ կվարվեր։
TigerBeetle-ը, սակայն, աշխատում է այլ կերպ։ Յուրաքանչյուր հաճախորդ ունի ուղիղ մեկ կապ տվյալների բազայի հետ՝ միաժամանակ առավելագույնը մեկ թռիչքի մեջ գտնվող հարցումով։ Մինչ հարցումը չի ավարտվել, հետագա հարցումները հավաքվում են խմբաքանակի մեջ, որն ուղարկվում է հենց նախորդ հարցումն ավարտվելուն պես։ Այս ագրեսիվ խմբավորումը այն եղանակներից մեկն է, որով Tigerbeetle-ը հասնում է բարձր արտադրողականության, և հաճախորդի իրականացումը դա անում է ավտոմատ։
Բայց։ Նմանատիպ բան կարելի է կառուցել PostgreSQL-ի համար։ Մենք կարող ենք գրել խմբավորող հաճախորդ, որը պահում է տվյալների բազայի մեկ կապ։ Մինչ նախորդ հարցումը մշակվում է, առաջիկա փոխանցումները հավաքվում են խմբաքանակի մեջ։ Հետո մենք կանչում ենք stored procedure, որը դրանք մշակում է խմբաքանակով – մեկ ցանցային կանչ բազմաթիվ փոխանցումների համար։
Հիշեք, որ այս տեխնիկան հարմարեցված է փոխանցումների կիրառման դեպքին – այն ընդհանուր դեպքում չէր աշխատի, քանի որ ընդհանրապես կարելի է կատարել կամայական հարցումներ։ Այստեղ, սակայն, մենք կարող ենք գրել batch_transfers ֆունկցիա, որն ընդունում է երեք զանգված՝ աղբյուր հաշիվներ, նպատակակետ հաշիվներ և գումարներ։ Յուրաքանչյուր փոխանցումից առաջ ստեղծվում է savepoint, որպեսզի «մեծ» խմբաքանակային գործարքը կարողանա մասամբ հետ գլորվել, եթե փոխանցումը ձախողվի։
Հաճախորդի կոդը
TigerBeetle-ի և PostgreSQL-ի հաճախորդները երկուսն էլ գրված են ասինխրոն Rust-ով՝ Tokio runtime-ի վրա։ Սա թույլ է տալիս հարյուրավոր կամ հազարավոր կատարողների զուգահեռ աշխատել փոքր թելերի pool-ի վրա։
Թեստային հաճախորդները աջակցում են երկու ռեժիմ՝ max-throughput և fixed-rate։ Առաջինը չափում է տվյալների բազայի կողմից պահպանվող փոխանցումների առավելագույն քանակը վայրկյանում՝ հաճախորդի տրված զուգահեռության մակարդակի դեպքում (այսինքն՝ թե քանի կատարող է փորձում փոխանցումներ ստեղծել ցիկլով)։ Երկրորդը չափում է փոխանցման ուշացումը՝ վայրկյանում փոխանցումների տրված արագության և հաճախորդի զուգահեռության դեպքում։
Մեր առաջին մեկ հանգույցով տեղական թեստերում մենք կենտրոնանում ենք բացառապես max-throughput թեստավորման վրա։
Յուրաքանչյուր հաճախորդ անցնում է երկու փուլով՝ warmup և measurement, որոնց տևողությունները կարգավորելի են։ Բոլոր չափումները ուղարկվում են Prometheus՝ OpenTelemetry մետրիկաների հավաքիչի միջոցով։
Եվ հաճախորդի կոդը միայն այսքանն է անում. max-throughput ռեժիմում այն պարզապես ամբողջ թեստի ընթացքում ռմբակոծում է տվյալների բազան պատահականորեն գեներացված փոխանցումներով՝ պատահականորեն ընտրված հաշիվների միջև (Զիպֆի բաշխմանը համաձայն, որը արտացոլում է այն փաստը, որ սովորաբար մի բուռ «թեժ» հաշիվներ փոխանցումների անհամաչափ բաժին են ստանում)։
Հաճախորդի կոդը պարունակում է երեք PostgreSQL կատարող (բացահայտ արգելափակում, անուղղակի արգելափակում, խմբավորված) և մեկ TigerBeetle կատարող։
Կոորդինատորը
Կոորդինատորի կոդը պատասխանատու է հաճախորդ(ներ)ի գործարկման, թեստի մի քանի փուլերի անցկացման (դրանց միջև տվյալների բազան մաքրելով) և տվյալների հավաքման ու հաշվետվության համար։
Տեղական գործարկումների համար Grafana-ն, Prometheus-ը և OpenTelemetry collector-ը միշտ գործարկվում են Docker-ով։ macOS-ում TigerBeetle-ը պետք է աշխատի անմիջապես host-ի վրա, քանի որ այն հենվում է io_uring-ի վրա, որը Docker-ը չի տրամադրում։ PostgreSQL-ը միշտ աշխատում է Docker կոնտեյներում։
Տեղական թեստերի արդյունքներ
Վերջապես, տեղական թեստերի արդյունքները։ Բոլոր թեստերը կատարվել են Apple MacBook Pro-ի վրա՝ M1 Max չիպով և 64GB RAM-ով։
Առաջին փուլում մենք անցկացրինք մի քանի «արագ» թեստ – 3 թեստային իտերացիա, յուրաքանչյուրը բաղկացած 30 վայրկյան տաքացումից, որին հաջորդում է 60 վայրկյան չափման փուլ։ Մենք օգտագործեցինք այս արագ թեստերը՝ թեստավորվող յուրաքանչյուր փոխանցման կատարողի համար լավագույն զուգահեռության կարգավորումը գտնելու համար։
Ահա լավագույն արդյունք տվող զուգահեռության կարգավորումները ըստ կատարողի՝
| Կատարող | Զուգահեռություն | Կապերի pool-ի չափ |
|---|---|---|
| Tigerbeetle | 24 576 | |
| Postgres բացահայտ արգելափակում | 64 | 16 |
| Postgres անուղղակի արգելափակում | 64 | 16 |
| Postgres խմբավորված | 384 |
Հաջորդը, օգտագործելով լավագույն արդյունք տված զուգահեռության կարգավորումը (որը տարբերվում էր ըստ կատարողի), մենք անցկացրինք ավելի երկար թեստ՝ 3 թեստային իտերացիա, 2 րոպե տաքացում և 5 րոպե չափում։ Ահա, թե ինչ ստացանք՝
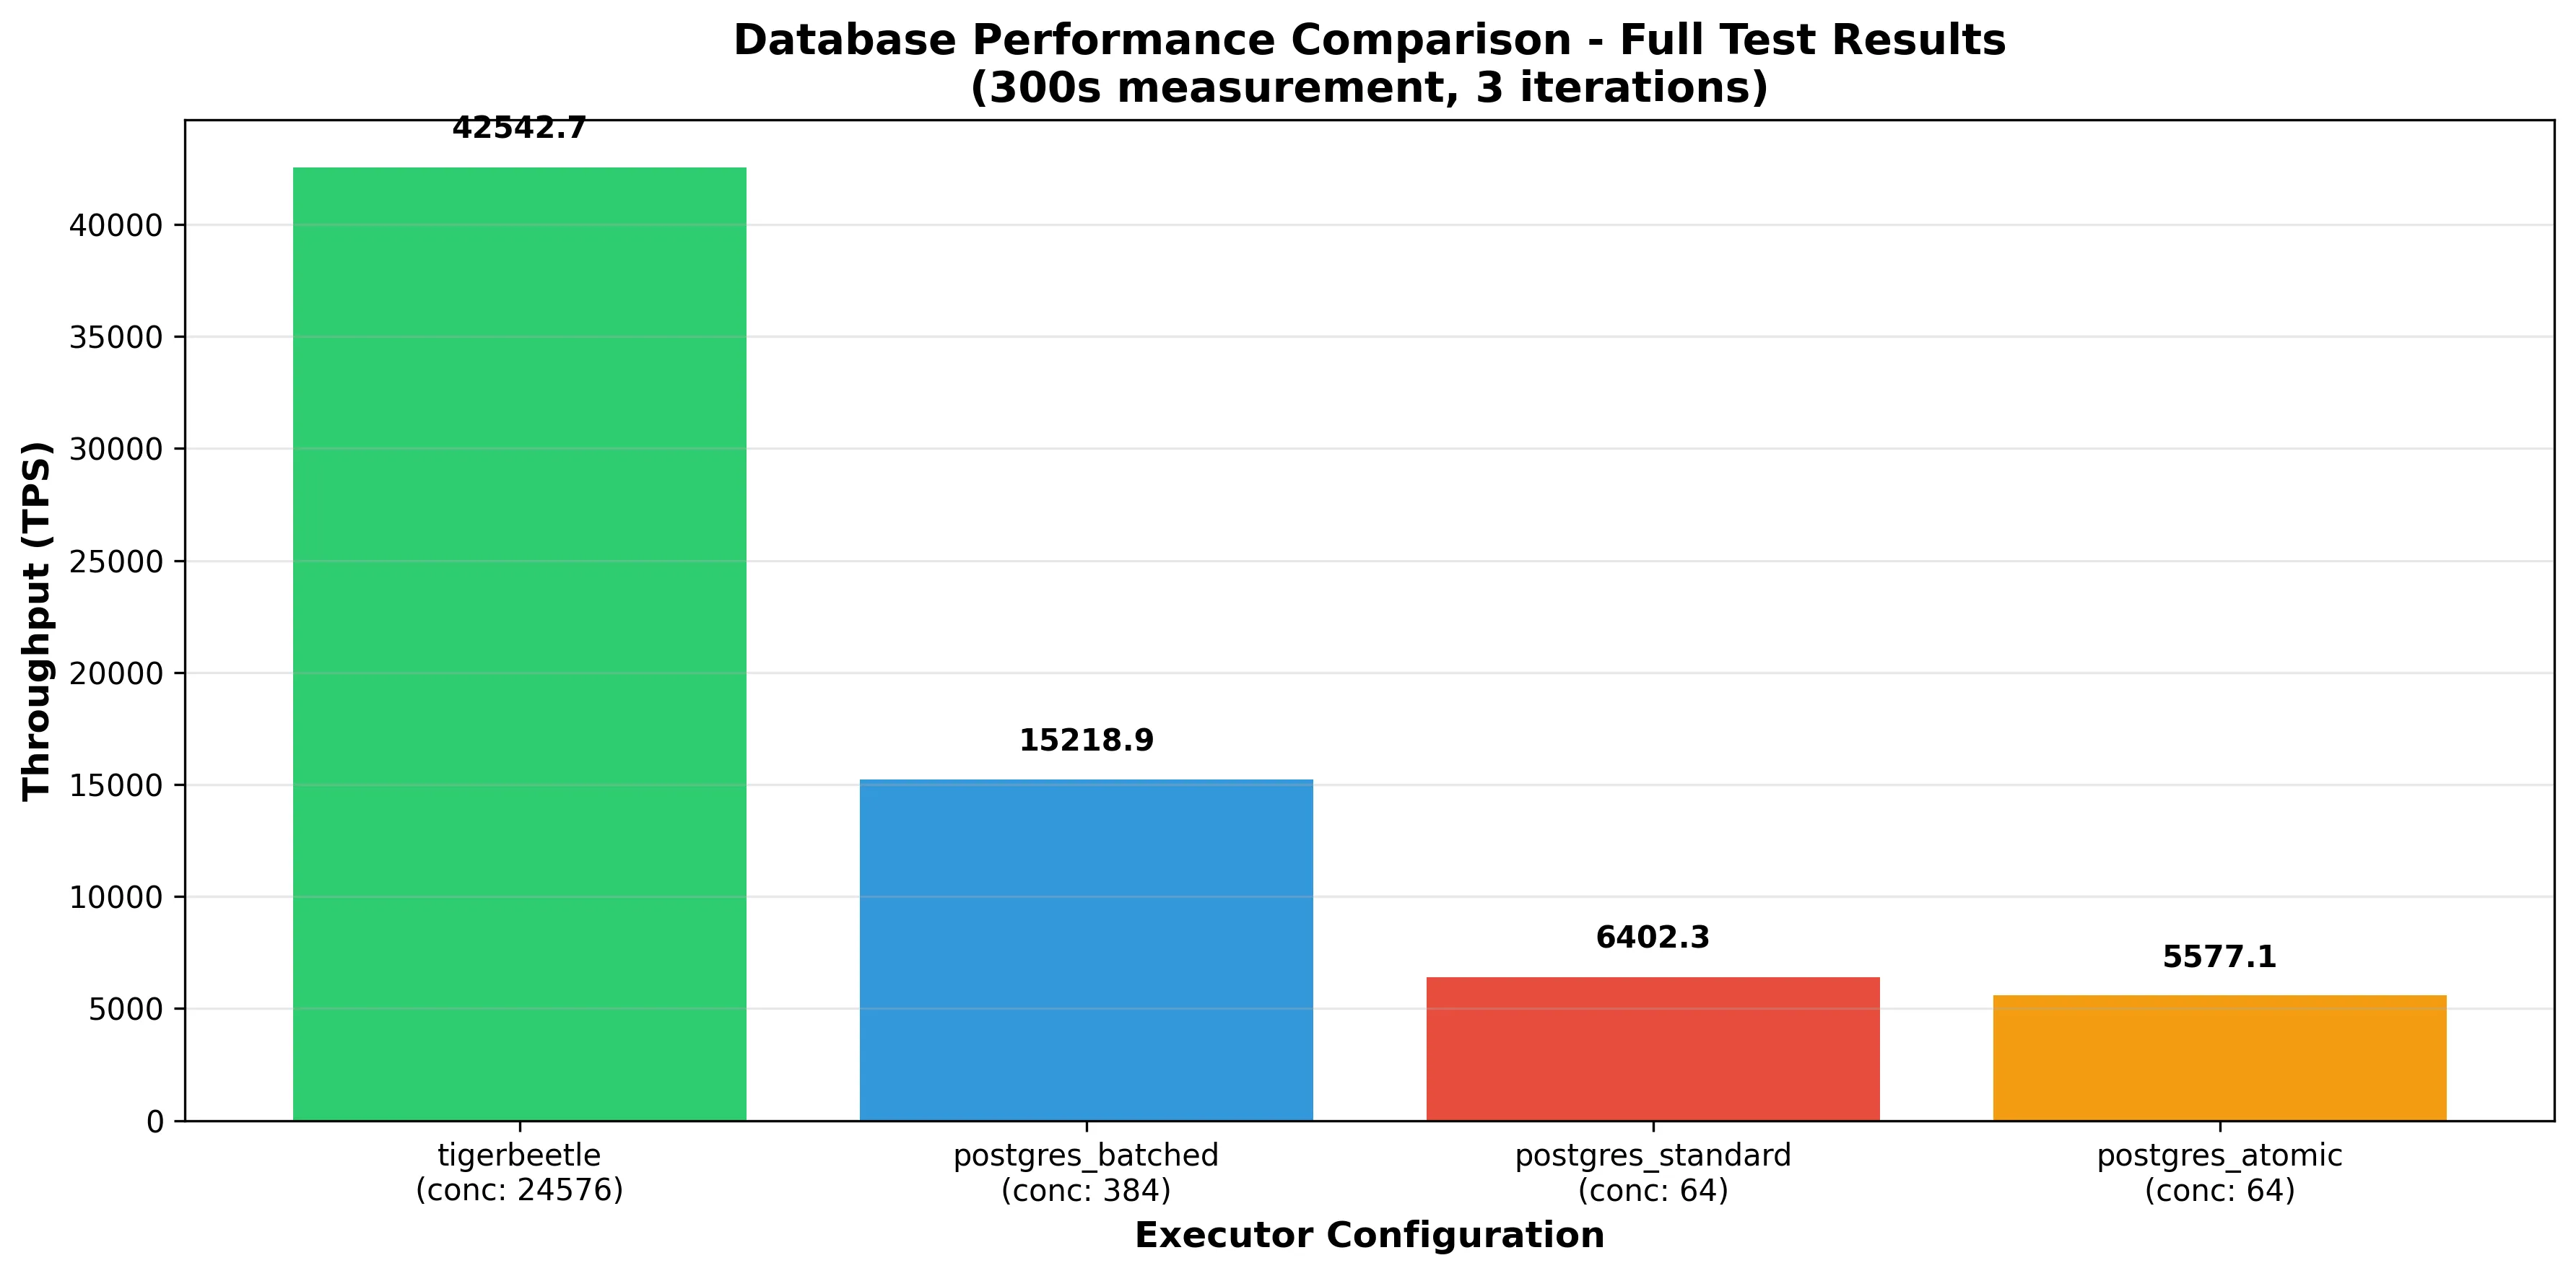
TigerBeetle-ը հասնում է 42k TPS-ի՝ լինելով 2.8 անգամ ավելի արագ, քան PostgreSQL-ի ամենաուժեղ իրականացումը՝ Postgres-batched-ը, որը 15k TPS է, և 6.6 անգամ ավելի արագ, քան Postgres-explicit-locking մոտեցումը։ Սա էական տարբերություն է (թեև ոչ 1000x)։
Հիշեք, որ TigerBeetle-ը այս թողունակությանը հասնում է շատ ավելի բարձր զուգահեռության կարգավորման դեպքում, ինչը ստեղծում է ավելի մեծ խմբաքանակներ։ Ավելի ցածր զուգահեռության կարգավորումների դեպքում թողունակությունը նույնպես իջնում է՝
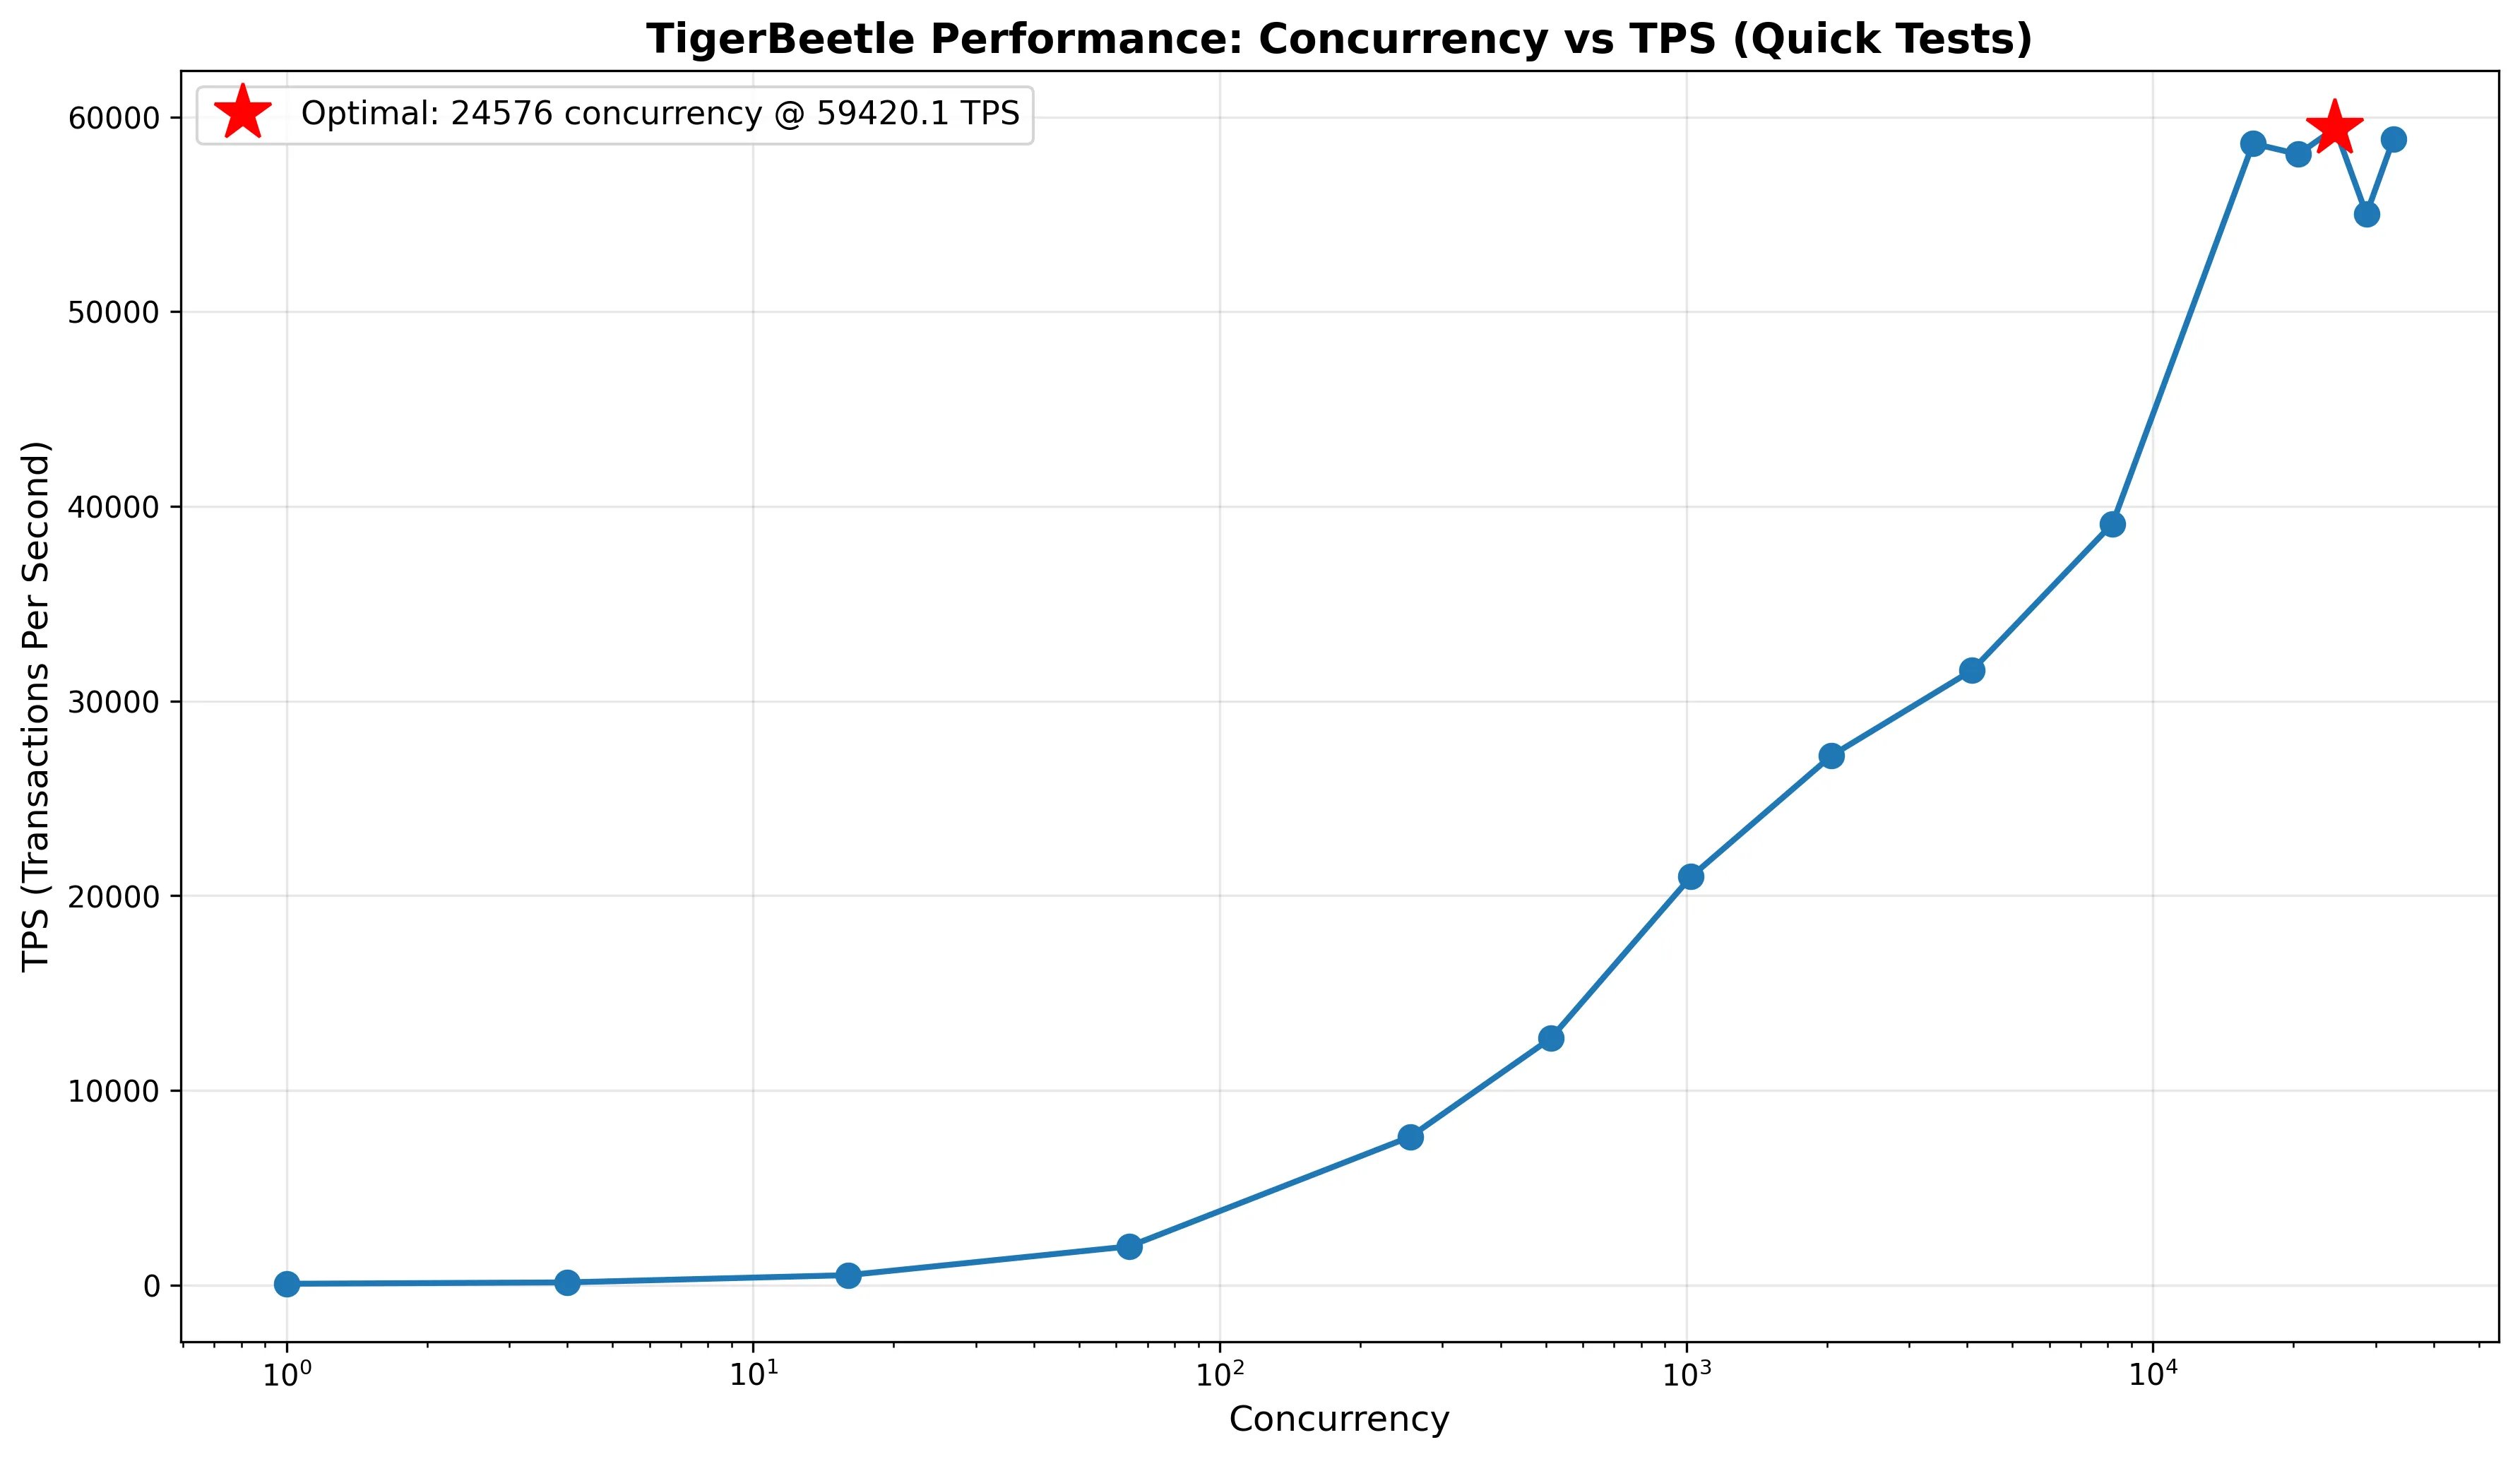
Այս գծապատկերը ցույց է տալիս «արագ» թեստերի արդյունքները, որոնցում TigerBeetle-ը հասավ նույնիսկ ավելի բարձր թողունակության (60k TPS), քան երկար թեստերում։
Թեստի սահմանափակումներ
Հիշեք, որ մենք փորձարկում ենք մեկ կոնկրետ օգտագործման սցենար – բազմաթիվ հաճախորդներ աշխատում են զուգահեռ (համապատասխանում է, օրինակ, մուտքային HTTP հարցումներին), յուրաքանչյուրը ստեղծում է մեկ փոխանցում։ Արտադրողականությունը կարող էր լրիվ այլ տեսք ունենալ, եթե խմբավորումը կատարվեր այլ մակարդակում և փոխանցումները գային արդեն խմբավորված (օր.՝ մինչև 8192 խմբաքանակի չափ, որը TigerBeetle-ի առավելագույնն է)։
Այնպես որ, մինչ վերևի թեստը կարող է ձեզ պատկերացում տալ, թե ինչպես է TigerBeetle-ը համեմատվում PostgreSQL-ի հետ, անպայման բենչմարկ արեք ձեր սեփական ծանրաբեռնվածության վրա՝ որևէ բան որոշելուց առաջ – արդյունքը կարող է բավական տարբեր լինել։
Հաջորդ քայլերը
Տեղական, մեկ հանգույցով թեստերը ամբողջական պատկեր չեն տալիս – դրանք միայն ակնարկում են, թե ինչպես կարող է արտադրողականությունը տեսք ունենալ «իրական» production կարգավորման մեջ։
Այդ պատճառով հաջորդ մասը կքննի կրկնօրինակվող կլաստերների արտադրողականությունը – այն եղանակով, որով TigerBeetle-ը նախատեսված է տեղակայվելու – աշխատող հատուկ սերվերների վրա։ Հետևեք մեզ։