أداء TigerBeetle مقابل PostgreSQL: كيف أعددنا الاختبار المرجعي ونتائج الاختبارات المحلية
تشرح هذه المقالة كيف صُمّمت الاختبارات وتعرض نتائج أولى التشغيلات المحلية على عقدة واحدة.
كتبنا قبل مدة عمّا يجعل TigerBeetle مثيرًا للاهتمام: قاعدة بيانات مالية متكررة النسخ (replicated) وعالية التوافر ذات مخطط ثابت وتركيز على الأداء. يتخذ TigerBeetle سلسلة من قرارات التصميم المثيرة، تستهدف جميعها بناء نظام يقدم «أداءً أعلى بألف مرة» ويستطيع تشغيل الجيل القادم من أحمال العمل المالية.
حان وقت اختبار التصميم وتلك الادعاءات معًا! سنقيس أداء TigerBeetle مقابل PostgreSQL، قاعدة البيانات العلائقية التي يلجأ إليها معظم الناس افتراضيًا. تشرح هذه المقالة كيف صُمّمت الاختبارات وتعرض نتائج أولى التشغيلات المحلية على عقدة واحدة. وفي المقالة التالية سنختبر عنقودًا كاملًا مع تكرار البيانات، يعمل بمعزل على خوادم مخصصة.
تصميم الاختبار: مخطط PostgreSQL
مخطط TigerBeetle ثابت ويدعم (فقط) مسك الدفاتر بالقيد المزدوج. ويدور حول ثلاثة كيانات: دفاتر الأستاذ والحسابات والتحويلات. يمس كل تحويل حسابين – أحدهما يُقيَّد دائنًا والآخر مدينًا. وإنشاء التحويلات هو العملية الأساسية في قاعدة البيانات، وهي التي يختبرها هذا الاختبار المرجعي.
ولمقارنة عادلة، سنبني مخطط PostgreSQL على غرار مخطط TigerBeetle، وإن كان مبسطًا إلى حد ما. فهو يحتوي فقط على الحقول التي تستخدمها الاختبارات فعلًا (مع حذف دفاتر الأستاذ وبيانات المستخدم والمهلة والرموز والأعلام والتحويلات المرتبطة):
CREATE TABLE IF NOT EXISTS accounts (
    id BIGINT PRIMARY KEY,
    balance BIGINT NOT NULL DEFAULT 0,
    CONSTRAINT balance_non_negative CHECK (balance >= 0)
);

CREATE TABLE IF NOT EXISTS transfers (
    id BIGSERIAL PRIMARY KEY,
    source_id BIGINT NOT NULL REFERENCES accounts(id),
    dest_id BIGINT NOT NULL REFERENCES accounts(id),
    amount BIGINT NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT NOW(),
    CONSTRAINT amount_positive CHECK (amount > 0),
    CONSTRAINT different_accounts CHECK (source_id != dest_id)
);

CREATE INDEX IF NOT EXISTS idx_transfers_source ON transfers(source_id);
CREATE INDEX IF NOT EXISTS idx_transfers_dest ON transfers(dest_id);
CREATE INDEX IF NOT EXISTS idx_transfers_created_at ON transfers(created_at);
تذكّر أننا نفرض دائمًا رصيدًا غير سالب؛ وهذا اختياري في TigerBeetle، لكن تحويلاتنا ستكون مفعّلًا فيها هذا الفحص (يُضبط العلم debits_must_not_exceed_credits عند إنشاء الحسابات).
التحويلات في PostgreSQL
بعد أن أصبح المخطط جاهزًا، حان وقت إجراء بعض التحويلات! يحتاج TigerBeetle فقط إلى طلب create_transfer، بينما يجب في PostgreSQL كتابة منطق التحويل بلغة SQL.
لدينا بضع استراتيجيات نختار منها، تستخدم كل منها أقفال PostgreSQL بطريقة مختلفة لضمان الصحة؛ ومهما اخترنا، يجب ألا تُخلق الأموال من العدم أبدًا. يتألف التحويل في PostgreSQL من ثلاث عمليات:
- خفض رصيد الحساب المصدر
- رفع رصيد الحساب الوجهة
- إضافة تحويل إلى جدول
transfers
ولتقليل عبء الشبكة ورحلات الذهاب والإياب، نُفّذت التحويلات كإجراء مخزَّن (stored procedure). وبهذه الطريقة يكون كل تحويل استدعاء شبكيًا واحدًا إلى قاعدة البيانات، التي تنفّذ الخطوات الثلاث كلها من جانبها.
يعتمد النهج الأول على القفل الصريح. نبدأ بـ SELECT … FOR UPDATE الذي يقفل ويقرأ أرصدة الحساب المصدر والوجهة (بالترتيب الصحيح، لمنع حالات الجمود deadlocks)، ثم UPDATE للجدول accounts بالقيم الجديدة، وأخيرًا INSERT لتحويل جديد. تجده في الدالة transfer.
ويستخدم النهج الثاني القفل الضمني عبر UPDATE … SET … WHERE ويتحقق من عدد الصفوف المتأثرة (أي هل نجح التحويل). فإن نجح، نُجري INSERT لتحويل جديد. وهذا موجود في الدالة transfer_atomic.
وبطبيعة الحال، يعمل الإجراء المخزَّن في الحالتين داخل كتلة معاملة (transaction). وهذا يضمن أن التحويل إما يُسجَّل كاملًا أو يُرفض (ولا يُطبَّق جزئيًا أبدًا). ونستخدم مستوى عزل المعاملات الضعيف نسبيًا READ COMMITTED، وهو كافٍ لحمل العمل هذا. (وهو يختلف عمومًا عن قابلية التسلسل الصارمة في TigerBeetle، لكن تنفيذ PostgreSQL لا يحتاج إلى ضمانات بهذه القوة.)
تجميع التحويلات في دفعات في PostgreSQL
بهذين النهجين يمكننا تنفيذ اختبارات حمل يؤدي فيها TigerBeetle وPostgreSQL عملًا متكافئًا عندما ينشئ العميل تحويلًا جديدًا: نستدعي ببساطة الدالة المناسبة.
لكن مقارنة قاعدتي البيانات بهذه الطريقة الساذجة قد تكون مضللة، لأن عملاء TigerBeetle يتصرفون بشكل مختلف عن عملاء SQL.
مع قاعدة بيانات SQL، يكون لديك عادةً مجمّع (pool) من الاتصالات المنشأة مسبقًا. يأخذ العميل الراغب في إرسال طلب اتصالًا مفتوحًا (إن كان هناك اتصال حر) أو ينتظر تحرر أحدها، وينفّذ العملية، ثم يعيد الاتصال إلى المجمّع. وسيتصرف اختبار حمل بعدد كبير من العملاء المتزامنين الذين يستدعون الإجراءات المخزَّنة transfer بالطريقة نفسها.
أما TigerBeetle فيعمل بشكل مختلف. فلكل عميل اتصال واحد بالضبط بقاعدة البيانات، مع طلب واحد على الأكثر قيد التنفيذ في الوقت نفسه. وما دام هناك طلب معلَّق، تُجمَّع أي طلبات إضافية في دفعة، تُرسل فور انتهاء الطلب السابق. هذا التجميع الصارم في دفعات إحدى الطرق التي يبلغ بها Tigerbeetle الأداء العالي، وتتعامل معه تنفيذات العميل تلقائيًا.
لكن! يمكن بناء شيء مماثل لـ PostgreSQL. نستطيع كتابة عميل يعمل بالدفعات ويحتفظ باتصال واحد بقاعدة البيانات. وبينما يجري تنفيذ الطلب السابق، تُجمَّع التحويلات القادمة في دفعة. ثم نستدعي إجراءً مخزَّنًا يعالجها كدفعة – استدعاء شبكي واحد لتحويلات كثيرة.
تذكّر أن هذه التقنية مفصَّلة على حالة استخدام التحويلات – ولن تعمل بشكل عام، لأنه يمكنك عمومًا تشغيل استعلامات اعتباطية. أما هنا فيمكننا كتابة دالة batch_transfers تقبل ثلاث مصفوفات: الحسابات المصدر والحسابات الوجهة والمبالغ. وتُنشأ نقطة حفظ (savepoint) قبل كل تحويل، بحيث تستطيع معاملة الدفعة «الكبيرة» التراجع جزئيًا إذا فشل تحويل.
شيفرة العميل
كُتب عميلا TigerBeetle وPostgreSQL كلاهما بلغة Rust غير المتزامنة على بيئة Tokio. وهذا يتيح تشغيل مئات أو آلاف المنفِّذات بالتزامن على مجمّع خيوط صغير.
يدعم عملاء الاختبار نمطين: أقصى معدل معالجة (max-throughput) ومعدل ثابت (fixed-rate). يقيس الأول أقصى عدد من التحويلات في الثانية تستطيع قاعدة البيانات تحمّله عند مستوى معين من تزامن العملاء (أي كم منفِّذًا يحاول إنشاء تحويلات في حلقة). ويقيس الثاني زمن استجابة التحويل عند معدل معين من التحويلات في الثانية وتزامن معين للعملاء.
وفي اختباراتنا المحلية الأولى على عقدة واحدة، نركّز حصريًا على اختبار أقصى معدل معالجة.
يمر كل عميل بمرحلتين، هما warmup وmeasurement، ومدتاهما قابلتان للضبط. وتُرسل جميع القياسات إلى Prometheus عبر جامع مقاييس OpenTelemetry.
وهذا كل ما تفعله شيفرة العميل: ففي نمط أقصى معدل المعالجة، تقصف قاعدة البيانات ببساطة طوال الاختبار بتحويلات مولَّدة عشوائيًا بين حسابات مختارة عشوائيًا (وفق توزيع Zipf، الذي يعبّر عن أنه عادةً ما تنال حفنة من الحسابات «الساخنة» حصة غير متناسبة من التحويلات).
وتحتوي شيفرة العميل على ثلاثة منفِّذات لـ PostgreSQL (قفل صريح، قفل ضمني، دفعات) ومنفِّذ واحد لـ TigerBeetle.
المنسِّق
شيفرة المنسِّق مسؤولة عن إطلاق العميل (العملاء)، وتشغيل عدة جولات اختبار (مع تفريغ قاعدة البيانات بينها)، وجمع البيانات والإبلاغ عنها.
وفي التشغيلات المحلية، يُشغَّل Grafana وPrometheus وجامع OpenTelemetry دائمًا بواسطة Docker. وعلى macOS، يجب تشغيل TigerBeetle مباشرة على المضيف، لأنه يعتمد على io_uring الذي لا يوفره Docker. أما PostgreSQL فيعمل دائمًا في حاوية Docker.
نتائج الاختبارات المحلية
أخيرًا، نتائج الاختبارات المحلية! جرت جميع الاختبارات على Apple MacBook Pro بشريحة M1 Max وذاكرة 64GB.
في المرحلة الأولى أجرينا عدة اختبارات «سريعة» – 3 تكرارات اختبار، يتألف كل منها من تسخين مدته 30 ثانية يليه مرحلة قياس مدتها 60 ثانية. واستخدمنا هذه الاختبارات السريعة لإيجاد أفضل إعداد للتزامن لكل منفِّذ تحويلات قيد الاختبار.
هذه أفضل إعدادات التزامن أداءً لكل منفِّذ:
| المنفِّذ | التزامن | حجم مجمّع الاتصالات |
|---|---|---|
| Tigerbeetle | 24 576 | |
| Postgres بقفل صريح | 64 | 16 |
| Postgres بقفل ضمني | 64 | 16 |
| Postgres بالدفعات | 384 |
بعد ذلك، وباستخدام إعداد التزامن الذي أعطى أفضل النتائج (والذي اختلف باختلاف المنفِّذ)، أجرينا اختبارًا أطول: 3 تكرارات اختبار، وتسخين مدته دقيقتان، وقياس مدته 5 دقائق. وهذا ما حصلنا عليه:
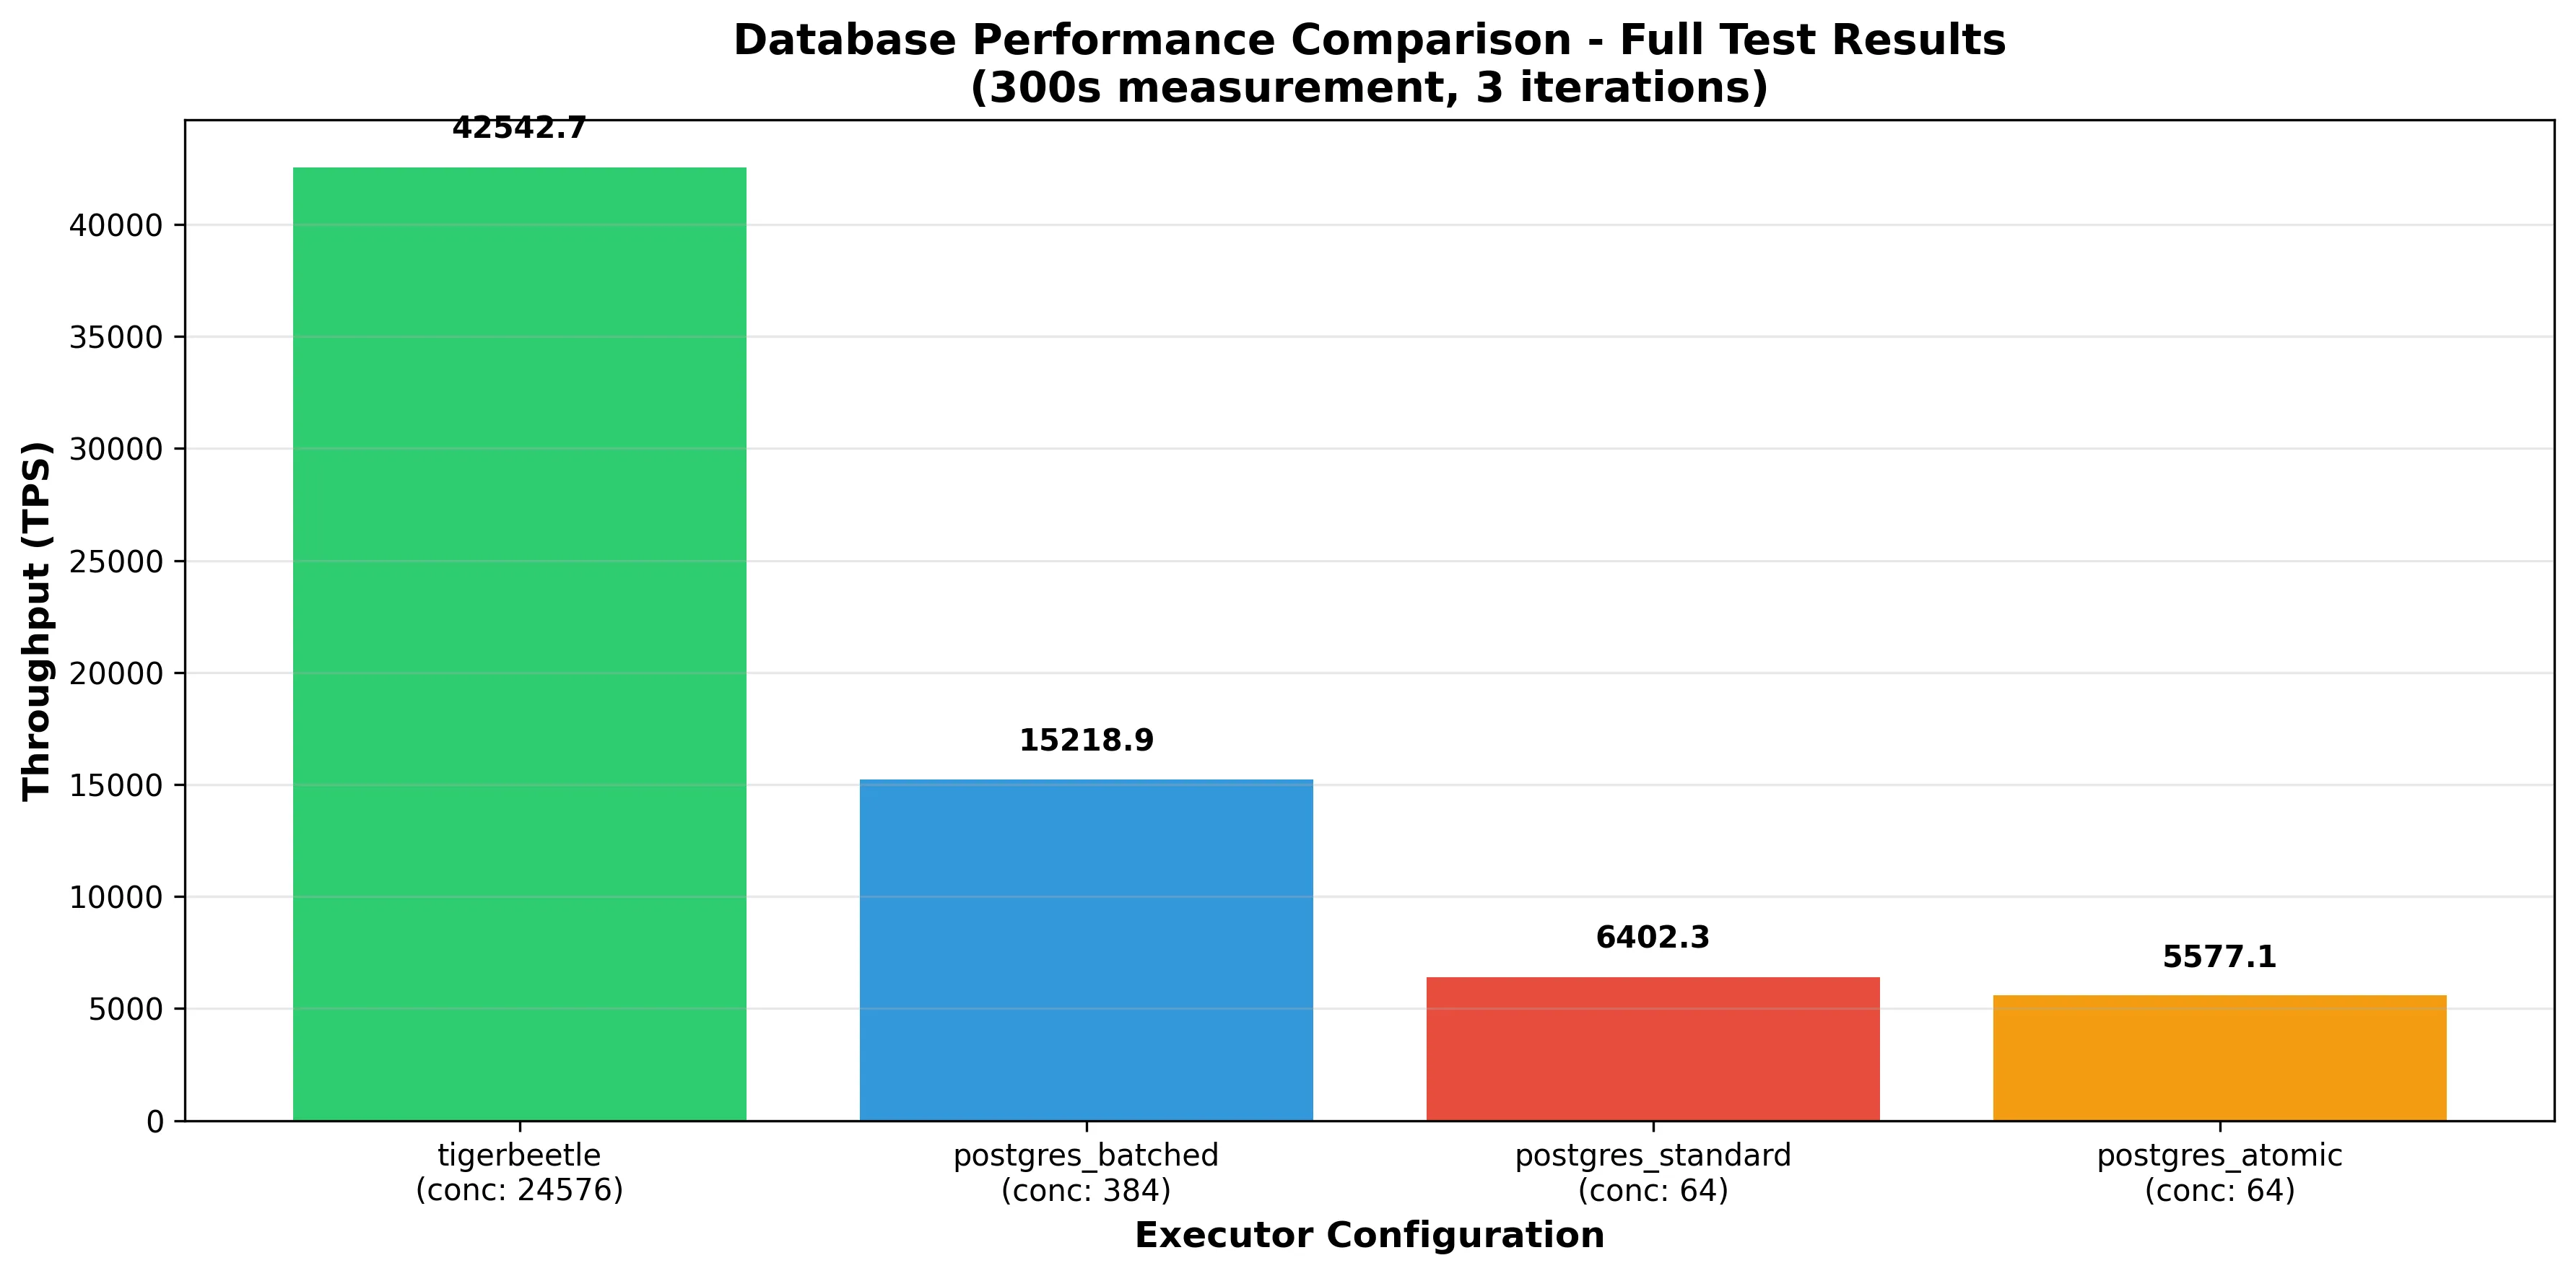
يصل TigerBeetle إلى 42 ألف TPS، أي أسرع بـ 2.8 مرة من أقوى تنفيذ لـ PostgreSQL، وهو Postgres-batched عند 15 ألف TPS، وأسرع بـ 6.6 مرة من نهج Postgres-explicit-locking. وهذه فجوة كبيرة (وإن لم تكن 1000 ضعف)!
تذكّر أن TigerBeetle يبلغ هذا المعدل عند إعداد تزامن أعلى بكثير، مما ينتج دفعات أكبر. وعند إعدادات تزامن أقل، ينخفض معدل المعالجة أيضًا:
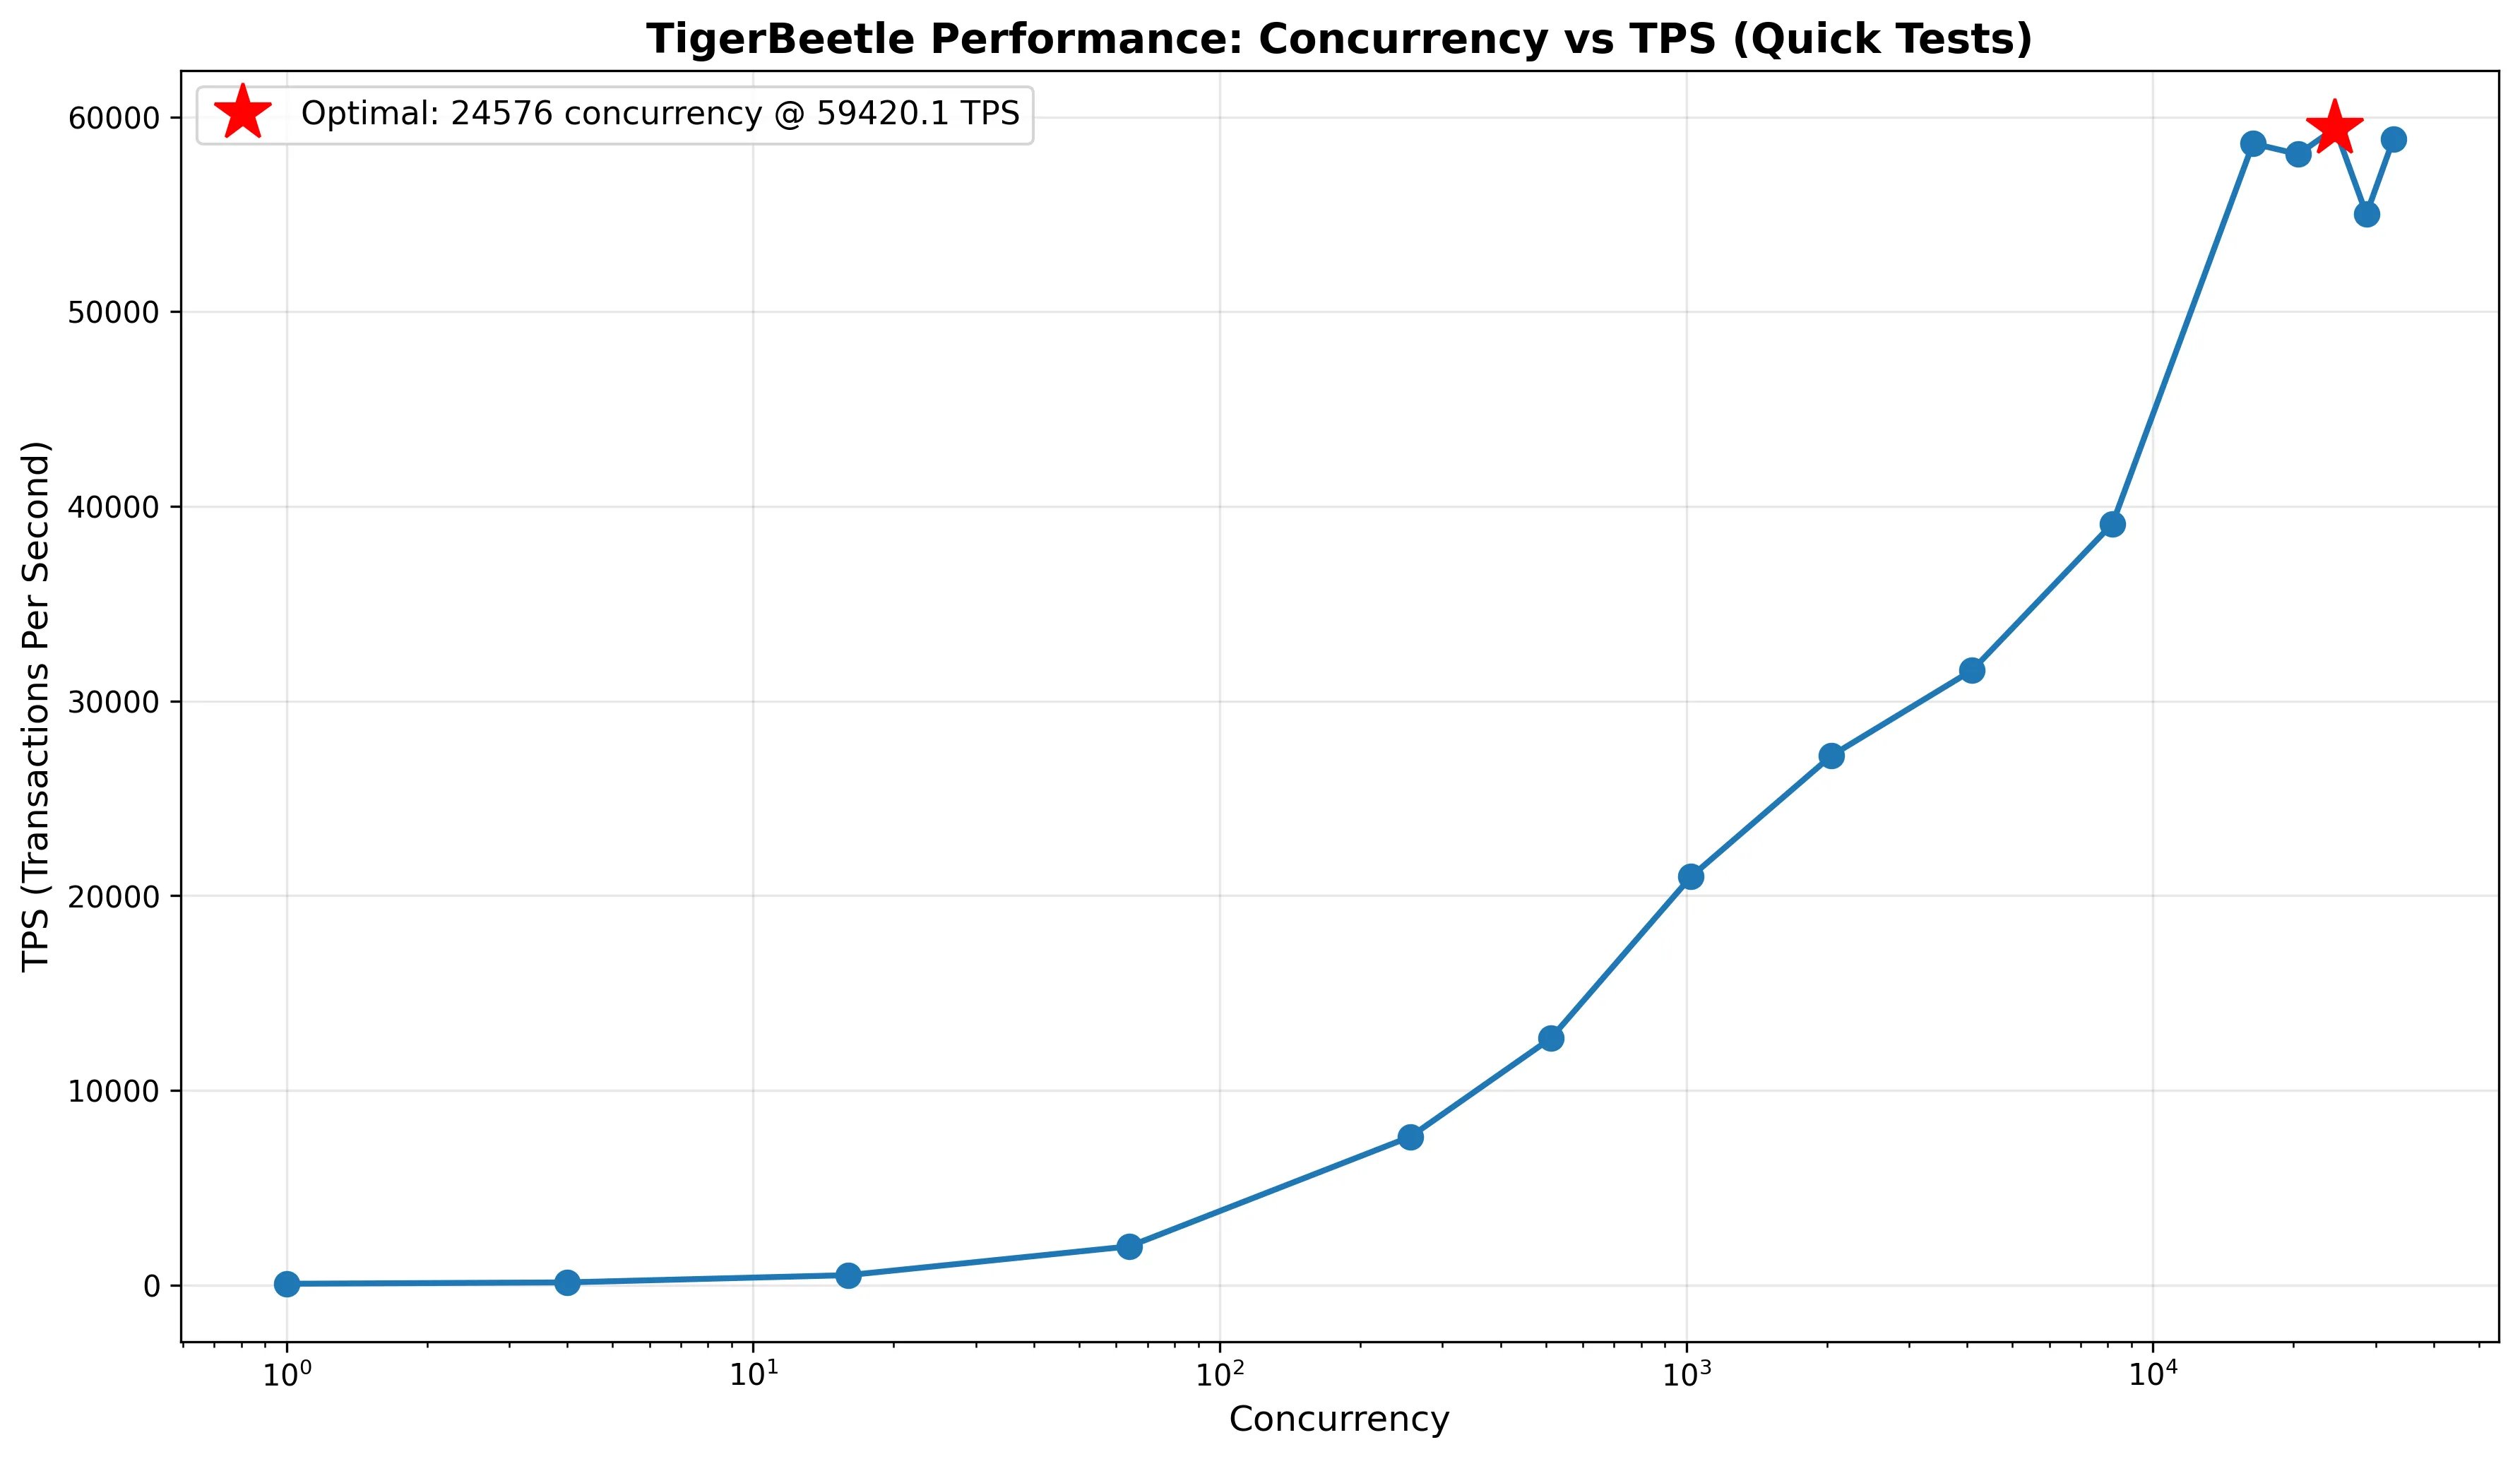
يعرض هذا المخطط نتائج الاختبارات «السريعة»، التي بلغ فيها TigerBeetle معدل معالجة أعلى (60 ألف TPS) من الاختبارات الطويلة.
حدود الاختبار
تذكّر أننا نختبر سيناريو استخدام واحدًا بعينه – عدد كبير من العملاء يعملون بالتزامن (يقابل، مثلًا، طلبات HTTP الواردة)، وينشئ كل منهم تحويلًا واحدًا. وقد يبدو الأداء مختلفًا تمامًا لو حدث التجميع في دفعات على مستوى آخر ووصلت التحويلات مجمَّعة أصلًا (مثلًا حتى حجم دفعة 8192، وهو الحد الأقصى في TigerBeetle).
لذا، فبينما يستطيع الاختبار أعلاه أن يعطيك فكرة عن مقارنة TigerBeetle بـ PostgreSQL، احرص على اختبار حمل عملك الخاص قبل أن تقرر أي شيء – فقد تكون النتيجة مختلفة تمامًا!
الخطوات التالية
الاختبارات المحلية على عقدة واحدة لا ترسم الصورة الكاملة – فهي تلمّح فقط إلى كيف قد يبدو الأداء في إعداد إنتاج «حقيقي».
ولهذا ستفحص الحلقة القادمة أداء العناقيد المتكررة النسخ – الطريقة التي صُمم TigerBeetle لنشره بها – العاملة على خوادم مخصصة. ترقّبوا!