ML նախագծերի մասին 6 ամենամեծ բիզնես թյուրըմբռնումները
Այս հոդվածում փորձում եմ ցույց տալ, թե ինժեների աչքերով ինչպիսին է իրականում մեքենայական ուսուցման նախագիծը և ինչ խնդիրների են սովորաբար բախվում հաճախորդները։ Այն անդրադառնում է այդ խնդիրներին, ինչն է սխալ ընթանում, ինչն է մեզ անակնկալի բերում, որտեղ են իրական ռիսկերը և ինչպես դրանք նվազեցնել։
Ահա թե ինչպես եմ պատկերացնում իմ աշխատած որոշ հաճախորդների մտածելակերպը.
«Տվյալները մենք ունենք, խնդիրը հասկանում ենք – պարզապես կառուցեք մեզ մոդել։ Կարող ենք նույնիսկ AutoML օգտագործել։ Մոդելը երբ պատրաստ լինի, գործն ավարտված է։ Կուղարկենք production, և այն ինքնուրույն կաշխատի հաջորդ մի քանի տարիների ընթացքում»։
Ցավոք, ամեն ինչ դրանից ավելի բարդ է։
Մեքենայական ուսուցումը Excel-ի plugin չէ։ Այն plug-and-play մաս չէ, որը գնում, տեղադրում եք և տարիներով օգտագործում առանց ջանքի։ Այն կենդանի համակարգ է, որը կախված է տվյալներից, ժամանակի ընթացքում փոխվում է և պահանջում է շարունակական բարելավում ու թարմացում։ Այն պահանջում է համբերություն, փորձարկումներ և առողջ համեստություն այն հարցում, ինչ մենք (դեռ) չգիտենք։
Այս հոդվածում փորձում եմ ցույց տալ, թե ինժեների աչքերով ինչպիսին է իրականում մեքենայական ուսուցման նախագիծը և ինչ խնդիրների են սովորաբար բախվում հաճախորդները։ Այն անդրադառնում է այդ խնդիրներին, ինչն է սխալ ընթանում, ինչն է մեզ անակնկալի բերում, որտեղ են իրական ռիսկերը և ինչպես դրանք նվազեցնել։
Եթե մտածում եք AI-ը ձեր արտադրանքի մեջ ներդնելու մասին կամ պլանավորում եք աշխատել ML թիմի հետ, այս հոդվածը կարող է օգնել խուսափել տիպիկ սխալներից։ Կամ գոնե կօգնի հասկանալ, թե ինչու մոդելը մեկ շաբաթ հետո կախարդանքով չհայտնվեց։
Առասպել 1. AI-ը կարող է լուծել ամեն ինչ
AI գործիքների նկատմամբ հետաքրքրությունը պայթել է ChatGPT-ի և Midjourney-ի նման համակարգերի գալուստով։ Դրանք արագ են, հաճախ տպավորիչ արդյունքներ են տալիս և համարյա կախարդանքի պես են զգացվում։ Զարմանալի չէ, որ որոշ բիզնես թիմեր այժմ AI-ին վերաբերվում են որպես «բոլորի համար հարմար լուծման»։
Սակայն որպես մեքենայական ուսուցման ինժեներ ես պարբերաբար հանդիպում եմ անիրատեսական սպասումներով հաճախորդների։ Նրանք ուզում են մոդել, որը կանխատեսում է ամեն ինչ, երբեք չի սխալվում, պատասխանում է ակնթարթորեն, հաղթահարում է ցանկացած սցենար և ինքնուրույն հարմարվում է։ Խնդիրն այն է, որ այդպիսի մոդելներ գոյություն չունեն։
Մեքենայական ուսուցման թիմի գործը միայն մոդել կառուցելը չէ, այլև հաճախորդներին կրթելը այն մասին, թե որտեղ է մեքենայական ուսուցումն իմաստ ունենում և որտեղ՝ ոչ. որտեղ այն կարող է իրական արժեք բերել և որտեղ դասական տվյալների վերլուծությունը կամ նույնիսկ համակարգում պարզ կանոնը ավելի լավ կծառայի։
Այս սահմանները իմանալը ML նախագծի հաջողության մի մասն է։ Որպես տեխնիկական գործընկերներ՝ մենք պատասխանատու ենք այդ սահմանները մատնանշելու և հասանելի լավագույն լուծումը գտնելու համար, թեկուզ այն ավելի քիչ տպավորիչ լինի, բայց շատ ավելի իրատեսական։
Առասպել 2. Պարզապես լցրեք տվյալները, մնացածը ML-ը կանի
Մեքենայական ուսուցման մասին ամենատարածված համոզմունքներից մեկը հնչում է այսպես.
«Մենք տվյալներ ունենք, ուստի դրանք դնում ենք մոդելի մեջ, և մոդելը կսովորի ու կլուծի խնդիրը»։
Տրամաբանական է թվում, չէ՞։ Չէ՞ որ տվյալները AI-ի «վառելիքն» են. որքան արագ լցնենք, այնքան շուտ շարժիչը կսկսի։ Բայց շարժիչի համեմատությունը շարունակելով՝ եթե օգտագործենք վատ կամ աղտոտված վառելիք, շարժիչը կփչանա, և մենք ոչ մի տեղ չենք հասնի։ Ահա թե ինչու «garbage in, garbage out» արտահայտությունն այդքան տարածված է ML-ում։ Եթե մոդելը մարզում եք ցածր որակի տվյալների վրա, լավ արդյունքներ սպասել չի կարելի։
Որտեղի՞ց է այս առասպելը
Սովորական IT նախագծերում տվյալները հակված են լինել մաքուր և կառուցվածքավորված. ձևեր և տվյալների բազաներ՝ սահմանված ձևաչափով և աղբյուրով։ Մեքենայական ուսուցման մեջ, սակայն, տվյալները միայն բջիջներում ճիշտ արժեքների մասին չեն. դրանք նաև իմաստի, տրամաբանության և այն մասին են, թե ինչպես են տվյալներն առաջացել։ Մոդելը սովորում է անմիջապես այն բանից, ինչ ստանում է, ուստի տվյալները պետք է իսկապես արտացոլեն այն գործընթացը կամ խնդիրը, որը ուզում ենք մոդելավորել։
Ուրեմն ի՞նչ անել «պարզապես տվյալները լցնելու» փոխարեն
- Սկսեք պարզ հարցից. ի՞նչ ճշգրիտ պետք է կանխատեսի մոդելը։ Կարո՞ղ է դա չափվել։ Ունե՞նք դրա պատմական օրինակներ։
- Վերցրեք փոքր նմուշ (50-ից 100 գրառում) և ձեռքով անցեք դրա միջով։ Պիտակները հետևողակա՞ն են։ Սյունակներն իմաստ ունե՞ն։ Արժեքները հակասո՞ւմ են միմյանց։ Իսկապե՞ս ունենք այս տեսակի տվյալներ։ Ունե՞նք այն փոփոխականը, որը ուզում ենք կանխատեսել։
- Նախագծի մեկնարկից առաջ նախատեսեք տվյալների փոքր աուդիտ։ Մեքենայական ուսուցման թիմը կարող է տրամադրել ստուգացանկ. արժեքների բաշխումներ, բացակայող տվյալներ, կորելյացիաներ և պիտակների որակ։
- Ներգրավեք բիզնես փորձագետների՝ տվյալները բացատրելու համար։ Միայն նախագիծը ճանաչող մարդիկ կարող են ասել այնպիսի բաներ, ինչպիսիք են. «Այս սյունակը կարևոր է միայն A տարածաշրջանի համար» կամ «այս գրառումները նախորդում են մեր համակարգի փոփոխությանը»։ Առանց այդ համատեքստի տվյալները հասկանալն ու լավ օգտագործելը շատ ավելի դժվար է դառնում։
Առասպել 3. Ավելի շատ տվյալ = ավելի լավ մոդել
Երբ ընդունում ենք, որ տվյալները կարևոր են, գայթակղիչ է դառնում կարճ ճանապարհներ փնտրելը.
«Մենք շատ տվյալներ ունենք, միլիոնավոր գրառումներ։ Լավ, դրանց մի մասը կարող է խառնաշփոթ լինել, բայց մոդելը կհասկանա։ Ավելի շատ տվյալը միշտ լավ է։ Այդպես չէ՞»։
Ոչ։ Մեքենայական ուսուցման մեջ ավելի շատ ցածր որակի տվյալներ կուտակելը ձեր մոդելը չի լավացնում։ Այն իրականում կարող է վատացնել։
Մեքենայական ուսուցման մոդելները տվյալների մեջ օրինաչափություններ են փնտրում։ Եթե տվյալները աղմկոտ են, անհետևողական կամ սխալ պիտակավորված, ապա որքան էլ մեծ լինի ձեր տվյալների հավաքածուն, այն պարզապես կլինի անօգուտ օրինակների հսկայական կույտ։
Իմ վերջին երկու նախագծերում հաճախորդները հպարտությամբ հանձնեցին հսկայական տվյալների հավաքածուներ՝ նախատեսված մոդելը մարզելու համար։ Շուտով պարզեցինք, որ տվյալները անհետևողական են, լի սխալ պիտակներով, և ի վերջո անօգտագործելի առանց լուրջ մաքրման։
Տվյալները՝ ցանկացած ML նախագծի ամենամեծ ռիսկը
Մեր տեսածի համաձայն՝ մեքենայական ուսուցման նախագծերում ժամանակի մեծ մասը գնում է ոչ թե մոդելներ կառուցելուն, այլ տվյալները հասկանալուն ու վերականգնելուն։ ML փորձագետների շրջանում անցկացված հարցումը ցույց տվեց, որ այս փուլը կարող է կազմել ընդհանուր ջանքերի մինչև 80%-ը։ Հենց այստեղ են առաջանում նաև թյուրըմբռնումների մեծ մասը։
Տիպիկ տվյալների խնդիրները, որոնց հանդիպում ենք.
- Թերի գրառումներ – օրինակ՝ 40%-ը չունի առանցքային տեղեկություն, ինչպես հաճախորդների որոշումները։
- Անհետևողականություններ – մի սյունակում գրված է «status = canceled», մյուսում՝ «status = closed»։
- Մոլորեցնող պիտակներ – «հաջողություն» պիտակը կարող է նշանակել «առաջարկը ուղարկվել է», այլ ոչ թե «ապրանքը վաճառվել է»։
- Բացակայող համատեքստ – ոչ ոք չի հիշում, թե ինչու է ներդրվել X բիզնես կանոնը, ուստի տվյալների 1/3-ը շեղված է։
Ուրեմն ո՞րն է ավելի կարևոր՝ քանակը, թե որակը
Մարդիկ հաճախ հարցնում են.
«Ո՞րն է ավելի կարևոր՝ տվյալների քանակը, թե որակը»։
Իմ խորհուրդն է որակը դնել առաջին տեղում, թեև քանակն էլ կարևոր է։ Ահա իրական օրինակ։
Մի նախագծում հաճախորդը կանխատեսող մոդելի մարզման համար մեծ տվյալների հավաքածու տրամադրեց։ Առաջին հայացքից այն հիանալի տեսք ուներ. շատ գրառումներ, մեծ բազմազանություն, ողջամիտ ընդգրկում։ Սակայն արագ աուդիտը բացահայտեց բացակայող արժեքներ և վատ սահմանված պիտակներ։
Երկար բանավեճի փոխարեն՝ թե ինչու է դա խնդիր, ես որոշեցի դա ցույց տալ։ Ընտրեցինք փոքր, ուշադիր ընտրված ենթաբազմություն՝ տվյալների 1%-ից պակաս, և ձեռքով ստուգեցինք ու ուղղեցինք։ Հետո կառուցեցինք երկու մոդել.
- Մեկը մարզված ամբողջ, խառնաշփոթ տվյալների հավաքածուի վրա
- Մեկը մարզված փոքր, մաքրված ենթաբազմության վրա
Երկուսն էլ գնահատեցինք նույն մաքրված թեստային հավաքածուի վրա։ Արդյունքը։ Մաքուր տվյալների վրա մարզված մոդելը ակնհայտորեն գերազանցեց ավելի մեծին։
Այս փոքր փորձը հաճախորդի վրա ուժեղ տպավորություն թողեց։ Այն ապացուցեց էական կետ. լավ տվյալները հաղթում են ավելի շատ տվյալներին։
Սա համընկնում է AI փորձագետ Andrew Ng-ի ասածի հետ. կիրառման շատ դեպքերում արդյունավետ մոդել կառուցելու համար կարող են բավարար լինել ընդամենը մի քանի տասնյակ բարձրորակ օրինակ։ Սա data-centric AI-ի էությունն է. ջանք ներդնել ավելի լավ տվյալների վրա, այլ ոչ միայն ավելի մեծ մոդելների, հաճախ տալիս է լավագույն արդյունքը։
Տվյալների որակի և մեքենայական ուսուցման ալգորիթմի արդյունավետության անկման կապը խորությամբ ուսումնասիրվել է «The Effects of Data Quality on Machine Learning Performance on Tabular Data» գիտական հոդվածում։ Մեկ այլ հետազոտություն՝ փոքր լեզվական մոդելների մարզման մասին, ցույց է տալիս, որ ուժեղ արդյունքների շարժիչը տվյալների որակն է, ոչ թե քանակը։
Ինչ արժե տվյալների վատ որակն իրականում
Երբ ոչ ոք ուշադրություն չի դարձնում տվյալների որակին.
- Մոդելը վերցնում է մոլորեցնող կորելյացիաներ – օրինակ՝ «այն հաճախորդները, որոնց ID-ն ավարտվում է 7-ով, ավելի հաճախ են կոնվերտվում»։
- Կորցնում եք ժամանակ և գումար – մարզումն ավելի երկար է տևում, իսկ դեբագն ավելի դժվար է դառնում։
- Time-to-market-ն աճում է – խնդիրները հետո ուղղելը նշանակում է աշխատանքը երկու անգամ անել։
Ինչու է այս առասպելն այդքան տարածված
- Ավանդական անալիտիկայում ավելի շատ տվյալը հաճախ իսկապես օգնում է։ Օրինակ՝ գծային ռեգրեսիայում մարզման տվյալների քանակը չորս անգամ մեծացնելը կարող է սխալը կիսով չափ նվազեցնել, բայց միայն այն դեպքում, երբ տվյալները բավարարում են մոդելի ենթադրություններին։
- Մարդիկ մոռանում են, որ մարկետինգային օրինակները հաճախ հենվում են ուշադիր ընտրված, մաքրված տվյալների հավաքածուների վրա (օրինակ՝ ChatGPT-ի կամ Falcon-ի նման մեծ մոդելների մարզման համար)։
- Ավելի շատ տվյալներ հավաքելը սովորաբար ավելի հեշտ է, քան դրանք վերանայելը, մաքրելը և իրապես հասկանալը։
Ինչ է ներառում ժամանակակից, տվյալակենտրոն մոտեցումը
Այսօրվա լավագույն մեքենայական ուսուցման թիմերը հետևում են data-centric AI-ին։ Գործնականում.
- Պարզ մոդելը կարող է լավ աշխատել, երբ տվյալները բարձր որակի են։
- Ավելի շատ տվյալներ հավաքելու փոխարեն՝ մենք բարելավում ենք արդեն ունեցածը – հեռացնելով աղմուկը, ուղղելով պիտակները և համաձայնեցնելով սահմանումները։
- Տվյալների մաքրումը հաղթում է դրանց կուտակմանը – ավելի մաքուր օրինակների փոքր հավաքածուն հաճախ ավելի լավ է աշխատում, քան ավելի մեծ, բայց թերի տվյալների հավաքածուն։
Առասպել 4. ML-ը աշխատում է այնպես, ինչպես դասական IT-ն
Շատ հաճախորդներ մեքենայական ուսուցման նախագծեր են գալիս՝ մտածելով ծրագրային ապահովման ավանդական մշակման տերմիններով։ Դա հասկանալի է. տարիներ շարունակ ծրագրեր ենք կառուցել կրկնվող ֆրեյմվորքերով.
«Գրում ենք պահանջները, աշխատանքը բաժանում ենք սպրինտների, պլանավորում ենք թողարկումները, անցկացնում ենք դեմո, և այն աշխատում է»։
Սա շատ լավ է աշխատում API, dashboard կամ հաճախորդների սպասարկման համակարգ կառուցելիս։ Սակայն երբ ML նախագիծը սկսվում է, այս մոտեցումը շուտով փլուզվում է։ Ինչու՞։
Որովհետև մեքենայական ուսուցումը տրամաբանություն գրելու մասին չէ, այլ տվյալների մեջ օրինաչափություններ գտնելու։ Եվ դա լրիվ այլ խաղ է։
ML-ը հետազոտություն է, ոչ թե պարզապես իրականացում
Մեքենայական ուսուցման նախագծերում.
- Չենք կարող նախապես իմանալ, թե որ մոդելը կաշխատի – պետք է փորձարկել և հասկանալ, թե ինչպիսին են տվյալները։
- Չենք կարող ջանքերը ճշգրիտ գնահատել – արդյունքները կախված են տվյալների որակից, ոչ միայն մաքուր կոդից։
- Տրամաբանությունը մենք չենք իրականացնում – մենք մարզում ենք մոդելին, որ սովորի այն։ Եվ մոդելը կարող է սխալ սովորել, նույնիսկ երբ կոդը անթերի է։
Մի անգամ ես նախագիծ էի վարում, որտեղ հաճախորդը սպասում էր «կանխատեսման դեմո երկու շաբաթում»։ Երկու շաբաթ անց մենք ունեինք տվյալների անհետևողականությունները բացատրող հինգ վարկած, նախնական մշակման երեք գաղափար և ոչ մի աշխատող մոդել։ Ոչ այն պատճառով, որ թիմը անարդյունավետ էր կամ հմտություններ չուներ, այլ որովհետև մեքենայական ուսուցման մեջ, նախքան որևէ բան աշխատի, պետք է հասկանալ, թե ինչի հետ գործ ունես։
Որտեղ ավանդական IT մոտեցումները թերանում են
Հաջողությունը երաշխավորված չէ
Մեքենայական ուսուցման նախագիծը միշտ չէ, որ հաջողվում է, հատկապես առաջին փորձից։ Երբ խնդիրը բարդ է, սկզբնական ենթադրությունները կարող են սխալ լինել։ Հավաքված տվյալները կարող են անբավարար, անհետևողական կամ մեքենայական ուսուցման համար պարզապես չափազանց սահմանափակ լինել։
Երբեմն բավական է խնդիրը վերաձևակերպել, վերանայել ենթադրությունները, տվյալները ավելի ուշադիր պատրաստել և նորից փորձել։ Այլ դեպքերում խնդիրը չափազանց բարդ է, որ ML-ը արդյունավետ կերպով հաղթահարի։
Ժամանակի մեծ մասը գնում է տվյալների որակին և մշակմանը
Հաճախորդները սովորաբար ուզում են աշխատող մեքենայական ուսուցման մոդել հնարավորինս շուտ. հասկանալի է, քանի որ ժամանակը փող է։ Բայց տվյալների որակի ստուգման և տվյալները հասկանալու փուլը բաց թողնելը նվազեցնում է հաջողության հնարավորությունները։
Կոդի ռեֆակտորինգը ծրագրային ապահովման մշակման նախագծի կյանքի ցիկլի նորմալ մասն է։ Ուրեմն ինչու՞ է «տվյալների ռեֆակտորինգը»՝ տվյալների որակի վերլուծությունն ու բարելավումը, դեռ դիտվում որպես կամընտիր։ Որովհետև մարդիկ չեն ընկալում, թե որքան բարդ է մեքենայական ուսուցման մշակումը և որքանով է նախագծի հաջողությունը կախված տվյալներից։
Հաճախորդները գալիս են ասելով, որ տվյալներ ունեն, և սպասում են, որ մենք պարզապես «մարզենք մոդելը և ավարտենք»։ Այդպես չի աշխատում։
Տվյալների մանրակրկիտ վերլուծությունը բաց թողնելն ու անմիջապես մոդելի մարզմանն անցնելը հանգեցնում է վատ արդյունավետության, հետո՝ դեբագի, որը, ինչպես կարող եք կռահել, ի վերջո վերադարձնում է տվյալներին։ Արժե վաղ ներդրում անել տվյալների վավերացման և հասկացման մեջ։ Եթե լուրջ խնդիրներ առաջանան, կարող ենք նախագիծը դադարեցնել, տվյալները ուղղել և հետո վստահությամբ շարունակել։
Նախագծի այլ ռիսկեր
Դասական ծրագրային նախագծերում ռիսկերը սովորաբար կարելի է հայտնաբերել և նվազեցնել վաղ՝ պահանջների հավաքագրման և նախատիպավորման ժամանակ, քանի որ ամեն ինչ պտտվում է ֆունկցիոնալության և օգտագործման սցենարների շուրջ։ ML նախագծերում, ընդհակառակը, հիմնական ռիսկը տվյալներն են։ Մինչև ինժեները չի տեսել և վերլուծել դրանք, նա աշխատում է ենթադրությունների վրա։
Անկանխատեսելիություն
Դժվար է գնահատել, թե որքան ժամանակ կպահանջվի տվյալները «ուղղելու» կամ հիպերպարամետրերը կարգավորելու համար։ Նույնիսկ խրախուսող տվյալների վերլուծությունից հետո մոդելը կարող է ձախողվել, քանի որ տվյալները բավականաչափ դեպքեր չեն ընդգրկում կամ քիչ կանխատեսող ուժ ունեն։ Դա հաճախ նշանակում է վերադառնալ տվյալների հավաքագրմանն ու պիտակավորմանը և նորից սկսել։
Տվյալները կարող են իսկական Պանդորայի արկղ դառնալ։ Առաջին հայացքից դրանք կարող են լավ թվալ, բայց ավելի մանրամասն վերլուծությունը կարող է բացահայտել բացեր և սխալներ։ Սա նախագծի լուրջ ռիսկ է, և այնպիսին, որը դժվար է կանխատեսել առանց պատշաճ խորը ուսումնասիրության։
Տվյալների լուրջ խնդիրները կարող են կտրուկ նվազեցնել նախագծի հաջողության հնարավորությունները կամ նույնիսկ բացառել մոդելի կառուցումը։ Նախագիծը կարող է դադարեցվել կամ ամբողջությամբ կանգնեցվել մինչև տվյալների ուղղումը, և հաճախ անհնար է ասել, թե որքան ժամանակ դա կտևի։
Կրկնություն R&D ոճով
Դասական «to do → in progress → done»-ի փոխարեն ML նախագծերը հակված են այսպես տեսք ունենալ. «Փորձեցինք → չաշխատեց → նորից փորձում ենք այլ կերպ»։
Ինչպես արդեն ասացի, տվյալները, որ ամուր էին թվում, կարող են թերի դուրս գալ, կամ մոդելի ճարտարապետությունը կարող է վատ ընտրություն լինել։ Սա հանգեցնում է փորձարկման և ուղղման ցիկլի։
Նույնիսկ հիպերպարամետրերի կարգավորումը կրկնվող գործընթաց է, որը սերտորեն կապված է մարզման տվյալների հավաքածուի հետ։
Վերջնական թեստեր չկան
ML-ում չկա unit թեստ, որը հայտարարի. «Մոդելն աշխատում է»։ Կան վիճակագրական մետրիկաներ, և դրանք պետք է մեկնաբանել։
Այլ ծախսային կորագիծ
Ծրագրային նախագծերում ծախսերը գագաթնակետին հասնում են մշակման ընթացքում և նվազում են տեղակայումից հետո, մնում է միայն սպասարկումը։
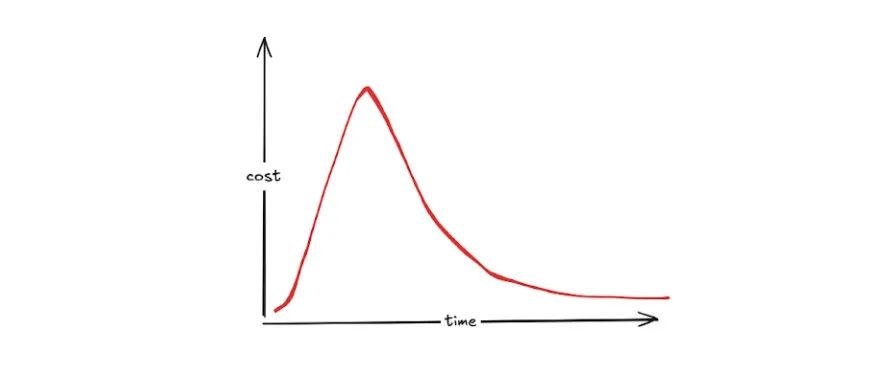
ML նախագծերի ծախսերը այդ կորագծին չեն հետևում։ Դրանք հաճախ մնում են բարձր կամ նույնիսկ ժամանակի ընթացքում աճում են, քանի որ.
- Մոդելները վատթարանում են և պետք է վերամարզվեն,
- Տվյալները փոխվում են և պետք է նորից վերլուծվեն,
- Փոփոխվող իրականությանը համապատասխանելու համար պետք է նոր մոդելներ կառուցվեն։
Ուրեմն ի՞նչ կարող եք անել
ML-ին մոտեցեք որպես հետազոտական նախագծի
Մտածեք ցիկլերով. վարկած → փորձ → վերլուծություն → որոշում – ճիշտ ինչպես R&D-ում։
Կառավարեք անորոշությունը, ոչ միայն առաջադրանքները
Հարցրեք ինքներդ ձեզ. ինչում վստահ չենք։ Որտեղ պետք է տվյալները վավերացնել։ Ինչը կարող է սխալ գնալ։
Պլանավորեք իրատեսական ժամանակացույց
Ներառեք այնպիսի փուլեր, ինչպիսիք են տվյալների ուսումնասիրությունը, փորձարկումը, վավերացումը, կարգավորումը և ինտեգրումը։
Ավելացրեք պաշար։ Հետո ավելացրեք ևս մեկը։
Կառավարեք սպասումները
Առաջընթացի մասին հաղորդեք հստակ և հաճախ.
«Մոդելը դեռ լավ չի աշխատում, որովհետև տվյալներում հայտնաբերեցինք X խնդիրը։ Աշխատում ենք դրա վրա»։ Այլ ոչ թե անորոշ խոստումներ, ինչպես. «MVP-ն համարյա պատրաստ է»։
Առասպել 5. ML մոդել = ML արտադրանք
Շատ հաճախորդներ, այդ թվում՝ խիստ տեխնիկականները, կարծում են, որ երբ մեքենայական ուսուցման մոդելը լավ է աշխատում, խնդիրը լուծված է։ Նրանց հարցն է.
«Մենք մոդել ունենք, և այն լավ է աշխատում։ Ե՞րբ կարող ենք դնել production»։
Առաջին հայացքից սա տրամաբանական է թվում. եթե մոդելը լավ է աշխատում թեստային հավաքածուի վրա, պետք է կարողանանք այն «միացնել համակարգին» և ավարտել։ Ցավոք, այդպես չի աշխատում։
ML մոդելը լուծման սիրտն է, բայց ինքնին այն արտադրանք չէ։ Այն չունի թոքեր, նյարդային համակարգ և դիմադրողականություն իր շուրջ դինամիկ միջավայրի փոփոխություններին։
Ինչն է այն դարձնում իրական ML արտադրանք
Պատկերացրեք ML մոդելը որպես շարժիչ։ Նույնիսկ եթե այն թերի չի աշխատում փորձադաշտում, առանց այլ մասերի այն ձեզ ոչ մի տեղ չի տանի։ Մեքենայի համար դրանք կլինեին փոխանցման տուփը, անիվները, արգելակները և այլն։ ML արտադրանքի համար դրանք են.
- Production միջավայր (որտեղ մոդելը տեղակայված է և հասանելի),
- Մուտքի և ելքի ինտերֆեյսներ (ինչպես են տվյալները մտնում մոդել և դուրս գալիս դրանից),
- Բիզնես տրամաբանություն դրա շուրջ (օրինակ՝ երբ պետք է կամ չպետք է կանչել մոդելը),
- Իրական ժամանակի մոնիտորինգ (այսօր լավ է աշխատում, ոչ թե միայն անցած շաբաթ),
- Վերամարզման մեխանիզմներ (քանի որ տվյալները փոխվում են, իսկ մոդելները հնանում են),
- Տվյալների և մոդելների տարբերակների կառավարում (ինչն է մարզվել և ինչ տվյալների վրա),
- Տեղակայման ենթակառուցվածք (CI/CD, API-ներ, հասանելիություն, անվտանգություն)։
Առանց այս բոլոր գործիքների մոդելը մնում է proof of concept, այլ ոչ production-ի համար պատրաստ լուծում։
Ինչ է պատահում, երբ այս առասպելը գոյատևում է
- Մոդելը գործարկվում է, բայց դադարում է պատշաճ աշխատել – որովհետև տվյալները փոխվել են, և ոչ ոք չի հետևել։
- Օգտատերերը չեն կարողանում հասկանալ կանխատեսումները – որովհետև մեկնաբանելիությունը երբեք չի քննարկվել։
- Թիմը չգիտի, թե ինչպես վերամարզել այն – որովհետև տվյալների և մարզման կոդի տարբերակների կառավարում չկա։
- Մոդելը կոտրվում է իրական աշխարհի մուտքերի վրա – որովհետև production API-ները տարբերվում են թեստային տվյալներից, կամ տվյալները շեղվել են, և մոդելը հնացել է։
Ինչպես ճիշտ անել
- Պլանավորեք ML արտադրանքը որպես ամբողջություն՝ սկսած առաջին օրվանից
Մի հարցրեք միայն. ինչպես ենք մարզելու մոդելը։
Հարցրեք նաև. ինչպես ենք այն հասցնելու, ինտեգրելու, սպասարկելու և բարելավելու։
- Որոշեք, թե ով է production փուլի սեփականատերը
ML թիմը։ DevOps թիմը։ Հաճախորդի IT բաժինը։
Սա ավելի կարևոր է, քան կարծում եք։
- Համոզվեք, որ մոնիտորինգը և մեկնաբանումը տեղում են
Ի՞նչ է նշանակում 0.87 կանխատեսումը։ Դա վստահությո՞ւն է։ Մոդելը վատթարացե՞լ է։
- Ընդունեք, որ մոդելը ընդամենը մեկ բաղադրիչ է
Նույնիսկ ամենալավ ալգորիթմը անարժեք է, եթե չի կարող օգտագործվել իրական աշխարհի գործընթացում։
Առասպել 6. Նոր ֆունկցիոնալություն ավելացնելը հեշտ կլինի
Երբեմն ML նախագծի կեսին հաճախորդը կարող է ասել.
«Հմմ, իսկ եթե X-ը կանխատեսելու փոխարեն փորձեինք Y-ը դասակարգել»։ Կամ. «Եկեք փոխենք մոդելը, գուցե XGBoost-ի փոխարեն նեյրոնային ցանց»։
Ավանդական ծրագրային նախագծերում նման փոփոխությունը մեծ բան չէ։ Ճշգրտում եք տրամաբանությունը, փոփոխում endpoint-ը, ավելացնում պայման, և վերջ։
Մեքենայական ուսուցման նախագծերում, սակայն, նույնիսկ խնդրի սահմանման չնչին փոփոխությունը կարող է նշանակել լուծման կեսը զրոյից վերակառուցել։
Ինչու է ML-ում փոփոխությունը = նորից սկսել
Մեքենայական ուսուցումը կախված է տվյալներից և հստակ սահմանված թիրախային փոփոխականից։ Եթե փոխում եք.
- թե ինչ եք փորձում կանխատեսել,
- թե ինչն է համարվում «դրական» դասը,
- թե որ feature-ներն են ազդում որոշման վրա,
…դուք ոչ միայն մեթոդն եք փոխում – դուք փոխում եք հենց խնդիրը։ Դա բերում է.
- նոր տվյալներ (կամ առկա տվյալները մշակելու այլ եղանակ),
- նոր feature engineering,
- նոր պիտակներ,
- մոդելի նոր ճարտարապետություն,
- գնահատման նոր մեթոդ,
- նոր ռիսկեր և հաջողության մետրիկաներ։
Դա նման է նրան, երբ հաճախորդը որոշում է, որ բաց պլանավորմամբ խոհանոց է ուզում՝ արդեն պահարանները տեղադրված լինելու պահին։ Հնարավո՞ր է դա անել։ Իհարկե։ Հե՞շտ է։ Ամենևին։
Օրինակ նախագծից
Մի նախագծում նպատակն էր կանխատեսել, թե որքան էսթետիկորեն գրավիչ է պատկերը։ Կես ճանապարհին հաճախորդը ավելացրեց պահանջ. կանխատեսումները պետք է ուղեկցվեն բացատրություններով, որպեսզի օգտատերերը կարողանան բարելավել իրենց պատկերը՝ հիմնվելով մոդելի ասածի վրա։
Առաջին հայացքից դա փոքր փոփոխություն էր թվում՝ գուցե ընդամենը ևս մեկ մոդուլ մեկնաբանելիության համար։ Իրականում այն պահանջեց.
- ընտրել և նախագծել մոդելի feature-ներ, որոնք օգտատերերը կարող են հասկանալ,
- վերակառուցել մարզման տվյալների հավաքածուն,
- վերամշակել նախնական մշակման և վավերացման տրամաբանությունը,
- վերամարզել և վերաթեստավորել մոդելները,
- և ստեղծել առաջարկներ գեներացնելու նոր մեխանիզմ։
Արդյունքը։ Երեք լրացուցիչ ամիս աշխատանք և քայլ հետ՝ դեպի տվյալների վերլուծության փուլ։
Ինչու է այս առասպելը դիմանում
- Ավանդական նախագծերում փոփոխությունը հաճախ հանգում է կոդին պայման ավելացնելուն։
- ML նախագծերի կառավարումը ինտուիտիվ չէ։ Մոդելի մեկնաբանելիություն ավելացնելը փոքր հնարավորություն է թվում, բայց հաճախ նշանակում է խնդրի վերասահմանում։
- Դրսից նայելիս ոչինչ չի փոխվում. մուտք, ելք, գծապատկերներ։
Սակայն ներսում դա լրիվ այլ պատմություն է։
Ինչպես դիմադրել դրան
- Հենց սկզբում հստակ սահմանեք խնդիրը և հաջողության մետրիկան։ Ի՞նչ ճիշտ ենք կանխատեսում։ Ինչպե՞ս ենք գնահատում «լավ» արդյունքը։ Ի՞նչն է ամենակարևորը։
- Փորձարկման փուլում կողպեք խնդրի սահմանումը։ Նոր գաղափարները ողջունելի են, բայց պետք է սպասեն հաջորդ իտերացիային։ Պահեք backlog և վերադարձեք դրան, երբ ընթացիկ փուլն ավարտվի։
- Խոշոր փոփոխություններին վերաբերվեք որպես նոր նախագծերի։ Նույնիսկ եթե դա «ընդամենը նոր մետրիկա է», ստուգեք, թե ինչպես է այն ազդում ամբողջ pipeline-ի վրա։
- Ներգրավեք ML թիմին որոշումների մեջ։ Ոչ ամեն շրջադարձ է արդարացված։ Երբեմն նպատակի փոփոխությունը ջնջում է մինչ այժմ կառուցված ամեն ինչի արժեքը։ ML թիմը կարող է օգնել արագ գնահատել գաղափարները և ներգրավված ջանքերը։
ML նախագծի կառավարում – ինչի համար պետք է պատրաստ լինել
Մեքենայական ուսուցումը գրավիչ է հնչում. ավտոմատացում, կանխատեսումներ, օպտիմիզացում, «խելացի որոշումներ»։ Եվ լավ կառուցված մոդելը իրոք կարող է էական բիզնես արժեք տալ։ Բայց մինչ այդ արժե հասկանալ մի քանի բան։
ML նախագիծը սպրինտ չէ, այլ ճանապարհորդություն չքարտեզագրված տարածք։ Որոշ բաներ կընթանան ըստ պլանի։ Մյուսները կպահանջեն ճշգրտումներ, փորձեր և այլ մոտեցում։ Ստորև թվարկված են բաները, որոնց համար պետք է պատրաստ լինել՝ ոչ թե ձեզ վախեցնելու, այլ անակնկալներից փրկելու համար։
Ամեն ինչ անմիջապես չի աշխատի
- Մոդելի առաջին տարբերակը հազվադեպ է վերջինը լինում։
- Փորձերը կարող են արդյունքները վատացնել, նախքան լավացնելը։
- Երբեմն մի քանի իտերացիա է պետք՝ պարզելու համար, թե խնդիրը ընդհանրապես լուծելի՞ է։
ML-ը գիտական գործընթաց է, ոչ թե պարզապես պատրաստի կտորների հավաքում։
Տվյալների պատրաստումը ժամանակ է պահանջում
- Տվյալները հասկանալը, մաքրելը և կազմակերպելը ավելի շատ ժամանակ կպահանջի, քան սպասում եք։
- Ձեզ օգնություն կպետք լինի տվյալների բիզնես համատեքստը ճանաչող մարդկանցից՝ հաճախ գործառնական թիմերից։
Սա միայն ML թիմի խնդիրը չէ. դա նախագծի կենսական մասն է։
ML-ը կարող է չստացվել
- Երբեմն տվյալները չափազանց նոսր են, չափազանց անհետևողական կամ պարզապես անբավարար։
- Երբեմն խնդրում հստակ օրինաչափություն չկա, և պարզ կանոնների վրա հիմնված մոտեցումը կարող է մոդելից ավելի լավ աշխատել։
Մեքենայական ուսուցումը ամեն խնդիր չի լուծում։ Եվ ավելի լավ է դա վաղ գիտակցել։
Ստիպված կլինեք հարմարվել
- Նպատակի սահմանման, տվյալների կամ նախագծի շրջանակի փոփոխությունները կարող են նշանակել մի քանի քայլ հետ գնալ։
- Նույնիսկ չնչին փոփոխությունները կարող են պահանջել մոդելի վերամարզում, ենթակառուցվածքի ճշգրտում կամ հաջողության չափման վերասահմանում։
ML նախագծերը ուժեղ են արձագանքում փոփոխությանը։ Դա թերություն չէ. դա պարզապես նրանց բնույթն է։
Շարունակական հսկողությունը պարտադիր է
- Մոդելը այն չէ, ինչ «միացնում ու մոռանում» ես։
- Այն պետք է մոնիտորվի, գնահատվի և թարմացվի – որովհետև ձեր տվյալներն ու բիզնես գործընթացները կշարունակեն փոխվել։
ML-ը աճում է ձեր ընկերության հետ միասին։ Այն պետք է դիտարկել որպես ձեր համակարգի մաս, ոչ թե որպես առանձին «գաջեթ»։
Ամփոփում
Մեքենայական ուսուցումը հսկայական ներուժ ունի։ Այն կարող է աջակցել որոշումներին, ավտոմատացնել գործընթացները և բացահայտել օրինաչափություններ, որոնք մարդիկ չեն տեսնում։ Սակայն այդ ներուժը իրապես իրացնելու համար պետք է հասկանալ, որ ML նախագծերը նման չեն ավանդական IT նախագծերին։
Ահա ինչ եմ հուսով, որ կհիշեք.
- Մոդելը արտադրանք չէ։ Այն արժեք է տալիս միայն լավ նախագծված գործընթացի մաս լինելով։
- Տվյալները հիմքն են։ ML մարտահրավերների մեծ մասը տեխնիկական չեն. դրանք բխում են տվյալների որակից, հասանելիությունից և հասկացումից։
- Ամեն ինչ կանխատեսելի չէ։ ML նախագծերը իտերատիվ և փորձարարական են և հաճախ պահանջում են ճանապարհին ենթադրությունների վերանայում։
- ML թիմի հետ աշխատանքը գործընկերություն է։ Դուք ճանաչում եք ձեր բիզնեսը, մենք՝ գործիքները. միասին կարող ենք ստեղծել իրապես արժեքավոր բան։
- Լավագույն արդյունքները գալիս են հստակությունից և նախապատրաստությունից։ Ամենահաջող նախագծերը սկսվում են հստակ նպատակով և գործընթացին մասնակցելու պատրաստակամությամբ։
Եթե պլանավորում եք մեքենայական ուսուցման նախագիծ, ձեզ նախապես բոլոր պատասխանները պետք չեն։ Սակայն օգտակար է գալ բաց մտքով, հստակ նպատակով և համագործակցելու պատրաստակամությամբ։
Որովհետև ML-ը կախարդանք չէ. այն համագործակցություն է, տրամաբանություն, տվյալներ և մի քիչ համբերություն։ Եվ լավ վարվող ML նախագիծը կարող է իրապես փոխել ձեր բիզնեսի աշխատանքի ձևը։