Աշխատո՞ւմ է արդյոք Vibe Coding-ը մեքենայական ուսուցման համար
Կարո՞ղ է vibe coding-ը փոխակերպել ML աշխատանքային հոսքերը։ Մենք փորձարկեցինք Cursor կոդավորման գործակալը EDA-ում, մոդելավորման, բացատրելիության և դեպլոյմենտի խնդիրներում՝ պարզելու համար։
Vibe coding-ն այնքան արագ է տարածվել, որ արդեն ունի իր սեփական Wikipedia էջը։ Եթե դեռ չեք լսել դրա մասին, vibe coding-ը մշակման նոր տեխնիկա է, որտեղ կոդը գրվում և հավելվածները կառուցվում են բնական լեզվի միջոցով։ Այն արդեն ուժեղ արդյունքներ է ցույց տվել ծրագրային ապահովման մշակման մի քանի ոլորտներում։ Մեքենայական ուսուցումը (ML) ընդգրկում է խնդիրների լայն շրջանակ, ինչպիսիք են՝
- տվյալների վիզուալիզացիան,
- մոդելների ուսուցումը,
- դրանց գնահատումը,
- դրանց դեպլոյը։
Կոդավորման գործակալները, ակնհայտորեն, կարող են արագացնել ռեգուլյար ծրագրավորման աշխատանքը, սակայն ավելի կարևոր հարցն այն է, թե արդյոք նրանք իսկապես կարող են աջակցել ML-ի հիմնական աշխատանքային հոսքերին։
Այս հոդվածում ես որպես գործակալային կոդի խմբագիր կօգտագործեմ Cursor-ը։ Ես նաև փորձել եմ կոդավորման գործակալներ VSCode-ում, բայց իմ փորձով Cursor-ն առաջարկում է ավելի հարթ և արդյունավետ աշխատանքային հոսք, հատկապես ML-ի հետ կապված մշակման համար։
Տվյալների հավաքածուներ
Իմ թեստերի համար ընտրեցի երկու շատ տարբեր տվյալների հավաքածու՝ բույսերի հիվանդությունների տվյալների հավաքածուն DiaMOS-ից և Unemployment Duration տվյալների հավաքածուն։ Նրանց կառուցվածքն ու բարդությունը զգալիորեն տարբերվում են, ինչը ինձ թույլ տվեց ստուգել, թե կոդավորման գործակալներն ինչպես են հաղթահարում ինչպես պարզ, այնպես էլ ավելի պահանջկոտ ML խնդիրները։
Բույսերի հիվանդությունների տվյալների հավաքածուն առաջադրում է բավականին պարզ վերահսկվող ուսուցման խնդիր՝ 4 դասով դասակարգում։ Յուրաքանչյուր պատկեր ցույց է տալիս բույսի տերևի մի տեսակ և ունի հիվանդության չորս պիտակներից մեկը։ Սա այն լավ է համապատասխանեցնում հիմնական ուսուցման փայփլայնների, պատկերների նախամշակման և բացատրելիության տեխնիկաների (օրինակ՝ Grad-CAM կամ saliency maps) փորձարկմանը։ Դասերը չափավոր անհավասարակշիռ են, բայց ընդհանուր առմամբ տվյալների հավաքածուն մաքուր է և տեսողականորեն համահունչ, ինչը թույլ է տալիս արագ նախատիպավորում և մոդելի իտերացիա։
Unemployment Duration տվյալների հավաքածուն, ընդհակառակը, շատ ավելի դժվար մարտահրավեր է։ Սա գոյատևման վերլուծության խնդիր է. թիրախը ֆիքսված պիտակ չէ, այլ գործազրկության տևողությունը, որն ուղեկցվում է ցենզուրավորման ցուցիչներով, որոնք ասում են՝ իրադարձությունը (աշխատանք գտնելը) տեղի ունեցել է, թե ոչ։ Տվյալների հավաքածուն պարունակում է մի քանի one-hot կոդավորված փոփոխականներ, թվային հատկանիշներ (օր.՝ տարիք, աշխատավարձ) և ժամանակային բաղադրիչներ։ Նման կառուցվածքը պահանջում է ավելի խորը ըմբռնում, թե ինչ է նշանակում յուրաքանչյուր փոփոխական՝ նախ և առաջ ցենզուրավորման տրամաբանությունը, որպեսզի վերլուծությունն ու մոդելավորումը մոլորեցնող արդյունքներ չտան։
Երկու տվյալների հավաքածուները լրացնում են միմյանց. մեկը վերաբերում է պատկերային տվյալների արդյունավետ դասակարգմանը, մյուսը՝ ցենզուրավորված «ժամանակ մինչև իրադարձություն» կանխատեսման նրբություններին։ Միասին նրանք ամուր հիմք են տալիս գնահատելու, թե ինչ կարող են և ինչ չեն կարող գործակալներով վարվող մեքենայական ուսուցման աշխատանքային հոսքերը։
Հետախուզական տվյալների վերլուծություն
Հետախուզական տվյալների վերլուծության (EDA) հուշումը (prompt) շատ պարզ էր՝
Create EDA for plant-disease from scratch as a jupyter notebook.
Արդյունքը անմիջապես նոթբուքում գրելու համար ինձ անհրաժեշտ էր օգտագործել Sonnet-4 մոդելը։
Ստացված նոթբուքը տպավորիչ էր։ Գրաֆիկների հավասարեցման մի քանի փոքր խնդիրներից բացի, այն տվեց հիմնական EDA արդյունքների օգտակար հավաքածու՝ վիզուալիզացիաներ յուրաքանչյուր դասի համար, դասերի բաշխման վիճակագրություն, ինչպես նաև պատկերների չափերի հարաբերակցություններ և հաճախականությունների բաշխումներ։ Վերլուծությունը անմիջապես ակնհայտ դարձրեց, որ տվյալների հավաքածուն անհավասարակշիռ է։
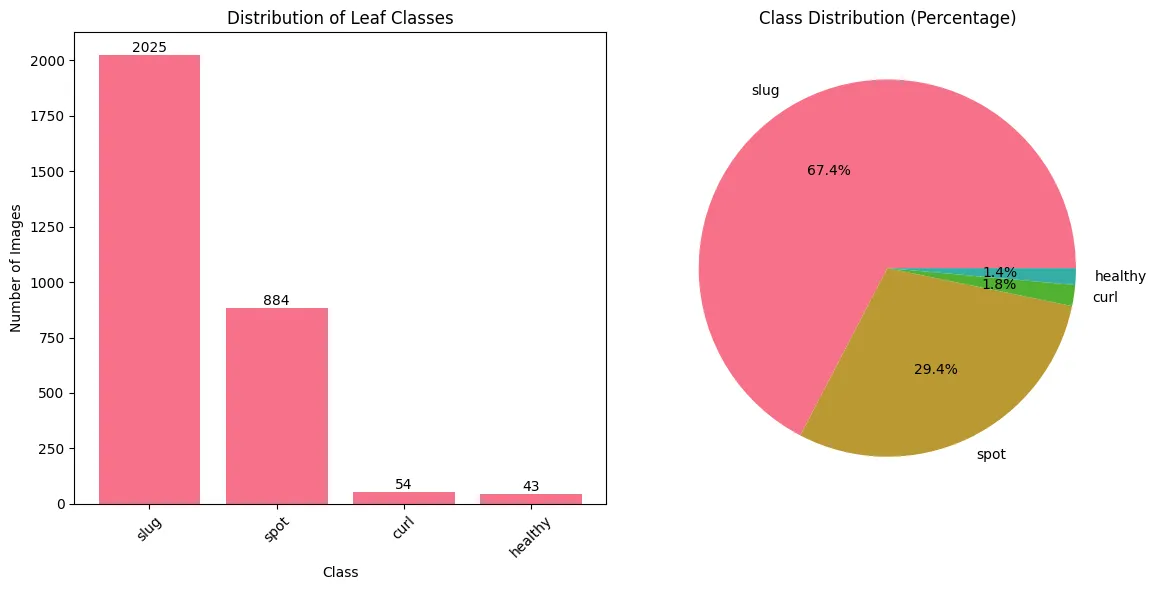
Մոդելն առաջարկեց նաև գործնական առաջարկություններ՝ ածանցված իր գտածոներից, որոնք նպատակ ունեին բարձրացնել մոդելի արդյունավետությունը՝ լուծելով տվյալների հավաքածուի հնարավոր խնդիրները։
Այս մոտեցումը զգալիորեն արագացնում է վաղ EDA փուլը, քանի որ տվյալների հավաքածուին հարմարեցված կոդն ու արդյունքները գեներացվում են ավտոմատ։ Սակայն ML մասնագետները դեռ պետք է ստուգեն արդյունքները։ Պատկերային տվյալների հավաքածուները լավ են համապատասխանում այսպիսի ավտոմատ վերլուծությանը, բայց ավելի բարդ տվյալների կառուցվածքները կարող են հանգեցնել սխալ եզրակացությունների կամ թերի վիզուալիզացիաների։
Հնարավոր խնդիրներ՝
- Հայտնաբերվեց դասերի անհավասարակշռություն։ Մոդելն առաջարկեց լուծել այն տվյալների աուգմենտացիայով կամ կշռված կորստի ֆունկցիայով։
- Պատկերների չափերը բավականին միատեսակ էին, ինչը պարզեցնում է նախամշակումը։
Առաջարկություններ՝
- Օգտագործել տվյալների աուգմենտացիա՝ տվյալների հավաքածուն մեծացնելու և ընդհանրացումը բարելավելու համար։
- Train/validation բաժանումը կատարել ստրատիֆիկացված եղանակով, որպեսզի դասերի բաշխումը պահպանվի։
- Բոլոր պատկերները հասցնել նույն չափերի (օր.՝ 224×224)՝ մուտքը ստանդարտացնելու համար։
- Նորմալացնել պատկերները ImageNet-ի վիճակագրությամբ, հատկապես transfer learning օգտագործելիս։
Հնարավոր խնդիրներ
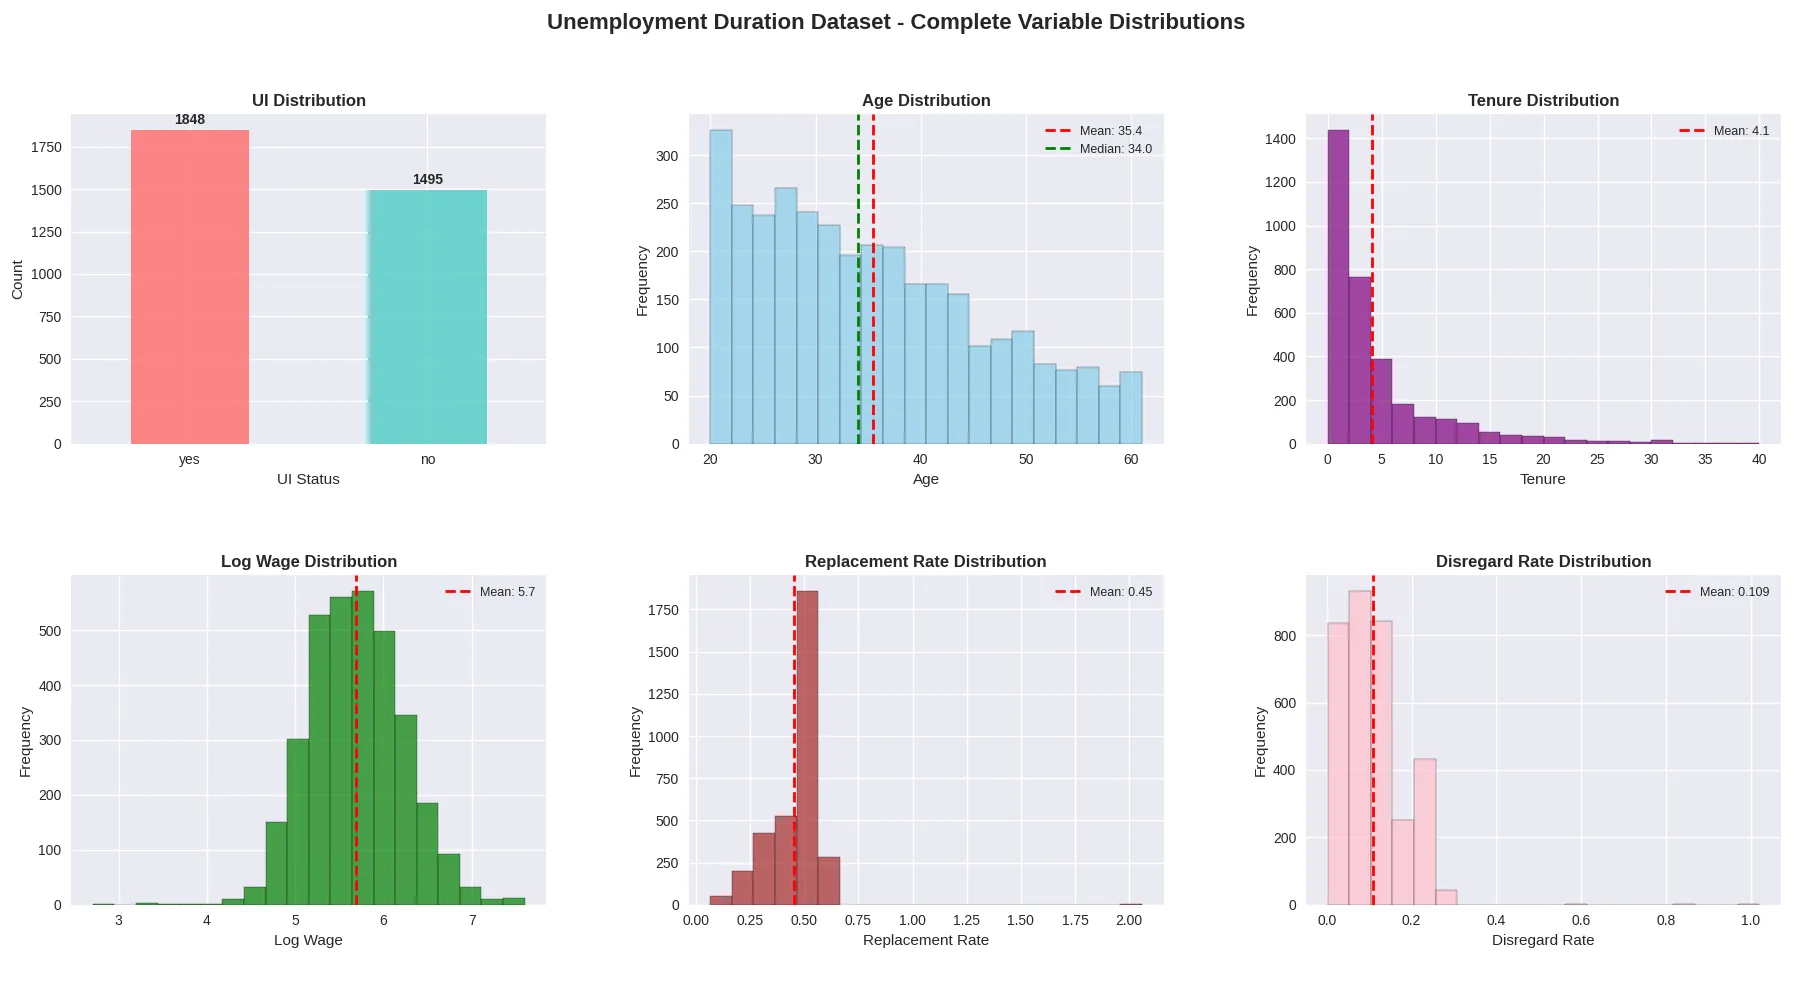
Գործազրկության տվյալների հավաքածուն լավ օրինակ է EDA արդյունքի, որը լիովին ճիշտ չէ։ Ստորև ամփոփված է, թե ինչ արտադրեց մոդելը նույն տվյալների հավաքածուի վրա երկու իտերացիայում։
Cursor-ի արդյունքը
Առաջին իտերացիա՝
🔍 ԳԼԽԱՎՈՐ ԵՂՐԱԿԱՑՈՒԹՅՈՒՆՆԵՐ՝
- UI ստացողներ. միջինը 8.0 շաբաթ
- Ոչ UI ստացողներ. միջինը 4.1 շաբաթ
- Տարբերություն. 3.9 շաբաթ (UI ստացողների համար ավելի երկար)
Երկրորդ իտերացիա՝
⏱️ ՏԵՎՈՂՈՒԹՅԱՆ ԸՆԹԱՑՔԸ՝
- Միջին տևողություն. 6.2 շաբաթ
- Մեդիանային տևողություն. 5.0 շաբաթ
- Տևողության փոփոխականություն. 5.6 շաբաթ (std)
- Տիրույթ. 1–28 շաբաթ
- Բաշխում. աջ թեք (skewness = 1.52)
🔍 ԳԼԽԱՎՈՐ ԵՂՐԱԿԱՑՈՒԹՅՈՒՆՆԵՐ՝
- UI-ի ազդեցություն. +3.9 շաբաթ (UI ստացողների համար ավելի երկար)
- Տարիքի հետ կորելյացիա. 0.153 (դրական կապ)
- Աշխատավարձի հետ կորելյացիա. 0.040 (ավելի բարձր աշխատավարձ = ավելի երկար որոնում)
- Փոխարինման դրույքի հետ կորելյացիա. -0.030
Ակնհայտ է, որ արդյունքները տարբերվում են մի գործարկումից մյուսը, թեև տվյալների հավաքածուն չի փոխվել, և արդյունքները ստացվել են հենց մոդելի գեներացրած կոդից։ Ավելի վատն այն է, որ երկու արդյունքներից և ոչ մեկը ճիշտ չէ։
Խնդրի արմատը տվյալների հավաքածուի կառուցվածքում է, որը պարունակում է չորս one-hot կոդավորված ցենզուրավորման փոփոխական՝ նկարագրելով, թե ինչպես է ավարտվել գործազրկության շրջանը։
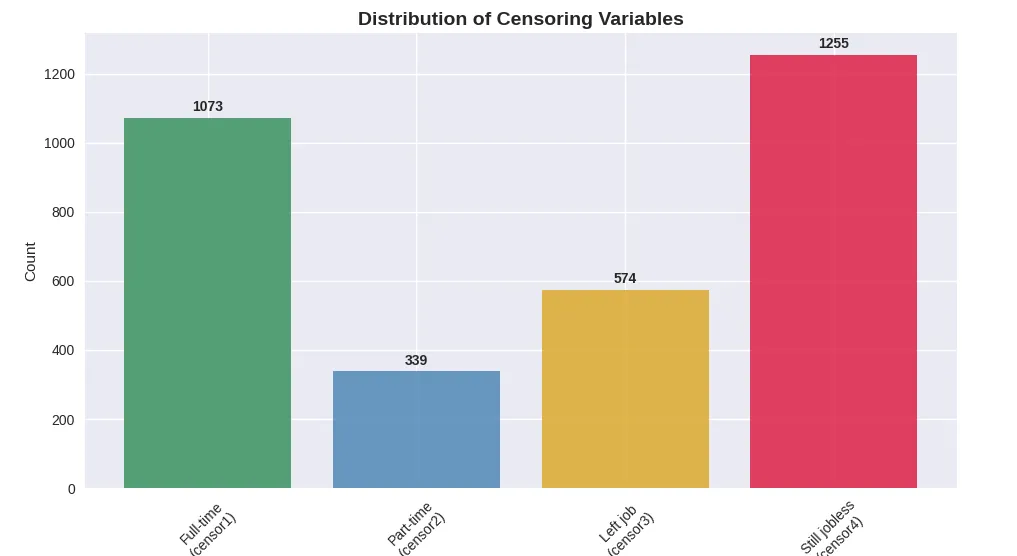
Այս փոփոխականները մեզ ասում են, ինչ տեսակի իրադարձությամբ է ավարտվել (կամ չի ավարտվել) գործազրկության շրջանը։ Ցավոք, մոդելը դրանք դիտարկում է որպես անկախ մուտքային հատկանիշներ՝ արդյունքի հետ կապված ցուցիչների փոխարեն, թեև ուղեկցող փաստաթղթավորումը հստակ նշում է դրանց նպատակը։
Օրինակ՝ երբ գրանցված տևողությունը 14 շաբաթ է և censor4-ը հավասար է 1-ի, սուբյեկտը դեռ գործազուրկ էր, երբ դիտարկման պատուհանը փակվեց, և իրադարձությունը (աշխատանք գտնելը) այդպես էլ տեղի չունեցավ։ Այդ դեպքում իրական տևողությունը աջից ցենզուրավորված է. գործազրկության շրջանը ավելի երկար է, քան տվյալների հավաքածուում արձանագրված 14 շաբաթը։
Տվյալների հավաքածուի բացատրող փոփոխականները թվարկված են ստորև՝
AutoML ընդդեմ Vibe Coding-ի
Այսօրվա շատ AutoML ֆրեյմվորքեր թույլ են տալիս կառուցել մեքենայական ուսուցման ամբողջական փայփլայններ՝ քիչ ձեռքի աշխատանքով և ML-ի համեստ գիտելիքներով։ Սա մեծապես իջեցնում է մուտքի շեմը, բայց հաճախ արտադրում է փոքր ճկունությամբ «սև արկղ» մոդելներ, ինչը դժվարացնում է արդյունքները վրիպազերծելը, ընդլայնելը կամ մեկնաբանելը՝ հատկապես բարդ կամ կարգավորվող միջավայրերում։
Vibe coding-ը, ընդհակառակը, օգտագործում է բնական լեզվով հուշումներ և մեծ լեզվական մոդելներ՝ աջակցելու այն մշակողներին, ովքեր արդեն ունեն մեքենայական ուսուցման փորձառություն կամ գոնե կարող են ստուգել և վավերացնել արդյունքները։ Այն կարող է արագացնել ML փայփլայնների կառուցումը՝ պահպանելով լիարժեք վերահսկողություն կոդի, ճարտարապետության և մեկնաբանելիության նկատմամբ։ Մշակողները ազատ են ընդլայնել կամ ճշգրտել փայփլայնը ըստ կարիքի՝ գտնելով հավասարակշռություն ավտոմատացման և թափանցիկության միջև։ Ստորև բերված աղյուսակը ներկայացնում է երկու մոտեցումների բարձր մակարդակի համեմատությունը՝
| Ասպեկտ | AutoML | Vibe Coding |
|---|---|---|
| Նպատակ | Ավտոմատացնում է ML ամբողջ փայփլայնը սկզբից մինչև վերջ | Արտադրում է ML կոդ բնական լեզվով հուշումներից |
| Ճկունություն | Ցածր–միջին. ֆիքսված, նախասահմանված աշխատանքային հոսքեր | Բարձր. համապատասխանում է կոդավորման ցանկացած սցենարի |
| Օգտագործման հեշտություն | Շատ հեշտ. կոդավորում գրեթե պետք չէ | Պահանջում է կոդավորման հմտություններ և ML-ի ըմբռնում |
| Լավագույնս հարմար է | Արագ նախատիպավորում, կառուցվածքային տվյալներ, բիզնես հավելվածներ | Հատուկ ML աշխատանքային հոսքեր, փորձեր, PoC-ներ |
| Ուսուցողական արժեք | Ցածր. թաքցնում է բարդության մեծ մասը | Բարձր. խթանում է ML-ի գործնական ուսուցումն ու իտերացիան |
Vibe coding-ով PoC պատկերների դասակարգիչ
Իմ թեստերում ես հենվեցի մոդելի ավտոմատ ընտրության վրա և սկսեցի այս հուշումով՝
Կառուցիր PyTorch-ով թեթև պատկերների դասակարգման մոդել՝ տերևների պատկերները 4 կատեգորիայի դասակարգելու համար։ Օգտագործիր պատկերների դասակարգման փոքր մոդելներից մեկը։ Բեռնիր պատկերները դիրեկտորիայից և ներառիր նախամշակման, ուսուցման և գնահատման քայլերը։ Կոդը պահիր մոդուլային, արդյունավետ և լավ մեկնաբանված։
Բույսերի հիվանդությունների տվյալների հավաքածուի վրա Cursor-ը արտադրեց կոդ, որն ընդգրկում էր տվյալների բեռնումը, հիմնական նախամշակումը, train-validation բաժանումը (թեև առանց ֆիքսված random seed-ի), մոդելի ուսուցումը և գնահատումը։ Հաղորդված ուսուցման ճշգրտությունը հասավ 87%-ի, ինչը սկզբում տպավորիչ է հնչում, այնպես չէ՞։
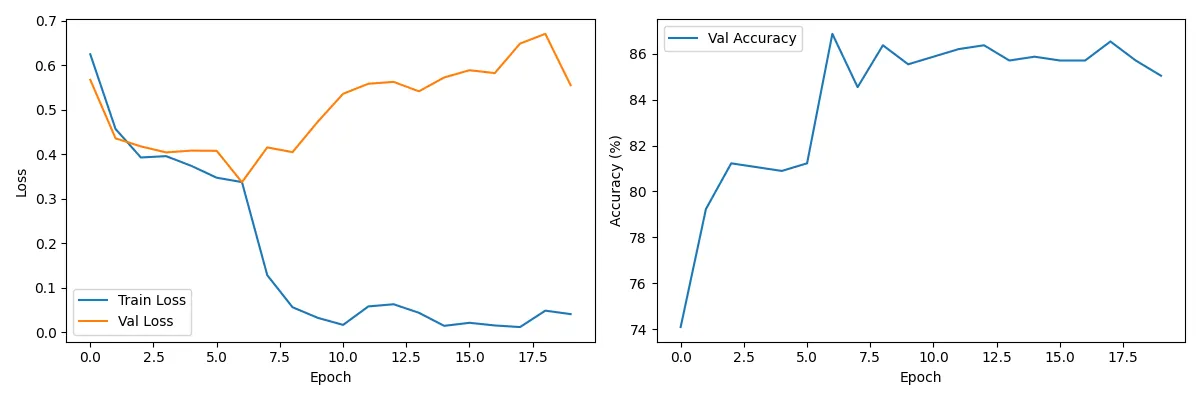
Գրաֆիկները ներկայացնում են կորստի մետրիկաները վերափոխված տվյալների հավաքածուի վրա
Սակայն կան մի քանի խնդիրներ, որոնք արժե նշել՝
- Գերուսուցման ռիսկ. կորստի գրաֆիկները ցույց են տալիս, որ ուսուցման և վալիդացիայի կորուստները որոշ պահից հեռանում են իրարից, ինչը նշան է, որ մոդելը սկսում է գերուսուցվել։ Ուսուցումը, հավանաբար, պետք է ավարտվեր ավելի շուտ։
- Վատնված հաշվարկ. ուսուցման շատ էպոխներ, ամենայն հավանականությամբ, լրացուցիչ արդյունավետություն չբերեցին և կարող էին բաց թողնվել՝ ժամանակ ու ռեսուրսներ խնայելու համար։
- Seed-ից զուրկ բաժանում. քանի որ տվյալների հավաքածուի բաժանումը seed չուներ, արդյունքները հնարավոր չէ հուսալիորեն վերարտադրել, և ուսուցանված մոդելը չի կարելի պատշաճ թեստավորել, քանի որ չգիտենք, թե որ տվյալները որ բազմությունում հայտնվեցին։
- Մետրիկայի սահմանափակումներ. 87% ճշգրտությունը կարող է տպավորիչ թվալ, բայց 4 դասով դասակարգման խնդրում այն կարող է խաբուսիկ լինել, հատկապես անհավասարակշիռ դասերի բաշխման դեպքում։ Առանց դասերի համամասնությունների մասին պատկերացման, մոդելը կարող էր պարզապես սովորել կանխատեսել գերակշռող դասը, որը կարող էր կազմել նմուշների 87%-ը։ Նման դեպքում միայն ճշգրտությունը բավարար չէ։ Ավելի տեղեկատվական մետրիկաներ են F1 score-ը, ROC կորերը (յուրաքանչյուր դասի համար) կամ ամբողջական classification report-ը, որը տալիս է precision, recall և support յուրաքանչյուր դասի համար։
Մի քանի իտերացիայից հետո ես կարողացա ավելացնել early stopping 3 էպոխ համբերությամբ և կարգավորել ուսուցումը այնպես, որ պահպանի լավագույն արդյունք ցույց տվող մոդելը։ Գործակալը չկարողացավ այս փոփոխությունները կատարել ինքնուրույն և ճիշտ անելու համար պահանջվեց ձեռքով ուղղորդում։
Այս բարելավումների շնորհիվ մոդելը լավ արդյունք ցույց տվեց թեստային բազմության վրա՝ հասնելով 0.867 ճշգրտության և 0.869 F1 score-ի։
Ահա classification report-ը ամբողջությամբ՝
            precision    recall  f1-score   support

     healthy     0.7500    0.8571    0.8000         7
        spot     0.7634    0.8680    0.8124       197
        slug     0.9307    0.8660    0.8972       388
        curl     1.0000    0.9000    0.9474        10

    accuracy                         0.8671       602
   macro avg     0.8610    0.8728    0.8642       602
weighted avg     0.8750    0.8671    0.8691       602
Դրականն այն է, որ Cursor-ը հիանալի աշխատանք կատարեց DataLoader կառուցելիս՝ ներառյալ նախամշակման ժամանակ MobileNet-ի ImageNet վիճակագրությամբ պատշաճ նորմալացումը։ Ընդհանուր առմամբ, փորձը ցույց տվեց, որ դասակարգման այս տեսակը իրագործելի է, և Cursor-ը արագ հավաքեց PoC, որը քիչ թե շատ աշխատում էր։
AutoML PoC
Ես նաև ստուգեցի, թե vibe coding-ով ստեղծված լուծման արդյունքները ինչպես են համեմատվում AutoML մոտեցման հետ։ Համեմատության համար օգտագործեցի AutoKeras-ը, որը ավտոմատ կառուցում է պատկերների դասակարգման մոդելներ՝ նախապես ուսուցանված ճարտարապետությունների հավաքածուից, ինչպիսիք են EfficientNet, ResNet, Xception և MobileNet։
AutoKeras-ը կարգավորեցի աշխատելու 5 փորձով (trial), և նրա լավագույն մոդելը հասավ 67% ճշգրտության։ Այդ թիվը, սակայն, խաբուսիկ է։ AutoML պրոցեսը թվում էր չափազանց կենտրոնացած validation loss-ի նվազագույնի հասցնելու վրա, ուստի ընտրեց մոդել, որը պարզապես կանխատեսում էր մեծամասնության դասը։ Ճշգրտությունն այստեղ քիչ բան է նշանակում, քանի որ մոդելը սովորել է գրեթե բոլոր նմուշները վերագրել մեկ գերակշռող դասի։
Հետաքրքիր է, որ AutoKeras-ը եզրակացրեց, թե առաջարկված նախապես ուսուցանված ճարտարապետություններից և ոչ մեկը լավ չի համապատասխանում, և փոխարենը ընտրեց սովորական CNN-ը ուսուցանել զրոյից։ Ստորև բերված classification report-ը ամփոփում է, թե ինչպես աշխատեց այս մոդելը՝
             precision    recall  f1-score   support

           0       0.00      0.00      0.00         8
           1       0.00      0.00      0.00         7
           2       0.67      1.00      0.81       304
           3       0.00      0.00      0.00       132

    accuracy                           0.67       451
   macro avg       0.17      0.25      0.20       451
weighted avg       0.45      0.67      0.54       451
Այս արդյունքը ակնհայտ է դարձնում դասերի անհավասարակշռության խնդիրը և մոդելի անկարողությունը ընդհանրացնելու բոլոր դասերի վրա։ Թեև ճշգրտությունը մակերեսորեն ողջամիտ է թվում, macro F1 score-ը և յուրաքանչյուր դասի մետրիկաները բացահայտում են արդյունավետության մեծ բացեր։
Իմ հանդիպած սահմանափակումներից ու սխալներից բացի, գործընթացը նաև լիովին պարզ չէր։ Տվյալների հավաքածուն այնքան մեծ էր, որ ամպային AutoML գործիքները անիրագործելի էին բեռնման և մշակման սահմանափակումների պատճառով։ Դրան գումարած, AutoKeras-ը չի զբաղվում տվյալների բեռնմամբ, ուստի ստիպված էի գրել իմ սեփական տվյալների բեռնիչը, կիրառել անհրաժեշտ նախամշակումը և տվյալների հավաքածուն ձեռքով բաժանել ուսուցման, վալիդացիայի և թեստային բազմությունների։
Փորձեր
Հաջորդը վերադարձա բույսերի հիվանդությունների տվյալների հավաքածուին և օգտագործեցի այս հուշումը՝
Create experiments for leaves model.
Գործակալի առաջարկած կոդը բավարար էր հիմնական վալիդացիայի համար և պարունակում էր փորձերի երեք մակարդակ՝ նախատեսված ուսուցման փայփլայնի տարբեր կոնֆիգուրացիաներ ստուգելու համար։ Դրանք կառուցված էին այսպես՝
- Simple Experiments-ը ստուգեց երեք learning rate-ի, երեք batch size-ի և երեք օպտիմիզատորի համակցությունները։
- Quick Experiments-ը ավելի առաջ գնաց՝ ընդգրկելով հիպերպարամետրերի համակցությունների ավելի լայն շրջանակ և ավելացնելով տվյալների աուգմենտացիայի տեխնիկաներ։
- Full Grid Search-ը կատարեց սահմանված learning rate-երի, batch size-երի և օպտիմիզատորների բոլոր հնարավոր համակցությունների սպառիչ որոնում։
Սա լավ մեկնակետ է վաղ փորձարկումների համար։ Փորձի յուրաքանչյուր տեսակ աշխատում է մեկ էպոխ, և կոդը ճիշտ է աշխատում՝ հաղորդելով ճշգրտության մետրիկաներ պարամետրերի տարբեր կոնֆիգուրացիաների համար։ Այն նաև կատարում է յուրաքանչյուր թեստում օգտագործված պարամետրերի հիմնական լոգավորում։
Ահա simple experiments-ի արդյունքները՝
🎯 Best Learning Rate: 0.001 (81.73%)
📦 Best Batch Size: 32 (83.89%)
⚡ Best Optimizer: SGD (84.72%)
Սակայն բացակայում է տվյալների հավաքածուի տարբերակների հետևումը, և ամեն ինչ ամբողջովին կախված է grid search-ից։ Նույնիսկ թեստերի քանակը սահմանափակելու հնարավորությամբ այն թերի է արդյունավետության և ճկունության առումով։
Random search-ը կամ դետերմինիստական սեմփլերները, ինչպիսին TPE-ն է, grid search-ի ավելի արդյունավետ այլընտրանք են, քանի որ օպտիմիզացնում են արդյունքները՝ առանց բոլոր համակցությունները սպառիչ փորձելու։ Այնպիսի գործիքները, ինչպիսիք են Hydra-ն Optuna Sweeper-ի հետ, էլ ավելի են պարզեցնում փորձերի կառավարումը և թույլ տալիս հիպերպարամետրերի առաջադեմ, զուգահեռացված կարգավորում։
Բացատրելիություն
Ես փորձարկեցի բացատրելիությունը NLP-ի վրա հիմնված դասակարգման մոդելի վրա՝ ավելացնելով SHAP հատկանիշների ազդեցությունը ուսումնասիրելու համար։ Գործակալը, սակայն, լիովին չհասկացավ փայփլայնը։ Այն օգտագործեց նմուշային տեքստային մուտքեր, որոնք կապ չունեին իրական տվյալների հավաքածուի հետ, և նույնիսկ օրինակներ արտադրեց սխալ լեզվով։ Մի քանի փորձից հետո էլ այն չկարողացավ իմաստալից արդյունք տալ։ Ավելի ճշգրիտ և մանրամասն հուշումը գուցե թույլ տար աշխատեցնել այն, բայց կարծում եմ, նման մասնագիտացված հուշում գրելը ավելի շատ ժամանակ է պահանջում, քան բացատրելիությունը ձեռքով իրականացնելը։
Վերադառնալով բույսերի հիվանդությունների տվյալների հավաքածուին, ուզում էի գնահատել ավելի վաղ գեներացված պատկերների դասակարգման մոդելի բացատրելիությունը։ Գործակալից խնդրեցի Feature Activation Maps, Grad-CAM և Saliency Maps։
Արդյունքները աշխատեցին, բայց դրանց հասնելը անարդյունավետ էր։ Գործակալը գրեց ավելի քան 1000 տող կոդ, ցրված գրեթե նույնական սկրիպտների մի քանի տարբերակների վրա (օր.՝ grad_cam.py, simple_grad_cam.py, working_gradcam.py և այլն), և ամբողջն արեց մոտ 30 րոպեում։ Գործնականում այս վիզուալիզացիաները կարելի էր անել 50-ից պակաս տողով կոմպակտ, ընթեռնելի կոդով։ Վերջնական արդյունքը տեխնիկապես ճիշտ էր, բայց գործակալի ավելորդ ծախսերը նվազեցրին դրա իրական օգտակարությունը։
Դեպլոյմենտ
Մեկ այլ թեստում Cursor-ին խնդրեցի օգնել դեպլոյ անել ավելի բարդ մեքենայական ուսուցման փայփլայն։
Գնահատվող փայփլայնը բաղկացած էր մի քանի մասից։ Նախ՝ PaddleOCR-ը սկանավորում էր կտրոնները և դրանք վերածում տող առ տող տեքստի։ Հաջորդը՝ ապրանքների նկարագրությունները տոկենիզացվում էին all-MiniLM-L6-v2 sentence transformer-ով։ Վերջում embedding-ները գնում էին XGBoost դասակարգիչի, որը նշանակում էր վեց նախասահմանված ապրանքային կատեգորիաներից մեկը։
Cursor-ը չկարողացավ արտադրել լիովին աշխատող լուծում առանց ծանր ձեռքով միջամտության։ Այն ընտրեց սխալ մոդելներ (բնօրինակ տարբերակը՝ տեղում լրացուցիչ ուսուցանվածի փոխարեն), օգտագործեց OCR-ի տարբեր կոնֆիգուրացիաներ և արդյունքները ցուցադրեց անհետևողականորեն մի իտերացիայից մյուսը։ Աշխատող իրականացում ստանալու համար պահանջվեց քայլ առ քայլ երկխոսություն՝ ճշգրտված հուշումներով և տարբեր բաղադրիչների ձեռքով ուղղումներով։
Ի վերջո, մի քանի իտերացիայից հետո փայփլայնը հաջողությամբ դեպլոյվեց։ Այն օգտագործեց FastAPI՝ մոդելը սպասարկելու համար և Gunicorn՝ որպես հավելվածի սերվեր։ Cursor-ը նաև կառուցեց պարզ օգտատիրական ինտերֆեյս՝ պատկերներ վերբեռնելու և արդյունքը դիտելու համար։ Կարգավորումը հեռու էր production-ի պատրաստ լինելուց, բայց այն ամուր proof-of-concept էր և ցույց տվեց, որ մոտեցումը կենսունակ է։
Այս մասին կարելի է վիճել, բայց Cursor-ը թվում էր, թե վրիպազերծման ընթացքում մի քանի անգամ մոլորվեց։ Որոշ իրավիճակներում կոդը ձեռքով գրելը, կամ ավելի ճիշտ՝ չատի միջոցով, գուցե ավելի արագ հանգեցներ աշխատող լուծման, հիմնականում այն պատճառով, որ լուծումը կարող էր ավելի կարճ լինել, քան մանրամասն հուշումը։ Փայփլայնի մեծ կոնտեքստն ու բարդությունը, հավանաբար, մեղավոր էին։ Սակայն հստակ պլյուսն այն էր, որ արդյունքների գեներացված վիզուալ ներկայացումը մաքուր և ինտուիտիվ էր։
Եզրակացություններ
Կոդավորման գործակալները, անկասկած, ծրագրավորման ապագայի կենտրոնական մասն են։ Սակայն փորձառու մեքենայական ուսուցման մասնագետները դեռ անփոխարինելի են մշակումը հսկելու և ուղղորդելու համար։ Ոլորտի փորձագիտություն ունեցողի ձեռքում այս գործիքները հստակ արտադրողականության աճ են բերում։ Սակայն դրանք հեշտությամբ կարող են տալ մոլորեցնող կամ սխալ արդյունքներ, երբ օգտագործվում են հիմքում ընկած մեթոդների ամուր ըմբռնում չունեցող մարդկանց կողմից։
Գործնականում կոդավորման գործակալները ավելի շատ գործում են որպես նոր սերնդի IDE-ներ. նրանք փայլում են, երբ ավարտում են վերահսկվող կոդը կամ ճշգրիտ, փորձագիտական մակարդակի հրահանգներից արտադրում լավ սահմանված ֆունկցիաներ։
Կոդավորման գործակալները դեռ չեն կարող տրամադրել լիովին production-ի պատրաստ հավելվածներ՝ մի շարք պատճառներով։ Հիմնական սահմանափակումներից մեկը նրանց թերի կոնտեքստային ըմբռնումն է, որը հակված է դրսևորվել նուրբ, բայց էական ձևերով։ Օրինակ՝ երբ Cursor-ին մի քանի առնչվող խնդիր տվեցի, այն չվերօգտագործեց արդեն գեներացրած կոդը, նույնիսկ համապատասխան կոնտեքստը տրամադրելու դեպքում, և ամեն անգամ նոր կոդ գրեց զրոյից։ Սա օրինական մտահոգություններ է առաջացնում կոդի պահպանելիության, համահունչության և աշխատանքային հոսքի ընդհանուր արդյունավետության վերաբերյալ։
Իմ փորձով՝ Cursor-ը դժվարանում էր միջավայրերի կառավարման հետ։ Այն հաճախ անտեսում էր առկա վիրտուալ միջավայրը և փորձում փաթեթները տեղադրել գլոբալ։ Արդյունքում այն անհարկի կերպով վերատեղադրում էր կախվածությունները՝ uv-ի նման գործիքներ օգտագործելու կամ վիրտուալ միջավայրերը պատշաճ կառավարելու փոխարեն, ինչը նվազեցնում էր կատարման արդյունավետությունը։
Դրական կողմում՝ Cursor-ը հատկապես լավ աշխատեց տվյալների վերլուծության և վիզուալիզացիայի ոլորտում։ Նույնիսկ այնտեղ, որտեղ ավելի մանրամասն բացատրություններ էին պետք, վիզուալիզացիաները ճշգրիտ էին, հստակ և գեղեցիկ ներկայացված։ Նրա մյուս ուժեղ կողմերն են նախագծի կառուցվածքավորումը, տվյալների բեռնումը և proof-of-concept-ների գեներացումը բավականին պարզ տվյալների հավաքածուների համար։ Մանրամասն, քայլ առ քայլ հուշումները կարող են այս հնարավորությունները էլ ավելի առաջ մղել։
Ամփոփելով՝ ես մտադիր եմ շարունակել օգտագործել կոդավորման գործակալներ իմ առօրյա աշխատանքում և խրախուսում եմ ձեզ նույնպես տեսնել, թե ինչպես դրանք կարող են բարելավել ձեր աշխատանքը։