هل ينجح Vibe Coding في تعلّم الآلة؟
هل يمكن لـ vibe coding أن يغيّر سير عمل تعلّم الآلة؟ اختبرنا وكيل البرمجة Cursor في تحليل البيانات الاستكشافي والنمذجة وقابلية التفسير والنشر لنرى.
انتشر vibe coding بسرعة كبيرة حتى صار له صفحة في ويكيبيديا. وإن لم تكن قد سمعت به بعد، فهو أسلوب تطوير جديد تُكتب فيه الشيفرة وتُبنى التطبيقات باستخدام اللغة الطبيعية. وقد أظهر بالفعل نتائج قوية في عدة مجالات من تطوير البرمجيات. ويشمل تعلّم الآلة (ML) مجموعة واسعة من المهام، مثل:
- تصوير البيانات بصريًا،
- تدريب النماذج،
- تقييمها،
- نشرها.
من الواضح أن وكلاء البرمجة يستطيعون تسريع أعمال البرمجة الروتينية، لكن السؤال الأهم هو ما إذا كان بإمكانهم دعم سير عمل تعلّم الآلة الأساسي فعلًا.
في هذا المقال سأستخدم Cursor كمحرر شيفرة وكيلي (agentic). جرّبت أيضًا وكلاء البرمجة في VSCode، لكن من تجربتي يقدّم Cursor سير عمل أكثر سلاسة وكفاءة، خاصة في التطوير المرتبط بتعلّم الآلة.
مجموعات البيانات
لاختباراتي اخترت مجموعتي بيانات مختلفتين جدًا: مجموعة بيانات أمراض النباتات من DiaMOS ومجموعة بيانات Unemployment Duration. تختلف بنيتاهما وتعقيدهما اختلافًا كبيرًا، مما أتاح لي التحقق من مدى تعامل وكلاء البرمجة مع مسائل تعلّم الآلة البسيطة والأكثر تطلبًا على حد سواء.
تطرح مجموعة بيانات أمراض النباتات مهمة تعلّم خاضع للإشراف بسيطة نسبيًا: مسألة تصنيف إلى 4 فئات. تُظهر كل صورة نوعًا من أوراق النباتات وتحمل واحدة من أربع تسميات للأمراض. وهذا يجعلها مناسبة لاختبار مسارات التدريب الأساسية ومعالجة الصور المسبقة وتقنيات قابلية التفسير مثل Grad-CAM أو خرائط البروز (saliency maps). الفئات غير متوازنة بدرجة معتدلة، لكن مجموعة البيانات نظيفة ومتسقة بصريًا في مجملها، مما يتيح النمذجة الأولية السريعة وتكرار تحسين النماذج.
أما مجموعة بيانات Unemployment Duration فهي تحدٍّ أصعب بكثير. إنها مسألة تحليل بقاء (survival analysis): الهدف ليس تسمية ثابتة بل مدة البطالة، مصحوبة بمؤشرات الحجب (censoring) التي تبيّن هل وقع الحدث (الحصول على وظيفة) أم لا. تحتوي مجموعة البيانات على عدة متغيرات مرمّزة بأسلوب one-hot، وميزات رقمية (مثل العمر والأجر)، ومكونات زمنية. تتطلب هذه البنية فهمًا أعمق لمعنى كل متغير – وقبل كل شيء منطق الحجب – كي لا تعطي عمليات التحليل والنمذجة نتائج مضللة.
تكمّل المجموعتان إحداهما الأخرى: الأولى تتعلق بتصنيف بيانات الصور بكفاءة، والثانية بدقائق التنبؤ بزمن وقوع الحدث مع الحجب. معًا توفران أساسًا متينًا لتقييم ما تستطيع سير عمل تعلّم الآلة الموجّهة بالوكلاء فعله وما لا تستطيع.
تحليل البيانات الاستكشافي
كان الطلب (prompt) الخاص بتحليل البيانات الاستكشافي (EDA) بسيطًا جدًا:
أنشئ EDA لمجموعة بيانات plant-disease من الصفر على شكل دفتر jupyter.
ولكي تُكتب المخرجات مباشرة في دفتر ملاحظات (notebook)، احتجت إلى استخدام نموذج Sonnet-4.
كان الدفتر الناتج مثيرًا للإعجاب. فباستثناء بعض المشكلات الصغيرة في محاذاة الرسوم البيانية، قدّم مجموعة مفيدة من مخرجات EDA الأساسية: تصورات لكل فئة، وإحصاءات توزيع الفئات، إضافة إلى نسب أحجام الصور وتوزيعاتها التكرارية. وأوضح التحليل فورًا أن مجموعة البيانات غير متوازنة.
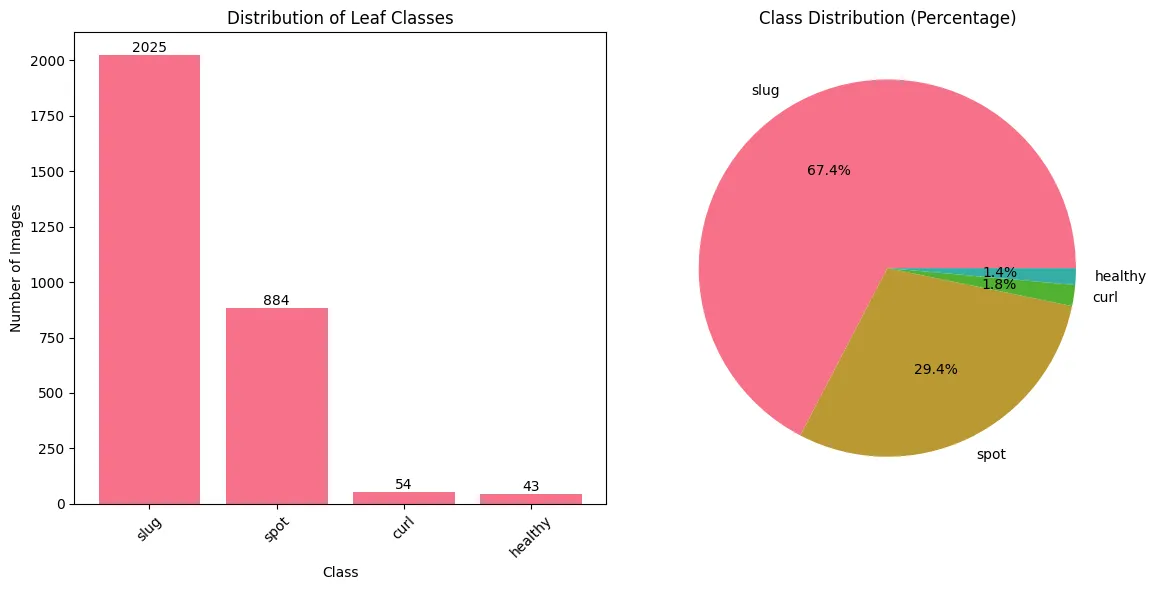
كما قدّم النموذج اقتراحات عملية مستمدة مما وجده، تهدف إلى رفع أداء النموذج بمعالجة المشكلات المحتملة في مجموعة البيانات.
يسرّع هذا النهج مرحلة EDA المبكرة بشكل كبير، لأن الشيفرة والنتائج المصممة خصيصًا لمجموعة البيانات تُولَّد تلقائيًا. ومع ذلك، لا يزال على ممارسي تعلّم الآلة التحقق من المخرجات. فمجموعات بيانات الصور مناسبة جدًا لهذا النوع من التحليل الآلي، لكن بنى البيانات الأكثر تعقيدًا قد تؤدي إلى استنتاجات خاطئة أو تصورات معيبة.
المشكلات المحتملة:
- اكتُشف عدم توازن في الفئات. واقترح النموذج معالجته بتعزيز البيانات (data augmentation) أو بدالة خسارة موزونة.
- كانت أحجام الصور متقاربة إلى حد كبير، مما يجعل المعالجة المسبقة أبسط.
التوصيات:
- استخدام تعزيز البيانات لتوسيع مجموعة البيانات وتحسين التعميم.
- تقسيم بيانات التدريب/التحقق بطريقة طبقية للحفاظ على توزيع الفئات.
- تغيير حجم كل الصور إلى الأبعاد نفسها (مثل 224×224) لتوحيد المدخلات.
- تطبيع الصور بإحصاءات ImageNet، خاصة عند استخدام التعلّم بالنقل.
مشكلات محتملة
تقدّم مجموعة بيانات البطالة مثالًا جيدًا على نتيجة EDA غير صحيحة تمامًا. فيما يلي ملخص لما أنتجه النموذج في تكرارين على مجموعة البيانات نفسها.
مخرجات Cursor
التكرار الأول:
🔍 أهم النتائج:
- المستفيدون من UI: متوسط 8.0 أسابيع
- غير المستفيدين من UI: متوسط 4.1 أسابيع
- الفرق: 3.9 أسابيع (أطول للمستفيدين من UI)
التكرار الثاني:
⏱️ رؤى حول المدة:
- متوسط المدة: 6.2 أسبوع
- وسيط المدة: 5.0 أسابيع
- تباين المدة: 5.6 أسبوع (انحراف معياري)
- المدى: 1–28 أسبوعًا
- التوزيع: ملتوٍ نحو اليمين (skewness = 1.52)
🔍 أهم النتائج:
- أثر UI: +3.9 أسابيع (أطول للمستفيدين من UI)
- ارتباط العمر: 0.153 (علاقة موجبة)
- ارتباط الأجر: 0.040 (أجور أعلى = بحث أطول)
- ارتباط معدل الاستبدال: -0.030
من الواضح أن النتائج تختلف من تشغيل إلى آخر، رغم أن مجموعة البيانات لم تتغير وأن النتائج تأتي من شيفرة ولّدها النموذج نفسه. والأسوأ أن أيًّا من المخرجين غير صحيح.
يكمن أصل المشكلة في بنية مجموعة البيانات، التي تحتوي على أربعة متغيرات حجب مرمّزة بأسلوب one-hot تصف كيف انتهت فترة البطالة.
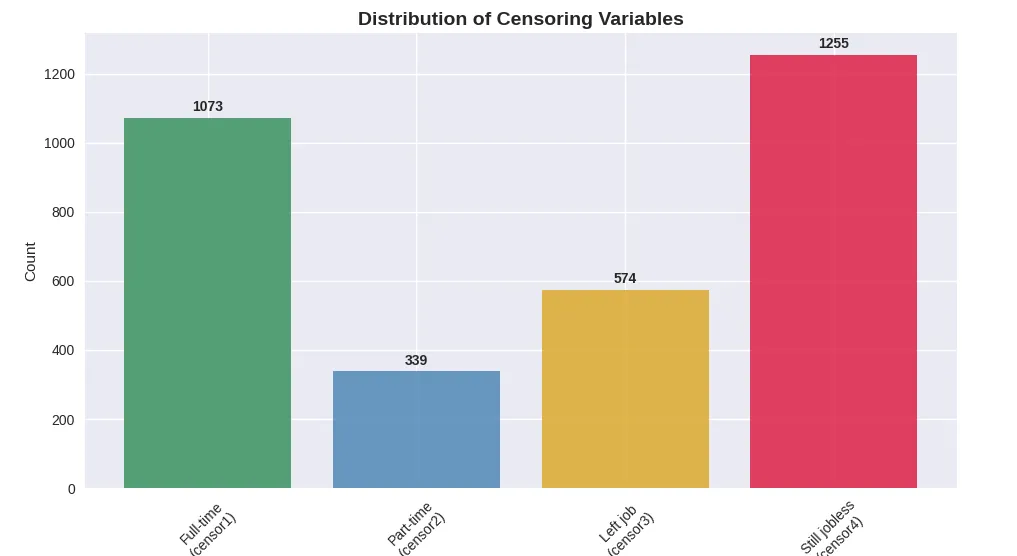
تخبرنا هذه المتغيرات أي نوع من الأحداث أنهى (أو لم ينهِ) فترة البطالة. وللأسف، يعاملها النموذج كميزات إدخال مستقلة بدلًا من مؤشرات متعلقة بالنتيجة، رغم أن الوثائق المرافقة توضح غرضها بجلاء.
فمثلًا، عندما تكون المدة المسجلة 14 أسبوعًا وتساوي censor4 القيمة 1، فهذا يعني أن الشخص كان لا يزال عاطلًا عن العمل عند إغلاق نافذة المراقبة، وأن الحدث (الحصول على وظيفة) لم يقع قط. وتكون المدة الحقيقية حينئذ محجوبة من اليمين (right-censored) – أي أن فترة البطالة أطول من الأسابيع الـ 14 المسجلة في مجموعة البيانات.
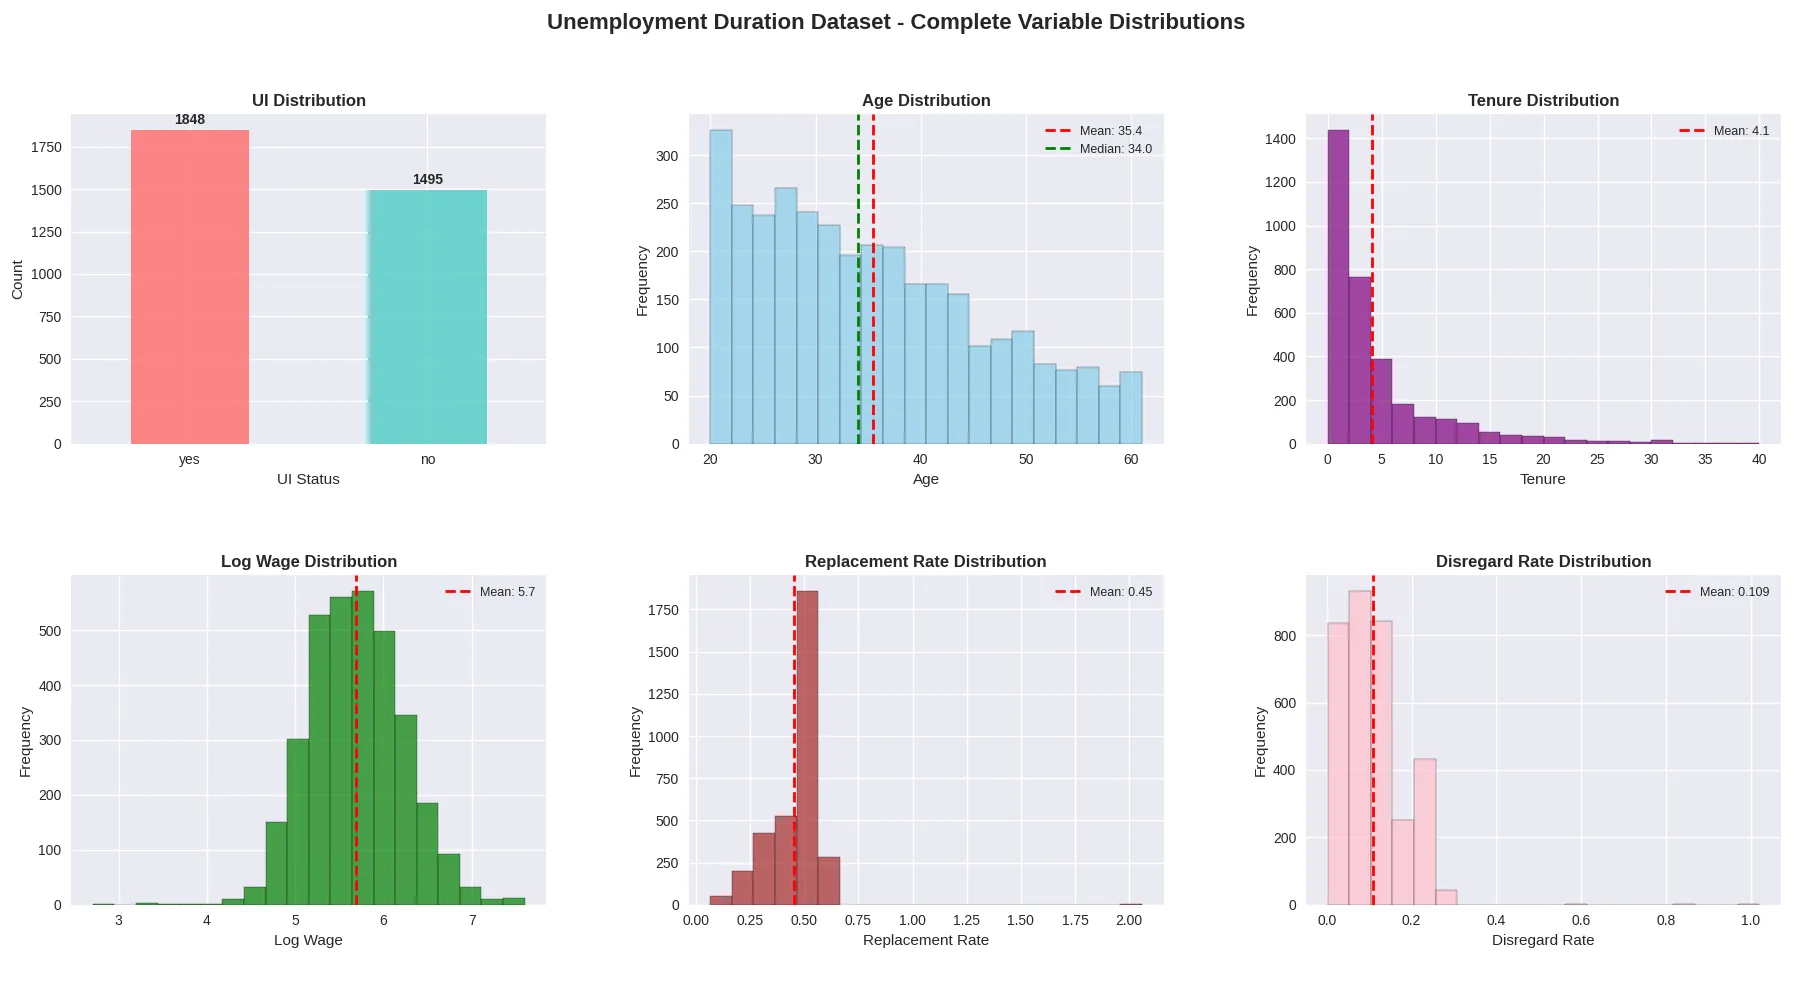
المتغيرات التوضيحية لمجموعة البيانات مدرجة أدناه:
AutoML مقابل Vibe Coding
تتيح لك كثير من أطر عمل AutoML اليوم بناء مسارات تعلّم آلة كاملة بجهد يدوي قليل ومعرفة متواضعة بتعلّم الآلة. وهذا يخفض حاجز الدخول بشكل كبير، لكنه كثيرًا ما ينتج نماذج صندوق أسود قليلة المرونة، مما يجعل تصحيح الأخطاء أو توسيع النتائج أو تفسيرها أصعب – خاصة في البيئات المعقدة أو الخاضعة للتنظيم.
أما Vibe coding، فعلى العكس، يستخدم طلبات باللغة الطبيعية ونماذج لغوية كبيرة لدعم المطوّرين الذين يملكون بالفعل خبرة في تعلّم الآلة، أو الذين يستطيعون على الأقل فحص النتائج والتحقق منها. ويمكنه تسريع بناء مسارات تعلّم الآلة مع الاحتفاظ بالتحكم الكامل في الشيفرة والمعمارية وقابلية التفسير. والمطوّرون أحرار في توسيع المسار أو تعديله حسب الحاجة، مع إيجاد توازن بين الأتمتة والشفافية. ويقدّم الجدول أدناه مقارنة عالية المستوى بين النهجين:
| الجانب | AutoML | Vibe Coding |
|---|---|---|
| الهدف | أتمتة مسار تعلّم الآلة بأكمله من البداية إلى النهاية | إنتاج شيفرة تعلّم آلة من طلبات باللغة الطبيعية |
| المرونة | منخفضة–متوسطة؛ سير عمل ثابتة ومحددة مسبقًا | عالية؛ تناسب أي سيناريو برمجي |
| سهولة الاستخدام | سهل جدًا؛ بالكاد يحتاج إلى برمجة | يحتاج إلى مهارات برمجة وفهم لتعلّم الآلة |
| الأنسب لـ | النمذجة الأولية السريعة والبيانات المنظمة وتطبيقات الأعمال | سير عمل تعلّم آلة مخصصة والتجارب وإثباتات المفهوم |
| القيمة التعليمية | منخفضة؛ يخفي معظم التعقيد | عالية؛ يعزز التعلّم العملي لتعلّم الآلة والتكرار |
إثبات مفهوم لمصنِّف صور بـ Vibe coding
في اختباراتي اعتمدت على الاختيار التلقائي للنموذج وبدأت بهذا الطلب:
ابنِ نموذجًا خفيفًا لتصنيف الصور في PyTorch لتصنيف صور الأوراق إلى 4 فئات. استخدم أحد نماذج تصنيف الصور الصغيرة. حمّل الصور من مجلد، وأدرج خطوات المعالجة المسبقة والتدريب والتقييم. اجعل الشيفرة وحدوية وفعّالة وموثّقة بالتعليقات جيدًا.
على مجموعة بيانات أمراض النباتات، أنتج Cursor شيفرة تغطي تحميل البيانات والمعالجة المسبقة الأساسية وتقسيم التدريب والتحقق (وإن كان دون بذرة عشوائية ثابتة) وتدريب النموذج وتقييمه. وبلغت دقة التدريب المُبلَّغ عنها 87% – وهو ما يبدو مثيرًا للإعجاب في البداية، أليس كذلك؟
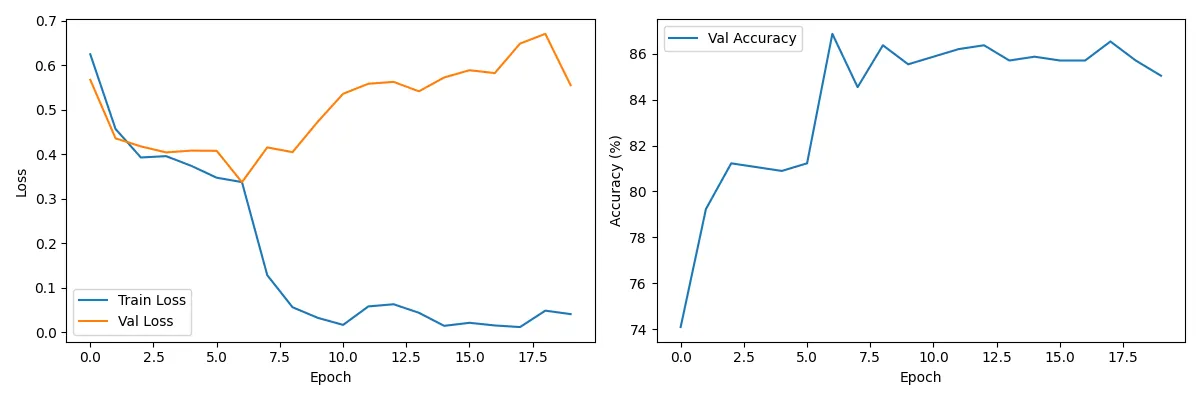
تعرض الرسوم مقاييس الخسارة على مجموعة البيانات المحوَّلة
ومع ذلك، هناك عدة مشكلات تستحق الإشارة إليها:
- خطر فرط التخصيص (overfitting): تُظهر رسوم الخسارة أن خسارتي التدريب والتحقق تتباعدان من نقطة معينة، وهي علامة على أن النموذج بدأ يفرط في التخصيص. كان ينبغي على الأرجح إنهاء التدريب أبكر.
- هدر الحوسبة: على الأرجح لم تضف كثير من حقب التدريب (epochs) أي أداء إضافي وكان يمكن تخطيها لتوفير الوقت والموارد.
- تقسيم بلا بذرة: لأن تقسيم مجموعة البيانات لم تكن له بذرة، لا يمكن إعادة إنتاج النتائج بشكل موثوق ولا اختبار النموذج المدرَّب اختبارًا سليمًا، إذ لا نعرف أي بيانات انتهت في أي مجموعة.
- حدود المقاييس: قد تبدو دقة 87% مثيرة للإعجاب، لكنها في مسألة تصنيف إلى 4 فئات قد تكون مضللة، خاصة مع توزيع فئات غير متوازن. فبدون معرفة نسب الفئات، قد يكون النموذج قد تعلّم ببساطة التنبؤ بالفئة المهيمنة، التي قد تشكل 87% من العينات. والدقة وحدها لا تكفي في هذه الحالة. ومن المقاييس الأكثر إفادة F1 score أو منحنيات ROC (لكل فئة)، أو تقرير تصنيف كامل يعطي الدقة (precision) والاستدعاء (recall) والدعم (support) لكل فئة.
بعد عدة تكرارات تمكنت من إضافة الإيقاف المبكر (early stopping) بصبر قدره 3 حقب وضبطت التدريب على حفظ النموذج الأفضل أداءً. لم يستطع الوكيل إجراء هذه التغييرات بنفسه واحتاج إلى توجيه يدوي لإتمامها بشكل صحيح.
وبفضل هذه التحسينات أبلى النموذج بلاءً حسنًا على مجموعة الاختبار، إذ بلغ دقة 0.867 وF1 score قدره 0.869.
وهذا هو تقرير التصنيف الكامل:
            precision    recall  f1-score   support

     healthy     0.7500    0.8571    0.8000         7
        spot     0.7634    0.8680    0.8124       197
        slug     0.9307    0.8660    0.8972       388
        curl     1.0000    0.9000    0.9474        10

    accuracy                         0.8671       602
   macro avg     0.8610    0.8728    0.8642       602
weighted avg     0.8750    0.8671    0.8691       602
وعلى الجانب الإيجابي، أبلى Cursor بلاءً رائعًا في بناء DataLoader، بما في ذلك التطبيع الصحيح بإحصاءات ImageNet الخاصة بـ MobileNet أثناء المعالجة المسبقة. وإجمالًا، أظهرت التجربة أن هذا النوع من التصنيف ممكن، وأن Cursor جمع بسرعة إثبات مفهوم يعمل إلى حد ما.
إثبات مفهوم بـ AutoML
تحققت أيضًا من مقارنة نتائج الحل المكتوب بـ vibe coding مع نهج AutoML. وللمقارنة استخدمت AutoKeras، الذي يبني نماذج تصنيف الصور تلقائيًا من مجموعة معماريات مدرَّبة مسبقًا مثل EfficientNet وResNet وXception وMobileNet.
ضبطت AutoKeras على تشغيل 5 محاولات، وبلغت دقة أفضل نموذج لديه 67%. لكن هذا الرقم مضلل. فقد بدت عملية AutoML مهووسة أكثر من اللازم بتقليل خسارة التحقق (validation loss)، فاستقرت على نموذج يتنبأ ببساطة بـ الفئة الأغلبية. والدقة هنا لا معنى لها تقريبًا، إذ تعلّم النموذج إسناد جميع العينات تقريبًا إلى فئة مهيمنة واحدة.
والمثير للفضول أن AutoKeras استنتج أن أيًّا من المعماريات المدرَّبة مسبقًا المتاحة لا يناسب المسألة، واختار بدلًا من ذلك تدريب CNN بسيطة من الصفر. ويلخص تقرير التصنيف أدناه أداء هذا النموذج:
             precision    recall  f1-score   support

           0       0.00      0.00      0.00         8
           1       0.00      0.00      0.00         7
           2       0.67      1.00      0.81       304
           3       0.00      0.00      0.00       132

    accuracy                           0.67       451
   macro avg       0.17      0.25      0.20       451
weighted avg       0.45      0.67      0.54       451
يوضح هذا الناتج بجلاء مشكلة عدم توازن الفئات وعجز النموذج عن التعميم عبر جميع الفئات. ورغم أن الدقة تبدو معقولة على السطح، فإن macro F1 score والمقاييس لكل فئة تكشف فجوات أداء كبيرة.
وبصرف النظر عن القيود والأخطاء التي واجهتها، لم تكن العملية بسيطة تمامًا أيضًا. فمجموعة البيانات كانت كبيرة بما يكفي لجعل أدوات AutoML السحابية غير عملية بسبب حدود الرفع والمعالجة. وعلاوة على ذلك، لا يتولى AutoKeras تحميل البيانات، فاضطررت إلى كتابة محمّل بيانات خاص بي، وتطبيق المعالجة المسبقة المطلوبة، وتقسيم مجموعة البيانات يدويًا إلى مجموعات تدريب وتحقق واختبار.
التجارب
بعد ذلك، عدت إلى مجموعة بيانات أمراض النباتات واستخدمت هذا الطلب:
أنشئ تجارب لنموذج الأوراق.
كانت الشيفرة التي اقترحها الوكيل كافية للتحقق الأساسي واحتوت على ثلاث مستويات من التجارب تهدف إلى اختبار إعدادات مختلفة لمسار التدريب. وكانت منظمة على النحو التالي:
- Simple Experiments اختبرت تركيبات من ثلاثة معدلات تعلّم وثلاثة أحجام دفعات وثلاثة محسّنات (optimizers).
- Quick Experiments ذهبت أبعد، فغطت نطاقًا أوسع من تركيبات المعاملات الفائقة وأضافت تقنيات تعزيز البيانات.
- Full Grid Search أجرت مسحًا شاملًا لكل تركيبة ممكنة من معدلات التعلّم وأحجام الدفعات والمحسّنات المعرَّفة.
هذه نقطة انطلاق جيدة للتجريب المبكر. تعمل كل أنواع التجارب لحقبة واحدة، والشيفرة تعمل بشكل سليم، وتبلغ عن مقاييس الدقة لمختلف إعدادات المعاملات. كما تسجّل تسجيلًا أساسيًا للمعاملات المستخدمة في كل اختبار.
وهذه نتائج التجارب البسيطة:
🎯 أفضل معدل تعلّم: 0.001 (81.73%)
📦 أفضل حجم دفعة: 32 (83.89%)
⚡ أفضل محسّن: SGD (84.72%)
لكن ما ينقصها هو تتبع إصدارات مجموعة البيانات، كما أنها تعتمد كليًا على البحث الشبكي (grid search). وحتى مع خيار تحديد عدد الاختبارات، يبقى ينقصها الكفاءة والمرونة.
يُعد البحث العشوائي أو أدوات أخذ العينات الحتمية مثل TPE بديلًا أكثر كفاءة من البحث الشبكي، إذ تحسّن النتائج دون تجربة كل تركيبة بشكل شامل. وتجعل أدوات مثل Hydra مع Optuna Sweeper إدارة التجارب أبسط، وتتيح ضبطًا متقدمًا ومتوازيًا للمعاملات الفائقة.
قابلية التفسير
جرّبت قابلية التفسير على نموذج تصنيف قائم على معالجة اللغات الطبيعية (NLP) بإضافة SHAP لفحص تأثير الميزات. لكن الوكيل لم يفهم المسار بالكامل. فقد استخدم مدخلات نصية نموذجية لا علاقة لها بمجموعة البيانات الحقيقية، بل أنتج أمثلة بلغة خاطئة. وبعد عدة محاولات، لم يستطع تقديم نتيجة ذات معنى. ربما كان من الممكن أن ينجح الأمر بطلب أدق وأكثر تفصيلًا، لكنني أعتقد أن كتابة طلب متخصص كهذا تستغرق وقتًا أطول من تنفيذ قابلية التفسير يدويًا.
وبالعودة إلى مجموعة بيانات أمراض النباتات، أردت تقييم قابلية تفسير نموذج تصنيف الصور المولَّد سابقًا. فطلبت من الوكيل خرائط تنشيط الميزات (Feature Activation Maps) وGrad-CAM وخرائط البروز (Saliency Maps).
نجحت النتائج، لكن الوصول إليها كان غير فعّال. فقد كتب الوكيل أكثر من 1,000 سطر من الشيفرة موزعة على عدة إصدارات من سكربتات شبه متطابقة (مثل grad_cam.py وsimple_grad_cam.py وworking_gradcam.py وغيرها)، واستغرق الأمر برمته نحو 30 دقيقة. وعمليًا، كان يمكن إنجاز هذه التصورات في أقل من 50 سطرًا من الشيفرة المركزة المقروءة. كان الناتج النهائي صحيحًا من الناحية التقنية، لكن العبء الإضافي الذي سببه الوكيل قلّل من فائدته العملية.
النشر
في اختبار آخر، طلبت من Cursor المساعدة في نشر مسار تعلّم آلة أكثر تعقيدًا.
تألف المسار قيد التقييم من عدة أجزاء. أولًا، مسح PaddleOCR الإيصالات وحوّلها إلى نص سطرًا بسطر. ثم جُزّئت أوصاف المنتجات إلى رموز (tokenization) بمحوّل الجمل all-MiniLM-L6-v2. وأخيرًا، دخلت المتجهات المضمَّنة (embeddings) إلى مصنِّف XGBoost الذي أسند واحدة من ست فئات منتجات محددة مسبقًا.
لم يستطع Cursor إنتاج حل يعمل بالكامل دون تدخل يدوي كبير. فقد اختار نماذج خاطئة (النسخة الأصلية بدلًا من نسخة مضبوطة محليًا)، واستخدم إعدادات OCR مختلفة، وعرض النتائج بشكل غير متسق من تكرار إلى آخر. واستلزم الوصول إلى تنفيذ يعمل حوارًا خطوة بخطوة مع طلبات منقّحة وإصلاحات يدوية لمكونات مختلفة.
وفي النهاية، وبعد عدة تكرارات، نُشر المسار بنجاح. فقد استخدم FastAPI لتقديم النموذج وGunicorn كخادم تطبيقات. وبنى Cursor أيضًا واجهة مستخدم بسيطة لرفع الصور وعرض الناتج. لم يكن الإعداد قريبًا من الجاهزية للإنتاج، لكنه شكّل إثبات مفهوم جيدًا وأظهر أن النهج قابل للتطبيق.
قد يجادل البعض في هذا، لكن Cursor بدا أنه يضيع طريقه عدة مرات أثناء تصحيح الأخطاء. وفي بعض المواقف، ربما كانت كتابة الشيفرة يدويًا – أو بالأحرى بمساعدة المحادثة – ستؤدي إلى حل يعمل أسرع، وذلك أساسًا لأن الحل قد يكون أقصر من طلب مفصّل. ولعل السياق الكبير وتعقيد المسار هما السبب. لكن الميزة الواضحة كانت العرض المرئي المولَّد للنتائج، الذي بدا نظيفًا وبديهيًا.
الخلاصات
لا شك أن وكلاء البرمجة جزء محوري من مستقبل البرمجة. لكن ممارسي تعلّم الآلة ذوي الخبرة لا يزالون لا غنى عنهم للإشراف على التطوير وتوجيهه. ففي يد من يملك خبرة في المجال، تحقق هذه الأدوات مكاسب إنتاجية واضحة. غير أنها قد تعطي بسهولة نتائج مضللة أو غير صحيحة عندما يستخدمها أشخاص لا يملكون فهمًا متينًا للأساليب الكامنة.
وعمليًا، يعمل وكلاء البرمجة أشبه بـ بيئات تطوير متكاملة من الجيل التالي – فهم يتألقون في الإكمال التلقائي للشيفرة الخاضعة للإشراف أو في إنتاج دوال محددة بوضوح من تعليمات دقيقة بمستوى الخبراء.
لا يستطيع وكلاء البرمجة بعد تقديم تطبيقات جاهزة تمامًا للإنتاج، لأسباب عدة. أحد القيود الرئيسية هو فهمهم غير المكتمل للسياق، الذي يظهر عادةً بطرق دقيقة لكنها جوهرية. فمثلًا، عندما أعطيت Cursor عدة مهام مترابطة، لم يعد استخدام الشيفرة التي ولّدها سابقًا – حتى مع توفير السياق ذي الصلة – وكتب شيفرة جديدة من الصفر في كل مرة. وهذا يثير مخاوف مشروعة بشأن قابلية صيانة الشيفرة واتساقها وكفاءة سير العمل عمومًا.
ومن تجربتي، واجه Cursor صعوبة في إدارة البيئات. فقد تجاهل كثيرًا البيئة الافتراضية الموجودة وحاول تثبيت الحزم على مستوى النظام. ونتيجة لذلك، أعاد تثبيت الاعتماديات دون داعٍ بدلًا من استخدام أدوات مثل uv أو التعامل مع البيئات الافتراضية بشكل صحيح، مما جعل التنفيذ أقل كفاءة.
وعلى الجانب الإيجابي، أبلى Cursor بلاءً حسنًا بوجه خاص في تحليل البيانات وتصويرها. فحتى حيث كانت هناك حاجة إلى شروح أكثر تفصيلًا، كانت التصورات دقيقة وواضحة ومعروضة بشكل جيد. وتشمل نقاط قوته الأخرى هيكلة المشاريع وتحميل البيانات وتوليد إثباتات المفهوم لمجموعات بيانات بسيطة نسبيًا. ويمكن للطلبات المفصلة خطوة بخطوة أن تدفع هذه القدرات إلى أبعد من ذلك.
وخلاصة القول، أنوي مواصلة استخدام وكلاء البرمجة في عملي اليومي، وأشجعك على أن ترى كيف يمكن أن تحسّن عملك أنت أيضًا.