Ֆունկցիոնալ ծրագրավորումը – ի՞նչ է դա
Ի՞նչ ենք իրականում հասկանում «ֆունկցիաներով ծրագրավորում» ասելով։ Փորձենք պատասխան գտնել։
«Ուղղափառ» սահմանման համաձայն՝ ֆունկցիոնալ ծրագրավորումը (FP) նշանակում է ծրագրավորում մաքուր / մաթեմատիկական / կողմնակի էֆեկտներից զերծ ֆունկցիաներով։ Սակայն դա ո՛չ գործնական է, ո՛չ էլ համընկնում է նրա հետ, թե մարդիկ ինչպես են իրականում օգտագործում այս տերմինը ամեն օր։
Այսպիսով, ի՞նչ է ֆունկցիոնալ ծրագրավորումը։ Եվ նույնիսկ եթե համաձայնենք այդ սահմանման հետ, ի՞նչ ենք իրականում հասկանում «ֆունկցիաներով ծրագրավորում» ասելով։ Փորձենք պատասխան գտնել։
«Տեսնելիս կճանաչես»
Մինչև ֆորմալ սահմանումներին անցնելը, դիտարկենք կոդի մի քանի օրինակ։ Ամեն անգամ մենք նույն ֆունկցիոնալությունը կիրականացնենք երկու տարբեր ոճով՝ «ֆունկցիոնալ» և ոչ ֆունկցիոնալ։ Դրանցից կփորձենք ձևակերպել ֆունկցիոնալ ծրագրավորման լեզվի և ոճի բնութագրիչները։
Բոնուս. կարո՞ղ եք անվանել այստեղ օգտագործված բոլոր լեզուները։
Կոլեկցիաներ
Սկսենք ֆունկցիոնալ ծրագրավորման ամենատարածված կիրառություններից մեկով՝ կոլեկցիաների վերափոխմամբ։
const numbers = [1, 2, 3, 4, 5, 6];

const result = numbers
  .map((num) => num * 2)
  .filter((num) => num % 3 === 0)
  .reduce((acc, num) => acc + num, 0);
const numbers = [1, 2, 3, 4, 5, 6];
let result = 0;
for (let i = 0; i < numbers.length; i++) {
const doubled = numbers[i] * 2;
if (doubled % 3 === 0) {
result += doubled;
}
}Ֆունկցիոնալությունը նույնն է, բայց կոդը լրիվ տարբեր տեսք ունի։ Արդեն առաջին օրինակը ցույց է տալիս, որ FP-ն իսկապես ինքնուրույն ծրագրավորման ոճ է՝ հիմնովին տարբերվող իմպերատիվ կամ պրոցեդուրային մոտեցումից։
Ինչպես հավանաբար գուշակեցիք, ֆունկցիոնալ ծրագրավորումը ներկայացված է առաջին հատվածով։ Ո՞ր հատկություններն են այս կոդը դարձնում «ֆունկցիոնալ»։
Նախ՝ կոլեկցիան վերափոխվում է դեկլարատիվ եղանակով. մենք նշում ենք, թե որ գործողությունները պետք է կիրառվեն (map, filter, reduce), այլ ոչ թե թե ինչպես դրանք իրականացնել։
Հետո՝ առաջին հատվածը մեծապես հենվում է ֆունկցիայի կիրառման վրա. map, filter և reduce ֆունկցիաները կիրառվում են որոշակի արգումենտների նկատմամբ։ Այդ արգումենտները իրենք էլ ֆունկցիաներ են։ Սա նշանակում է, որ մենք օգտագործում ենք բարձր կարգի ֆունկցիաներ՝ այլ ֆունկցիաներով պարամետրիզացված ֆունկցիաներ։
Վերջապես՝ աշխատում է ֆունկցիաների կոմպոզիցիան։ map-ի արդյունքը ծառայում է որպես filter-ի մուտք, իսկ filter-ի արդյունքը՝ reduce-ի մուտք։
Իմպերատիվ հատվածը, ընդհակառակը, հենվում է բացահայտ կառավարման հոսքի (for ցիկլեր, if պայմաններ) և փոփոխվող տվյալների (result) վրա։ Թերևս ավելի էականն այն է (թեև դա կարող է ճաշակի հարց լինել), որ նրա պրոցեդուրային, այլ ոչ թե դեկլարատիվ բնույթը նշանակում է, որ միանգամից պարզ չէ, թե մուտքային զանգվածի նկատմամբ ինչ վերափոխում է կիրառվում։
Կոլեկցիաներ, շարունակություն
Երկրորդ օրինակը նույնպես վերաբերում է կոլեկցիաների վերափոխմանը։ Ահա հատվածները.
val menu: List<Meal> = if (vegetarian) {
  entireMenu.filter { meal -> meal.ingredients.all { it.plant } }
} else {
  entireMenu.filter { meal -> meal.ingredients.any { it.meat } }
}
val dietaryRestriction: (Meal) -> Boolean = if (vegetarian) {
{ m -> m.ingredients.all { it.plant } }
} else {
{ m -> m.ingredients.any { it.meat } }
}
val menu = entireMenu.filter(dietaryRestriction)Երկու հատվածներն էլ օգտագործում են ֆունկցիոնալ ծրագրավորման գործիքակազմի գործիքներ (նկարագրված վերևում)։ Սակայն երկրորդը նաև սահմանում է dietaryRestriction-ը որպես արժեք, որը պատահաբար ֆունկցիա է։
Այլ խոսքով՝ ֆունկցիոնալ լեզուները ֆունկցիաները դիտարկում են որպես առաջին կարգի արժեքներ։ Դրանք կարելի է օգտագործել ինչպես ցանկացած այլ արժեք. վերագրել փոփոխականներին, փոխանցել որպես արգումենտներ կամ վերադարձնել ֆունկցիաներից։
Առաջին հատվածը մեզ ստիպում է filter-ի կանչը (որքան էլ պարզ լինի) գրել երկու անգամ։ Երկրորդ հատվածը խուսափում է այս կոդի կրկնությունից, որովհետև ֆունկցիաները կարելի է վերաբերվել որպես արժեքների։
Տվյալների սահմանում
Կոլեկցիաների վերափոխումն իհարկե կարևոր է, բայց նախ մեզ պետք է որևէ միջոց՝ սահմանելու այն տվյալների կառուցվածքները, որոնք կվերափոխենք։ Դիտարկենք երրորդ օրինակը, որտեղ կառուցում ենք որոշ տվյալներ՝ մարդկանց և հասցեների համապատասխանությունը։ Ծննդյան օրը մարդկանցից մեկը տեղափոխվում է, և համապատասխանությունը թարմացվում է.
case class Person(name: String, age: Int)
case class Address(where: String, permanent: Boolean)

val chris = Person("Chris", 29)
val friends = Map(
  chris -> Address("Berlin", permanent = true),
  Person("Nicole", 36) -> Address("Paris", permanent = false)
)

val updatedFriends = friends
  .removed(chris)
  .updated(chris.copy(age = 30),
    Address("Munich", permanent = true))
class Person { String name; int age; }
class Address { String where; boolean permanent; }
Person chris = new Person("Chris", 29);
Map<Person, Address> friends = new HashMap<>();
friends.put(chris, new Address("Berlin", true));
friends.put(new Person("Nicole", 36),
new Address("Paris", false));
chris.setAge(30);
friends.put(chris, new Address("Munich", true));Այստեղ ո՛չ բարձր կարգի ֆունկցիաներ կան, ո՛չ առաջին կարգի արժեքներ հանդիսացող ֆունկցիաներ։ Այդուհանդերձ, առաջին հատվածը կանվանենք «ֆունկցիոնալ», իսկ երկրորդը՝ «իմպերատիվ»։ Ի՞նչն է տարբերությունը։
Կարևորն այն է, որ 1-ին ցուցակը օգտագործում է անփոփոխ (immutable) տվյալների կառուցվածքներ, իսկ 2-րդը հենվում է փոփոխվողների վրա։ Առաջին հատվածում Map-ը, Address-ը և Person դասերը բոլորն էլ անփոփոխ են։ Երբ դրանց օրինակները ստեղծվել են, դրանք չի կարելի փոփոխել։ Մենք կարող ենք միայն ստանալ այդ տվյալների կառուցվածքների թարմացված պատճենները removed, updated և copy ֆունկցիաներով։
Անփոփոխ տվյալները շատ առավելություններ են տալիս, հատկապես երբ տվյալները կիսվում են միաժամանակ աշխատող ֆունկցիաների և պրոցեսների միջև։ Երբ գիտեք, որ ֆունկցիան պարզապես չի կարող փոփոխել իր ստացած արգումենտները, կամ որ որոշ տվյալներ կարելի է անվտանգ կարդալ առանց սինխրոնիզացիայի, կոդի մասին դատելը դառնում է ավելի հեշտ։
Իմպերատիվ տարբերակը (երկրորդ հատվածը) հենվում է փոփոխվող տվյալների կառուցվածքների վրա (HashMap, դասեր, որոնց դաշտերը կարող են փոխվել)։ Մենք դեռ կանչում ենք ֆունկցիաներ՝ տվյալները փոփոխելու համար (put, setAge), բայց դրանք սովորաբար ոչ մի իմաստալից բան չեն վերադարձնում (դրանք void են կամ վերադարձնում են () / Unit արժեքներ)։ Այլ խոսքով՝ մենք դրանք կանչում ենք բացառապես դրանց կողմնակի էֆեկտների համար։
Ինչ վերաբերում է ծրագրավորման ոճին, անփոփոխ տվյալների կառուցվածքներն ունեն հետագա հետևանքներ։ Քանի որ copy, removed և updated ֆունկցիաները վերադարձնում են թարմացված արժեքներ, մենք կարող ենք (և պետք է) հենվել ֆունկցիաների կոմպոզիցիայի վրա՝ friends համապատասխանության հաջորդական վերափոխումներն արտահայտելու համար. օրինակ՝ removed-ի վերադարձրածը փոխանցվում է updated-ին։
Ընդհակառակը, կողմնակի էֆեկտներ ունեցող ֆունկցիաները, որոնք ոչ մի իմաստալից բան չեն վերադարձնում, խանգարում են ֆունկցիաների կոմպոզիցիային և ֆունկցիոնալ ծրագրավորմանը, որոնք դառնում են շատ ավելի դժվար, եթե ընդհանրապես հնարավոր են։ Փոխարենը մենք ստիպված ենք գրել էֆեկտներ ունեցող հրամանների հաջորդականություն։
Սա մեզ բերում է ֆունկցիոնալ ոճի մեկ այլ բնութագրիչի՝ ֆունկցիաների էֆեկտների սահմանափակմանը։ Ինչպես վերևում ցույց տրվեց, մենք հակադրում ենք անփոփոխ կոլեկցիաների վրա աշխատող էֆեկտներից զերծ ֆունկցիաները (որոնք կանչում ենք բացառապես վերադարձվող արժեքի համար) փոփոխվող կոլեկցիաների վրա աշխատող կողմնակի էֆեկտներ ունեցող ֆունկցիաների հետ։ Էֆեկտների կրճատումը ավտոմատ կերպով թույլ է տալիս ծրագրավորել ավելի ֆունկցիոնալ ոճով։ Որքանո՞վ պետք է առաջ տանել այս գաղափարը։
Էֆեկտներ
Էֆեկտների մասին խոսելով՝ դրանք ամենուր են։ Տվյալների բազաների հետ աշխատանքը, HTTP հարցումներ ուղարկելը և հրթիռներ արձակելը ծրագրավորողի առօրյա խնդիրներն են։ Դիտարկենք կոդի մի քանի օրինակ այս ոլորտից.
public class RocketLauncher {
  public void launch() {
    checkFuelLevel();
    initializeNavigation();
    performSystemCheck();
    igniteEngine();
    System.out.println("Success!");
  }
}
launchRocket :: IO ()
launchRocket = do
checkFuelLevel
initializeNavigation
performSystemCheck
igniteEngine
putStrLn "Success!"launchRocket : '{IO}
launchRocket _ =
checkFuelLevel
initializeNavigation
performSystemCheck
igniteEngine
printLine "Success!"Կրկին երեքն էլ նույն բանն են անում։ Դրանք կարդալիս մենք կոդի մասին մտածում ենք նման, իմպերատիվ ձևով. «Հրթիռ արձակելը նշանակում է նախ ստուգել վառելիքի մակարդակը, հետո ինիցիալիզացնել նավիգացիան, անցկացնել համակարգի ստուգումները և վերջում միացնել շարժիչը։ Դրանից հետո կարող եմ աշխարհին պատմել ևս մեկ հաջող արձակման մասին»։ Այսպիսով, մետա-մակարդակում բոլորն էլ արտահայտում են նույն դատողությունը։ Բայց ծրագրավորման մակարդակում դրանք չէին կարող ավելի տարբեր լինել։
Առաջին հատվածը այն է, ինչ կարող ենք անվանել «սովորական հին իմպերատիվ ծրագրավորում»։ Ֆունկցիայի կանչը անմիջապես առաջացնում է (կողմնակի) էֆեկտների հաջորդականություն, և մենք անցնում ենք առաջ։
Երկրորդ հատվածը, ընդհակառակը, մոդելավորում է էֆեկտները որպես արժեքներ։ checkFuelLevel, initializeNavigation և այլ ֆունկցիաները պարզապես կառուցում և վերադարձնում են արժեքներ, որոնք հաշվարկների նկարագրություններ են։ Էֆեկտների մոդելավորումը որպես արժեքներ էֆեկտներից զերծ ֆունկցիաներ գրելու տեխնիկա է։
Այս արժեքներն ապա համակցվում են մեկ ավելի մեծ նկարագրության մեջ, որը ներքին նկարագրությունները հաջորդաբար դասավորում է do-նոտացիայի միջոցով (սինտակտիկ շաքար IO.flatMap բարձր կարգի ֆունկցիաների շղթայի կանչի համար)։ Էֆեկտները տեղի են ունենում միայն այն ժամանակ, երբ վերին մակարդակի ինտերպրետատորը հաշվարկում է այս նկարագրությունը (ինչը կարող է կատարվել մեկ անգամ, բազմաթիվ անգամ կամ ընդհանրապես չկատարվել)։ Արդյունքում էֆեկտ ունեցող հաշվարկների սահմանումը անջատվում է դրանց կատարումից։
Մենք չենք խորանա էֆեկտները այսպես սահմանափակելու առավելությունների և թերությունների մանրակրկիտ վերլուծության մեջ, քանի որ դա կպահանջեր անդրադառնալ control monad-ներին, laziness-ին և այլն. համացանցը դա արդեն լայնորեն ընդգրկում է։ Բավական է ասել, որ (գոնե որոշ) ֆունկցիոնալ լեզուներ տրամադրում են էֆեկտները որպես արժեքներ մոդելավորելու և դրանք ծուլորեն հաշվարկելու միջոց։
Ավելի վաղ ասացինք, որ ֆունկցիոնալ ոճը շահում է ֆունկցիայի հնարավոր էֆեկտները հնարավորինս կրճատելուց, և այստեղ մենք դա հասցնում ենք ծայրահեղության։ Էֆեկտներն ընդհանրապես չեն թույլատրվում։ Այս արմատական մոտեցումը արդյունք է տալիս. մենք կարող ենք լինել 100% ֆունկցիոնալ։ Բայց դա նաև զգալի գին ունի՝ runtime-ի, ճանաչողական և սինտակտիկ լրացուցիչ ծանրաբեռնվածություն՝ հաշվի առնելով, թե որքան տարածված են կողմնակի էֆեկտները իրական կոդային բազաներում։
Երրորդ հատվածը ցույց է տալիս մի տեսակ փոխզիջում. էֆեկտներ ունեցող հաշվարկների կատարումը պահանջում է ability (կարողություն), որը ներառված է ֆունկցիայի տիպում։ Այդպիսի կոդը կարելի է դիտարկել իմպերատիվ կերպով՝ էֆեկտները անմիջապես հաշվարկվում են, երբ ability-ն հասանելի է տիրույթում։ Կամ կարելի է յուրաքանչյուր ֆունկցիա, որը պահանջում է ability-ներ, դիտարկել որպես ծույլ և հետևաբար էֆեկտներից զերծ, քանի որ էֆեկտները կարող են տեղի ունենալ միայն ability-ն տրամադրելուց հետո։
Ծրագրերի կոմպոզիցիա
Տեսնենք, թե ինչպես կարելի է մեծ ծրագրեր կառուցել փոքր մասերից.
var order = Order.Parse(request); // might throw
order.Validate(); // might throw
order.CalculateTotal();

if (request.LoyalCustomer)
{
  order.SetLoyal(true);
  order.ApplyDiscount();
}

order.CalculateTax();

var invoice = new Invoice(order.Total, order.Tax);
parse_order request (* returns a Result *)
|> Result.bind validate_order
|> Result.map (fun order ->
create_invoice
(apply_discount (calculate_total order) request)
(calculate_tax order))Այստեղ գործում են կոմպոզիցիայի երկու տեսակ։ Առաջինը պատվերի վերլուծության և վալիդացիայի համադրումն է, որոնցից ցանկացածը կարող է ձախողվել։ Առաջին օրինակը դա լուծում է էֆեկտներով՝ բացառություններ նետելով։ Երկրորդը՝ առանց էֆեկտների. սխալները ներկայացվում են որպես արժեքներ Result տվյալների տիպի միջոցով (որոշ լեզուներ նույն նպատակով օգտագործում են Either)։ Ընդհանրապես, հասկացությունների մոդելավորումը որպես արժեքներ այն է, ինչ հաճախ կտեսնեք ֆունկցիոնալ լեզուներում։
Երկրորդը մի քանի ֆունկցիաների համադրումն է՝ ինվոյսի հաշվարկի տրամաբանությունն արտահայտելու համար։ Առաջին հատվածը դա անում է իմպերատիվ քայլերով (հրամանների շարք), փոփոխվող տվյալներով և կողմնակի էֆեկտներ ունեցող ֆունկցիաներով։
Երկրորդ հատվածում apply_discount, calculate_total և այլ ֆունկցիաները ո՛չ տվյալներ են փոփոխում, ո՛չ այլ էֆեկտներ են առաջացնում. դրանք պարզապես հաշվարկում են ինչ-որ բան իրենց մուտքերից և վերադարձնում արժեքներ։ Մենք հենվում ենք էֆեկտներից զերծ ֆունկցիաների կոմպոզիցիայի վրա՝ արտահայտությունների միջոցով, որոնք արտադրում են անփոփոխ տվյալներ։ Սրանք հենց այն բնութագրիչներն են, որոնք նկատեցինք տվյալների սահմանումը քննարկելիս։ Ակնհայտորեն, սա FP է։
Տվյալներ և վարք
Վերջապես (համառոտ) դիտարկենք, թե ինչպես են օբյեկտ-կողմնորոշված և ֆունկցիոնալ ծրագրավորումը կապված միմյանց հետ։ Դրանք կարող են գոյակցել (ինչպես ցույց են տալիս F#-ը և Scala-ն), բայց երբեմն նույն հարցին պատասխանում են տարբեր կերպ։
interface Shape { double area(); }

class Square implements Shape {
  private double side;
  Square(double side) { this.side = side; }

  double area() { return side * side; }
}

class Circle implements Shape {
  private double radius;
  Circle(double radius) { this.radius = radius; }

  double area() { return Math.PI * radius * radius; }
}
enum Shape {
Square { side: f64 },
Circle { radius: f64 },
}
fn area(shape: &Shape) -> f64 {
match shape {
Shape::Square { side } => side * side,
Shape::Circle { radius } => std::f64::consts::PI * radius * radius,
}
}Օբյեկտ-կողմնորոշված ծրագրավորումը «ինչպե՞ս վարվել կոդի և տվյալների հետ» հարցին պատասխանում է երկուսին համադրելով. սա ինկապսուլյացիայի էությունն է։ Տվյալները թաքցվում են աբստրակցիան օգտագործողներից և կարող են փոփոխվել միայն օբյեկտի բացահայտած մեթոդներով։ Սա հաճախ ուղեկցվում է փոփոխելիությամբ։ Տվյալների ինկապսուլյացիան կարող է ճիշտ ընտրություն լինել, բայց միակը չէ։
FP-ի այլընտրանքային պատասխանը տվյալները և վարքը առանձնացնելն է։ Տվյալների կառուցվածքները սահմանվում են առանց կցված վարքի (վարքն արտահայտվում է ֆունկցիաներով)։ Տվյալները հակված են լինել անփոփոխ (ինչպես նշվեց վերևում), և FP լեզուների մեծ մասը, եթե ոչ բոլորը, ունեն հանրահաշվական տվյալների տիպերի (ADT) և pattern matching-ի ներկառուցված աջակցություն։ Վերևի երկրորդ հատվածում Shape-ը enum է՝ կոպրոդուկտ, երկու տարբերակով՝ Square և Circle, որոնցից յուրաքանչյուրը մեկ դաշտ պարունակող struct է (պրոդուկտ)։
ADT-ները գործնական, ճկուն և տիպային անվտանգությամբ միջոց են տալիս անփոփոխ տվյալների կառուցվածքներ սահմանելու համար։ Ֆունկցիաների հետ միասին դրանք կազմում են ֆունկցիոնալ ծրագրերի հիմնարար շինանյութը։
Ֆունկցիոնալ ծրագրավորման լեզուների հատկանիշներն ու ոչ-հատկանիշները
Այն, ինչ մինչ այժմ սովորեցինք, կարելի է ամփոփել որպես ծրագրավորման լեզվի հնարավոր հատկանիշների «ստուգացանկ»։ Դրանցից յուրաքանչյուրը մեծացնում է հավանականությունը, որ լեզուն կընկալվի որպես ֆունկցիոնալ, կամ գոնե հնարավոր է դարձնում ֆունկցիոնալ ոճով ծրագրավորել։ Դրան զուգահեռ կա ոչ-հատկանիշների ցուցակ, որը կարող է օգնել ճանաչել իմպերատիվ կամ պրոցեդուրային լեզուները.
| «Ֆունկցիոնալ» մոտեցման հատկանիշներ | «Ֆունկցիոնալ» ոճի ոչ-հատկանիշներ |
|---|---|
| Ֆունկցիաների կոմպոզիցիա | Իմպերատիվ քայլեր |
| Բարձր կարգի ֆունկցիաներ | Ցիկլեր, պայմաններ |
| Ֆունկցիաները որպես առաջին կարգի արժեքներ | Կրկնվող կոդ |
| Էֆեկտներից զերծ ֆունկցիաներ | Կողմնակի էֆեկտներ ունեցող ֆունկցիաներ |
| Էֆեկտները որպես արժեքներ | Անմիջապես կատարվող էֆեկտներ |
| Արտահայտություններ | Հրամաններ |
| Անփոփոխ տվյալներ | Փոփոխվող տվյալներ |
| ADT-ներ և pattern matching | Դասեր, ժառանգում |
| Տվյալներն ու վարքը առանձին | Տվյալներն ու վարքը միասին փաթեթավորված |
Ձեռք բերելով որոշակի ինտուիցիա և անդրադառնալով գործնական կողմերին՝ ծրագրավորման լեզուների որ հնարավորություններն են համարվում «ֆունկցիոնալ», անցնենք տեսությանը և ֆորմալ սահմանումներին։
FP-ի տեսական ընկալումը
Երբ փորձում ենք բացահայտել և հասկանալ, թե ինչ է ֆունկցիոնալ ծրագրավորումը, բնական առաջին քայլը Wikipedia-ում այն փնտրելն է։ Հոդվածը բավականին ընդարձակ է, բայց մենք կկենտրոնանանք նրա բացման պարբերության վրա, որը պարունակում է սահմանումը.
պարադիգմ, որում ծրագրերը կառուցվում են ֆունկցիաների կիրառմամբ և կոմպոզիցիայով
Այսքանն է, և դա համընկնում է մինչ այժմ գտածի հետ։ Եթե ֆունկցիաների կիրառումը և կոմպոզիցիան պետք է լինեն ծրագրեր կառուցելու հիմնական գործիքը, շուտով մեզ պետք կգան բարձր կարգի ֆունկցիաներ և ֆունկցիաները որպես առաջին կարգի արժեքներ։ Առանց դրանց մենք չէինք կարող արդյունավետ օգտագործել այս ծրագրավորման ոճը։
Հետևաբար, ֆունկցիոնալ ծրագիրը ֆունկցիաների կիրառումների ծառ է։ Մի կողմից, սա նրան դեկլարատիվ զգացողություն է տալիս, որտեղ մենք նկարագրում ենք «ինչը», այլ ոչ թե «ինչպես» (թեև նրանց միջև սահմանը հաճախ աղոտ է)։ Դեկլարատիվ լինելը նաև նշանակում է, որ ծրագրի վարքը սահմանվում է առանց կառավարման հոսքի բացահայտ կառուցվածքների, կամ գոնե դրանցից ավելի քիչով։ Մյուս կողմից, մենք գործ ունենք արտահայտությունների հետ՝ ֆունկցիոնալ ծրագրավորման ևս մեկ հատկանիշ, որ երևաց օրինակներում։
Հիշեք, որ երբ «ֆունկցիաները որպես առաջին կարգի արժեքներ» կամ «բարձր կարգի ֆունկցիաները» նշում ենք որպես լեզվի պարտադիր հնարավորություններ, նկատի ունենք, որ դրանք ունեն ողջամտորեն թեթև սինտակս և հարմար են օգտագործելու համար. զուտ սեմանտիկ հնարավորությունը՝ «ինչ-որ կերպ ճարել և սահմանել բարձր կարգի ֆունկցիա», բավարար չէ։
Իսկ ի՞նչ է ֆունկցիան
Վերևի սահմանումն ունի մեկ թույլ կողմ։ Ի՞նչ է ճիշտ ասած ֆունկցիան։ Այն դիտարկելու երկու եղանակ կա։ Մեկը Wikipedia-ում function հղումին հետևելն է, որն ասում է.
ֆունկցիան ծրագրային ապահովման միավոր է, որը կարելի է կանչել, ունի հստակ սահմանված վարք և կարող է կանչվել բազմիցս
Մյուսը նրանց համար է, ովքեր ավելի մաթեմատիկական հակում ունեն։ Մենք լավ գիտենք, որ f: D → C ֆունկցիան հարաբերություն է, որում յուրաքանչյուր x ∈ D-ին համապատասխանում է ճիշտ մեկ f(x) ∈ C։ Մաթեմատիկական ֆունկցիաները դետերմինիստական են և զերծ էֆեկտներից. դրանց արդյունքը որոշվում է բացառապես մուտքով։ Ո՛չ աշխարհի վիճակը, ո՛չ օրվա ժամը, ո՛չ եղանակը, ո՛չ էլ տվյալների բազայում պահվածը չեն ազդում ֆունկցիայի արդյունքի վրա։
Ֆունկցիայի որ սահմանումն ընդունենք, այն էլ կորոշի, թե FP-ի ինչ տարատեսակի կհանգենք։ Համակարգչային սահմանումը, որում ֆունկցիաները կարող են ունենալ (կողմնակի) էֆեկտներ, տալիս է այն, ինչ ես կանվանեմ պատահական ֆունկցիոնալ ծրագրավորում (casual functional programming) (տերմին, որ նոր եմ հորինել և որը ընդհանուր օգտագործման մեջ չէ՝ գոնե դեռևս)։
Մաթեմատիկական սահմանումը տալիս է մաքուր ֆունկցիոնալ ծրագրավորում՝ շատ ավելի տարածված տերմին, որում յուրաքանչյուր ֆունկցիա զերծ է էֆեկտներից։
Մաքրությունը գերազանց և արժանի նպատակ է։ Այդուհանդերձ, ոչ մի հանրաճանաչ լեզու թույլ չի տալիս ստուգել, որ ֆունկցիան մաքուր է։ Միշտ գոյություն ունի «փախուստի դուռ». Haskell-ում, ի վերջո, կա unsafePerformIO։ Սա չի դարձնում հասկացությունը անօգուտ, բայց կարող է հուշել, որ ամբողջ կոդային բազայում մաքրություն պահանջելը պարտադիր չէ, որ ցանկալի հատկություն լինի։
Մի՞թե casual FP-ն պարզապես մաքուր կոդ (clean code) չէ
Բայց, կարող եք առարկել, սահմանումը «casual FP»-ի ընդլայնելով՝ մենք ըստ էության ասում ենք, որ ուզում ենք ծրագրեր կառուցել՝ կիրառելով և համադրելով կանչվող ծրագրային միավորներ (որոնք կարող են ունենալ ցանկացած էֆեկտ)։ Մի՞թե սա պարզապես ծրագրավորում չէ փոքր ֆունկցիաներով։ Մի բան, որ վաղուց խրախուսվում է որպես clean code-ի մաս։
Այո՛. OO սպագետտի կոդը փոքր մեթոդների ռեֆակտորինգի ենթարկելը ձեզ մոտեցնում է FP-ին։ Clean code-ը կարող է լի լինել FP սկզբունքներով։
Եվ ոչ. միայն փոքր մեթոդները բավարար չեն, եթե ուզում ենք ֆունկցիաները ավելի հաճախ համադրել։ Դրանց ձևը նույնպես պետք է կտրուկ փոխվի. փոփոխելու և կողմնակի էֆեկտներ առաջացնելու փոխարեն դրանք պետք է վերադարձնեն իմաստալից արժեքներ, որոնք կարող են ծառայել որպես այլ ֆունկցիաների մուտք։
Միայն այն ժամանակ, երբ ավելացնում ենք բարձր կարգի ֆունկցիաներ, ֆունկցիաները որպես 1-ին կարգի արժեքներ, ADT-ներ, անփոփոխություն, արտահայտությունների վրա կողմնորոշված լեզու, էֆեկտների սահմանափակում (թեև ոչ պարտադիր վերացում) և այլն, հասնում ենք casual FP-ին։
Լեզուն որքանով ֆունկցիոնալ կարելի է համարել, կախված է նրանից, թե արդյոք այս FP հատկանիշներով ծրագրեր կառուցելը հարմար է և հիմնական մոտեցումն է (այլ ոչ թե երկրորդական կամ պարզապես հնարավոր)։
Որտեղ է FP-ի արժեքը
Իմ կարծիքով, ֆունկցիոնալ ծրագրավորման ոճի առաջարկածի մեծ մասը գալիս է իմպերատիվ/պրոցեդուրային ոճերի և casual FP-ի միջև բացը կամրջելուց։ Այլ խոսքով՝ մենք օգտագործում ենք վերևում սահմանված FP հատկանիշները (ֆունկցիաները որպես 1-ին կարգի արժեքներ, բարձր կարգի ֆունկցիաներ, անփոփոխ տվյալներ, էֆեկտների սահմանափակում)՝ առանց պարտադիր դրանց նկատմամբ շատ խիստ լինելու։
Հաջորդ քայլը՝ casual FP-ից մաքուր FP-ի անցումը (էֆեկտներից զերծ ֆունկցիաներ, այսինքն՝ յուրաքանչյուր էֆեկտ արժեք է), կարող է արժեքավոր լինել, բայց դրա օգուտը կարող է նաև նվազել։
Դիտարկենք այս երեք օրինակները.
var users = new ArrayList[User]()
for id <- peopleIds do
  users.add(fetchFromDb(id))

var likes = new ArrayList[Response]()
var dislikes = new ArrayList[Response]()
for user <- users do
  val response = sendRequest(user)
  if response.body.likedSciFiMovies.contains("Star Wars")
  then likes.add(response)
  else dislikes.add(response)
peopleIds
.map(fetchFromDb)
.map(sendRequest)
.map(_.body.likedSciFiMovies)
.partition(_.body
.likedSciFiMovies
.contains("Star Wars"))peopleIds
.traverse: id =>
fetchFromDb(id)
.flatMap(sendRequest)
.map(_.partition(_.body
.likedSciFiMovies
.contains("Star Wars")))Առաջինը հետևում է իմպերատիվ, փոփոխվող ոճի՝ լի կառավարման հոսքի կառուցվածքներով, ինչպիսիք են ցիկլերը։ Այն ունի կողմնակի էֆեկտներով fetchFromDb և sendRequest մեթոդները։ Կոդը «նորմալ է», բայց կարո՞ղ ենք բարելավել այն։
Երկրորդ հատվածը նույն բանն է անում՝ ռեֆակտորինգի ենթարկված casual FP-ի։ map և partition բարձր կարգի ֆունկցիաները արտահայտում են ցանկալի վերափոխումը, իսկ ֆունկցիաների կոմպոզիցիան շղթայակցում է քայլերը. fetchFromDb-ն և sendRequest-ը մնում են էֆեկտներով։ Դա սպասելի է, հաշվի առնելով դրանց անվանումները և այն ֆունկցիոնալությունը, որ կառուցում ենք։
Վերջապես, երրորդ հատվածը ռեֆակտորինգի է ենթարկվել մաքուր FP-ի, էֆեկտներով՝ որպես արժեքներ։ Արդյունքում դրանց համադրումն ու վերափոխումը պետք է կատարվի արժեքների մակարդակում՝ ավելացնելով լրացուցիչ շերտ, որն այստեղ երևում է traverse և map կանչերով։ Էֆեկտները վերահսկվում և հաշվարկվում են ծուլորեն. դրանց սահմանումները անջատված են հաշվարկից, բայց մեծ մասամբ մենք չենք օգտվում այս հնարավորություններից։
Նման տեսակետ կա Jane Street-ի հայտնի FP ելույթում. որքան գիտեմ, OCaml-ի ամենախոշոր կոմերցիոն օգտագործողը և FP համայնքի ակտիվ անդամը։ «Why FP doesn’t matter» ելույթը սկսվում է վերևում քննարկված որոշ գաղափարների ներկայացմամբ, ապա նկարագրում այն հնարավորությունները, որոնք FP-ն դարձնում են կարևոր Jane Street-ի համար.
- Ճշտություն. արտահայտիչ ստատիկ տիպերն ու ADT-ները թույլ են տալիս անթույլատրելի վիճակները դարձնել ներկայացման անհնար
- Ճարպկություն. ոչ մի boilerplate, ստատիկ տիպերի ստուգում, օրինակ՝ սպառիչության ստուգումներ տվյալների տիպերի էվոլյուցիայի ժամանակ
- Արտադրողականություն. բարձր մակարդակի OCaml կոդը մեքենայական կոդի կոմպիլյացիան կանխատեսելի է և բավականին հեշտ է դրա մասին դատել
Մաքրությունն ու ծուլությունը ցուցակի ներքևում են. երբեմն օգտակար, բայց ոչ ֆունկցիոնալ ծրագրավորման էական մասեր։
Մաքրությունը կարևոր է, թե ոչ, քննարկումն ավարտելու համար, կարծում եմ, պետք է հիշենք, որ կիսվող փոփոխվող վիճակը միշտ կլինի։ Ես սրտանց համաձայն եմ, որ ծրագրի հիշողության վիճակից այն հեռացնելը լավ պրակտիկա է, որին մենք բոլորս պետք է ձգտենք՝ անկախ մեր սիրելի ծրագրավորման ոճից։ Բայց մտածեք մի ծրագրի մասին, որը միաժամանակ աշխատեցնում է երկու պրոցես.
// thread 1
writeToDatabase(user.copy(age = user.age + 1))

// thread 2
readFromDatabase(userId)
Անկախ նրանից, թե ինչպես ենք ներկայացնում այս էֆեկտներով ֆունկցիաները՝ monad-ով, անմիջական էֆեկտներով թե ability-ներով, կոդը կարդալիս պետք է հիշենք, որ այն աշխատեցնելը կփոփոխի որոշ գլոբալ փոփոխվող վիճակ (այստեղ՝ տվյալների բազայում)։
Վիճակը, որի վրա աշխատում է մեր կոդը, սահմանափակված չէ հիշողության մեջ գտնվողով, ինչպես գլոբալ փոփոխականները։ (Որոնցից, կրկին, պետք է հեռու մնալ։ Կյանքը ավելի դժվար մի դարձրեք, քան անհրաժեշտ է։) Կան նաև տվյալների բազան, ֆայլային համակարգը և անհամար արտաքին ծառայություններ, որտեղ յուրաքանչյուր POST/PUT կանչ փոփոխում է լայն իմաստով «աշխարհի վիճակը», որին պատկանում է մեր կառուցած ծառայությունը։
Գլոբալ վիճակի փոփոխությունից խուսափել հնարավոր չէ. կներեք։
FP-ի այլ սահմանումներ
Զարմանալի չէ, որ համացանցում շրջում են FP-ի շատ այլ սահմանումներ։ Քանի որ արհեստական բանականությունը միևնույն է ամեն ինչ գրավում է, լսենք, թե ինչ է մտածում այն.
ChatGPT-ն շեշտում է մաքրությունը, անփոփոխությունը և բարձր կարգի ֆունկցիաները, ինչը սերտորեն համընկնում է մեր գտածի հետ։ Գուցե մաքրությունը ցուցակի մեջ ներքև իջնի, երբ այս հոդվածը մտնի ուսուցման տվյալների հավաքածու. ժամանակը ցույց կտա։
Իսկ StackOverflow-ն։ Կան մի քանի առնչվող հարցեր, բայց դիտարկենք FP-ի և ոչ-FP ծրագրավորման մասին հարցը։ Զարմանալի չէ, որ ընդունված պատասխանը նշում է ֆունկցիաները որպես առաջին կարգի արժեքներ և անփոփոխությունը։
Մեկ այլ պատասխան համապատասխանում է մեր ավելի վաղ արված casual և pure տարբերակմանը։ Եթե այդ պատասխանը պատմականորեն ճիշտ է, casual FP-ն եկել է առաջինը և միայն հետո է գերազանցվել Haskell-ի՝ մաքրության վրա կենտրոնանալով։
Պատմության մասին խոսելով՝ չենք կարող բաց թողնել John Hughes-ի Why Functional Programming Matters հոդվածը, որը ամենայն հավանականությամբ արդեն դասական է համարվում։ Առաջին հայացքից հոդվածի օգտագործած սահմանումը նշում է միայն ֆունկցիաների կոմպոզիցիան և կիրառումը.
Սակայն հետագա ընթերցանությամբ պարզ է դառնում, որ հոդվածի ֆունկցիաները մաթեմատիկական տեսակի են։ Ուրեմն՝ ոչ մի կողմնակի էֆեկտ և ոչ մի փոփոխություն. մաքուր FP։ Հոդվածը ներկայացնում է բարձր կարգի ֆունկցիաները և ծուլությունը որպես երկու նոր տեսակի «սոսինձ» մոդուլային ծրագրեր գրելու համար՝ նմանեցնելով դա նրան, թե ինչպես կառուցվածքային ծրագրավորումը բարելավեց goto-ները։ Մենք իրականում արդեն անուղղակիորեն անդրադարձել ենք John-ի հոդվածին, երբ քննարկում էինք Jane Street-ի ելույթը, որը համաձայն է հոդվածի թեզին միայն մասամբ։
Վերջապես, ի՞նչ է ասում համացանցի առաջին էջը՝ Reddit-ը։ Իսկապես կան մի քանի թեմաներ, օրինակ՝ What even is FP and why do we like it? (իսկ մենք սիրո՞ւմ ենք)։ Subreddit-ում մեմեր չկան, բայց մի պատասխան հատկապես դուր է գալիս ինձ.
Այն ընդգծում է ֆունկցիոնալ լեզվի ergonomic և համայնքային կողմը. կարելի է ոչ միայն ամեն ինչ անել ֆունկցիոնալ կերպով, այլև դա նաև առաջարկվող մոտեցումն է՝ լեզվի ոգուն համապատասխան։
Մյուս բարձր վարկանիշ ունեցող պատասխանները թեքվում են դեպի մաքուր FP.
Այսպիսով, ի՞նչ է FP-ն
Փորձենք մեր գտածները սեղմել FP-ի հնարավորինս կոմպակտ սահմանման մեջ.
Ֆունկցիոնալ ծրագրավորումը մոտեցում է, որտեղ ծրագրի տրամաբանությունը հիմնականում արտահայտվում է ֆունկցիաների կոմպոզիցիայով։ Այստեղ ֆունկցիան հստակ սահմանված ինտերֆեյսով կոդ է, որը կարելի է բազմիցս կանչել։ Ֆունկցիոնալ ծրագրավորումը հաճախ հենվում է ստորև նշված գործիքների և տեխնիկաների վրա, թեև ոչ միշտ բոլորի, ոչ էլ միշտ.
- Ֆունկցիաները որպես 1-ին կարգի արժեքներ
- Բարձր կարգի ֆունկցիաներ
- Արտահայտությունների նախընտրումը հրամանների նկատմամբ
- Անփոփոխ տվյալների կառուցվածքներ
- Հանրահաշվական տվյալների տիպեր և pattern matching
- Էֆեկտների ներկայացումը որպես արժեքներ
- Կիսվող փոփոխվող վիճակից հեռու մնալը
- Էֆեկտներից խուսափելը կամ դրանք սահմանափակ պահելը
- Վարքի և տվյալների առանձին պահելը
Ֆունկցիոնալ ծրագրավորման լեզուն այն լեզուն է, որը ֆունկցիոնալ ծրագրավորումը դարձնում է հարմար, ինչը երևում է նրա ստանդարտ գրադարանից, արտաքին գրադարաններից և փաստաթղթավորումից։ Լեզուն համարվում է ֆունկցիոնալ միայն այն դեպքում, երբ FP-ն ծրագրեր կառուցելու գերիշխող եղանակն է։ FP-ն պետք է պատկանի լեզվի ոգուն, այլ ոչ թե պարզապես տեխնիկապես հնարավոր լինի։
Ինչ վերաբերում է այս գործիքներին և տեխնիկաներին, արժե հարցնել, թե արդյոք դրանք ծրագրավորման լեզվի ցանկալի հնարավորություններ են և որքանով։ Որքանո՞վ ֆունկցիոնալ պետք է լինեն մեր լեզուները։
Դրանցից որոշները վիճելի չեն և լայնորեն ճանաչվում են որպես օգտակար, մյուսները քննարկելի են։ Դրանցից ոչ մեկը արծաթե փամփուշտ չէ։ Յուրաքանչյուրն արժանի է իր սեփական հոդվածին, իսկ համացանցում այդպիսիք արդեն շատ կան, ուստի կանգ կառնենք այստեղ։
FP-ն կախարդական կերպով ձեր կոդը ամբողջությամբ չի բարելավի։ Հաճախ կբարելավի, բայց ոչ ամեն դեպքում։ Ֆունկցիոնալ գրված կոդը հակված է լինել ավելի անվտանգ, ավելի հեշտ ընթեռնելի, ավելի հակիրճ և այլն։ Բնականաբար, որոշ դեպքերում այն կարող է նաև վատը լինել, և իմպերատիվ, փոփոխվող տարբերակը կարող է ավելի հեշտ սպասարկվել։
Որքանո՞վ են ֆունկցիոնալ այն լեզուները, որոնք օգտագործում և սիրում ենք
Վերը նշված բնութագրիչների հիման վրա փորձենք կազմել «ֆունկցիոնալության գնահատական». մի քանի հանրաճանաչ լեզուների «որքանով FP լինելու» սուբյեկտիվ, մոտավոր գնահատական։ Այնպես որ՝ այո, վերաբերվեք դրանց վերապահումով և ազատ զգացեք փոփոխել միավորները՝ իմ սխալները ուղղելու համար։
Գնահատման կատեգորիաները համապատասխանում են վերևում սահմանված բնութագրիչներին, գումարած մեկ լրացուցիչ կատեգորիա՝ «ստանդարտ գրադարանը որքանով է ֆունկցիոնալ», որը նպատակ ունի ցույց տալ՝ FP-ն այն ոճն է, որի համար լեզուն կառուցվել է, թե պարզապես տարբերակ։
Ստորև ներկայացված է աղյուսակը՝ կապված Google Sheet-ի հետ, որը կարող եք պատճենել և փոփոխել ինչպես հարմար եք համարում.
Լեզուները խառը հավաքածու են, և դրանցից մի քանիսը հայտնվել են վերևի կոդի հատվածներում։ Սկսենք Java-ից։ Ձեր առաջին ասոցիացիան, հավանաբար, օբյեկտ-կողմնորոշված, այլ ոչ թե ֆունկցիոնալ ծրագրավորումն է, և լիովին հիմնավոր։ Դուք կարող եք ֆունկցիաները ներկայացնել որպես արժեքներ և գրել ֆունկցիոնալ ոճով, եթե ընտրեք, բայց լեզուն և ստանդարտ գրադարանը կդիմադրեն։ Java-ի ստանդարտ կոլեկցիաները փոփոխվող են, և ողջ Java էկոհամակարգը հենվում է փոփոխվող տվյալների կառուցվածքների վրա, որոնք տվյալները ինկապսուլացնում են օբյեկտների ներսում։ Վերջերս ավելացված record-ները և pattern matching-ը լեզուն մղում են դեպի FP, բայց FP-ն երբեք հավասար դիրքում չի լինի OO, իմպերատիվ կամ պրոցեդուրային ոճերի հետ։
Իսկ Kotlin-ը։ Այն լուծում է Java-ի շատ խնդիրներ՝ սկսած սինտակսից, և նաև գործիքներ է տալիս անփոփոխ տվյալների կառուցվածքներ կառուցելու համար։ Դրանով կարելի է գրել FP ոճի կոդ, բայց Kotlin-ը մնում է խորապես արմատավորված Java-ի էկոհամակարգում։ Նրա ստանդարտ գրադարանի կոլեկցիաները անփոփոխ չեն, և գրադարանները հաճախ Java-ի նման են թվում։ Սա տալիս է գերազանց ինտեր-օպերացիա Java-ի հետ, բայց նաև նշանակում է, որ Java-ի որոշ խնդիրներ մնում են չլուծված։
JVM-ի վրա մնալով՝ կա Scala-ն, լեզու, որը նախատեսված է որպես OO-ի և FP-ի հիբրիդ։ Քանի որ Scala-ն այն լեզուն է, որ ամենաշատն եմ օգտագործում, այն բաժանել եմ այսօր օգտագործվող երկու տարատեսակի. direct-style, որը համապատասխանում է casual FP-ին, և pure-FP։ Scala-ի ստանդարտ գրադարանը լիովին ֆունկցիոնալ է և լռելյայն տրամադրում է անփոփոխ տվյալների կառուցվածքներ։ Սա ուժեղ ազդեցություն ունի Scala գրադարանների գրելու եղանակի վրա։ Կիսվող փոփոխվող վիճակից խուսափելը և էֆեկտների սահմանափակումը Scala-ում ընդունված պրակտիկա են, բայց դեռ կախված են կարգապահությունից. կոմպիլյատորը դրանք չի ստուգում։
Հաջորդը «այն» FP լեզուն է՝ Haskell-ը։ Այն համապատասխանում է գրեթե բոլոր կետերին՝ տալով մաքուր FP, որտեղ էֆեկտները կարելի է սահմանել միայն IO monad-ի միջոցով։ «Փախուստի դռներ» դեռ կան (unsafePerformIO ֆունկցիայի տեսքով, որը սահմանմամբ անվտանգ չէ)։ Haskell-ը փորձարկում է բազմաթիվ հետաքրքիր ծրագրավորման գաղափարներ, ինչը և՛ օրհնություն է, և՛ անեծք. այն հայտնի է կոմպիլյատորի բազմաթիվ ընդլայնումներով, որոնք փաստորեն ստեղծում են Haskell-ի բազմաթիվ տարբեր տարատեսակներ։ Սակայն դրա շնորհիվ FP-ն հաճախ մղվում է նոր սահմաններ։
Վերջապես, երևացող անհավանական թեկնածու՝ Rust-ը։ Կարո՞ղ է Rust-ը ընդհանրապես համարվել ֆունկցիոնալ ծրագրավորման լեզու։ Պարզվում է՝ այո, մեր գնահատականում այն բավականին բարձր է։ Ուրեմն կամ Rust-ը իսկապես ֆունկցիոնալ է, կամ մեր գնահատականը թերի է։ Սակայն ավելի ուշադիր նայենք. ֆունկցիաները առաջին կարգի արժեքներ են. տվյալները լռելյայն մոդելավորվում են enum-ներով և struct-երով (= ADT-ներ). կիսվող փոփոխվող վիճակի կանխումը Rust-ի հիմնական նախագծային նպատակներից է։ Rust-ը դրան հասնում է այլ գործիքներով (սեփականության հետևում, այլ ոչ թե անփոփոխություն), բայց արդյունքը այդքան էլ տարբեր չէ։ Երբեմն կպայքարեք borrow checker-ի հետ, բայց դրա դիմաց կստանաք մաքուր արտադրողականություն և ավելի կանխատեսելի հիշողության օգտագործում։
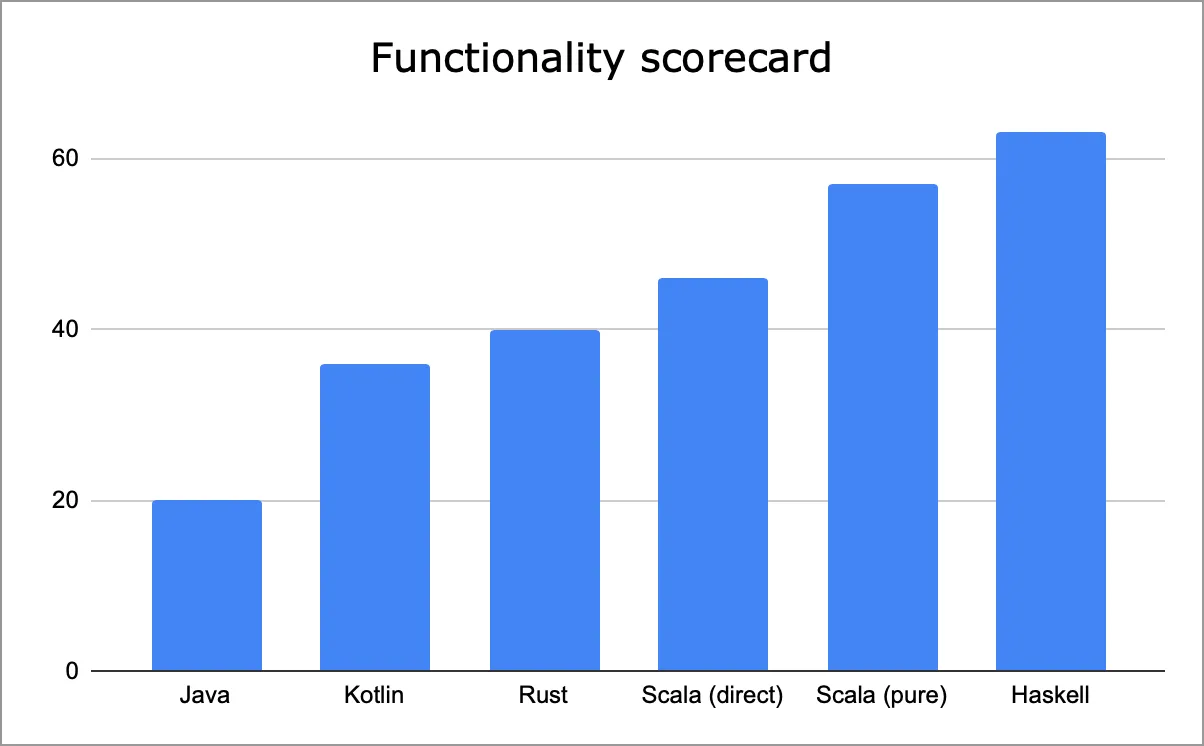
Որոշ լեզուներ ակնհայտորեն ֆունկցիոնալ են. Haskell-ը, Scala-ն, F#-ը և OCaml-ը պատկանում են այստեղ (նկատենք, որ միայն Haskell-ում է «լռելյայն», որ յուրաքանչյուր ֆունկցիա մաքուր է, իսկ էֆեկտները ներկայացվում են որպես արժեքներ)։ Որոշ լեզուներ ակնհայտորեն ֆունկցիոնալ չեն. Java-ն և C#-ը դասագրքային օրինակներ են։ Մեծ մասը հայտնվում է ինչ-որ տեղ մեջտեղում, ինչպես Kotlin-ը և Rust-ը։ Հիշեք, որ «որքանով FP է մեր կոդը» երբեք չպետք է լինի վերջնական նպատակ. դա պարզապես գործիքների հավաքածու է, որոնք լավ համադրվում են՝ օգնելու մեզ ավելի լավ ծրագրեր կառուցել։
Մեր կոդի մեծ մասը կխառնի ոճերը, երբեմն նույնիսկ մեկ ֆունկցիայի ներսում, և դա միանգամայն նորմալ է։
Եզրակացություն
Ֆունկցիոնալ ծրագրավորումը ոչ մի տեղ չի գնում։ Այն չի նվաճել աշխարհը, բայց այսօր շատ հանրաճանաչ ծրագրավորման լեզուներ ընդունել են գոնե նրա որոշ գաղափարներ։ Արժե դրանք ճիշտ ճանաչել և հասկանալ, թե ինչպես է FP-ն կիրառվում գործնականում։ Ինչպես ցույց տվեցին առաջին բաժնի կոդի օրինակները, FP-ն ավելի լայն տերմին է, քան պարզապես ծրագրավորումը մաքուր ֆունկցիաներով։
Մենք մանրամասն քննեցինք Haskell-ը, Rust-ը, Scala-ն, Java-ն և Kotlin-ը։ Բայց կան նաև C#, TypeScript, JavaScript, Python, Ruby և շատ ուրիշներ՝ յուրաքանչյուրը գոնե որոշ ֆունկցիոնալ հնարավորություններով, էլ չեմ խոսում ֆունկցիոնալ-առաջնահերթ լեզուների մասին, ինչպիսիք են F#-ը կամ OCaml-ը։ Դրանք բոլորը ամեն օր օգտագործվում են production-ում՝ աշխատող ծրագրեր մատակարարելու համար։ Ֆունկցիոնալ ծրագրավորումը թույլ է տալիս դա անել ավելի մեծ վստահությամբ և արդյունավետությամբ։
FP-ում կարևորը հիմունքներն են. ֆունկցիաները որպես առաջին կարգի արժեքներ դիտարկելու հարմար սինտակս, բարձր կարգի ֆունկցիաներ, անփոփոխ տվյալների կառուցվածքներ, ADT-ներ և ֆունկցիոնալ ստանդարտ գրադարան։ Ահա թե ինչու FP-ի արժեքի մեծ մասը գտնվում է «casual» տարբերակում, որը այն հասանելի է դարձնում լայն լսարանի համար։
Եթե ձեր լեզուն FP-ն դարձնում է ամենահարմար և գործնական ոճը՝ ընդգրկելով այն լեզվում, ստանդարտ գրադարանում և համայնքում, հիանալի է։ Եթե ոչ, ֆունկցիոնալ ծրագրավորումը դեռ կարող է էական արժեք բերել։