البرمجة الوظيفية – ما هي؟
ماذا نقصد حقًا بعبارة «البرمجة بالدوال»؟ دعونا نبحث عن إجابة.
وفقًا للتعريف «التقليدي»، تعني البرمجة الوظيفية (FP) البرمجة بدوال نقية / رياضية / خالية من الآثار الجانبية. ومع ذلك فهذا التعريف ليس عمليًا ولا ينسجم مع الطريقة التي يستخدم بها الناس المصطلح فعليًا كل يوم.
إذن ما هي البرمجة الوظيفية؟ وحتى لو قبلنا بهذا التعريف، فماذا نقصد حقًا بعبارة «البرمجة بالدوال»؟ دعونا نبحث عن إجابة.
«تعرفها حين تراها»
قبل الوصول إلى التعريفات الرسمية، لنفحص بعض الأمثلة البرمجية. في كل مرة سننفذ الوظيفة نفسها بأسلوبين مختلفين: أسلوب «وظيفي» وآخر غير وظيفي. ومن خلالها سنحاول تحديد خصائص لغة البرمجة الوظيفية وأسلوبها.
مكافأة: هل تستطيع تسمية كل اللغات المستخدمة هنا؟
المجموعات
سنبدأ بأحد أكثر تطبيقات البرمجة الوظيفية شيوعًا: تحويل المجموعات (collections):
const numbers = [1, 2, 3, 4, 5, 6];

const result = numbers
  .map((num) => num * 2)
  .filter((num) => num % 3 === 0)
  .reduce((acc, num) => acc + num, 0);
const numbers = [1, 2, 3, 4, 5, 6];
let result = 0;
for (let i = 0; i < numbers.length; i++) {
const doubled = numbers[i] * 2;
if (doubled % 3 === 0) {
result += doubled;
}
}الوظيفة متطابقة، لكن الشيفرة تبدو مختلفة تمامًا! يُظهر المثال الأول وحده أن البرمجة الوظيفية أسلوب برمجة قائم بذاته، يختلف جوهريًا عن النهج الأمري أو الإجرائي.
كما خمّنت على الأرجح، تمثّل المقطع الأول البرمجة الوظيفية. فما الخصائص التي تجعل هذه الشيفرة «وظيفية»؟
أولًا، تُحوَّل المجموعة بأسلوب تصريحي: فنحن نحدد العمليات التي ينبغي تطبيقها (map وfilter وreduce) بدلًا من كيفية تنفيذها.
ثانيًا، يعتمد المقطع الأول بشكل كبير على تطبيق الدوال: إذ تُطبَّق الدوال map وfilter وreduce على وسائط معينة. وهذه الوسائط هي نفسها دوال. هذا يعني أننا نستخدم دوال من رتبة أعلى: أي دوال تتعامل معها دوال أخرى كمعاملات.
وأخيرًا، تعمل هنا تركيبة الدوال. فناتج map يُستخدم مدخلًا لـ filter، وناتج filter بدوره مدخل لـ reduce.
أما المقطع الأمري فيعتمد، على العكس، على تدفق تحكم صريح (حلقات for وشروط if) وبيانات قابلة للتغيير (result). وربما الأهم (وإن كان ذلك مسألة ذوق) أن طابعه الإجرائي لا التصريحي يعني أنه ليس واضحًا على الفور أي تحويل يُطبَّق على المصفوفة المدخلة.
المجموعات، تتمة
المثال الثاني يتعلق أيضًا بتحويل المجموعات. إليك المقطعين:
val menu: List<Meal> = if (vegetarian) {
  entireMenu.filter { meal -> meal.ingredients.all { it.plant } }
} else {
  entireMenu.filter { meal -> meal.ingredients.any { it.meat } }
}
val dietaryRestriction: (Meal) -> Boolean = if (vegetarian) {
{ m -> m.ingredients.all { it.plant } }
} else {
{ m -> m.ingredients.any { it.meat } }
}
val menu = entireMenu.filter(dietaryRestriction)يستخدم كلا المقطعين أدوات من صندوق أدوات البرمجة الوظيفية (الموصوف أعلاه). غير أن الثاني يعرّف أيضًا dietaryRestriction كقيمة تصادف أنها دالة.
بعبارة أخرى، تتعامل اللغات الوظيفية مع الدوال بوصفها قيمًا من الدرجة الأولى. يمكنك استخدامها كأي قيمة أخرى: إسنادها إلى متغيرات، وتمريرها كوسائط، وإرجاعها من دوال.
يجبرنا المقطع الأول على كتابة استدعاء filter (على بساطته) مرتين. أما المقطع الثاني فيتجنب هذا التكرار في الشيفرة لأنه يمكن التعامل مع الدوال كقيم.
تعريف البيانات
تحويل المجموعات شيء، لكننا نحتاج أولًا إلى وسيلة لتعريف هياكل البيانات التي سنحوّلها. لنتأمل مثالًا ثالثًا نبني فيه بعض البيانات: ربط الأشخاص بعناوينهم. في عيد ميلاد أحد الأشخاص ينتقل إلى مسكن جديد، ويُحدَّث الربط:
case class Person(name: String, age: Int)
case class Address(where: String, permanent: Boolean)

val chris = Person("Chris", 29)
val friends = Map(
  chris -> Address("Berlin", permanent = true),
  Person("Nicole", 36) -> Address("Paris", permanent = false)
)

val updatedFriends = friends
  .removed(chris)
  .updated(chris.copy(age = 30),
    Address("Munich", permanent = true))
class Person { String name; int age; }
class Address { String where; boolean permanent; }
Person chris = new Person("Chris", 29);
Map<Person, Address> friends = new HashMap<>();
friends.put(chris, new Address("Berlin", true));
friends.put(new Person("Nicole", 36),
new Address("Paris", false));
chris.setAge(30);
friends.put(chris, new Address("Munich", true));لا توجد هنا دوال من رتبة أعلى ولا دوال مستخدمة كقيم من الدرجة الأولى. ومع ذلك سنسمي المقطع الأول «وظيفيًا» والثاني – «أمريًا». فما الذي يصنع الفرق؟
المهم أن القائمة الأولى تستخدم هياكل بيانات غير قابلة للتغيير (immutable)، بينما تعتمد الثانية على هياكل قابلة للتغيير. في المقطع الأول، كل من Map والصنفين Address وPerson غير قابل للتغيير. فبعد إنشاء نسخها لا يمكن تعديلها. كل ما يمكننا فعله هو إنتاج نسخ محدّثة من هياكل البيانات هذه بدوال مثل removed وupdated وcopy.
تحمل البيانات غير القابلة للتغيير مزايا كثيرة، خاصة حين تُشارك البيانات بين دوال وعمليات تعمل بالتزامن. فحين تعلم أن دالة لا يمكنها ببساطة تعديل الوسائط التي تتلقاها، أو أن بعض البيانات يمكن قراءتها بأمان دون مزامنة، يصبح التفكير في الشيفرة أسهل.
تعتمد النسخة الأمرية (المقطع الثاني) على هياكل بيانات قابلة للتغيير (HashMap وأصناف يمكن تغيير حقولها). ما زلنا نستدعي دوالًا لتعديل البيانات (put وsetAge)، لكنها عادةً لا تُرجع شيئًا ذا معنى (فهي void، أو تُرجع قيمًا من نوع () / Unit). بعبارة أخرى، نستدعيها لآثارها الجانبية وحدها.
من حيث أسلوب البرمجة، لهياكل البيانات غير القابلة للتغيير عواقب أخرى. وبما أن copy وremoved وupdated تُرجع قيمًا محدّثة، يمكننا (بل يجب علينا) الاعتماد على تركيب الدوال للتعبير عن التحويلات المتتابعة لخريطة friends؛ فمثلًا، ما تُرجعه removed يُمرَّر إلى updated.
وعلى العكس، فإن الدوال ذات الآثار الجانبية التي لا تُرجع شيئًا ذا معنى تعيق تركيب الدوال والبرمجة الوظيفية، اللتين تصبحان أصعب بكثير، إن أمكنتا أصلًا. ونُجبَر بدلًا من ذلك على كتابة سلسلة من التعليمات ذات الآثار.
وهذا يقودنا إلى خاصية أخرى للأسلوب الوظيفي: الحد من آثار الدوال. وكما رأينا أعلاه، نقابل بين الدوال الخالية من الآثار (التي نستدعيها فقط للحصول على قيمتها المُرجعة) والتي تعمل على مجموعات غير قابلة للتغيير، والدوال ذات الآثار الجانبية التي تعمل على مجموعات قابلة للتغيير. إن تقليل الآثار يتيح لنا تلقائيًا البرمجة بأسلوب أكثر وظيفية. إلى أي مدى ينبغي أن ندفع بهذه الفكرة؟
الآثار
بالحديث عن الآثار: إنها في كل مكان. فالتحدث إلى قواعد البيانات، وإرسال طلبات HTTP، وإطلاق الصواريخ مهام يومية للمبرمج. لنلقِ نظرة على بعض الأمثلة البرمجية في هذا المجال:
public class RocketLauncher {
  public void launch() {
    checkFuelLevel();
    initializeNavigation();
    performSystemCheck();
    igniteEngine();
    System.out.println("Success!");
  }
}
launchRocket :: IO ()
launchRocket = do
checkFuelLevel
initializeNavigation
performSystemCheck
igniteEngine
putStrLn "Success!"launchRocket : '{IO}
launchRocket _ =
checkFuelLevel
initializeNavigation
performSystemCheck
igniteEngine
printLine "Success!"مرة أخرى، تفعل الثلاثة الشيء نفسه. وعند قراءتها نفكر في الشيفرة بطريقة أمرية متشابهة: «إطلاق صاروخ يعني فحص مستوى الوقود أولًا، ثم تهيئة الملاحة، ثم تشغيل فحوصات الأنظمة، وأخيرًا إشعال المحرك. بعد ذلك يمكنني إخبار العالم بإطلاق ناجح آخر». أي أن الثلاثة جميعًا تنقل المنطق نفسه على المستوى الأعلى. أما على مستوى البرمجة فلا يمكن أن تكون أشد اختلافًا!
المقطع الأول هو ما قد نسميه «البرمجة الأمرية التقليدية». فاستدعاء دالة يطلق فورًا سلسلة من الآثار (الجانبية)، ثم ننتقل إلى ما بعدها.
أما المقطع الثاني، فعلى العكس، يمثّل الآثار كقيم. فالدوال مثل checkFuelLevel وinitializeNavigation وغيرها لا تفعل سوى بناء وإرجاع قيم هي أوصاف لعمليات حسابية. وتمثيل الآثار كقيم أسلوب لكتابة دوال خالية من الآثار.
ثم تُدمج هذه القيم في وصف أكبر واحد يرتّب الأوصاف الداخلية عبر صيغة do (وهي سكّر نحوي لاستدعاء سلسلة من الدوال عالية الرتبة IO.flatMap). ولا تحدث الآثار إلا حين يقيّم مفسّر من المستوى الأعلى هذا الوصف (وقد يحدث ذلك مرة واحدة أو مرات عديدة أو لا يحدث أبدًا). ونتيجة لذلك ينفصل تعريف العمليات ذات الآثار عن تقييمها.
لن نخوض في تحليل شامل لمزايا هذا التقييد للآثار وعيوبه، إذ يتطلب ذلك تناول مونادات التحكم والتقييم الكسول وغيرها – فالإنترنت يغطي ذلك باستفاضة. يكفي القول إن (بعض) اللغات الوظيفية على الأقل توفر وسيلة لتمثيل الآثار كقيم وتقييمها بكسل.
قلنا سابقًا إن الأسلوب الوظيفي يستفيد من تقليل الآثار الممكنة للدالة إلى أقصى حد، وهنا ندفع بذلك إلى أقصى الحدود. فالآثار غير مسموحة إطلاقًا. يؤتي هذا النهج الجذري ثماره: إذ يمكننا أن نكون وظيفيين بنسبة 100%. لكنه يأتي أيضًا بثمن كبير: عبء في وقت التشغيل وعبء معرفي وعبء في الصياغة، نظرًا لانتشار الآثار الجانبية في قواعد الشيفرة الواقعية.
يُظهر المقطع الثالث نوعًا من الحل الوسط: فتنفيذ العمليات ذات الآثار يتطلب قدرة (ability)، تُدرج في نوع الدالة. يمكنك النظر إلى هذه الشيفرة بشكل أمري، مع تقييم الآثار فورًا حين تكون القدرة في النطاق. أو يمكنك اعتبار كل دالة تتطلب قدرات كسولة وبالتالي خالية من الآثار، لأن الآثار لا يمكن أن تحدث إلا بعد توفير القدرة.
تركيب البرامج
لنرَ كيف يمكن بناء برامج أكبر من أجزاء أصغر:
var order = Order.Parse(request); // might throw
order.Validate(); // might throw
order.CalculateTotal();

if (request.LoyalCustomer)
{
  order.SetLoyal(true);
  order.ApplyDiscount();
}

order.CalculateTax();

var invoice = new Invoice(order.Total, order.Tax);
parse_order request (* returns a Result *)
|> Result.bind validate_order
|> Result.map (fun order ->
create_invoice
(apply_discount (calculate_total order) request)
(calculate_tax order))هناك نوعان من التركيب هنا. الأول هو الجمع بين تحليل الطلب والتحقق منه، وكلاهما قد يفشل. يعالج المثال الأول ذلك بآثار، عبر رمي الاستثناءات. أما الثاني فيفعل ذلك دون آثار: إذ تُمثَّل الأخطاء كقيم عبر نوع البيانات Result (وتستخدم بعض اللغات Either للغرض نفسه). وعمومًا، فإن تمثيل المفاهيم كقيم أمر كثيرًا ما تراه في اللغات الوظيفية.
والنوع الثاني هو الجمع بين عدة دوال للتعبير عن منطق حساب الفاتورة. يحقق المقطع الأول ذلك عبر خطوات أمرية (سلسلة من التعليمات) وبيانات قابلة للتغيير ودوال ذات آثار جانبية.
أما في المقطع الثاني، فإن دوالًا مثل apply_discount وcalculate_total وغيرها لا تعدّل البيانات ولا تنتج آثارًا أخرى؛ بل تحسب شيئًا من مدخلاتها وتُرجع قيمًا. نحن نعتمد على تركيب الدوال الخالية من الآثار، عبر تعبيرات تنتج بيانات غير قابلة للتغيير. وهذه بالضبط الخصائص التي لاحظناها عند فحص تعريف البيانات. من الواضح أن هذه برمجة وظيفية.
البيانات والسلوك
أخيرًا، لنلقِ نظرة (موجزة) على العلاقة بين البرمجة كائنية التوجه والبرمجة الوظيفية. يمكن أن تتعايشا جنبًا إلى جنب (كما تظهر F# وScala)، لكنهما تجيبان أحيانًا عن السؤال نفسه إجابتين مختلفتين.
interface Shape { double area(); }

class Square implements Shape {
  private double side;
  Square(double side) { this.side = side; }

  double area() { return side * side; }
}

class Circle implements Shape {
  private double radius;
  Circle(double radius) { this.radius = radius; }

  double area() { return Math.PI * radius * radius; }
}
enum Shape {
Square { side: f64 },
Circle { radius: f64 },
}
fn area(shape: &Shape) -> f64 {
match shape {
Shape::Square { side } => side * side,
Shape::Circle { radius } => std::f64::consts::PI * radius * radius,
}
}تجيب البرمجة كائنية التوجه عن سؤال «كيف نتعامل مع الشيفرة والبيانات» بـالجمع بينهما: وهذا جوهر التغليف. فالبيانات مخفية عمّن يستخدمون التجريد ولا يمكن تغييرها إلا عبر الدوال التي يكشفها الكائن. وغالبًا ما يترافق ذلك مع قابلية التغيير. قد يكون تغليف البيانات الخيار الصحيح، لكنه ليس الوحيد.
أما الإجابة البديلة للبرمجة الوظيفية فهي الفصل بين البيانات والسلوك. تُعرَّف هياكل البيانات دون سلوك مرتبط بها (ويُعبَّر عن السلوك عبر الدوال). وتميل البيانات إلى أن تكون غير قابلة للتغيير (كما ذُكر سابقًا)، وتأتي معظم لغات البرمجة الوظيفية، إن لم تكن كلها، بدعم مدمج لـأنواع البيانات الجبرية (ADTs) ومطابقة الأنماط. في المقطع الثاني أعلاه، Shape هو تعداد (enum) – مجموع مشترك (coproduct) – له متغيّران – Square وCircle – كل منهما بنية (ضرب product) تحمل حقلًا واحدًا.
توفر أنواع البيانات الجبرية وسيلة عملية ومرنة وآمنة من حيث الأنواع لتعريف هياكل بيانات غير قابلة للتغيير. ومع الدوال، تشكل اللبنات الأساسية للبرامج الوظيفية.
سمات لغات البرمجة الوظيفية وما ليس منها
يمكن تلخيص ما تعلمناه حتى الآن في «قائمة تحقق» بالسمات التي قد تمتلكها لغة برمجة. كل منها يجعل اللغة أكثر ترجيحًا أن تُعدّ وظيفية، أو على الأقل يتيح البرمجة بأسلوب وظيفي. وإلى جانبها قائمة بما ليس من السمات يمكن أن تساعدنا في التعرف على اللغات الأمرية أو الإجرائية:
| سمات النهج «الوظيفي» | ما ليس من سمات الأسلوب «الوظيفي» |
|---|---|
| تركيب الدوال | خطوات أمرية |
| دوال من رتبة أعلى | حلقات وشروط |
| الدوال كقيم من الدرجة الأولى | شيفرة مكررة |
| دوال خالية من الآثار | دوال ذات آثار جانبية |
| الآثار ممثلة كقيم | آثار تُنفَّذ فورًا |
| التعبيرات | التعليمات |
| بيانات غير قابلة للتغيير | بيانات قابلة للتغيير |
| ADTs ومطابقة الأنماط | الأصناف والوراثة |
| البيانات والسلوك منفصلان | البيانات والسلوك مجمّعان معًا |
بعد أن كوّنّا بعض الحدس وتناولنا الجوانب العملية – أي ميزات لغات البرمجة تُعدّ «وظيفية» – لننتقل إلى النظرية والتعريفات الرسمية.
نظرة نظرية إلى البرمجة الوظيفية
عند محاولة اكتشاف ماهية البرمجة الوظيفية وفهمها، فإن الخطوة الأولى الطبيعية هي البحث عنها في ويكيبيديا. المقال مفصّل نسبيًا، لكننا سنركز على فقرته الافتتاحية التي تحتوي على التعريف:
نموذج تُبنى فيه البرامج بتطبيق الدوال وتركيبها
هذا كل شيء – وهو يتطابق مع ما وجدناه حتى الآن. فإذا كان تطبيق الدوال وتركيبها هو الأداة الرئيسية لبناء البرامج، فسنحتاج سريعًا إلى دوال من رتبة أعلى ودوال كقيم من الدرجة الأولى. بدونها لا يمكننا استخدام هذا الأسلوب البرمجي بفعالية.
وبالتالي فإن البرنامج الوظيفي شجرة من تطبيقات الدوال. فمن جهة، يمنحه ذلك طابعًا تصريحيًا نصف فيه «ماذا» لا «كيف» (وإن كان الخط الفاصل بينهما كثيرًا ما يكون ضبابيًا). كما أن كونه تصريحيًا يعني أن سلوك برنامجنا يُحدَّد دون بنى تحكم صريحة في التدفق، أو بعدد أقل منها على الأقل. ومن جهة أخرى، ينتهي بنا الأمر إلى التعامل مع التعبيرات – وهي سمة أخرى من سمات البرمجة الوظيفية ظهرت في الأمثلة.
تذكّر أنه حين نعدّ «الدوال كقيم من الدرجة الأولى» أو «الدوال من رتبة أعلى» ميزات مطلوبة في اللغة، فإننا نعني أنها تأتي بصياغة خفيفة نسبيًا ومريحة في الاستخدام؛ فمجرد القدرة الدلالية على «الالتفاف وتعريف دالة من رتبة أعلى» لا تكفي.
لكن ما هي الدالة؟
يعاني التعريف أعلاه من نقطة ضعف واحدة. ما هي الدالة بالضبط؟ هناك طريقتان للنظر إليها. إحداهما اتباع رابط function في ويكيبيديا، الذي يخبرنا بأن:
الدالة وحدة برمجية يمكن استدعاؤها، ولها سلوك محدد جيدًا، ويمكن استدعاؤها مرات عديدة
والأخرى لمن يميلون إلى الرياضيات. نعلم جيدًا أن الدالة f: D → C علاقة يقابل فيها كل x ∈ D عنصرًا واحدًا بالضبط f(x) ∈ C. الدوال الرياضية حتمية وخالية من الآثار؛ ونتيجتها تحددها مدخلاتها وحدها. فلا حالة العالم ولا الوقت من اليوم ولا الطقس ولا ما هو مخزّن في قاعدة البيانات يؤثر في نتيجة الدالة.
إن تعريف الدالة الذي نتبناه يحدد نكهة البرمجة الوظيفية التي سنصل إليها. فاعتماد التعريف الموجّه للحاسوب، الذي قد تكون فيه للدوال آثار (جانبية)، يعطي ما سأسميه البرمجة الوظيفية غير الصارمة (casual functional programming) (وهو مصطلح ابتكرته للتو وليس شائع الاستخدام – على الأقل ليس بعد).
أما اعتماد التعريف الرياضي فيعطي البرمجة الوظيفية النقية، وهو مصطلح أكثر انتشارًا بكثير، تكون فيه كل دالة خالية من الآثار.
النقاء هدف ممتاز ويستحق السعي إليه. ومع ذلك لا توجد لغة شائعة تتيح لنا التحقق من أن الدالة نقية. فهناك دائمًا مخرج للهروب – ففي Haskell مثلًا توجد unsafePerformIO. وهذا لا يجعل المفهوم عديم الفائدة، لكنه قد يوحي بأن اشتراط النقاء في قاعدة الشيفرة كلها ليس بالضرورة خاصية مرغوبة.
أليست البرمجة الوظيفية غير الصارمة مجرد شيفرة نظيفة؟
لكن – قد تعترض – بتوسيع التعريف إلى «برمجة وظيفية غير صارمة»، نحن نقول في الأساس إننا نريد بناء برامج بتطبيق وحدات برمجية قابلة للاستدعاء وتركيبها (قد تكون لها أي آثار). أليست هذه مجرد البرمجة بدوال صغيرة؟ وهو أمر روّج له الناس طويلًا كجزء من الشيفرة النظيفة؟
نعم – إن إعادة هيكلة شيفرة سباغيتي كائنية التوجه إلى دوال صغيرة تقرّبك من البرمجة الوظيفية. فالشيفرة النظيفة يمكن أن تزخر بمبادئ البرمجة الوظيفية.
ولا – فالدوال الصغيرة وحدها لا تكفي إذا أردنا تركيب الدوال بصورة أكثر تكرارًا. إذ يجب أن يتغير شكلها جذريًا أيضًا: فبدلًا من التعديل وإحداث آثار جانبية، ينبغي أن تُرجع قيمًا ذات معنى يمكن أن تكون مدخلات لدوال أخرى.
ولا نصل إلى البرمجة الوظيفية غير الصارمة إلا بعد أن نضيف الدوال من رتبة أعلى، والدوال كقيم من الدرجة الأولى، وأنواع البيانات الجبرية، وعدم قابلية التغيير، ولغة موجهة نحو التعبيرات، وتقييد الآثار (وإن لم يكن بالضرورة إزالتها) وغير ذلك.
يعتمد مدى اعتبار لغة ما وظيفية على ما إذا كان بناء البرامج بهذه السمات الوظيفية مريحًا وهو النهج الرئيسي (وليس ثانويًا أو ممكنًا فحسب).
أين تكمن قيمة البرمجة الوظيفية
في رأيي، معظم ما يقدمه أسلوب البرمجة الوظيفية ينبع من سد الفجوة بين الأساليب الأمرية/الإجرائية والبرمجة الوظيفية غير الصارمة. بعبارة أخرى، نستفيد من سمات البرمجة الوظيفية المحددة أعلاه (الدوال كقيم من الدرجة الأولى، والدوال من رتبة أعلى، والبيانات غير القابلة للتغيير، والحد من الآثار) دون التشدد فيها بالضرورة.
أما الخطوة التالية، الانتقال من البرمجة الوظيفية غير الصارمة إلى النقية (دوال خالية من الآثار، أي أن كل أثر هو قيمة)، فقد تكون مجدية، لكن عوائدها قد تتناقص أيضًا.
لننظر في هذه الأمثلة الثلاثة:
var users = new ArrayList[User]()
for id <- peopleIds do
  users.add(fetchFromDb(id))

var likes = new ArrayList[Response]()
var dislikes = new ArrayList[Response]()
for user <- users do
  val response = sendRequest(user)
  if response.body.likedSciFiMovies.contains("Star Wars")
  then likes.add(response)
  else dislikes.add(response)
peopleIds
.map(fetchFromDb)
.map(sendRequest)
.map(_.body.likedSciFiMovies)
.partition(_.body
.likedSciFiMovies
.contains("Star Wars"))peopleIds
.traverse: id =>
fetchFromDb(id)
.flatMap(sendRequest)
.map(_.partition(_.body
.likedSciFiMovies
.contains("Star Wars")))الأول يتبع أسلوبًا أمريًا قابلًا للتغيير مليئًا ببنى تحكم في التدفق مثل الحلقات. وفيه الدالتان fetchFromDb وsendRequest ذواتا الآثار الجانبية. الشيفرة «مقبولة»، لكن هل يمكننا تحسينها؟
المقطع الثاني يفعل الشيء نفسه، بعد إعادة هيكلته إلى برمجة وظيفية غير صارمة. تعبّر الدالتان من رتبة أعلى map وpartition عن التحويل المطلوب، ويربط تركيب الدوال الخطوات معًا؛ وتبقى fetchFromDb وsendRequest ذواتي آثار. وهذا متوقع، بالنظر إلى اسميهما والوظيفة التي نبنيها.
وأخيرًا، أُعيدت هيكلة المقطع الثالث إلى برمجة وظيفية نقية، مع تمثيل الآثار كقيم. ونتيجة لذلك يجب أن يتم تركيبها وتحويلها على مستوى القيم، ما يضيف طبقة إضافية تظهر هنا في استدعاءات traverse وmap. الآثار مضبوطة وتُقيَّم بكسل؛ وتعريفاتها منفصلة عن تقييمها، ومع ذلك لا نستفيد من هذه القدرات في معظم الأحيان.
تظهر رؤية مشابهة في محاضرة معروفة عن البرمجة الوظيفية من Jane Street – وهي، على حد علمي، أكبر مستخدم تجاري للغة OCaml وعضو نشط في مجتمع البرمجة الوظيفية. تبدأ المحاضرة «Why FP doesn’t matter» بعرض بعض الأفكار التي نوقشت أعلاه ثم تصف الميزات التي تجعل البرمجة الوظيفية مهمة لدى Jane Street:
- الصحة: تتيح الأنواع الساكنة المعبّرة وأنواع البيانات الجبرية جعل الحالات غير القانونية غير قابلة للتمثيل
- البراعة: لا شيفرة نمطية متكررة، وفحص أنواع ساكن، مثل فحوصات الاستيفاء عند تطور أنواع البيانات
- الأداء: ترجمة شيفرة OCaml عالية المستوى إلى شيفرة آلة أمر يمكن التنبؤ به وسهل التفكير فيه نسبيًا
يقع النقاء والتقييم الكسول قرب أسفل القائمة – مفيدان بين الحين والآخر، لكنهما ليسا جزأين أساسيين من البرمجة الوظيفية.
ولإنهاء النقاش حول ما إذا كان النقاء مهمًا، أعتقد أننا ينبغي أن نتذكر أن الحالة المشتركة القابلة للتغيير ستظل موجودة دائمًا. أتفق من كل قلبي أن إزالتها من حالة البرنامج في الذاكرة ممارسة جيدة ينبغي أن نسعى إليها جميعًا، أيًا كان أسلوب البرمجة المفضل لدينا. لكن تخيّل برنامجًا يشغّل عمليتين في الوقت نفسه:
// thread 1
writeToDatabase(user.copy(age = user.age + 1))

// thread 2
readFromDatabase(userId)
مهما مثّلنا هذه الدوال ذات الآثار – بمونادة، أو آثار فورية، أو قدرات – فعند قراءة الشيفرة يجب أن نتذكر أن تشغيلها سيغيّر حالة عامة قابلة للتغيير (هنا، في قاعدة البيانات).
الحالة التي تعمل عليها شيفرتنا لا تقتصر على ما يوجد في الذاكرة، كالمتغيرات العامة. (والتي ينبغي، مرة أخرى، أن نتجنبها! لا تجعل الحياة أصعب مما يلزم.) فهناك أيضًا قاعدة البيانات ونظام الملفات وعدد لا يحصى من الخدمات الخارجية، حيث يغيّر كل استدعاء POST/PUT «حالة العالم» بمعناها الواسع التي تنتمي إليها الخدمة التي نبنيها.
لا يمكنك تجنب تغيير الحالة العامة – آسف!
تعريفات أخرى للبرمجة الوظيفية
ليس مستغربًا أن تنتشر على الإنترنت تعريفات أخرى كثيرة للبرمجة الوظيفية. وبما أن الذكاء الاصطناعي سيستولي على كل شيء على أي حال، فلنسمع ما يراه:
يركّز ChatGPT على النقاء وعدم قابلية التغيير والدوال من رتبة أعلى، وهذا يتطابق إلى حد كبير مع ما وجدناه. ولعل النقاء سيتراجع في القائمة بعد أن يدخل هذا المقال إلى مجموعة التدريب؛ والأيام كفيلة بالإجابة!
وماذا عن StackOverflow؟ توجد عدة أسئلة ذات صلة، لكن لننظر في السؤال عن البرمجة الوظيفية مقابل غير الوظيفية. وكما هو متوقع، تذكر الإجابة المقبولة الدوال كقيم من الدرجة الأولى وعدم قابلية التغيير.
وتتوافق إجابة أخرى مع التمييز الذي رسمناه سابقًا بين غير الصارمة والنقية. فإذا كانت تلك الإجابة دقيقة تاريخيًا، فقد جاءت البرمجة الوظيفية غير الصارمة أولًا ثم تجاوزها لاحقًا تركيز Haskell على النقاء!
وبالحديث عن التاريخ، لا يمكننا تجاوز ورقة Why Functional Programming Matters لجون هيوز – التي يُرجَّح أنها تُعدّ الآن من الكلاسيكيات. للوهلة الأولى، لا يذكر التعريف الذي تستخدمه الورقة سوى تركيب الدوال وتطبيقها:
لكن عند مواصلة القراءة يتضح أن دوال الورقة من النوع الرياضي. أي لا آثار جانبية ولا تغيير: برمجة وظيفية نقية. تقدّم الورقة الدوال من رتبة أعلى والتقييم الكسول بوصفهما نوعين جديدين من «الغراء» لكتابة برامج معيارية، مشبّهة ذلك بكيفية تحسين البرمجة المهيكلة لما كان قائمًا على goto. وقد تناولنا ورقة جون بالفعل بشكل غير مباشر حين ناقشنا محاضرة Jane Street، التي توافق أطروحة الورقة جزئيًا فقط.
وأخيرًا، ماذا تقول الصفحة الأولى للإنترنت – Reddit؟ توجد بالفعل عدة نقاشات، مثل ما هي البرمجة الوظيفية أصلًا ولماذا نحبها؟ (هل نحبها؟). لا توجد في هذا المنتدى الفرعي ميمات، لكن إحدى الإجابات تروق لي بصفة خاصة:
فهي تبرز الجانب المريح والمجتمعي للغة وظيفية: فليس بإمكانك فعل كل شيء بطريقة وظيفية فحسب، بل هذا هو النهج الموصى به أيضًا، انسجامًا مع روح اللغة.
وتميل إجابات أخرى حازت أصواتًا مرتفعة إلى البرمجة الوظيفية النقية:
إذن ما هي البرمجة الوظيفية؟
لنحاول تكثيف ما توصلنا إليه في أكثر تعريف موجز ممكن للبرمجة الوظيفية:
البرمجة الوظيفية نهج يُعبَّر فيه عن منطق البرنامج أساسًا عبر تركيب الدوال. والدالة هنا شيفرة ذات واجهة محددة جيدًا يمكن استدعاؤها مرارًا. وتعتمد البرمجة الوظيفية كثيرًا على الأدوات والتقنيات التالية، وإن لم يكن دائمًا على كلها ولا في كل الأوقات:
- الدوال بوصفها قيمًا من الدرجة الأولى
- الدوال من رتبة أعلى
- تفضيل التعبيرات على التعليمات
- هياكل البيانات غير القابلة للتغيير
- أنواع البيانات الجبرية ومطابقة الأنماط
- تمثيل الآثار كقيم
- تجنب الحالة المشتركة القابلة للتغيير
- تجنب الآثار أو إبقاؤها محدودة
- الفصل بين السلوك والبيانات
لغة البرمجة الوظيفية هي التي تجعل البرمجة الوظيفية مريحة، كما ينعكس في مكتبتها القياسية ومكتباتها الخارجية ووثائقها. ولا تُعدّ اللغة وظيفية إلا حين تكون البرمجة الوظيفية الطريقة السائدة لبناء البرامج. فيجب أن تنتمي البرمجة الوظيفية إلى روح اللغة، لا أن تكون ممكنة تقنيًا فحسب.
وفيما يتعلق بهذه الأدوات والتقنيات، يجدر السؤال عما إذا كانت ميزات مرغوبة في لغة البرمجة، وإلى أي مدى. ما مدى وظيفية اللغات التي ينبغي أن نستخدمها؟
بعضها لا خلاف عليه ومعترف بفائدته على نطاق واسع؛ وبعضها الآخر قابل للنقاش. ولا شيء منها حل سحري. كل منها يستحق مقالًا خاصًا، وفي الإنترنت منها الكثير بالفعل، لذا سنكتفي بهذا القدر.
لن تحسّن البرمجة الوظيفية شيفرتك بشكل سحري في كل المجالات. كثيرًا ما تفعل، لكن ليس في كل الحالات. تميل الشيفرة المكتوبة بأسلوب وظيفي إلى أن تكون أكثر أمانًا وأسهل قراءة وأكثر إيجازًا وغير ذلك. وبطبيعة الحال، قد تكون في بعض حالات الاستخدام أسوأ، وقد تتبين النسخة الأمرية القابلة للتغيير أسهل صيانة.
ما مدى وظيفية اللغات التي نستخدمها ونحبها؟
استنادًا إلى الخصائص أعلاه، لنحاول وضع «بطاقة تقييم للوظيفية»: تقييم ذاتي وتقريبي لمدى «وظيفية» عدة لغات شائعة. لذا خذها بشيء من الحذر، ولا تتردد في تعديل الدرجات لتصحيح أي أخطاء مني.
تتطابق فئات التقييم مع الخصائص المحددة سابقًا، بالإضافة إلى فئة إضافية لـ«مدى وظيفية المكتبة القياسية»، تهدف إلى رصد ما إذا كانت البرمجة الوظيفية هي الأسلوب الذي صُمّمت اللغة له أم مجرد خيار.
فيما يلي الجدول، المرتبط بجدول بيانات Google يمكنك نسخه وتعديله كما تشاء:
اللغات متنوعة، وبعضها ظهر في المقاطع البرمجية أعلاه. لنبدأ بـ Java. ارتباطك الأول بها على الأرجح هو البرمجة كائنية التوجه لا الوظيفية، وله ما يبرره. يمكنك تمثيل الدوال كقيم والكتابة بأسلوب وظيفي إن شئت، لكن اللغة والمكتبة القياسية ستقاومان ذلك. فمجموعات Java القياسية قابلة للتغيير، ويقوم النظام البيئي لـ Java كله على هياكل بيانات قابلة للتغيير تغلّف البيانات داخل الكائنات. وتدفع السجلات (records) ومطابقة الأنماط المضافة حديثًا اللغة نحو البرمجة الوظيفية، لكن البرمجة الوظيفية لن تقف فيها أبدًا على قدم المساواة مع الأساليب كائنية التوجه أو الأمرية أو الإجرائية.
وماذا عن Kotlin؟ إنها تحل كثيرًا من مشكلات Java، بدءًا بالصياغة، وتوفر أيضًا أدوات لبناء هياكل بيانات غير قابلة للتغيير. يمكنك كتابة شيفرة بأسلوب البرمجة الوظيفية بها؛ ومع ذلك تظل Kotlin متجذرة بعمق في النظام البيئي لـ Java. فمجموعات مكتبتها القياسية ليست غير قابلة للتغيير، وكثيرًا ما تبدو المكتبات على طريقة Java. وهذا يمنح توافقًا ممتازًا مع Java، لكنه يعني أيضًا أن بعض مشكلات Java تبقى دون حل.
وبالبقاء على JVM، هناك Scala، وهي لغة مقصود بها أن تكون هجينًا بين البرمجة كائنية التوجه والوظيفية. ولأن Scala هي اللغة التي أستخدمها أكثر، فقد قسمتها إلى النكهتين المستخدمتين اليوم: النمط المباشر (direct-style)، الذي يطابق البرمجة الوظيفية غير الصارمة، والنمط النقي. مكتبة Scala القياسية وظيفية بالكامل وتوفر هياكل بيانات غير قابلة للتغيير افتراضيًا. وهذا يشكّل بقوة طريقة كتابة مكتبات Scala. فتجنب الحالة المشتركة القابلة للتغيير وتقييد الآثار ممارسة شائعة في Scala، لكنها ما زالت تعتمد على الانضباط – فالمترجم لا يتحقق منها.
ثم تأتي «لغة» البرمجة الوظيفية: Haskell. فهي تستوفي تقريبًا كل الشروط، إذ توفر برمجة وظيفية نقية لا تُعرَّف فيها الآثار إلا عبر مونادة IO. ومع ذلك ما زالت هناك مخارج للهروب (في شكل الدالة unsafePerformIO، وهي غير آمنة بحكم تعريفها). تجرّب Haskell أفكار برمجة مثيرة كثيرة، وهذا نعمة ونقمة معًا: فهي معروفة بامتداداتها العديدة للمترجم، التي تنتج فعليًا نكهات عديدة مختلفة من Haskell. لكن بفضل ذلك كثيرًا ما تُدفع البرمجة الوظيفية إلى آفاق جديدة.
وأخيرًا، هناك مرشح يبدو غير مرجّح: Rust. هل يمكن اعتبار Rust لغة برمجة وظيفية أصلًا؟ كما تبيّن، نعم – فهي تحصل على درجة مرتفعة إلى حد ما في بطاقة التقييم. فإما أن Rust وظيفية حقًا، أو أن بطاقتنا معيبة. لكن لننظر عن كثب: الدوال قيم من الدرجة الأولى؛ والبيانات تُنمذج افتراضيًا بـenum وبنى (= أنواع بيانات جبرية)؛ ومنع الحالة المشتركة القابلة للتغيير من أهداف تصميم Rust الرئيسية. وتصل Rust إلى ذلك بأدوات مختلفة (تتبع الملكية بدلًا من عدم قابلية التغيير)، لكن النتيجة ليست مختلفة كثيرًا. ستصارع أحيانًا مدقق الاستعارة (borrow checker)، لكنك تحصل في المقابل على أداء خام واستخدام أكثر قابلية للتنبؤ للذاكرة.
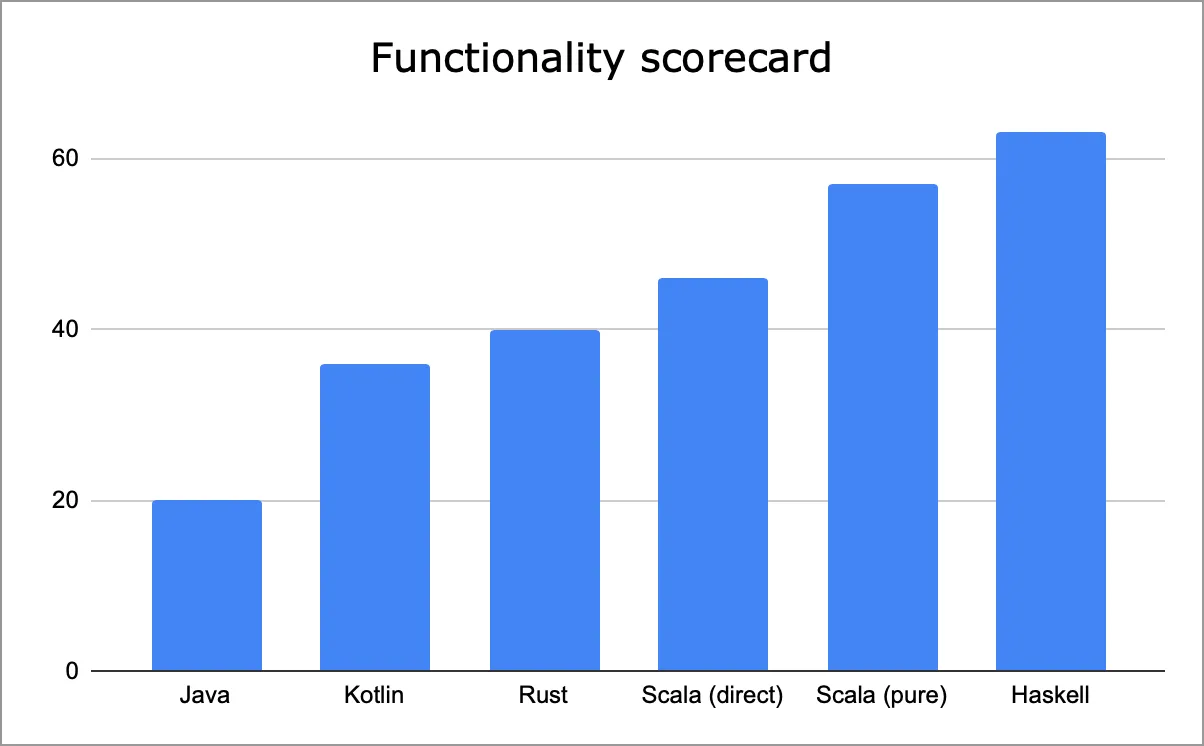
بعض اللغات وظيفية بوضوح: تنتمي إلى هذه الفئة Haskell وScala وF# وOCaml (لاحظ أن كون كل دالة نقية والآثار ممثلة كقيم هو «الافتراضي» في Haskell وحدها). وبعض اللغات ليست وظيفية بوضوح: Java وC# مثالان نموذجيان. ومعظمها يقع في مكان ما في المنتصف، مثل Kotlin وRust. تذكّر أن «مدى وظيفية شيفرتنا» لا ينبغي أن يكون هو الهدف النهائي أبدًا؛ فهي مجرد مجموعة أدوات تتكامل جيدًا لتساعدنا في بناء برمجيات أفضل.
ستمزج معظم شيفرتنا بين الأساليب، وأحيانًا حتى داخل دالة واحدة، وهذا لا بأس به إطلاقًا.
الخاتمة
البرمجة الوظيفية لن تختفي. لم تغزُ العالم، لكن كثيرًا من لغات البرمجة الشائعة اليوم تبنّت بعضًا من أفكارها على الأقل. ومن المفيد التعرف عليها بشكل صحيح وفهم كيفية تطبيق البرمجة الوظيفية عمليًا. وكما أظهرت الأمثلة البرمجية في القسم الأول، فالبرمجة الوظيفية مصطلح أوسع من مجرد البرمجة بدوال نقية.
لقد فحصنا Haskell وRust وScala وJava وKotlin بالتفصيل. لكن هناك أيضًا C# وTypeScript وJavaScript وPython وRuby وغيرها الكثير – ولكل منها بعض الميزات الوظيفية على الأقل، ناهيك عن اللغات الوظيفية أولًا مثل F# أو OCaml. وكلها تُستخدم في الإنتاج كل يوم لتسليم برمجيات تعمل. وتتيح لنا البرمجة الوظيفية فعل ذلك بمزيد من الثقة والكفاءة.
ما يهم في البرمجة الوظيفية هو الأساسيات: صياغة مريحة للتعامل مع الدوال كقيم من الدرجة الأولى، ودوال من رتبة أعلى، وهياكل بيانات غير قابلة للتغيير، وأنواع بيانات جبرية، ومكتبة قياسية وظيفية. ولهذا تكمن معظم قيمة البرمجة الوظيفية في النسخة «غير الصارمة»، التي تجعلها متاحة لجمهور واسع.
إذا كانت لغتك تجعل البرمجة الوظيفية الأسلوب الأكثر راحة وعملية، وتتبناها في اللغة والمكتبة القياسية والمجتمع – فهذا رائع! وإذا لم تفعل، فلا تزال البرمجة الوظيفية قادرة على تقديم قيمة كبيرة.