Ի՞նչ տեսակի AI չաթբոտ է ձեզ հարկավոր
Գտեք AI չաթբոտի լուծումը, որն առավելագույնս համապատասխանում է ձեր կազմակերպության կարիքներին և պահանջներին։
AI չաթբոտը Large Language Model (LLM) է, որն անցել է հրահանգներով կարգավորում։ Այսպիսի չաթբոտը կարող է արագ, ճշգրիտ և համապատասխան պատասխաններ տալ իրեն ուղղված հարցերին։ Սակայն այն սահմանափակված է իր մարզման տվյալներում առկա տեղեկատվությամբ, տեքստի տոնով, ձևաչափով և ոճով։
Retrieval Augmented Generation (RAG-Chatbot) տեխնիկայի միջոցով կարող եք AI չաթբոտը կապել ձեր կազմակերպության ներքին, մասնավոր փաստաթղթերին, որպեսզի այն հարցերին պատասխանի՝ օգտագործելով տրամադրված գիտելիքների բազան։ Օգտատերերը հարցեր են տալիս և ստանում են փաստաթղթերի վրա հիմնված պատասխաններ, թեև մոդելը մարզման ընթացքում երբեք չի հանդիպել դրանց (ձեր ներքին փաստաթղթերը մնում են մասնավոր և ապահով)։ AI-ը ընտրում է ճիշտ փաստաթղթերը օգտատիրոջ հարցման հիման վրա և դրանք որպես համատեքստ կցում է հարցմանը՝ նախքան այն AI չաթբոտին փոխանցելը։
RAG-Chatbot կառուցելու համար պետք է կազմակերպության ողջ փաստաթղթերը վերածել պատշաճ ձևաչափի և կայացնել մի շարք նախագծային որոշումներ։ Նկար 1-ը ցույց է տալիս RAG-Chatbot նախագծելու և տեղակայելու բոլոր հնարավոր տարբերակները։
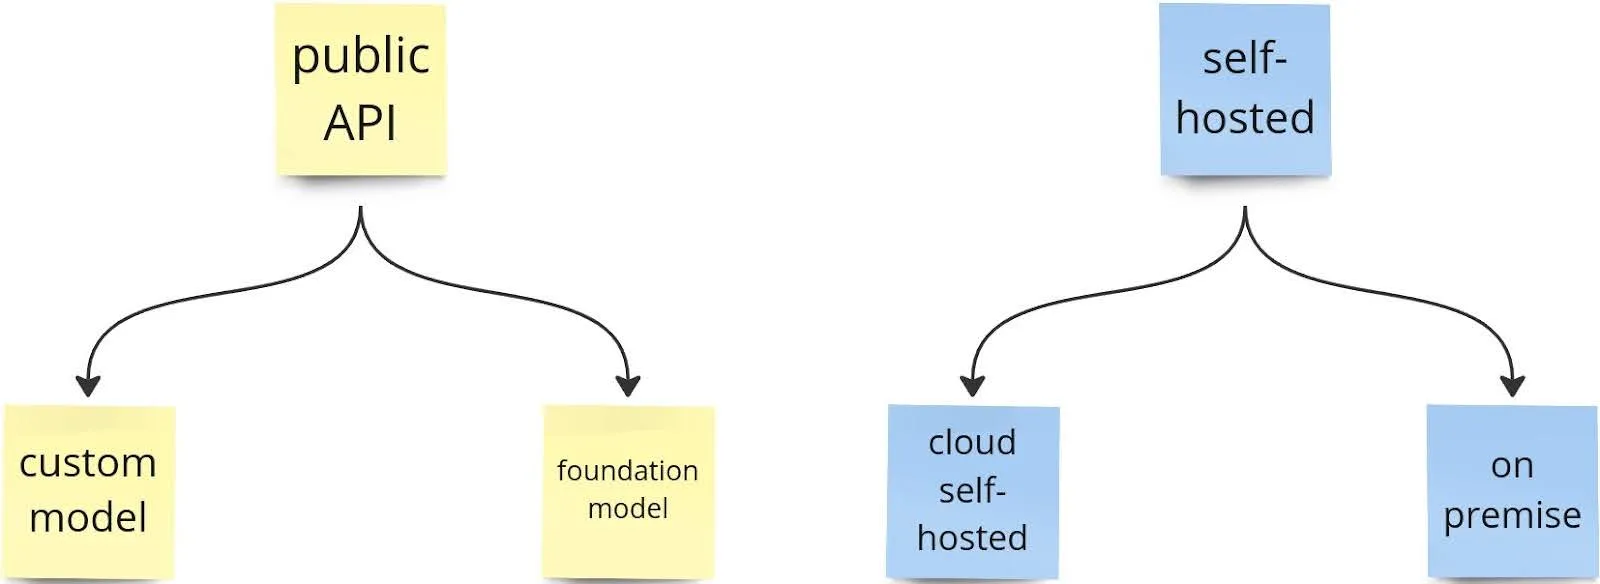
Նկար 1. Ձեր RAG-Chatbot-ի հոսթինգի տարբերակները։
Թե որ լուծումն է ավելի հարմար, կախված է կիրառման դեպքից։ Ստորև ես անցնում եմ յուրաքանչյուր մոտեցմամբ և կշռադատում դրա առավելություններն ու թերությունները։
RAG-Chatbot լուծումներ
Հանրային API (LLM SaaS)
Ամպային API-ների վրա կառուցված լուծումները փայլում են մշակման արագության, Proof-of-Concept-ի վավերացման և ցածր օգտագործման տրաֆիկի դեպքում։ Դրանք նաև ապահովում են մոդելի կանոնավոր թարմացումներ առանց լրացուցիչ ծախսի։ Սակայն դրանք ունեն մի շարք սահմանափակումներ.
- Անհատականացումը սահմանափակ է։
- Շատ բարձր տրաֆիկի դեպքում դրանք ծախսարդյունավետ չեն։
- Դրանք կարող են բավարար անվտանգություն չապահովել խիստ գաղտնի տվյալների համար։
- Foundation model
Շատ դեպքերում սա լավագույն մոտեցումն է։ Այն կարելի է արագ իրականացնել, և այն ողջամտորեն լավ է աշխատում։ Դուք վճարում եք ըստ օգտագործման (յուրաքանչյուր հարցման համար) գումարած փոքր ֆիքսված վճար։ Սա ամենաէժան տարբերակն է, երբ տրաֆիկը անհավասար է (օգտագործման բարձր գագաթներ, համակարգը մեծ մասամբ պարապ է) կամ համեմատաբար ցածր (օրական 10,000-ից պակաս)։ Այն նաև ապահովում է նոր մոդելի տարբերակներին ավտոմատ անցում, այնպես որ պատասխանների որակը ժամանակի ընթացքում բարելավվում է։ Google Cloud-ի Vertex AI-ի կամ AWS-ի Bedrock լուծումների օգտագործումը ապահովում է ձեր տվյալների գաղտնիությունը։ Սա լավագույն եղանակն է ձեր կազմակերպության համար RAG-Chatbot-ի Proof-of-Concept կառուցելու և ստուգելու, թե արդյոք դա ձեզ հարմար լուծում է՝ կամ պարզապես զրուցային չաթբոտ կառուցելու, եթե ձեր տրաֆիկը չափավոր է և ձեզ անհատականացում պետք չէ։
Անհատական մոդել
Այս տարբերակը բնականորեն շարունակում է նախորդը, թեև կարող է ընտրվել նաև որպես վերջնական լուծում հենց սկզբից։ Այն թույլ է տալիս հարմարեցնել (fine-tune) մոդելը հաճախորդների տվյալների վրա և այդպես հասնել RAG-Chatbot-ի էլ ավելի լավ կատարողականության կամ հնարավորությունների, որոնք այլ կերպ անհասանելի կլինեին։ Մոդելի fine-tuning-ը իմաստ ունի, եթե.
- Ուզում եք, որ մոդելը վարվի որոշակի ձևով։
- Ընդօրինակի խոսքի հատուկ տոն։
- Արդյունքը ստեղծի որոշակի ձևաչափով։
- Պետք է օպտիմալացնել մոդելի կատարողականը (իրականացնել RAG առանց գիտելիքների բազայի)։
- Մոդելին ստիպել անել մի բան, որի համար այն չի մարզվել։
- Ամենակարևորը՝ fine-tune արեք մոդելը, երբ prompt-երը և գիտելիքների բազայի տարբերակը արդյունք չեն տալիս։
Անհատական մոդելը բերում է ավելի բարձր ծախսեր։ Տվյալների հավաքածուն պետք է պատրաստել մարզման, վավերացման և թեստավորման համար ճիշտ ձևաչափով։ Մարզման ծախսերը կախված են մոդելի տեսակից, տվյալների հավաքածուի չափից և ենթակառուցվածքի մատակարարից, բայց կոպիտ գնահատականը 1,000 token-ի համար $0.0008 է կամ ~20$/ժ։ LLM fine-tuning-ի ծախսերի մանրամասները հասանելի են այստեղ AWS-ի համար և այստեղ GCP-ի համար։
Մոդելի սպասարկումը ավելացնում է լրացուցիչ ծախսեր։ Ըստ պահանջի գնագոյացումն այլևս չի կիրառվում. անհատական մոդելը ունի ժամային հիմնական վճար՝ ~$7-20/ժ։ Այդ գնով դուք ստանում եք մասնավոր մոդել, որը լիովին ձեր տրամադրության տակ է։
Մոդելի fine-tuning-ը ամպային մատակարարի API-ի միջոցով կրճատում է մշակման ժամանակը, բայց սահմանափակում է օպտիմալացման հնարավորությունները։ Fine-tune կարելի է անել միայն որոշ մոդելներ, և ինժեներները չեն կարող նայել «կափարիչի տակ»՝ մոդելը հետագայում կարգավորելու համար։ Մանրամասն տեղեկատվություն ամպային API-ի միջոցով մոդելների fine-tuning-ի մասին՝ որպես օրինակ օգտագործելով AWS Bedrock-ը և Titan մոդելը, կգտնեք այստեղ։
Ինքնուրույն հոսթինգ
Ինքնուրույն հոսթինգով RAG չաթբոտերի դեպքում մենք լիովին վերահսկում ենք մոդելը և ինֆերենսի փոխակրիչը։ Դրանք տալիս են անհատականացման լայն հնարավորություններ և տվյալների գաղտնիություն, հեշտացնում են և՛ LLM-ի, և՛ embedder մոդելների fine-tuning-ը և թույլ են տալիս կառուցել առաջադեմ որոնման ալգորիթմներ։ Երբ անհատական Rag չաթբոտը կառուցված է, հարցը դառնում է՝ որտե՞ղ այն հոսթ անել։ Կա երկու ընտրություն՝ ամպում կամ տեղում (on-premise)։ Դրանց առավելություններն ու թերությունները ներկայացված են ստորև։
Ամպային ինքնուրույն հոսթինգ
Այս տարբերակը պարզ է սպասարկել, մասշտաբավորվող է և հուսալի, քանի որ ենթակառուցվածքի սպասարկումը կատարում է ամպային մատակարարը։ Մյուս կողմից՝ այն ավելի թանկ է, քան on-premise լուծումները։ Հիմնական կարգավորումը արժե մոտ $1.2/ժ և կարող է հասնել $12/ժ մեկ ինստանսի համար։ Մեկ ինստանսը կարող է սպասարկել օրական մինչև 50 հազար հարցում։
On-premise
On-premise, ինքնուրույն հոսթինգով մոդելը առաջարկում է տվյալների ամենաուժեղ գաղտնիությունը։ Արտաքին API-ներ չեն կանչվում, և բոլոր տվյալները մնում են կազմակերպության ցանցի ներսում։ Ինքնուրույն հոսթինգով մոդելը ձեզ տալիս է RAG չաթբոտի լիակատար վերահսկողություն և թույլ է տալիս ցանկացած անհատականացում։ Շահագործման ծախսերը ցածր են, քանի որ վճարում եք միայն էլեկտրաէներգիայի և սպասարկման համար։ Այս տարբերակի հիմնական թերությունները սպասարկումն ու մասշտաբավորելիությունն են։
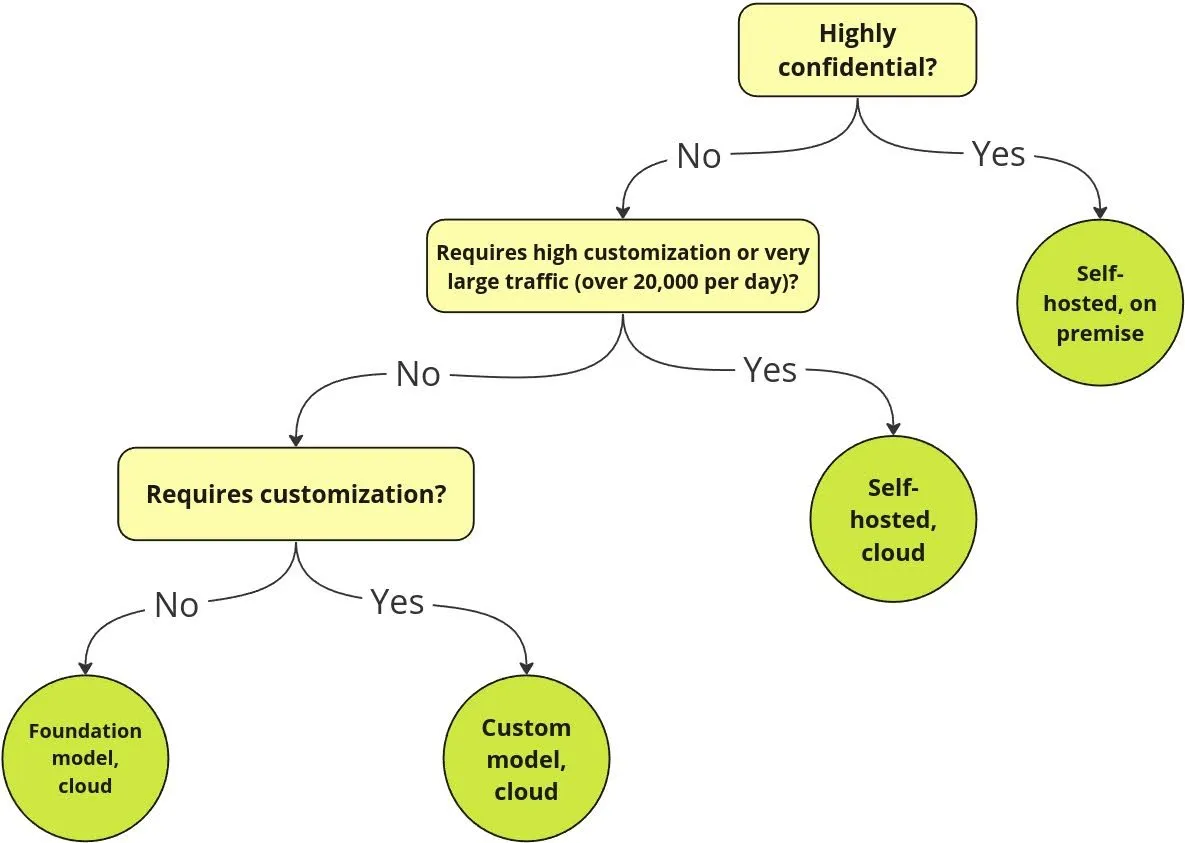
Նկար 2. RAG-Chatbot իրականացնելու որոշումների դիագրամ։
Արդյո՞ք ինձ պետք է անհատական մոդել
Fine-tuning-ը կարող է զգալիորեն բարելավել մոդելի կատարողականը որոշակի խնդիրների վրա։ Երբ fine-tuning-ի ընթացքում մոդելը տեսնում է խնդրին հատուկ տվյալներ, այն սովորում է այդ խնդրի համար ավելի ճշգրիտ կանխատեսումներ անել։ Օրինակ, նախապես մարզված մոդելի fine-tuning-ը բժշկական տեքստերի վրա տալիս է բժշկական լեզուն հասկանալու մասնագիտացած մոդել։ Ոլորտին հատուկ տվյալների վրա fine-tuning-ը թույլ է տալիս մոդելին յուրացնել ոլորտի գիտելիքը՝ ամրապնդելով նրա հասկացողությունն ու գեներացման կարողությունները այդ ոլորտում։ Ընդհանուր առմամբ, fine-tuning-ը թույլ է տալիս հենվել նախապես մարզված մոդելների ուժեղ կողմերի վրա՝ միաժամանակ դրանք հարմարեցնելով ձեր հատուկ կարիքներին, ինչը հանգեցնում է ձեր կոնկրետ խնդիրների համար ավելի լավ կատարողականի և արդյունավետության։
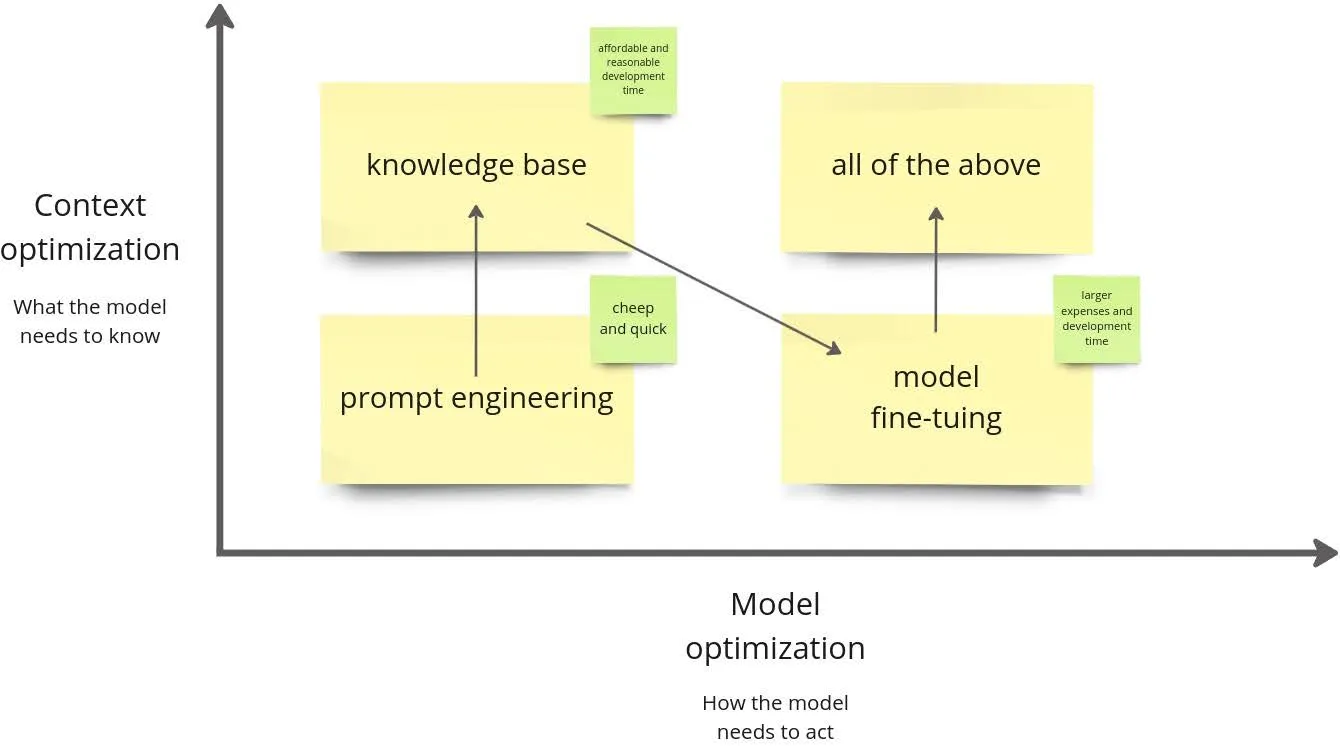
Նկար 3. Մոդելի օպտիմալացման դիագրամ։
Մոդելի fine-tuning-ը պետք է գիտակցված ընտրություն լինի։ Սովորաբար RAG-Chatbot-ի մշակումը հետևում է Նկար 3-ում ցույց տրված ճանապարհին։ Մենք սկսում ենք prompt engineering-ից, ամենահեշտ հասանելի պտղից, դրանից քամում ենք հնարավորինս շատ, ապա անցնում ենք Retrieval Augmented Generation-ին՝ միացված գիտելիքների բազայով։ Այդ փուլում մենք արդեն ստանում ենք լավ որակի պատասխաններ՝ հիմնված մեր կազմակերպության ներքին գիտելիքի վրա։ Այնուհետև կարող ենք ընտրել մոդելի կատարողականն էլ ավելի բարձրացնել՝ այն fine-tune անելով մեր տվյալների վրա և ստանալով իր դասի լավագույն լուծումը։
Prompt engineering-ի սահմանափակումները
Prompt engineering-ը մոդելի անհատականացման միշտ առաջին քայլն է, քանի որ այն էժան է և արագ իրականացվող։ Հաճախ միայն դա բավական է՝ ուրիշ ոչինչ չի պահանջվում։ Դրա թերությունն այն է, որ այն երկարացնում է համատեքստը, ուստի կարող եք հասնել մոդելի համատեքստի սահմանին։ Եթե prompt engineering-ից հետո մոդելի կատարողականը դեռ անբավարար է, մտածեք fine-tuning-ի մասին։ Fine-tuning-ը հատկապես արդյունավետ է ոճն ու տոնը վերարտադրելու համար։ Սակայն այն պահանջում է շատ ավելի աշխատանք, քանի որ պետք է տվյալների հավաքածուն պատրաստել ճիշտ ձևաչափով և մոդելը մարզել ոչ էժան սարքավորումների վրա։
Շահագործման ծախսերի համեմատություն
Աղյուսակ 1-ը ցույց է տալիս գնահատված ծախսերն ու կատարողականը յուրաքանչյուր տեղակայման եղանակի համար։
Աղյուսակ 1. Շահագործման ծախսերի և կատարողականի համեմատություն 4 տարբեր տեղակայման տարբերակների միջև։
AWS-ի գները՝ https://aws.amazon.com/bedrock/pricing/
GCP-ի գները՝ https://cloud.google.com/vertex-ai/pricing#custom-trained_models
Տվյալների գաղտնիություն
Ձեր տվյալների գաղտնիության աստիճանը կախված է ձեր օգտագործած ծառայություններից և ամպային մատակարարից։ Այդ պատճառով ցանկացած ամպային մատակարարի API-ն օգտագործելուց առաջ պետք է ուշադիր կարդալ համաձայնագրի պայմանները։ Ստորև ներկայացված է ներկա իրավիճակը երեք առաջատար ամպային լուծումների մատակարարների մոտ։
Google Cloud
- Gemini API կանչերում ուղարկված տվյալները կարող են օգտագործվել մարզման համար և կարող են դիտվել մարդ գնահատողների կողմից, ուստի այդ ծառայությանը մի ուղարկեք զգայուն, գաղտնի կամ անձնական տեղեկատվություն։ Gemini API-ի ծառայության պայմանները VertexAI-ից դուրս հասանելի են այստեղ
- VertexAI-ի շրջանակներում, որը նախատեսված է ձեռնարկության մակարդակի աջակցության համար, դուք օգտագործում եք Vertex AI Gemini API-ը, որի ծառայության պայմանները արգելում են ձեր տվյալները նոր foundation model-ներ մարզելու համար օգտագործելը։
AWS
- Bedrock-ի ծառայության պայմանները նշում են, որ Titan մոդելի մուտքն ու ելքը չեն օգտագործվում foundation model-ներ մարզելու համար։
- «AWS Chatbot-ը լռելյայն պահպանում և մշակում է օգտատիրոջ տվյալները, ներառյալ AWS Chatbot-ի կոնֆիգուրացիաները, ծանուցումները, օգտատիրոջ մուտքերը, AWS Chatbot-ի ստեղծած պատասխանները և փոխազդեցության տվյալները։ AWS Chatbot-ը օգտագործում է այս տվյալները՝ շարունակաբար բարելավելու և զարգացնելու իրեն, ինչպես նաև Արհեստական բանականության (AI) տեխնոլոգիաները»։ (աղբյուր)։
Azure
- Azure OpenAI-ը ո՛չ պահպանում է, ո՛չ օգտագործում է ձեր տվյալները։ (աղբյուր)
- OpenAI-ը կարող է օգտագործել ձեր տվյալները նոր մոդելներ մարզելու համար։ (աղբյուր)
Ամփոփելու համար՝ ձեռնարկության մակարդակի լուծումները չեն օգտագործում մուտքի/ելքի տվյալները, մինչդեռ հանրային API-ները մուտքի տվյալներն օգտագործում են մոդելներ մարզելու և AI-ը բարելավելու համար։ Նկատի ունեցեք նաև, որ վերը նշված բոլոր գաղտնիության քաղաքականությունները միշտ ենթակա են տեղական օրենսդրության։ Ընկերությունները պետք է հանձնեն իրենց տվյալները, երբ դա պահանջում է օրենքը կամ կառավարական մարմնի պարտադիր կարգադրությունը։
Ամփոփում
Աղյուսակ 2. Ամպային API-ի և ինքնուրույն հոսթինգով RAG-Chatbot-ի առավելություններն ու թերությունները։
Մեր ընկերությունում մենք կառուցում ենք լուծումներ, որոնք հարմարեցված են մեր հաճախորդների կարիքներին։ Անկախ այն բանից՝ ուզում եք ձեր RAG-Chatbot-ը արագ ստանալ, սպասում եք ցածր տրաֆիկի, թե պետք է ձեր տվյալներից առավելագույնը քամող անհատական լուծում, մենք կարող ենք այն կառուցել։ Մենք գործընկերություններ ունենք առաջատար ամպային մատակարարների հետ և կարող ենք առաջարկել անվճար զեղչեր ու կրեդիտներ ձեր նախագիծը մեկնարկելու համար։ Եթե հարցեր ունեք, մի հապաղեք կապ հաստատել – մենք սիրով կօգնենք։