Հերթերը Kafka-ում՝ այսօր և վաղը
Տեսեք, թե ինչպես է KMQ պատերնը թույլ տալիս Kafka-ում արդեն այսօր իրականացնել հերթերի որոշ հնարավորություններ։
Kafka-ն հաղորդագրությունների և ստրիմինգի առաջատար հարթակն է և մեծ ծավալի տվյալների տեղափոխման դե ֆակտո ստանդարտը։ Նրա հիմնական աբստրակցիան topic-ն է, որը բաժանվում է partition-ների։ Այս բաժանման շնորհիվ Kafka-ի topic-ները շատ լավ են մասշտաբավորվում, և միակ սահմանափակումը partition-ների քանակն է։
Topic-ները կարելի է կարդալ publish-subscribe ձևով, այսինքն՝ յուրաքանչյուր կլիենտ ստանում է topic-ում հրապարակված յուրաքանչյուր հաղորդագրություն։ Այսպիսի հեռարձակման սցենարները իրենց կիրառությունն ունեն, բայց ավելի հաճախ մենք ուզում ենք, որ կլիենտների խումբը հաղորդագրությունները սպառի համագործակցաբար, այնպես որ յուրաքանչյուր բաժանորդագրված կլիենտ ստանա հաղորդագրությունների եզակի ենթաբազմություն։ JMS-ի տերմիններով՝ մենք ուզում ենք, որ Kafka-ն աշխատի որպես queue, այլ ոչ թե որպես topic։
Սա հնարավոր է consumer groups-ի միջոցով. խմբի ներսում յուրաքանչյուր consumer-ին տրվում է partition-ների մի հավաքածու, որտեղից նա կարդում է հաղորդագրությունները։ Consumer group coordinator-ը ապահովում է, որ յուրաքանչյուր partition վերագրված լինի ինչ-որ կլիենտի և որ ոչ մի partition չվերագրվի երկու կլիենտի։
Տարիների ընթացքում այս մոտեցումն իրեն արդարացրել է։ Այնուամենայնիվ, այն չի ծածկում օգտագործման բոլոր դեպքերը, այդ իսկ պատճառով ընթացքի մեջ է KIP (Kafka Improvement Process)՝ Kafka-ին հերթերի ավելի շատ հնարավորություններ ավելացնելու համար. KIP-932: Queues for Kafka։
Սկսենք նրանից, թե ինչ են առաջարկում consumer groups-ը և որտեղ են թերանում։ Այնուհետև կանցնենք KIP-932-ի առաջարկած նոր հնարավորություններին։ Վերջում կցուցադրենք, թե ինչպես կարելի է հերթերի որոշ հնարավորություններ արդեն այսօր իրականացնել Kafka-ում KMQ պատերնով։
Եթե consumer groups-ը գիտեք մինչև վերջ, կարող եք բաց թողնել հաջորդ բաժինը և անմիջապես անցնել share groups-ին։
Consumer groups
Consumer groups-ը Kafka-ի մանրակրկիտ ուսումնասիրված և փաստաթղթավորված հնարավորություն է, ուստի կտանք միայն համառոտ ակնարկ այն մասին, թե ինչպես են դրանք վարվում և ինչն է սահմանափակում դրանք։
Սկզբում նկատենք, որ մեկ topic-ը կարող է ունենալ բազմաթիվ consumer groups, որոնցից յուրաքանչյուրը տվյալները սպառում է անկախ։ Սա վերաբերում է այս հոդվածում դիտարկվող բոլոր մոտեցումներին. պարզության համար մենք միշտ կկենտրոնանանք այն բանի վրա, թե ինչպես է մեկ consumer/share group փոխազդում մեկ topic-ի հետ (որը սովորաբար ունի բազմաթիվ partition-ներ)։
Partition-ների վերագրումը
Ինչպես վերևում նշվեց, consumer group-ին պատկանող յուրաքանչյուր consumer ստանում է partition-ների իր եզակի հավաքածուն, որտեղից կարդում է տվյալները, և այդ partition-ներին ունի բացառիկ հասանելիություն։
Սա բացահայտում է առաջին սահմանափակումը. consumer group-ի անդամների քանակը սահմանափակված է partition-ների քանակով։ Partition-ներից ավելի շատ անդամներ ունենալն անիմաստ է, քանի որ որոշ անդամներ կմնան առանց partition-ի, որտեղից կարդային։ Թեև գոյություն ունեցող topic-ի partition-ների քանակը հնարավոր է փոխել, դա խանգարող է և ազդում է տվյալների բաշխման վրա։ Ուստի լավագույնն է նախապես պլանավորել, ինչը երբեք հեշտ չէ։
Երբ consumer group-ին միանում է նոր անդամ, խումբը վերաբալանսավորվում է (rebalance)։ Լռելյայն ալգորիթմը ձգտում է յուրաքանչյուր անդամին տալ մոտավորապես նույն քանակի partition-ներ։ Այդուհանդերձ, նման rebalance-ը խանգարող է, թեև Kafka-ի վերջին տարբերակները այն կատարում են իտերատիվ կերպով։ Եթե partition-ը, որը պատկանում էր A անդամին, այժմ պետք է սպառվի նոր B անդամի կողմից, նախ պետք է համոզվենք, որ A-ն դադարեցնում է դրանից կարդալը և ավարտում է իր մշակումը. միայն դրանից հետո B-ն կարող է վերցնել այն։ Այս գործընթացը հայտնի է որպես fencing։
Հաղորդագրությունների մշակումը
Ինչ վերաբերում է հենց մշակմանը, յուրաքանչյուր անդամ իրեն վերագրված topic-ներից հաղորդագրությունները բերում է այն կարգով, որով դրանք գտնվում են partition-ների վրա։ Այսպիսով, սպառումը մասնակիորեն կարգավորված է. եթե M1 և M2 հաղորդագրությունները նույն partition-ում են, և M1-ը այդ partition-ի լոգում ավելի վաղ է, անդամը կստանա M1-ը M2-ից առաջ։ Սակայն partition-ների միջև ստացված հաղորդագրությունների կարգի վերաբերյալ երաշխիք չկա։
Հաղորդագրությունները մշակվելուց հետո դրանց offset-ը կարելի է commit անել Kafka-ում, որպեսզի սպառումը վերսկսվելիս (վթարի կամ rebalance-ի պատճառով) առաքումը շարունակվի դեռ չմշակված (չ-commit արված) հաղորդագրություններից։ Commit-ը հանգում է հատուկ __consumer_offsets topic-ում գրելուն, որն ինքն էլ բաժանված է Kafka-ի broker-ների վրա։
Սակայն consumer group-ում հաղորդագրությունները կարելի է commit անել միայն մինչև որևէ offset. մենք կարող ենք պնդել միայն, որ տրված offset-ից ցածր offset ունեցող յուրաքանչյուր հաղորդագրություն համարվում է commit արված։ Այս լուծումը պարզ է և արագ, բայց սահմանափակ. հաղորդագրությունները չի կարելի հաստատել մեկ-մեկ, այլ միայն խմբաքանակներով՝ մինչև որևէ offset։
Իհարկե, կարելի է հաղորդագրությունները մշակել առանձին և յուրաքանչյուր offset commit անել՝ նախքան հաջորդ հաղորդագրությանն անցնելը։ Սակայն դրա արդյունավետության գինը խիստ և լայնածավալ կլինի, ուստի այս մոտեցումը Kafka-ի հետ շատ հազվադեպ է համադրվում (եթե ընդհանրապես համադրվում է)։ Այն պարզապես հակասում է նրան, թե ինչպես են նախագծված consumer groups-ը և offset commit մեխանիզմը։
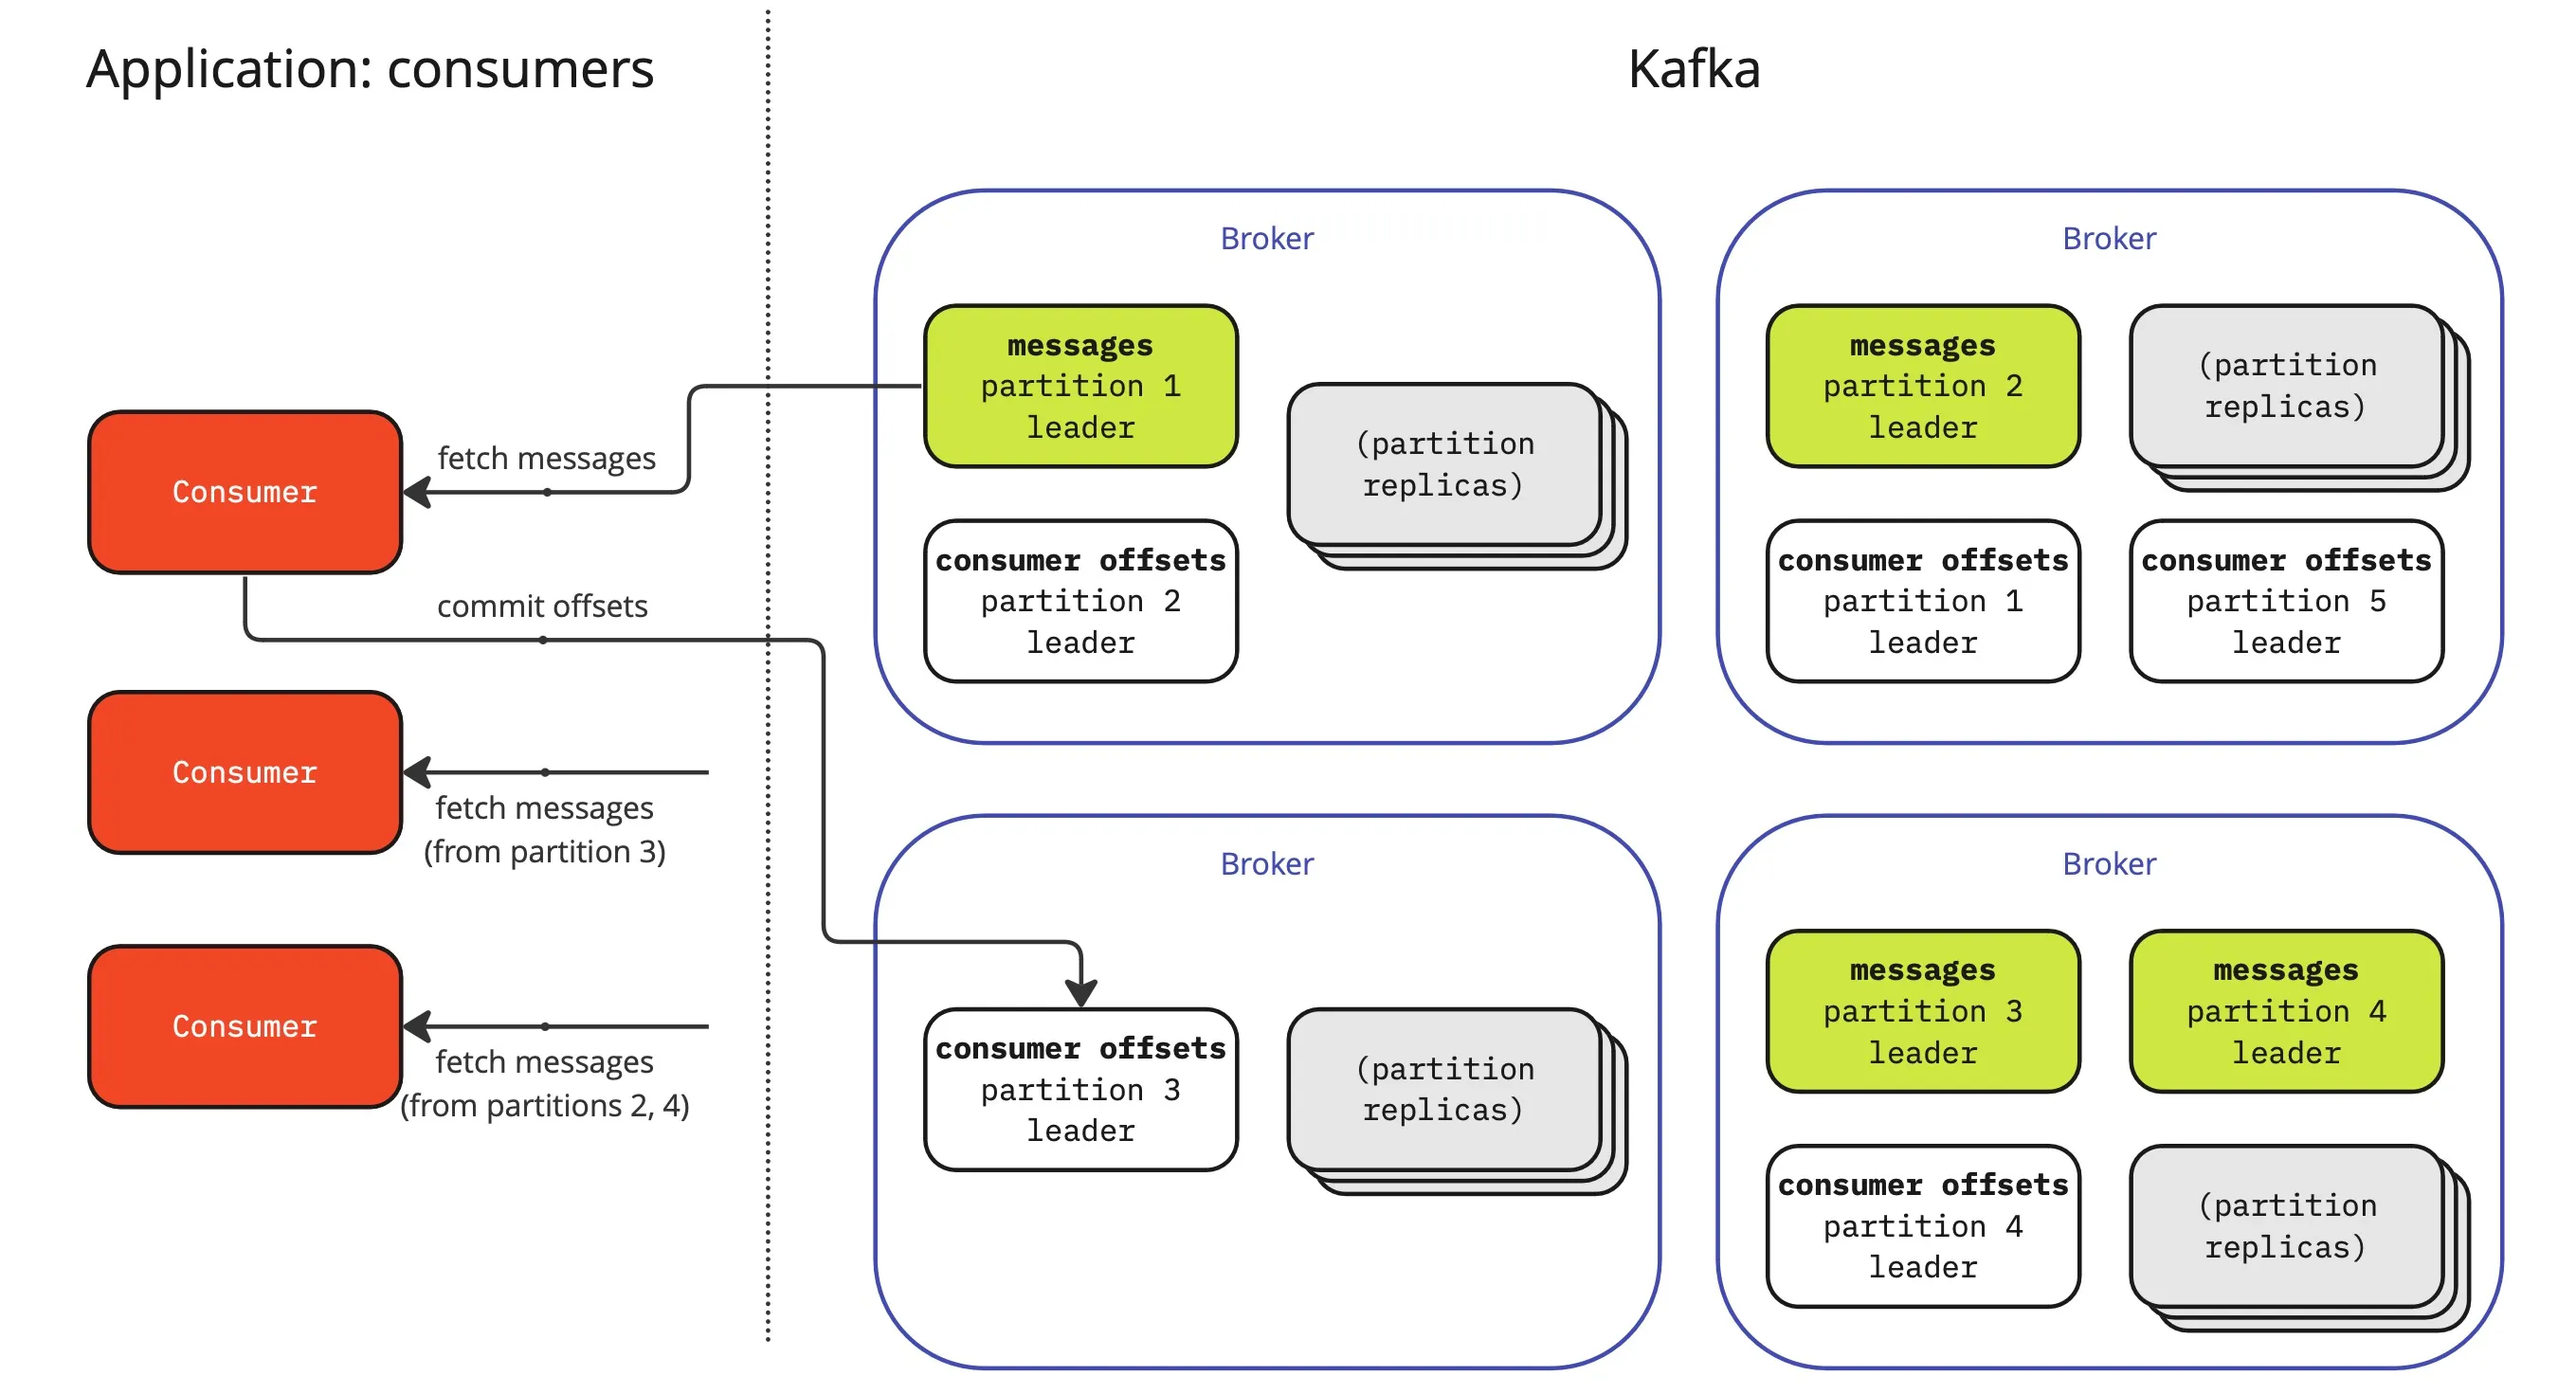
Այլ բնութագրեր
Կարելի չէ նաև պահանջել մեկ հաղորդագրության կրկնակի առաքում կամ հաղորդագրությունը նշել որպես անմշակելի։ Սպառման այն ձևը, որը աջակցում են consumer groups-ը, կարող է նաև խնդիրներ առաջացնել, երբ հաղորդագրությունների մշակման ժամանակը խիստ տարբեր է։ Սա կոչվում է head-of-line blocking։ Մեկ հաղորդագրություն, որի մշակումը շատ ավելի երկար է տևում, քան մնացածինը, կարող է արգելակել այդ partition-ի բոլոր հաջորդ հաղորդագրությունները. սովորական consumer հոսքում մենք նախ բերում ենք հաղորդագրությունների խմբաքանակը, հետո մշակում ենք դրանք (հնարավոր է՝ զուգահեռ) և վերջում commit ենք անում դրանց offset-ները, երբ բոլորը մշակված են։
Receive-process-commit offsets ալգորիթմին հետևելը մեզ տալիս է at-least-once առաքման սեմանտիկա. գործընթացը կարող է վթարվել մշակման և offset-ների commit-ի միջև։ Եթե դա տեղի ունենա, այն հաղորդագրությունները, որոնց offset-ները commit չեն արվել, partition-ի վերավերագրումից հետո կրկին կառաքվեն և կմշակվեն։
Այդ հոսքում քայլերը փոխելը՝ receive-commit offsets-process, մեզ փոխարենը տալիս է at-most-one։
Արդյունավետության տեսանկյունից consumer groups-ին դժվար է հաղթել. հաղորդագրությունները բերվում են խմբաքանակներով, և offset-ները նույնպես commit են արվում խմբաքանակներով, հնարավոր է՝ հետնաբեմում։
Consumer Groups-ի ամփոփում
- consumer group-ի յուրաքանչյուր անդամ ստանում է partition-ների բացառիկ հավաքածու, որտեղից կարդում է տվյալները
- consumer-ների քանակը, հետևաբար և տվյալների մշակման զուգահեռականության աստիճանը, սահմանափակված է partition-ների քանակով
- consumer-ների ստացած հաղորդագրությունները մասնակիորեն կարգավորված են յուրաքանչյուր վերագրված partition-ի ներսում
- հաղորդագրությունները կարելի է commit անել միայն «բոլորը մինչև որևէ offset»՝ խմբաքանակներով
- անհատական հաստատումը և հաղորդագրության կրկնակի առաքումը հնարավոր չեն
- երբ հաղորդագրությունների մշակման ժամանակը տարբեր է, head-of-line blocking-ը կարող է ազդել partition-ի ներսում հաղորդագրությունների մշակման latency-ի վրա
- հաղորդագրությունները մշակվում են at-least-once կամ at-most-once սեմանտիկայով
- կապի ծախսը շատ ցածր է. offset-ները պետք է commit արվեն միայն ժամանակ առ ժամանակ
- արդյունավետությունը շատ բարձր է
Queues for Kafka՝ share groups
Վերը նկարագրված consumer-group սահմանափակումներից մի քանիսը վերացնելու համար KIP-932: Queues For Kafka-ը առաջարկում է Kafka-ին ավելացնել share group աբստրակցիա։ Share groups-ը, ինչպես consumer groups-ը, հնարավորություն են տալիս Kafka topic-ի հաղորդագրությունները սպառել համագործակցաբար։ Սակայն կան մի քանի էական տարբերություններ։
Partition-ների վերագրումը
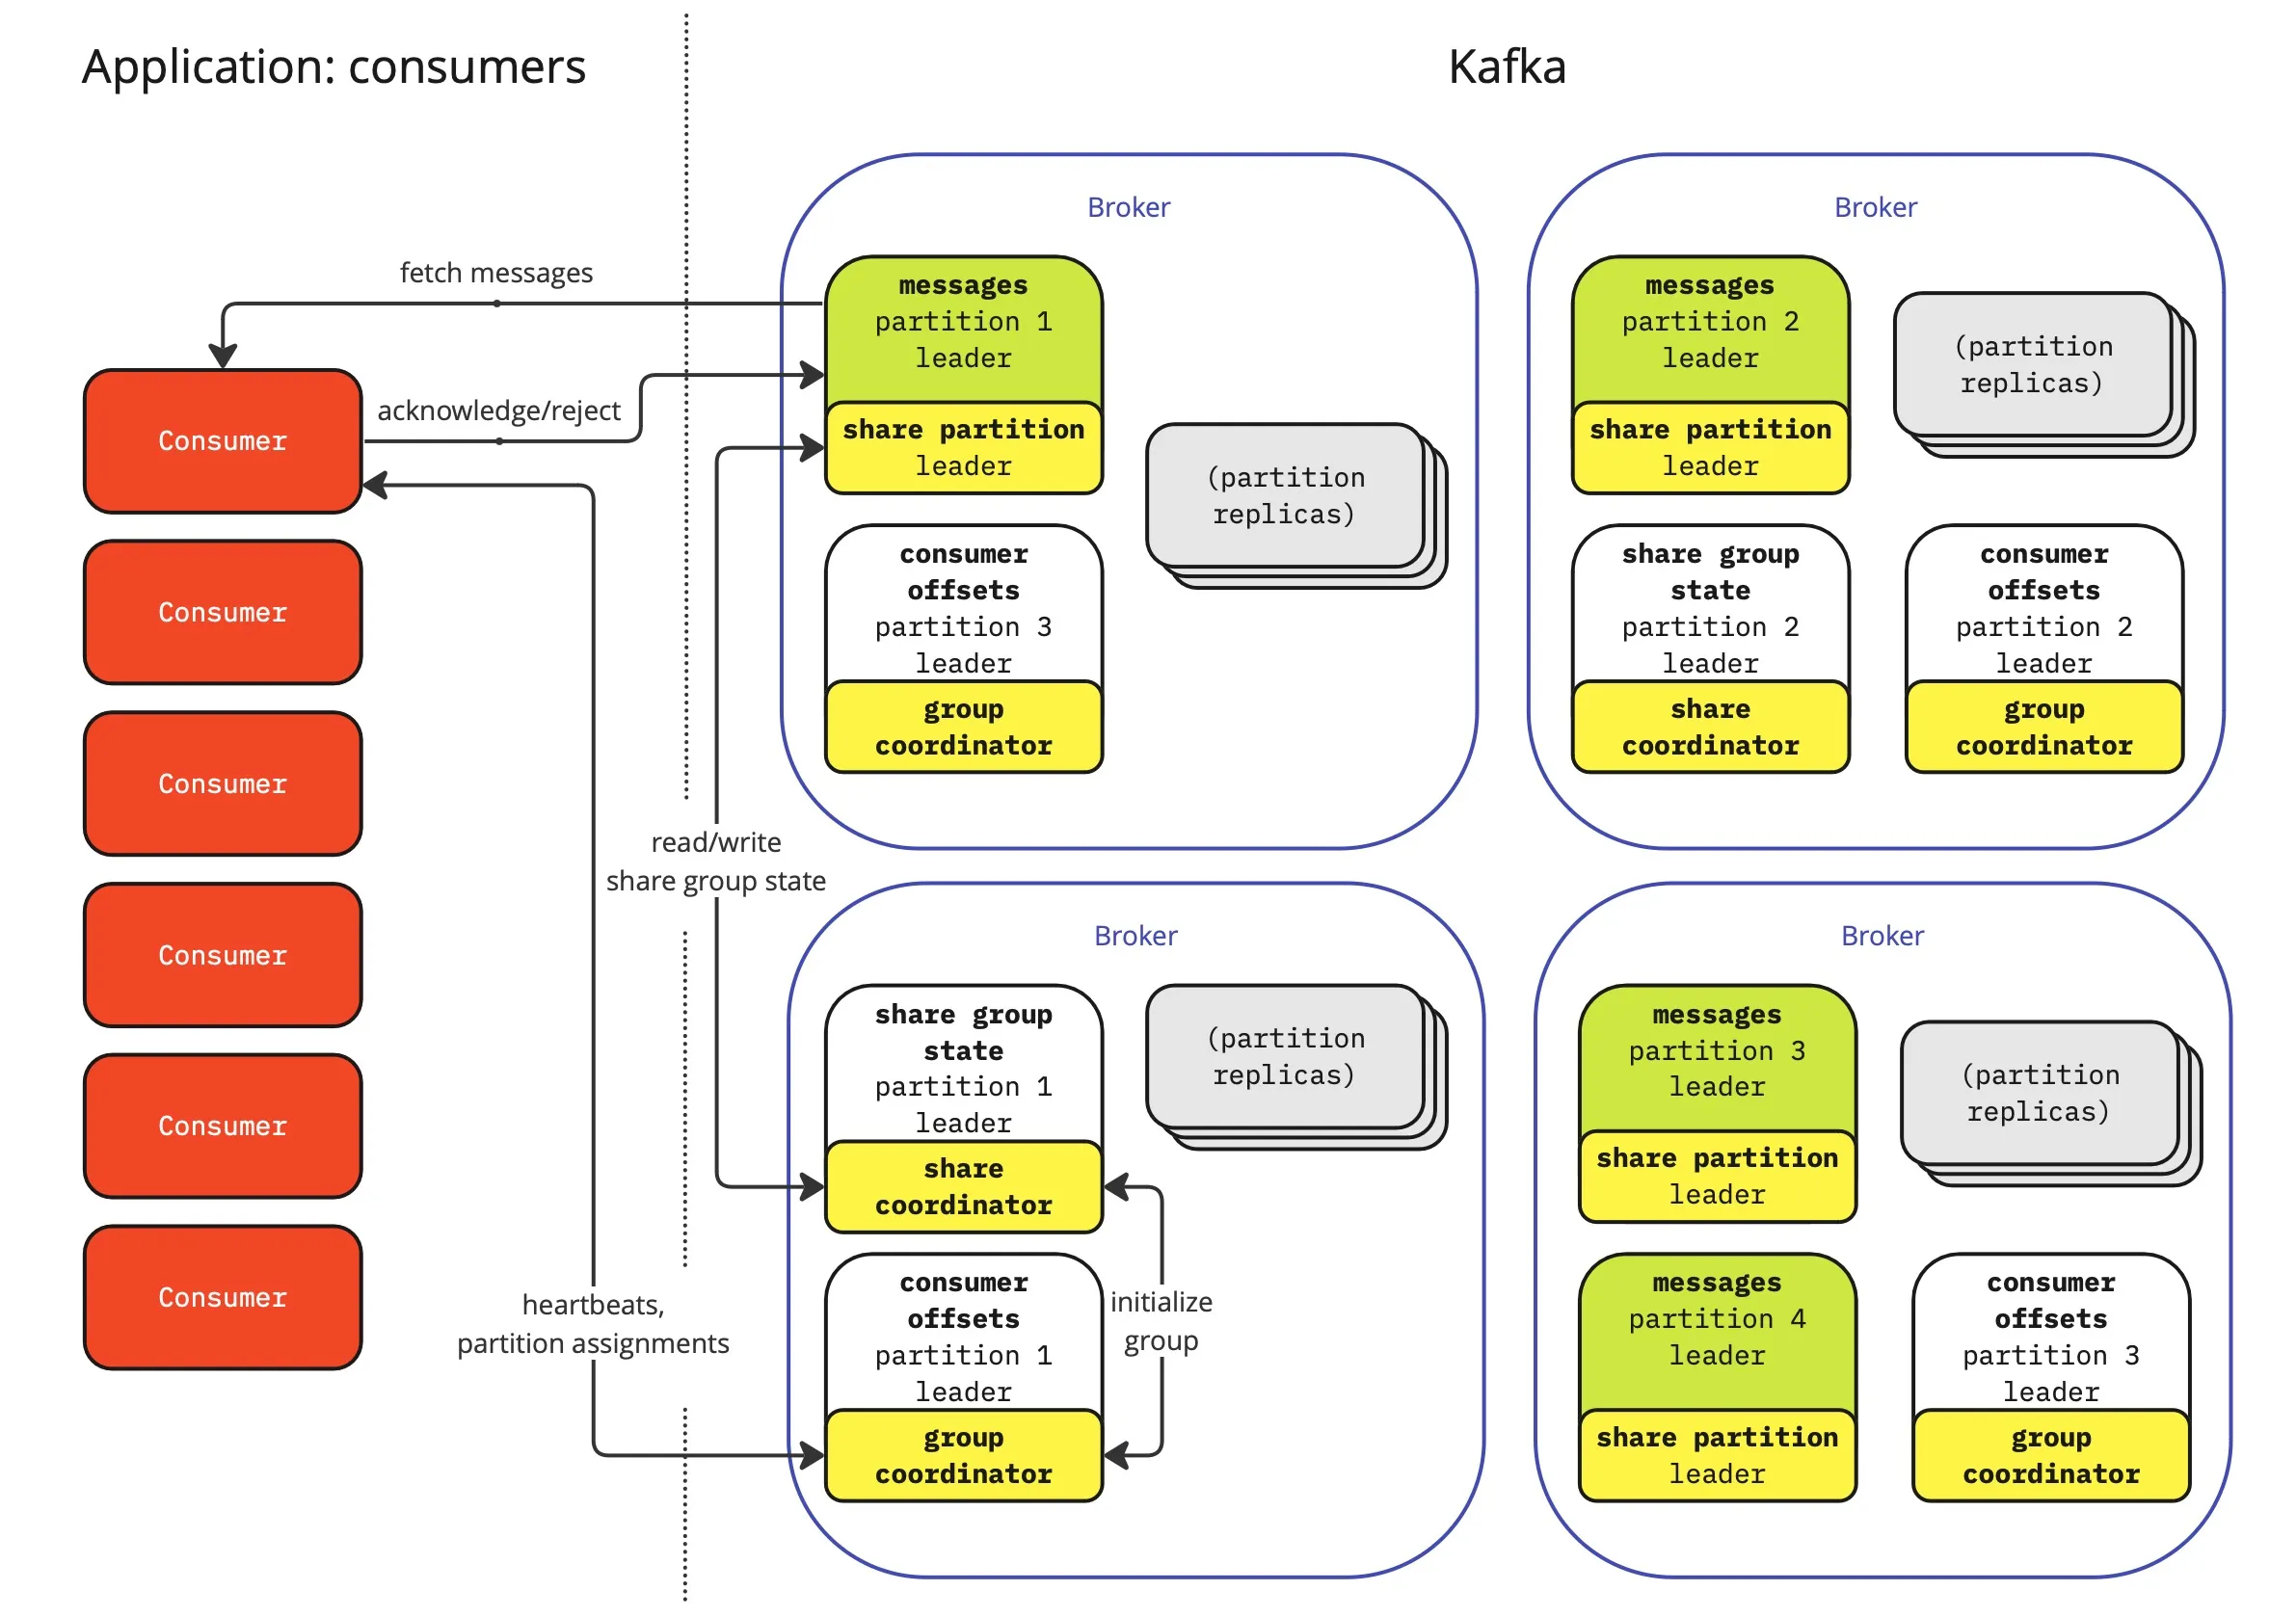
Երբ անդամը միանում է share group-ին, նրան վերագրվում է մի շարք share-partition-ներ, որտեղից նա կարող է բերել հաղորդագրություններ մշակման համար։ Consumer groups-ի հակառակ՝ այս վերագրումը բացառիկ չէ. շատ անդամներ կարող են վերագրվել նույն partition-ին և նրանից տվյալներ սպառել։ Սա վերացնում է partition-ների քանակի դրած սահմանը խմբի անդամների քանակի վրա։ Միևնույն ժամանակ այն բերում է շատ ավելի դժվար խնդիր. ապահովել, որ յուրաքանչյուր անդամ մշակման համար ստանա տարբեր հաղորդագրություններ։
Նախքան դրան անցնելը, ավելի մանրամասն տեսնենք, թե ինչպես է անդամը միանում share group-ին։ Նոր միացող անդամը heartbeat է ուղարկում խմբի coordinator-ին, որը գտնվում է broker-ներից մեկի վրա՝ consumer offsets topic-ի partition-ի leader-ի վրա։ Այդ broker-ը գործարկում է partition-ների վերագրման ալգորիթմը, և heartbeat-ի պատասխանում անդամը ստանում է այն share-partition-ները, որոնցից պետք է կարդա։ Վերագրումները կարող են փոխվել, և մյուս անդամները իմանում են, թե որ partition-ներ են իրենց ավելացվել կամ հանվել, իրենց հաջորդ heartbeat-ների միջոցով։
Fencing-ը պետք չէ, քանի որ մի քանի անդամ կարող են հաղորդագրություններ սպառել մեկ partition-ից։ Այնպես որ, եթե կարճ ժամանակով partition-ը սպառում են ավելի շատ անդամներ, քան նախատեսել էր վերագրման ալգորիթմը, դա նշանակություն չունի։ Սա պարզեցնում է rebalancing-ը՝ առանց «stop the world» fencing իրադարձությունների։
Հաղորդագրությունների մշակումը
Այս պահին խմբի coordinator-ի գործն ավարտված է։ Այնուհետև անդամները fetch-messages հարցում են ուղարկում իրենց վերագրված յուրաքանչյուր share-partition-ին։ Յուրաքանչյուր share-partition հետևում է իր պարունակած հաղորդագրությունների վիճակին. հաղորդագրությունը կարող է լինել.
- available սպառման համար
- acquired, բայց դեռ չհաստատված (այլ կերպ՝ այժմ մշակվում է)
- acknowledged
- rejected
Անդամից նոր fetch-messages հարցում ստանալիս share-partition-ը ստուգում է իր ներքին վիճակը և որոշում, թե որ հաղորդագրությունները առաքի։ Որտեղ հնարավոր է, share-partition-ը փորձում է հաղորդագրությունները առաքել խմբաքանակներով, որպեսզի հաստատումները նույնպես կարողանան խմբաքանակով լինել (փոխանցելով offset-ների միջակայքեր, այլ ոչ թե առանձին offset-ներ)։ Սա, բնականաբար, շատ կարևոր է արդյունավետության համար։
Սպառման համար հասանելի հաղորդագրություններից share-partition-ը ընտրում է խմբաքանակ և նշում այն որպես acquired։ Այնուհետև այդ հաղորդագրությունները տրվում են անդամին մշակման համար և որոշակի ժամանակահատվածով մնում են acquired վիճակում։ Եթե այն լրանալուց առաջ դրանք չեն նշվում որպես մշակված, վերադառնում են available վիճակի։ Մոդելը նման է, օրինակ, SQS-ին կամ GCP-ի Pub/Sub-ին, որտեղ հաղորդագրությունների մշակումը պետք է հաստատվի տրված ժամանակային պատուհանում, հակառակ դեպքում հաղորդագրությունները կրկին առաքվում են։
Այլ բնութագրեր
Յուրաքանչյուր հաղորդագրության (կամ հաղորդագրությունների միջակայքի) կցված է առաքման հաշվիչ։ Հաշվիչը մեծանում է ամեն անգամ, երբ հաղորդագրության acquisition-ը ժամկետանց է դառնում կամ անդամը բացահայտ release է անում հաղորդագրությունը (ազդանշանելով, որ այն պետք է կրկին առաքվի)։ Երբ առաքման փորձերի քանակը անցնում է սահմանված շեմը, հաղորդագրությունը դառնում է rejected, և առաքման հետագա փորձ չի արվում։ DLQ չկա՝ գոնե առայժմ, թեև այն հիշատակվում է որպես հնարավոր ապագա լրացում։ Նաև առաքման հաշվիչը պետք է դիտարկվի միայն որպես մոտավորություն, քանի որ broker-ների խափանումները կարող են պատճառ դառնալ, որ այն տարբերվի առաքման և մշակման փորձերի իրական քանակից։
Kafka-ի share group իրականացումը սահմանափակում է և՛ հաղորդագրության մշակման տևողությունը (ինչպես բացատրված է վերևում), և՛ թռիչքի մեջ գտնվող (in flight) հաղորդագրությունների քանակը, այսինքն՝ առաքման համար հասանելի դարձվածների։ Սա կառավարվում է share partition-ի սկզբի և վերջի offset-ներով (SPSO և SPEO)։ Հաղորդագրությունների վիճակներից (acknowledged/ rejected/ delivery count) բացի, SPSO-ն նույնպես մաս է կազմում share partition-ի վիճակի։
Քանի որ շատ consumer-ներ կարող են հաղորդագրություններ ստանալ ցանկացած partition-ից և հաղորդագրությունները կարելի է հաստատել մեկ-մեկ, կարգի վերաբերյալ որևէ երաշխիք չկա։ Երբ fetch հարցում է գալիս, ցանկացած հասանելի հաղորդագրություն կարող է տրվել consumer-ին։ Բացեր կարող են առաջանալ, քանի որ որոշ հաղորդագրություններ կրկին են առաքվում կամ արդեն հաստատվել են. բացի այդ, տարբեր consumer-ներ ստանում են հասանելի հաղորդագրությունների տարբեր խմբաքանակներ։
Coordinator-ներ և պահպանում
Share partition-ի վիճակը պետք է պահպանվի, որպեսզի դիմանա broker-ների վթարներին։ Սա տեղի է ունենում առանձին topic-ում և կառավարվում է share coordinator-ի կողմից։ Ինչպես group coordinator-ի պարտականությունները բաշխված են broker-ների միջև, այնպես էլ share coordinator-ի պարտականություններն են բաշխված։ Share coordinator-ը հաղորդագրությունների վիճակները և խմբի epoch-ները պահպանում է առանձին, խիստ partition-ավորված topic-ում։ Այն աշխատում է __share_group_state topic-ի այն partition-ի leader-ի կողքին, որը պահում է տվյալ share-partition-ի տվյալները։ Թե որ broker-ն է դա, կարելի է գտնել coordinator-ների տեղորոշման համար նախատեսված Kafka-ի արձանագրությամբ (նույն մեխանիզմը ծառայում է consumer group-ի նոր իրականացմանը, group coordinator-ներին և share coordinator-ներին)։ Այս մասին ավելին կարող եք կարդալ KIP-848: Next Generation of Consumer Rebalance Protocol-ում։
__share_group_state topic-ում պահպանվող վիճակը միտումնավոր ընտրված է և նվազագույն։ Նախ՝ հաղորդագրության acquisition-ը չի պահպանվում. միայն երբ հաղորդագրությունները հաստատվում կամ մերժվում են, դա մտնում է պահպանվող վիճակի մեջ։ Սա նվազեցնում է broker-ների միջև երթևեկությունը, ինչպես նաև պահպանվող տվյալների ծավալը։ Մյուս կողմից, եթե broker-ը վթարվի, որոշ հաղորդագրություններ կարող են կրկին առաքվել, թեև դրանց acquisition ժամանակային պատուհանը դեռ չի լրացել։ Consumer groups-ը կարող են նույն կերպ վարվել. հաղորդագրությունները «acquired» են, երբ առաքվում են consumer-ին, և offset-ները պահպանվում են միայն հաղորդագրությունների հաստատումից հետո։ Թեև քիչ հավանական է, երկու consumer-ներ կարող են միաժամանակ մշակել նույն հաղորդագրությունները։
Share group-ի վերագրումները նույնպես չեն պահպանվում. պահպանվում են միայն epoch-ները, որոնք պաշտպանում են զոմբի group coordinator-ներից և թույլ են տալիս անդամներին ստուգել՝ իրենց ստացած վերագրումները արդիական են արդյոք։ Այս օպտիմալացումները նախատեսված են __share_group_state topic-ում պահվող տվյալների ծավալը կրճատելու համար։
Յուրաքանչյուր share coordinator պահում է իր պահած share-partition-ների վիճակի հիշողության մեջ գտնվող պատկերը և ժամանակ առ ժամանակ snapshot-ներ է գրում հիմքի պահոցում։ Երբ բոլոր share-partition-ների snapshot-ները պահպանվել են, ավելի վաղ վիճակի թարմացումները կարելի է հեռացնել. այս compaction-ը նույնպես կառավարվում է share coordinator-ի տրամաբանությամբ։
Share groups-ի ամփոփում
Ամփոփելով՝ Queues for Kafka KIP-ը մտցնում է նոր հասկացություն՝ share groups, որոնք թույլ են տալիս ցանկացած քանակի consumer-ների հաղորդագրությունները սպառել համագործակցաբար։ Երեք նոր stateful բաղադրիչ աշխատում են բաշխված ձևով Kafka-ի broker-ների վրա՝ group coordinator-ը, share coordinator-ը և share-partition-ները։ Դրանք միասին պահում են հիշողության մեջ պատկերներ յուրաքանչյուր share-partition-ի վիճակի (որ հաղորդագրությունները կարող են առաքվել, որոնք են հաստատվել և այլն) և այն մասին, թե ինչպես են անդամները վերագրվում partition-ներին։ Այս վիճակը պահպանվում է նոր __share_group_state topic-ում և արդեն գոյություն ունեցող __consumer_offsets-ում։
Խոսել ենք consumer groups-ի head-of-line blocking խնդրի մասին։ Share groups-ը կարող են պոտենցիալ լուծել այն, եթե յուրաքանչյուր partition սպառվում է մեկից ավելի consumer-ի կողմից։ Դրա համար մեզ պետք կլինեն partition-ներից շատ ավելի շատ consumer-ներ. լռելյայն broker-ի կողմի partition assignor-ը յուրաքանչյուր consumer-ին տալիս է հնարավորինս քիչ partition-ներ։ Սակայն կարելի է տրամադրել սեփական assignor-ներ, որպեսզի, օրինակ, երաշխավորվի, որ յուրաքանչյուր partition սպառվում է մի քանի consumer-ների կողմից։ Եթե խմբաքանակով առաքված հաղորդագրությունները հետո մշակվեն զուգահեռ, այլ ոչ թե հաջորդաբար, head-of-line blocking-ը կարող էր լուծվել։
Արդյունավետությունը դեռ անհայտ է (նախագիծը դեռ վերջնական չէ. հնարավորությունը ներկայումս նախատեսված է Kafka 4.0-ի համար), կամ գոնե մենք բենչմարկների չենք հանդիպել։ Այնուհանդերձ, խնդիրներ չպետք է սպասենք. հաղորդագրությունները բերվում են խմբաքանակներով անմիջապես broker-ներից, և հաստատումը կարող է (և պետք է՛) նույնպես լինել խմբաքանակով։ Մի բան, որ կարող է ազդել latency-ի վրա, այն է, որ հաղորդագրությունների հաստատումը ներառում է մինչև 3 ցանցային թռիչք (consumer -> share-partition -> share coordinator -> replicas), մինչդեռ consumer groups-ում՝ 2 ցանցային թռիչք (consumer -> consumer offsets -> replicas)։ Սակայն քանի դեռ դա արվում է խմբաքանակներով, հավելյալ ծախսը պետք է հեշտությամբ ամորտիզացվի։
Վերադառնանք consumer groups-ի ամփոփման մեջ թվարկված բնութագրերին.
- share group-ի յուրաքանչյուր անդամ ստանում է partition-ների ոչ բացառիկ հավաքածու, որտեղից կարդում է տվյալները
- տվյալների մշակման զուգահեռականության աստիճանը չի սահմանափակվում partition-ների քանակով
- ստացված հաղորդագրությունները գալիս են առանց որևէ որոշակի կարգի
- հաղորդագրությունները կարելի է մեկ-մեկ հաստատել, մերժել կամ release անել կրկնակի առաքման համար
- ներսում Kafka-ն փորձում է խմբաքանակավորել և՛ հաղորդագրությունների առաքումը, և՛ հաստատումը
- head-of-line blocking խնդիրը պոտենցիալ կարելի է լուծել
- հաղորդագրությունները կարող են մշակվել at-least-once կամ at-most-once սեմանտիկայով
- կապի ծախսը ցածր է. հաղորդագրությունները պետք է հաստատվեն (հնարավոր է՝ խմբաքանակով), և share-partition-ի վիճակը պետք է պահպանվի
- արդյունավետությունը դեռ հայտնի չէ, բայց պետք է բարձր լինի
KMQ
KMQ-ն պատերն է, որն իրականացնում է հաղորդագրությունների անհատական հաստատումներ՝ Kafka-ի consumer groups-ի առաջարկած ֆունկցիոնալության վրա, ուստի աշխատում է Kafka-ի ցանկացած տարբերակի հետ։ Կարող եք նկատել որոշ նմանություններ KMQ-ի և share groups-ի նախագծերի միջև։ Սակայն KMQ-ն շատ ավելի պարզ է իրականացնել և տեղակայել, ինչը նշանակում է նաև, որ այն լուծում է consumer groups-ի թերություններից միայն մի քանիսը։ KMQ-ն ամբողջությամբ գտնվում է consumer-ի կողմում, ի տարբերություն share groups-ի, որտեղ էական տրամաբանություն աշխատում է broker-ների ներսում։
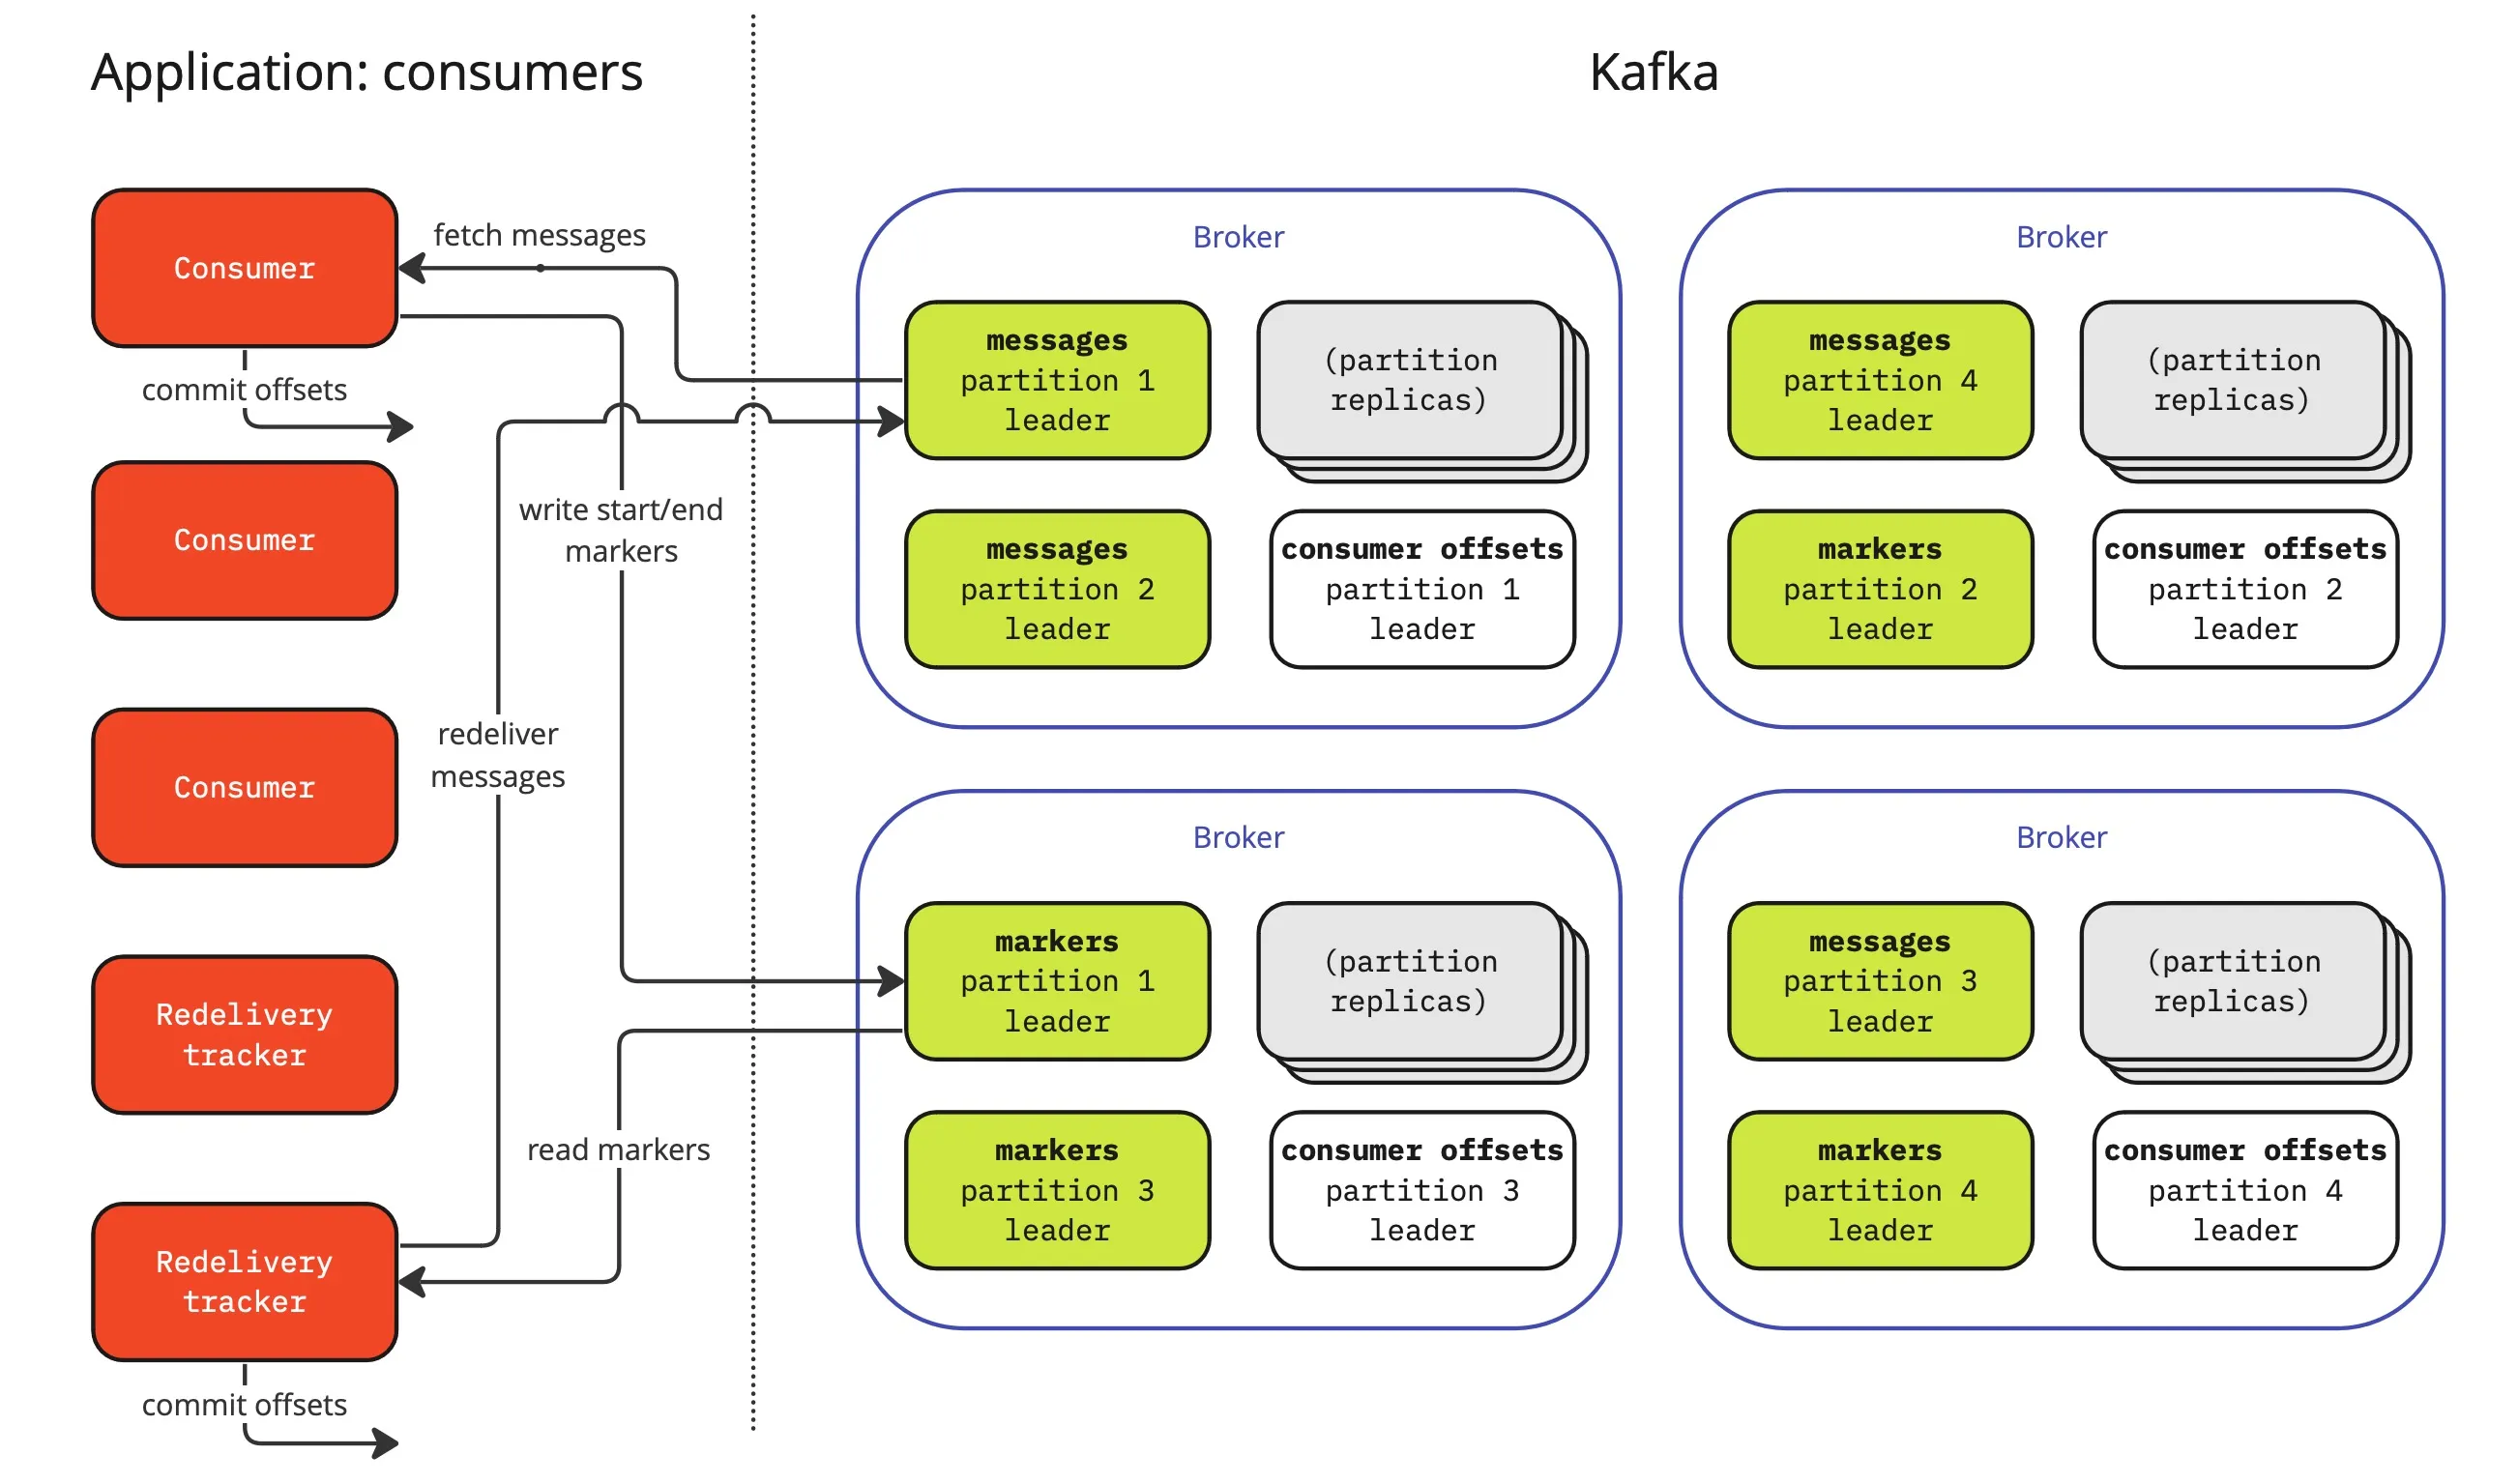
Ինչպես share groups-ը կախված են լրացուցիչ բաղադրիչներից (group և share coordinator-ներ, share-partition-ներ) և մետատվյալների պահպանման լրացուցիչ topic-ներից (__consumer_offsets և __share_group_state), այնպես էլ KMQ-ն հենվում է մեկ լրացուցիչ բաղադրիչի վրա՝ redelivery tracker-ի, և մետատվյալների մեկ լրացուցիչ topic-ի վրա՝ markers topic-ի։
Հաղորդագրությունների մշակումը
Topic-ից հաղորդագրություններ սպառելը consumer-ի կողմում ներառում է մի քանի լրացուցիչ քայլ։ Սա նման է share groups-ում հատուկ KafkaShareConsumer-ի օգտագործմանը և գալիս է հրապարակված KMQ փաթեթի հետ։ Այսպես թե այնպես, մեր գիտելիքով, շատերը KMQ-ին վերաբերվում են որպես պատերնի և հաղորդագրություններ ստանալու տրամաբանությունը պարզապես պատճենում են իրենց կոդի բազայում՝ ըստ կարիքի հարմարեցնելով։
KMQ topic-ի consumer-ները պետք է կազմեն consumer group, ուստի՝ ճիշտ ինչպես consumer groups-ում՝ մշակման զուգահեռականությունը սահմանափակվում է հաղորդագրությունները պարունակող topic-ի partition-ների քանակով։ Իրեն վերագրված partition-ներից հաղորդագրությունների խմբաքանակ ստանալուց հետո consumer-ը պետք է գրի start marker-ներ յուրաքանչյուր ստացված հաղորդագրության համար (համադրելի է share groups-ի acquired վիճակի հետ)։ Այստեղ է consumer groups-ից հիմնական տարբերությունը. երբ start marker-ները գրված են, consumer-ը պետք է commit անի սպառվող topic-ի offset-ները և միայն դրանից հետո մշակի հաղորդագրությունները։ Երբ մշակումն ավարտված է, consumer-ը պետք է գրի end marker-ներ, ինչը համապատասխանում է share groups-ում հաղորդագրությունների հաստատմանը։
Հաղորդագրությունների կրկնակի առաքումը
Հաղորդագրությունները ճիշտ կրկնակի առաքելու համար պահանջվում է լրացուցիչ բաղադրիչ՝ redelivery tracker-ը։ Այն պետք է տեղակայվի ինչպես ցանկացած այլ Kafka հավելված՝ markers topic-ը սպառելով համագործակցաբար որպես consumer group-ի մաս (վերոնշյալից տարբեր խմբի)։ Ինչպես share groups-ում share coordinator-ի պարտականությունները բաշխված են broker հանգույցների վրա, այստեղ redelivery tracker-ի պարտականությունները բաշխված են consumer հանգույցների վրա։ Երբ redelivery tracker հանգույցը խափանվում է, consumer group-ի rebalancing-ը նրա partition-ները հանձնում է մնացած աշխատող redelivery tracker օրինակներին։
Redelivery tracker-ը markers topic-ից սպառում է start և end marker-ները և թարմացնում է իր ներքին վիճակը, որը արտացոլում է հաղորդագրությունների առաքման վիճակը։ KMQ-ն հենվում է համանման timeout մեխանիզմի վրա՝ հաղորդագրությունները կրկին առաքելով, երբ կարգավորված հաղորդագրության timeout-ի ընթացքում end marker չի գրվում։ Հաղորդագրությունը կրկին առաքել նշանակում է պարզապես նորից գրել այն իր topic-ում, և հաղորդագրության մետատվյալներում առաքման հաշվիչը թարմացվում է միևնույն պահին։ Երբ առաքման հաշվիչը գերազանցում է կարգավորված շեմը, հաղորդագրությունը փոխարենը գրվում է DLQ-ում։
Redelivery tracker-ը markers topic-ում offset-ները commit է անում՝ օգտագործելով ամենաբարձր offset-ը։ Յուրաքանչյուր start marker ունի համապատասխան end marker (դրանք գրվում են նաև ժամկետանց հաղորդագրությունների համար)։ Դրա շնորհիվ markers topic-ին կարելի է տալ retention ժամանակահատված, ասենք՝ հաղորդագրության timeout-ից կրկնակի երկար, ինչը redelivery tracker-ին թողնում է բավարար ժամանակ՝ կրկին առաքելու ժամկետանց դարձած ցանկացած հաղորդագրություն։
Վերջապես, արդյունավետության մասին. start/end marker-ներ գրելը իրոք հավելյալ ծախս է ավելացնում, բայց ինչպես մյուս լուծումներում, դա կարող է խմբաքանակավորվել՝ ծախսը բաշխելով այնպես, որ մեկ հաղորդագրության հաշվով այն ստացվի բավականին ցածր։ Ինչպես consumer groups-ում, հաղորդագրությունների «հաստատումը»՝ այսինքն՝ end marker-ների գրառումը, պահանջում է երկու ցանցային թռիչք (consumer -> markers topic -> replicas)։ Որոշ ժամանակ առաջ մենք KMQ-ն բենչմարկեցինք consumer groups-ի դեմ և ստացանք համադրելի թողունակության արդյունքներ։
KMQ-ի ամփոփում
- յուրաքանչյուր consumer ստանում է partition-ների բացառիկ հավաքածու, որտեղից կարդում է տվյալները
- տվյալների մշակման զուգահեռականության աստիճանը սահմանափակվում է partition-ների քանակով
- ստացված հաղորդագրությունները գալիս են առանց որևէ որոշակի կարգի
- հաղորդագրությունները կարելի է հաստատել մեկ-մեկ. մերժումը և release-ը իրականացված չեն, բայց դրանք ավելացնելը աննշան կլիներ
- marker-ները գրվում են խմբաքանակներով՝ Kafka-ի ստանդարտ գրառման խմբաքանակավորման մեխանիզմներով
- head-of-line blocking-ը կարող է խնդիր լինել, ճիշտ ինչպես consumer groups-ում
- հաղորդագրությունները մշակվում են at-least-once սեմանտիկայով
- կապի ծախսը միջին է. յուրաքանչյուր հաղորդագրության համար պետք է գրվեն start և end marker, և offset-ները պետք է պարբերաբար commit արվեն
- արդյունավետությունը բարձր է
Համեմատություն
Մանրամասն դիտարկեցինք երեք եղանակ, որով մի քանի կլիենտ-consumer-ներ կարող են համագործակցաբար սպառել Kafka topic-ի հաղորդագրությունները։ Ահա ամփոփում, թե ինչ է առաջարկում յուրաքանչյուրը.
| Consumer groups | Share groups | KMQ պատերն | |
|---|---|---|---|
| Հասանելիություն | Kafka-ի մաս է «արկղից» | Կարող է հայտնվել Kafka-ի ապագա տարբերակներում | Պատերն, որը իրականացվում է Kafka-ի ցանկացած տարբերակի վրա |
| Հաստատումներ | Միայն յուրաքանչյուր հաղորդագրություն մինչև տրված offset-ը | Հաստատում յուրաքանչյուր հաղորդագրության համար | Հաստատում յուրաքանչյուր հաղորդագրության համար |
| Consumer-ների քանակ (մշակման զուգահեռականություն) | Սահմանափակված է partition-ների քանակով | Սահմանափակում չկա | Սահմանափակված է partition-ների քանակով |
| Կարգավորվածություն | Հաղորդագրությունները կարգավորված են յուրաքանչյուր partition-ի ներսում | Կարգ չկա | Կարգ չկա |
| Head-of-line blocking | Կարող է առաջանալ | Կարելի է խուսափել | Կարող է առաջանալ |
| Առաքման սեմանտիկա | At-least-once / at-most-once | At-least-once / at-most-once | At-least-once |
| Կապի ծախս | Շատ ցածր | Ցածր | Միջին |
| Արդյունավետություն | Շատ բարձր | Հավանաբար բարձր | Բարձր |
Իր պարզ հիմքերի վրա հենվելով՝ Kafka-ն շարունակում է ավելացնել նոր ֆունկցիոնալություն և հասցեագրել օգտագործման ամենատարբեր դեպքերի կարիքները։ Հիմնարար առումով Kafka-ն ապահովում է տվյալների դիմացկունություն՝ topic-ները կրկնօրինակելով մի քանի broker-ների վրա, և առաջարկում է մասշտաբավորելիություն՝ topic-ները բաժանելով մի շարք partition-ների։ Այս նախագիծը ունի իր սահմանները, բայց լավ նախագծված հավելվածները հաճախ կարող են շրջանցել դրանք։
Հաղորդագրությունների հերթավորումը սա լավ պատկերում է. շատ դեպքերում consumer groups-ը այն ամենն է, ինչ Ձեզ պետք է։ Ավելի պահանջկոտ օգտագործման դեպքերի համար լուծում կարող են լինել KMQ-ի նման պատերնները։ Իսկ Kafka-ում հերթավորման խնդիրը լիովին լուծելու համար կա առաջարկ՝ ընդլայնել նրա ֆունկցիոնալությունը share groups-ով։
Հուսով ենք, որ այս ակնարկը օգտակար եղավ և կօգնի Ձեզ ընտրել Kafka-ում հաղորդագրություններ սպառելու ճիշտ եղանակը։