Ինտելեկտուալ փաստաթղթերի մշակումը ձեր բիզնեսի ծառայության մեջ
Իմացեք, թե ինչպես կարելի է արհեստական բանականության գործիքներով մշակել փաստաթղթեր, ինչ խնդիրների դեպքում են դրանք օգնում և ինչպես դրանք կիրառել ձեր ընկերությունում։
Ինչո՞ւ փաստաթղթեր
Թվային, թե թղթային՝ փաստաթղթերը պաշտոնական հաղորդակցության հիմնական ուղին են ինչպես ընկերությունների ներսում, այնպես էլ նրանց միջև։ Դրանք տեղեկատվություն փոխանակելու ունիվերսալ միջոց են՝ անկախ ոլորտից, երկրից կամ լեզվից։ Դրան գումարած՝ փաստաթղթաշրջանառությունը հաճախ պահանջվում է օրենքով։
Քանի որ տեղեկատվության փոխանակման այս ձևն այդքան տարածված է և օրենքով պարտադիր, ընկերությունները ստիպված են հարմարվել միջավայրին, որում այժմ գործում են։ Շատերը օգտվում են թվայնացումից և պարտադիր փաստաթղթերից բացի տեղեկատվություն փոխանակում են ավելի կառուցվածքային ձևաչափով, օրինակ՝ Excel աղյուսակներով։ Սակայն զգալի մասը, հատկապես փոքր ընկերությունները, չեն ներդրում այս գործընթացի ավտոմատացման մեջ, քանի որ իրենց չափերի պատճառով դա շոշափելի օգուտ չի տալիս։ Նրանց համար խնդիր չէ, որ աշխատակիցը PDF-ով ստացված հաշիվ-ապրանքագրից կարդա տվյալները և մուտքագրի բանկային փոխանցման ձևի մեջ, պարզապես այն պատճառով, որ դա հաճախ չի պատահում։ Բայց բազմաթիվ գործընկերների հետ աշխատող խոշոր կազմակերպությունների համար այս գործընթացը կարող է դառնալ զգալի ծախս։ Այդպիսի ընկերությունները կարող են շատ խնայել՝ փաստաթղթերի մշակումն ավտոմատացնելով արհեստական բանականության գործիքով։
Այս հոդվածում ես կիսվում եմ իմ տեսակետով բիզնես գործընթացների օպտիմալացման համար ԱԲ տեխնոլոգիայի պոտենցիալի մասին և նկարագրում եմ այն խնդիրների տարբեր տեսակները, որոնք արհեստական բանականությունը կարող է լուծել փաստաթղթերի մշակման մեջ։ Ինտելեկտուալ փաստաթղթերի մշակման մասին այս շարքի հաջորդ մասերում ես ավելի մանրամասն կանդրադառնամ իրականացման մոտեցումներին, պահանջներին և այս խնդիրների հետ կապված հնարավոր դժվարություններին։ Շարունակեք կարդալ։
Բիզնես առավելություն
Կսկսեմ հարցից. ինչո՞ւ։ Ինչո՞ւ պետք է ընկերությունները հոգ տանեն արհեստական բանականությունը փաստաթղթերի մշակման մեջ կիրառելու մասին։ Ինչպե՞ս կարելի է նրանց համոզել ներդրում կատարել այնպիսի նորարարության մեջ, ինչպիսին արհեստական բանականության տեխնոլոգիաներն են։
Ծախսերի կրճատում և ավելի լավ մասշտաբավորում
Արհեստական բանականության համակարգը կարող է ավտոմատացնել փաստաթղթերի մշակումը և փոխարինել մարդ աշխատողներին, թեև բարդ դեպքերում դեռ պետք կլինի մարդու միջամտություն։ Այդպիսի համակարգի գլխավոր ուժը նրա մասշտաբավորվելու ունակությունն է։ Ենթադրենք՝ համակարգով անցնող փաստաթղթերի քանակը հանկարծ կրկնապատկվում է։ Առանց ԱԲ-ի ստիպված կլինեք վարձել 2 անգամ ավելի շատ աշխատակից, իսկ ԱԲ-ի դեպքում պարզապես ավելացնում եք տեղակայված մոդելի օրինակների քանակը։ Իսկ նոր աշխատակիցներին ինտեգրելու և վերապատրաստելու խնդիրը վերանում է։
Սա աշխատում է նաև հակառակ ուղղությամբ – եթե փաստաթղթերի մշակման պահանջարկը նվազում է, դուք պարզապես ավելի քիչ ամպային ռեսուրսներ եք օգտագործում՝ առանց կրճատումների։ Մեքենայական ուսուցման մեթոդները հեշտացնում են հարմարվելը այն ծառայությունների տատանվող պահանջարկին, որոնք նախկինում կատարում էին մարդ աշխատողները։
Իմ կարծիքով – և հաշվի առեք, որ ես ML ինժեներ եմ, ոչ թե ղեկավար – խոշոր ձեռնարկությունների համար փաստաթղթեր մշակող ԱԲ համակարգերում ներդրումը կիջեցնի ծախսերը և կապահովի սահուն մասշտաբավորում։ Սա ամենակարևորն է այն ընկերությունների համար, որոնք բախվում են իրենց մշակած փաստաթղթերի ծավալի հանկարծակի տատանումների։ Բացի այդ, ավտոմատացման ցանկացած ձև վերացնում է մարդկային սխալը։
Փաստաթղթերի մշակման արագացում
Տվյալները համակարգիչներով մշակելու ակնհայտ օգուտը արագությունն է։ Այն, ինչը կարող է մարդ մասնագետից րոպեներ կամ ժամեր խլել, մեքենան անում է վայրկյանների ընթացքում։ Դա մեծ պլյուս է, հատկապես այն գործընթացների համար, որոնք պահանջում են անմիջական արձագանք կամ որոնց արժեքը շատ կարճատև է։
Պարզ օրինակ է ընկերության բաժնետոմսերի գների տվյալները։ Պատկերացրեք, որ ունեք իրական ժամանակի տվյալների հոսքերի հասանելիություն։ Ամեն անգամ, երբ տվյալները փոխվում են, մարդուն պետք է պահ՝ դրանք վերլուծելու և որոշելու, թե ինչ անել։ Եթե չափազանց դանդաղ արձագանքեք, տվյալներն արդեն փոխվել են, ուստի որոշումը կարող է այլևս վավեր չլինել։ Իսկ մեքենան, ընդհակառակը, տվյալները վերլուծում է վայրկյանի մի մասում և որոշում է կայացնում իր ալգորիթմի համաձայն՝ նախքան տվյալների հնանալը։
Ավտոմատացում
Բարդ բիզնես գործընթացների համար ավտոմատացումը կրճատում է մշակման ժամանակը և գործընթացը դարձնում ավելի թափանցիկ։ Փաստաթղթերը հաճախ անցնում են բազմաթիվ ձեռքերով. մարդիկ ստուգում են դրանց տարբեր կողմերը, հաստատում են տվյալների ճշտությունը, դրանցից մի քանիսը պատճենում են արտաքին տեղեկատվական համակարգեր, կիրառում են բարդ բիզնես տրամաբանություն և այլն։ Եթե գործընթացը ընթացակարգային է և կարգավորվում է հստակ սահմանված կանոններով, այն կարելի է ավտոմատացնել։
Ինտելեկտուալ փաստաթղթերի մշակում
Document AI և Intelligent Document Processing եզրույթները բավական լայն են և ընդգրկում են բոլոր այն ոլորտները, որտեղ ԱԲ հավելվածները կարող են ավտոմատ մշակել տարբեր տեսակի փաստաթղթեր։ Այստեղ ես կդիտարկեմ միայն այն փաստաթղթերը, որոնց առավել հաճախ հանդիպում ենք ընկերությունների ներսում կամ նրանց միջև պաշտոնական հաղորդակցության մեջ, այսինքն՝ պայմանագրեր, ձևեր, հաշիվ-ապրանքագրեր, դիմումներ և այլն։ Սակայն բիզնեսի տեսանկյունից, կարծում եմ, պատվերներն ու հաշիվ-ապրանքագրերն ունեն ավտոմատացման ամենամեծ պոտենցիալը՝ հաշվի առնելով, թե որքան կենտրոնական են դրանք ընկերության գործընթացներում և որքան տարածված են։
Document AI-ը գալիս է բազմաթիվ ձևերով, ուստի ես դրա տարբեր կողմերը կներկայացնեմ հետևյալ բաժիններում։
Փաստաթղթերի դասակարգում
Աղբյուր
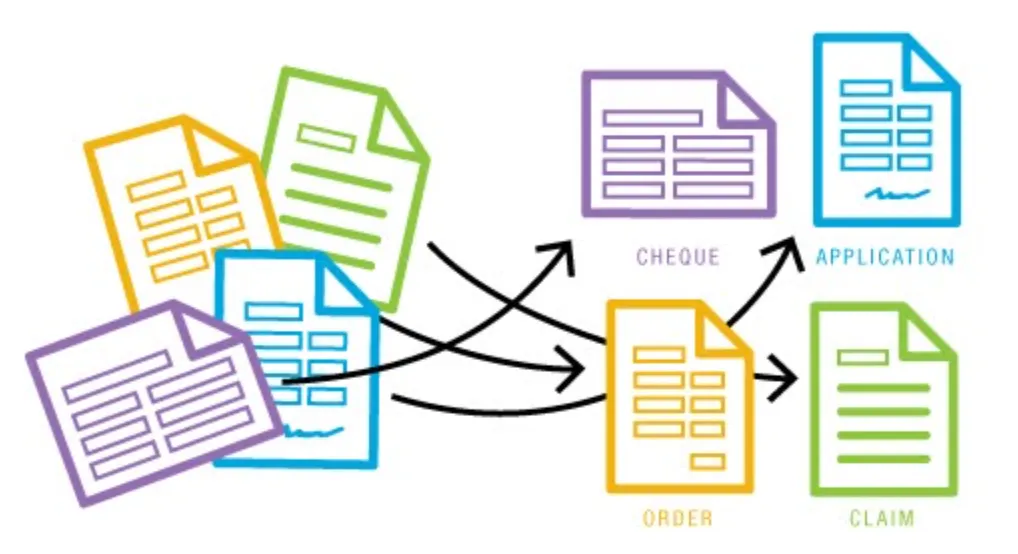
Փաստաթղթերի դասակարգումը այն խնդիրներից մեկն է, որ ԱԲ-ն կարող է լուծել։ Փաստաթղթի տեսակը որոշում է, թե որ ԱԲ համակարգերը կամ մեքենայական ուսուցման մոդելները կկիրառենք – ավելի վաղ հիշատակված հաշիվ-ապրանքագիրը և առաջխաղացման հայտը կմշակվեն տարբեր եղանակներով։
Ինչո՞ւ։ Հիմնականում այն պատճառով, որ փաստաթղթերն ունեն տարբեր բնութագրեր, որոնք մենք ավելի մանրամասն կքննարկենք այս շարքի հաջորդ հոդվածներում։ Առայժմ ենթադրենք, որ զուտ տեքստային տվյալները պահանջում են բնական լեզվի մշակման տեխնիկաներ և խորը ուսուցման մոդելներ, որոնք օգտագործում են փաստաթղթի տեքստային հատկանիշները։ Պատկերները, իրենց հերթին, պահանջում են համակարգչային տեսողության մեթոդներ։ Իսկ տեսողականորեն հարուստ փաստաթղթերը, որոնք ունեն խիստ սահմանված դասավորություն, պահանջում են երկուսի բազմամոդալ համադրություն։
Փաստաթղթի դասավորության վերլուծություն
Լավ սահմանված ձևաչափ ունեցող փաստաթղթերը, որոնք հայտնի են որպես Visually-Rich Documents, կարելի է մշակել համակարգչային տեսողության տեխնիկայով, որը կոչվում է Document Layout Analysis (DLA)։ Այն բաղկացած է փաստաթղթի որոշակի մասերը նախապես սահմանված դասերին վերագրելուց, օրինակ՝ աղյուսակ, տեքստի տող, վերնագիր, պատկեր, պատկերի ստորագրություն, էջատակ և այլն։
ԱԲ հետազոտությունները շարունակում են ստեղծել մասնագիտացված մեքենայական ուսուցման մոդելներ, որոնք այս խնդիրը կատարում են ավելի ու ավելի լավ։ Առաջնագծում են բազմամոդալ խորը ուսուցման ալգորիթմները՝ չպիտակավորված բազմամոդալ տվյալների նմուշների վրա հատուկ մարզման ընթացակարգերով։
Ստորև կարող եք տեսնել Document Layout Analysis-ը, կիրառված գիտական հոդվածի մի էջի վրա։
Աղբյուր
Տեսնելու համար, թե Document Layout Analysis-ը ինչպես է աշխատում ձեր սեփական տվյալների վրա, փնտրեք HuggingFace Spaces-ի ինտերակտիվ դեմոներից որևէ մեկը։
Աղյուսակի կառուցվածքի ճանաչում
Աղբյուր
Table Structure Recognition (TSR)-ը դասավորության վերլուծության մասնավոր դեպք է։ TSR-ը վերլուծում է միայն աղյուսակի տարածքը և որոշում է դրա բաղադրիչները, ինչպիսիք են տողը, սյունը, բջիջը, սյան վերնագիրը և այլն։ TSR-ի միջոցով փաստաթղթերի աղյուսակները կարելի է ավտոմատ կերպով վերլուծել կառուցվածքային ձևի, որը օգտագործելի է, օրինակ, փաստաթուղթը վերլուծելու կամ վավերացնելու համար։ Հաշվի առնելով ԱԲ մոդելների արդյունավետությունը՝ TSR-ը կիրառվում է ոչ թե ամբողջ փաստաթղթի, այլ միայն դրա այն մասի վրա, որտեղ աղյուսակ է հայտնաբերվել։
TSR-ի վրա հիմնված լուծումները լավ են աշխատում հստակ տեսողական սահմաններով աղյուսակների վրա, որոնք հայտնի են որպես եզրագծերով աղյուսակներ։ Որքան պարզ են տարրերը տեսողականորեն առանձնացված, այնքան հեշտ է աշխատանքը արհեստական բանականության մոդելի համար։ Բարդ աղյուսակային հիերարխիաներն ու առանց եզրագծերի աղյուսակները այն տեղերն են, որտեղ դժվարություն է առաջանում։
Աղյուսակի ճանաչում
Փաստաթղթում աղյուսակները հայտնաբերելը աղյուսակների հետ կապված համակարգչային տեսողության մեկ այլ խնդիր է։ Դա փաստաթղթերի վրա կիրառվող Object Detection խնդրի մասնավոր դեպք է և բաղկացած է փաստաթղթի էջում աղյուսակը պարունակող ամենափոքր ուղղանկյունը գտնելուց։ Դա TSR-ի նախապայմանն է։
Բենչմարկերի վրա խորը մոդելները, ըստ հաղորդումների, հասնում են գրեթե 100% արդյունավետության։ Սակայն իրական փաստաթղթերի դեպքում նրանց արդյունավետությունը հաճախ պակասում է և պահանջում է ձեռքի տակ եղած տվյալներին հարմարեցված անհատական լուծում։ Քանի որ Table Structure Recognition-ը հիմնվում է այս խնդրի արդյունքի վրա, սխալները փոխանցվում են և խիստ իջեցնում են վերջնական արդյունավետությունը։ Այդ պատճառով այս փուլի արդյունքները արժանի են հավելյալ ուշադրության։
Օպտիկական նիշերի ճանաչում
Աղբյուր
Օպտիկական նիշերի ճանաչումը (Optical Character Recognition) փաստաթղթերի մշակման հիմնարար քայլ է, որը տեսողական տեսքով փաստաթղթից դուրս է բերում կառուցվածքային, համակարգչով ընթեռնելի տվյալներ և դնում դրանք փաստաթղթի վրա։ Այն հատկապես կարևոր է այն փաստաթղթերի համար, որոնք չունեն տեքստային շերտ, բայց պարունակում են բիզնեսի համար կարևոր բովանդակություն։ OCR գործիքները սովորաբար վերադարձնում են բառերի կամ տեքստի տողերի ցանկ՝ դրանք պարունակող սահմանային տուփերի հետ միասին։
Վիզուալ հարցերի պատասխանում
VQA-ն վերաբերում է պատկերի կամ փաստաթղթի հիման վրա տեքստային հարցերին պատասխանելուն։ ԱԲ համակարգի դա անելու ինտուիտիվ օրինակ է չաթբոտը, որին կարելի է հարցեր տալ փաստաթղթի մասին։ Ենթադրենք՝ համակարգ ենք վերբեռնում ընկերության եռամսյակային հաշվետվություն և մեր վերլուծությունն արագացնելու համար գեներատիվ ԱԲ համակարգին տալիս ենք հիմնական հարցերը՝ սպասելով, որ այն փաստաթղթի հիման վրա ճիշտ պատասխաններ կտա։ Պարզ ասած՝ VQA համակարգերն այսպես են աշխատում։
Դուք կարող եք փորձել VQA-ն HuggingFace Spaces-ում՝ Donut խորը ուսուցման մոդելով։
Հիմնական տեղեկատվության արդյունահանում
Ես սա համարում եմ ամենամեծ պոտենցիալ ունեցող խնդիրներից մեկը։ Այն թույլ է տալիս փաստաթղթից տեղեկատվություն արդյունահանել կառուցվածքային բանալի-արժեք ձևով։ Երբ փաստաթուղթը վերածվել է բառարանի, այդ կառուցվածքային տվյալները կարելի է ազատորեն օգտագործել – օրինակ՝ փոխանցել այլ համակարգերի, անցկացնել բիզնես տրամաբանության միջով, օգտագործել դաշտերը, հաշիվ-ապրանքագրի տվյալները և այլն վավերացնելու համար – ինչը ավտոմատացնում է մարդու կրկնվող աշխատանքը։
Աղբյուր
KIE-ն սովորաբար կառուցվում է երկու խնդրի համադրությամբ՝ Semantic Entity Recognition (SER) և Relation Extraction (RE)։ Առաջինը փաստաթղթի յուրաքանչյուր բառին դաս է վերագրում և կազմում է անընդհատ սուբյեկտներ (սովորաբար «Question» և «Answer» դասերով), իսկ երկրորդը որոշում է՝ սուբյեկտների միջև կապեր կա՞ն։ Դասերն ու կապերը ձեռքի տակ ունենալով՝ մենք կարող ենք այս տեղեկատվությունը վերածել բանալի-արժեք բառարանի։
Ամփոփում
Այս հոդվածում ես բացատրեցի, թե ինչ է ինտելեկտուալ փաստաթղթերի մշակումը և ինչ խնդիրներ է այն ներառում։ Ես նկարագրեցի այն առավելությունները, որոնք տեսնում եմ փաստաթղթերի մշակման համար նման ԱԲ համակարգեր օգտագործելու մեջ, համառոտ անդրադարձա Document AI-ի լուծած խնդիրներին և ուրվագծեցի դրանց հնարավոր բիզնես կիրառությունները։ Հուսով եմ, որ սա կարդալուց հետո ունեք ընդհանուր պատկերացում, թե որ ԱԲ տեխնիկաները կարող են ձեզ աջակցել փաստաթղթերի ավտոմատ մշակման մեջ։ Առաջիկա գրառումներում ավելի մանրամասն կքննարկվեն կոնկրետ խնդիրներն ու այն, թե ԱԲ ալգորիթմներն ինչպես են դրանք լուծում – հետևեք մեզ։