توظيف المعالجة الذكية للمستندات في عملك
تعرّف على كيفية استخدام أدوات الذكاء الاصطناعي في معالجة المستندات، والمشكلات التي تساعد في حلّها، وكيف تضعها قيد العمل في شركتك.
لماذا المستندات؟
سواء كانت رقمية أو ورقية، تُعد المستندات القناة الأساسية للتواصل الرسمي داخل الشركات وفيما بينها. فهي وسيلة عالمية لتبادل المعلومات، أيًّا كان القطاع أو البلد أو اللغة. وفوق ذلك، كثيرًا ما يكون تدفق المستندات مطلوبًا بموجب القانون.
ولأن هذا الشكل من تبادل المعلومات منتشر على نطاق واسع ومفروض قانونًا، يتعين على الشركات أن تتكيّف مع البيئة التي تعمل فيها اليوم. وكثير منها يستفيد من الرقمنة، وإلى جانب المستندات الإلزامية، يشارك المعلومات بصيغة أكثر تنظيمًا، مثل جداول Excel. غير أن نسبة كبيرة – ولا سيما الشركات الصغيرة – لا تستثمر في أتمتة هذه العملية، إذ لا تحقق لها، بالنظر إلى حجمها، مكاسب ملموسة. فبالنسبة إليها، لا يمثل قيام الموظفين بقراءة بيانات فاتورة وردت بصيغة PDF وإدخالها في نموذج تحويل مصرفي مشكلة، لمجرد أن ذلك لا يحدث كثيرًا. أما بالنسبة إلى المؤسسات الكبيرة التي تتعامل مع عدد كبير من الأطراف المقابلة، فقد تتحول هذه العملية إلى تكلفة كبيرة. ويمكن لمثل هذه الشركات أن توفر الكثير بأتمتة معالجة المستندات بأداة ذكاء اصطناعي.
أشارك في هذه المقالة رؤيتي حول إمكانات تقنية الذكاء الاصطناعي في تحسين العمليات التجارية، وأصف مختلف أنواع المهام التي يستطيع الذكاء الاصطناعي تنفيذها في معالجة المستندات. وفي الأجزاء القادمة من هذه السلسلة حول المعالجة الذكية للمستندات، سأتناول بمزيد من التفصيل مناهج التنفيذ والمتطلبات والمشكلات المحتملة المتعلقة بهذه المهام. تابع القراءة!
الميزة التجارية
سأبدأ بسؤال: لماذا؟ لماذا ينبغي أن تهتم الشركات بتطبيق الذكاء الاصطناعي على معالجة المستندات؟ وكيف يمكن إقناعها بالاستثمار في ابتكار مثل تقنيات الذكاء الاصطناعي؟
خفض التكاليف وتحسين التوسّع
يستطيع نظام ذكاء اصطناعي أتمتة معالجة المستندات وتولّي مهام العاملين البشر، وإن كانت الحالات المعقدة ستظل تحتاج إلى تدخل بشري. وتتمثل القوة الرئيسية لمثل هذا النظام في مدى جودة توسّعه. فلنفترض أن عدد المستندات المارة عبر النظام تضاعف فجأة. بدون الذكاء الاصطناعي، سيتعين عليك توظيف ضعف عدد الموظفين؛ أما مع الذكاء الاصطناعي فتزيد فقط عدد نسخ النماذج المنشورة. وتختفي مشكلة استقطاب الموظفين الجدد وتدريبهم.
وهذا يعمل في الاتجاه المعاكس أيضًا – فإذا انخفض الطلب على معالجة المستندات، فإنك ببساطة تستهلك موارد سحابية أقل، دون أي تسريح للعاملين. وتجعل تقنيات تعلّم الآلة التكيّف مع تذبذب الطلب على الخدمات التي كان العاملون البشر يؤدونها أسهل.
في رأيي – ومن المهم أن تتذكر عند تقييمه أنني مهندس تعلّم آلة وليس مديرًا تنفيذيًا – أن الاستثمار في أنظمة الذكاء الاصطناعي لمعالجة المستندات سيخفض التكاليف ويتيح توسّعًا سلسًا بالنسبة إلى المؤسسات الكبيرة. ويكون ذلك أكثر أهمية للشركات التي تواجه تقلبات مفاجئة في حجم المستندات التي تتعامل معها. بالإضافة إلى ذلك، فإن أي شكل من أشكال الأتمتة يلغي الخطأ البشري.
تسريع معالجة المستندات
الفائدة الواضحة من معالجة البيانات بالحواسيب هي السرعة. فما قد يستغرق من خبير بشري دقائق أو ساعات، تنجزه الآلة في ثوانٍ. وهذه ميزة كبيرة، خاصة للعمليات التي تتطلب ردّ فعل فوريًا أو التي تكون قيمتها قصيرة الأمد جدًا.
ومثال بسيط على ذلك بيانات أسعار أسهم الشركات. تخيّل أن لديك إمكانية الوصول إلى تدفقات بيانات فورية. كلما تغيرت البيانات، يحتاج الشخص إلى لحظة ليحللها ويقرر ما يفعل. وإذا تأخر ردّ فعله، تكون البيانات قد تغيرت، وقد لا يعود القرار صالحًا. أما الآلة، في المقابل، فتحلل البيانات في جزء من الثانية وتتخذ قرارًا وفق خوارزميتها قبل أن تفقد البيانات صلاحيتها.
الأتمتة
بالنسبة إلى العمليات التجارية المعقدة، تقصّر الأتمتة وقت المعالجة وتجعل العملية أكثر شفافية. فكثيرًا ما تمر المستندات عبر أيدٍ عديدة: يفحص الأشخاص جوانب مختلفة منها، ويتحققون من صحة البيانات، وينسخون بعضها إلى أنظمة معلومات خارجية، ويطبقون منطق أعمال معقدًا، وهكذا. وإذا كانت العملية إجرائية وتحكمها قواعد محددة جيدًا، فيمكن أتمتتها.
المعالجة الذكية للمستندات
مصطلحا Document AI وIntelligent Document Processing واسعان إلى حد ما، ويشملان كل مجال تستطيع فيه تطبيقات الذكاء الاصطناعي معالجة مستندات من أنواع مختلفة تلقائيًا. وسأتناول هنا فقط المستندات التي نصادفها غالبًا في التواصل الرسمي داخل الشركات أو فيما بينها، أي العقود والنماذج والفواتير والطلبات وغيرها. غير أنني أعتقد، من منظور الأعمال، أن أوامر الشراء والفواتير تمتلك أكبر إمكانات الأتمتة، نظرًا لمحوريتها في عمليات الشركات وشيوعها.
لـ Document AI أشكال كثيرة، لذا سأغطي جوانبه المختلفة في الأقسام التالية.
تصنيف المستندات
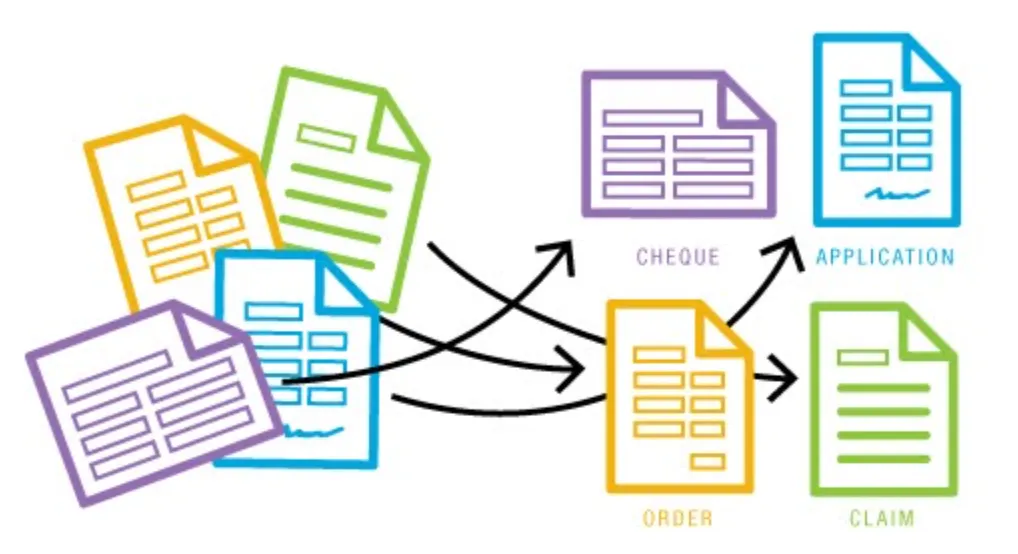
المصدر
يُعد تصنيف المستندات إحدى المهام التي يستطيع الذكاء الاصطناعي تنفيذها. فنوع المستند هو الذي يحدد أي أنظمة ذكاء اصطناعي أو نماذج تعلّم آلة نطبّقها – فالفاتورة وطلب العرض الترويجي المذكوران آنفًا سيُعالجان بطريقتين مختلفتين.
لماذا؟ في المقام الأول لأن للمستندات خصائص مختلفة، وسنتناولها بتفصيل أكبر في مقالات لاحقة من هذه السلسلة. أما الآن، فلنفترض أن البيانات النصية البحتة تتطلب تقنيات معالجة اللغة الطبيعية ونماذج تعلّم عميق تستفيد من الخصائص النصية للمستند. وتتطلب الصور بدورها أساليب رؤية الحاسوب. أما المستندات الغنية بصريًا ذات التخطيطات المحددة بدقة فتتطلب مزيجًا متعدد الوسائط من الاثنين.
تحليل تخطيط المستند
يمكن التعامل مع المستندات ذات التنسيق المحدد جيدًا، المعروفة باسم المستندات الغنية بصريًا (Visually-Rich Documents)، بتقنية في رؤية الحاسوب تُسمى تحليل تخطيط المستند (Document Layout Analysis، أو DLA). وهي تقوم على إسناد أجزاء معينة من المستند إلى فئات محددة مسبقًا، مثل الجدول وسطر النص والترويسة والصورة وتعليق الصورة والتذييل وغيرها.
ولا تتوقف أبحاث الذكاء الاصطناعي عن إنتاج نماذج تعلّم آلة متخصصة تؤدي هذه المهمة بشكل أفضل فأفضل. وتأتي في الطليعة خوارزميات التعلّم العميق متعددة الوسائط ذات إجراءات التدريب المخصصة على عينات بيانات متعددة الوسائط غير موسومة.
يمكنك في ما يلي رؤية تحليل تخطيط المستند مطبقًا على صفحة من مقالة علمية.
المصدر
ولترى أداء تحليل تخطيط المستند على بياناتك الخاصة، ابحث عن أحد العروض التفاعلية على HuggingFace Spaces.
التعرف على بنية الجداول
المصدر
التعرف على بنية الجداول (Table Structure Recognition، أو TSR) حالة خاصة من تحليل التخطيط. فهو يحلل منطقة الجدول فقط ويحدد مكوناتها، مثل الصف والعمود والخلية ورأس العمود وغيرها. وبواسطة TSR يمكن تحليل الجداول في المستندات تلقائيًا إلى شكل منظم يمكن استخدامه، مثلًا، في تحليل المستند أو التحقق منه. وبالنظر إلى أداء نماذج الذكاء الاصطناعي، لا يُطبَّق TSR على المستند كله بل على الجزء الذي اكتُشف فيه جدول فقط.
تؤدي الحلول القائمة على TSR أداءً جيدًا مع الجداول ذات الحدود البصرية الواضحة، المعروفة باسم الجداول المحدّدة بإطار. وكلما كانت العناصر أوضح انفصالًا بصريًا، كانت المهمة أسهل على نموذج الذكاء الاصطناعي. أما التسلسلات الهرمية المعقدة للجداول والجداول بلا حدود فهي موضع الصعوبة.
التعرف على الجداول
يُعد اكتشاف الجداول في المستند مهمة أخرى من مهام رؤية الحاسوب المتعلقة بالجداول. وهي حالة خاصة من مهمة اكتشاف الكائنات مطبقة على المستندات، وتتمثل في إيجاد أصغر مستطيل يحيط بجدول في صفحة مستند. وهي شرط مسبق لـ TSR.
وتشير التقارير إلى أن النماذج العميقة تبلغ في المعايير القياسية فعالية تقارب 100%. أما مع المستندات الواقعية، فكثيرًا ما تقصّر فعاليتها وتتطلب حلًا مخصصًا يُضبط وفق البيانات المتاحة. ولأن التعرف على بنية الجداول يبني على مخرجات هذه المهمة، فإن الأخطاء تنتقل وتخفض الأداء النهائي بشدة. ولذلك تستحق نتائج هذه المرحلة اهتمامًا إضافيًا.
التعرف الضوئي على الحروف
المصدر
التعرف الضوئي على الحروف (OCR) خطوة أساسية في معالجة المستندات، تستخرج بيانات منظمة مقروءة حاسوبيًا من مستند بصيغة بصرية وتضعها على المستند. وهو مهم خصوصًا للمستندات التي تفتقر إلى طبقة نصية لكنها تحتوي على محتوى ذي صلة بالأعمال. وعادةً ما تعيد أدوات OCR قائمة بالكلمات أو أسطر النص مع الصناديق المحيطة التي تحتويها.
الإجابة عن الأسئلة البصرية
تقوم VQA على الإجابة عن أسئلة نصية استنادًا إلى صورة أو مستند. ومثال بديهي على نظام ذكاء اصطناعي يفعل ذلك روبوت محادثة يمكنك أن تسأله عن مستند. لنفترض أننا حمّلنا التقرير الربعي لإحدى الشركات إلى النظام، وطرحنا على نظام الذكاء الاصطناعي التوليدي الأسئلة الرئيسية لتسريع تحليلنا، متوقعين أن يقدم إجابات صحيحة بالاستناد إلى المستند. ببساطة، هكذا تعمل أنظمة VQA.
يمكنك تجربة VQA على HuggingFace Spaces باستخدام نموذج التعلّم العميق Donut.
استخراج المعلومات الرئيسية
أعتبر هذه إحدى المهام ذات الإمكانات الأكبر. فهي تتيح لك استخراج المعلومات من مستند بصيغة منظمة من أزواج مفتاح–قيمة. وبمجرد تحويل المستند إلى قاموس، يمكن استخدام تلك البيانات المنظمة بحرية – مثل تمريرها إلى أنظمة أخرى، أو تشغيلها عبر منطق الأعمال، أو استخدامها للتحقق من الحقول وبيانات الفواتير وغيرها – مما يؤتمت العمل البشري المتكرر.
المصدر
يُبنى KIE عادةً بالجمع بين مهمتين: التعرف على الكيانات الدلالية (Semantic Entity Recognition، أو SER) واستخراج العلاقات (Relation Extraction، أو RE). تسند الأولى فئة إلى كل كلمة في المستند وتكوّن كيانات متصلة (عادةً بفئتي «سؤال» و«إجابة»)، بينما تحدد الثانية ما إذا كانت هناك علاقات بين الكيانات. وبالفئات والعلاقات في أيدينا، يمكننا تحويل هذه المعلومات إلى قاموس من أزواج مفتاح–قيمة.
الخلاصة
شرحتُ في هذه المقالة ما المعالجة الذكية للمستندات وما المهام التي تتضمنها. ووصفتُ المزايا التي أراها في استخدام أنظمة الذكاء الاصطناعي هذه لمعالجة المستندات، وغطيتُ بإيجاز المهام التي يتولاها Document AI، ورسمتُ تصورًا لتطبيقاتها التجارية المحتملة. وآمل أن تكون، بعد قراءة هذا، قد كوّنت فكرة عامة عن تقنيات الذكاء الاصطناعي التي يمكن أن تدعمك في معالجة المستندات المؤتمتة. وستتناول المنشورات القادمة بمزيد من التدقيق مشكلات محددة وكيف تحلّها خوارزميات الذكاء الاصطناعي – ترقّب المزيد!