Ինչո՞վ է TigerBeetle-ը արժանի ուշադրության
TigerBeetle-ը կրկնօրինակվող, բարձր հասանելիությամբ ֆինանսական տվյալների բազա է՝ ֆիքսված սխեմայով և արտադրողականության վրա կենտրոնացմամբ, և այն գրավում է թվացյալ անհամաչափ մեծ ուշադրություն։ Ինչո՞ւ է այսքան աղմուկ։ Ինչո՞վ է TigerBeetle-ը հետաքրքիր։
TigerBeetle. կրկնօրինակվող, բարձր հասանելիությամբ ֆինանսական տվյալների բազա՝ ֆիքսված սխեմայով և արտադրողականության վրա կենտրոնացմամբ։ Սա քիչ թե շատ ամփոփում է նախագծի էությունը։ Այդուհանդերձ, TigerBeetle-ը գրավում է թվացյալ անհամաչափ մեծ ուշադրություն։ Ինչո՞ւ է այսքան աղմուկ։ Ինչո՞վ է TigerBeetle-ը հետաքրքիր։
Եկեք խորանանք։
TigerBeetle-ը SQL-ի աչքերով
Սկսենք բավականին սովորական տեսանկյունից։ Ընթերցողների մեծ մասը հավանաբար ուժեղ SQL փորձ ունի, և ռելյացիոն տվյալների բազաները ձևավորում են այն, թե ինչպես ենք մենք գնահատում տվյալների բազաների այլ համակարգերը (նույնիսկ երբ ինչ-որ բան ռելյացիոն տվյալների բազա չէ, մենք այն անվանում ենք «NoSQL»)։
Ռելյացիոն տվյալների բազայից տարբերվելով՝ TigerBeetle-ի սխեման ֆիքսված է և ունի ընդամենը երեք «էության տեսակ»՝ ledger-ներ, հաշիվներ և փոխանցումներ։ Յուրաքանչյուր էության տեսակ ունի սյունակների որոշակի քանակ, յուրաքանչյուրը՝ որոշակի տիպի։ Սխեման կարող եք պատկերացնել որպես ERP դիագրամ:
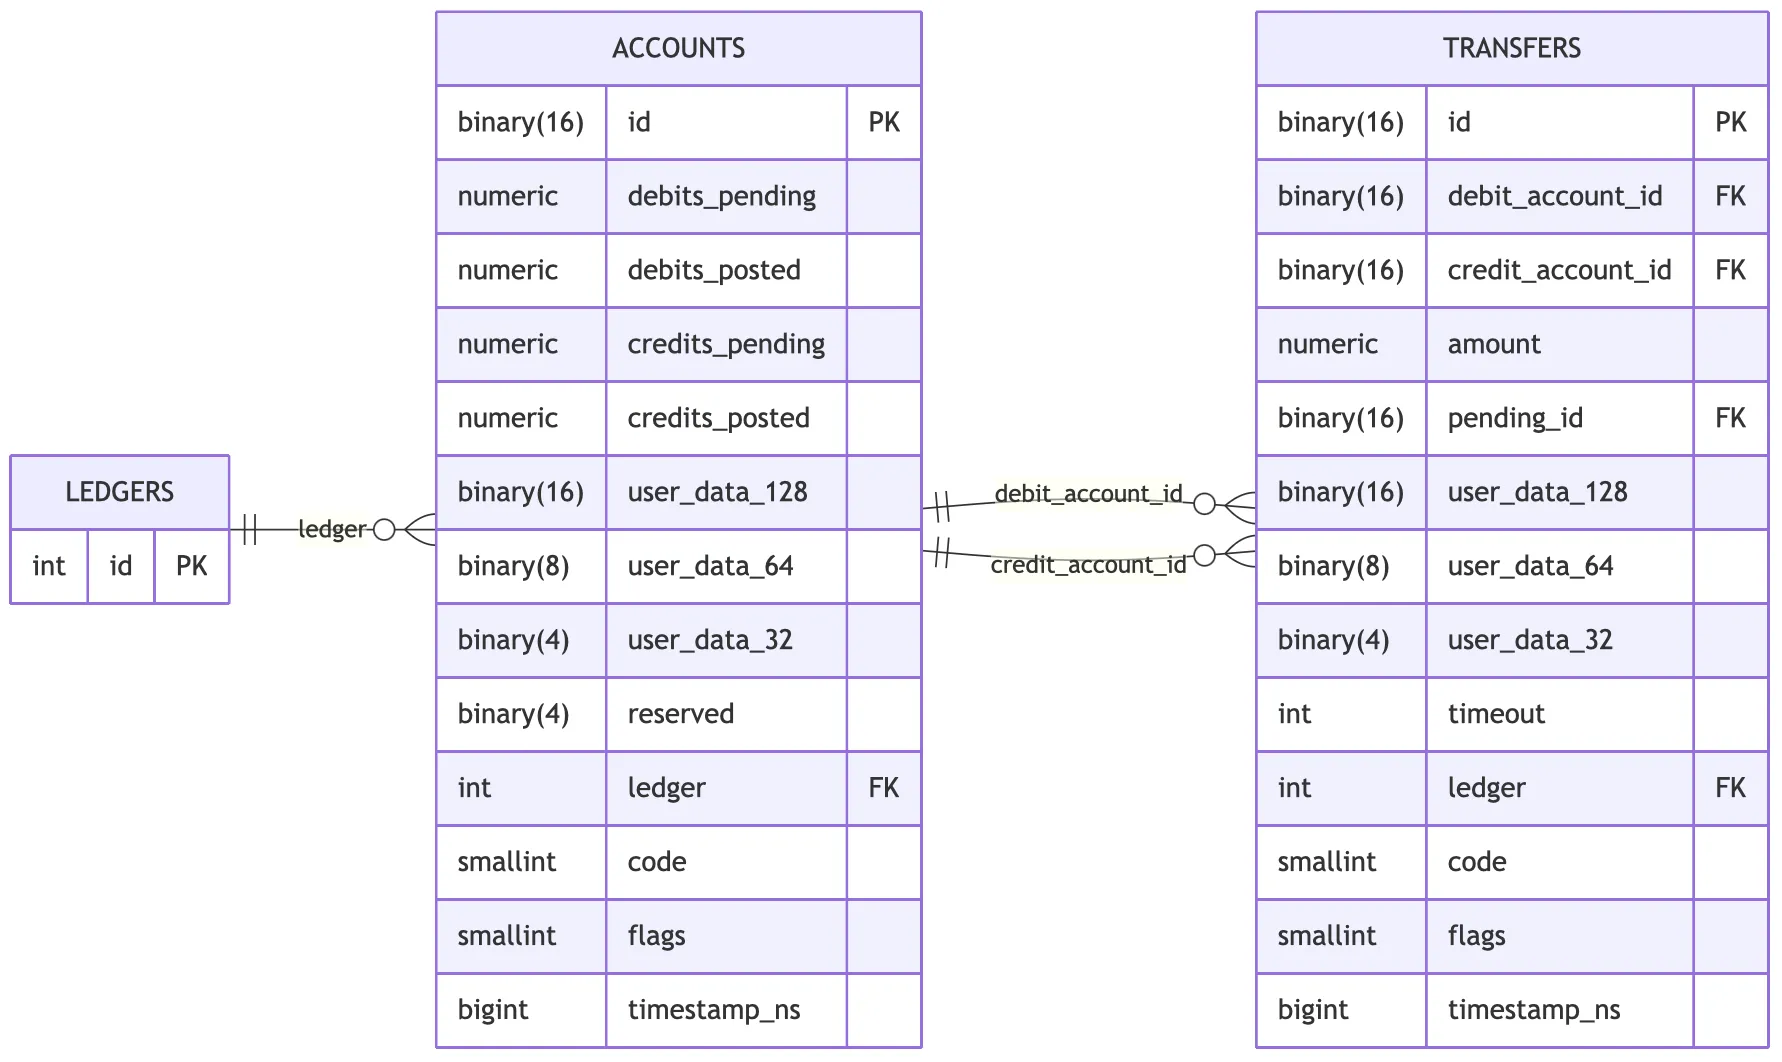
Սխեման իրականացնում է հայտնի հաշվապահական հասկացություն՝ կրկնակի գրառմամբ հաշվապահություն։ Սկիզբ առնելով Միջնադարից՝ այն հիմնված է մի պարզ կանոնի վրա. յուրաքանչյուր փոխանցում միշտ ներառում է երկու հաշիվ, մեկը՝ դեբետագրվող, մյուսը՝ կրեդիտագրվող։ Այլ կերպ ասած՝ գումարը (կամ ցանկացած հետևվող ռեսուրս) երբեք չի անհետանում և երբեք չի հայտնվում դատարկությունից։
Եթե երբեք չեք աշխատել հաշվապահությունում, տերմինները կարող են այնքան էլ ծանոթ չլինել։ Այդ պատճառով TigerBeetle-ը գրել է ներածական ուղեցույց, որը ձեզ կուղղորդի հաշվապահության 101 մակարդակին։ Այն ինքնին հետաքրքիր և ուսուցողական է, նույնիսկ եթե հենց TigerBeetle-ը ձեզ առանձնապես չի հետաքրքրում։
Ինչ է OLTP-ն
TigerBeetle-ը ներկայանում է որպես OLTP տվյալների բազա (online transaction processing), մի ոլորտ, որը ավանդաբար պատկանում է SQL տվյալների բազաներին։ OLTP-ն հակադրվում է OLAP-ին (online analytical processing, օրինակ՝ ClickHouse)։
TigerBeetle-ը, սակայն, լրացուցիչ տարբերակում է անում։ Մի կողմից OLGP-ն է (online general purpose), կատեգորիա PostgreSQL-ի, MySQL-ի և այլնի համար. մյուս կողմից «իսկական» OLTP-ն է, որը զբաղվում է իրական ժամանակի գործարքներով, և որին պատկանում է TigerBeetle-ը։
Տվյալների բազան OLGP է, թե OLTP, երևում է նաև նրանից, թե ինչպես է այն սովորաբար օգտագործվում։ OLGP տվյալների բազաներում ընթերցումները սովորաբար գերազանցում են գրառումները։ OLTP-ում այն, ինչ դուք անում եք, հիմնականում նոր փոխանցումների ստեղծումն է։ TigerBeetle-ը օպտիմալացված է գրառումներով ծանրաբեռնված աշխատանքային բեռների համար։
Համաձայնեցվածություն (Consistency)
SQL տվյալների բազան մեզ տալիս է մեկուսացման մակարդակների ընտրություն (repeatable read, snapshot isolation և այլն), և մեկն ընտրելով՝ մենք անուղղակիորեն որոշում ենք, թե որ «երևույթների» (ինչպիսիք են phantom read, lost updates և այլն) կարող ենք հանդիպել։
TigerBeetle-ը ամեն ինչ պահում է շատ ավելի պարզ. դուք ստանում եք խիստ սերիալիզացիա (strict serializability)՝ առանց այլընտրանքների։ Գործարքները միշտ կատարվում են հաջորդաբար, մեկ առ մեկ, և յուրաքանչյուրը տեսնում է իրենից առաջ գործարքների բոլոր հետևանքները։
Աշխատանք տվյալների հետ. ներդրում և հարցումներ
Դուք TigerBeetle-ի հետ խոսում եք ոչ թե SQL-ի կամ հատուկ հարցումների լեզվի, այլ API-ի միջոցով։ Ամենատարածված ծրագրավորման էկոհամակարգերի համար գոյություն ունեն կլիենտ գրադարաններ, և կարող եք նաև պարզապես օգտագործել փաթեթավորված CLI կլիենտը։
TigerBeetle-ի յուրաքանչյուր տվյալ անփոփոխ է, ուստի ամենը, ինչ կարող եք անել, ներդնելն է (և հարցում անելը)։ Չկան UPDATE-ներ, DELETE-ներ կամ ALTER SCHEMA-ներ, քանի որ սխեման ֆիքսված է։
Ներդրումը գալիս է երեք հնարավորությամբ, որոնք էական են TigerBeetle-ի շատ օգտագործման դեպքերի համար։
Նախ՝ կարող եք պահանջել, որ հաշվի մնացորդը երբեք չիջնի 0-ից ցածր։ Ցանկացած փոխանցում, որը կխախտի այս կանոնը, մերժվում է։ Քանի որ փոխանցումները կիրառվում են հաջորդաբար ընթացիկ վիճակի վրա, ընդունված փոխանցումը նշանակում է, որ կարող եք վստահ լինել, որ հաշվի մնացորդը դա թույլ է տալիս։
Հետո՝ փոխանցումները կարող են միացվել շղթայի։ TigerBeetle-ը երաշխավորում է, որ շղթայի փոխանցումները կա՛մ բոլորն ընդունվում են, կա՛մ բոլորը մերժվում։ Շղթայի փոխանցումները կարող են վերաբերել նույն հաշիվներին կամ բոլորովին տարբեր ledger-ների տարբեր հաշիվների։
Վերջապես՝ կարող եք ստեղծել «սպասման մեջ գտնվող» (pending) երկփուլ փոխանցումներ, որոնք միայն ամրագրում են գումարը. այդպիսի փոխանցումը կարող է ունենալ ժմչփ՝ արտահայտված վայրկյաններով՝ ամրագրումը կատարվելու պահից հաշված։ Սպասման մեջ գտնվող փոխանցումը հետագայում կարող է հաստատվել (վերջնականացվել) կամ չեղարկվել։ Վարկային քարտերի նախնական թույլտվությունները կամ ժամանակով սահմանափակված տեղերի ամրագրումները լավ պատկերացում են տալիս, թե ինչպես է դա աշխատում։
Փոխանցումներ ստեղծելու առանցքային կողմն այն է, որ յուրաքանչյուր փոխանցում ունի եզակի ID, որը պետք է վերագրի վերջնական կլիենտը։ Վերջնական կլիենտն այստեղ նշանակում է դիտարկիչը կամ մոբայլ հավելվածը, այլ ոչ թե որևէ միջանկյալ API շերտ։ Յուրաքանչյուր ID պետք է պահվի (օրինակ՝ կլիենտի տեղային պահոցում) և ապա վերօգտագործվի ցանկացած կրկնակի փորձի ժամանակ։ Այն գործում է որպես idempotency բանալի՝ երաշխավորելով, որ դուք կվճարեք միայն մեկ անգամ նույնիսկ անհուսալի ցանցում։
TigerBeetle-ը ավելի մեծ համակարգի մեջ
TigerBeetle-ը նպատակ ունի ապահովել գերազանց գրառման արտադրողականություն և դրա շրջանակում «օժանդակ» հնարավորությունները պահում է նվազագույնի։ Դուք ստանում եք տվյալների բազա, որը կենտրոնացած է տվյալների անվտանգության (դրա մասին՝ ստորև) և հնարավորինս արագ գրելու վրա, բայց առանց որևէ բանի անվտանգության կամ նույնականացման համար. այն ենթադրում է, որ աշխատում է վստահելի միջավայրում վստահելի օգտատերերի հետ։
Այդ պատճառով TigerBeetle-ը միշտ պետք է գտնվի ինչ-որ gateway-ի հետևում։ Gateway-ը երկու գործ ունի՝ անվտանգություն և batching։ Նախ՝ այն պետք է ապահովի, որ իր փոխանցած յուրաքանչյուր հարցում պատշաճ կերպով նույնականացված է։ Երկրորդ՝ այն պետք է հարցումները խմբավորի (batch)՝ լավագույն արտադրողականություն ստանալու համար։ Յուրաքանչյուր կլիենտային սեսիա կարող է ունենալ միայն մեկ ընթացքի մեջ գտնվող հարցում, ուստի մինչ TigerBeetle-ը աշխատում է մեկ batch-ի վրա, gateway-ը պետք է հավաքի փոխանցումները հաջորդի համար։
Թեև նույնականացումը պատկանում է gateway-ին, պետք է համոզվեք, որ gateway-ը չի վերածվում համակարգի խցանման։ Օրինակ՝ յուրաքանչյուր մուտքային փոխանցման համար SQL հարցում կատարելը՝ օգտատիրոջը գտնելու համար, բացառվում է։ Փոխարենը օգտագործեք թեթև մոտեցումներ, ինչպիսին JWT token-ի վալիդացիան է, կամ, եթե իսկապես այլ ելք չկա, օգտատիրոջ ստուգումը Redis քեշում։
Ընթերցման կողմում կարող եք TigerBeetle-ից խնդրել կոնկրետ փոխանցում կամ փոխանցումների տիրույթ, կամ ստանալ հաշվի ընթացիկ մնացորդը։ Դրանից դուրս ամեն ինչ պահանջում է պրոյեկցիայի կառուցում, որը կարող է դժվար լինել ձեռքով համաժամեցված պահել։ Բարեբախտաբար, TigerBeetle-ը տրամադրում է CDC data capture, որը յուրաքանչյուր փոխանցում հրապարակում է AMQP հերթում (օրինակ՝ RabbitMQ) at-least-once առաքմամբ։
Այսպիսով, այն համակարգի հղման ճարտարապետությունը, որտեղ TigerBeetle-ը մշակում է գործարքները, կարող է այսպիսին լինել.
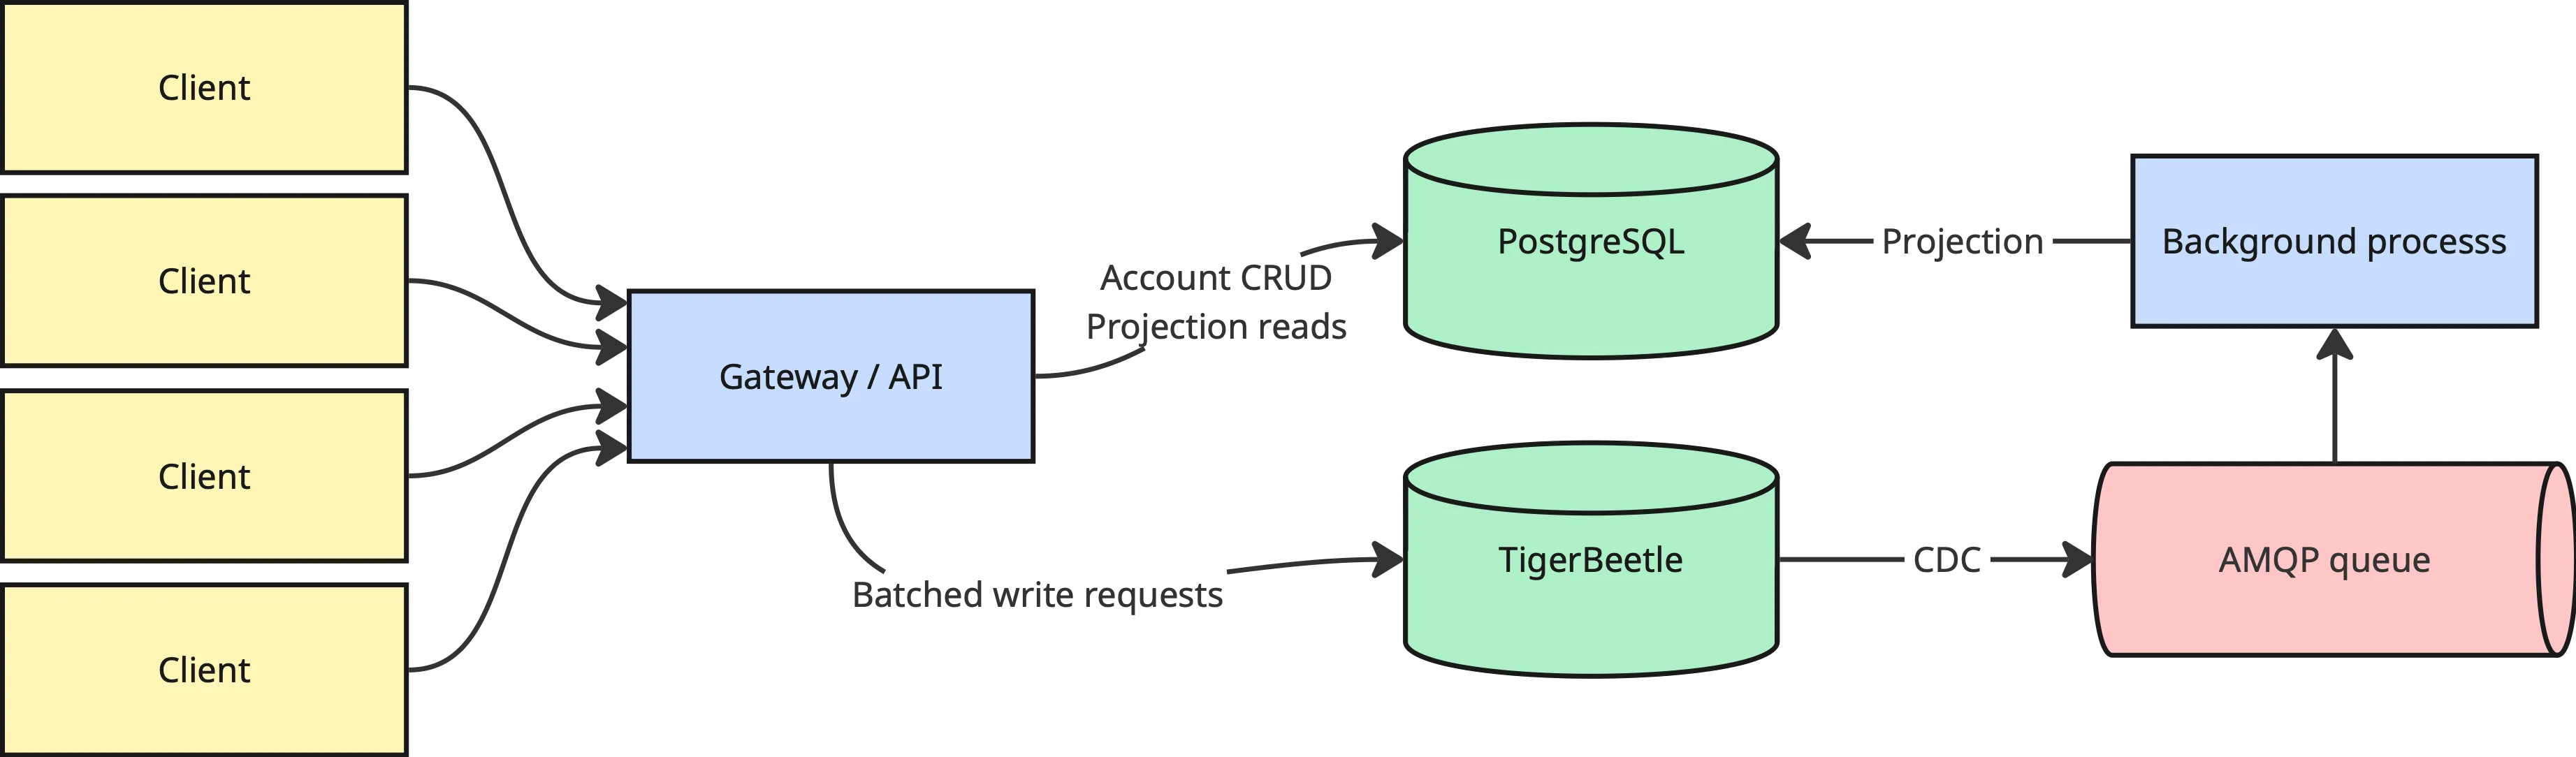
«Տաք գրառման ուղու» (hot write-path) վրա gateway-ը իդեալականորեն պետք է լինի առանց վիճակի (stateless)։ Մնացած ամեն ինչի համար այն կարող է և պետք է հենվի OLGP տվյալների բազայի վրա։ Այսպիսով, երբ օգտատիրոջ հաշիվ է ստեղծվում, դուք կստեղծեք հաշիվ բոլոր սովորական մանրամասներով SQL տվյալների բազայում, գումարած հաշիվ TigerBeetle-ում։
Շատ հավանական է, որ TigerBeetle-ի յուրաքանչյուր դեպլոյմենտ պետք է ունենա իր կողքին SQL տվյալների բազա. առաջինը հոգ է տանում բարձր մրցակցությամբ գրառումների մասին, իսկ երկրորդը մշակում է տվյալները, CRUD գործողությունները, պրոյեկցիաները և ընթերցման ու հարցումների բոլոր տեսակները։
Օգտագործման դեպքեր
Ֆիքսված սխեմայի դեպքում արդյո՞ք TigerBeetle-ը հարմար է միայն ֆինանսական հավելվածների համար։ Ոչ իսկապես. դեբետներն ու կրեդիտները կարող են մոդելավորել շատ բաներ՝ գումարից բացի։
Վերցրեք տոմսերի վաճառքը, որը միշտ հսկայական ճնշում է գործադրում տոմսավաճառության համակարգի վրա հանրաճանաչ միջոցառումների դեպքում (հաճախ այն կործանելով)։ Կամ API հասանելիության rate limiting-ը։
TigerBeetle-ի փաստաթղթերը ներառում են մի քանի բաղադրատոմս (recipes), բայց եթե մտածեք, սերվերազուրկ (serverless) համակարգում կրեդիտների հաշվառումը, էներգիայի չափումը և LLM token-ների օգտագործումը մեկ խնդրի տարբերակներ են՝ սահմանափակ ռեսուրսի հաշվառում և ապահովում, որ այն երբեք չանհետանա և չկեղծվի։ Ուստի TigerBeetle-ի օգտագործման դեպքերը հասնում են շատ ավելի հեռու, քան ֆինանսները։
Ինչպես են նախագծված տվյալների կրկնօրինակումն ու անվտանգությունը
TigerBeetle-ը կրկնօրինակվող տվյալների բազա է, որը երաշխավորում է, որ ընդունված փոխանցումը երկարակյաց կերպով պահվում է. այն երբեք չի կորչի (իհարկե, բացառությամբ յուրաքանչյուր replica-ի վրա տվյալների աղետալի կորստի)։ Առաջին հայացքից սա կարող է առանձնապես նոր չթվալ, քանի որ բազմաթիվ տվյալների բազաներ տվյալների անվտանգություն են խոստանում կրկնօրինակման միջոցով։
Սակայն երբ խորանում եք TigerBeetle-ի դիզայնի մեջ, սկսում եք գնահատել, թե քանի ձախողման սցենար է թիմը դիտարկել և շարունակում է թեստավորել տվյալների բազան դրանց դեմ։ Դրանք ընդգրկում են սկավառակի վրա պատահական բիթերի շրջում և սխալ ուղղված գրառումներ (որոնք, ըստ երևույթին, կարող են տեղի ունենալ, երբ տվյալները հայտնվում են սխալ offset-ում), սկավառակի և ցանցի grey failure-ներ (երբ ամեն ինչ աշխատում է, պարզապես չափազանց դանդաղ), մինչև պատահականորեն ընտրված հանգույցների հանկարծակի կամ աստիճանական մահը։
Եվ ուշադիր նայելով այլ տվյալների բազաներին՝ բոլոր տեսակի աղետների նկատմամբ նման դիմացկունությունը անգերազանցելի է։ Մենք fsyncgate-ից հետո շատ առաջ ենք անցել, բայց կասկածում եմ, որ շատ այլ տվյալների բազաներ կարող են պարծենալ դիմացկունության նման աստիճանով։
TigerBeetle-ը տվյալները տեղային մակարդակում պաշտպանում է՝ պահելով checksum-ներ յուրաքանչյուր տվյալների բլոկի համար (պահվում են տվյալներից առանձին), կազմակերպելով տվյալները որպես ծառ և ամեն ինչ hash-շղթայավորելով։ Hash-շղթայավորումը հնարավորություն է տալիս արագ ստուգել տվյալների համաձայնեցվածությունը. այս գաղափարը կարող եք ճանաչել git-ից կամ blockchain-ից։
Բաշխված տվյալների անվտանգության համար TigerBeetle-ը կոնսենսուսի վրա հիմնված կրկնօրինակվող վիճակի մեքենա է։ Մեկ լիդեր հանգույցը մշակում է ամբողջ տրաֆիկը՝ առանց շարդինգի կամ բեռի հավասարակշռման։ Հետևաբար մասշտաբավորումը նշանակում է ավելի արագ հիշողություն կամ ավելի արագ պրոցեսորներ ավելացնել («scale up»), այլ ոչ թե scale out։
Դա միտումնավոր է. օգտագործման դեպքերը, որոնց թիրախավորում է TigerBeetle-ը, հաճախ ներառում են տվյալներ, որոնք լավ չեն շարդավորվում՝ դեպքեր, երբ մի քանի «տաք» հաշիվներ մասնակցում են գործարքների մեծ մասին։ Դրա վրա ավելանում է, որ ամեն ինչ տեղային պահելը շատ հեշտացնում է համաձայնեցվածության և խիստ սերիալիզացիայի երաշխավորումը։ Ավելին, TigerBeetle-ի ամբողջ պրոցեսն աշխատում է մեկ թելի (thread) վրա՝ օգտագործելով մեկ CPU միջուկ։ Եվ այն դեռ շլացուցիչ արագ է։ (Կամ գուցե հենց այդ պատճառո՞վ։)
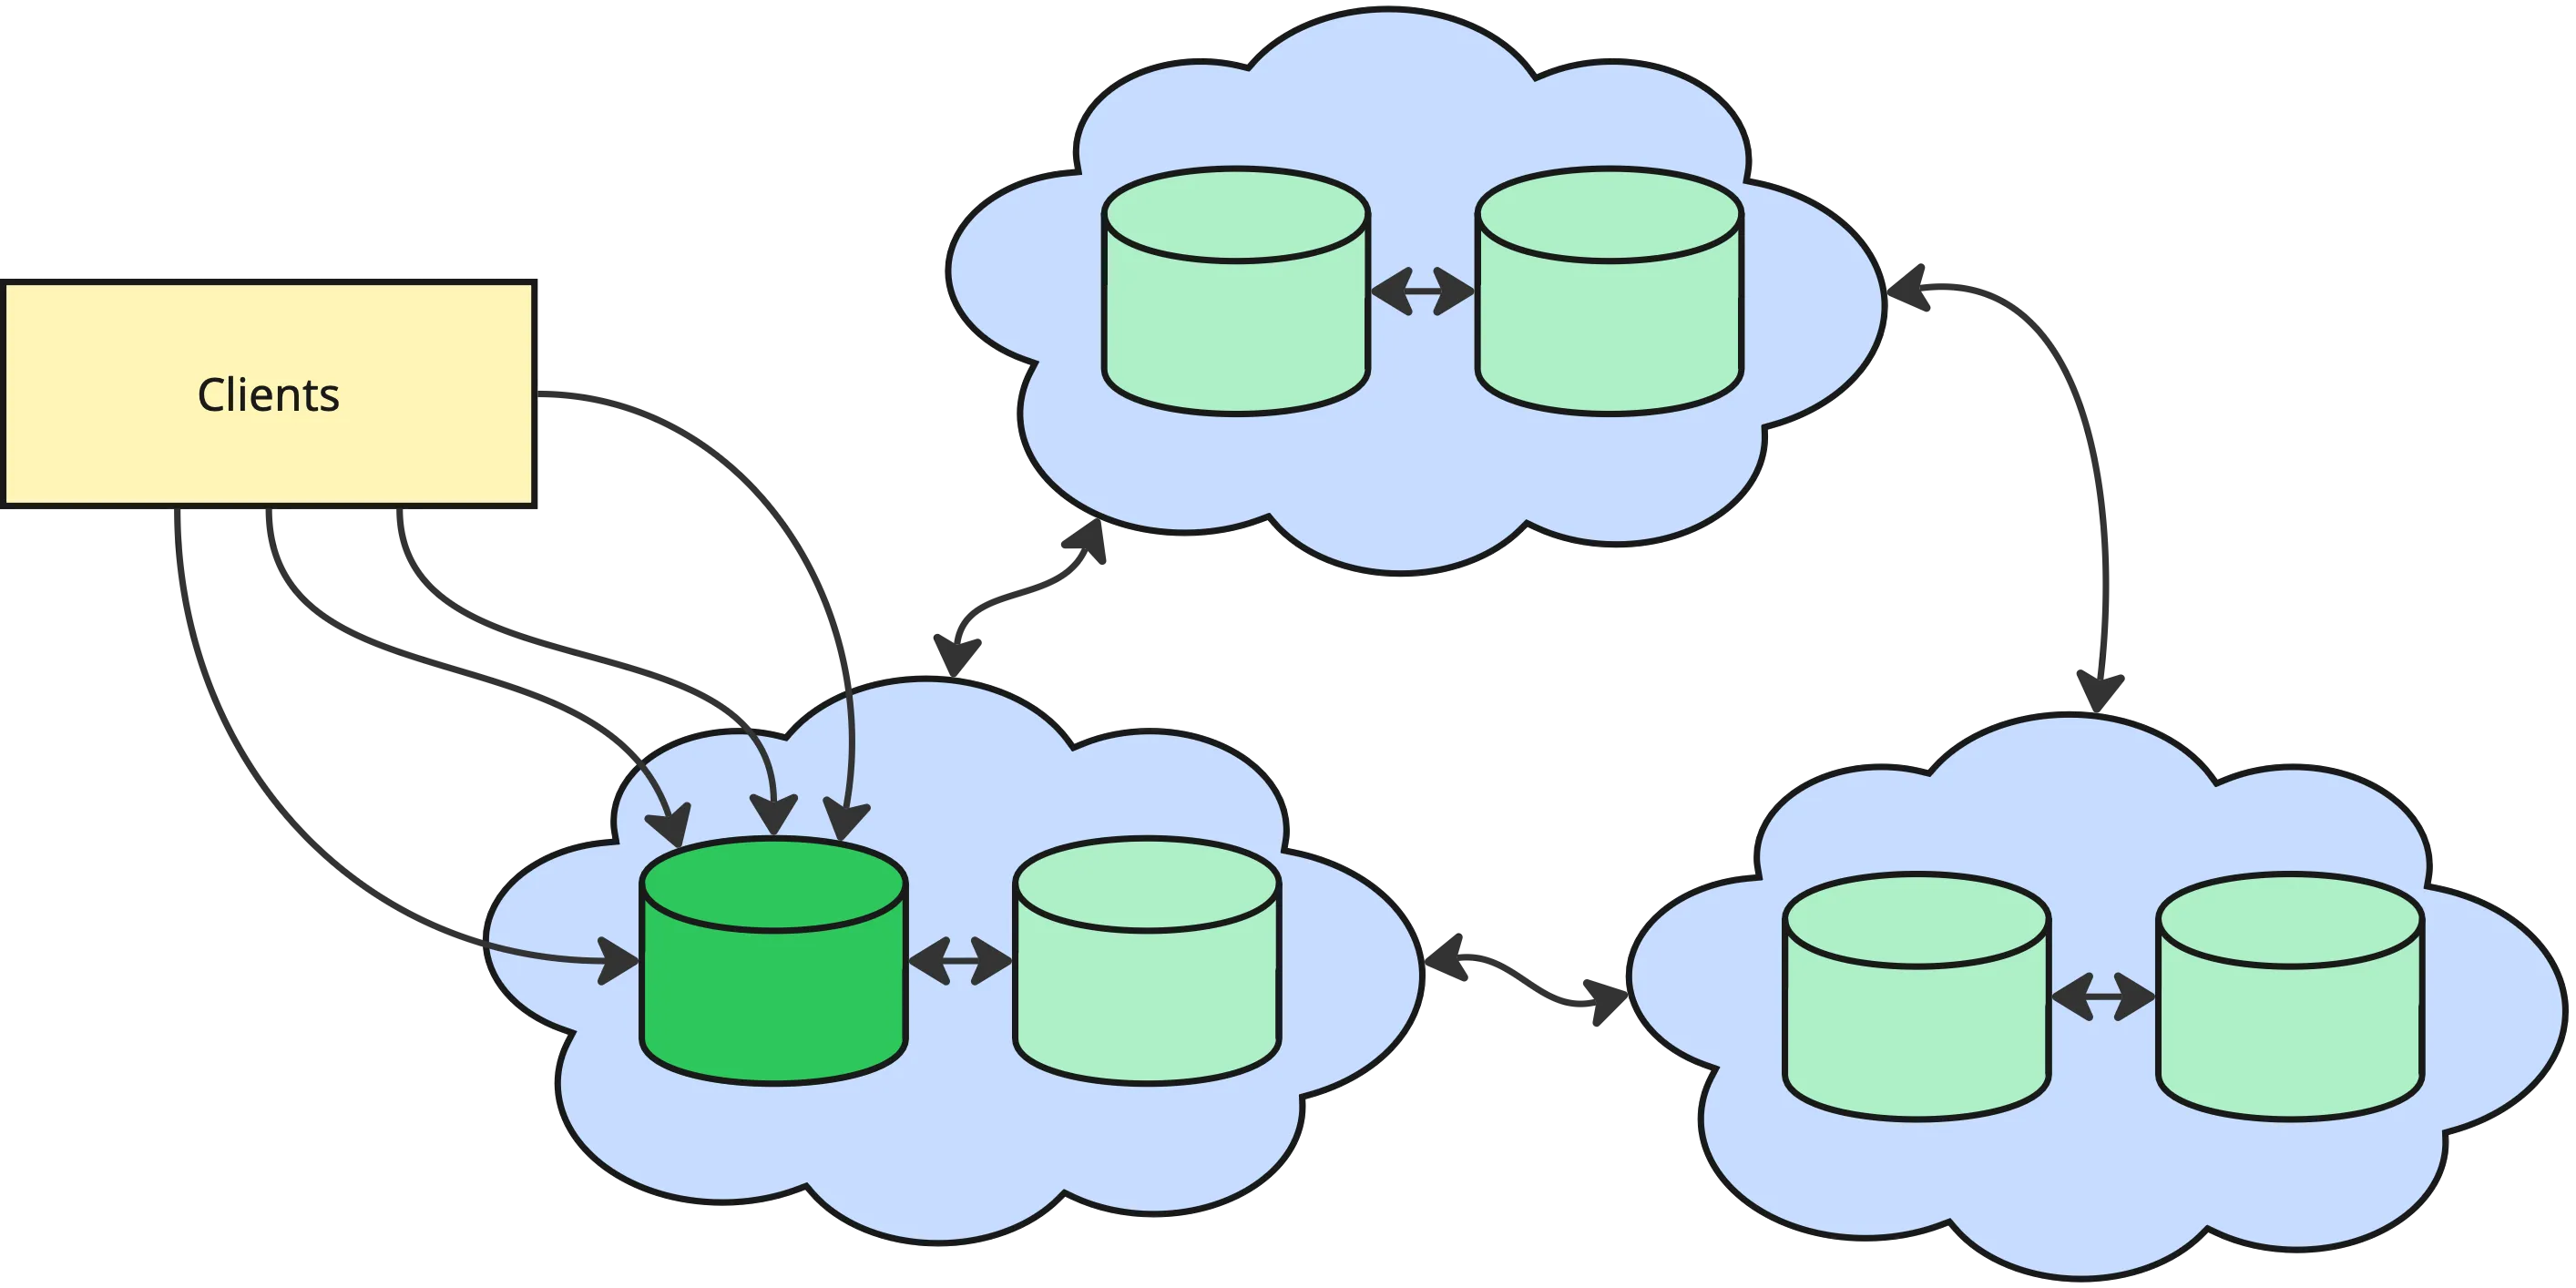
TigerBeetle-ը խորհուրդ է տալիս 6 հանգույցով դեպլոյմենտ։ Սա անսովոր է, քանի որ սովորական խորհուրդը կենտ թվով հանգույցներն են, որպեսզի քվորումները հեշտ ձևավորվեն։ Գաղափարն այստեղ 3 ամպային պրովայդերների վրա բաշխելն է, որոնք գտնվում են միլիվայրկյաններ հեռավորության վրա, յուրաքանչյուրը 2 հանգույցով։ Այդպես մեկ պրովայդերի լիարժեք խափանումը չի կանգնեցնի ձեր համակարգը։ Բացի այդ, գրառման քվորումը բաղկացած է լիդերից գումարած 2 այլ հանգույցից, ուստի քանի դեռ լիդերը աշխատում է, հանգույցների միայն կեսն է պետք։ Նոր լիդեր ընտրելը, սակայն, պահանջում է մեծամասնություն։
Կրկնօրինակումը սինխրոն է, ինչը նշանակում է, որ մինչ դուք պատասխան եք ստանում, ձեր տվյալները երաշխավորված անվտանգ են՝ գրված սկավառակի վրա և կրկնօրինակված կլաստերով մեկ։ TigerBeetle-ը խթանում է ագրեսիվ batching (մինչև 8k փոխանցում մեկ հարցումում)՝ ինչպես հարցումների, այնպես էլ հետագայում կլաստերի ներսում կրկնօրինակման ժամանակ։
Կրկնօրինակման ալգորիթմ
Կոնսենսուսի վրա հիմնված կրկնօրինակվող վիճակի մեքենայի մասին կարդալիս կարող են մտքում գալ այնպիսի ալգորիթմներ, ինչպիսիք են Multi-Paxos-ը կամ Raft-ը։ TigerBeetle-ը, սակայն, օգտագործում է այլ ալգորիթմ՝ Viewstamped Replication (VR)։ Այն ավելի քիչ հայտնի է, բայց ստեղծվել է Paxos-ի հետ միաժամանակ՝ նրանից անկախ։
Կարելի է պնդել, որ երեք մոտեցումները (Paxos, Raft, VR) կիսում են նույն հիմնական ալգորիթմը։ Սատանան, բնականաբար, մանրուքների մեջ է։ Raft-ը ամենահեշտն է հասկանալու համար, բայց նաև ունի ամենաշատ սահմանափակումները, հատկապես անմաքուր անջատումների և վերականգնման շուրջ։ Paxos-ը սկզբում զուտ կոնսենսուսի ալգորիթմ էր և հետագայում ընդլայնվեց բազմաթիվ արժեքների համար՝ որպես Multi Paxos, մինչդեռ VR-ը աշխատում է անմիջապես կրկնօրինակվող լոգի հետ։
VR-ը հավանաբար ընտրվել է Paxos-ի փոխարեն, քանի որ այն ավելի հեշտ է իրականացնել՝ միաժամանակ առաջարկելով հենց այն պրիմիտիվները, որոնք անհրաժեշտ էին TigerBeetle թիմին։ Այն նաև ավելի լավ է աշխատում (ավելի քիչ round-trip-երով)։
Թեստավորում
TigerBeetle-ը անցնում է ընդարձակ թեստավորում՝ օգտագործելով մի քանի նորարար տեխնիկա։
Առաջինը VOPR-ն է (Viewstamped Operation Replicator), որն ապահովում է Deterministic Simulation Testing (DST) TigerBeetle կլաստերի համար։ VOPR-ը կառուցվում է տվյալների բազայի հետ միասին և աշխատում է անդադար՝ որոնելով սխալներ կոդային բազայում։ Երբ այն գտնում է մեկը, դուք ստանում եք պատահական seed և ճշգրիտ հետք, որը ցույց է տալիս, թե ինչպես վերարտադրել խնդիրը տեղային մակարդակում։
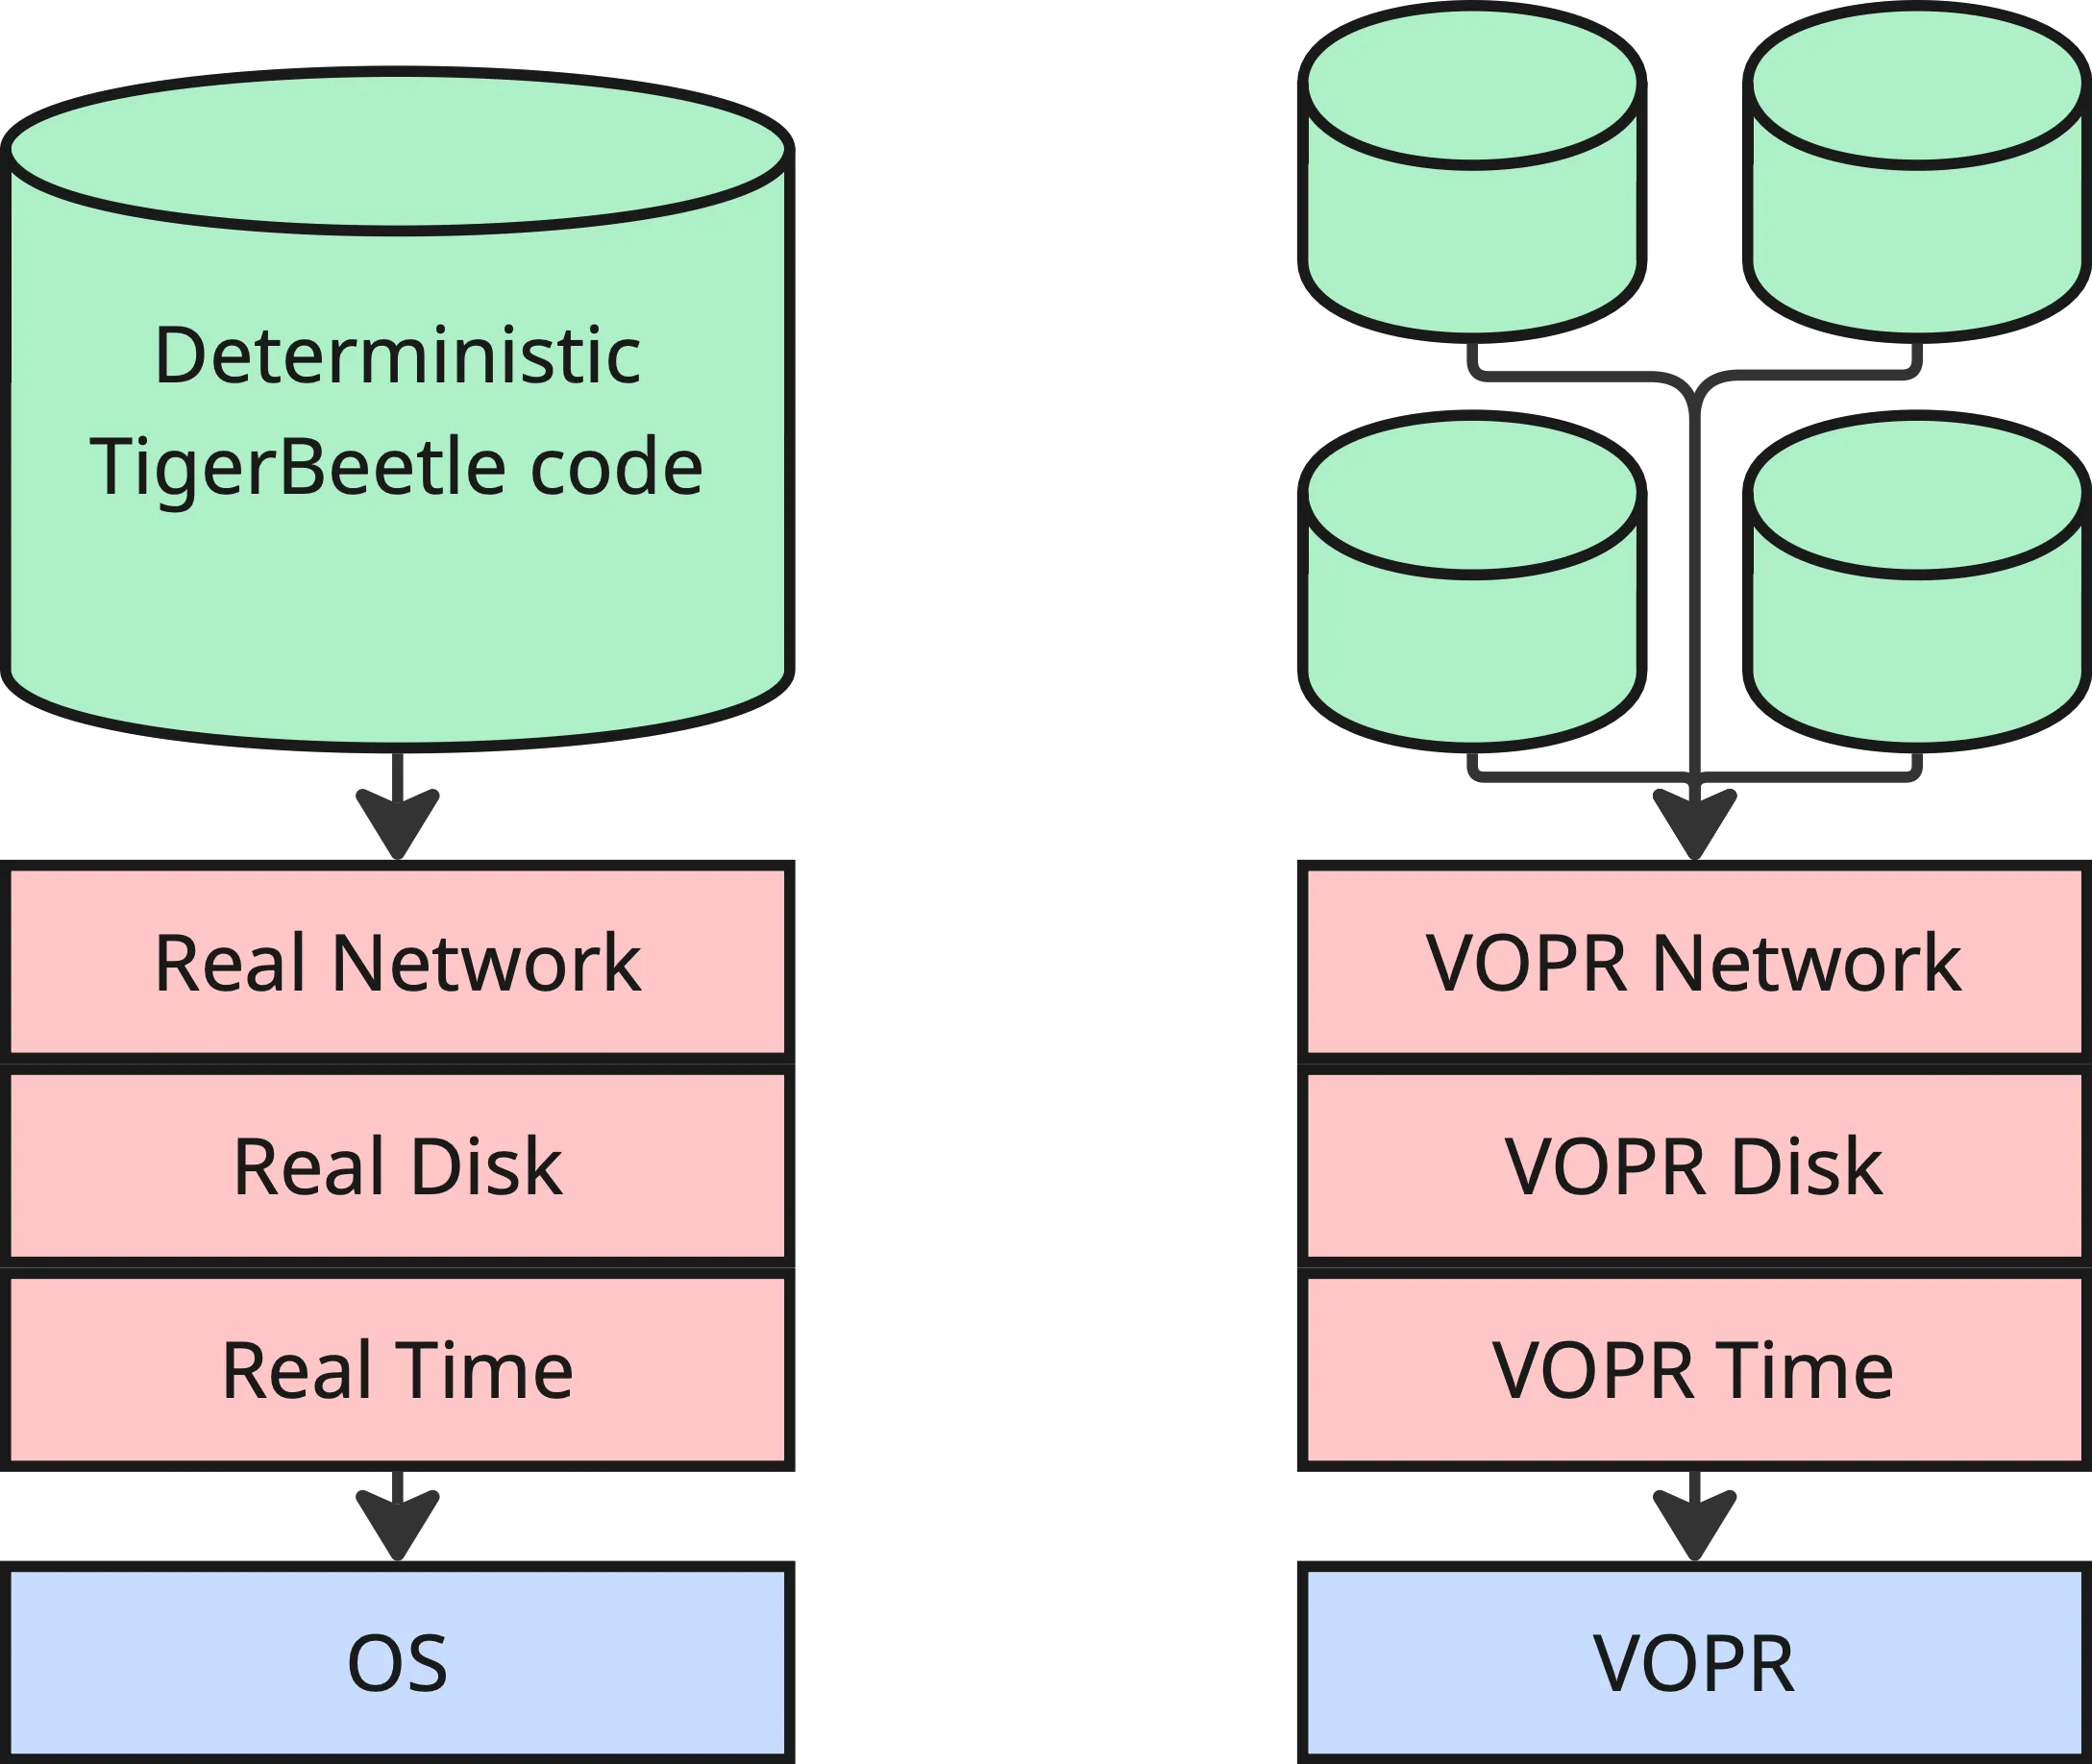
VOPR-ը տրամադրում է փոխարինող իրականացումներ ոչ դետերմինիզմի յուրաքանչյուր աղբյուրի համար՝ սկավառակ, ցանց և համակարգային ժամացույց։ Այն կարող է սիմուլյացնել TigerBeetle-ի ամբողջ կլաստերը մեկ միջուկի վրա և արագացնել ժամանակը՝ սեղմելով TigerBeetle-ի աշխատանքի մեկ ամիսը մեկ ժամի մեջ։ Այն կարող է նաև ներարկել բոլոր տեսակի խափանումներ, ինչպիսիք են կորած հաղորդագրությունները կամ սիմուլյացված վատ սեկտորները։
TigerBeetle-ը թեստավորվել է նաև Antithesis-ով՝ DST-ի այլ մոտեցմամբ, որն աշխատում է Docker կոնտեյների մակարդակում։ Antithesis-ը նույնպես կարող է ներարկել սկավառակի և ցանցի խափանումներ, բայց չունի VOPR-ի առաջարկած սերտ ինտեգրացիան։
Վերջապես, TigerBeetle-ի Jepsen թեստերը բացահայտեցին միայն երկու տվյալների անվտանգության խնդիր՝ բացակայող հարցման արդյունքներ և խնդիրներ վրիպազերծման API-ի հետ (երկուսն էլ հետո ուղղվել են)։ Վերլուծությունը նշում է, որ TigerBeetle-ը ցուցաբերում է բացառիկ դիմացկունություն սկավառակի խափանումների նկատմամբ։ Գտնվել են նաև մի քանի խնդիրներ, որոնք վերաբերում են կլիենտի կամ տվյալների բազայի կրաշերին թարմացումների ժամանակ։ Ընդհանուր առմամբ, սակայն, համեմատելով Jepsen-ի բացահայտումները տարբեր տվյալների բազաների միջև՝ TigerBeetle-ի արդյունքները արտացոլում են իսկապես ամուր դիզայն։
Ուշագրավ ինժեներական որոշումներ
Թիմը կայացրել է շատ հետաքրքիր ինժեներական որոշումներ։ TigerBeetle-ի մոտեցումը, իհարկե, բոլորի համար չէ՝ հաշվի առնելով օգտագործման դեպքի առանձնահատկությունը, բայց միշտ կա ինչ-որ բան սովորելու։ Մասնակի ցանկ.
- TigerBeetle-ը գրված է Zig-ով՝ համակարգային ծրագրավորման լեզվով։ Rust-ը և C-ն երկուսն էլ քննարկվել են, բայց Zig-ը հավանաբար ընտրվել է հիշողության նուրբ վերահսկողության, էրգոնոմիկայի, չսահմանված վարքագծերի բացակայության (ի տարբերություն C-ի) և ցածր մակարդակի տվյալների բազայի նախագծին անհրաժեշտ ճշգրիտ հնարավորությունների շնորհիվ։
- Ամբողջ հիշողությունը հատկացվում է նախապես. ոչինչ դինամիկ կերպով չի հատկացվում։
- Ամեն ինչ դետերմինիստական կերպով աշխատում է մեկ միջուկի վրա։
- Ամբողջ I/O-ն ուղղակի է՝ շրջանցելով միջուկի page cache-երը և բուֆերավորումը։
- TigerBeetles-ը պահում է «կլաստերային ժամացույց», որը երաշխավորում է, որ ժամանակային դրոշմները միշտ աճում են։ Եթե որևէ հանգույց ցուցաբերում է չափազանց մեծ ժամանակային շեղում, այդ հանգույցը կրաշ է լինում։
- Կոդը հետևում է Tiger style-ին, որը հիմնված է NASA-ի power-of-ten կանոնների վրա և նպատակ ունի «ճիշտ անել առաջին անգամից»։ Կոդի մակարդակում ռեկուրսիան արգելված է, assertion-ները ամենուր են, թույլատրվում են միայն պարզ աբստրակցիաներ, մեթոդները չեն կարող գերազանցել 70 տողը և այլն։ Դիզայնի մակարդակում շատ նախաձեռնողական մտածողություն և հետազոտություն է տեղի ունենում նախքան որևէ կոդ գրելը։
TigerBeetle. նոր սերնդի տվյալների բազաների սկիզբը՞
TigerBeetle-ի CEO-ն և հիմնադիրը պնդում է, որ 2018 թվականի երկու իրադարձություն նոր գլուխ բացեցին տվյալների բազաների մշակման մեջ՝ fsyncgate-ը (ինչպես են տվյալների բազաները հաղթահարում սկավառակի գրառման ձախողումները և I/O բուֆերավորումը) և խափանումներից հետո protocol-aware վերականգնումը։ Երկուսն էլ ազդել են TigerBeetle-ի նախագծման վրա։
Նա կարծում է, որ մենք կարող ենք տեսնել նոր տեսակի տվյալների բազայի առաջացում. այնպիսի մեկի, որը կառուցվում է տարիների, այլ ոչ թե տասնամյակների ընթացքում։ Սա հնարավոր է դարձել այնպիսի նվաճումներով, ինչպիսիք են DST-ն, Direct I/O-ն, io_uring-ը, համակարգային ծրագրավորման նոր լեզուները (Zig, Rust) և բացահայտ խափանումների մոդելները, որոնք բոլորն արագացնում են տվյալների բազաների մշակումը։
TigerBeetle-ը լիովին կարող է լինել տիրույթին հատուկ, շլացուցիչ արագ և երկարակյաց տվյալների բազաների նոր սերնդի առաջատար սագը։