Kafka առանց ZooKeeper-ի
Apache Kafka-ն և Apache ZooKeeper-ը տարիներ շարունակ գնում էին ձեռք ձեռքի տված։ Այս հոդվածը բացատրում է, թե ինչպես է աշխատում քվորումի վրա հիմնված նոր Kafka-ն և ինչով է այն տարբերվում ZooKeeper-ից կախված տարբերակից, բայց սկզբում տեսնենք, թե ինչպես սկսվեց այդ ամենը։
Apache Kafka-ն և Apache ZooKeeper-ը տարիներ շարունակ գնում էին ձեռք ձեռքի տված։ Kafka-ն պատասխանատու էր հաղորդագրությունների հուսալի առաքման համար pub/sub API-ի հետևում, իսկ ZooKeeper-ը հանդես էր գալիս որպես կլաստերի մետատվյալների բաշխված պահոց։ ZooKeeper-ը հետևում էր, թե որ ռեպլիկան որ պարտիցիան է ղեկավարում, ինչպես են պարտիցիաները բաշխված բրոքերների միջև, սպառողների օֆսեթներին և շատ ավելին։ Երբ Kafka-ն ստեղծվում էր, ZooKeeper-ի ընտրությունը մեծ բեռ հանեց Kafka-ի մշակողների ուսերից. նրանք կարող էին ապավինել փորձված բաղադրիչին՝ իրենց հաղորդագրությունների համակարգի համընկնողությունը (consistency) պահպանելու համար։
Այս լուծումը, սակայն, ունի իր թերությունները։ Այն դժվարացնում է շահագործումը. կան երկու առանձին ինֆրաստրուկտուրային բաղադրիչներ, որոնք պետք է կարգավորել, պաշտպանել և մոնիթորինգ անել։ Այն նաև Kafka-ին վաստակեց սպասարկման համար դժվար և ինֆրաստրուկտուրայի համար ծանր լինելու համբավ։ Եվ քանի որ Kafka-ն ինքն էլ բաշխված համակարգ է, ZooKeeper-ի բոլոր պարտականությունները աստիճանաբար Kafka-ի մեջ տեղափոխելու գաղափարը շատ գրավիչ էր։
Այս հոդվածում ես կներկայացնեմ, թե ինչպես է աշխատում քվորումի վրա հիմնված նոր Kafka-ն և ինչով է այն տարբերվում նախորդից, բայց սկզբում տեսնենք, թե ինչպես սկսվեց այդ ամենը։
Թարմացում. Apache Kafka 4.0.0-ն ամբողջովին հեռացրեց ZooKeeper-ը և փոխարինեց այն KRaft-ով։
Հայացք պատմությանը
Ճանապարհը պաշտոնապես սկսվեց մոտ 2019 թվականին, երբ ստեղծվեց KIP-500-ը (KIP-ը նշանակում է Kafka Improvement Proposal)։ KIP-500-ը հանդես եկավ որպես հովանոց մի քանի հաջորդող KIP-երի համար, որոնց բոլորի նպատակը Zookeeper-ի նոր ներքին փոխարինող կառուցելն էր։ 2021 թվականին 2.8 թողարկումը բերեց KRaft կոնսենսուսի մեխանիզմի վրա հիմնված քվորումային կոնտրոլերի նոր ռեժիմի բետա տարբերակը։ 3.0 տարբերակը այն առաքեց որպես նախադիտում։ 2022 թվականին Kafka 3.3-ը KRaft-ը հայտարարեց պրոդակշնի համար պատրաստ (թեև միայն նոր կլաստերների համար)։ Վերջերս թողարկված 3.5-ը առաջարկեց վաղ հասանելիություն՝ կլաստերները (առանց պարապուրդի) նոր, ZK-ազատ կոնֆիգուրացիային միգրացնելու համար, և նաև հայտարարեց Zookeeper-ի աջակցության հնացման (deprecation) մասին։
Նոր, ավելի պարզ և ավելի լավ Kafka-ի հիմքերն արդեն դրված են, բայց ճանապարհը դեռ ավարտված չէ։ KRaft-ին միգրացիան վաղ հասանելիությունից դուրս կգա միայն Kafka 3.6-ում, որը սպասվում է 2023 թվականի երկրորդ կեսին։ 2024 թվականին նախատեսված Kafka 4.0-ը կլինի այն տարբերակը, որը ZK-ն ամբողջովին կհեռացնի։
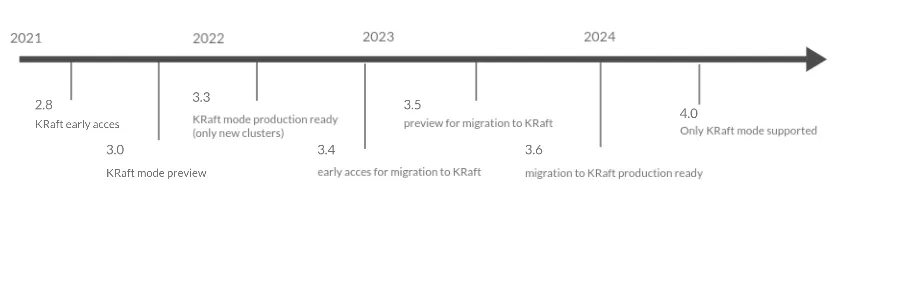
3.5-ում ZK-ից KRaft միգրացիան դեռ վաղ հասանելիության մեջ է, ուստի այն չպետք է օգտագործվի պրոդակշնում։ Առայժմ KRaft-ը պատրաստ է միայն այն դեպքում, երբ սկսում եք զրոյից։ Ավելի մանրամասն տեղեկություններ կան KIP-866 / Migration overview-ում կամ այս ձեռնարկում։
Kafka-ի ճարտարապետությունը Zookeeper-ով
Kafka կլաստերը կազմված է մի քանի հանգույցներից, որոնք կոչվում են բրոքերներ։ Կլաստերը կարող է ունենալ ընդամենը մեկ բրոքեր, սակայն նման կոնֆիգուրացիան իմաստ ունի միայն թեստավորման և մշակման համար, քանի որ ավելցուկություն չի ապահովում։ Պրոդակշն կլաստերները սովորաբար ունեն առնվազն մի քանի բրոքեր։ Որոշ կլաստերներ, սակայն, հասնում են հսկայական չափերի. սա Kafka-ի մասշտաբավորման որակի ապացույցն է։
Բրոքերները իրար հետ խոսում են երկուական, TCP-ի վրա հիմնված արձանագրությամբ։ Նրանք նաև հաղորդագրություններ են փոխանակում պրոդյուսեր և սպառող հավելվածների հետ, որոնք հաղորդագրություններ են գրում թոփիքներում և կարդում դրանցից։
ZooKeeper
Վերջապես, բրոքերները միանում են ZooKeeper օրինակների կլաստերի, այսպես կոչված անսամբլի (ensemble)։
Zookeeper-ը տվյալները պահում է տվյալների ռեգիստրներում, որոնք կոչվում են znode-ներ։ ZNode-երը կազմակերպված են ֆայլային համակարգին նման կառուցվածքով, և znode-ի անունը նման է ֆայլի ուղու։ Բրոքերի zk.connect կոնֆիգուրացիոն հատկությունը բրոքերին ասում է՝ որ անսամբլին և ինչ ուղով միանալ։ Մեկ ZK անսամբլ կարող է սպասարկել մի քանի Kafka կլաստերներ, եթե դրանք ուղղված են տարբեր ուղիների։ Կլաստերին միանալիս բրոքերը ստեղծում է իր սեփական znode-ը, որը սահմանվում է broker.id հատկությամբ։ Կլաստերի բոլոր բրոքերները պետք է zk.connect-ում օգտագործեն նույն հասցեն և ուղին, իսկ յուրաքանչյուր broker.id պետք է եզակի լինի։
Բրոքերների՝ միանալիս ստեղծած znode-երը հատուկ տեսակի են՝ ժամանակավոր (ephemeral)։ Ժամանակավոր հանգույցը ռեգիստրից հեռացվում է ավտոմատ կերպով, հենց որ ZK-ի և բրոքերի միջև կապն ավարտվում է։ Դա կարող է պատահել, երբ բրոքերը կլաստերը թողնում է սահուն կերպով, բայց ZK-ն նաև կավարտի սեսիան, եթե Kafka օրինակը մահանա կամ դադարի արձագանքել (օրինակ՝ երկար GC դադարի պատճառով)։ Ցույց տալու համար, որ կենդանի են, բրոքերները պետք է heartbeat ազդանշաններ ուղարկեն ZK-ին։ Եթե ZK-ն zookeeper.session.timeout.ms-ով սահմանված ժամանակում բրոքերից կենդանության նշան չտեսնի, այն հանգույցը համարում է ձախողված։ Ամեն անգամ, երբ ժամանակավոր հանգույց է ստեղծվում կամ ջնջվում, ZK-ն ծանուցում է ուղարկում, և Kafka-ի մյուս բաղադրիչները բաժանորդագրվում են այդ ծանուցումներին՝ կլաստերի վիճակի արդի պատկերը պահելու համար։
Zookeeper-ը կլաստերի կոնֆիգուրացիայի և մետատվյալների ճշմարտության աղբյուրն է, որը պահում է թոփիքների, բրոքերների և ACL-ների մասին տեղեկատվություն։ Այն նաև պատասխանատու է կոնտրոլեր բրոքերի նշանակման համար (քննարկվում է հաջորդ բաժնում)։
Նախկինում ZK-ն ավելի շատ պարտականություններ ուներ։ Վահանակային հավելվածները (ինչպես console-producer.sh-ը կամ console-consumer.sh-ը) ZK-ն օգտագործում էին որպես կլաստերի մուտքի կետ (այսօր բավական է –bootstrap-server պարամետրով բրոքերի հասցե փոխանցել)։
Ավելին, Kafka-ի վաղ տարբերակներում (մինչև 0.9) ZK-ն պահում էր commit արված օֆսեթների մասին տեղեկատվությունը։ Այսօր այս տեղեկատվությունը գտնվում է __consumer_offsets ներքին թոփիքում։
Կոնտրոլեր
Կլաստերի մեկ բրոքերը հատուկ դեր ունի. այն նշանակվում է կոնտրոլեր։ Այն կատարում է բազմաթիվ վարչական խնդիրներ, ինչպիսիք են պարտիցիայի լիդերի ընտրությունների գործարկումը կամ պարտիցիաների վերաբաշխումը բրոքերների միջև։ Այն նաև պատասխանատու է կլաստերի մետատվյալների համար՝ հետևելով թոփիքներին, պարտիցիաներին, ռեպլիկաներին և այն բանին, թե ինչպես են դրանք նշանակված բրոքերներին։ Բացի այդ, այն ապահովում է, որ մետատվյալների թարմացումները պահպանվեն ZK-ում և տարածվեն մյուս բրոքերներին։
Ցանկացած պահի կլաստերը կարող է ունենալ միայն մեկ կոնտրոլեր։ Դա երաշխավորելու համար Kafka-ն ապավինում է ZK-ի հատկություններին։ Երբ բրոքերները միանում են կլաստերին, նրանք մրցում են /controller ենթաուղու տակ ժամանակավոր znode ստեղծելու համար։ Քանի որ տվյալ ուղով կարող է գոյություն ունենալ միայն մեկ znode, հաղթում է միայն մեկ բրոքեր և դառնում նոր կոնտրոլեր։ Երբ կոնտրոլերը լքում է կլաստերը, ZK-ն բոլոր բրոքերներին ծանուցում է, որ նրանք պետք է նորից մրցեն նորը ընտրելու համար։
Բրոքերը երբեմն կարող է կորցնել իր կոնտրոլերի կարգավիճակը (օրինակ՝ երբ երկար GC դադարը խանգարել է heartbeat ուղարկել)՝ առանց դա գիտակցելու։ Այդ դեպքում այն վերածվում է այսպես կոչված զոմբի կոնտրոլերի։ Երբ նոր կոնտրոլեր ընտրվի, կարող ենք ունենալ երկու կոնտրոլեր՝ օրինականը և զոմբին։ Դրանից խուսափելու համար յուրաքանչյուր նոր ընտրված կոնտրոլեր ստանում է հաջորդական համար, որը մեկով մեծանում է՝ կոնտրոլերի epoch-ը։ Այդ դեպքում բրոքերները կարող են պարզապես անտեսել ավելի ցածր epoch ունեցող կոնտրոլերի հարցումները։
Նախքան նոր կոնտրոլերը կսկսի իր աշխատանքը, այն պետք է ZooKeeper-ից վերցնի մետատվյալների վերջին վիճակը և փոխանցի այն մյուս բրոքերներին։ Փոքր կլաստերներում դա տեղի է ունենում բավականին արագ։ Սակայն ավելի մեծ համակարգերում վերցնումը կարող է տևել մի քանի վայրկյան։ Սա Kafka-ZK կոնֆիգուրացիայի հսկայական թուլությունն է. մետատվյալները լոկալ չեն պահվում բրոքերների վրա, այլ պետք է կարդացվեն ZK ռեգիստրներից։ Մեծ, ծանրաբեռնված կլաստերներում նույնիսկ մի քանի վայրկյանի ուշացումը կարող է լուրջ խնդիրներ առաջացնել։
Տարիների ընթացքում կոնտրոլերի ընտրության գործընթացը ստացել է բազմաթիվ արդյունավետության բարելավումներ, ինչպիսին ZK-ից բրոքեր տվյալների ասինխրոն փոխանցումն է։ Այդուհանդերձ, այն շարունակում է մնալ ակնհայտ խցանում և վատ է մասշտաբավորվում՝ պարտիցիաների քանակի աճին զուգընթաց։ Kafka-ին պետք էր կլաստերի մետատվյալների կառավարման նոր, ավելի լավ եղանակ։
Kafka KRaft-ով
Քվորումային կոնտրոլերի նոր կոնֆիգուրացիայի հիմնական գաղափարն այն է, որ Kafka-ն իր բնույթով լոգի վրա հիմնված է։ Մետատվյալների փոփոխությունները կարելի է ներկայացնել որպես լոգում պահվող հաղորդագրություններ և ապա հոսքով փոխանցել բաժանորդներին։
KRaft ռեժիմում մի քանի Kafka օրինակ կարող են նշանակվել կոնտրոլեր։ Հանգույցը կարող է գործել միայն որպես բրոքեր, միայն որպես կոնտրոլեր կամ երկուսն էլ միաժամանակ (ինչը շատ հարմար է փոքր կլաստերներում)։ Սա փոփոխություն է հին կոնֆիգուրացիայի համեմատ, որն ուներ ընդամենը մեկ կոնտրոլեր։ Նույնիսկ մի քանի կոնտրոլերի դեպքում, սակայն, ցանկացած պահի ակտիվ է միայն մեկը, իսկ մնացածը սպասողական ռեժիմում են։ Եթե ակտիվ կոնտրոլերը խափանվի, մյուսներից մեկը ստանձնում է նրա պարտականությունները։
Կլաստերի մետատվյալների փոփոխություններ կարող է կատարել միայն ակտիվ կոնտրոլերը։ Այն թարմացումները գրում է __cluster_metadata անունով հատուկ ներքին թոփիքում (մեկ պարտիցիայով)։ Մյուս բոլոր կոնտրոլերներն այնուհետև այս թոփիքից ռեպլիկացնում են հաղորդագրությունները, ուստի նրանցից յուրաքանչյուրն իր լոկալ ռեպլիկայում պահում է տվյալների գրեթե արդի պատճենը։ Սա շատ կարևոր է. նոր կոնտրոլերին այլևս պետք չէ բոլոր տվյալները քաշել Zookeeper-ից։ Ամեն ինչ արդեն իր լոկալ լոգում է. առավելագույնը նրան պետք է հասնել բաց թողած մի քանի հաղորդագրության։
Ռեպլիկացիա
Մետատվյալների ռեպլիկացիան աշխատում է շատ նման սովորական Kafka թոփիքների տվյալների ռեպլիկացիային։ Ռեպլիկաները միակ պարտիցիայի լիդերին (ակտիվ կոնտրոլերին) հարցում են ուղարկում իրենց տեսած վերջին օֆսեթով, և լիդերը պատասխանում է վերջին հաղորդագրություններով։ Բարենպաստ սցենարում նրանք արագ հասնում են լիդերին։
Կան, սակայն, կարևոր տարբերություններ։ Նախ, չկա համաժամեցված ռեպլիկաների (ISR) գաղափար, որոնք կարող էին փոխարինել, երբ լիդերը անհասանելի է։ Նոր լիդերի (որը նաև ակտիվ կոնտրոլերն է) ընտրությունը միշտ քվորումի վրա հիմնված է։ Ինչպես ռեժիմի անվանումը (KRaft) հավանաբար հուշում է, լիդերը ընտրվում է Raft ալգորիթմով։
Լիդերի ընտրություն
Ակտիվ կոնտրոլերը պետք է կանոնավոր ընդմիջումներով heartbeat-ներ ուղարկի մյուս կոնտրոլերներին։ Եթե չի ուղարկում, նրանք որոշում են, որ այն խափանվել է, և սկսում են նոր ընտրություն։ Յուրաքանչյուր կոնտրոլեր իրեն համարում է թեկնածու և վերցնում է իր իմացած լիդերի վերջին epoch-ը։ Այն մեծացնում է այդ արժեքը մեկով և ուղարկում է այն այն հարցումների հետ, որոնցով մյուս կոնտրոլերներին խնդրում է քվեարկել իր օգտին։ Քվեարկության հարցում ստանալիս կոնտրոլերը ստուգում է՝ արդյոք արդեն տեսել է ավելի ուշ epoch ունեցող հարցումներ կամ արդեն պատասխանել է նույն epoch-ով հարցման։ Եթե ոչ մեկը չի եղել, այն հաստատում է հարցումը։ Կոնտրոլերները քվեներ խնդրելուց առաջ սպասում են պատահական ժամանակահատված, ինչը թույլ չի տալիս բոլոր հանգույցներին միաժամանակ հարցումներ ուղարկել։ Այն կոնտրոլերը, որը քվեների քվորում հավաքի, դառնում է նոր լիդեր։
Օֆսեթների commit
Մետատվյալների օֆսեթների commit-ն էլ է աշխատում այլ կերպ, քան սովորական թոփիքների համար։ Kafka-ն պետք է պարտադրի fsync մետատվյալների թոփիքին նոր հաղորդագրություն կցելիս։ Սա երաշխավորում է, որ հաղորդագրությունները կայուն կերպով պահվում են լոգում, ինչը Raft ալգորիթմին անհրաժեշտ է ճիշտ մնալու համար։ Յուրաքանչյուր գրառում նշվում է լիդերի epoch համարով, ինչը հնարավորություն է տալիս համաձայնեցնել լոգերը՝ նոր ակտիվ կոնտրոլերի ընտրվելուց հետո։
Որքանո՞վ է կարևոր KRaft-ը
KRaft-ը հսկայական քայլ է առաջ Kafka-ի համար։ Այն արագացնում է կրիտիկական գործողությունները, ինչպիսին կոնտրոլերի խափանումից հետո վերականգնումն է, և հեռացնում է նաև Kafka-ի այլ սահմանափակումներ։ Երբ մետատվյալները կառավարվում են ZK-ում, թոփիք ստեղծելը կամ ջնջելը տևում է O(n) (որտեղ n-ը գոյություն ունեցող թոփիքների քանակն է), քանի որ կոնտրոլերը պետք է ZooKeeper-ից բեռնի թոփիքների անունների ամբողջական ցանկը։ KRaft-ով այս գործողությունները տևում են O(1)։
Առանց ZooKeeper-ի Kafka-ի տեղակայումը շատ ավելի պարզ է։ ZK-ի արտադրողականությունն ու նուրբ կարգավորումն այլևս մեր հոգսը չեն։ KRaft-ի հաճախ աչքից վրիպող առավելությունը մշակողի ավելի լավ փորձառությունն է։ Նախկինում նույնիսկ թեստավորման համար փոքր լոկալ միահանգույց Kafka կլաստերը պահանջում էր գործարկել նաև Zookeeper։ KRaft-ով դա այլևս անհրաժեշտ չէ։
Հայացք դեպի ապագա
ZooKeeper-ի կախվածության հեռացումը Kafka-ի պատմության ամենասպասված փոփոխություններից է։ 2024 թվականին նախատեսված 4.0 տարբերակը կավարտի Zookeeper-ի աջակցությունը, և այդ ժամանակ կկարողանանք ասել, որ այս էպիկական ճանապարհը վերջապես հասել է իր ավարտին։