Kafka من دون ZooKeeper
سار Apache Kafka و Apache ZooKeeper جنبًا إلى جنب لسنوات. تشرح هذه المقالة كيف يعمل إعداد Kafka الجديد القائم على النصاب (quorum) وبمَ يختلف عن الإعداد الذي يعتمد على ZooKeeper – لكن لنلقِ أولًا نظرة على كيف بدأ كل ذلك.
سار Apache Kafka و Apache ZooKeeper جنبًا إلى جنب لسنوات. كان Kafka مسؤولًا عن التسليم الموثوق للرسائل خلف واجهة pub/sub، بينما كان ZooKeeper يعمل كمخزن موزَّع للبيانات الوصفية (metadata) الخاصة بالعنقود. كان ZooKeeper يتتبع أي نسخة متماثلة تقود أي قسم (partition)، وكيف توزَّع الأقسام على الوسطاء (brokers)، وإزاحات المستهلكين (consumer offsets)، والكثير غير ذلك. وعندما كان Kafka قيد البناء، أزاح اختيار ZooKeeper عبئًا كبيرًا عن كاهل مطوري Kafka – إذ استطاعوا الاعتماد على مكوّن مُجرَّب لإبقاء نظام الرسائل لديهم متسقًا.
لكن لهذا الحل عيوبه. فهو يزيد صعوبة التشغيل: هناك مكوّنان منفصلان للبنية التحتية يجب ضبطهما وتأمينهما ومراقبتهما. كما أكسب Kafka سمعة بأنه صعب الصيانة وثقيل على البنية التحتية. وبما أن Kafka نفسه نظام موزَّع، فقد كانت فكرة نقل جميع مسؤوليات ZooKeeper تدريجيًا إلى Kafka جذابة جدًا.
في هذه المقالة سأستعرض كيف يعمل إعداد Kafka الجديد القائم على النصاب وما الذي يميزه عن السابق – لكن لنلقِ أولًا نظرة على كيف بدأ كل ذلك.
تحديث: أزال Apache Kafka 4.0.0 ZooKeeper بالكامل واستبدله بـ KRaft.
لمحة تاريخية
بدأت الرحلة رسميًا حوالي عام 2019، عندما أُنشئ KIP-500 (يرمز KIP إلى Kafka Improvement Proposal، أي مقترح تحسين Kafka). كان KIP-500 بمثابة مظلة لعدة KIPs لاحقة، تهدف جميعها إلى بناء بديل داخلي جديد لـ Zookeeper. وفي عام 2021، قدّم الإصدار 2.8 نسخة تجريبية (beta) من وضع المتحكم القائم على النصاب المبني على آلية الإجماع KRaft. وأصدره الإصدار 3.0 كمعاينة (preview). وفي عام 2022 أعلن Kafka 3.3 أن KRaft جاهز للإنتاج (لكن للعناقيد الجديدة فقط). وأتاح الإصدار 3.5 الأخير وصولًا مبكرًا لترحيل العناقيد (من دون توقف) إلى الإعداد الجديد الخالي من ZK، كما أعلن إهمال دعم Zookeeper.
لقد وُضع الأساس لـ Kafka جديد وأبسط وأفضل، لكن الرحلة لم تنتهِ بعد. فلن يخرج الترحيل إلى KRaft من مرحلة الوصول المبكر إلا في Kafka 3.6، المتوقع في النصف الثاني من عام 2023. أما Kafka 4.0، المخطط له في عام 2024، فسيكون الإصدار الذي يتخلى عن ZK كليًا.
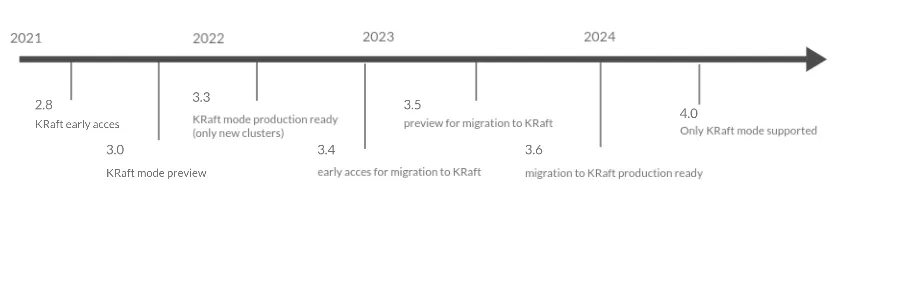
في الإصدار 3.5 لا يزال الترحيل من ZK إلى KRaft في مرحلة الوصول المبكر، ولذلك لا ينبغي استخدامه في الإنتاج. حاليًا، يكون KRaft جاهزًا فقط عندما تبدأ من الصفر. تتوفر تفاصيل أكثر في KIP-866 / Migration overview أو في هذا الدليل.
معمارية Kafka مع Zookeeper
يتكون عنقود Kafka من عدة عقد تُعرف بالوسطاء (brokers). يمكن أن يضم العنقود وسيطًا واحدًا فقط، لكن هذا الإعداد لا معنى له إلا للاختبار والتطوير، لأنه لا يوفر أي تكرار احتياطي. وعادةً ما تضم عناقيد الإنتاج عددًا من الوسطاء لا يقل عن بضعة وسطاء. ومع ذلك تنمو بعض العناقيد إلى أحجام هائلة – دليل على مدى قابلية Kafka للتوسع.
يتحدث الوسطاء إلى بعضهم عبر بروتوكول ثنائي مبني على TCP. كما يتبادلون الرسائل مع تطبيقات المنتِجين والمستهلكين التي تكتب الرسائل إلى المواضيع (topics) وتقرؤها منها.
ZooKeeper
أخيرًا، يتصل الوسطاء بعنقود من نسخ ZooKeeper – ما يسمى بالمجموعة (ensemble).
يحتفظ Zookeeper بالبيانات في سجلات بيانات تُعرف بـ znodes. تُنظَّم ZNodes في بنية تشبه نظام الملفات، ويبدو اسم الـ znode مثل مسار ملف. تخبر خاصية إعداد الوسيط zk.connect الوسيطَ بأي مجموعة يتصل وتحت أي مسار. يمكن لمجموعة ZK واحدة أن تخدم عدة عناقيد Kafka، طالما أنها تشير إلى مسارات مختلفة. وعند الانضمام إلى العنقود، ينشئ الوسيط znode خاصًا به، تحدده الخاصية broker.id. ويجب أن تستخدم جميع الوسطاء في العنقود العنوان والمسار نفسيهما في zk.connect، ويجب أن يكون كل broker.id فريدًا.
الـ znodes التي ينشئها الوسطاء عند انضمامهم من نوع خاص: مؤقتة (ephemeral). تُزال العقدة المؤقتة من السجل تلقائيًا بمجرد انتهاء الاتصال بين ZK والوسيط. قد يحدث هذا عندما يغادر الوسيط العنقود بسلاسة، لكن ZK سينهي الجلسة أيضًا إذا تعطلت نسخة Kafka أو توقفت عن الاستجابة (مثلًا بسبب توقف طويل لجامع المهملات GC). ولإثبات أنها حية، يجب على الوسطاء إرسال إشارات نبض (heartbeat) إلى ZK. وإذا لم يرَ ZK أي علامة حياة من وسيط خلال المدة المحددة بـ zookeeper.session.timeout.ms، فإنه يعتبر العقدة فاشلة. وفي كل مرة تُنشأ عقدة مؤقتة أو تُحذف، يرسل ZK إشعارًا، وتشترك مكوّنات Kafka الأخرى في هذه الإشعارات لتحتفظ برؤية محدّثة لحالة العنقود.
Zookeeper هو المصدر الموثوق لإعدادات العنقود وبياناته الوصفية، إذ يحتفظ بمعلومات عن المواضيع والوسطاء وقوائم التحكم في الوصول (ACLs). وهو أيضًا المسؤول عن تعيين وسيط متحكم (controller) (نتناوله في القسم التالي).
في الماضي كانت لـ ZK مسؤوليات أكثر. فقد كانت التطبيقات المعتمدة على سطر الأوامر (مثل console-producer.sh أو console-consumer.sh) تستخدم ZK كنقطة دخولها إلى العنقود (واليوم يكفي تمرير عنوان وسيط بالمعامل –bootstrap-server).
وفوق ذلك، في الإصدارات الأولى من Kafka (قبل 0.9) كان ZK يحتفظ بمعلومات الإزاحات المعتمَدة (committed offsets). أما اليوم فتوجد هذه المعلومات في الموضوع الداخلي __consumer_offsets.
المتحكم (Controller)
يؤدي وسيط واحد في العنقود دورًا خاصًا – إذ يُعيَّن متحكمًا. يتولى مهام إدارية كثيرة، مثل تشغيل انتخابات قائد القسم أو إعادة إسناد الأقسام بين الوسطاء. وهو مسؤول أيضًا عن البيانات الوصفية للعنقود، فيتتبع المواضيع والأقسام والنسخ المتماثلة وكيفية إسنادها إلى الوسطاء. بالإضافة إلى ذلك، يضمن حفظ تحديثات البيانات الوصفية في ZK ونشرها إلى بقية الوسطاء.
في أي لحظة، يمكن أن يكون للعنقود متحكم واحد فقط. ويعتمد Kafka على خصائص ZK لضمان ذلك. عندما ينضم الوسطاء إلى العنقود يتسابقون لإنشاء znode مؤقتة تحت المسار الفرعي /controller. ولأنه لا يمكن أن توجد سوى znode واحدة بمسار معين، يفوز وسيط واحد فقط ويصبح المتحكم الجديد. وكلما غادر المتحكم العنقود، يُخطر ZK جميع الوسطاء بأن عليهم التنافس مجددًا لاختيار متحكم جديد.
قد يفقد وسيط أحيانًا صفة المتحكم (مثلًا عندما يمنعه توقف طويل لجامع المهملات من إرسال النبضات) دون أن يدرك ذلك. عندئذ يتحول إلى ما يسمى المتحكم الزومبي. وبمجرد انتخاب متحكم جديد، قد ينتهي بنا الأمر إلى متحكمين: الشرعي والزومبي. ولتجنب ذلك، يتلقى كل متحكم منتخَب حديثًا رقمًا تسلسليًا يزداد بمقدار واحد – وهو عصر المتحكم (controller epoch). وعندها يمكن للوسطاء ببساطة تجاهل طلبات المتحكم التي تحمل عصرًا أدنى.
قبل أن يبدأ المتحكم الجديد عمله، عليه استرجاع أحدث حالة للبيانات الوصفية من ZooKeeper وتمريرها إلى بقية الوسطاء. في العناقيد الصغيرة يحدث ذلك بسرعة نسبيًا. أما في الأنظمة الكبيرة فقد يستغرق الجلب بضع ثوانٍ. وهذه نقطة ضعف كبيرة في إعداد Kafka-ZK – فالبيانات الوصفية لا تُحفظ محليًا على الوسطاء بل يجب قراءتها من سجلات ZK. وفي العناقيد الكبيرة المزدحمة، قد يتسبب حتى تأخير بضع ثوانٍ في مشكلات خطيرة.
على مر السنين شهدت عملية انتخاب المتحكم تحسينات كثيرة في الأداء، مثل النقل غير المتزامن للبيانات من ZK إلى الوسيط. ومع ذلك تبقى عنق زجاجة واضحًا ولا تتوسع جيدًا مع زيادة عدد الأقسام. احتاج Kafka إلى طريقة أحدث وأفضل لإدارة البيانات الوصفية للعنقود.
Kafka مع KRaft
الفكرة الرئيسية وراء إعداد المتحكم القائم على النصاب الجديد هي أن Kafka قائم على السجل (log) بطبيعته. يمكن تمثيل تغييرات البيانات الوصفية كرسائل مخزنة في سجل ثم بثّها إلى المشتركين.
في وضع KRaft يمكن تعيين عدة نسخ Kafka كمتحكمات. ويمكن للعقدة أن تعمل وسيطًا فقط، أو متحكمًا فقط، أو كليهما في الوقت نفسه (وهذا مريح جدًا في العناقيد الصغيرة). وهذا تغيير عن الإعداد القديم الذي كان فيه متحكم واحد فقط. ومع تعدد المتحكمين، يكون واحد فقط نشطًا في أي لحظة، بينما يبقى الباقون في وضع الاستعداد. وإذا فشل المتحكم النشط، يتولى أحد الآخرين مهامه.
لا يمكن إجراء تغييرات على البيانات الوصفية للعنقود إلا بواسطة المتحكم النشط. فهو يكتب التحديثات إلى موضوع داخلي خاص (بقسم واحد) اسمه __cluster_metadata. ثم تنسخ جميع المتحكمات الأخرى الرسائل من هذا الموضوع، فيحتفظ كل منها بنسخة شبه محدّثة من البيانات في نسخته المتماثلة المحلية. وهذا مهم جدًا – فلم يعد المتحكم الجديد بحاجة إلى سحب كل البيانات من Zookeeper. كل شيء موجود بالفعل في سجله المحلي؛ وعليه على الأكثر اللحاق ببضع رسائل فاتته.
التكرار (Replication)
يشبه تكرار البيانات الوصفية إلى حد كبير تكرار البيانات للمواضيع العادية في Kafka. ترسل النسخ المتماثلة طلبًا إلى قائد القسم الوحيد (المتحكم النشط) مع آخر إزاحة رأتها، ويرد القائد بأحدث الرسائل. وفي المسار السعيد تلحق بالقائد بسرعة.
لكن هناك اختلافات مهمة. فأولًا، لا يوجد مفهوم النسخ المتماثلة المتزامنة (ISR) التي يمكنها التدخل عندما يكون القائد غير متاح. فانتخاب قائد جديد (وهو أيضًا المتحكم النشط) قائم دائمًا على النصاب. وكما يوحي اسم الوضع (KRaft) على الأرجح، يُختار القائد باستخدام خوارزمية Raft.
انتخاب القائد
يجب على المتحكم النشط إرسال نبضات إلى المتحكمات الأخرى على فترات منتظمة. وإذا لم يفعل، فإنها تقرر أنه تعطل وتبدأ انتخابًا جديدًا. يعامل كل متحكم نفسه كمرشح ويأخذ أحدث عصر قائد يعرفه. ويزيده بمقدار واحد ويرسله مع طلبات تطلب من المتحكمات الأخرى التصويت له. وعند تلقي طلب تصويت، يتحقق المتحكم مما إذا كان قد رأى طلبات بعصر أحدث أو سبق أن رد على طلب بالعصر نفسه. وإذا لم يكن أي من الأمرين صحيحًا، فإنه يقر الطلب. وتنتظر المتحكمات مدة عشوائية قبل طلب الأصوات، مما يمنع جميع العقد من إرسال الطلبات في وقت واحد. ويصبح القائد الجديد هو المتحكم الذي يجمع نصابًا من الأصوات.
اعتماد الإزاحات (Offset committing)
يعمل اعتماد الإزاحات للبيانات الوصفية أيضًا بشكل مختلف عن المواضيع العادية. فعلى Kafka فرض fsync عند إلحاق رسالة جديدة بموضوع البيانات الوصفية. وهذا يضمن تخزين الرسائل بشكل دائم في السجل، وهو ما تتطلبه خوارزمية Raft لتبقى صحيحة. ويوسم كل سجل برقم عصر القائد، مما يتيح مصالحة السجلات بمجرد انتخاب متحكم نشط جديد.
ما مدى أهمية KRaft؟
KRaft خطوة ضخمة إلى الأمام لـ Kafka. فهو يسرّع العمليات الحرجة، مثل التعافي بعد فشل المتحكم، ويزيل قيودًا أخرى في Kafka أيضًا. فمع إدارة البيانات الوصفية في ZK، يستغرق إنشاء موضوع أو حذفه O(n) (حيث n هو عدد المواضيع الموجودة)، لأن على المتحكم تحميل القائمة الكاملة لأسماء المواضيع من ZooKeeper. أما مع KRaft فتستغرق هذه العمليات O(1).
ومن دون ZooKeeper يصبح إعداد Kafka أبسط بكثير. فلم يعد أداء ZK وضبطه الدقيق همًّا لنا. ومن فوائد KRaft التي يغفلها كثيرون تجربة مطور أفضل. فسابقًا، حتى عنقود Kafka محلي صغير بعقدة واحدة للاختبار كان يتطلب تشغيل Zookeeper أيضًا. ومع KRaft لم يعد ذلك ضروريًا.
نظرة إلى المستقبل
تُعد إزالة الاعتماد على ZooKeeper من أكثر التغييرات انتظارًا في تاريخ Kafka. وسينهي الإصدار 4.0، المخطط له في عام 2024، دعم Zookeeper، وعندها سنتمكن من القول إن هذه الرحلة الملحمية انتهت أخيرًا.