كيف توظّف الشركات البيانات الضخمة
اكتشف كيف تؤدي تحليلات البيانات الضخمة إلى قرارات أفضل وتعزّز ما تستطيع العمليات التجارية تحقيقه.
تجمع خدمات الإنترنت والأجهزة كمية هائلة من المعلومات وتحتفظ بها، وهي تمسّ كل جانب من جوانب حياتنا. وتجمع الشركات هذه البيانات وتستخدمها للابتكار ولكسب أفضلية على المنافسين. إنها أحجية معقدة قادرة على كشف أسرار ماضينا وحاضرنا ومستقبلنا.
سأبدأ هذه المقالة بشرح موجز لأهم المصطلحات المرتبطة بالبيانات الضخمة (Big Data). بعد ذلك ننتقل إلى الموضوع الرئيسي للمقالة: كيف تستخدم الشركات البيانات الضخمة؟ سنرى كيف تؤدي تحليلات البيانات الضخمة إلى قرارات أفضل وتعزّز ما تستطيع العمليات التجارية تحقيقه.
لكن أولًا، السؤال الأكثر أساسية.
ما هي البيانات الضخمة؟
البيانات الضخمة هي المعلومات الهائلة والمتنوعة التي يُنتجها عالم مترابط رقميًا. وما يميّز البيانات الضخمة تصفه 3Vs: الحجم (volume) والسرعة (velocity) والتنوع (variety). وتضيف بعض التعريفات حرفي V آخرين – المصداقية (veracity) والقيمة (value) – ليصبح المجموع 5V. لنتفحصها عن قرب.
تأتي البيانات الضخمة بـحجم ضخم إلى درجة تتجاوز قدرة أدوات إدارة البيانات التقليدية. ونتيجة لذلك تكون معالجتها وتحليلها بفعالية بالطرق التقليدية صعبة أو مستحيلة تمامًا.
وهي تُظهر أيضًا تنوعًا كبيرًا: فهي تصل بصيغ مختلفة ومن مصادر كثيرة، مما يجعل العمل بها معقدًا ومرهقًا. وتشمل طيفًا واسعًا من أنواع البيانات، المنظمة وغير المنظمة – نصوص وصور ومقاطع فيديو وقراءات مستشعرات وتفاعلات وسائل التواصل الاجتماعي وغيرها.
تصف السرعة الوتيرة غير المسبوقة التي تُنتَج بها البيانات الضخمة وتتجدد، إذ تتدفق المعلومات في الزمن الحقيقي من مصادر لا تحصى.
وتصف القيمة مدى أهمية البيانات الضخمة من منظور الأعمال وما يمكن أن تقدمه من رؤى. وفي هذا المحيط الهائل من المعلومات تنبع القيمة الحقيقية من القدرة على تحليل البيانات وتفسيرها للحصول على رؤى ذات معنى وكشف أنماط كانت خافية من قبل.
وأخيرًا، المصداقية هي بُعد البيانات الضخمة المتعلق بمدى موثوقية البيانات. ومع الحجم الهائل للبيانات القادمة من مصادر متنوعة يصبح ضمان جودتها ودقتها تحديًا كبيرًا. فقد تحتوي البيانات على أخطاء أو تناقضات أو تحيزات، وهذه – إن تُركت دون معالجة – قد تؤدي إلى استنتاجات مضللة أو خاطئة.
لمحة تاريخية
خلقت الأيام الأولى للإنترنت فرصًا غير مسبوقة لتحليل البيانات. فبدأت شركات الويب مثل Yahoo وAmazon وeBay بجمع بيانات عن سلوك العملاء بفحص معدلات النقر ومواقع المستخدمين المستنتجة من عناوين IP أو المواقع الفرعية التي زارها الناس. وتنامت كمية البيانات المجموعة بسرعة، وصارت الشركات بحاجة إلى أدوات جديدة ومبتكرة للاستفادة منها.
أضاف قاموس أكسفورد الإنجليزي مصطلح Big Data في عام 2013، لكن العبارة نفسها أقدم من ذلك بكثير. فقد صاغها Roger Mougalas في عام 2005 لوصف مجموعات البيانات الكبيرة التي كان من شبه المستحيل إدارتها بأدوات ذلك الوقت. وفي العام نفسه أطلقت Yahoo نظام Hadoop، وهو إطار عمل مفتوح المصدر للحوسبة الموزعة. وقد أتاح هذا البرنامج الرائد معالجة بيانات أكبر من أن تتسع لها آلة واحدة. يتألف Hadoop من ثلاثة مكونات رئيسية: نظام ملفات موزع (HDFS)، ومدير للموارد (YARN)، ومحرك معالجة (MapReduce). ولم يلبث نظام Hadoop البيئي أن توسع ليشمل أدوات عديدة مرتبطة به: Apache Pig (صدر عام 2006) – لغة تدفق بيانات عالية المستوى، وApache Hive (2010) – لغة استعلام شبيهة بـ SQL لمستودعات البيانات، وHBase (2009) – قاعدة بيانات NoSQL تعمل على HDFS، وكثير غيرها.
لا يزال Hadoop قيد الاستخدام اليوم. أما محرك المعالجة فيه، MapReduce، فقد قلّت شعبيته منذ صدور Spark في عام 2014. بُني Spark لمعالجة بعض قيود MapReduce، وفي مقدمتها إدخال العمليات داخل الذاكرة التي تجعل مهام معالجة البيانات أسرع بكثير.
واليوم أصبحت بداية العمل مع البيانات الضخمة أسهل من أي وقت مضى، إذ يقدم مزوّدو الخدمات السحابية مجموعة من الخدمات والحلول المصممة خصيصًا لمعالجة كميات هائلة من المعلومات وتخزينها وتحليلها. وتتيح هذه العروض للمؤسسات من أي حجم مواجهة تحديات البيانات الضخمة دون استثمارات كبيرة في العتاد أو إدارة معقدة للبنية التحتية.
كيف نخزّن البيانات الضخمة؟
يتطلب جمع البيانات الضخمة اختيار معمارية لتخزين البيانات تناسب الاحتياجات والخصائص المحددة لها.
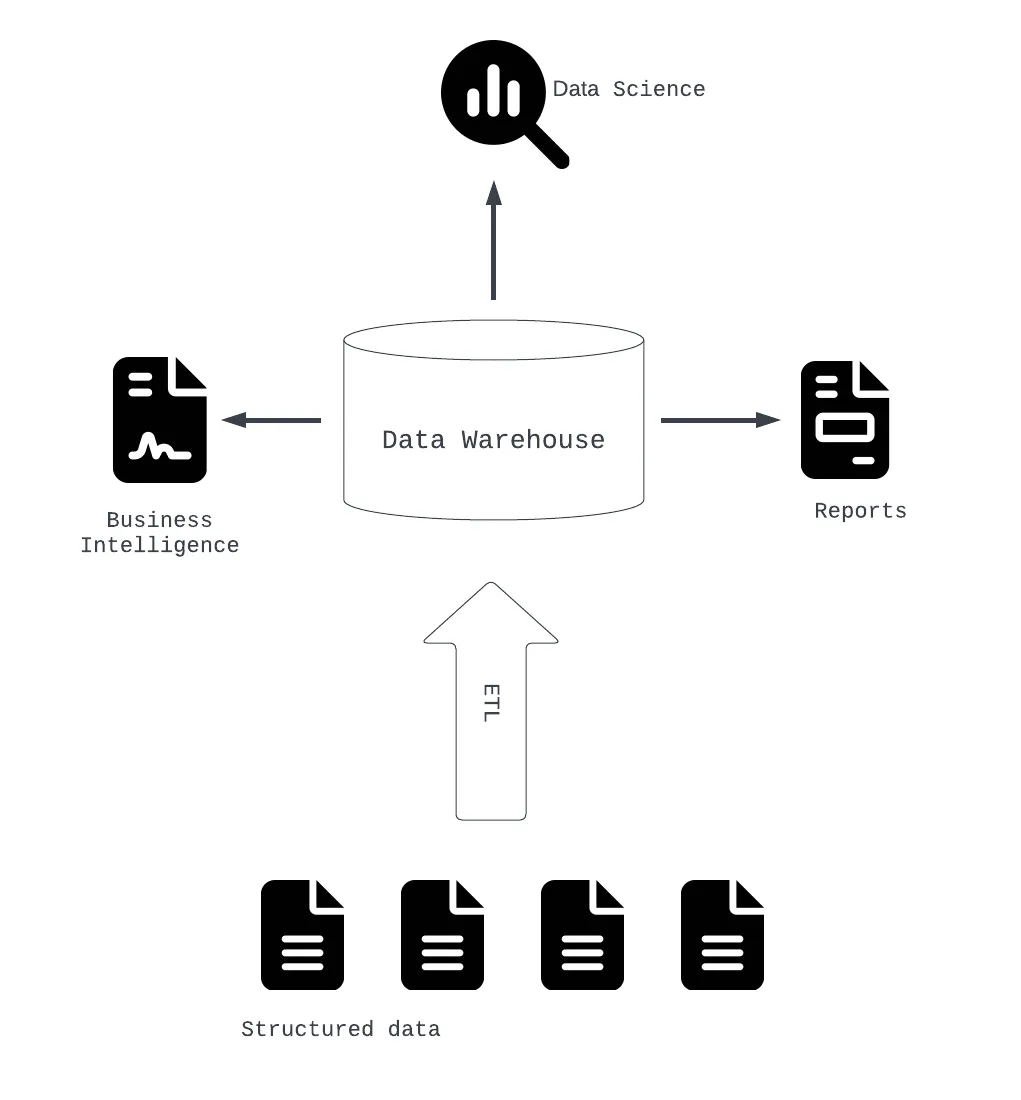
لطالما كانت مستودعات البيانات (Data warehouses) الأسلوب المهيمن لتخزين البيانات وإدارتها. فهي توفر مستودعًا مركزيًا للبيانات المنظمة القادمة من مصادر عديدة. وقبل تحميل البيانات إلى المستودع تُنظَّف عادةً وتُحوَّل عبر عملية ETL (الاستخراج والتحويل والتحميل). ويحتفظ المستودع بالبيانات وفق مخطط محدد مسبقًا من نمط النجمة أو ندفة الثلج. المستودعات مُحسَّنة للاستعلامات التحليلية وتعطي رؤية منظمة ومتسقة للمعلومات. وأكبر عيوبها جمود المخطط: إذ يجب تصميمه مسبقًا، مما يجعل المستودعات أقل مرونة عندما يتغير مخطط البيانات الواردة. كما تضيف ETL عبئًا في المعالجة وقد تستهلك كثيرًا من الوقت والموارد.
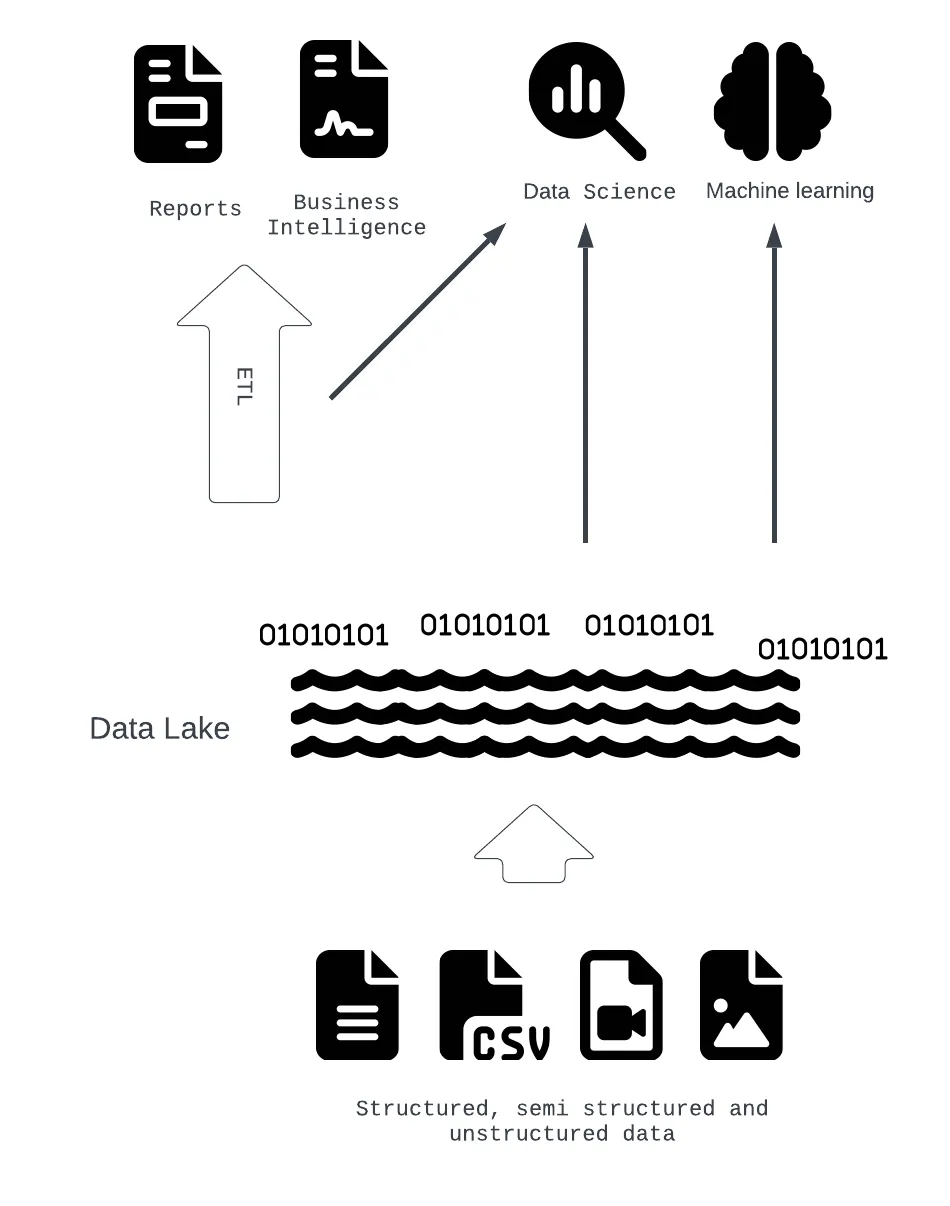
يحل نمط بحيرة البيانات (Data lake) هذه المشكلة. وهي مستودع مركزي قادر على احتواء البيانات المنظمة وغير المنظمة بصيغتها الخام الأصلية. وفي بحيرة البيانات لا يُفرض المخطط عند الإدخال، بل يُستنتج وقت القراءة. وبفضل هذه المرونة يسهل تخزين أنواع البيانات المتنوعة والتعامل معها، مما يجعل بحيرات البيانات مناسبة لاستكشاف البيانات والتجريب. وهي تعمل جيدًا عندما يكون هيكل البيانات غير واضح أو عند التعامل مع بيانات خام غير منسّقة تتطلب الاستكشاف والتحليل الارتجالي. أما الجانب السلبي فهو أن الاستعلام قد يكون أصعب دون مخطط محدد مسبقًا.
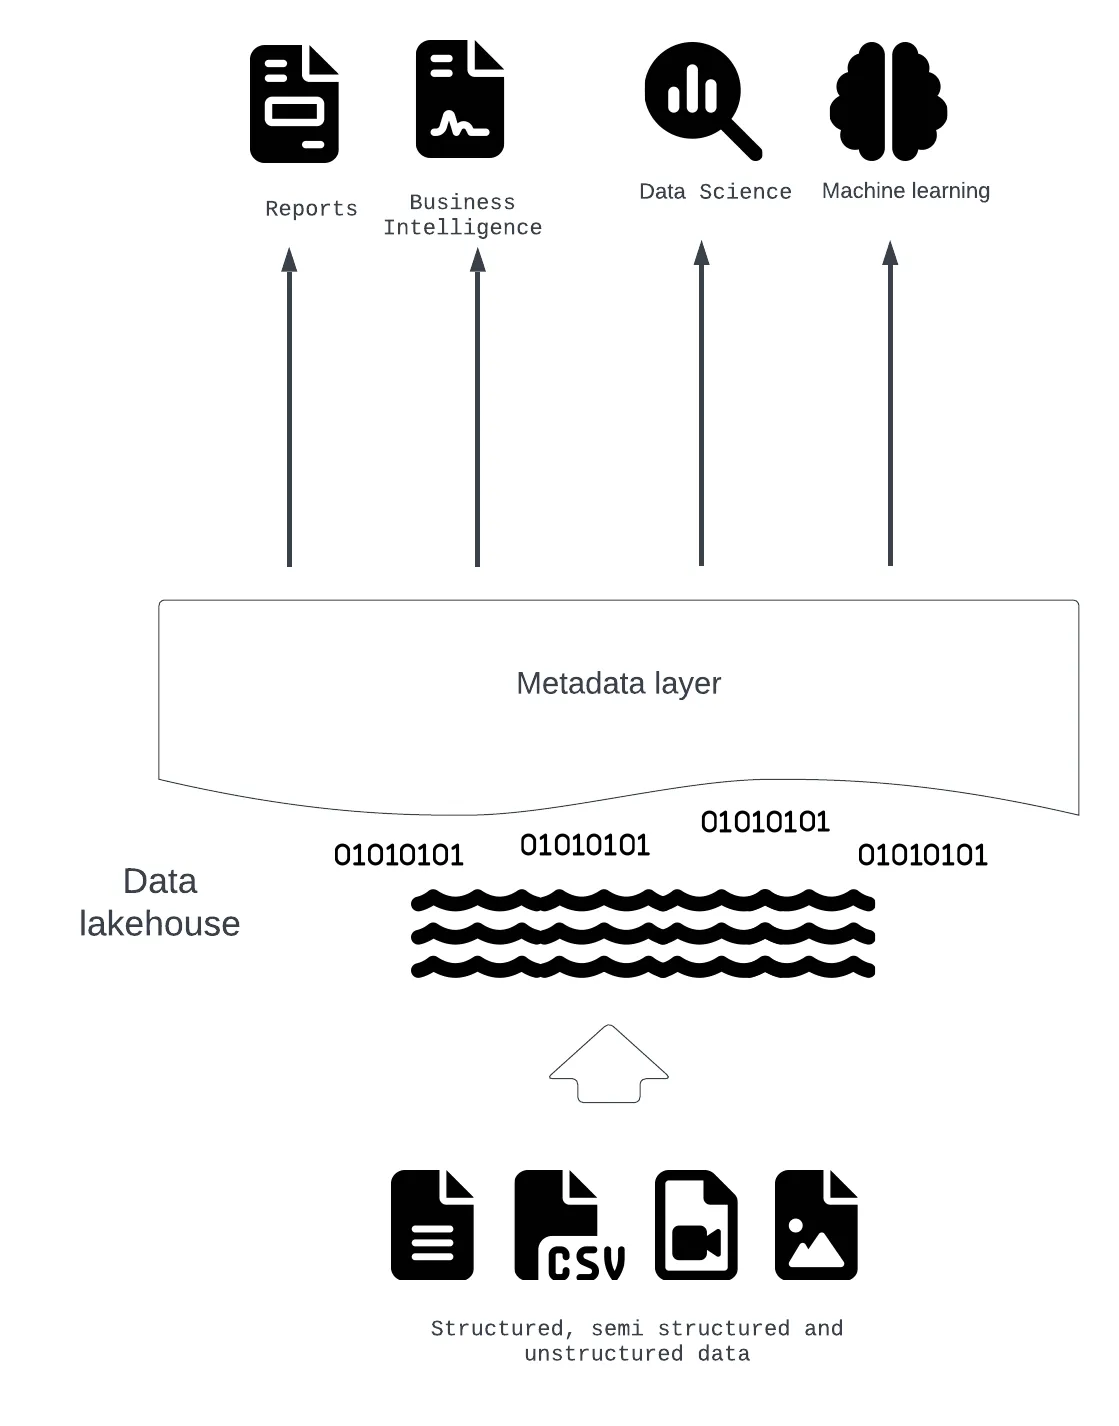
يُعد نمط بحيرة البيانات المنزلية (Data lakehouse) نهجًا أحدث يجمع مزايا مستودعات البيانات وبحيرات البيانات. فهو يعتمد على معمارية تخزين موحدة تحتوي البيانات المنظمة وغير المنظمة. وقدرته على تخزين المعلومات المتنوعة بمرونة تجعله يشبه بحيرة البيانات، بينما يوفر أيضًا الاستعلام المنظم وميزات إدارة البيانات كما في مستودع البيانات. ويحقق Data Lakehouse ذلك بتقنيات مثل Delta Lake.
تعتمد كل الأساليب الموصوفة حتى الآن على تخزين مركزي للبيانات، وقد يخلق ذلك اختناقات ومشكلات في التوسع مع نمو حجم بيانات المؤسسة وتعقيدها. كما يضع ضغطًا كبيرًا على فريق البيانات المركزي. وData Mesh نموذج معماري جديد نسبيًا لإدارة بيانات المؤسسة، يقترح طريقة لا مركزية وموجَّهة بالمجالات للتعامل معها. فكرته المحورية معاملة البيانات كمنتج وتوزيع ملكيتها والمسؤولية عنها على مجالات العمل المختلفة. وتصبح كل وحدة أعمال مسؤولة عن إدارة بياناتها، بما في ذلك الجودة والحوكمة والوصول. ويمنح Data mesh خبراء المجال سيطرة أكبر على بياناتهم. وعيبه أن تقسيم البيانات إلى أجزاء أصغر قد يجعل نموذج البيانات أكثر تعقيدًا إجمالًا عند النظر إليه من منظور المؤسسة كلها.
كثيرًا ما يُنفَّذ تخزين البيانات الضخمة على خوادم محلية (on-premise) باستخدام قواعد بيانات SQL أو NoSQL متنوعة – وهو خيار شائع للمؤسسات التي تفضّل إبقاء البيانات الحساسة داخل مقراتها. وفي السحابة يوجد كثير من المحركات المصممة لأعباء عمل مستودعات البيانات والتحليلات واسعة النطاق لتختار منها: Snowflake وAWS Redshift وGoogle BigQuery وغيرها الكثير.
كيف تستخدم الشركات البيانات الضخمة؟
كما ذُكر سابقًا، تجمع الشركات كميات من البيانات لا يمكن تخيلها. فمستشعرات المحركات في طائرة واحدة فقط تولّد 20 تيرابايت في الساعة. لكن بدون سياق تجاري ليست تلك البيانات سوى سلسلة من الآحاد والأصفار تشغل مساحة على القرص. ولا تصبح ذات قيمة لا تُقدّر إلا عندما نستطيع تحليلها بشكل صحيح واستخلاص رؤى عملية منها.
يدعم استكشاف البيانات الضخمة اتخاذ القرار في صناعات كثيرة. فهو يساعد على تحسين العلاجات وحياة المرضى في الرعاية الصحية، ويدعم قرارات تسويقية سليمة، ويساعد على كشف الاحتيال. وأخيرًا، تغذّي البيانات ثورة الذكاء الاصطناعي اليوم. فتُدرَّب نماذج تعلّم الآلة على كميات هائلة من المعلومات – وتؤثر جودة تلك البيانات وسلامتها في كفاءة الذكاء الاصطناعي ودقته.
في الفقرات التالية أصف حالات استخدام كلاسيكية من أربعة قطاعات صناعية استفادت من تحليلات البيانات الضخمة.
التجزئة (Retail)
لنبدأ بالتجزئة – مثال ممتاز على علم البيانات المطبَّق عمليًا. ينتج القطاع ككل أحجامًا هائلة من البيانات من مصادر كثيرة: المعاملات عبر الإنترنت وخارجه، وتفاعلات العملاء، ومستويات المخزون، وأنشطة سلسلة الإمداد، وغيرها. ويُظهر استخدامه للبيانات الضخمة قوة اتخاذ القرارات المبنية على البيانات، والاستراتيجيات المتمحورة حول العميل، وتحسين العمليات، ويبيّن كيف يمكن للبيانات الضخمة أن تعيد تشكيل صناعة تقليدية. فيما يلي بعض أكثر حالات استخدام تحليلات البيانات الضخمة شيوعًا:
تحليل السلوك
تطبّق شركات التجزئة علم البيانات والتحليلات على سلوك العملاء لتواصل تحسين عروضها. وتجمع هذه المعلومات في كل مرة يسجّل فيها المستخدم دخوله ويُجري عملية شراء، أو يتصفح ببساطة تشكيلة منتجات المتجر. وعندما يعود العملاء يرون منتجات تناسب أسلوبهم وذوقهم بناءً على ما اشتروه وتصفحوه سابقًا. وحتى حين لا ينوون شراء المزيد، تغريهم هذه العروض المخصصة بمشتريات إضافية.
قصة Target مثال معروف على تحليلات السلوك باستخدام البيانات الضخمة. فقد اكتشف مهندسو البيانات في Target أن منتجات معينة، مثل المستحضر غير المعطر ومكملات الفيتامينات، تشير إلى أن العميلة قد تكون حاملًا عند شرائها معًا. وبناءً على ذلك أنشأوا درجة للتنبؤ بالحمل، مكّنتهم من عرض إعلانات موجَّهة (دون قصد التورية) لمنتجات الأطفال تستهدف النساء ذوات الدرجات العالية في دالة التنبؤ.
إدارة المخزون
تستخدم شركات التجزئة تحليلات البيانات الضخمة لتحسين طريقة إدارة المخزون. فالتنبؤات الدقيقة بالطلب مع تحليل بيانات المبيعات التاريخية والحالية تساعدها على تجنب فائض المخزون ونفاده معًا. فمثلًا قد تستخدم شركات التجزئة تحليلات البيانات الضخمة للتنبؤ بالطلب الموسمي على المنتجات.
تعديل الأسعار
تطبيق آخر لتحليلات البيانات الضخمة في التجزئة هو تحديد الأسعار بناءً على تحليل أسعار المنافسين وبيانات المبيعات التاريخية وطلب العملاء واتجاهات السوق. وكل عامل من هذه العوامل ضروري لبناء خطط تسعير ديناميكية محسَّنة.
إدارة سلسلة الإمداد
تحلل شركات التجزئة سجلات الخدمات اللوجستية والنقل ومستويات المخزون لتحسين عمليات سلسلة الإمداد وتبسيطها. وهذا يؤدي إلى أوقات انتظار أقصر وحالات نفاد أقل.
تحليل اتجاهات السوق
تدعم البيانات الضخمة شركات التجزئة أيضًا في تحليل اتجاهات السوق وتفضيلات العملاء وبيانات المنافسين. فهي تدرس البيانات من منصات التواصل الاجتماعي وتقييمات العملاء والمنتديات على الإنترنت لفهم مشاعر العملاء وما يفضّلونه. وهذا يساعد على اكتشاف الاتجاهات الناشئة وتحسين عرض المنتجات.
الرعاية الصحية (Healthcare)
غيّرت تحليلات البيانات الضخمة قطاع الرعاية الصحية، وبدّلت جذريًا طريقة تقديم الرعاية الطبية. فالشركات الطبية تجمع كميات هائلة من بيانات المرضى، مثل السجلات الصحية الإلكترونية (EHRs) والمعلومات الجينومية وبيانات المراقبة في الزمن الحقيقي، ويمكن أن تدفع هذه البيانات الابتكار الطبي وتؤدي إلى نتائج علاجية أفضل.
ومن الأمثلة اللافتة على تحليلات البيانات الضخمة المراقبة في الزمن الحقيقي لبيانات حالات COVID-19، التي مكّنت مختصي الصحة العامة من تحديد بؤر الانتشار وتتبع كيفية انتشار المرض.
تحليل البيانات الطبية
تعتمد المؤسسات الصحية على تحليلات البيانات الضخمة لتمشيط كميات هائلة من البيانات وإيجاد أنماط في صحة السكان وحدوث الأمراض وفعالية العلاج. ويمكن للمرافق الصحية استخدام هذه النتائج لتصميم بروتوكولات علاج جديدة وتوزيع الموارد بشكل أكثر رشدًا ودعم جهود الصحة العامة مثل ترصّد الأمراض وإدارة تفشيها.
الرعاية الطبية الفردية
تتيح البيانات الضخمة الطب المخصص، حيث تُكيَّف رعاية المريض مع ملفه الجيني ونمط حياته وسماته الأخرى. وبذلك يستطيع الأطباء تصميم علاجات مخصصة للمرضى ذوي الحالات الصعبة، مثل السرطان وأمراض القلب والأوعية الدموية والشذوذات الجينية النادرة. فيمكن للمرافق الطبية مثلًا استخدام البيانات الجينومية لتحديد علاجات سرطانية مستهدفة بديلة بناءً على الشذوذات الجينية لدى المريض.
تطوير الأدوية
تجمع شركات الأدوية بيانات بيولوجية وكيميائية وسريرية لتسريع تطوير الأدوية الجديدة. وتطبّق صناعة الأدوية خوارزميات تعلّم الآلة للتنبؤ بفعالية الأدوية وسميّتها، وبذلك تخفّض تكلفة التجارب السريرية.
التحليلات التنبؤية الأولية
تستخدم شركات الرعاية الصحية البيانات التي تجمعها للتنبؤ بنتائج الأمراض وإيجاد الأشخاص المعرّضين لخطر مرتفع للإصابة بأمراض معينة. فيمكن لنماذج تعلّم الآلة، مثلًا، استخدام بيانات الأجهزة القابلة للارتداء لتوقع مشكلات صحية مثل النوبات القلبية.
الفعالية التشغيلية
يمكن أن يساعد تحليل بيانات جدولة المرضى وتخصيص الموارد وسلسلة الإمداد المؤسسات الصحية على أن تصبح أكثر كفاءة تشغيليًا – بتبسيط العمليات وخفض التكاليف وتحسين تدفق المرضى وتقليل الإنهاك الوظيفي لدى الموظفين.
الترفيه (Entertainment)
تساعد تحليلات البيانات الضخمة شركات الإعلام على فهم جماهيرها بشكل أفضل. والهدف الأسمى هو رفع معدلات تفاعل المستخدمين والاحتفاظ بهم.
اقتراح المحتوى
تستخدم منصات الإعلام تحليلات البيانات الضخمة لدراسة سلوك المستخدمين والتوصية بمحتوى يُرجَّح أن يستمتعوا به. فكل منصة رئيسية لبث الموسيقى تنشئ توصيات لقوائم التشغيل من أنماط استماع المستخدمين، وتعتمد منصات الفيديو على تحليلات البيانات لاقتراح محتوى بناءً على ما يشاهده المستخدمون.
تحسين الإعلانات
تتيح البيانات الضخمة للشركات فهم سلوك المستهلكين وما يفضّلونه. وهذا يجعل من الممكن تقديم إعلانات أكثر دقة وفعالية، مما يؤدي إلى عائد أفضل على الاستثمار (ROI).
التحليلات التنبؤية
بتحليل بيانات سلوك المستخدمين وعادات الاستهلاك تستطيع شركات الإعلام التنبؤ بنوع المواد التي ستحظى بالشعبية. وهذا يقلل خطر فشل المحتوى ويدعم قرارات استثمار أكثر حكمة.
مراقبة الأداء
تطبّق شركات الإعلام تحليلات البيانات الضخمة لمراقبة أداء محتواها عبر منصات كثيرة، مثل وسائل التواصل الاجتماعي وخدمات البث والمواقع الإلكترونية. وقد يساعدها ذلك على رصد الاتجاهات وتحسين استراتيجية المحتوى.
المالية (Finance)
تحليلات البيانات الضخمة لا غنى عنها لقطاع الخدمات المالية. وتعتمد عليها شركات التقنية المالية (FinTech) لتحسين تجربة العملاء والأمان وإدارة المخاطر ورفع الكفاءة التشغيلية.
أبحاث المستهلكين
تستخدم المؤسسات المصرفية تقنيات تحليلات البيانات الضخمة لإيجاد فرص البيع المتقاطع والبيع الأعلى وتخصيص العروض والترويجات. وعند تحليل ملاحظات العملاء يمكنها أيضًا تطبيق تحليل المشاعر لفهم تفضيلات العملاء ومواقفهم تجاه المؤسسة.
- ضبط المخاطر
بمساعدة تحليلات البيانات الضخمة تستطيع المؤسسات المالية إدارة مخاطر الائتمان والسوق والتشغيل بفعالية أكبر. وبتحليل بيانات السوق السابقة تستطيع المؤسسات المالية اكتشاف الاتجاهات والأنماط التي توجّه قرارات مقدار المخاطرة المقبول.
- التقارير التنظيمية وتقارير الامتثال
تساعد التحليلات المطبّقة على بيانات سجل المعاملات في الزمن الحقيقي المؤسسات المصرفية على الوفاء بالتزاماتها التنظيمية. ويمكن للمؤسسات المالية أتمتة جمع البيانات التنظيمية وتحليلها لضمان الامتثال لقواعد مثل اعرف عميلك (KYC) ومكافحة غسل الأموال (AML)
- التحليلات للتداول والاستثمار
تطبّق شركات التقنية المالية تحليل البيانات الضخمة لدراسة أنماط السوق والمعلومات المالية واستراتيجيات الاستثمار، مما يساعد المؤسسات على اتخاذ قرارات تداول واستثمار أفضل. ويمكن للمؤسسات المالية تحليل بيانات السوق، مثل أسعار الأسهم أو أحجام التداول، لإيجاد فرص استثمارية جديدة وتحسين استراتيجيات التداول.
- إدارة القروض
تستخدم الشركات المالية البيانات الضخمة أيضًا للتنبؤ بمعدلات التعثر عن سداد القروض وتقييم أهلية المقترضين وتحليل مخاطر الائتمان. وينتج عن ذلك إجراءات أكثر رشاقة لإدارة القروض واحتمال أقل للتعثر.
- اكتشاف الاحتيال
يأتي الاحتيال بأشكال كثيرة، مثل سرقة الهوية والمعاملات غير المصرح بها ببطاقات الائتمان أو الاحتيال في برامج الولاء. وبدراسة أنماط المعاملات وسلوك المستهلكين وبيانات الاحتيال السابقة تستطيع شركات التقنية المالية كشف المشكلات المحتملة. فهي تحلل البيانات في الزمن الحقيقي لرصد الأنماط المشبوهة، مثل المعاملات المنفَّذة من عدة مواقع خلال وقت قصير أو التحويلات المالية ذات الحجم غير المعتاد. ويمكن لنماذج تعلّم الآلة اكتشاف الاتجاهات غير المعتادة في سلوك العملاء، مثل التغيرات المفاجئة في عادات الشراء.
خاتمة
غيّرت البيانات الضخمة الطريقة التي تعمل بها الشركات في صناعات كثيرة وتتخذ بها قراراتها. فتحليلات البيانات هي المفتاح للبقاء في المقدمة في بيئة المنافسة اليوم، ومع تزايد أهمية الذكاء الاصطناعي ستزداد أهميتها أكثر.
هل تفكر في الجمع بين البيانات الضخمة وتعلّم الآلة للاستفادة من الإمكانات غير المستغلة في بياناتك؟ من خلال عملية استكشاف للبيانات يمكننا التحقق من فكرتك وبناء نموذج أولي (PoC) يوضح لك كيف تمضي قدمًا.