5 պատճառ, թե ինչու Drizzle ORM-ը գերազանցում է ավանդական JavaScript ORM-ներին
Բացահայտեք հինգ պատճառ, թե ինչու արժե ավելի ուշադիր նայել Drizzle ORM-ին, մասնավորապես արդյունավետության, հարցումների նկատմամբ լիարժեք վերահսկողության և մաքուր TypeScript ճարտարապետության առումով։
TypeScript էկոհամակարգը արագ աճում է և ավանդական JavaScript ORM-ների (Object Relational Mapping) փոխարեն բերում է ավելի լավ, ավելի անվտանգ այլընտրանքներ։ Drizzle-ը և Prisma-ն դրանց թվում ամենաուշագրավներից են։ Թեև երկուսն էլ թույլ են տալիս մշակողներին աշխատել տվյալների բազաների հետ տիպով անվտանգ եղանակով, դրանք մարմնավորում են տարբեր փիլիսոփայություններ։
Այս հոդվածում ես կկենտրոնանամ 5 պատճառի վրա, թե ինչու Drizzle ORM-ն արժանի է ձեր ուշադրությանը, մասնավորապես.
- արդյունավետություն,
- հարցումների նկատմամբ լիարժեք վերահսկողություն,
- մաքուր TypeScript ճարտարապետություն։
1. Առաջնակարգ մշակողի փորձ
Drizzle ORM-ը ստեղծված է այն մշակողների համար, ովքեր ուզում են լիակատար պատկերացում և վերահսկողություն իրենց տվյալների շերտի նկատմամբ՝ առանց կոդավորման հարմարավետությունը զոհաբերելու։
Այն տրամադրում է.
- հիանալի IntelliSense աջակցություն՝ ավտոմատ լրացմամբ, տիպերի ածանցմամբ և ներկառուցված փաստաթղթերով,
- տիպային անվտանգություն կոմպիլյացիայի ժամանակ, այնպես որ եթե հարցումը սխալ է, TypeScript-ը կզգուշացնի ձեզ,
- կլիենտի ստեղծման քայլի բացակայություն, ինչը նշանակում է ավելի քիչ շարժվող մաս և ավելի արագ իտերացիա։
Վերջին կետի մասին. ի տարբերություն Prisma-ի նման ORM-ների, Drizzle-ին լրացուցիչ քայլ պետք չէ սխեմայից կլիենտ գրադարան ստեղծելու համար։ Prisma-ում տվյալների բազայի սխեման սահմանում եք .prisma ֆայլում, իսկ հետո, հատուկ TypeScript կլիենտ ստեղծելու համար, պետք է գործարկել հրամանը.
npx prisma generateՍտացված կլիենտը ծառայում է որպես ինտերֆեյս դեպի տվյալների բազա և պետք է վերաստեղծվի սխեմայի յուրաքանչյուր փոփոխության ժամանակ։
Kysely-ն TypeScript էկոհամակարգի մեկ այլ հայտնի գրադարան է։ Դա թեթև, տիպով անվտանգ SQL query builder է, որը նույնպես նպատակ ունի հեշտացնել մշակողների կյանքը։ Prisma-ի նման՝ Kysely-ին առանձին քայլ է պետք տիպերի մասին տեղեկությունը կոդ ներմուծելու համար։ Մշակողները սովորաբար կա՛մ ինտերֆեյսները գրում են ձեռքով, կա՛մ ապավինում են արտաքին գործիքների, ինչպիսին kysely-codegen-ն է, որը ստուգում է տվյալների բազայի սխեման և իրական աղյուսակներից ստեղծում TypeScript սահմանումներ.
- Քայլ 1. սահմանել տվյալների բազայի ինտերֆեյսը,
- Քայլ 2. ստեղծել տիպերի սահմանումներ տվյալների բազայի սխեմայի համար։
Այսպիսով, թեև Kysely-ն տալիս է մեծ ճկունություն և ուժեղ տիպավորում, այն նաև ավելացնում է լրացուցիչ քայլեր և գործիքակազմ՝ տիպերը տվյալների բազայի հետ համաձայնեցված պահելու համար։ Սխեման հաճախ գտնվում է հավելվածի կոդից դուրս, և երկուսը կապված պահելը կարող է սխալների աղբյուր լինել կամ հանգեցնել անհետևողական տիպավորման, եթե որևէ մեկը բաց թողնի ստեղծման քայլը։
Drizzle-ը այս ամենից ազատվում է։ Սխեմայի ֆայլերի և կոդի գեներացիայի վրա ապավինելու փոխարեն՝ Drizzle-ը մշակողներին թույլ է տալիս տվյալների բազայի սխեման սահմանել անմիջապես TypeScript-ով, և հարցումները գրվում են այդ սխեմայի դեմ՝ բնիկ TypeScript արտահայտություններով։ Չկա միջանկյալ կլիենտի շերտ, կոմպիլյացիայի քայլ և հնարավորություն, որ տիպերը հեռանան իրական սխեմայից։
Արդյունքը.
- ավելի արագ իտերացիա (մշակողները կլիենտի ստեղծմանը սպասելու կարիք չունեն),
- ավելի նիհար գործիքակազմեր,
- ավելի քիչ սխալներ, որոնք առաջանում են սխեմաների և կլիենտների համաժամանակությունը կորցնելուց,
- ավելի հարթ ադապտացիա նոր մշակողների համար (քանի որ այն, ինչ տեսնում են կոդում, հենց այն է, ինչ ստանում են)։
Drizzle-ի մոտեցումը մշակողի փորձը դարձնում է ավելի թափանցիկ և ուղիղ և ավելի լավ է համապատասխանում ժամանակակից TypeScript աշխատանքային հոսքերին։
Աղյուսակի սահմանումը կարող է այսպիսի տեսք ունենալ.
import { pgTable, uuid, varchar, timestamp } from 'drizzle-orm/pg-core';

export const users = pgTable('users', {
  id: uuid('id').primaryKey().defaultRandom(),
  email: varchar('email').notNull().unique()
  createdAt: timestamp('created_at')
.notNull()
.defaultNow(),
});
Իսկ այդ սխեմայի դեմ հարցումը կարող է այսպիսի տեսք ունենալ.
import { eq } from 'drizzle-orm';
import db from '../db';
import { users } from '../db/schema';

export const getAllUsers = async () => {
  return await db.select().from(users)
};
2. Հարցումների API. տիպավորված և պարզ
Drizzle-ը կիրառում է SQL-first մոտեցում՝ հարցումները պահելով ergonomic և հեշտ ընթեռնելի։ Այն մշակողներին չի ստիպում սովորել դոմենային սխեմայի լեզու։ Prisma-ի դեպքում, ընդհակառակը, մշակողները տվյալների բազաները նկարագրում են Prisma Schema Language-ով, և Prisma-ն այդ սխեմայից ստեղծում է TypeScript կլիենտ։ Դրա մասին ավելին կարող եք իմանալ Prisma-ի կայքում։
Prisma-ն թաքցնում է SQL-ը և առաջարկում է հարցումների API, որը կենտրոնացած է entity-ների հետ աշխատանքի վրա։ Հարցում գրելը նման է սովորական JavaScript-ին նմանվող օբյեկտների հետ աշխատելուն.
// Prisma query API

const users = await prisma.users.findMany({
  where: {
    OR: [
      { email: { contains: 'mail.com' } },
      { name: { startsWith: 'C' } }
    ],
    articles: { some: { published: true } }
  },
  select: {
    id: true,
    email: true,
    _count: { select: { articles: true } }
  },
  take: 5
});
Նման հարցումները թույլ են տալիս մշակողներին գործել բարձր մակարդակով։ Նրանք join-ների կամ հում SQL-ի մասին մտածելու կարիք չունեն. պարզապես նկարագրում են, թե ինչ են ուզում, և Prisma-ն հոգ է տանում մնացած ամեն ինչի մասին կապոտի տակ։
Drizzle-ն ընդունում է SQL հասկացությունները և առաջարկում է հարցումների API, որը զգացվում է որպես SQL գրել անմիջապես TypeScript-ով. արտահայտիչ, կանխատեսելի և տվյալների բազայի շերտին մոտ։
Ի տարբերություն Prisma-ի նման լուծումների, որոնք ապավինում են առանձին դոմենային լեզվի (DSL) և տիպավորված կլիենտ ստեղծելու կոդի գեներացիայի քայլի, Drizzle-ն աշխատում է ամբողջությամբ TypeScript կոդային բազայի ներսում։ Թե՛ տվյալների բազայի սխեման, թե՛ հարցումները սահմանվում են կոդով, և տիպային անվտանգությունը ածանցվում է անմիջապես այդ սահմանումներից՝ առանց արտաքին սխեմայի ֆայլերի կամ ստեղծված կլիենտների անհրաժեշտության։
Սա պարզեցնում է մշակման աշխատանքային հոսքը և վերացնում է տվյալների բազայի մոդելն ու կլիենտի API-ն համաժամանակեցված պահելու անհրաժեշտությունը։
Երբ ծրագրավորողը փոխում է սխեման, TypeScript տիպերը թարմացվում են ինքնուրույն, և լրացուցիչ քայլեր պետք չեն։ Սա ձեզ տալիս է ավելի շատ վերահսկողություն կատարվողի նկատմամբ.
// Drizzle query API

const users = await db.select({
  id: users.id,
  email: users.email,
  articleCount: sql`count(${articles.id})`
.as('article_count')
})
.from(users)
.leftJoin(articles, eq(users.id, articles.authorId))
.where(
  or(
    like(users.email, '%mail.com%'),
    like(users.name, 'C%')
  )
)
.groupBy(users.id, users.email)
.having(gt(sql`count(${articles.id})`, 0))
.limit(5);
Այս API-ն տրամադրում է.
- կանխատեսելի վարք (կատարվում է միայն այն, ինչ գրում եք),
- TypeScript-ի լիարժեք ծածկույթ,
- ոչ մի թաքնված կախարդանք. լիարժեք տեսանելիություն, թե որ հարցումն է ուղարկվում։
Ավելին, քանի որ Drizzle հարցումները շատ նման են template literal-ներում կամ կառուցվածքային արտահայտություններում գրված հում SQL-ին, խմբագրիչի մի շարք ընդլայնումներ կարող են բարելավել մշակողի փորձը։ Visual Studio Code-ն, օրինակ, ունի այնպիսի ընդլայնումներ, ինչպիսիք են.
- SQL Lit,
- SQL tagged template literals։
Նման ընդլայնումները կարող են ստուգել SQL շարահյուսությունը կամ նշել տիպիկ սխալները անմիջապես խմբագրիչում, ինչը հեշտացնում է սխալները վաղ նկատելը՝ նույնիսկ մինչ հավելվածի գործարկումը։
Այդուհանդերձ, մշակողների կյանքը հեշտացնելու համար Drizzle-ը տրամադրում է նաև ավելի բարձր մակարդակի ռելյացիոն API.
const userWithArticles = await db.query.users.findFirst({
  where: eq(users.id, 1),
  with: {
    articles: {
      where: eq(articles.published, true),
      limit: 5
    }
  }
});
3. Prepared statements. արդյունավետության աճ
Drizzle-ն անմիջապես աջակցում է prepared statements, մշակողներին տալով արդյունավետությունը բարելավելու պարզ եղանակ, հատկապես serverless միջավայրերում։
Հասկանալու համար, թե ինչու են prepared statements-ը բարձրացնում արդյունավետությունը, տեսնենք, թե ինչ է կատարվում կապոտի տակ, երբ հարցումը կատարվում է Drizzle-ից կամ մեկ այլ ORM-ից։ Տվյալների բազայի դեմ հարցում կատարելը ներառում է մի քանի քայլ, ինչպես ցույց է տալիս ստորև նկարը.
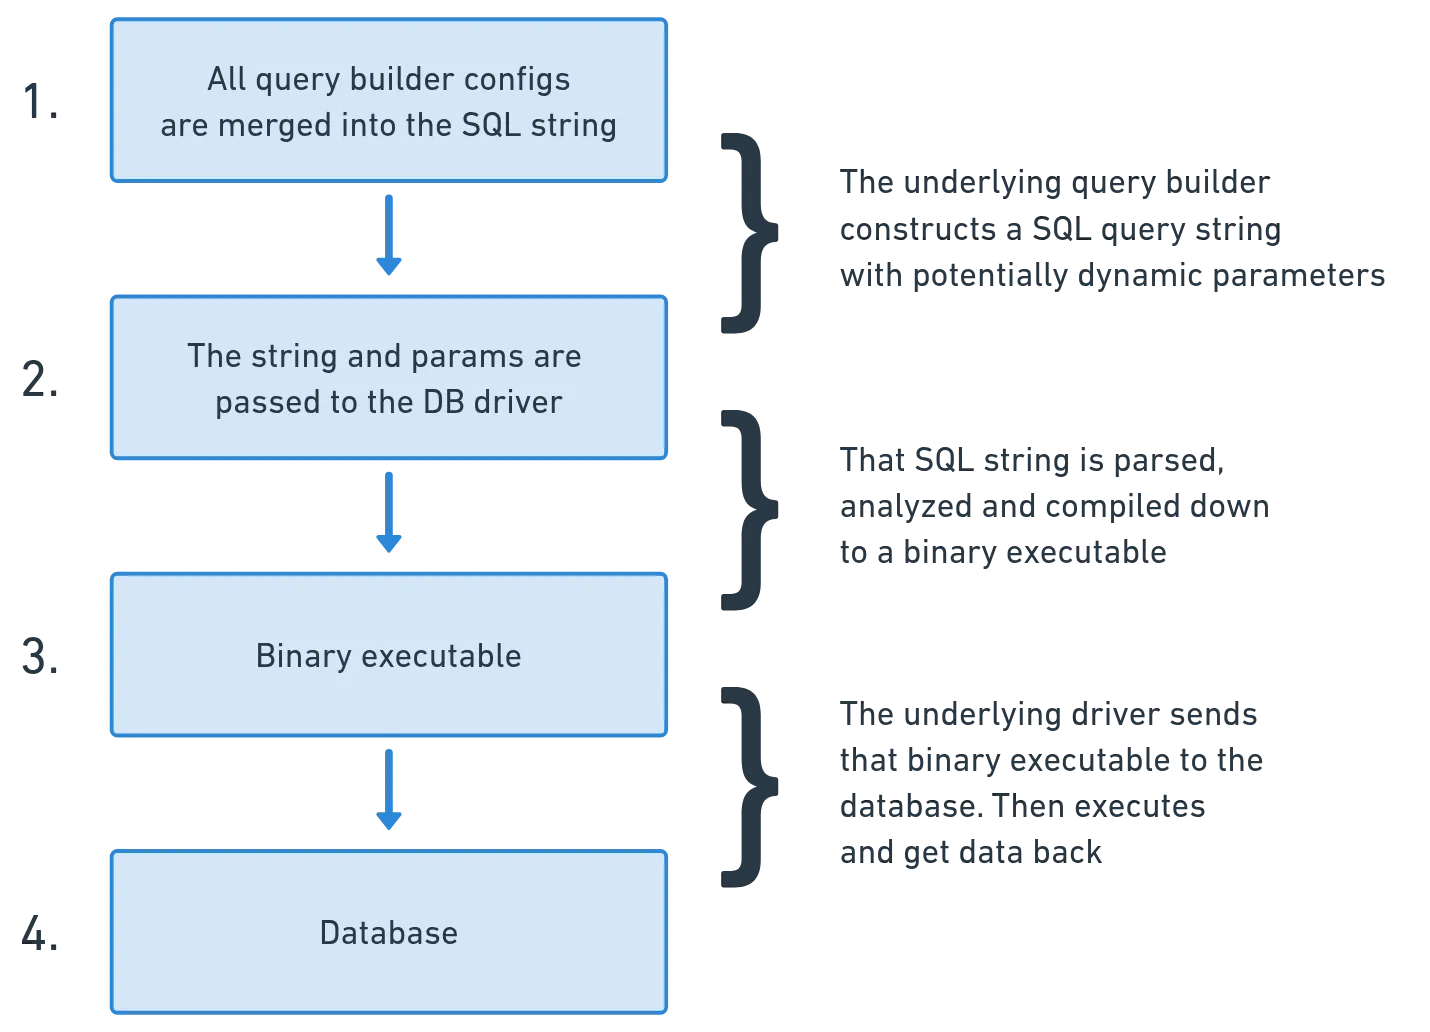
Վերևում ցուցադրված գործընթացը տեղի է ունենում ամեն անգամ, երբ SQL-ը կատարվում է query builder-ի միջոցով։ Սովորաբար սա մեծ խնդիր չէ և հազվադեպ է արդյունավետության խնդիրներ առաջացնում։ Բայց երբ մշակողները գործ ունեն շատ բարդ հարցումների հետ, օրինակ՝ բազմաթիվ join-ներով և դրույթների շարքով, վերլուծությունը, անալիզը և կոմպիլյացիան ավելորդ կերպով կրկնվում են յուրաքանչյուր կատարման ժամանակ։ Դա տեղի է ունենում նույնիսկ եթե հարցման կառուցվածքը մնում է նույնը, և փոխվում են միայն պարամետրերը։
Եթե 1-ին, 2-րդ և 3-րդ քայլերը կարելի լիներ կատարել նախապես և նրանց արդյունքները կրկին օգտագործել, վերադիրը կարող էր զգալիորեն կրճատվել։ Հնարքն այն է, որ շարունակենք աջակցել դինամիկ պարամետրերին՝ խուսափելով կրկնվող կոմպիլյացիայից։ Հենց դա են թույլ տալիս prepared statements-ը. դրանք առաջին քայլերի կրկնվող կատարումը փոխարինում են նախակոմպիլացված հարցման կառուցվածքով, որը runtime-ում ընդունում է դինամիկ մուտքեր.
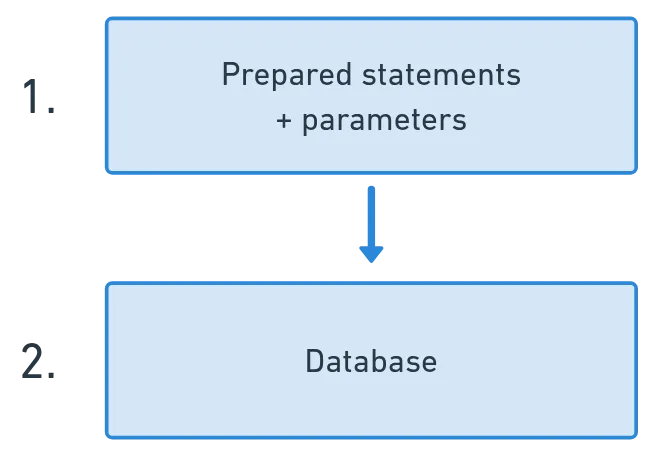
Prepared statements-ը նշանակում են, որ.
- տվյալների բազան կարող է նորից օգտագործել հարցման պլանը՝ կրճատելով վերլուծության ժամանակը,
- հարցումների լատենտությունը նվազում է. հիանալի է cold start-երի համար,
- խուսափում եք runtime string interpolation-ից կամ ձեռքով սանիտիզացիայից, որոնք երկուսն էլ SQL injection խոցելիությունների հաճախակի պատճառ են։ Prepared statements-ը հարցման կառուցվածքը պահում են տվյալներից առանձին, ուստի օգտատիրոջ մուտքը միշտ անվտանգ պարամետրիզացվում է և երբեք չի կատարվում որպես SQL տրամաբանության մաս։
Ահա, թե ինչ տեսք կարող է ունենալ prepared statement-ը.
const db = drizzle(...);
const prepared = db.select()
.from(users)
.prepare("statement_name");

const res1 = await prepared.execute();
const res2 = await prepared.execute();
const res3 = await prepared.execute();
Եվ ահա մեկը placeholder-ով (երբ դինամիկ runtime արժեք պետք է ներդնել).
const u1 = db
  .select()
  .from(users)
  .where(eq(users.id, sql.placeholder('id')))
  .prepare("u1");

await u1.execute({ id: 1 }) // SELECT * FROM users WHERE id = 1
await u1.execute({ id: 2 }) // SELECT * FROM users WHERE id = 2
Ի տարբերություն Prisma-ի, որը SQL-ը կառուցում և կատարում է runtime-ում կոմպիլյացված կլիենտի միջոցով, Drizzle-ի prepared statements-ը գտնվում են տվյալների բազայի ավելի մոտ և ապահովում են շատ ավելի արագ cold start ժամանակներ. վճռորոշ գործոն serverless տեղակայումներում, ինչպիսին AWS Lambda-ն է։
4. Ոչ մի runtime կախարդանք. մաքուր և դեկլարատիվ կոդ
Drizzle-ը ոչ մի ենթադրություն չի անում այն մասին, թե ինչպես պետք է վարվեն հարցումները։ Չկա թաքնված վիճակ, բարդ կլիենտի գեներացիա և վերացարկման շերտեր, որոնք կանգնած լինեն ձեր կոդի և SQL-ի միջև։
Prisma-ում սխեման սահմանվում է .prisma ֆայլում, որից հետո պետք է գործարկել CLI՝ կլիենտը ստեղծելու համար։ Kysely-ն ունի համանման գործընթաց, որտեղ տիպային անվտանգությունը սովորաբար ստացվում է TypeScript ինտերֆեյսներ տվյալների բազայի սխեմայից արտաքին գործիքներով ստեղծելով։ Ամեն դեպքում, սկզբնական սխեման և ստեղծված տիպերը համաժամանակեցված պահելը պահանջում է լրացուցիչ build քայլ և ավելի շատ գործիքներ։
Drizzle-ի դեպքում, ընդհակառակը.
- ծրագրավորողները սխեման և հարցումները հայտարարում են սովորական TypeScript-ով,
- չկա կլիենտի շերտ, որը կարող է սխալ հասկանալ, թե ինչ նկատի ուներ մշակողը,
- հարցումները միշտ թափանցիկ են. SQL կառուցվածքը հենց այնտեղ է՝ տեսանելի կոդում։
Արդյունքը ավելի հուսալի վրիպազերծումն է և ավելի քիչ անակնկալներ production-ում։
Ավելի խորը համեմատության համար տե՛ս ստորև «Drizzle և Prisma. թարգմանության տարբեր ռազմավարություններ» բաժինը։
5. Մինիմալ և կոմպոզիցիոն նախագիծ
Drizzle-ը հետևում է մոդուլային, կոմպոզիցիոն նախագծման փիլիսոփայության։ Ամեն ինչ մեկ մոնոլիտ գործիքակազմի մեջ փաթեթավորելու փոխարեն՝ այն տրամադրում է փոքր, կենտրոնացած գործիքներ.
- drizzle-orm. query builder-ը,
- drizzle-kit. ընտրովի CLI միգրացիաների կառավարման համար,
- ադապտերներ կոնկրետ տվյալների բազաների համար (օրինակ՝ pg, mysql, sqlite) – առանց ավելորդ ծանրաբեռնվածության։
Դրա շնորհիվ Drizzle-ը.
- հեշտ է ինտեգրել ցանկացած backend ֆրեյմվորքի հետ (Express, Bun, Hono և այլն),
- բավականաչափ թեթև է edge և serverless տեղակայումների համար,
- կատարյալ ընտրություն է միկրոսերվիսային ճարտարապետության կամ մոդուլային monorepo-ների համար։
Այս մոդուլայնությունը հնարավորություն է տալիս ճկուն նախագծային դասավորությունների և մտահոգությունների մաքուր բաժանման։ Քանի որ Drizzle-ին չեն պետք ո՛չ կենտրոնացված կոդի գեներացիայի քայլ, ո՛չ մոնոլիտ կլիենտ, այն լավ տեղավորվում է սերվիսակենտրոն կամ շերտավորված ճարտարապետություններում։ Տվյալների բազայի փոխազդեցությունները որոշակի մոդուլներով կամ փաթեթներով սահմանափակելը դառնում է ավելի հեշտ՝ առանց գլոբալ runtime-ի կամ ընդհանուր կլիենտի ինստանսի պարտադրման։
Դրանից բացի, խուսափելով ամուր կապված վերացարկումներից և մնալով ստանդարտ TypeScript և SQL կառուցվածքների վրա, Drizzle-ը մնում է բավականին թեթև և հարմարվում է տարբեր կոնֆիգուրացիաներին՝ ավանդական սերվերային միջավայրերից մինչև edge runtime-ներ և serverless հարթակներ։
Drizzle և Prisma. թարգմանության տարբեր ռազմավարություններ
Թեև Drizzle-ը և Prisma-ն երկուսն էլ նպատակ ունեն հարթեցնել տվյալների բազայի հասանելիությունը, դրանք դա անում են սկզբունքորեն տարբեր ձևերով։
Prisma. օգտագործում է schema-first մոդել՝ առաջնահերթություն տալով պարզությանը և վերացարկմանը։ Մշակողները տվյալների մոդելը սահմանում են հատուկ սխեմայի լեզվով, և Prisma-ն ստեղծում է կլիենտ OOP ոճի API-ով։ Այն թաքցնում է SQL-ը, բայց դա կարող է նաև բերել արդյունավետության խնդիրներ, ավելի քիչ ճկունություն և «արտահոսող» վերացարկումներ։
Drizzle. որդեգրում է SQL-first, schema-as-code, TypeScript-native մոտեցում։ Նրա նշանաբանն է. «Եթե գիտեք SQL, գիտեք Drizzle»։ Այն շեշտը դնում է թափանցիկության, վերահսկողության և կանխատեսելիության վրա։ Չկա կլիենտի գեներացիա, թաքնված վարք և ոչ մի անսպասելի բան runtime-ում։ Դա կատարյալ գործիք է այն մշակողների համար, ովքեր ուզում են մնալ տվյալների բազային մոտ՝ վայելելով ուժեղ տիպավորում և IDE աջակցություն։
Տվյալների մոդելավորում
Տեսնենք հիմա, թե ինչպես է սահմանվում տվյալների բազայի սխեման և ինչպես կարող են մշակողները դրան հղվել տվյալներ հարցնելիս.
// Prisma ORM

model User {
  id         Int     @id @default(autoincrement())
  name       String?
  email      String  @unique
  articles Article[]
}

model Article {
  id        Int     @id @default(autoincrement())
  title     String
  content   String?
  published Boolean @default(false)
  authorId  Int?
  author    User?   @relation(fields: [authorId], references: [id])
}
Դրանից հետո Prisma-ն ստեղծում է տիպով անվտանգ կլիենտ, որը կարող եք օգտագործել ձեր կոդում.
import { PrismaClient } from '@prisma/client'
const prisma = new PrismaClient()

async function main() {
  const user = await prisma.user.create({
    data: {
      email: 'john@doe.com',
      name: 'John',
      articles: {
        create: { title: 'Article no. 1' }
      }
    },
    include: { articles: true }
  })
}
Այս դասավորությունը կոկիկ կերպով բաժանում է սխեման հավելվածի մնացած կոդից և ձեզ տալիս է ճշմարտության մեկ աղբյուր։ Թերությունն այն է, սակայն, որ մշակողները պետք է կոդի գեներացիայի քայլ գործարկեն սխեմայի յուրաքանչյուր փոփոխության ժամանակ։
Drizzle-ի մոտեցումը սխեմայի սահմանման համար ապավինում է ծրագրային TypeScript API-ին.
import {
  boolean,
  integer,
  pgTable,
  serial,
  text,
  uniqueIndex,
  varchar,
} from 'drizzle-orm/pg-core'

export const users = pgTable('users', {
  id: serial('id').primaryKey(),
  name: varchar('name', { length: 256 }),
  email: varchar('email', { length: 256 }).unique(),
})

export const articles = pgTable('articles', {
  id: serial('id').primaryKey(),
  title: varchar('title', { length: 256 }).notNull(),
  content: text('content'),
  published: boolean('published'),
  authorId: serial('author_id').references(() => users.id),
});

export const usersRelations = relations(users, ({ many }) => ({
  articles: many(articles)
}));
Drizzle-ի հետ ես կարող եմ այս սխեմայի օբյեկտներն օգտագործել անմիջապես իմ հարցումներում, օրինակ.
async function main() {
  const user = await db.insert(users)
    .values({ email: 'john@doe.com', name: 'John' })
    .returning();

  await db.insert(articles)
    .values(
      { title: 'Article no. 1', authorId: user.id }
    );

  const userWithArticles = await db.query.users
    .findFirst({
      where: (users, { eq }) => eq(users.id, user.id),
   with: { articles: true }
    });
}
Drizzle-ը ապավինում է TypeScript կոմպիլյատորին՝ սխեմայի հետ կապված խնդիրները բռնելու համար, ուստի հավելվածը անմիջապես արտացոլում է սխեմայի ցանկացած փոփոխություն՝ առանց վերակառուցման կամ կոդի գեներացիայի գործարկման։
Կապեր
Աղյուսակների միջև կապերի մշակումը տվյալների բազաների հետ աշխատանքի ավելի բարդ մասերից է, հատկապես TypeScript միջավայրում։ Այն, թե ինչպես են Prisma-ն և Drizzle-ը զբաղվում կապերով, բացահայտում է ORM-ի նախագծման նրանց հակադիր փիլիսոփայությունները։
Prisma-ն կապերը դիտարկում է որպես իր համակարգի հիմնական մաս։ Դրանք ներկառուցված են անմիջապես և՛ սխեմայի, և՛ ստեղծված կլիենտի մեջ։ Prisma Schema Language-ում մշակողները կապերը հայտարարում են հստակ, կառուցվածքային ձևով.
model User {
  id         Int        @id @default(autoincrement())
  articles   Article[]   // One-to-many relationship
  profile    Profile?    // One-to-one relationship
}

model Article {
  id       Int  @id @default(autoincrement())
  author   User @relation(fields: [authorId], references: [id])
  authorId Int
}

model Profile {
  id     Int  @id @default(autoincrement())
  user   User @relation(fields: [userId], references: [id])
  userId Int  @unique
}
Այս կապակենտրոն նախագիծը տարածվում է նաև այն վրա, թե ինչպես են մշակողները հարցումներ գրում։ Կապված տվյալները ստեղծվում, ստացվում և թարմացվում են կոկիկ, ներդրված շարահյուսությամբ.
const user = await prisma.user.create({
  data: {
    email: 'john@doe.com',
    articles: {
      create: [{ title: 'Article no. 1' }]
    },
    profile: {
      create: { bio: 'The programmer' }
    }
  }
});

// Querying with relationship filters
const users = await prisma.user.findMany({
  where: {
    articles: {
      some: { published: true }
    }
  }
});
Prisma-ի համակարգի ուժը կայանում է նրանում, թե որքան է այն պարզեցնում բարդ տվյալների գործողությունները։ Մշակողները կարող են բազմամակարդակ գործողություններ (օրինակ՝ կապված գրառումներ ստեղծել) կատարել մեկ հարցմամբ, մինչդեռ Prisma-ն կուլիսների հետևում պահպանում է տվյալների ամբողջականությունը և համահունչությունը։ Կարիք չկա ձեռքով զբաղվել արտաքին բանալիներով կամ գրել մի քանի հարցում՝ ամեն ինչ համահունչ պահելու համար։
Drizzle-ը գնում է այլ ճանապարհով։ Աղյուսակները և կապերը սահմանվում են առանձին. մշակողները աղյուսակները սահմանելու համար օգտագործում են schema builder-ը, իսկ դրանք կապելու համար՝ առանձին relations API.
export const users = pgTable('users', {
  id: serial('id').primaryKey(),
  email: text('email').notNull()
});

export const articles = pgTable('articles', {
  id: serial('id').primaryKey(),
  title: text('title').notNull(),
  authorId: serial('author_id').references(() => users.id)
});

// Relationship definitions
export const usersRelations = relations(users, ({ many }) => ({
  articles: many(articles)
}));

export const articlesRelations = relations(articles, ({ one }) => ({
  author: one(users, {
    fields: [articles.authorId],
    references: [users.id]
  })
}));
Այս նախագիծը ավելի բացահայտ է. այն տվյալների կառուցվածքը պահում է դրա ասոցիացիաներից առանձին։ Կապված տվյալներ հարցնելու համար Drizzle-ը տրամադրում է ռելյացիոն API, որը թույլ է տալիս մշակողներին կապված գրառումները բեռնել ինտուիտիվ եղանակով.
const userWithArticles = await db.query.users.findFirst({
  with: {
    articles: {
      where: eq(articles.published, true),
      limit: 5
    }
  }
});
Առանցքային տարբերությունն այն է, թե որքան սերտ են ինտեգրված կապերը։ Prisma-ն դրանք խորապես հյուսում է թե՛ կարդալու, թե՛ գրելու մեջ՝ ավտոմատացնելով ծանր աշխատանքի մեծ մասը։ Drizzle-ը ամեն ինչ պահում է ավելի առանձին և մշակողից ավելի գիտակցված մոտեցում է պահանջում՝ զիջելով որոշակի հարմարավետություն՝ դիմաց ստանալով մանրակրկիտ վերահսկողություն։
SQL տրանզակցիաները Drizzle ORM-ով
Տվյալների համահունչությունն ու ամբողջականությունը պահպանելը կարևոր է ցանկացած հավելվածում, որը կատարում է մի քանի փոխկապակցված տվյալների բազայի գործողություններ։ Երբ հարցումների խումբը պետք է կամ բոլորը հաջողվեն, կամ բոլորը ձախողվեն միասին, տրանզակցիոն վերահսկողությունը անփոխարինելի է։
Պատկերացրեք բովանդակություն հրապարակող համակարգ, որը նոր հոդվածները պահպանում է տվյալների բազայում։ Հոդվածի հրապարակումը կարող է ներառել.
- հոդվածի գրառման ներդրում,
- դրա կապումը հեղինակի հետ,
- թեգերի հավաքածուի կցում։
Եթե հոդվածը ներդրվում է, բայց թեգերի վերագրումը ձախողվում է (ասենք, բացակայող արտաքին բանալու կամ սահմանափակման խախտման պատճառով), համակարգը կարող է մնալ թերի տվյալներով. որբ հոդված, որը զուրկ է ցանկացած համատեքստից։ Նման անհամապատասխանությունները դժվար է նկատել և շտկել հետո։
Նման խնդիրները կանխելու համար SQL տվյալների բազաները առաջարկում են տրանզակցիաներ, որոնք գործողությունների շարքը միավորում են մեկ ատոմար միավորի մեջ։ Տրանզակցիաները հետևում են ACID սկզբունքներին.
- Atomicity (ատոմարություն). կամ տրանզակցիայի յուրաքանչյուր գործողություն հաջողվում է, կամ դրանցից ոչ մեկը ուժի մեջ չի մտնում։
- Consistency (համահունչություն). տվյալների բազան վավեր վիճակում է և՛ տրանզակցիայից առաջ, և՛ հետո։
- Isolation (մեկուսացում). համաժամանակյա տրանզակցիաները չեն խանգարում միմյանց միջանկյալ վիճակին։
- Durability (դիմացկունություն). հաստատվելուց հետո փոփոխությունները գոյատևում են նույնիսկ համակարգի ձախողման դեպքում։
Տրանզակցիաներ Drizzle-ով
Drizzle ORM-ը լիովին աջակցում է տրանզակցիոն գործողություններ հիմքում ընկած տվյալների բազայի ադապտերի միջոցով։ PostgreSQL-ում դա արվում է պարզ, ինտուիտիվ API-ով, որտեղ տրանզակցիայի համատեքստը փոխանցվում է որպես մեկուսացված tx ինստանս (https://orm.drizzle.team/docs/transactions)։
Ստորև ներկայացված է տրանզակցիայի օրինակ, որը ներդնում է article, վերագրում է author և կցում է tags՝ այս ամենը գործողությունների մեկ բլոկի ներսում.
const db = drizzle(...);

await db.transaction(async (tx) => {
  const [article] = await tx
    .insert(articles)
    .values({
      title: 'Understanding Drizzle Transactions',
      published: true,
    })
    .returning();

  await tx.insert(articleAuthors).values({
    articleId: article.id,
    authorId: '7d4ae4dc-faac-4d48-9320-6865110aa0d5',
  });

  await tx.insert(articleTags).values([
    { articleId: article.id, tagId: 'typescript' },
    { articleId: article.id, tagId: 'database' },
  ]);
});
Եթե տրանզակցիայի բլոկի ներսում որևէ գործողություն ձախողվի, բոլոր նախորդ փոփոխությունները ավտոմատ կերպով հետ են գլորվում։ Դուք պետք չէ ինքներդ ROLLBACK կամ COMMIT հրամաններ տալ. Drizzle-ը դա անում է կապոտի տակ։
Այս տրանզակցիոն մոդելը ձեզ տալիս է.
- Անվտանգություն. մասնակի գրառումները երբեք չեն պահպանվում։
- Հստակություն. տրանզակցիոն մտադրությունը բացահայտ է և սահմանափակված։
- Կոմպոզիցիոնություն. հավելվածի ցանկացած մաս կարող է անվտանգ օգտագործել տրանզակցիաներ՝ առանց տվյալների բազայի ինտերֆեյսը փոխելու։
Savepoint-ներ և ներդրված տրանզակցիաներ
Ավելի բարդ սցենարներում գուցե անհրաժեշտ լինի հաստատել կամ հետ գլորել տրանզակցիոն աշխատանքային հոսքի միայն որոշակի մասեր։ Հենց այստեղ են օգտակար լինում savepoint-ները և ներդրված տրանզակցիաները։
Drizzle ORM-ը աջակցում է ներդրված տրանզակցիոն գործողություններ՝ նորից օգտագործելով տրանզակցիոն բլոկին փոխանցված tx օբյեկտը։ Եթե ներդրված բլոկը ձախողվում է, միայն այդ մասն է հետ գլորվում. արտաքին տրանզակցիան անփոփոխ է մնում, եթե սխալը չի տարածվում։
Սա հնարավորություն է տալիս կառուցել մոդուլային, դիմացկուն տրանզակցիոն հոսքեր։ Ահա օրինակ.
const db = drizzle(...);

await db.transaction(async (tx) => {
  await tx.insert(logs).values(
    { message: 'Starting import...' }
  );

  try {
    await tx.transaction(async (tx2) => {
      await tx2.insert(importQueue).values(
        { fileId: '9bb1fceb' }
      );
      await tx2.insert(importResults).values(
        { fileId: 'cb1f1766', success: true }
      );
    });
  } catch (error) {
    await tx.insert(logs).values(
      { message: 'Import failed. Rolling back nested transaction.' }
    );
    // The nested transaction is rolled back, the outer one continues.
  }

  await tx.insert(logs).values(
    { message: 'Outer transaction continues...' }
  );
});
Այս կառուցվածքը.
- կանխում է ձախողումների ավելորդ տարածումը,
- օգնում է կողմնակի էֆեկտները պահել մոդուլային,
- տալիս է մանրակրկիտ վերահսկողություն այն բանի վրա, թե ինչպես են վարվում հետ գլորումները։
Թեև Drizzle-ը թույլ է տալիս տրանզակցիայի բլոկները ներդնել, PostgreSQL-ը բնիկ չի աջակցում իսկական ներդրված տրանզակցիաներ։ PostgreSQL-ը թույլ է տալիս միայն մեկ ակտիվ տրանզակցիա յուրաքանչյուր միացման համար։ Ներդրումը նմանակելու համար Drizzle-ը ներքուստ օգտագործում է SQL savepoint-ներ։
Երբ կանչվում է ներդրված tx.transaction(...), Drizzle-ը տալիս է SAVEPOINT։ Եթե սխալ է բարձրացվում, այն կատարում է ROLLBACK TO SAVEPOINT. Արտաքին տրանզակցիան շարունակում է անփոփոխ, եթե սխալը կրկին չի նետվում։
Այս իրականացումը ապահովում է հետևողական մշակողի փորձ տվյալների բազայի տարբեր backend-ներում՝ միաժամանակ հարգելով այն, ինչ PostgreSQL-ի տրանզակցիաները իրականում կարող են անել։
Drizzle ORM-ի հասկացությունների գործնական ամփոփում
Հոդվածն ավարտելու համար նայենք հավելվածին, որը ես կառուցել եմ՝ ցուցադրելու վերը քննարկված Drizzle ORM-ի բոլոր առանցքային հասկացությունները։
Այս հոդվածում ընդգրկված հավելվածի հիմնական կողմերն են.
- կարդալու և գրելու պատասխանատվությունների մաքուր բաժանում երկու առանձին սերվիսների միջոցով՝ writer և reader,
- Drizzle ORM սխեմայի կենտրոնացված սահմանում, որը պահվում է shared մոդուլում,
- տվյալների բազայի թույլտվությունների խիստ վերահսկողություն PostgreSQL մակարդակում՝ սահմանափակ արտոնություններով հատուկ տվյալների բազայի օգտատերերի միջոցով,
- կրկին օգտագործելի, տիպով անվտանգ տվյալների հասանելիության և վավերացման տրամաբանություն, որը կիսում են երկու սերվիսները,
- պարզ, բայց իմաստալից REST API endpoint-ներ կարդալու և գրելու գործողությունների համար,
- docker-ի վրա հիմնված կոնֆիգուրացիա՝ սկզբնավորման սկրիպտներով, որոնք ստեղծում են օգտատերեր, դերեր և թույլտվություններ։
Նախագծի կառուցվածքը
Պահոցը բաժանված է երեք վերին մակարդակի թղթապանակների.
shared/
Այս թղթապանակը պարունակում է Drizzle ORM սխեմայի սահմանումները, վալիդատորները և միայն կարդալու endpoint-ների ընդհանուր տրամաբանությունը, օրինակ.
- GET /users
- GET /users/:id
- GET /activities
- GET /activities/:id
Այս endpoint-ներն օգտագործում են և՛ reader-ը, և՛ writer-ը։
reader/
Ինքնուրույն հավելված՝ միայն կարդալու հասանելիությամբ։ Այն ներմուծում է ընդհանուր սխեման և endpoint-ները, բայց տվյալների բազային միանում է որպես միայն կարդալու օգտատեր, որն ունի միայն SELECT արտոնություններ։
writer/
Երկրորդ ինքնուրույն սերվիսը, որը ներմուծում է ընդհանուր սխեման և կարդալու endpoint-ները և լրացուցիչ տրամադրում է գրելու գործողություններ, ինչպիսիք են.
- POST /users
- PUT /users/:id
- PATCH /users/:id
- DELETE /users/:id
Այն միանում է որպես writer օգտատեր՝ լիարժեք արտոնություններով (SELECT, INSERT, UPDATE, DELETE)։
Drizzle տրանզակցիաներ
Նախագիծը ցույց է տալիս, թե ինչպես են օգտագործվում Drizzle ORM տրանզակցիաները։ Սա պատկերում են երկու հիմնական օրինակ.
- օգտատիրոջ ստեղծում ավտոմատ ակտիվությամբ միասին (POST /users),
- օգտատիրոջ թարմացում ակտիվության հետևմամբ (PATCH /users/:id)։
Տվյալների բազայի դերեր և անվտանգություն
PostgreSQL կոնտեյները կարգավորված է docker-compose-ով, իսկ դերերը սկզբնավորվում են SQL սկրիպտներով (shared/sql/init-users.sql և shared/sql/grant-access.sql), որոնք.
- ստեղծում են երկու առանձին օգտատեր՝ writer_user և reader_user,
- writer-ին տալիս են լիարժեք արտոնություններ
- reader-ին տալիս են միայն կարդալու հասանելիություն,
- reader-ից հետ են վերցնում գրելու հետ կապված յուրաքանչյուր թույլտվություն,
- կիրառում են այս արտոնությունները սխեմայի միգրացիայից հետո, որպեսզի դրանք ճիշտ կիրառվեն։
Այս կոնֆիգուրացիան ապահովում է մտահոգությունների խիստ բաժանում և կանխում է պատահական փոփոխությունները reader սերվիսում։
Պահոց և ինչպես գործարկել
Ամփոփում
Drizzle ORM-ը հիանալի տարբերակ է ժամանակակից TypeScript հավելվածներ կառուցելու համար՝ տվյալների շերտի նկատմամբ լիարժեք վերահսկողությամբ։ Այն միավորում է տիպային անվտանգությունը, արդյունավետությունը և պարզությունը այնպես, որ բնականորեն տեղավորվում է այսօրվա JavaScript էկոհամակարգում։
Drizzle-ը հատկապես արժե փորձել, երբ կառուցում եք միկրոսերվիսներ, տեղակայում եք edge-ում կամ պարզապես անհրաժեշտ է թեթև, կոմպոզիցիոն ORM։ Շատ հավանական է, որ կգրեք ավելի քիչ կոդ, ավելի քիչ սխալներ կանեք և նորից կվայելեք ձեր տվյալների բազայի շերտը։