5 أسباب تجعل Drizzle ORM يتفوق على أدوات ORM التقليدية في JavaScript
اكتشف خمسة أسباب تدفعك إلى إلقاء نظرة أقرب على Drizzle ORM، لا سيما من حيث الأداء والتحكم الكامل في الاستعلامات وبنية TypeScript النظيفة.
يتنامى نظام TypeScript البيئي بسرعة ويقدم بدائل أفضل وأكثر أمانًا لأدوات ORM (التعيين الكائني العلائقي) التقليدية في JavaScript. وتُعد Drizzle وPrisma من أبرزها. ورغم أن كلتيهما تتيح للمطورين العمل مع قواعد البيانات بطريقة آمنة من حيث الأنواع، فإنهما تجسدان فلسفتين مختلفتين.
في هذه المقالة سأركز على 5 أسباب تجعل Drizzle ORM جديرًا باهتمامك، لا سيما من حيث:
- الأداء،
- التحكم الكامل في الاستعلامات،
- بنية TypeScript نظيفة.
1. تجربة مطور من الطراز الأول
بُني Drizzle ORM للمطورين الذين يريدون رؤية كاملة لطبقة بياناتهم وتحكمًا كاملًا بها، دون التضحية بالراحة أثناء كتابة الشيفرة.
وهو يوفر:
- دعمًا ممتازًا لـ IntelliSense، مع الإكمال التلقائي واستنتاج الأنواع والتوثيق المضمّن،
- أمان الأنواع وقت الترجمة، فإذا كان الاستعلام خاطئًا سينبهك TypeScript،
- لا خطوة لتوليد العميل (client)، مما يعني أجزاء متحركة أقل وتكرارًا أسرع.
وبخصوص هذه النقطة الأخيرة: خلافًا لأدوات ORM مثل Prisma، لا يحتاج Drizzle إلى خطوة إضافية لتوليد مكتبة عميل من المخطط. ففي Prisma تعرّف مخطط قاعدة البيانات في ملف .prisma ثم، لإنتاج عميل TypeScript مخصص، عليك تشغيل الأمر:
npx prisma generateيعمل العميل الناتج كواجهة إلى قاعدة البيانات ويجب إعادة توليده في كل مرة يتغير فيها المخطط.
Kysely مكتبة معروفة أخرى في نظام TypeScript البيئي. وهي أداة بناء استعلامات SQL خفيفة وآمنة من حيث الأنواع تهدف بدورها إلى تسهيل حياة المطورين. وكما في Prisma، تحتاج Kysely إلى خطوة منفصلة لإدخال معلومات الأنواع إلى الشيفرة. فعادةً يكتب المطورون الواجهات (interfaces) يدويًا أو يعتمدون على أدوات خارجية مثل kysely-codegen، التي تفحص مخطط قاعدة البيانات وتنتج تعريفات TypeScript من الجداول الفعلية:
- الخطوة 1: تعريف واجهة قاعدة البيانات،
- الخطوة 2: توليد تعريفات الأنواع لمخطط قاعدة البيانات.
فرغم أن Kysely توفر مرونة كبيرة وأنواعًا قوية، فإنها تضيف أيضًا خطوات وأدوات إضافية للحفاظ على توافق الأنواع مع قاعدة البيانات. وكثيرًا ما يعيش المخطط خارج شيفرة التطبيق، وقد يكون إبقاء الاثنين مرتبطين عرضة للأخطاء أو يؤدي إلى أنواع غير متسقة إذا تخطى أحدهم خطوة التوليد.
يتخلص Drizzle من كل ذلك. فبدلًا من الاعتماد على ملفات المخطط وتوليد الشيفرة، يجعل Drizzle المطورين يعرّفون مخطط قاعدة البيانات مباشرة في TypeScript، وتُكتب الاستعلامات مقابل ذلك المخطط بتعابير TypeScript الأصيلة. لا توجد طبقة عميل وسيطة، ولا خطوة ترجمة، ولا فرصة لانحراف الأنواع عن المخطط الفعلي.
والنتيجة هي:
- تكرار أسرع (فلا حاجة لانتظار توليد العميل)،
- سلاسل أدوات أخف،
- أخطاء أقل ناجمة عن عدم تزامن المخططات والعملاء،
- تأهيل أسلس للمطورين الجدد (لأن ما يرونه في الشيفرة هو بالضبط ما يحصلون عليه).
يجعل نهج Drizzle تجربة المطور أكثر شفافية ومباشرة، ويناسب سير عمل TypeScript الحديث بشكل أفضل.
قد يبدو تعريف الجدول هكذا:
import { pgTable, uuid, varchar, timestamp } from 'drizzle-orm/pg-core';

export const users = pgTable('users', {
  id: uuid('id').primaryKey().defaultRandom(),
  email: varchar('email').notNull().unique()
  createdAt: timestamp('created_at')
.notNull()
.defaultNow(),
});
وقد يبدو استعلام على ذلك المخطط هكذا:
import { eq } from 'drizzle-orm';
import db from '../db';
import { users } from '../db/schema';

export const getAllUsers = async () => {
  return await db.select().from(users)
};
2. واجهة الاستعلامات – مُنمَّطة وبسيطة
يتبنى Drizzle نهجًا يضع SQL أولًا مع إبقاء الاستعلامات مريحة وسهلة القراءة. فهو لا يجعل المطورين يتعلمون لغة مخطط خاصة بالمجال. أما مع Prisma، في المقابل، فيصف المطورون قواعد البيانات بلغة Prisma Schema Language، وتستخدم Prisma ذلك المخطط لتوليد عميل TypeScript. يمكنك معرفة المزيد عنها على موقع Prisma.
تخفي Prisma لغة SQL وتقدم واجهة استعلام تتمحور حول العمل مع الكيانات. فكتابة استعلام تبدو كالعمل مع كائنات تشبه JavaScript العادية:
// Prisma query API

const users = await prisma.users.findMany({
  where: {
    OR: [
      { email: { contains: 'mail.com' } },
      { name: { startsWith: 'C' } }
    ],
    articles: { some: { published: true } }
  },
  select: {
    id: true,
    email: true,
    _count: { select: { articles: true } }
  },
  take: 5
});
تتيح استعلامات كهذه للمطورين العمل على مستوى عالٍ. فلا يضطرون إلى التفكير في الوصلات (joins) أو SQL الخام – بل يصفون ما يريدون ببساطة، وتتولى Prisma كل شيء آخر تحت الغطاء.
يتبنى Drizzle مفاهيم SQL ويقدم واجهة استعلام تبدو كأنك تكتب SQL مباشرة في TypeScript – معبّرة وقابلة للتنبؤ وقريبة من طبقة قاعدة البيانات.
وخلافًا لحلول مثل Prisma، التي تعتمد على لغة خاصة بالمجال (DSL) منفصلة وعلى خطوة توليد شيفرة لإنشاء عميل مُنمَّط، يعمل Drizzle بالكامل داخل قاعدة شيفرة TypeScript. فمخطط قاعدة البيانات والاستعلامات كلاهما يُعرَّف في الشيفرة، ويُستنتج أمان الأنواع مباشرة من هذه التعريفات، دون حاجة إلى ملفات مخطط خارجية أو عملاء مولّدين.
وهذا يبسّط سير عمل التطوير ويلغي الحاجة إلى إبقاء نموذج قاعدة البيانات وواجهة العميل البرمجية متزامنين.
وعندما يغيّر المبرمج المخطط، تتحدث أنواع TypeScript من تلقاء نفسها ولا حاجة إلى خطوات إضافية. وهذا يمنحك تحكمًا أكبر في ما يجري:
// Drizzle query API

const users = await db.select({
  id: users.id,
  email: users.email,
  articleCount: sql`count(${articles.id})`
.as('article_count')
})
.from(users)
.leftJoin(articles, eq(users.id, articles.authorId))
.where(
  or(
    like(users.email, '%mail.com%'),
    like(users.name, 'C%')
  )
)
.groupBy(users.id, users.email)
.having(gt(sql`count(${articles.id})`, 0))
.limit(5);
توفر هذه الواجهة البرمجية:
- سلوكًا قابلًا للتنبؤ (لا يُنفَّذ إلا ما تكتبه)،
- تغطية كاملة بـ TypeScript،
- لا سحر خفيًا – رؤية كاملة للاستعلام الذي يُرسل.
والأهم أنه لأن استعلامات Drizzle تشبه كثيرًا SQL الخام المكتوبة في literals قوالب أو تعابير منظمة، يمكن لمجموعة من إضافات المحرر أن تحسّن تجربة المطور. فمثلًا لدى Visual Studio Code إضافات مثل:
- SQL Lit،
- SQL tagged template literals.
يمكن لهذه الإضافات التحقق من صياغة SQL أو الإشارة إلى الأخطاء الشائعة مباشرة في المحرر، مما يسهّل اكتشاف الأخطاء مبكرًا، قبل تشغيل التطبيق أصلًا.
ومع ذلك، لتسهيل حياة المطورين، يوفر Drizzle أيضًا واجهة علائقية أعلى مستوى:
const userWithArticles = await db.query.users.findFirst({
  where: eq(users.id, 1),
  with: {
    articles: {
      where: eq(articles.published, true),
      limit: 5
    }
  }
});
3. العبارات المُعدّة – دفعة في الأداء
يدعم Drizzle العبارات المُعدّة (prepared statements) بشكل مباشر، مما يمنح المطورين طريقة بسيطة لتحسين الأداء، لا سيما في بيئات serverless.
ولنرى لماذا تعزز العبارات المُعدّة الأداء، لننظر إلى ما يجري تحت الغطاء عند تنفيذ استعلام من Drizzle أو من أداة ORM أخرى. فتشغيل استعلام على قاعدة بيانات يتضمن عدة خطوات، كما يبين الشكل أدناه:
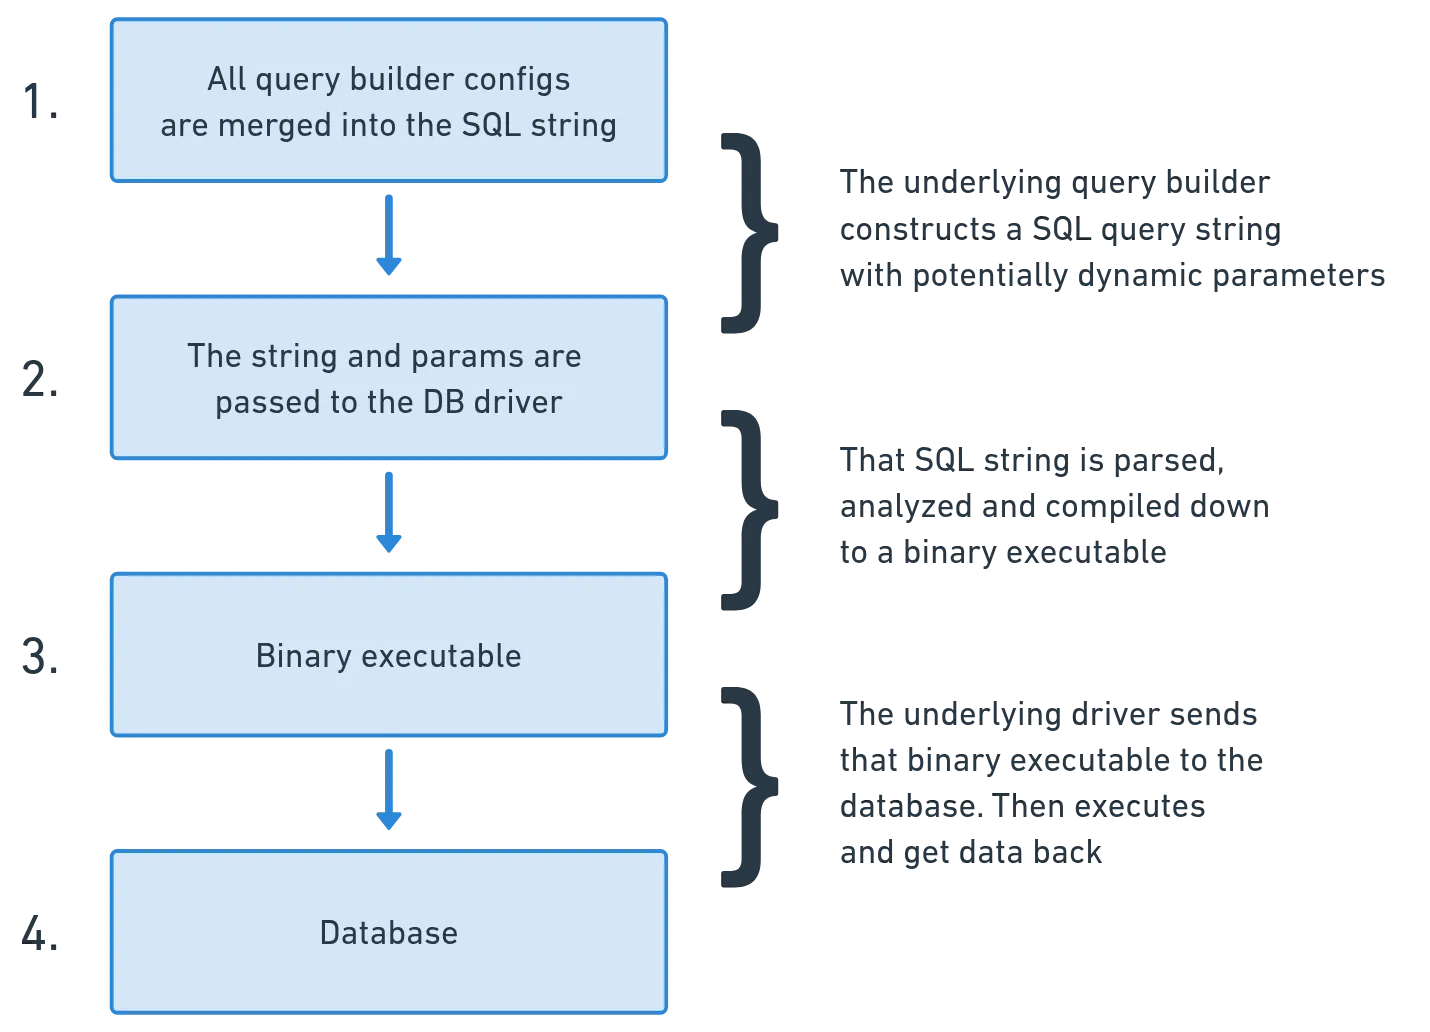
تحدث العملية الموضحة أعلاه في كل مرة تُنفَّذ فيها SQL عبر أداة بناء الاستعلامات. وعادةً لا يشكل ذلك مشكلة كبيرة ونادرًا ما يسبب مشكلات في الأداء. لكن عندما يتعامل المطورون مع استعلامات معقدة جدًا – مثل تلك التي تحتوي على وصلات كثيرة ومجموعة من الجمل – فإن التحليل النحوي والتحليل والترجمة تتكرر دون داعٍ في كل تنفيذ. ويحدث هذا حتى لو بقيت بنية الاستعلام كما هي وتغيرت المعاملات فقط.
لو أمكن إنجاز الخطوات 1 و2 و3 مسبقًا وإعادة استخدام نتائجها، لانخفض الحمل الإضافي كثيرًا. والحيلة هي مواصلة دعم المعاملات الديناميكية مع تجنب الترجمة المتكررة. وهذا بالضبط ما تتيحه العبارات المُعدّة: فهي تستبدل التشغيل المتكرر لتلك الخطوات الأولى ببنية استعلام مترجمة مسبقًا تقبل مدخلات ديناميكية وقت التشغيل:
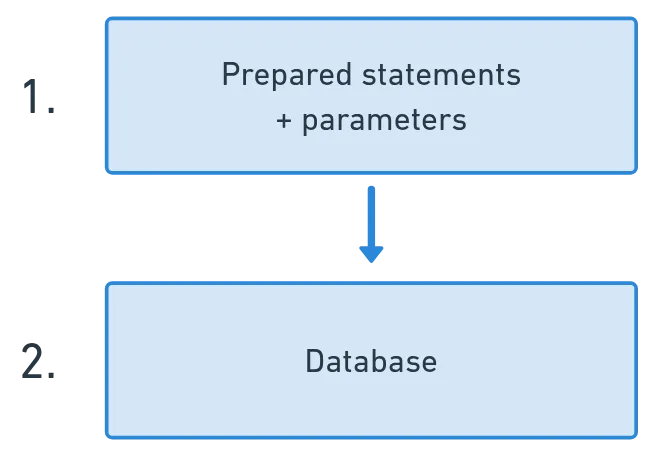
تعني العبارات المُعدّة أن:
- قاعدة البيانات تستطيع إعادة استخدام خطة الاستعلام، مما يقلل زمن التحليل،
- ينخفض زمن استجابة الاستعلام – وهذا ممتاز للبدايات الباردة (cold starts)،
- تتجنب استيفاء السلاسل النصية وقت التشغيل أو التعقيم اليدوي، وكلاهما سبب متكرر لثغرات حقن SQL. فالعبارات المُعدّة تُبقي بنية الاستعلام منفصلة عن البيانات، فيكون مدخل المستخدم دائمًا مُعاملًا بأمان ولا يُنفَّذ أبدًا كجزء من منطق SQL.
وهكذا قد تبدو العبارة المُعدّة:
const db = drizzle(...);
const prepared = db.select()
.from(users)
.prepare("statement_name");

const res1 = await prepared.execute();
const res2 = await prepared.execute();
const res3 = await prepared.execute();
وهذه واحدة بمتغير نائب (placeholder) (لحالة الحاجة إلى تضمين قيمة ديناميكية وقت التشغيل):
const u1 = db
  .select()
  .from(users)
  .where(eq(users.id, sql.placeholder('id')))
  .prepare("u1");

await u1.execute({ id: 1 }) // SELECT * FROM users WHERE id = 1
await u1.execute({ id: 2 }) // SELECT * FROM users WHERE id = 2
وخلافًا لـ Prisma، التي تبني SQL وتشغّلها وقت التشغيل عبر عميل مترجم، تقع العبارات المُعدّة في Drizzle أقرب إلى قاعدة البيانات وتوفر أزمنة بدء بارد أسرع بكثير – وهو عامل حاسم في عمليات النشر serverless مثل AWS Lambda.
4. لا سحر وقت التشغيل – شيفرة نظيفة وتصريحية
لا يفترض Drizzle أي افتراضات حول كيفية سلوك الاستعلامات. فلا توجد حالة خفية، ولا توليد معقد للعميل، ولا طبقات تجريد تقف بين شيفرتك وSQL.
ففي Prisma يُعرَّف المخطط في ملف .prisma، وبعد ذلك يجب تشغيل واجهة سطر أوامر (CLI) لتوليد العميل. ولدى Kysely عملية مماثلة، إذ يُحصل على أمان الأنواع عادةً بتوليد واجهات TypeScript من مخطط قاعدة البيانات بأدوات خارجية. وفي الحالتين يتطلب إبقاء المخطط المصدر والأنواع المولّدة متزامنين خطوة بناء إضافية وأدوات أكثر.
أما مع Drizzle، في المقابل:
- يعلن المبرمجون المخطط والاستعلامات في TypeScript عادية،
- لا توجد طبقة عميل قد تسيء فهم مقصد المطور،
- الاستعلامات شفافة دائمًا – فبنية SQL موجودة أمامك، ظاهرة في الشيفرة.
والنتيجة تصحيح أخطاء أكثر موثوقية ومفاجآت أقل في الإنتاج.
لمقارنة أعمق، راجع قسم «Drizzle مقابل Prisma – استراتيجيات ترجمة مختلفة» أدناه.
5. تصميم بسيط وقابل للتركيب
يتبع Drizzle فلسفة تصميم نمطية وقابلة للتركيب. فبدلًا من حشر كل شيء في سلسلة أدوات واحدة متراصة، يوفر أدوات صغيرة مركّزة:
- drizzle-orm: أداة بناء الاستعلامات،
- drizzle-kit: واجهة سطر أوامر اختيارية لإدارة الترحيلات (migrations)،
- محوّلات (adapters) لقواعد بيانات معينة (مثل pg, mysql, sqlite) – دون تضخم لا لزوم له.
وبفضل ذلك يكون Drizzle:
- سهل الدمج مع أي إطار عمل خلفي (Express وBun وHono وغيرها)،
- خفيفًا بما يكفي لعمليات النشر على الحافة (edge) وserverless،
- مناسبًا تمامًا لبنية الخدمات المصغّرة أو المستودعات الأحادية النمطية (monorepos).
تتيح هذه النمطية تخطيطات مشاريع مرنة وفصلًا نظيفًا بين الاهتمامات. ولأن Drizzle لا يحتاج إلى خطوة توليد شيفرة مركزية ولا إلى عميل متراص، فإنه يندمج جيدًا في البنى الموجهة بالخدمات أو الطبقية. ويصبح حصر تفاعلات قاعدة البيانات في وحدات أو حزم معينة أسهل، دون فرض وقت تشغيل عام أو نسخة عميل مشتركة.
وفوق ذلك، فبابتعاده عن التجريدات المقترنة بإحكام والتزامه بتراكيب TypeScript وSQL القياسية، يبقى Drizzle خفيفًا نسبيًا ويتكيف مع إعدادات شتى، من بيئات الخوادم التقليدية إلى بيئات الحافة ومنصات serverless.
Drizzle مقابل Prisma – استراتيجيات ترجمة مختلفة
رغم أن Drizzle وPrisma كلتيهما تهدفان إلى تسهيل الوصول إلى قواعد البيانات، فإنهما تسلكان ذلك بطرق مختلفة جوهريًا.
Prisma: تستخدم نموذجًا يضع المخطط أولًا (schema-first)، مقدّمة البساطة والتجريد. يعرّف المطورون نموذج بيانات بلغة مخطط مخصصة، وتولّد Prisma عميلًا بواجهة برمجية على نمط OOP. وهي تخفي SQL، لكن ذلك قد يجلب أيضًا مشكلات في الأداء ومرونة أقل وتجريدات متسرّبة.
Drizzle: يتبنى نهجًا يضع SQL أولًا، والمخطط كشيفرة، وأصيلًا في TypeScript. وشعاره «If you know SQL, you know Drizzle». ويركز على الشفافية والتحكم وقابلية التنبؤ. لا يوجد توليد للعميل، ولا سلوك خفي، ولا شيء غير متوقع وقت التشغيل. إنه الأداة المثالية للمطورين الذين يريدون البقاء قريبين من قاعدة البيانات مع التمتع بأنواع قوية ودعم من IDE.
نمذجة البيانات
لننظر الآن كيف يُعرَّف مخطط قاعدة البيانات وكيف يمكن للمطورين الرجوع إليه عند استعلام البيانات:
// Prisma ORM

model User {
  id         Int     @id @default(autoincrement())
  name       String?
  email      String  @unique
  articles Article[]
}

model Article {
  id        Int     @id @default(autoincrement())
  title     String
  content   String?
  published Boolean @default(false)
  authorId  Int?
  author    User?   @relation(fields: [authorId], references: [id])
}
بعد ذلك تولّد Prisma عميلًا آمنًا من حيث الأنواع يمكنك استخدامه في شيفرتك:
import { PrismaClient } from '@prisma/client'
const prisma = new PrismaClient()

async function main() {
  const user = await prisma.user.create({
    data: {
      email: 'john@doe.com',
      name: 'John',
      articles: {
        create: { title: 'Article no. 1' }
      }
    },
    include: { articles: true }
  })
}
يفصل هذا الترتيب المخطط بأناقة عن بقية شيفرة التطبيق ويمنحك مصدرًا وحيدًا للحقيقة. لكن الجانب السلبي أن على المطورين تشغيل خطوة توليد الشيفرة في كل مرة يتغير فيها المخطط.
ويعتمد نهج Drizzle على واجهة TypeScript برمجية لتعريف المخطط:
import {
  boolean,
  integer,
  pgTable,
  serial,
  text,
  uniqueIndex,
  varchar,
} from 'drizzle-orm/pg-core'

export const users = pgTable('users', {
  id: serial('id').primaryKey(),
  name: varchar('name', { length: 256 }),
  email: varchar('email', { length: 256 }).unique(),
})

export const articles = pgTable('articles', {
  id: serial('id').primaryKey(),
  title: varchar('title', { length: 256 }).notNull(),
  content: text('content'),
  published: boolean('published'),
  authorId: serial('author_id').references(() => users.id),
});

export const usersRelations = relations(users, ({ many }) => ({
  articles: many(articles)
}));
ومع Drizzle يمكنني استخدام كائنات المخطط هذه مباشرة في استعلاماتي، مثلًا:
async function main() {
  const user = await db.insert(users)
    .values({ email: 'john@doe.com', name: 'John' })
    .returning();

  await db.insert(articles)
    .values(
      { title: 'Article no. 1', authorId: user.id }
    );

  const userWithArticles = await db.query.users
    .findFirst({
      where: (users, { eq }) => eq(users.id, user.id),
   with: { articles: true }
    });
}
يعتمد Drizzle على مترجم TypeScript لاكتشاف المشكلات المتعلقة بالمخطط، فيعكس التطبيق أي تغيير في المخطط فورًا، دون إعادة بناء أو تشغيل توليد الشيفرة.
العلاقات
تُعد معالجة العلاقات بين الجداول من أصعب أجزاء العمل مع قواعد البيانات، لا سيما في بيئة TypeScript. وطريقة تعامل Prisma وDrizzle مع العلاقات تكشف فلسفتيهما المتباينتين في تصميم ORM.
تعد Prisma العلاقات جزءًا محوريًا من نظامها. فهي مدمجة مباشرة في المخطط والعميل المولّد معًا. وفي Prisma Schema Language يعلن المطورون العلاقات بطريقة واضحة ومنظمة:
model User {
  id         Int        @id @default(autoincrement())
  articles   Article[]   // One-to-many relationship
  profile    Profile?    // One-to-one relationship
}

model Article {
  id       Int  @id @default(autoincrement())
  author   User @relation(fields: [authorId], references: [id])
  authorId Int
}

model Profile {
  id     Int  @id @default(autoincrement())
  user   User @relation(fields: [userId], references: [id])
  userId Int  @unique
}
يمتد هذا التصميم المتمحور حول العلاقات إلى طريقة كتابة المطورين للاستعلامات. فالبيانات ذات الصلة تُنشأ وتُجلب وتُحدَّث بصياغة متداخلة مرتبة:
const user = await prisma.user.create({
  data: {
    email: 'john@doe.com',
    articles: {
      create: [{ title: 'Article no. 1' }]
    },
    profile: {
      create: { bio: 'The programmer' }
    }
  }
});

// Querying with relationship filters
const users = await prisma.user.findMany({
  where: {
    articles: {
      some: { published: true }
    }
  }
});
تكمن قوة نظام Prisma في مدى تبسيطه الكبير لعمليات البيانات المعقدة. فيستطيع المطورون تنفيذ عمليات متعددة المستويات (مثل إنشاء سجلات مرتبطة) في استعلام واحد، بينما تحافظ Prisma على سلامة البيانات واتساقها خلف الكواليس. ولا حاجة إلى التعامل مع المفاتيح الأجنبية يدويًا أو كتابة عدة استعلامات للحفاظ على اتساق كل شيء.
يسلك Drizzle طريقًا مختلفًا. فالجداول والعلاقات تُعرَّف بشكل منفصل: يستخدم المطورون أداة بناء المخطط لتعريف الجداول وواجهة علاقات (relations API) مميزة لربطها:
export const users = pgTable('users', {
  id: serial('id').primaryKey(),
  email: text('email').notNull()
});

export const articles = pgTable('articles', {
  id: serial('id').primaryKey(),
  title: text('title').notNull(),
  authorId: serial('author_id').references(() => users.id)
});

// Relationship definitions
export const usersRelations = relations(users, ({ many }) => ({
  articles: many(articles)
}));

export const articlesRelations = relations(articles, ({ one }) => ({
  author: one(users, {
    fields: [articles.authorId],
    references: [users.id]
  })
}));
هذا التصميم أكثر صراحة – فهو يفصل بنية البيانات عن ارتباطاتها. ولاستعلام البيانات ذات الصلة، يوفر Drizzle واجهة علائقية تتيح للمطورين تحميل السجلات المرتبطة بطريقة بديهية:
const userWithArticles = await db.query.users.findFirst({
  with: {
    articles: {
      where: eq(articles.published, true),
      limit: 5
    }
  }
});
الفرق الجوهري هو مدى إحكام دمج العلاقات. فـ Prisma تنسجها بعمق في القراءات والكتابات معًا، مؤتمتةً الكثير من العمل الشاق. أما Drizzle فيُبقي الأمور أكثر انفصالًا ويطلب من المطور أن يكون أكثر قصدًا، متخليًا عن بعض الراحة مقابل تحكم دقيق.
معاملات SQL مع Drizzle ORM
الحفاظ على اتساق البيانات وسلامتها أمر حيوي في أي تطبيق ينفذ عدة عمليات مترابطة على قاعدة البيانات. وعندما يجب أن تنجح مجموعة من الاستعلامات كلها أو تفشل كلها معًا، يصبح التحكم بالمعاملات (transactions) لا غنى عنه.
تخيّل نظام نشر محتوى يحفظ مقالات جديدة في قاعدة بيانات. قد يشمل نشر مقالة:
- إدراج سجل المقالة،
- ربطها بكاتب،
- إرفاق مجموعة من الوسوم.
فإذا أُدرجت المقالة لكن إسناد الوسوم فشل (مثلًا بسبب مفتاح أجنبي مفقود أو انتهاك قيد)، فقد يُترك النظام ببيانات ناقصة – مقالة يتيمة بلا أي سياق. ومن الصعب اكتشاف حالات عدم الاتساق هذه وإصلاحها بعد وقوعها.
ولمنع مشكلات كهذه، توفر قواعد بيانات SQL المعاملات، التي تجمع سلسلة من العمليات في وحدة ذرية واحدة. وتلتزم المعاملات بمبادئ ACID:
- الذرّية (Atomicity): إما أن تنجح كل عملية في المعاملة، أو لا يسري أي منها.
- الاتساق (Consistency): تكون قاعدة البيانات في حالة صالحة قبل المعاملة وبعدها.
- العزل (Isolation): لا تتداخل المعاملات المتزامنة مع الحالة الوسيطة لبعضها.
- الديمومة (Durability): بعد الإيداع (commit)، تبقى التغييرات حتى لو فشل النظام.
المعاملات مع Drizzle
يدعم Drizzle ORM العمليات المعاملاتية بالكامل عبر محوّل قاعدة البيانات الأساسي. وفي PostgreSQL يتم ذلك بواجهة برمجية بسيطة وبديهية يُسلَّم فيها سياق المعاملة كنسخة معزولة tx (https://orm.drizzle.team/docs/transactions).
فيما يلي مثال لمعاملة تُدرج مقالة وتسند كاتبًا وترفق وسومًا – كل ذلك داخل كتلة عمليات واحدة:
const db = drizzle(...);

await db.transaction(async (tx) => {
  const [article] = await tx
    .insert(articles)
    .values({
      title: 'Understanding Drizzle Transactions',
      published: true,
    })
    .returning();

  await tx.insert(articleAuthors).values({
    articleId: article.id,
    authorId: '7d4ae4dc-faac-4d48-9320-6865110aa0d5',
  });

  await tx.insert(articleTags).values([
    { articleId: article.id, tagId: 'typescript' },
    { articleId: article.id, tagId: 'database' },
  ]);
});
إذا فشلت أي عملية داخل كتلة المعاملة، يُتراجع تلقائيًا عن كل تغيير سابق. ولا حاجة إلى إصدار الأمرين ROLLBACK أو COMMIT بنفسك – فDrizzle يفعل ذلك تحت الغطاء.
يمنحك هذا النموذج المعاملاتي:
- الأمان: لا تبقى الكتابات الجزئية أبدًا.
- الوضوح: القصد المعاملاتي صريح ومحدد النطاق.
- قابلية التركيب: يمكن لأي جزء من التطبيق استخدام المعاملات بأمان دون تغيير واجهة قاعدة البيانات.
نقاط الحفظ والمعاملات المتداخلة
في السيناريوهات الأكثر تعقيدًا، قد تحتاج إلى إيداع أجزاء معينة فقط من سير عمل معاملاتي أو التراجع عنها. وهنا تفيد نقاط الحفظ (savepoints) والمعاملات المتداخلة.
يدعم Drizzle ORM العمليات المعاملاتية المتداخلة بإعادة استخدام الكائن tx الممرر إلى الكتلة المعاملاتية. فإذا فشلت كتلة متداخلة، يُتراجع عن ذلك الجزء فقط – ولا تتأثر المعاملة الخارجية ما لم يُمرَّر الخطأ إليها.
وهذا يتيح بناء مسارات معاملاتية نمطية ومرنة. وإليك مثالًا:
const db = drizzle(...);

await db.transaction(async (tx) => {
  await tx.insert(logs).values(
    { message: 'Starting import...' }
  );

  try {
    await tx.transaction(async (tx2) => {
      await tx2.insert(importQueue).values(
        { fileId: '9bb1fceb' }
      );
      await tx2.insert(importResults).values(
        { fileId: 'cb1f1766', success: true }
      );
    });
  } catch (error) {
    await tx.insert(logs).values(
      { message: 'Import failed. Rolling back nested transaction.' }
    );
    // The nested transaction is rolled back, the outer one continues.
  }

  await tx.insert(logs).values(
    { message: 'Outer transaction continues...' }
  );
});
هذه البنية:
- تمنع انتشار الإخفاقات دون داعٍ،
- تساعد على إبقاء الآثار الجانبية نمطية،
- توفر تحكمًا دقيقًا في سلوك عمليات التراجع.
ورغم أن Drizzle يتيح لك تداخل كتل المعاملات، فإن PostgreSQL لا تدعم أصلًا معاملات متداخلة حقيقية. فهي تسمح بمعاملة نشطة واحدة فقط لكل اتصال. ولمحاكاة التداخل، يستخدم Drizzle نقاط حفظ SQL داخليًا.
وعند استدعاء tx.transaction(...) متداخلة، يصدر Drizzle أمر SAVEPOINT. وإذا حدث خطأ، ينفّذ ROLLBACK TO SAVEPOINT. وتستمر المعاملة الخارجية دون تأثر ما لم يُعاد إطلاق الخطأ.
ويوفر هذا التنفيذ تجربة مطور متسقة عبر مختلف خلفيات قواعد البيانات مع احترام ما تستطيعه معاملات PostgreSQL فعليًا.
ملخص عملي لمفاهيم Drizzle ORM
لإتمام هذه المقالة، لنلقِ نظرة على تطبيق بنيته لتوضيح جميع مفاهيم Drizzle ORM الأساسية التي نوقشت أعلاه.
الجوانب الرئيسية للتطبيق التي تغطيها هذه المقالة هي:
- فصل واضح بين مسؤوليتي القراءة والكتابة عبر خدمتين منفصلتين – writer وreader،
- تعريف مركزي لمخطط Drizzle ORM محفوظ في وحدة shared مشتركة،
- تحكم صارم في صلاحيات قاعدة البيانات على مستوى PostgreSQL عبر مستخدمي قاعدة بيانات مخصصين بصلاحيات مقيدة،
- منطق وصول إلى البيانات وتحقق منها قابل لإعادة الاستخدام وآمن من حيث الأنواع تشترك فيه الخدمتان،
- نقاط نهاية REST بسيطة لكنها ذات معنى لعمليات القراءة والكتابة،
- إعداد قائم على docker مع سكربتات تهيئة تُنشئ المستخدمين والأدوار والصلاحيات.
بنية المشروع
ينقسم المستودع إلى ثلاثة مجلدات في المستوى الأعلى:
shared/
يحتوي هذا المجلد على تعريفات مخطط Drizzle ORM وأدوات التحقق (validators) والمنطق المشترك لنقاط النهاية للقراءة فقط، مثل:
- GET /users
- GET /users/:id
- GET /activities
- GET /activities/:id
وتستخدم كل من reader وwriter نقاط النهاية هذه.
reader/
تطبيق مستقل بوصول للقراءة فقط. يستورد المخطط ونقاط النهاية المشتركة، لكنه يتصل بقاعدة البيانات كمستخدم للقراءة فقط لا يملك سوى صلاحيات SELECT.
writer/
خدمة مستقلة ثانية تستورد المخطط ونقاط نهاية القراءة، وتوفر إضافة إلى ذلك عمليات كتابة مثل:
- POST /users
- PUT /users/:id
- PATCH /users/:id
- DELETE /users/:id
وتتصل كمستخدم writer بصلاحيات كاملة (SELECT, INSERT, UPDATE, DELETE).
معاملات Drizzle
يوضح المشروع كيفية استخدام معاملات Drizzle ORM. ويبيّن ذلك مثالان رئيسيان:
- إنشاء مستخدم مع نشاط تلقائي (POST /users)،
- تحديث مستخدم مع تتبع النشاط (PATCH /users/:id).
أدوار قاعدة البيانات والأمان
تُعدّ حاوية PostgreSQL بواسطة docker-compose، وتُهيَّأ الأدوار بسكربتات SQL (shared/sql/init-users.sql وshared/sql/grant-access.sql) التي:
- تنشئ مستخدمين منفصلين: writer_user وreader_user،
- تمنح الكاتب صلاحيات كاملة
- تمنح القارئ وصولًا للقراءة فقط،
- تسحب كل صلاحية متعلقة بالكتابة من القارئ،
- تطبّق هذه المنح بعد ترحيل المخطط، لضمان فرضها بشكل صحيح.
يضمن هذا الإعداد فصلًا صارمًا بين الاهتمامات ويمنع التعديلات العرضية في خدمة القارئ.
المستودع وطريقة التشغيل
الخلاصة
يُعد Drizzle ORM خيارًا رائعًا لبناء تطبيقات TypeScript الحديثة مع تحكم كامل في طبقة البيانات. فهو يجمع أمان الأنواع والأداء والبساطة بطريقة تنسجم طبيعيًا مع نظام JavaScript البيئي اليوم.
ويستحق Drizzle التجربة بوجه خاص عندما تبني خدمات مصغّرة أو تنشر على الحافة أو تحتاج ببساطة إلى ORM خفيف وقابل للتركيب. وقد ينتهي بك الأمر إلى كتابة شيفرة أقل وارتكاب أخطاء أقل والاستمتاع بطبقة قاعدة البيانات لديك من جديد.