الذكاء الاصطناعي للمستندات من منظور الأعمال
يُعدّ استخراج المعلومات الرئيسية من مستندات مثل الفواتير والإيصالات والعقود أو التقارير من أكثر التحديات التي تواجهها الشركات تكرارًا – ويمكن للذكاء الاصطناعي للمستندات أتمتته.
لديك كل شهر عشرات الآلاف من المستندات لمعالجتها، وتتساءل هل يستحق الاستثمار في الذكاء الاصطناعي؟ أو ربما اقترح أحد أعضاء فريقك: «OpenAI على الأرجح يستطيع فعل هذا – لنجرّب»؟
إن استخراج المعلومات الرئيسية من مستندات مثل الفواتير والإيصالات والعقود أو التقارير من أكثر التحديات التي تواجهها الشركات تكرارًا – ويمكن للذكاء الاصطناعي للمستندات أتمتته. غير أنه أيضًا من أسهل الحلول سوءًا في التصميم. فالتقنية التي تختارها تؤثر مباشرة في التكاليف وقابلية التوسع وجودة المخرجات ومدى إحباط المستخدمين.
فيما يلي قائمة بالأسئلة الأساسية التي ينبغي أن تطرحها كل شركة على نفسها قبل الالتزام بحل قائم على تعلّم الآلة (ML). اختيار المقاربة الصحيحة ليس قرارًا تقنيًا فحسب بل قرار استراتيجي، له عواقب طويلة الأمد على التكاليف والقدرات والمرونة.
- هل نبني حلنا الخاص أم نشتري حلًا جاهزًا (build vs. buy)؟
- هل انخفاض التكلفة التشغيلية (OPEX) أهم بالنسبة لنا، أم أننا مستعدون لقبول استثمار أولي أكبر (CAPEX)؟
- هل نحتاج إلى سيطرة كاملة على النموذج، أم يكفي «صندوق أسود» يعمل جيدًا؟
- هل نريد تطوير قدرات داخلية والاستثمار في مبادرات الذكاء الاصطناعي القادمة؟
في هذه المقالة أقارن بين ثلاث طرق عملية لمعالجة هذه المشكلة:
- خدمات SaaS الجاهزة (Azure AI Document Intelligence)
- نماذج LLM التجارية (OpenAI)
- ضبط النماذج مفتوحة المصدر (fine-tuning)
لا أحاول تتويج فائز شامل. بل سأوضح أي مقاربة تقدّم أفضل أداء عند أي حجم، وبأي مقايضات، وكيف تتقارن تكاليفها التشغيلية، وما ينبغي مراعاته قبل إنفاق وقت فريق تعلّم الآلة لديك أو أموالك على واجهات API خارجية.
يشرح الجزء الأول ما هو VRDU (فهم المستندات الغنية بصريًا – Visually-Rich Document Understanding) فعلًا ولماذا تنهار معالجة اللغات الطبيعية (NLP) الكلاسيكية كثيرًا على المستندات الواقعية مثل الفواتير أو العقود. بعد ذلك أستعرض أكثر الطرق عملية ثلاثًا لاستخراج المعلومات الرئيسية من المستندات الغنية بصريًا – أدوات SaaS، ونماذج اللغة الكبيرة (LLMs)، والنماذج مفتوحة المصدر المضبوطة.
ثم أقارن بين هذه الحلول من حيث التكلفة والتحكم وقابلية التوسع وجهد التنفيذ. كما أعرض تفصيلًا للتكاليف مبنيًا على حسابات فعلية، لتتمكن من تقدير العائد على الاستثمار (ROI) واختيار المسار الذي يناسب احتياجاتك وحجمك. وسواء كنت تعدّ إثبات مفهوم (PoC)، أو توسّع منصة ناضجة، أو تحاول تجنب أخطاء مكلفة – فهذا الدليل مقصود به مساعدتك.
ما هو فهم المستندات الغنية بصريًا (VRDU)؟
تعمل غالبية أنظمة معالجة اللغات الطبيعية (NLP) على نص عادي: أسطر وفقرات وتسلسلات من الكلمات. أما مستندات الأعمال فتلعب بقواعد مختلفة.
تأمّل صورة فاتورة. إنها ليست نصًا فحسب – بل بنية: أعمدة وحقول وترويسات وصفوف جداول وتوقيعات. وقد تكمن المعلومات الرئيسية في زاوية، أو بجانب شعار، أو في التذييل، أو أسفل جدول. ويمكن أن يحمل مستندان البيانات نفسها لكن بتخطيط مختلف.
ولهذا غالبًا ما تقصّر مقاربات NLP الكلاسيكية أو استخراج المعلومات (IE) التي تعتمد على تسلسلات النصوص وحدها. فهي تفتقر إلى الوعي البصري – أي إدراك موضع المعلومات على الصفحة.
فهم المستندات الغنية بصريًا (VRDU) مجال يجمع بين التعرف على النص (OCR) وتحليل التخطيط ونمذجة السياق البصري النصي (مثل العلاقات بين الحقول ومواضع الخلايا في الجداول وتسلسل الترويسات الهرمي).
بعبارة بسيطة: عندما يحمل تخطيط مستنداتك معنى، فأنت بحاجة إلى حل يفهمه ويستفيد منه.
ما هو استخراج المعلومات الرئيسية من المستندات؟
يعني استخراج المعلومات الرئيسية (KIE) سحب بيانات محددة وذات صلة بالأعمال من المستندات تلقائيًا. ويشمل ذلك حقولًا مثل:
- رقم الفاتورة وتاريخ البيع والمبلغ الصافي/الإجمالي ونسبة ضريبة القيمة المضافة والرقم الضريبي
- معلومات المتعاقد
- رقم الحساب المصرفي
- تاريخ انتهاء العقد أو اسم المنتج
يحوّل التعرف الضوئي الكلاسيكي على الحروف (OCR) صورة المستند إلى نص، لكن KIE يذهب أبعد: فهو يحدد أي أجزاء النص مهمة، وما تمثله، وأين تقع هذه المعلومات في نموذج بياناتك.
الأمر لا يتعلق فقط بـ ما كُتب بل بـ ما يعنيه ضمن سياق المستند بأكمله.
إن تحويل النص شبه المنظم إلى بيانات منظمة هو الخطوة الأصعب. فقد يكون الرقم نفسه معرّف فاتورة في موضع، ورقم حساب مصرفي في موضع آخر. وقد تظهر كلمة «VAT» عدة مرات، بمعنى مختلف في كل مرة. ويتطلب جدول البنود في الفاتورة معالجة تسلسلية وفهمًا لسياق كل عمود.
لا يكتفي حل KIE الجيد بالتعرف على الحقول – بل يسند لكل منها أيضًا تسمية ونوع بيانات وموضعًا متوقعة بشكل صحيح. وفي السيناريوهات الأكثر تقدمًا يستطيع أيضًا اكتشاف العلاقات بين الحقول (مثل أي مبلغ يخص أي نسبة ضريبة).
ولهذا يحتاج KIE إلى أكثر من NLP الكلاسيكي أو الرؤية الحاسوبية أو OCR وحدها – فلكي يعمل بكفاءة يتطلب مزيجًا من فهم المحتوى وتحليل بنية المستند والوعي بالسياق البصري.
يمكنك أدناه رؤية مخرجات نموذجية من حل KIE كهذا (المصدر: Microsoft)، مع حقول معينة محددة على فاتورة. وبعد الاستخراج تصبح هذه البيانات جزءًا من مستند رقمي منظم ويمكن أن تغذي أي سير عمل: إذ يمكن إرسالها إلى أنظمة أخرى أو تصديرها أو التحقق منها.

كيف نحل هذه المشكلة؟
أثناء تحليل هذا التحدي وجدت ثلاث طرق مختلفة اختلافًا واضحًا لحله. وفي هذا القسم سأصف كلًّا منها من زاوية الأعمال.
SaaS مدعوم بالذكاء الاصطناعي
ما يجعل هذه المقاربة جذابة هو بساطتها:
- لا حاجة إلى فريق ML داخلي
- لا بنية تحتية للعناية بها
- لا حاجة إلى بيانات تدريب مسبقًا
كل ما يلزم هو واجهة API وحفنة من المستندات، ويمكن أن تبدأ النتائج بالظهور خلال أيام. وفي هذا المثال سأستخدم Azure AI Document Intelligence الذي يدعم لغات كثيرة.
الفوائد
- نشر سريع – ما عليك سوى الاتصال بواجهة API وبناء تكامل أساسي للحصول على النتائج
- OCR عالي الجودة وفهم للتخطيط – تعتمد Microsoft على محركات الرؤية + NLP الخاصة بها
- حاجز دخول منخفض – لا حاجة إلى تدريب النماذج أو ضبط المعاملات الفائقة أو التحقق اليدوي من البيانات
- دعم متعدد اللغات – فهو حاليًا يدعم 48 لغة، مع تغطية جيدة للأسواق الأوروبية والآسيوية
- حاجة قليلة جدًا إلى بيانات التدريب – تقول الوثائق إن 5 عينات موسومة فقط لكل تخطيط مستند قد تكفي، وتتوفر أداة لتوسيم البيانات
المخاطر
- تنمو التكاليف مع الحجم – كل صفحة مستند هي طلب API منفصل، مما قد يصل عند الأحجام الكبيرة إلى مئات الآلاف من الدولارات شهريًا
- لا سيطرة على النموذج – ليس لديك أي اطلاع على عمله الداخلي، ولا يمكنك تكييفه مع بياناتك الخاصة أو التعامل مع الحالات الحدّية
- خيارات ضبط محدودة – متاحة لنماذج مختارة فقط وبحد أقصى 50,000 مثال
- الارتباط بالمزود (vendor lock-in) – قد يجلب تغيير المزودين تكاليف تقنية وتنظيمية كبيرة
- لا معايير أداء عامة – هناك شفافية قليلة بشأن الدقة المتوقعة أو أداء النموذج
- قد لا يكون هناك ضمان لبقاء بياناتك خاصة وعدم استخدامها، مثلًا، لتدريب إصدارات مستقبلية من نموذج المزود (يعتمد هذا على الحل المحدد؛ وقد يحدده بعضها في سياسة الخصوصية)
- مشكلات محتملة في الامتثال التنظيمي للائحة GDPR وغيرها من اللوائح (يعتمد هذا على الحل المحدد؛ وقد يحدده بعضها في سياسته)
لمن تناسب هذه المقاربة؟
يُعدّ حل SaaS المدعوم بالذكاء الاصطناعي الخيار الأكثر منطقية عندما:
- تحتاج إلى نموذج أولي سريع دون إنشاء فريق ML داخلي
- يكون حجم مستنداتك صغيرًا إلى متوسط (مثلًا عشرات الآلاف شهريًا)
- لديك مجموعة بيانات موسومة صغيرة ولا تخطط للاستثمار في توسيعها
- تكون الاستقرارية أولويتك، إلى جانب اتفاقية مستوى الخدمة (SLA) والأمان – بدلًا من السيطرة الكاملة على سلوك النموذج
- يكون استخراج البيانات أداة مساعدة لا قلب ميزتك التنافسية
وفي هذه الحالات يقدّم SaaS زمنًا ممتازًا للوصول إلى القيمة. لكن مع تزايد متطلبات الحجم والتخصيص تقل جدواه الاقتصادية بسرعة.
النماذج مفتوحة المصدر
الخيار الأكثر تطلبًا، تقنيًا وتنظيميًا، هو بناء نموذج تعلّم آلة خاص بك لاستخراج المعلومات الرئيسية، يُدرَّب على بيانات شركتك ويُنشر في بيئتك الخاصة.
وفي هذه المقاربة تتحكم في العملية بأكملها:
- اختيار معمارية النموذج (مثل LiLT وLayoutLM وDonut)
- بناء مسار معالجة خاص بك (OCR واستخراج العلاقات وتصنيف الحقول)
- إعادة تدريب النموذج بشكل مستمر
- النشر على بنيتك التحتية الخاصة (السحابة أو في المقر)
الفوائد
- أفضل ملاءمة لبياناتك الخاصة – يتعلم النموذج من مستندات شركتك، مع أخذ الحالات الحدّية في الاعتبار
- سيطرة كاملة على سلوك النموذج – يمكنك ضبطه وإعادة تدريبه وتحليل أخطائه وإضافة فئات حقول جديدة متى لزم
- لا رسوم على الرموز (tokens) – بعد النشر تكون التكاليف التشغيلية أقل بكثير وتعتمد على الوقت والموارد المستهلكة في معالجة البيانات
- يلبي متطلبات الأمان والخصوصية – وهو أمر بالغ الأهمية في قطاعات مثل التمويل والرعاية الصحية والخدمات اللوجستية
- فرصة لبناء بنية ML داخلية – يمكن لمشروع واحد أن يضع الأساس لاستراتيجية الذكاء الاصطناعي كلها
- أداء قوي تدعمه الأبحاث – تؤكد عدة أوراق أكاديمية مدى فعالية معماريات النماذج مفتوحة المصدر الشائعة: 1، 2، 3، 4، 5
- أداء أفضل من الحلول الأخرى
المخاطر
- تكلفة أولية كبيرة – تحتاج إلى فريق ML وDevOps وموسِّمين (annotators) ووقت للتنفيذ. إنه استثمار طويل الأمد
- بنية تحتية وصيانة معقدتان – فالتدريب والاختبار والنشر والمراقبة وإعادة التدريب الآلي كلها تزيد التعقيد التشغيلي
- قيود محتملة في تراخيص المصادر المفتوحة – قد لا يُسمح باستخدام بعض النماذج إلا لأغراض غير تجارية (ويجب تقييم ذلك في تحليل المخاطر)
- كمية كبيرة من بيانات التدريب عالية الجودة – قد لا تكفي مجموعة بيانات صغيرة لتدريب نموذج متين، وقد تلزم عشرات الآلاف من العينات الموسومة. ويمكن جمع بعضها بشكل سلبي (مثلًا من تصحيحات المستخدمين)، لكن إعدادها لا يزال يكلف جهدًا ووقتًا
لمن تناسب هذه المقاربة؟
يناسب هذا الخيار المؤسسات أكثر عندما:
- تعالج ملايين المستندات شهريًا
- لديها (أو قادرة على بناء) مجموعة بيانات تدريب كبيرة
- لديها (أو تبني) فريق ML / علم البيانات
- تريد ملكية كاملة للحل ولبياناتها
- تتعامل مع الذكاء الاصطناعي بوصفه مسألة استراتيجية، لا تنفيذًا لمرة واحدة
وعند الحجم المناسب يسدد بناء حل كهذا تكلفته بسرعة، وتحصل الشركة لا على نموذج فحسب بل على أساس لمعمارية ذكاء اصطناعي مصممة بالكامل وفق احتياجاتها.
نماذج LLM
تعتمد الطريقة الثالثة لاستخراج المعلومات من المستندات على نماذج اللغة الكبيرة (LLMs) التجارية – مثل GPT-4o (OpenAI) وClaude وMistral – بوصفها مكوّن المعالجة المركزي.
ويسير المسار النموذجي على النحو التالي:
- OCR – تحويل المستند (مثل PDF أو مسح ضوئي) إلى نص مع الحفاظ على ترتيب قراءة أجزائه
- هندسة الأوامر (Prompt engineering) – كتابة استعلامات مثل «Extract the data from this document in the format: {prompt_format}»
- المعالجة اللاحقة (Post-processing) – تنظيف الاستجابة وهيكلتها والتحقق من الحقول وتطبيق قواعد احتياطية أو مصنّفات
الفوائد
- نمذجة أولية سريعة – تتعامل نماذج LLM بشكل مدهش مع تنوع اللغة والتخطيطات غير المعتادة وOCR غير المثالي
- لا حاجة إلى تدريب نموذج – كل ما تحتاجه أمر موجّه (prompt) جيد التصميم وبعض بيانات الاختبار
- تكلفة دخول منخفضة – مثالي لإثبات المفهوم (PoC) أو دراسات الجدوى (R&D)
- استثمار قصير الأمد
- مرونة مع أنواع المستندات غير القياسية – مثل التقارير المالية وطلبات الخدمة والملاحظات المكتوبة بخط اليد
المخاطر
- غياب الحتمية – قد ينتج الأمر الموجّه نفسه نتائج مختلفة، مما قد يجعل بعض التطبيقات أصعب أو مستحيلة
- الهلوسة وأخطاء الاستخراج – قد «يخمّن» النموذج بيانات مفقودة، وهو أمر غير مقبول في مجالات مثل المحاسبة والمالية والقانون. وفوق ذلك، لا شيء يضمن أن يعيد النموذج عدد الحقول المتوقع بالضبط، مما يضيف فئة أخرى من الأخطاء
- يصعب التحقق من جودة المخرجات – فبدون إحالات إلى إحداثيات المستند يصبح الاختبار وتصحيح الأخطاء أصعب. والإحداثيات التي تنتجها نماذج LLM تكون عادةً خاطئة
- يصبح الاستدلال أغلى عند الأحجام الكبيرة – الفوترة بحسب الرموز، والمستندات عادةً طويلة
- قلة الأبحاث الشاملة التي تؤكد مدى جودة أداء نماذج LLM – الدراسة الوحيدة التي وجدتها وتقيّم GPT-4o تُظهر أن هذه النماذج تؤدي أسوأ من النماذج المتخصصة مفتوحة المصدر (المزيد عنها هنا)
- ضبط النموذج على بياناتك الخاصة مستحيل (أو مكلف جدًا)
- قد يكون إرسال المستندات إلى واجهة API خارجية غير مقبول في القطاعات المنظمة (التمويل والطب)
- يلزم الكثير من تجارب هندسة الأوامر
لمن تناسب هذه المقاربة؟
يناسب الاستخراج القائم على LLM عندما:
- تكون في بداية استكشاف مساحة المشكلة وتريد تجربة بعض المفاهيم بسرعة
- تعمل مع مستندات غير نمطية لا تتبع قوالب ثابتة (مثل الرسائل والتقارير والملاحظات)
- تريد إنشاء PoC دون ربط موارد ML أو بنية تحتية
- تكون مستعدًا للتخلي عن بعض الدقة والتحكم مقابل تنفيذ أسرع
إنه أداة ممتازة للاستكشاف والتكرار السريع، لكنه ليس بالضرورة التقنية المناسبة لنظام بمستوى الإنتاج يعمل على نطاق واسع بمتطلبات دقة صارمة.
الاختلافات الرئيسية
التكاليف التشغيلية
أعددت جدولًا يقارن التكاليف التشغيلية لكل حل. وكان معظمها مخبأً في أعماق الوثائق. ففي حالة LLM احتجت إلى وضع افتراضات حول استهلاك الرموز، وفي حالة النموذج مفتوح المصدر قدّرت أزمنة المعالجة بناءً على نماذج بحجم مماثل. ولا يترك الرسم البياني أدناه أي شك في أي خيار يفوز من حيث التكاليف التشغيلية.
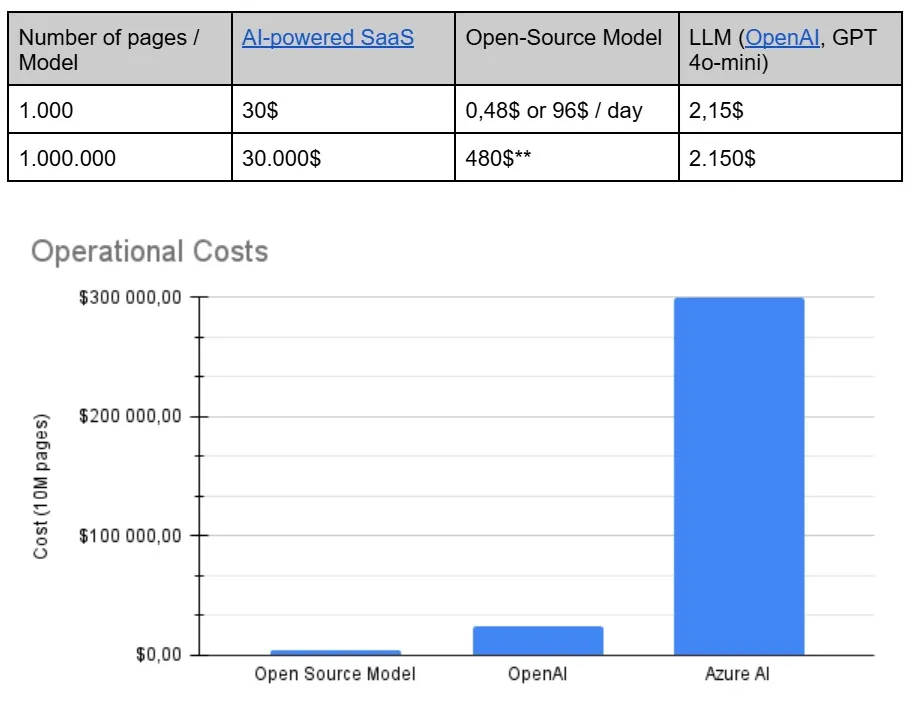
رسم بياني يعرض التكاليف التشغيلية لأدوات مختلفة.
الافتراضات
في هذه المحاكاة أفترض أن ملف PDF يُرسَل إلى نموذج GPT-4o مع تعليمات نظام تصف المهمة. تضيف هذه التعليمات رموزًا، لكن لنفترض أنها تتسع ضمن 500 رمز.
الحسابات
في هذه المحاكاة أفترض أن ملف PDF يُرسَل إلى نموذج GPT-4o-mini مع تعليمات نظام تصف المهمة. تضيف هذه التعليمات رموزًا، لكن لنفترض أنها تتسع ضمن 500 رمز. ولنفترض أيضًا أن الاستجابة لا تتجاوز 1,500 رمز.
يستخدم نموذج GPT-4o-mini رموزًا أكثر لتمثيل الصور، ويبدو أن المستخدمين يؤكدون ذلك في نقاشات. وعدد الرموز هو نفسه كما في GPT-4o، لذا سأستخدم ذلك النموذج لحساب تكلفة معالجة الصورة ثم أضيف تكلفة مخرجات GPT-4o-mini.
حسابات GPT-4o
2.5$ / 1,000,000 = 0.0000025$ لكل رمز مُدخَل
500 رمز مُدخَل = 500 × 0.0000025$ = 0.00125$
حسابات GPT-4o-mini
0.6$ / 1,000,000 = 0.0000006$ لكل رمز مُخرَج
1,500 رمز مُخرَج = 1,500 × 0.0000006$ = 0.0009$
0.00125$ + 0.0009$ = 0.00215$ للصفحة
كيف نختار المقاربة المناسبة بحسب الحجم والاحتياجات؟ – الخلاصة
لا يوجد حل واحد يناسب كل حالات استخراج البيانات من المستندات. فلكل مقاربة – SaaS أو LLM أو نموذج مخصص – مكانها. والمهم ليس أي تقنية أفضل بل أيها يناسب سياقك الخاص أكثر: حجمك والموارد المتاحة لديك ومتطلبات الجودة واستراتيجيتك طويلة الأمد.
وفيما يلي ملخص قد يساعدك على اتخاذ القرار:
ما التالي؟
إذا كنت تفكر في إدخال نظام لاستخراج البيانات من المستندات، فنقطة البداية الجيدة هي تحليل الاحتياجات، ثم مواءمة التقنية مع حجم مؤسستك وعملياتها.
ننظم ورش عمل واستشارات نقوم فيها بما يلي:
- تقييم إمكانات الأتمتة
- مقارنة المقاربات المتاحة (مثل SaaS وLLM والنموذج المخصص)
- إعداد توصية مصممة وفق حالتك
- تجهيز خارطة طريق للمشروع جاهزة للنشر