Document AI բիզնեսի տեսանկյունից
Փաստաթղթերից, ինչպիսիք են հաշիվ-ապրանքագրերը, անդորրագրերը, պայմանագրերը կամ հաշվետվությունները, հիմնական տեղեկատվության արդյունահանումը բիզնեսների ամենահաճախ հանդիպող մարտահրավերներից է, և document AI-ը կարող է ավտոմատացնել այն։
Ամեն ամիս դուք ունեք մշակման ենթակա տասնյակ հազարավոր փաստաթղթեր և մտածում եք՝ արժե՞ արդյոք ներդրում անել AI-ում։ Կամ գուցե ձեր թիմի որևէ անդամ առաջարկել է. «OpenAI-ը հավանաբար կարող է սա անել, փորձենք»։
Փաստաթղթերից, ինչպիսիք են հաշիվ-ապրանքագրերը, անդորրագրերը, պայմանագրերը կամ հաշվետվությունները, հիմնական տեղեկատվության արդյունահանումը բիզնեսների ամենահաճախ հանդիպող մարտահրավերներից է, և document AI-ը կարող է ավտոմատացնել այն։ Սակայն այն նաև ամենահեշտ վատ նախագծվող խնդիրներից է։ Ձեր ընտրած տեխնոլոգիան ուղղակի ազդեցություն ունի ծախսերի, մասշտաբավորվելու, արդյունքի որակի և ձեր օգտատերերի ունեցած հիասթափության վրա։
Ստորև բերված է հիմնական հարցերի ցանկ, որոնք յուրաքանչյուր ընկերություն պետք է տա իրեն՝ նախքան մեքենայական ուսուցման (ML) լուծման հանձնառություն ստանձնելը։ Ճիշտ մոտեցման ընտրությունը ոչ միայն տեխնիկական, այլև ռազմավարական որոշում է՝ երկարաժամկետ հետևանքներով ծախսերի, հնարավորությունների և ճկունության համար։
- Մե՞նք ենք կառուցում սեփական լուծումը, թե՞ գնում ենք պատրաստի (build vs. buy)։
- Մեզ համար ավելի կարևո՞ր է ցածր գործառնական ծախսը (OPEX), թե՞ պատրաստ ենք ընդունել ավելի մեծ սկզբնական ներդրում (CAPEX)։
- Մեզ անհրաժե՞շտ է մոդելի վրա լիակատար վերահսկողություն, թե՞ աշխատող «սև արկղը» բավարար է։
- Մենք ուզո՞ւմ ենք զարգացնել ներքին կարողություններ և ներդրումներ անել առաջիկա AI նախաձեռնություններում։
Այս հոդվածում ես համեմատում եմ այս խնդիրը լուծելու երեք գործնական եղանակ՝
- Պատրաստի SaaS սերվիսներ (Azure AI Document Intelligence)
- Առևտրային LLM-ներ (OpenAI)
- Բաց կոդով մոդելների fine-tuning
Ես չեմ փորձում հռչակել համընդհանուր հաղթող։ Փոխարենը ցույց կտամ, թե որ մոտեցումն է լավագույնս աշխատում ինչ մասշտաբի դեպքում, ինչ փոխզիջումներով, ինչպես են համեմատվում նրանց գործառնական ծախսերը, և ինչ պետք է հաշվի առնել՝ նախքան ձեր ML թիմի ժամանակը կամ ձեր գումարը արտաքին API-ների վրա ծախսելը։
Առաջին մասը բացատրում է, թե իրականում ինչ է VRDU-ն (Visually-Rich Document Understanding) և ինչու է դասական NLP-ն հաճախ ձախողվում իրական փաստաթղթերի, ինչպիսիք են հաշիվ-ապրանքագրերը կամ պայմանագրերը, վրա։ Դրանից հետո անցնում եմ վիզուալ հարուստ փաստաթղթերից հիմնական տեղեկատվություն արդյունահանելու երեք ամենագործնական եղանակներով՝ SaaS գործիքներ, մեծ լեզվական մոդելներ (LLM-ներ) և fine-tune արված բաց կոդով մոդելներ։
Այնուհետև համեմատում եմ այս լուծումները ծախսերի, վերահսկողության, մասշտաբավորվելու և իրականացման ջանքերի տեսանկյունից։ Ներկայացնում եմ նաև ծախսերի բաժանում՝ հիմնված իրական հաշվարկների վրա, որպեսզի կարողանաք գնահատել ROI-ն և ընտրել ձեր կարիքներին ու մասշտաբին համապատասխանող ուղին։ Անկախ նրանից՝ PoC եք պատրաստում, հասուն պլատֆորմ եք մասշտաբավորում, թե փորձում եք խուսափել թանկ սխալներից, այս ուղեցույցը նախատեսված է օգնելու համար։
Ի՞նչ է Visually-Rich Document Understanding-ը (VRDU)
Բնական լեզվի մշակման (NLP) համակարգերի մեծ մասն աշխատում է պարզ տեքստի վրա՝ տողեր, պարբերություններ և բառերի հաջորդականություններ։ Սակայն բիզնես փաստաթղթերը խաղում են այլ կանոններով։
Դիտարկեք հաշիվ-ապրանքագրի պատկերը։ Դա պարզապես տեքստ չէ, այլ կառուցվածք է՝ սյունակներ, դաշտեր, վերնագրեր, աղյուսակի տողեր, ստորագրություններ։ Հիմնական տեղեկատվությունը կարող է լինել անկյունում, լոգոյի կողքին, էջատակում կամ աղյուսակի տակ։ Երկու փաստաթուղթ կարող են պարունակել նույնական տվյալներ, բայց դասավորել դրանք տարբեր կերպ։
Ահա թե ինչու դասական NLP կամ Information Extraction (IE) մոտեցումները, որոնք հենվում են բացառապես տեքստային հաջորդականությունների վրա, հաճախ թերանում են։ Նրանք վիզուալ իրազեկվածություն չունեն. չգիտեն, թե որտեղ է տեղեկատվությունը տեղակայված էջի վրա։
Visually-Rich Document Understanding (VRDU)-ն ոլորտ է, որը միավորում է տեքստի ճանաչումը (OCR), դասավորության վերլուծությունը և վիզուալ-տեքստային համատեքստի մոդելավորումը (օրինակ՝ դաշտերի միջև կապերը, դիրքերը աղյուսակների ներսում, վերնագրերի հիերարխիան)։
Պարզ ասած. երբ ձեր փաստաթղթերի դասավորությունը իմաստ է կրում, ձեզ անհրաժեշտ է լուծում, որը հասկանում և օգտագործում է այն։
Ի՞նչ է հիմնական տեղեկատվության արդյունահանումը փաստաթղթերից
Key Information Extraction-ը (KIE) նշանակում է փաստաթղթերից կոնկրետ, բիզնեսի համար կարևոր տվյալների ավտոմատ արդյունահանում։ Սա ընդգրկում է այնպիսի դաշտեր, ինչպիսիք են՝
- Հաշիվ-ապրանքագրի համարը, վաճառքի ամսաթիվը, զուտ/համախառն գումարը, ԱԱՀ-ի դրույքաչափը, հարկ վճարողի համարը
- Կապալառուի տվյալները
- Բանկային հաշվի համարը
- Պայմանագրի ավարտի ամսաթիվը կամ ապրանքի անվանումը
Դասական օպտիկական նիշերի ճանաչումը (OCR) փաստաթղթի պատկերը վերածում է տեքստի, բայց KIE-ն գնում է ավելի հեռու. այն պարզում է, թե տեքստի որ մասերն են կարևոր, ինչ են նշանակում և որտեղ է այդ տեղեկատվությունը տեղավորվում ձեր տվյալների մոդելում։
Խոսքը ոչ միայն այն մասին է, թե ինչ է գրված, այլև թե ինչ է դա նշանակում ամբողջ փաստաթղթի համատեքստում։
Կիսակառուցվածքային տեքստը կառուցվածքային տվյալների վերածելը ամենադժվար քայլն է։ Նույն թիվը կարող է մի տեղում լինել հաշիվ-ապրանքագրի ID, մեկ այլ տեղում՝ բանկային հաշվի համար։ «ԱԱՀ» բառը կարող է հայտնվել մի քանի անգամ, ամեն անգամ՝ տարբեր իմաստով։ Հաշիվ-ապրանքագրի ապրանքների աղյուսակը պահանջում է հաջորդական մշակում և յուրաքանչյուր սյունակի համատեքստի ըմբռնում։
Լավ KIE լուծումը ոչ միայն ճանաչում է դաշտերը, այլև յուրաքանչյուրին վերագրում է ճիշտ կանխատեսված պիտակ, տվյալների տիպ և դիրք։ Ավելի առաջադեմ սցենարներում այն կարող է հայտնաբերել նաև դաշտերի միջև կապերը (օրինակ՝ որ գումարը որ ԱԱՀ դրույքաչափին է համապատասխանում)։
Ահա թե ինչու KIE-ին անհրաժեշտ է ավելին, քան միայն դասական NLP-ն, համակարգչային տեսողությունը կամ OCR-ը. արդյունավետ աշխատելու համար այն պահանջում է բովանդակության ըմբռնման, փաստաթղթի կառուցվածքի վերլուծության և վիզուալ համատեքստի իրազեկվածության համադրություն։
Ստորև կարող եք տեսնել նման KIE լուծման նմուշային արդյունք (աղբյուր՝ Microsoft), հաշիվ-ապրանքագրի վրա առանձնացված կոնկրետ դաշտերով։ Արդյունահանումից հետո այս տվյալները դառնում են կառուցվածքային թվային փաստաթղթի մաս և կարող են սնել ցանկացած աշխատանքային հոսք. դրանք կարելի է ուղարկել այլ համակարգեր, արտահանել կամ վավերացնել։

Ինչպե՞ս լուծել այս խնդիրը
Այս մարտահրավերը վերլուծելիս ես գտա այն լուծելու երեք նկատելիորեն տարբեր եղանակ։ Այս բաժնում կնկարագրեմ դրանցից յուրաքանչյուրը բիզնեսի տեսանկյունից։
AI-ով աշխատող SaaS
Այս մոտեցումը գրավիչ է դարձնում դրա պարզությունը՝
- Ներքին ML թիմ պետք չէ
- Խնամելու ենթակառուցվածք չկա
- Նախապես ուսուցման տվյալներ պետք չեն
Պետք է միայն API և մի բուռ փաստաթղթեր, և արդյունքները կարող են սկսել գալ օրերի ընթացքում։ Այս օրինակում կօգտագործեմ Azure AI Document Intelligence-ը, որն աջակցում է բազմաթիվ լեզուներ։
Առավելություններ
- Արագ ներդրում – պարզապես միացեք API-ին և կառուցեք հիմնական ինտեգրացիա՝ արդյունքներ ստանալու համար
- Բարձրորակ OCR և դասավորության ըմբռնում – Microsoft-ը հենվում է իր սեփական Vision + NLP շարժիչների վրա
- Մուտքի ցածր շեմ – մոդելի ուսուցում, հիպերպարամետրերի կարգավորում կամ տվյալների ձեռքով վավերացում պետք չէ
- Բազմալեզու աջակցություն – այն այժմ աջակցում է 48 լեզու, եվրոպական և ասիական շուկաների լավ ընդգրկմամբ
- Շատ քիչ ուսուցման տվյալներ են պետք – փաստաթղթերի համաձայն՝ փաստաթղթի յուրաքանչյուր դասավորության համար կարող է բավարար լինել նույնիսկ 5 նշագրված նմուշ, և տրամադրվում է տվյալների նշագրման գործիք
Ռիսկեր
- Ծախսերը աճում են ծավալի հետ – փաստաթղթի յուրաքանչյուր էջ առանձին API հարցում է, ինչը մեծ ծավալների դեպքում կարող է գումարվել ամսական հարյուր հազարավոր դոլարի
- Մոդելի վրա վերահսկողություն չկա – դուք պատկերացում չունեք նրա ներքին աշխատանքի մասին և չեք կարող այն հարմարեցնել ձեր կոնկրետ տվյալներին կամ լուծել եզրային դեպքերը
- Սահմանափակ fine-tuning տարբերակներ – հասանելի է միայն ընտրված մոդելների համար և սահմանափակված է 50,000 օրինակով
- Vendor lock-in – մատակարարը փոխելը կարող է բերել զգալի տեխնոլոգիական և կազմակերպչական ծախսեր
- Հանրային benchmark-ներ չկան – սպասվող ճշգրտության կամ մոդելի արդյունավետության վերաբերյալ քիչ թափանցիկություն կա
- Կարող է երաշխիք չլինել, որ ձեր տվյալները մնում են գաղտնի և չեն օգտագործվում, օրինակ՝ մատակարարի մոդելի ապագա տարբերակները ուսուցանելու համար (դա կախված է կոնկրետ լուծումից. ոմանք կարող են դա սահմանել իրենց գաղտնիության քաղաքականության մեջ)
- Հնարավոր խնդիրներ GDPR-ի և այլ կանոնակարգերի համապատասխանության հետ (դա կախված է կոնկրետ լուծումից. ոմանք կարող են դա սահմանել իրենց քաղաքականության մեջ)
Ո՞ւմ համար է հարմար այս մոտեցումը
AI-ով աշխատող SaaS լուծումը ամենաողջամիտ ընտրությունն է, երբ՝
- Ձեզ անհրաժեշտ է արագ նախատիպ առանց ներքին ML թիմ ստեղծելու
- Ձեր փաստաթղթերի ծավալը փոքր է կամ միջին (օրինակ՝ ամսական տասնյակ հազարներ)
- Դուք ունեք նշագրված տվյալների փոքր հավաքածու և այն ընդլայնելու համար ներդրում անելու պլան չունեք
- Կայունությունն է ձեր առաջնահերթությունը, SLA-ի և անվտանգության հետ միասին, այլ ոչ թե մոդելի վարքի վրա լիակատար վերահսկողությունը
- Տվյալների արդյունահանումը օժանդակ գործիք է, այլ ոչ թե ձեր մրցակցային առավելության սիրտը
Այս իրավիճակներում SaaS-ը ապահովում է գերազանց time-to-value։ Սակայն մասշտաբի և հարմարեցման պահանջների աճի հետ այն արագորեն դառնում է պակաս ծախսարդյունավետ։
Բաց կոդով մոդելներ
Տարբերակը, որը ամենաշատն է պահանջում թե՛ տեխնոլոգիապես, թե՛ կազմակերպչապես, սեփական մեքենայական ուսուցման մոդելի կառուցումն է հիմնական տեղեկատվության արդյունահանման համար՝ ուսուցանված ձեր ընկերության տվյալների վրա և տեղակայված ձեր սեփական միջավայրում։
Այս մոտեցմամբ դուք վերահսկում եք ամբողջ գործընթացը՝
- Մոդելի ճարտարապետության ընտրություն (օրինակ՝ LiLT, LayoutLM, Donut)
- Սեփական մշակման pipeline-ի կառուցում (OCR, կապերի արդյունահանում, դաշտերի դասակարգում)
- Մոդելի շարունակական վերաուսուցում
- Տեղակայում ձեր սեփական ենթակառուցվածքում (ամպ կամ on-premise)
Առավելություններ
- Ձեր կոնկրետ տվյալներին լավագույն համապատասխանությունը – մոդելը սովորում է ձեր ընկերության փաստաթղթերից՝ եզրային դեպքերը հաշվի առնելով
- Լիակատար վերահսկողություն մոդելի վարքի վրա – կարող եք այն fine-tune անել, վերաուսուցանել, վերլուծել նրա սխալները և ավելացնել դաշտերի նոր դասեր, երբ անհրաժեշտ է
- Token վճարներ չկան – տեղակայումից հետո գործառնական ծախսերը շատ ավելի ցածր են և կախված են տվյալների մշակման վրա ծախսված ժամանակից ու ռեսուրսներից
- Բավարարում է անվտանգության և գաղտնիության պահանջները – կարևոր է այնպիսի ոլորտներում, ինչպիսիք են ֆինանսները, առողջապահությունը և լոգիստիկան
- Ներքին ML ենթակառուցվածք կառուցելու հնարավորություն – մեկ նախագիծը կարող է հիմք դնել ձեր ամբողջ AI ռազմավարությանը
- Ուժեղ արդյունավետություն, հաստատված հետազոտություններով – մի քանի ակադեմիական հոդվածներ հաստատում են հանրաճանաչ բաց կոդով մոդելների ճարտարապետությունների արդյունավետությունը՝ 1, 2, 3, 4, 5
- Ավելի լավ արդյունավետություն, քան մյուս լուծումները
Ռիսկեր
- Զգալի սկզբնական ծախս – ձեզ պետք են ML թիմ, DevOps, նշագրողներ և ժամանակ իրականացման համար։ Դա երկարաժամկետ ներդրում է
- Բարդ ենթակառուցվածք և պահպանում – ուսուցումը, թեստավորումը, տեղակայումը, մոնիթորինգը և ավտոմատ վերաուսուցումը բոլորը մեծացնում են գործառնական բարդությունը
- Հնարավոր OSS լիցենզիայի սահմանափակումներ – որոշ մոդելներ կարող են օգտագործվել միայն ոչ առևտրային նպատակներով (դա պետք է գնահատվի ռիսկերի վերլուծության ժամանակ)
- Բարձրորակ ուսուցման տվյալների մեծ քանակ – փոքր տվյալների հավաքածուն կարող է չբավարարել հուսալի մոդել ուսուցանելու համար, և կարող են պահանջվել տասնյակ հազարավոր նշագրված նմուշներ։ Դրանց մի մասը կարելի է հավաքել պասիվ կերպով (օրինակ՝ օգտատերերի ուղղումներից), բայց դրանք պատրաստելը դեռ ջանք և ժամանակ է արժենում
Ո՞ւմ համար է հարմար այս մոտեցումը
Այս տարբերակը լավագույնս համապատասխանում է կազմակերպություններին, որոնք՝
- Ամսական մշակում են միլիոնավոր փաստաթղթեր
- Ունեն (կամ կարող են կառուցել) մեծ ուսուցման տվյալների հավաքածու
- Ունեն (կամ կառուցում են) ML / Data Science թիմ
- Ուզում են լուծման և իրենց տվյալների լիակատար սեփականություն
- AI-ը դիտարկում են որպես ռազմավարական հարց, այլ ոչ թե մեկանգամյա իրականացում
Ճիշտ մասշտաբի դեպքում նման լուծումը կառուցելը արագորեն հատուցվում է, և ընկերությունը ստանում է ոչ միայն մոդել, այլև հիմք՝ իր կարիքներին լիովին հարմարեցված AI ճարտարապետության համար։
LLM-ներ
Փաստաթղթերից տեղեկատվություն արդյունահանելու երրորդ եղանակը հենվում է առևտրային մեծ լեզվական մոդելների (LLM) վրա, ինչպիսիք են GPT-4o-ն (OpenAI), Claude-ը կամ Mistral-ը, որպես կենտրոնական մշակող բաղադրիչ։
Տիպիկ pipeline-ը այսպիսին է՝
- OCR – փաստաթուղթը (օրինակ՝ PDF կամ սկան) վերածել տեքստի՝ պահպանելով նրա հատվածների ընթերցման կարգը
- Prompt engineering – գրել հարցումներ, ինչպիսին է «Արդյունահանիր այս փաստաթղթի տվյալները հետևյալ ձևաչափով. {prompt_format}»
- Հետմշակում – մաքրել և կառուցվածքավորել պատասխանը, վավերացնել դաշտերը և կիրառել fallback կանոններ կամ դասակարգիչներ
Առավելություններ
- Արագ նախատիպավորում – LLM-ները զարմանալիորեն լավ են գլուխ հանում բազմազան լեզվից, անսովոր դասավորություններից և անկատար OCR-ից
- Մոդելի ուսուցում պետք չէ – պետք է միայն լավ նախագծված prompt և մի քանի թեստային տվյալ
- Մուտքի ցածր արժեք – կատարյալ է proof-of-concept-ի (PoC) կամ իրագործելիության ուսումնասիրությունների (R&D) համար
- Կարճաժամկետ ներդրում
- Ճկունություն ոչ ստանդարտ փաստաթղթերի տեսակների հետ – օրինակ՝ ֆինանսական հաշվետվություններ, սպասարկման հայտեր, ձեռագիր գրառումներ
Ռիսկեր
- Դետերմինիզմի բացակայություն – միևնույն prompt-ը կարող է տալ տարբեր արդյունքներ, ինչը որոշ կիրառություններ կարող է դժվարացնել կամ անհնար դարձնել
- Հալյուցինացիաներ և արդյունահանման սխալներ – մոդելը կարող է «գուշակել» բացակայող տվյալները, ինչը անընդունելի է այնպիսի ոլորտներում, ինչպիսիք են հաշվապահությունը, ֆինանսները կամ իրավունքը։ Դրան գումարած՝ ոչինչ չի երաշխավորում, որ մոդելը կվերադարձնի ճիշտ այնքան դաշտ, որքան սպասում եք, ինչը ավելացնում է սխալների ևս մեկ դաս
- Արդյունքի որակը դժվար է վավերացնել – առանց փաստաթղթի կոորդինատներին հղումների թեստավորումն ու վրիպազերծումը դառնում են ավելի դժվար։ LLM-ների ստեղծած կոորդինատները սովորաբար սխալ են
- Inference-ը մասշտաբի դեպքում դառնում է ավելի թանկ – վճարումը ըստ token-ների է, իսկ փաստաթղթերը սովորաբար երկար են
- Չկան բավարար համապարփակ հետազոտություններ, որոնք հաստատում են, թե LLM-ներն ինչպես են աշխատում – միակ ուսումնասիրությունը, որ գտա և որը գնահատում է GPT-4o-ն, ցույց է տալիս, որ այս մոդելները զիջում են հատուկ բաց կոդով մոդելներին (ավելին դրա մասին այստեղ)
- Մոդելի fine-tuning-ը ձեր սեփական տվյալների վրա անհնար է (կամ շատ թանկ)
- Փաստաթղթերը արտաքին API ուղարկելը կարող է անընդունելի լինել կանոնակարգվող ոլորտներում (ֆինանսներ, բժշկություն)
- Պահանջվում է prompt engineering փորձարկումների մեծ քանակ
Ո՞ւմ համար է հարմար այս մոտեցումը
LLM-ների վրա հիմնված արդյունահանումը լավ է համապատասխանում, երբ՝
- Դուք նոր եք սկսում ուսումնասիրել խնդրի տիրույթը և ուզում եք արագ փորձել մի քանի գաղափար
- Աշխատում եք ատիպիկ փաստաթղթերի հետ, որոնք չեն հետևում ֆիքսված ձևանմուշների (օրինակ՝ նամակներ, հաշվետվություններ, գրառումներ)
- Ուզում եք PoC ստեղծել՝ առանց ML ռեսուրսներ կամ ենթակառուցվածք կապելու
- Պատրաստ եք զիջել որոշ ճշգրտություն և վերահսկողություն ավելի արագ իրականացման դիմաց
Դա գերազանց գործիք է արագ ուսումնասիրելու և իտերացիա անելու համար, բայց ոչ անպայման ճիշտ տեխնոլոգիա արտադրական մակարդակի համակարգի համար, որը աշխատում է մասշտաբով՝ խիստ ճշգրտության պահանջներով։
Հիմնական տարբերությունները
Գործառնական ծախսեր
Ես կազմեցի աղյուսակ, որը համեմատում է յուրաքանչյուր լուծման գործառնական ծախսերը։ Դրանց մեծ մասը թաքնված էր փաստաթղթերի խորքում։ LLM-ների համար ես ստիպված էի ենթադրություններ անել token-ների օգտագործման վերաբերյալ, իսկ բաց կոդով մոդելի համար մշակման ժամանակը գնահատեցի նման չափի մոդելների հիման վրա։ Ստորև բերված գծապատկերը կասկած չի թողնում, թե որ տարբերակն է հաղթում գործառնական ծախսերով։
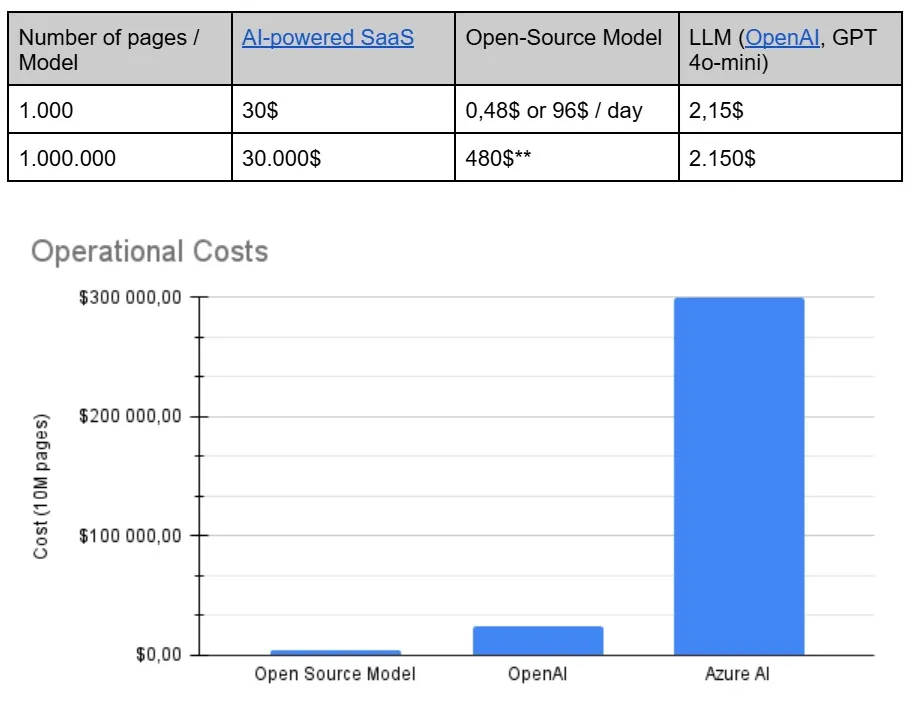
Գծապատկեր, որը ցույց է տալիս տարբեր գործիքների գործառնական ծախսերը։
Ենթադրություններ
Այս սիմուլյացիայի համար ես ենթադրում եմ, որ PDF ֆայլը GPT-4o մոդելին ուղարկվում է առաջադրանքը նկարագրող համակարգային հրահանգի հետ միասին։ Այդ հրահանգը ավելացնում է token-ներ, բայց ենթադրենք՝ այն տեղավորվում է 500 token-ի մեջ։
Հաշվարկներ
Այս սիմուլյացիայի համար ես ենթադրում եմ, որ PDF ֆայլը GPT-4o-mini մոդելին ուղարկվում է առաջադրանքը նկարագրող համակարգային հրահանգի հետ միասին։ Այդ հրահանգը ավելացնում է token-ներ, բայց ենթադրենք՝ այն տեղավորվում է 500 token-ի մեջ։ Ենթադրենք նաև, որ պատասխանը 1,500 token-ից երկար չէ։
GPT-4o-mini մոդելը պատկերները ներկայացնելու համար օգտագործում է ավելի շատ token-ներ, և օգտատերերը, թվում է, հաստատում են դա քննարկումներում։ Token-ների քանակը նույնն է, ինչ GPT-4o-ի դեպքում, ուստի ես այդ մոդելը կօգտագործեմ պատկերի մշակման արժեքը հաշվելու համար, ապա կավելացնեմ GPT-4o-mini-ի ելքի արժեքը։
GPT-4o հաշվարկներ
2.5$ / 1,000,000 = 0.0000025$ մեկ մուտքային token-ի համար
500 մուտքային token = 500 × 0.0000025$ = 0.00125$
GPT-4o-mini հաշվարկներ
0.6$ / 1,000,000 = 0.0000006$ մեկ ելքային token-ի համար
1,500 ելքային token = 1,500 × 0.0000006$ = 0.0009$
0.00125$ + 0.0009$ = 0.00215$ մեկ էջի համար
Ինչպե՞ս ընտրել ճիշտ մոտեցումը ըստ մասշտաբի և կարիքների – Ամփոփում
Ոչ մի լուծում չի համապատասխանում փաստաթղթերից տվյալներ արդյունահանելու բոլոր դեպքերին։ Յուրաքանչյուր մոտեցում՝ SaaS, LLM կամ սեփական մոդել, ունի իր տեղը։ Կարևորն այն չէ, թե որ տեխնոլոգիան է գերազանցում, այլ թե որն է լավագույնս համապատասխանում ձեր կոնկրետ համատեքստին՝ ձեր մասշտաբին, ձեր ունեցած ռեսուրսներին, որակի ձեր պահանջներին և ձեր երկարաժամկետ ռազմավարությանը։
Ահա ամփոփում, որը կարող է օգնել ձեզ որոշել՝
Ի՞նչ է հաջորդը
Եթե մտածում եք փաստաթղթերից տվյալներ արդյունահանելու համակարգ ներդնելու մասին, լավ մեկնակետ է կարիքների վերլուծությունը, որին հաջորդում է տեխնոլոգիայի համապատասխանեցումը ձեր կազմակերպության մասշտաբին և գործընթացներին։
Մենք անցկացնում ենք workshop-եր և խորհրդատվություններ, որոնցում՝
- Գնահատում ենք ավտոմատացման ներուժը
- Համեմատում ենք հասանելի մոտեցումները (օրինակ՝ SaaS, LLM, սեփական մոդել)
- Կազմում ենք ձեր դեպքին հարմարեցված առաջարկություն
- Պատրաստում ենք նախագծի ճանապարհային քարտեզ, որը պատրաստ է ներդրման համար