Cassandra-ն 3.11-ից հետո շատ է փոխվել. այժմ դուք կարող եք այն չճանաչել
Ակնարկ Apache Cassandra 5.0-ի ճարտարապետական փոփոխությունների և 6.0-ում սպասվող հնարավորությունների մասին՝ ինդեքսավորում, կոմպակցիա, վեկտորային որոնում, repair և տրանզակցիաներ։
Ով սովորել է Cassandra-ն մոտավորապես 3.11 տարբերակի ժամանակ, ստացել է բավականին միատեսակ խորհուրդներ. մոդելավորել աղյուսակները հարցումների շուրջ, զգուշությամբ վերաբերվել երկրորդային ինդեքսներին, ըստ աշխատանքային բեռի ընտրել կոմպակցիայի ռազմավարություն և repair-ի պլանավորումը կազմակերպել ինքնուրույն։ Պայմանական թարմացումների համար օգտագործել թեթև տրանզակցիաներ (lightweight transactions)։ Իսկ եթե անհրաժեշտ են տրանզակցիաներ մի քանի բաժանումների (partition) վրա, պատրաստ լինել աշխատանքի ավելի մեծ մասը կատարել տվյալների բազայից դուրս։
Խորհրդատվական աշխատանքիս ընթացքում ես դեռ հանդիպում եմ 3.11 կլաստերների, որոնք շահագործվում են այդ մոդելով։ Դրա մեծ մասը դեռ ուժի մեջ է, բայց այն սահմանափակումներից մի քանիսը, որոնք թելադրում էին այդ խորհուրդները, այլևս նույնը չեն։ Cassandra-ն այժմ առաջարկում է պահեստի հետ ինտեգրված ինդեքսավորում, վեկտորային որոնում, ավելի ճկուն կոմպակցիայի ռազմավարություն և ներկառուցված repair-ի պլանավորում։ 6.0-ի աշխատանքներն ավելի խորանում են կլաստերի մետատվյալների և տրանզակցիաների մեջ։
2026 թվականի սեպտեմբերի դրությամբ ամենանոր GA թողարկումը Apache Cassandra 5.0.9-ն է։ Cassandra 6.0-ը դեռ չի հասել GA-ի, թեև alpha կառուցումները կարելի է ներբեռնել։ Տարբերությունը կարևոր է. SAI-ն արժե գնահատել կայուն թողարկման վրա, իսկ Accord-ը պատճառ է հետևելու հաջորդ թողարկմանը և փորձարկելու այն։
Այս ամենը հետաքրքիր է դարձնում ոչ թե այն, որ Cassandra-ն ձեռք է բերել ավելի շատ կարգավորման պարամետրեր։ Այլ այն, որ երկարամյա մի շարք ենթադրություններ այն մասին, թե ինչպես պետք է Cassandra-ին հարցումներ անել և ինչպես այն շահագործել, սկսել են թուլանալ։ Մոտավորապես համեմատությունն այսպես է երևում.
| Ոլորտ | Ինչ է փոխվել | Թողարկում |
|---|---|---|
| Streaming | Համապատասխան ամբողջական SSTable-ը կարելի է ուղարկել zero-copy փոխանցման ուղով | 4.0 |
| Շահագործման սահմանափակումներ | Guardrails-ը առաջարկում է կարգավորվող զգուշացումներ և խափանումներ | 4.1 |
| Երկրորդային ինդեքսավորում | Storage-Attached Indexing, կամ SAI | 5.0 |
| Կոմպակցիա | Unified Compaction Strategy, կամ UCS | 5.0 |
| Նմանության հարցումներ | Ներկառուցված վեկտորներ և մոտավոր ամենամոտ հարևանի որոնում | 5.0 |
| Repair-ի պլանավորում | Auto Repair, որը 5.0 backport-ում պահանջում է հստակ համաձայնություն (opt-in) | 5.0.8+ |
| Կլաստերի մետատվյալներ | Transactional Cluster Metadata | 6.0 աշխատանքներ |
| Բաժանումների միջև տրանզակցիաներ | Accord-ի ինտեգրում | 6.0 աշխատանքներ |
Այսօր արժե հարցնել, թե խորհուրդներից որոնք են դեռ բխում Cassandra-ի ճարտարապետությունից, և որոնք պարզապես արտացոլում էին հին իրականացման սահմանափակումները։
Cassandra 4.0-ը բարելավեց տվյալների տեղափոխման արժեքը
Streaming-ը տվյալները տեղափոխում է հանգույցների (node) միջև bootstrap-ի, փոխարինման, rebuild-ի, repair-ի և տոպոլոգիայի փոփոխությունների ժամանակ։ Մեծ կլաստերում այն որոշում է, թե որքան ժամանակ կանցնի, մինչև հանգույցը օգտակար դառնա, և որքան արագ կարելի է վերականգնել բացակայող replica-ի տվյալները։
Cassandra 4.0-ը ավելացրեց zero-copy streaming ուղի համապատասխան ամբողջական SSTable-ների համար։ Դրանց պարունակությունը Java օբյեկտների մեջ դեսերիալիզացնելու և հետո նորից սերիալիզացնելու փոխարեն՝ Cassandra-ն կարող է ֆայլերն ուղարկել ավելի ուղղակիորեն։ Մասնակի փոխանցումները և այլ դեպքեր դեռ անցնում են համապատասխան streaming ուղով. օպտիմալացումը չի ընդգրկում յուրաքանչյուր փոխանցում։
4.0 streaming-ի փաստաթղթերը նշում են մոտ հնգապատիկ արագացում այն benchmark-ում, որն օգտագործվել է հնարավորությունը ներկայացնելիս։ Դա յուրաքանչյուր կլաստերի հզորության կանխատեսում չէ, բայց ցույց է տալիս, թե ինչու էր փոփոխությունը նշանակալի. քիչ հիշողության հատկացման և CPU աշխատանքի դեպքում փոխանցման ավելի մեծ մասը կարող է սահմանափակվել պահեստի և ցանցի թողունակությամբ։
Տերաբայթներով տվյալներ պահող հանգույցի համար ավելի արագ streaming-ը կարող է արագացնել փոխարինումը և կրճատել այն ժամանակահատվածը, երբ replica-ները բացակայում են։ Դա շահագործման առավելություն է, թեև հավելվածի CQL-ը բոլորովին չի փոխվում։
Guardrails-ը որոշ սահմանափակումներ տեղափոխում է տվյալների բազա
Cassandra-ի հին տեղակայումները հաճախ հիմնվում էին կոնվենցիաների վրա, որոնց պահպանումը վերահսկվում էր code review-ով կամ runbook-ներով։ Չստեղծել հարյուրավոր աղյուսակներ։ Պահել կոլեկցիաները սահմանափակ։ Թույլ չտալ, որ հավելվածը կատարի հարցումներ անվերահսկելի թվով բաժանումների վրա։ Զգույշ լինել ALLOW FILTERING-ի հետ։
4.1-ում ավելացված Guardrails Framework-ով օպերատորները կարող են այդ կանոններից մի քանիսը կոդավորել հենց Cassandra-ում։ Կախված guardrail-ից՝ կոնֆիգուրացիան կարող է տալ զգուշացում, մերժել գործողությունը շեմն անցնելու դեպքում կամ անջատել հնարավորությունը։ Օրինակները ընդգրկում են աղյուսակների և ինդեքսների քանակը, կոլեկցիաների չափերը և այն, թե հարցումը քանի բաժանման բանալի է ընտրում։ ALLOW FILTERING-ը կարելի է անջատել։
Սկզբունքային տեսքով.
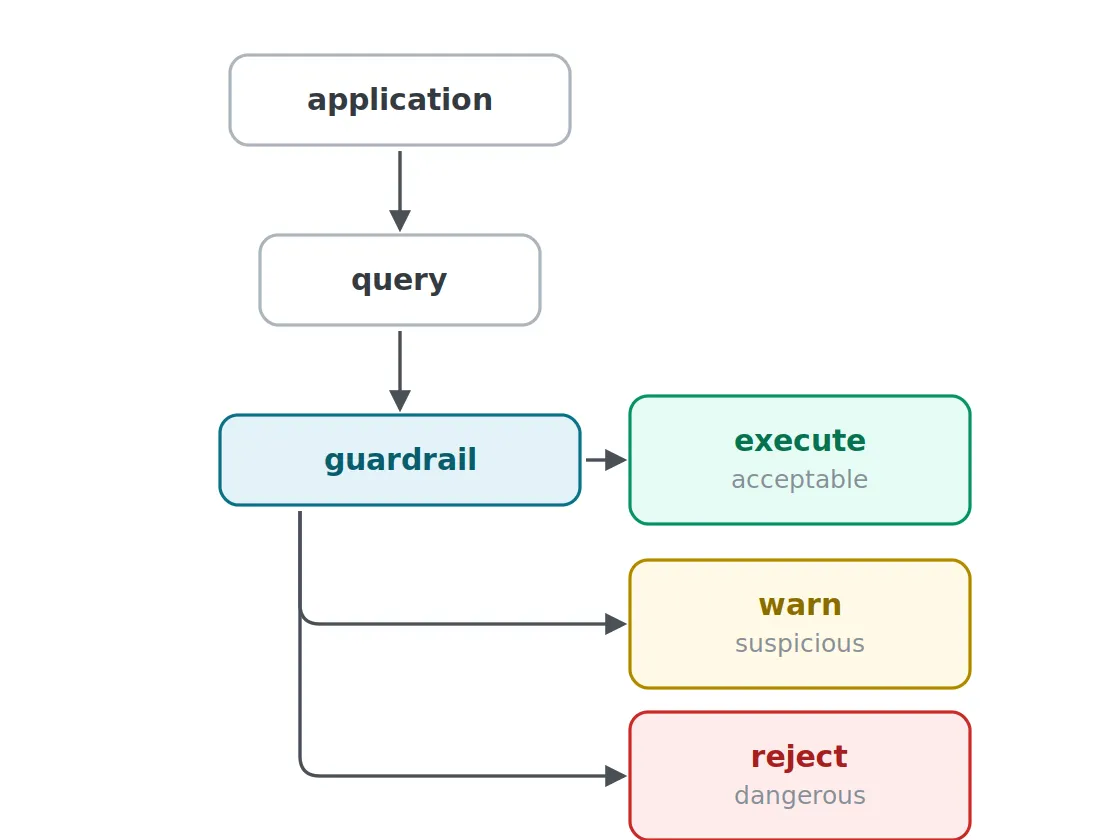
Զգուշացումը թույլ է տալիս հավելվածի թիմին լուծել աճող օգտագործումը մինչև խափանման շեմին հասնելը։ Մերժումը արգելափակում է կարգավորված սահմանը գերազանցող ցանկացած գործողություն։ Ոչ մեկը չի փոխարինում աշխատանքային բեռի նախագծմանը, բայց երկուսն էլ ավելի հուսալի են, քան հույսը, թե յուրաքանչյուր մշակող կարդացել է նույն շահագործման ուղեցույցը։
Երկրորդային ինդեքսների մասին խորհուրդը պետք է տարբերի SAI-ը հին ինդեքսներից
Եթե Cassandra-ին ծանոթացել եք տարիներ առաջ, շատ հավանական է՝ ինչ-որ մեկը ձեզ ասել է.
Հեռու մնացեք երկրորդային ինդեքսներից։
Հաճախ դա առողջ խորհուրդ էր։ Cassandra-ի դասական երկրորդային ինդեքսները կարող էին վատ աշխատել մեծ մասշտաբով, մասնավորապես երբ հարցումները պետք է տարածվեին բազմաթիվ բաժանումների վրա կամ երբ ինդեքսի կարդինալությունը չէր համապատասխանում աշխատանքային բեռին։ Փորձառու թիմերը հակված էին նախընտրել Cassandra-ի այլ օրինաչափություն. կառուցել լրացուցիչ աղյուսակ, որը ճիշտ այն ձևն ունի, որ պետք է հարցմանը։
Ասենք՝ պահում ենք օգտատերերին.
CREATE TABLE users (
    id uuid PRIMARY KEY,
    country text,
    age int,
    status text,
    name text
);
և պետք է նրանց հարցնել ըստ country-ի և age-ի։ Cassandra-ի դասական լուծումը կարող էր լինել ևս մեկ աղյուսակ.
users_by_country_and_ageհամապատասխան բաժանման և կլաստերավորման բանալիով։ Հետո նոր հարցում է հայտնվում, և նոր աղյուսակ ևս։ Դա ինքնաբերաբար սխալ չէ. հարցումներով առաջնորդվող դենորմալիզացիան դեռ Cassandra-ի ուժեղ կողմերից մեկն է։
Cassandra 5.0-ը ներմուծում է Storage-Attached Indexing։ Կարող ենք ինդեքսավորել այն սյուները, որոնցով ֆիլտրում ենք.
CREATE INDEX users_country_idx
ON users(country)
USING 'sai';

CREATE INDEX users_age_idx
ON users(age)
USING 'sai';

CREATE INDEX users_status_idx
ON users(status)
USING 'sai';
Այս օրինակները ենթադրում են, որ արդեն գոյություն ունեցող keyspace-ը ընտրված է session-ի համար։ Շարահյուսությունը և աջակցվող սյունի տիպերը նկարագրված են CQL ինդեքսի փաստաթղթերում։
SAI-ն ինդեքսները կապում է memtable-ների և SSTable-ների հետ։ Կարդալիս արդյունքները միավորվում են այս կառուցվածքներից, և ինդեքսի կյանքի ցիկլը հետևում է պահեստի շարժիչի flush-ներին և կոմպակցիաներին։ Այն աջակցում է թվային միջակայքեր, ինդեքսավորված պրեդիկատների համակցություններ, կոլեկցիաների պրեդիկատներ և տեքստի հավասարություն։ Որոշակի հասանելիության օրինաչափությունների համար դա կարող է ավելորդ դարձնել լրացուցիչ, հարցմանը հատուկ աղյուսակը։
Կա նաև շահագործման հետ կապված կարևոր առավելություն։ Երբ անհրաժեշտ ֆիլտրումը կարող է մնալ Cassandra-ի ներսում, հնարավոր է՝ ստիպված չլինեք արտաքին ինդեքսավորման համակարգում պահել երկրորդ պատճենը՝ իր սեփական replication-ով, վերականգնմամբ և մոնիթորինգով։ Դա ճիշտ է միայն եթե SAI-ն ապահովում է հավելվածին անհրաժեշտ հարցումների վարքը։
Ինդեքսը չի վերացնում հարցման տարածումը (fan-out)
SAI-ն փոխում է այն, թե ինչպես է Cassandra-ն գտնում համապատասխան տողերը։ Այն չի դարձնում բազմաթիվ բաժանումներ ընդգրկող հարցումը նույնքան էժան, որքան մեկ բաժանման բանալիով որոնումը։
Վերևի ինդեքսներով կարող ենք ֆիլտրել և՛ ըստ country-ի, և՛ ըստ age-ի՝ առանց ALLOW FILTERING.
SELECT id, name, age
FROM users
WHERE country = 'PL'
  AND age >= 30
  AND age < 40;
SAI-ն թույլ է տալիս ինդեքսավորված պրեդիկատները համադրել AND-ով, ինչպես ցույց է տալիս հարցումների փաստաթղթերը։ Դա մեզ տալիս է ևս մեկ հասանելիության օրինաչափություն՝ առանց ևս մեկ աղյուսակ պահպանելու անհրաժեշտության։
Սակայն ֆիզիկական դասավորությունը նույնը չէ։ Ըստ country-ի բաժանված աղյուսակը՝ age-ով որպես կլաստերավորման սյուն, կարող է այս հարցմանը պատասխանել համապատասխան երկրի replica բազմությունից։ users աղյուսակում տողերը դեռ բաժանված են ըստ ID-ի, ուստի ինդեքսավորված հարցումը կարող է ստիպված լինել աշխատանք կատարել մի քանի token միջակայքերում։ Նույն ֆիլտրի աջակցությունը չի նշանակում նույն ուղղորդումը, դասավորությունը կամ կարդալու արժեքը։
users օրինակը միտումնավոր պարզ է։ Տարածված country-ով կամ status-ով ֆիլտրումը կարող է ընդգրկել տվյալների հավաքածուի մեծ մասը։ Ինդեքսը նման հարցումը դարձնում է արտահայտելի և կարող է կրճատել տեղային սկանավորումը, բայց արժեքների բաշխումը և հանգույցների միջև բաշխված աշխատանքը դեռ կարևոր են։
Հաճախակի հարցման համար, որը խիստ հապաղման պահանջներ ունի, ես SAI-ը կչափեի այդ հարցման համար կառուցված աղյուսակի դեմ՝ օգտագործելով ներկայացուցչական տվյալներ։ Չափեք կարդալու հապաղումը և կլաստերի աշխատանքը, ապա հաշվի առեք գրելու և պահեստավորման արժեքը՝ կամ ինդեքսները, կամ դենորմալիզացված աղյուսակները պահպանելու համար։
Երկրորդային ինդեքսներից խուսափելու հին համատարած կանոնը չափազանց լայն է։ Այն փոխարինում է կոնկրետ հասանելիության օրինաչափության համար SAI-ի գնահատումը, մինչդեռ բաժանումը և ընտրողականությունը (selectivity) մնում են որոշման մաս։
UCS-ը հեշտացնում է կոմպակցիայի վարքի կարգավորումը
Ավանդաբար Cassandra-ի օպերատորները ընտրել են մի քանի կոմպակցիայի ռազմավարությունից.
| Ռազմավարություն | Ընտրելու բնորոշ պատճառ | Հաշվի առնելու արժեք |
|---|---|---|
| STCS | Գրելով գերիշխող աշխատանքային բեռներ | Կարդալիս գուցե ստիպված լինեն ստուգել ավելի շատ SSTable |
| LCS | Կարդալու ավելի ցածր ուժեղացում (read amplification) | Կոմպակցիան վերագրում է ավելի շատ տվյալ |
| TWCS | Ժամանակային շարքերի տվյալներ՝ համապատասխան TTL օրինաչափություններով | Թե որքան լավ է աշխատում, կախված է timestamp-ի և ժամկետի լրացման վարքից |
Cassandra 5.0-ը ներմուծում է Unified Compaction Strategy։ UCS-ի փաստաթղթերը խորհուրդ են տալիս այն աշխատանքային բեռների մեծամասնության համար և բացատրում, թե ինչպես կարգավորել այն՝ հին ռազմավարությունների նման վարվելու համար։
UCS-ը մակարդակային (tiered) և աստիճանային (leveled) փոխզիջումը արտահայտում է scaling պարամետրերով։ Դրական արժեքները հակվում են tiered վարքի, բացասականները՝ leveled վարքի, և յուրաքանչյուր մակարդակ կարող է օգտագործել իր սեփական կարգավորումները։ Sharding-ը թույլ է տալիս կոմպակցիայի աշխատանքը կատարել զուգահեռ և օգնում է SSTable-ների չափերը վերահսկել մեծ տվյալների հավաքածուներով հանգույցներում։
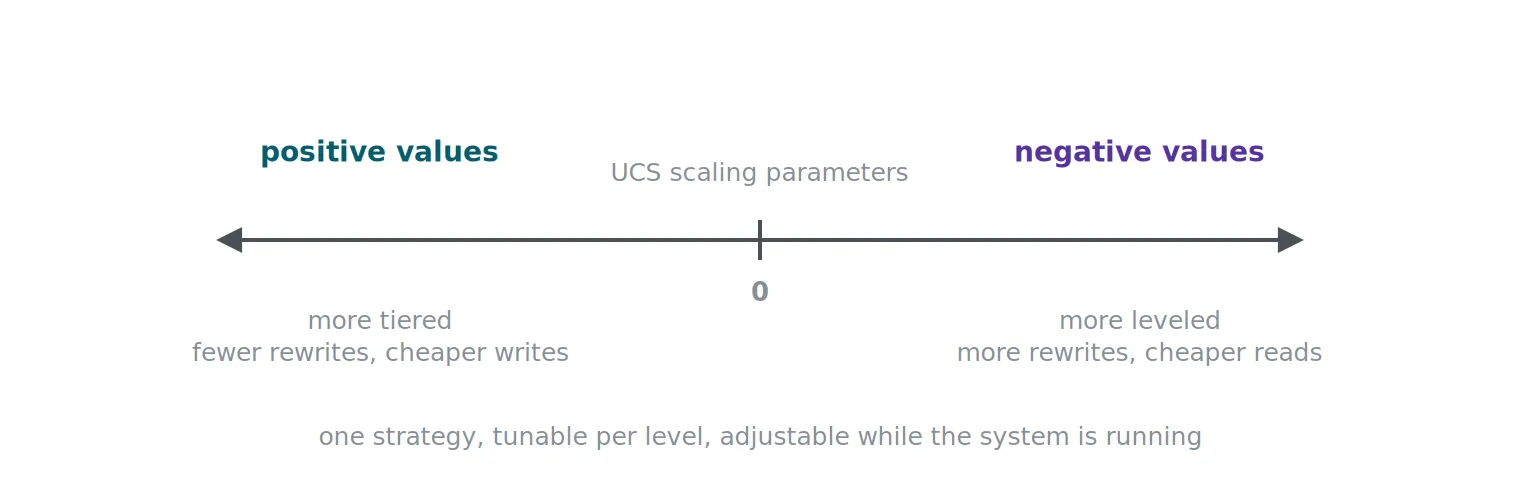
Պարամետրերը կարող եք փոխել համակարգի աշխատանքի ընթացքում՝ առանց լրիվ վերակոմպակցիայի՝ այս վարքերի միջև անցնելու համար։ Դա կարգավորումը դարձնում է շատ ավելի քիչ խանգարող, քան սկզբնական ռազմավարությունը որպես ցմահ որոշում դիտելը։
Չափումը դեռ անհրաժեշտ է։ Փոփոխությունը, որը նվազեցնում է read amplification-ը, կարող է մեծացնել ֆոնային գրելու աշխատանքը։ Գոյություն ունեցող SSTable-ներին նույնպես ժամանակ է պետք՝ կոմպակցիայով անցնելու համար. կարգավորումը փոխելը անմիջապես նոր դասավորություն չի ստեղծում։ UCS-ը օպերատորներին տալիս է մեկ ընդհանուր մեխանիզմ այդ հավասարակշռությունը տեղաշարժելու համար. այն չի վերացնում հավասարակշռությունը։
Վեկտորային որոնումը կարող է մնալ օպերացիոն տվյալների կողքին
Cassandra 5.0-ը ավելացնում է բնիկ vector տիպ և մոտավոր ամենամոտ հարևանի որոնում SAI-ի միջոցով։ Արտադրանքը կարող է իր օպերացիոն դաշտերը և embedding-ը պահել կողք կողքի.
CREATE TABLE products (
    id uuid PRIMARY KEY,
    name text,
    description text,
    embedding vector<float, 768>
);

CREATE INDEX products_embedding_idx
ON products(embedding)
USING 'sai';
Այնուհետև հաճախորդը կարող է պատրաստել նմանության հարցում.
SELECT id, name
FROM products
ORDER BY embedding ANN OF ?
LIMIT 10;
Այս հարցման մեջ ?-ը bind marker է 768 տարրանոց հարցման վեկտորի համար, որը տրամադրում է հաճախորդը։ Embedding-ը ստեղծող մոդելը մնում է Cassandra-ից դուրս։
Աջակցվող նմանության ֆունկցիաներն են կոսինուսային նմանությունը, սկալյար արտադրյալը և Էվկլիդեսյան հեռավորությունը։ 5.0-ի հայտարարությունը վեկտորային որոնումը թվարկում է թողարկման հիմնական հավելումների շարքում։
Ամենահամոզիչ դեպքը այն հավելվածն է, որն արդեն Cassandra-ում պահում է մեծ օպերացիոն տվյալների հավաքածու և ուզում է դրա վրա նմանության հարցումներ կատարել։ Գրառումը և embedding-ը միասին պահելը կարող է խնայել ձեզ այդ տվյալները երկրորդ տվյալների բազա պատճենելուց՝ միայն վեկտորային որոնման համար։
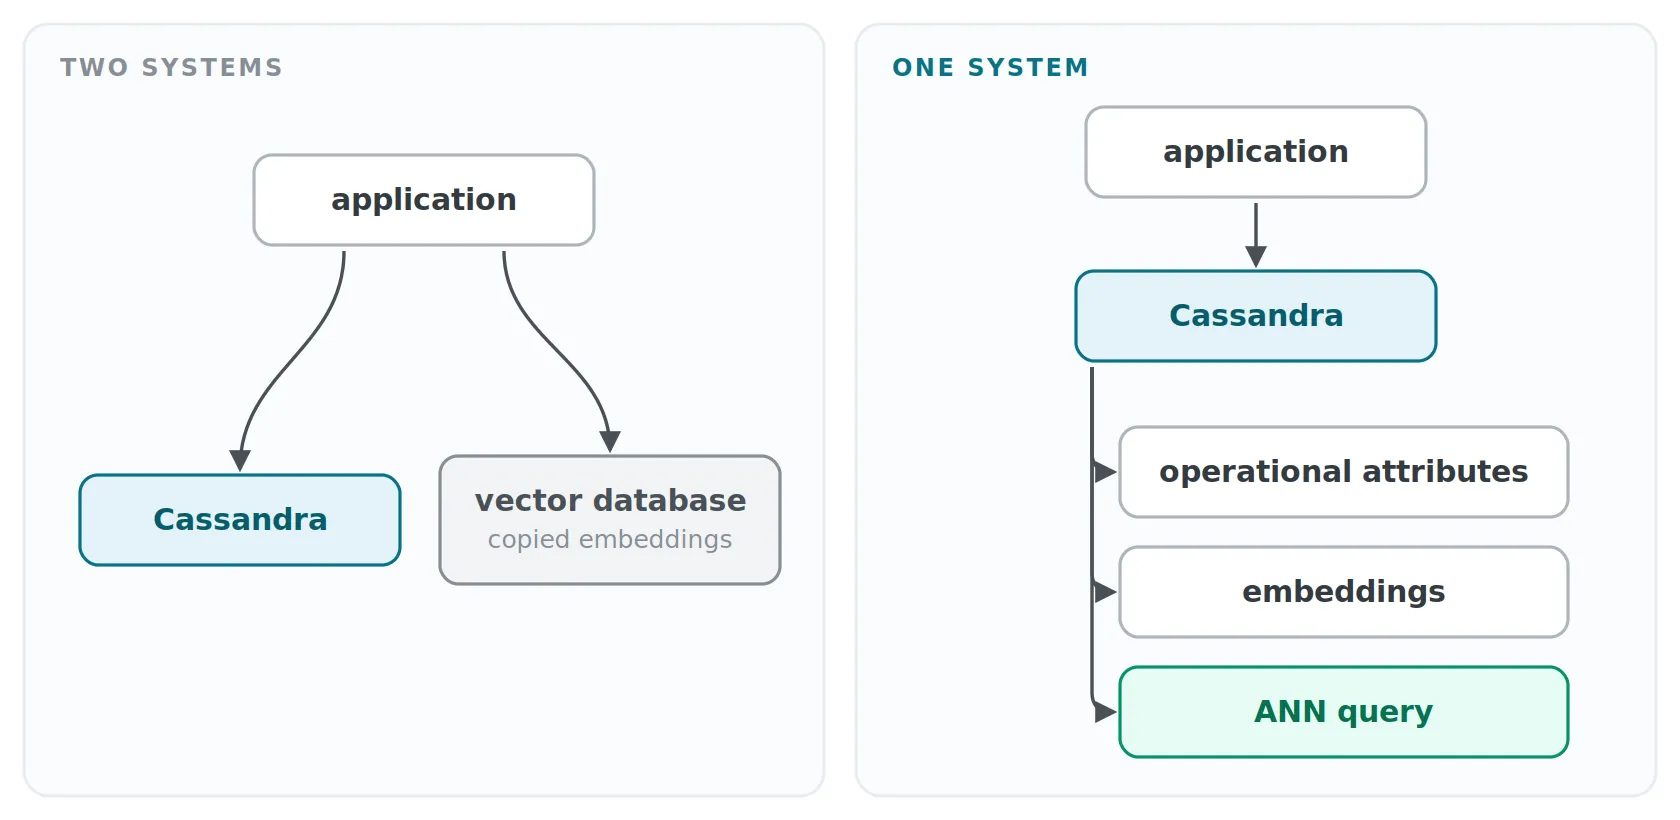
Սա չի որոշում, թե որ որոնման համակարգն օգտագործել։ Մոտավոր որոնման որակը, ֆիլտրումը, հապաղումը, թարմացումների վարքը և շահագործման արժեքը դեռ պետք է գնահատվեն։ Օրինակ՝ RAG հավելվածի համար կարևոր է իր իրական կորպուսի վրա լավ որոնումը, այլ ոչ թե պարզապես ANN հարցում կատարելու հնարավորությունը։
Auto Repair-ը ավելացնում է ներկառուցված պլանավորում
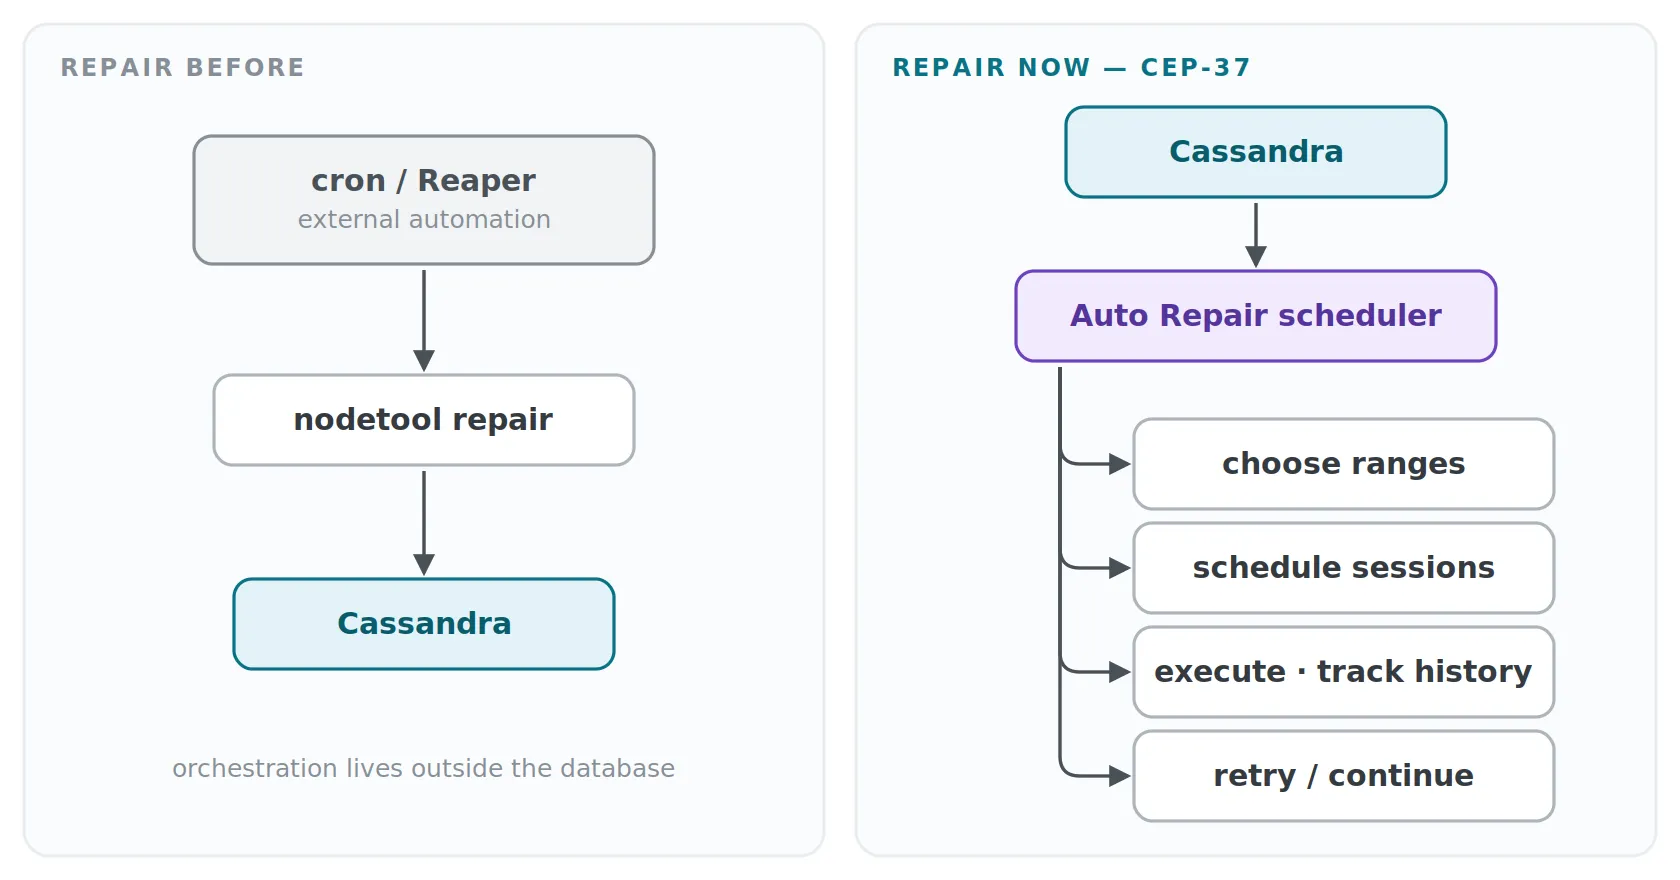
Cassandra-ի replica-ները կարող են ժամանակավորապես շեղվել իրարից։ Anti-entropy repair-ը համեմատում է replica-ների տվյալները և հաշտեցնում տարբերությունները, որոնք այլ մեխանիզմները չեն ուղղել։ Repair-ի մեխանիզմը Cassandra-ում վաղուց կա. սակայն դրա պլանավորումը կլաստերի մասշտաբով հաճախ հիմնվել է արտաքին գործիքների վրա, ինչպիսին Cassandra Reaper-ն է։
Պլանավորիչը պետք է ընդգրկի համապատասխան token միջակայքերը, կրկնի ձախողված փորձերը և աշխատանքը բաշխի այնպես, որ առաջնային տրաֆիկը չխեղդվի։ Auto Repair-ը, որը կառուցվել է CEP-37-ի շրջանակում 6.0-ի համար և backport արվել 5.0.8-ին, այդ օրկեստրացիան բերում է Cassandra-ի ներսում։ Այն կառավարում է լրիվ, ինկրեմենտալ և preview repair-ի պլանավորումը, token միջակայքերի բաժանումը, repair-ի պատմությունը և աղյուսակների առաջնահերթությունները։ Preview repair-ը ստուգում է համահունչությունը՝ տարբերությունները ուղղելու փոխարեն։
5.0 backport-ը ներառում է երկու առանձին քայլ։ JVM հատկությունը cassandra.autorepair.enable միացնում է պահանջվող սխեմայի աջակցությունը, իսկ պլանավորումը հետո միացվում է կոնֆիգուրացիայով կամ JMX-ով։ Ըստ փաստաթղթերի՝ հատկությունը չի կարող հետ շրջվել. պլանավորումն անջատելը առանձին գործողություն է։ Սա պահանջում է գիտակցված միգրացիայի որոշում, այլ ոչ թե այն շարքային կոնֆիգուրացիայի մաքրման հետ միասին անելը։
Ներկառուցված պլանավորիչ ունենալը նշանակում է առանձին օրկեստրացիոն սերվիս գործարկելու ավելի քիչ կարիք։ Օպերատորները դեռ պետք է ստուգեն ընդգրկումը, հաջող ավարտը և ռեսուրսների սպառումը։ Կարգավորված պլանավորումը չի ապացուցում, որ յուրաքանչյուր միջակայք repair է արվում բավարար հաճախությամբ։
Cassandra 6.0-ը դասավորում է կլաստերի մետատվյալների փոփոխությունները
Հետևյալ փոփոխությունները 6.0 մշակման գծի մաս են, այլ ոչ թե ընթացիկ կայուն 5.0 թողարկման։
Պատմականորեն Cassandra-ն ուժեղ հենվել է gossip-ի և ի վերջո կատարվող տարածման (eventual propagation) վրա՝ կլաստերի տեղեկատվության համար։ Դա լավ է դիտարկումներ կիսելու համար, բայց տոպոլոգիայի և սխեմայի փոփոխությունները պահանջում են համահունչ մեկնաբանություն։ Երբ հանգույցը միանում է կամ հեռանում, կոորդինատորները պետք է իմանան, թե որ replica-ներն են տիրապետում ազդված միջակայքերին՝ նույնիսկ երբ հարցումները դեռ ընթացքի մեջ են։
Transactional Cluster Metadata-ն, որը սահմանված է CEP-21-ում, բերում է Cluster Metadata Service և վերափոխումների դասավորված մատյան (log)։ Հանգույցները կիրառում են հաստատված մետատվյալների փոփոխությունները այդ հաջորդականությամբ։ Սա սխեմայի թարմացումների և token սեփականության անցումների նման փոփոխություններին տալիս է ընդհանուր պատմություն։
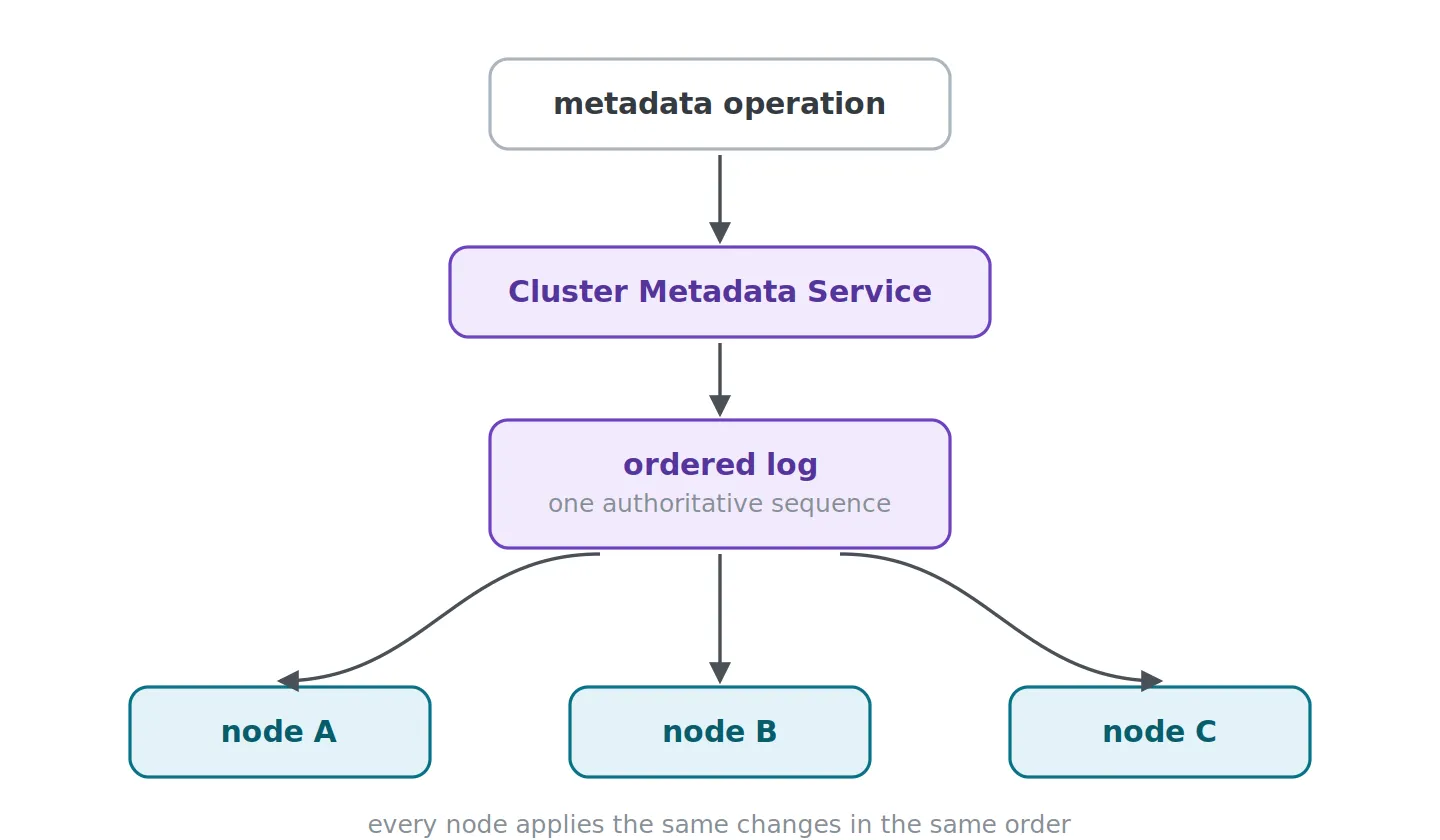
Հիմնական տարբերությունը կլաստերի կառուցվածքի շուրջ համաձայնության գալու և հանգույցների կենդանի լինելը դիտարկելու միջև է։ Gossip-ը դեռ դեր ունի. պարզապես այլևս չի սպասվում, որ այն սահմանի կրիտիկական մետատվյալների փոփոխությունների հեղինակավոր կարգը։ Ոչ էլ օգտատիրոջ տվյալների յուրաքանչյուր գրառումը դառնում է մշտական առաջնային հանգույցով ուղղորդվող գործողություն։
Օպերատորների համար սա վերացնում է անորոշությունը միաժամանակ կատարվող կամ միայն մասամբ դիտարկվող տոպոլոգիայի փոփոխությունների շուրջ։ Նպատակն է սեփականության անցումները դարձնել հստակ և համահունչ մեկնաբանվող, փոխանակ հույս դնելու, որ յուրաքանչյուր հանգույց ի վերջո կկազմի նույն պատկերը։
Accord-ը տրանզակցիայի մոդելը ընդլայնում է բաժանումների միջև
Cassandra-ն արդեն աջակցում է ատոմար գործողություններ մեկ բաժանման ներսում և Paxos-ի վրա հիմնված թեթև տրանզակցիաներ պայմանական թարմացումների համար։ Օգտանունը զբաղեցնելը հայտնի օրինակ է.
INSERT INTO usernames (username, user_id)
VALUES ('alice', ?)
IF NOT EXISTS;
Սա ենթադրում է username-ով բանալիավորված աղյուսակ և հաճախորդ, որը կապում է user_id-ն։ Այն արտահայտում է պայմանական գործողություն այդ բաժանման ներսում։ Այն չի առաջարկում ընդհանուր տրանզակցիա ոչ առնչվող բաժանումների վրա կամայական կարդալու և գրելու համար։
Սա կարևոր է, երբ ինվարիանտը ընդգրկում է մի քանի հաշիվ, պահեստային միավոր կամ այլ սուբյեկտներ, որոնք բաժանվում են անկախ։ Ամեն ինչ մեկ բաժանման մեջ սեղմելը կարող է հեշտացնել համակարգումը, բայց կարող է նաև հանգեցնել թեժ կամ անսահմանափակ բաժանման։ Բաժանումների միջև logged batch-ը չի կարող փոխարինել մեկուսացված, պայմանական բազմաբաժանումային տրանզակցիային։
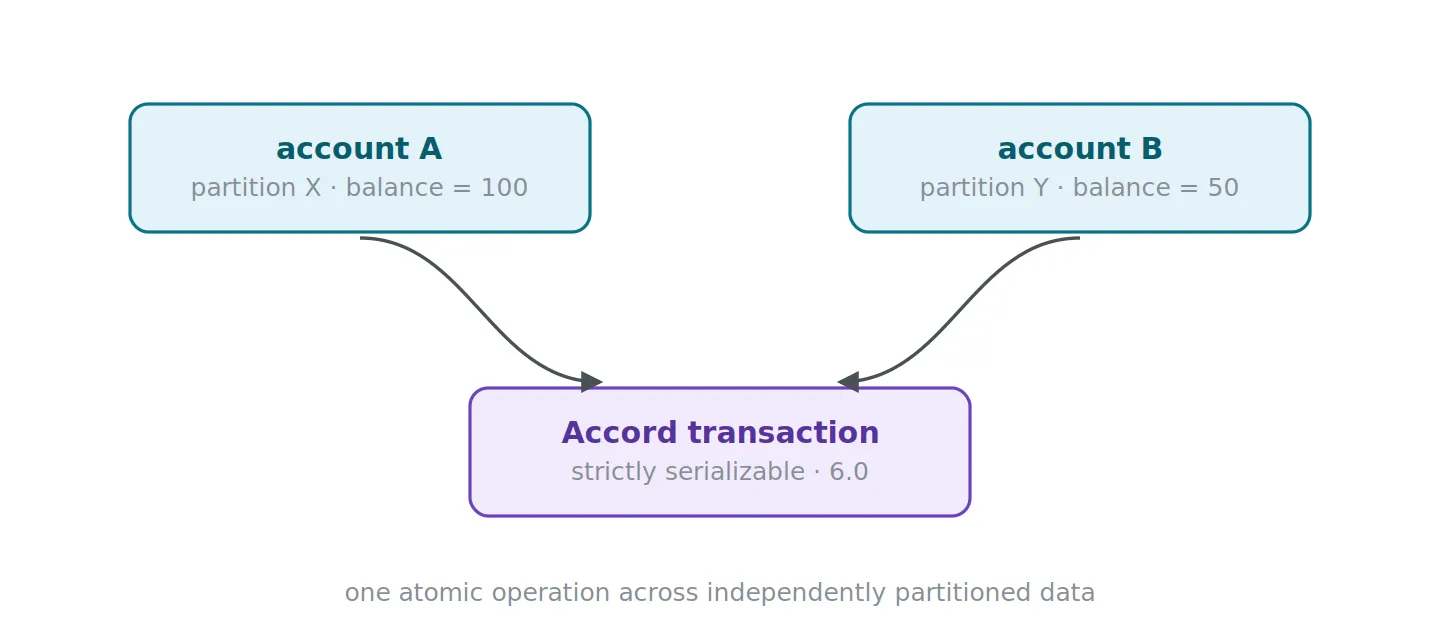
CEP-15-ը բերում է Accord՝ ընդհանուր նշանակության տրանզակցիաների համար խիստ սերիալիզացվելիությամբ (strict serializability)։ Այն նպատակ ունի առանց լիդերի (leaderless) պրոտոկոլի, որի արագ ուղին նորմալ պայմաններում պահանջում է մեկ WAN round trip։ Դա պրոտոկոլի հատկություն է իր նշած պայմաններում, այլ ոչ թե ընդհանուր հապաղման երաշխիք յուրաքանչյուր հավելվածային տրանզակցիայի համար։
6.0-alpha2 ինտեգրման փաստաթղթերը բացատրում են, թե ինչպես է Cassandra-ն CQL-ի կատարումը, պահպանումը և վերականգնումը կապում Accord-ի հետ։ Առանձին բաժանումներում գտնվող հաշիվների միջև փոխանցման դեպքում սպասվող շահույթն այն է, որ տվյալների բազան կարող է պայմանական դեբետը և կրեդիտը համակարգել որպես մեկ տրանզակցիա։
Խիստ սերիալիզացվելիությունը նշանակում է, որ հաստատված տրանզակցիաները գործում են այնպես, կարծես կատարվել են ինչ-որ սերիական կարգով, որը նաև հարգում է իրական ժամանակի կարգը։ Դա շատ ավելի լայն երաշխիք է, քան յուրաքանչյուր հաշվին առանձին հաջող գրառումները։
Համակարգումը և միգրացիան դեռ ուշադրություն են պահանջում
Բաժանումների միջև տրանզակցիաները ներառում են մասնակից replica-ներ, տրանզակցիայի վիճակ, կոնֆլիկտների մշակում և վերականգնում։ Տվյալների տեղայնությունը դեռ ազդում է արժեքի վրա, իսկ մրցակցությունը (contention) կարող է ազդել հապաղման վրա։ Accord-ը կարող է պահպանել ինվարիանտ, որը նախկինում պահանջում էր համակարգում հավելվածում, բայց չի դարձնում յուրաքանչյուր բաշխված թարմացում էժան։
Ընդունման նախագծումը նաև թույլ է տալիս գոյություն ունեցող Paxos-ի վրա հիմնված LWT-ին և Accord-ին աշխատել կողք կողքի անցման ընթացքում։ CEP-15-ը պահանջում է կենդանի միգրացիա և Paxos-ի հնարավոր վերջնական հնացումը (deprecation) թողնում է ապագա որոշման։ AxonOps-ի ամփոփումը Ariel Weisberg-ի օպերատորական ելույթի մասին ասում է, որ Accord-ը նախատեսված է լռելյայն անջատված լինել և ընդունվել աղյուսակ առ աղյուսակ, աղյուսակը Paxos-ի վրա հիմնված LWT-ին հետ տեղափոխելու հնարավորությամբ։ Ճշգրիտ կոնֆիգուրացիան և միգրացիայի վարքը պետք է ստուգել ձեր գնահատած 6.0 թողարկման դեմ. alpha-ի վարքը վերջնական արտադրական պայմանագիր չէ։
Գոյություն ունեցող հավելվածի համար ես կսկսեի այն ինվարիանտից, որը այսօր դժվար է ապահովել, և կփորձարկեի հենց այդ գործողությունը։ Չափեք և՛ նորմալ կատարումը, և՛ խափանումներից հետո վերականգնումը։ Նոր երաշխիքը արդարացվում է, երբ պարզեցնում է իրական պահանջը, այլ ոչ թե երբ դառնում է պատրվակ՝ բնականաբար առնչվող տվյալները մի քանի բաժանումների վրա ցրելու համար։
Ինչը դեռ նույն խնամքն է պահանջում
Բաժանման բանալիները դեռ որոշում են, թե որտեղ են հայտնվում տվյալները։ Շեղված տրաֆիկը կարող է ստեղծել թեժ բաժանումներ, իսկ մեծ բաժանումները դեռ թանկ են կարդալու, կոմպակցիայի ենթարկելու և տեղափոխելու համար։ SAI-ն և Accord-ը այս ամենից ոչինչ չեն փոխում։
Դենորմալիզացիան դեռ արժեքավոր է կանխատեսելի, հաճախակի հարցումների համար։ Պարզապես այժմ կա ևս մեկ տարբերակ՝ կշռելու համար. համեմատել, թե որքան է արժե հատուկ կառուցված աղյուսակը ինդեքսավորված հասանելիության համեմատ, ներառյալ յուրաքանչյուր ներկայացման թարմ պահելու աշխատանքը։
Tombstone-ները և TTL-ները շարունակում են ազդել կարդալու, կոմպակցիայի և repair-ի վրա։ Տվյալների ջնջումը կամ ժամկետի լրանալը ակնթարթորեն չի ազատվում պահված յուրաքանչյուր տարբերակից։ Նոր կոմպակցիայի ռազմավարությունը փոխում է այդ աշխատանքի կազմակերպումը, ոչ թե այն, թե արդյոք այն պետք է կատարվի։
Cassandra-ն նաև մնում է կենտրոնացած բաշխված, բաժանված աշխատանքային բեռների վրա։ Ճկուն ինդեքսավորումը և ավելի լայն տրանզակցիաները չեն բերում կամայական ռելացիոն join-եր։ Համապատասխանությունը դեռ կախված է հավելվածի հարցումների օրինաչափություններից, բաշխման կարիքներից և համահունչության ընտրություններից։
Վերադարձ 3.11-ից
Եթե աշխատեցնում եք 3.11, Cassandra 5.0-ը խելամիտ թողարկում է, որը պետք է գնահատել առաջինը։ SAI-ը, UCS-ը և վեկտորային որոնումն արդեն այնտեղ են՝ ցածր մակարդակի փոփոխությունների հետ միասին, ինչպիսիք են trie-based memtable-ները և BTI SSTable ձևաչափը։ Auto Repair-ը գալիս է 5.0-ի ավելի ուշ սպասարկման թողարկումներում՝ նախկինում նկարագրված opt-in պահանջներին համապատասխան։
Տեղափոխվելու համար կա նաև սպասարկման փաստարկ. Apache-ը 3.x շարքի կյանքի ավարտը հայտարարեց 5.0-ի հետ միասին։ Նոր հնարավորությունների գնահատումը պետք է առանձնացնել չսպասարկվող ճյուղից դուրս գալու որոշումից։
Միգրացիան պլանավորեք աջակցվող 4.x թողարկման միջոցով՝ մինչև 5.0-ին անցնելը։ Apache-ը նկարագրում է 3.11-ից 4.x և 4.x-ից 5.0 որպես թարմացման ուղիներ, որոնք նախագծված և փորձարկված են առցանց կատարվելու համար։ Կոնկրետ patch տարբերակները, runtime պահանջները, դրայվերների համատեղելիությունը և SSTable քայլերը դեռ պետք է հետևեն ձեր թիրախային թողարկման թարմացման նշումներին։
Ես տարբերակի թարմացումը կանեի առանձին, սխեմայի և ինդեքսավորման փոփոխություններից անջատ, ապա թարմացված կլաստերում կհամեմատեի ներկայացուցչական հարցումներն ու շահագործման խնդիրները։ Այդպես ավելի հեշտ է հասկանալ, թե որ փոփոխությունն է ազդել վարքի վրա։
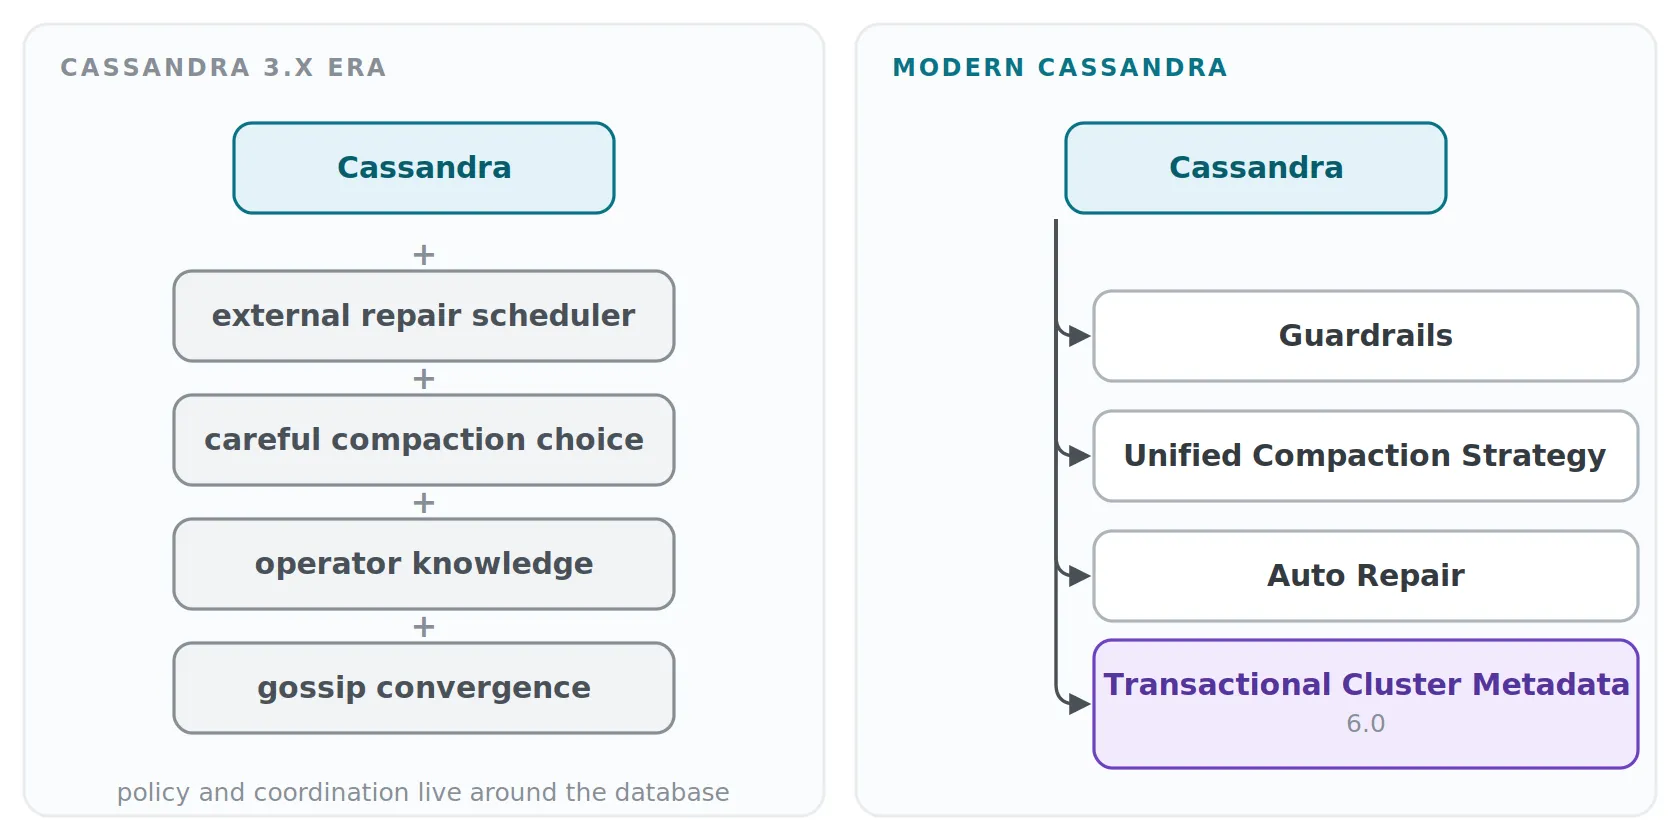
Եթե Cassandra-ի մասին ձեր պատկերացումը ձևավորվել է 3.11-ով, թարմացումը, որ արժե անել, կոնկրետ է. որոշ հարցումների այլևս լրացուցիչ աղյուսակ պետք չէ, կոմպակցիան ավելի հեշտ է կարգավորել մեկ ռազմավարության շրջանակում, և repair-ի պլանավորումը կարող է ապրել տվյալների բազայի ներսում։ 6.0-ի աշխատանքները կարող են հավելվածից վերցնել ևս մեկ բեռ՝ բաժանումների միջև տրանզակցիաների միջոցով։ Բաժանումը և աշխատանքային բեռի նախագծումը դեռ այն են, ինչ որոշում է, թե արդյոք այդ հնարավորությունները իրոք օգնում են։