ScyllaDB-ն ավելին է, քան C++-ով գրված Cassandra-ն. նայեք երկրորդ անգամ
ScyllaDB-ն սկսվել է որպես Cassandra-ի ավելի արագ վերաիրականացում։ Tablet-ները, Raft-ը, ուժեղ համակարգվածությունը և DynamoDB-ի հետ համատեղելիությունը ցույց են տալիս, թե որքան հեռու է այն գնացել այդ մոդելից։
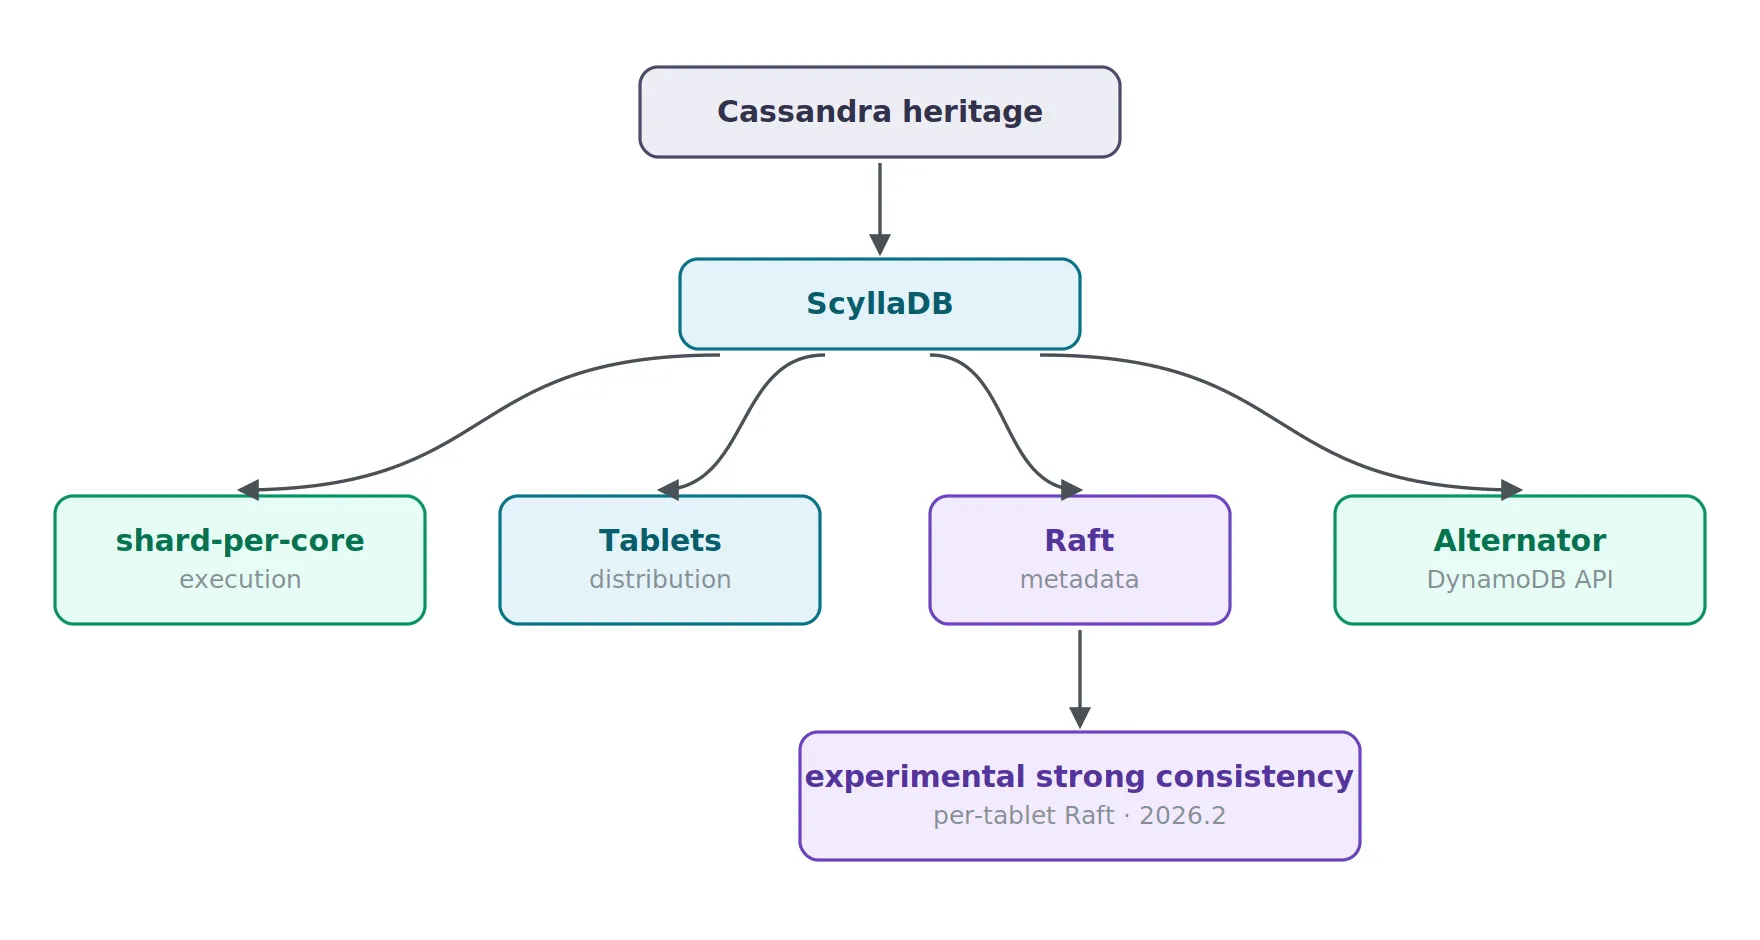
ScyllaDB-ն հաճախ ամփոփում են որպես C++-ով վերաիրականացված Cassandra։ Սկզբնական գաղափարը պարզ էր. պահպանել տվյալների մոդելը և CQL էկոհամակարգը, բայց JVM-ը փոխարինել Seastar-ով, ասինխրոն I/O-ով և shard-per-core ճարտարապետությամբ։ Արդյունավետ օգտագործել բազմամիջուկ սարքավորումը, խուսափել garbage-collection դադարներից և latency-ն պահել կանխատեսելի։
Խորհրդատվական նախագծերում թիմերը դեռ հակված են ScyllaDB-ին միգրացիան ներկայացնել որպես անցում «ավելի արագ Cassandra-ի»։ Սակայն տվյալների տեղաբաշխումը, կլաստերի կառավարումը և նույնիսկ պահպանման շարժիչը բոլորը զարգանում են.
| Ինչպես էր ընկալվում ScyllaDB-ն | ScyllaDB-ն հիմա |
|---|---|
| Cassandra-ի հետ համատեղելի տվյալների բազա՝ այլ իրականացմամբ | Գնալով ավելի շատ՝ սեփական տվյալների բազայի ճարտարապետություն |
| Տվյալները բաշխվում են vNode-երով և token ring-ով | Tablet-ները դինամիկ կերպով բաշխում են առանձին աղյուսակները |
| Սխեման և տոպոլոգիան համակարգվում են Gossip-ի միջոցով | Raft-ը կարգավորում է սխեմայի և տոպոլոգիայի փոփոխությունները |
| Կարգավորելի eventual consistency՝ LWT-ի հետ միասին | Փորձարարական per-tablet Raft-ը ավելացնում է ուժեղ համակարգվածություն օգտատիրոջ տվյալների համար |
| Հիմնականում CQL/Cassandra էկոհամակարգ | CQL գումարած DynamoDB-ի հետ համատեղելի լայն API |
| ScyllaDB Open Source՝ AGPL լիցենզիայով | Տվյալների բազայի հիմնական թողարկումներն այժմ source-available են |
Հետևյալ թողարկումների ակնարկը հասնում է մինչև ScyllaDB 2026.2, որում Strongly Consistent Tables-ը և vNode-ից Tablet-ի online միգրացիան փորձարարական են։ Logstor-ը դիտարկվում է առանձին՝ որպես դեռ մշակման մեջ գտնվող աշխատանք։
Առաջին տարբերությունը մեկ հանգույցի ներսում էր
Cassandra-ն և վաղ ScyllaDB-ն հավասարապես բաշխում էին տվյալները հանգույցների միջև token ring-ով։ ScyllaDB-ն լրացուցիչ ներմուծեց sharding յուրաքանչյուր հանգույցի ներսում՝ հենվելով Seastar-ի shard-per-core ճարտարապետության վրա։
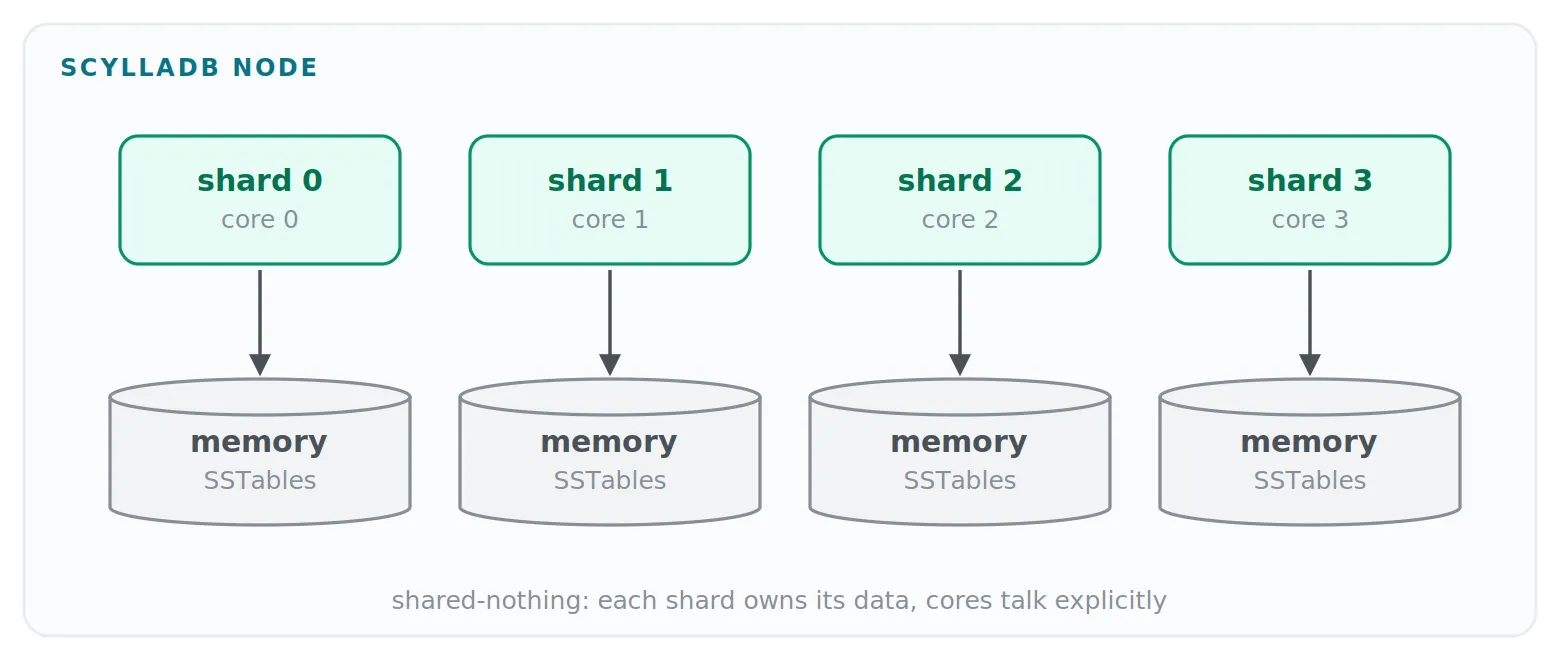
Shard-ը ScyllaDB-ի այն մասն է, որն աշխատում է մեկ CPU միջուկի վրա և ունի իր սեփական տվյալներն ու ռեսուրսները։ Այն սպասարկում է բազմաթիվ CQL partition-ներ, որոնցից յուրաքանչյուրը խմբավորում է նույն partition key ունեցող տողերը։ Shard-երը խոսում են միմյանց հետ բացահայտ կերպով, ուստի աշխատանքի մեծ մասը մնում է տեղային միջուկի վրա։ Ավելի մանրամասն՝ ScyllaDB-ի shard-per-core ակնարկում։
Shard-aware դրայվերները հարցումները ուղարկում են անմիջապես այն միջուկին, որին պատկանում են տվյալները՝ խնայելով միջուկների միջև լրացուցիչ անցումը։ Tablet-aware դրայվերները լրացուցիչ կերպով պարզում են, թե որտեղ են գտնվում tablet-ները, սերվերի հետ ուղարկվող routing տեղեկատվությունից, և թարմացնում են իրենց քեշերը, երբ տեղաբաշխումը փոխվում է։ Ավելի հին shard-aware դրայվերները շարունակում են աշխատել, թեև նրանց routing-ը պակաս արդյունավետ է։
Tablet-ների դեպքում տվյալների տեղաբաշխումը սահմանվում է աղյուսակի մակարդակով
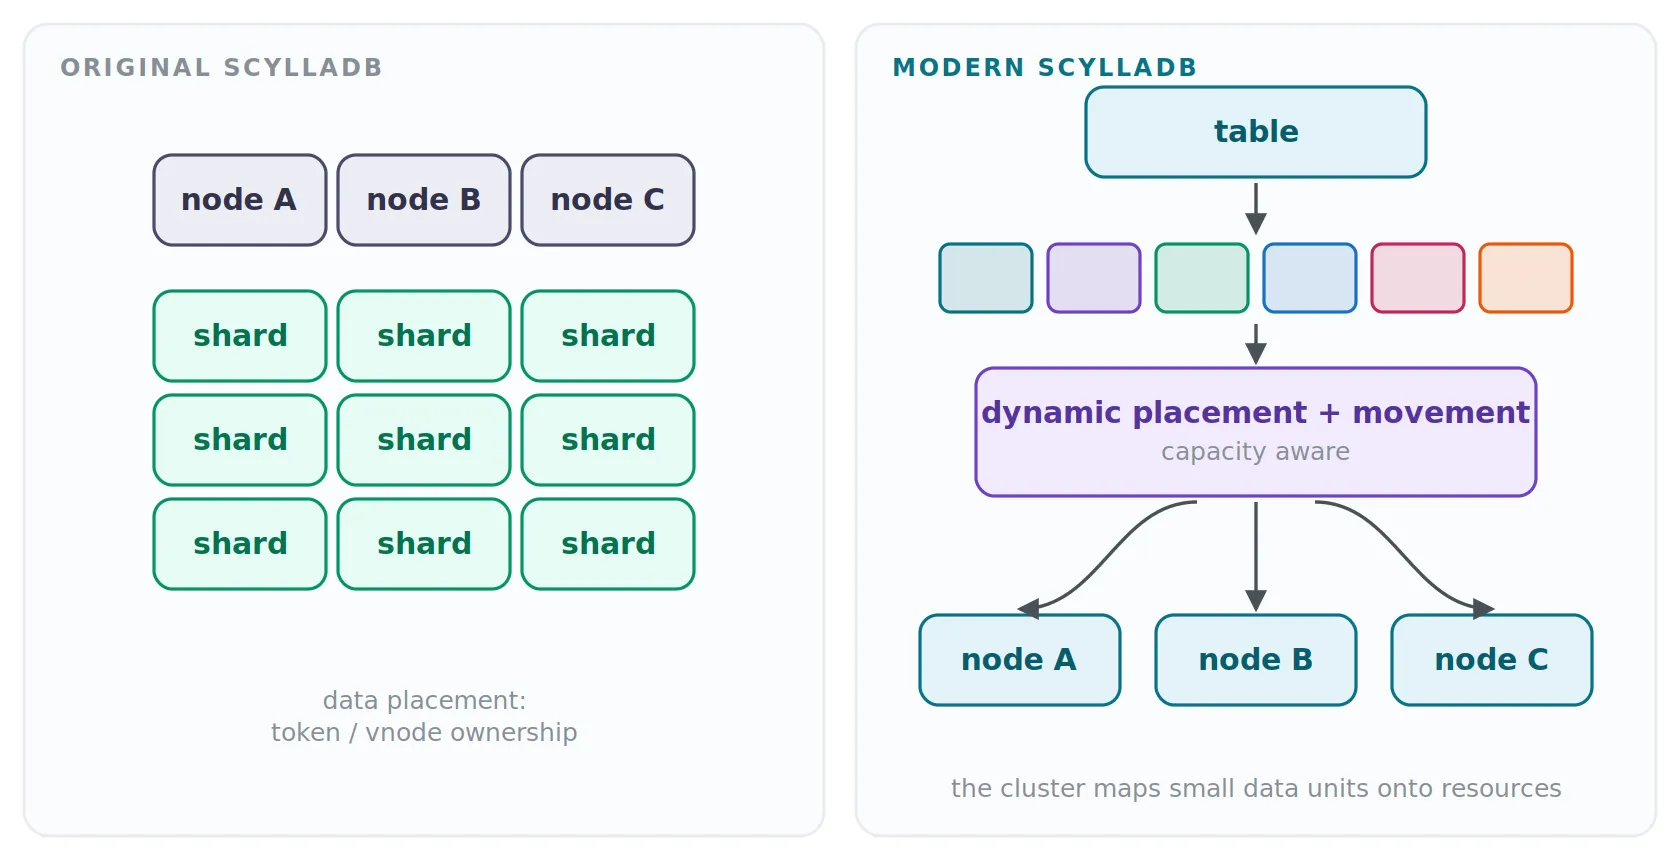
vNode-երի դեպքում partition key-ը hash է արվում token-ի, և տեղաբաշխումը բխում է նրանից, թե կլաստերում որ հանգույցն է տիրապետում այդ token-ին։ Յուրաքանչյուր ֆիզիկական հանգույց տիրապետում է մի քանի միջակայքերի։ Բոլոր աղյուսակները կիսում են այս սեփականության քարտեզը, իսկ replication-ի կարգավորումները որոշում են, թե որտեղ են գնում replica-ները։
Tablet-ը ներկայացնում է մեկ աղյուսակի token միջակայք։ Նրա replica-ները գտնվում են կոնկրետ հանգույցների և shard-երի վրա։ Յուրաքանչյուր աղյուսակ կարող է token տարածությունը բաժանել իր սեփական եղանակով, և մեկ shard-ը կարող է հյուրընկալել բազմաթիվ tablet replica-ներ։
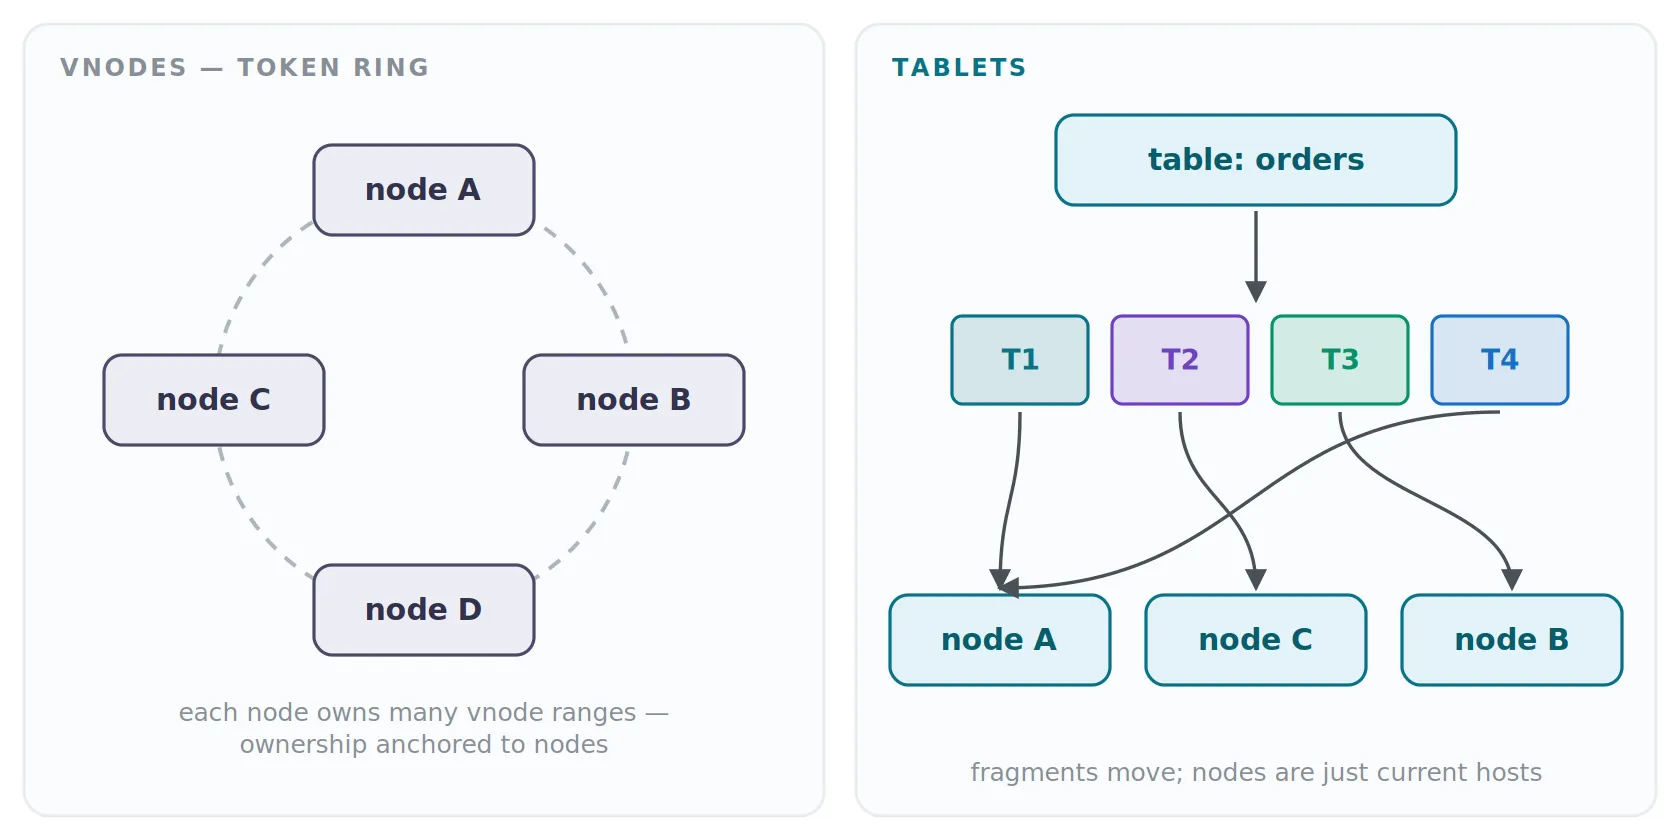
Ենթադրենք՝ events աղյուսակը պարունակում է մի քանի տերաբայթ, իսկ customers աղյուսակը՝ ընդամենը մի քանի գիգաբայթ։ Պատճառ չկա, որ երկուսն էլ բաշխվեն նույն մանրությամբ։ Երբ events-ը մեծանում է, նրա tablet-ները կարող են բաժանվել, և նոր tablet-ները կարելի է տեղափոխել անկախ կերպով, մինչդեռ ավելի փոքր աղյուսակը կարող է մնալ ավելի քիչ tablet-ներով։
Balancer-ը կարող է tablet replica-ն տեղափոխել այլ հանգույց կամ նույն հանգույցի այլ shard։ Բաժանման և միավորման շնորհիվ տվյալների բազան կարող է կարգավորել իր կառավարած միավորների չափը։ Token միջակայքերը դեռ կան. պարզապես սեփականությունն այժմ կառավարվում է աղյուսակի մակարդակով։
Մեկ էական սահմանափակում մնում է. յուրաքանչյուր CQL partition գտնվում է հենց մեկ tablet-ում։ Tablet-ի բաժանումը բաժանում է partition-ների միջակայքը, այլ ոչ թե այն, ինչ գտնվում է մեկ partition-ի ներսում։ Այսպիսով, վատ ընտրված partition key-ը դեռ կարող է հանգեցնել տաքացած (hot) կամ չափազանց մեծ partition-ի։ Tablet-ները տվյալների բազային տալիս են ավելի շատ ազատություն տվյալների տեղաբաշխման մեջ, բայց նրանք այդ մեկ partition-ը առանձին tablet-ների վրա ձեր փոխարեն չեն բաշխի։
Ի՞նչ է լինում, երբ ավելացնում եք հզորություն
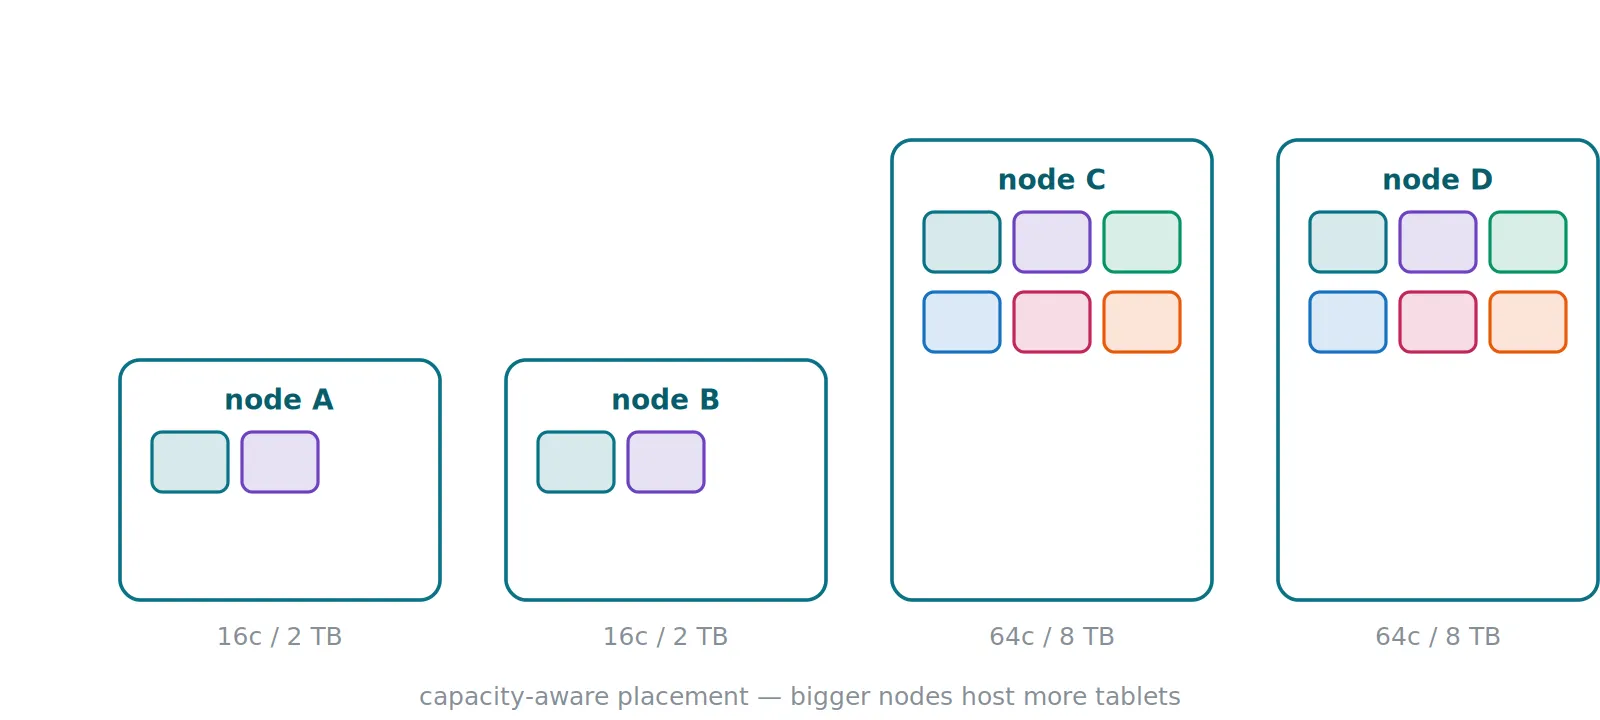
Պատկերացրեք՝ սարքավորման թարմացման շրջանակում ավելի մեծ մեքենա եք ավելացնում։ vNode տեղաբաշխման դեպքում token-ի հատկացումը պետք է նրան տա տվյալների համապատասխան մասնաբաժինը։ Tablet-ների դեպքում balancer-ը կարող է առանձին tablet replica-ներ տեղափոխել դրա վրա և շարունակել ճշգրտել տեղաբաշխումը, քանի որ կլաստերը զարգանում է։
2026.1-ում ներդրված capacity-aware հավասարակշռումը հաշվի է առնում tablet-ների չափերը և հանգույցի հզորությունը՝ անհավասար սկավառակի օգտագործումը լուծելու համար, երբ մի հանգույցի տեղը վերջանում է, իսկ մյուսներն ունեն դեռ ազատ տեղ։
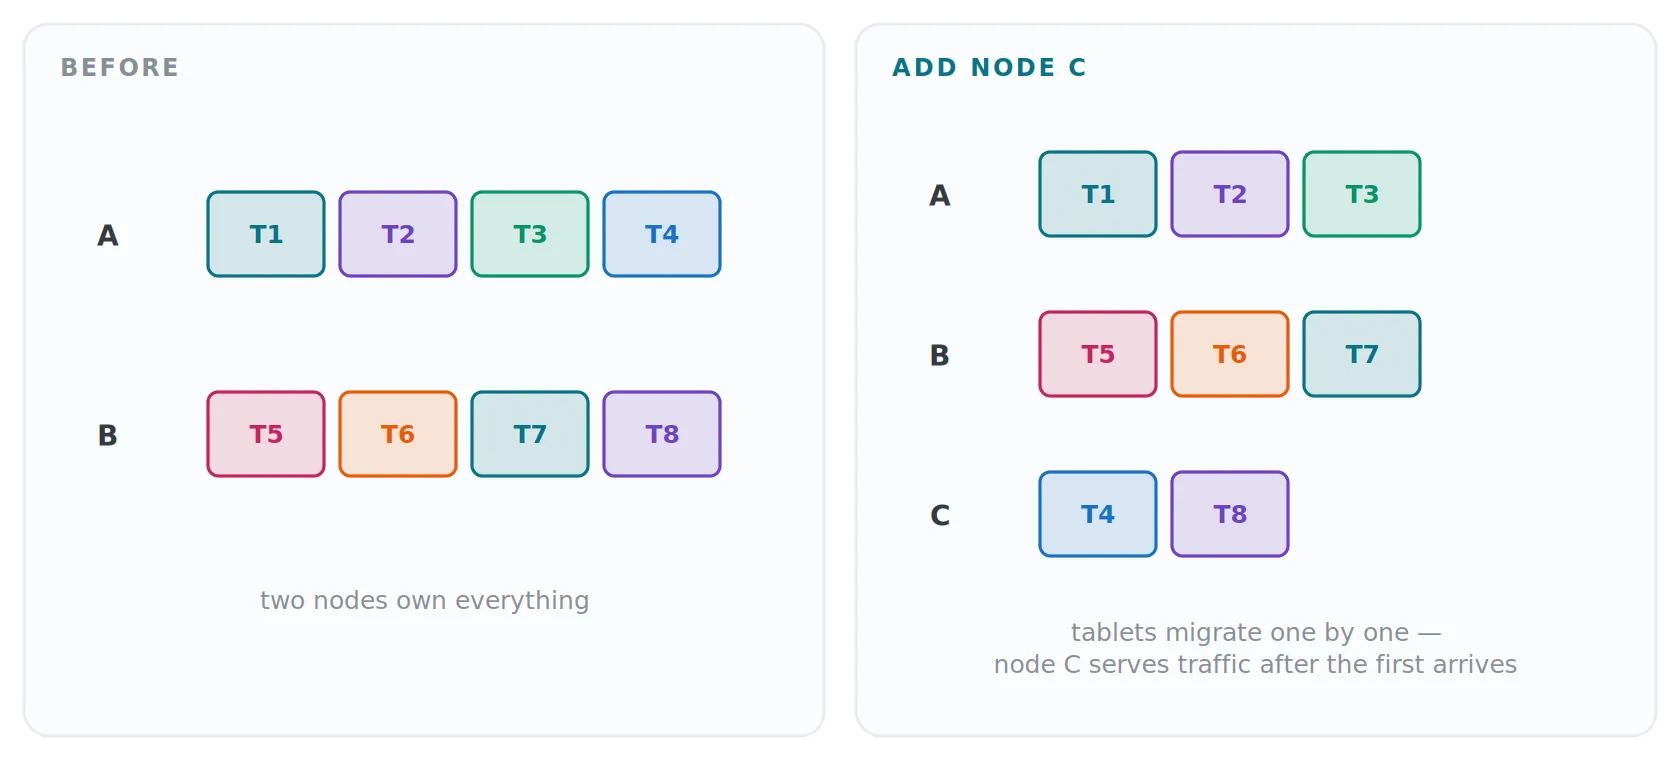
Խառը սարքավորմամբ աշխատելն ավելի իրատեսական է դառնում, բայց «capacity-aware» չի նշանակում, որ յուրաքանչյուր ռեսուրս հավասարաչափ օգտագործվում է։ Սկավառակի տարածքը, CPU-ի հզորությունը և հարցումների տրաֆիկը առանձին սահմանափակումներ են։ Շատ ազատ սկավառակ ունեցող հանգույցը կարող է արդեն զբաղված լինել հանրաճանաչ partition սպասարկելով։ Ես դեռ կչափեի իրական workload-ը՝ նախքան ենթադրելը, թե սարքավորման թարմացումը համաչափ շահումներ կբերի։
Tablet-ների միգրացիան նույնպես հենվում է ֆայլերի վրա հիմնված streaming-ի վրա։ SSTable-ները որպես ֆայլեր տեղափոխելը խնայում է նրանց բովանդակությունը վերահավասարակշռման ժամանակ ապակոդավորելու և վերակոդավորելու ջանքի մի մասը։
Tablet-ները հասուն են, բայց միգրացիան դեռ զգուշություն է պահանջում
Դրանք ներդրվել են մի քանի թողարկումների ընթացքում.
| Թողարկում | Ինչ փոխվեց |
|---|---|
| 6.0, 2024 թվականի հունիս | Tablet-ները լռելյայն միացված են նոր կլաստերների համար՝ ուժեղ համակարգված տոպոլոգիայի թարմացումների հետ միասին. աջակցություն տարբեր միջուկների քանակի համար։ |
| 2024.2 | Tablet-ները հասան Enterprise գծին։ Մի շարք հնարավորություններ դեռ պահանջում էին vNode-եր։ |
| 2025.1 | Tablet-ների միավորում (merge) և ֆայլերի վրա հիմնված streaming՝ առաջին միասնական արտադրանքի թողարկման մեջ։ |
| 2026.1 | Աջակցություն counter-ների և capacity-aware հավասարակշռման համար։ Ըստ թողարկման նշումների՝ tablet-ները հնարավորություններով այլևս չեն զիջում vNode-երին։ |
| 2026.2 | Online միգրացիա vNode-երից tablet-ների՝ որպես փորձարարական հնարավորություն։ |
Այս վերջին կետը կարևոր է գործող տեղակայումների համար։ Այն, որ նոր կլաստերները լռելյայն ստանում են tablet-ներ, չի նշանակում, որ թարմացումը յուրաքանչյուր գոյություն ունեցող vNode-ի վրա հիմնված աղյուսակ դարձնում է tablet-ների վրա հիմնված։ Արժե առանձին ստուգել, թե ինչպես են տեղաբաշխված ձեր ընթացիկ աղյուսակները և որ միգրացիայի ընթացակարգն է աջակցվում։
Raft-ը կարգ է բերում սխեմայի և տոպոլոգիայի փոփոխություններին
Gossip-ը լավ է աշխատում այն տարածելու համար, ինչ հանգույցները նկատում են միմյանց մասին։ Սակայն միաժամանակյա սխեմայի փոփոխությունները ավելի խիստ բան են պահանջում. կոնսենսուս այն մասին, թե որ փոփոխությունն է առաջինը։
ScyllaDB-ի Raft փաստաթղթերը բացատրում են, թե ինչպես էր սխեմայի հին մեխանիզմը կարող փոփոխություններ կորցնել, երբ հանգույցները հակասող թարմացումները լուծում էին timestamp-ով։ Raft-ի վրա հիմնված սխեմայի կառավարումը, որը 5.2-ում լռելյայն միացվեց նոր կլաստերների համար, այս գործողությունները անցկացնում է կոնսենսուսի log-ի միջոցով։
Հաջորդը եղավ տոպոլոգիայի կառավարումը։ Bootstrap-ը, decommission-ը, հանգույցի հեռացումը և փոխարինումը այժմ աշխատում են կլաստերին ովքեր են պատկանում՝ համաձայնեցված պատկերի վրա։ Տվյալների բազան համակարգում է դրանց հերթականությունը և ընթացքը, ինչը հնարավոր է դարձնում այնպիսի գործողություններ, ինչպիսին է մի քանի հանգույցի միաժամանակ ավելացումը։ Համակարգված տոպոլոգիայի փոփոխությունները պարտադիր դարձան 2025.2-ում։
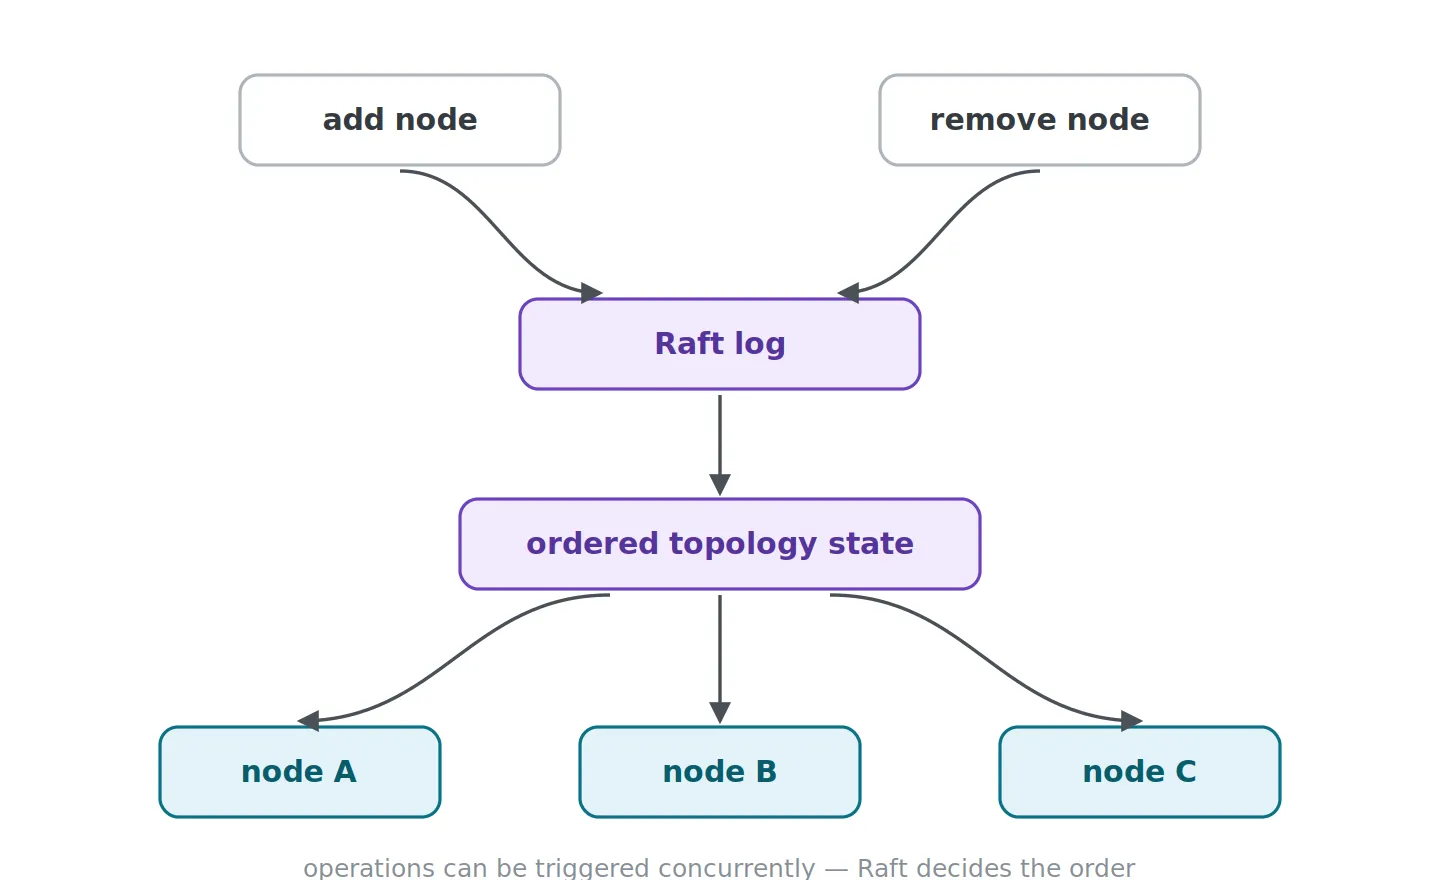
Սա ազդում է այն բանի վրա, թե ինչպես են ընթանում խափանումները։ Եթե կորչում է մետատվյալների Raft quorum-ը, սխեմայի և տոպոլոգիայի փոփոխությունները կարող են արգելափակվել։ Սովորական read-երը և write-երը կարող են շարունակվել, քանի դեռ անհրաժեշտ տվյալների replica-ները հասանելի են և պահանջվող համակարգվածության մակարդակը կարող է բավարարվել։ Սակայն դա չի երաշխավորում, որ հավելվածի տրաֆիկը անձեռնմխելի է մետատվյալների quorum-ի խափանումից. նույն խափանված հանգույցները կամ ցանցի բաժանումը կարող են նաև տվյալները անհասանելի դարձնել։
Gossip-ը դեռ օգտագործվում է հանգույցի վիճակը տարածելու համար։ Raft-ը պատասխանատու է այն մետատվյալների համար, որոնք պահանջում են համաձայնեցված հերթականություն։ Cassandra-ի Transactional Cluster Metadata առաջարկը լուծում է հարակից խնդիր, ուստի սա ևս մեկ ոլորտ է, որտեղ Cassandra-ի հին թողարկման հետ համեմատելը կարող է սխալ ուղու վրա դնել։ Երկու նախագծերն էլ վերամշակել են կլաստերի կառավարումը։
Օգտատիրոջ տվյալների համար Raft-ը առանձին քայլ է
Սխեման Raft-ով անցկացնելը սովորական աղյուսակային գործողությունները ուժեղ համակարգված չի դարձնում։ Դրանք դեռ հենվում են հայտնի համակարգվածության մակարդակների վրա, ինչպիսիք են ONE, QUORUM և LOCAL_QUORUM։ Պայմանական write-երն անցնում են Lightweight Transactions-ով, որոնք կառուցված են Paxos-ի վրա։
2026.2-ի փորձարարական Strongly Consistent Tables հնարավորությունը Raft-ը մտցնում է օգտատիրոջ տվյալների ուղու մեջ՝ յուրաքանչյուր tablet-ի համար մեկ Raft խմբով։ Tablet-ները այստեղ բնական սահման են կազմում. տվյալների բազան արդեն գիտի, թե որ replica-ներն են պահում տվյալների յուրաքանչյուր միավորը, և առանձին խմբերը կարող են համակարգվել ինքնուրույն։
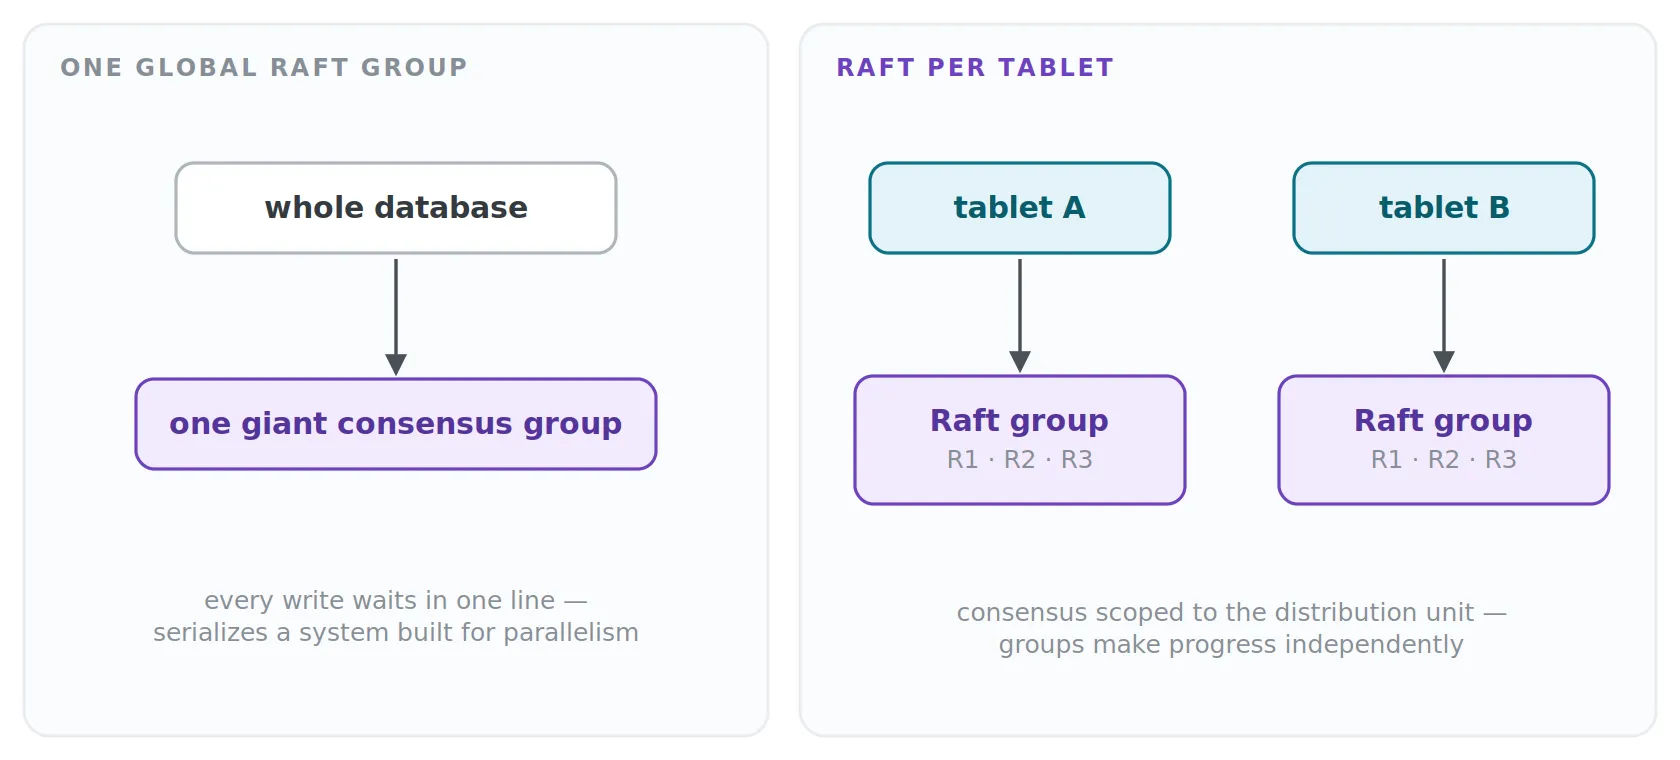
Փորձարարական երաշխիքը վերաբերում է նույն partition-ը թիրախավորող հարցումներին։ Բազմաբանալի transaction-ները դեռ ավելի երկարաժամկետ նպատակ են։
Raft-ով ապահովված write-երը պահանջում են համաձայնություն իրենց replication խմբի ներսում, ուստի դրանց վրա անմիջապես ազդում են replica-ների տեղաբաշխումը, ցանցի latency-ն և quorum-ի հասանելիությունը։ Մետատվյալների Raft-ը և per-tablet Raft-ը ծառայում են տարբեր նպատակների և ունեն տարբեր quorum պահանջներ։
Alternator-ը ScyllaDB-ին ավելացնում է երկրորդ API
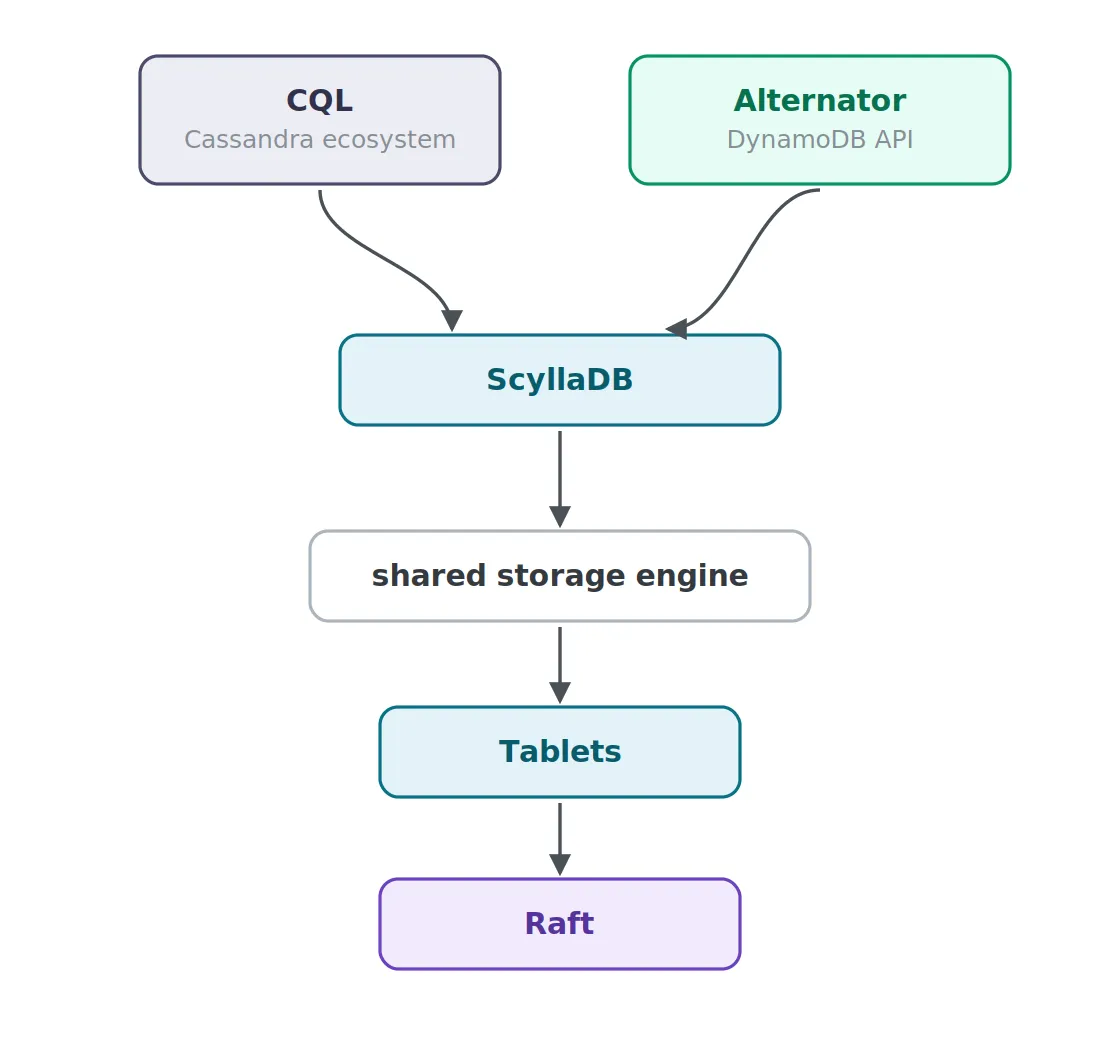
Cassandra-ի հետ համատեղելիությունն այլևս ScyllaDB-ի հավելվածներին առաջարկած միակ ինտերֆեյսը չէ։ Alternator-ը տրամադրում է DynamoDB-ի հետ համատեղելի API, որն իրականացված է անմիջապես ScyllaDB-ի պահոցի վրա։ DynamoDB-ի hash key-ը համապատասխանում է partition key-ին, իսկ ընտրովի sort key-ը՝ clustering key-ին։
Սա ScyllaDB-ին բերում է միգրացիայի մասին այլ տեսակի զրույցի մեջ։ DynamoDB-ի վրա գտնվող թիմը կարող է ցանկանալ իր հավելվածի API-ն անփոփոխ պահել՝ փոխելով այն, թե որտեղ է աշխատում տվյալների բազան և ինչպես է շահագործվում։
Համատեղելիությունը պետք է ստուգվի PutItem-ից և GetItem-ից դուրս։ Հավելվածները նաև հենվում են index-ների, պայմանական գործողությունների, stream-ների և իրենց SDK-ների վարքագծի վրա։ Հարցման հիմնական ձևաչափը ճիշտ ստանալը միգրացիայի միայն մեկ մասն է։
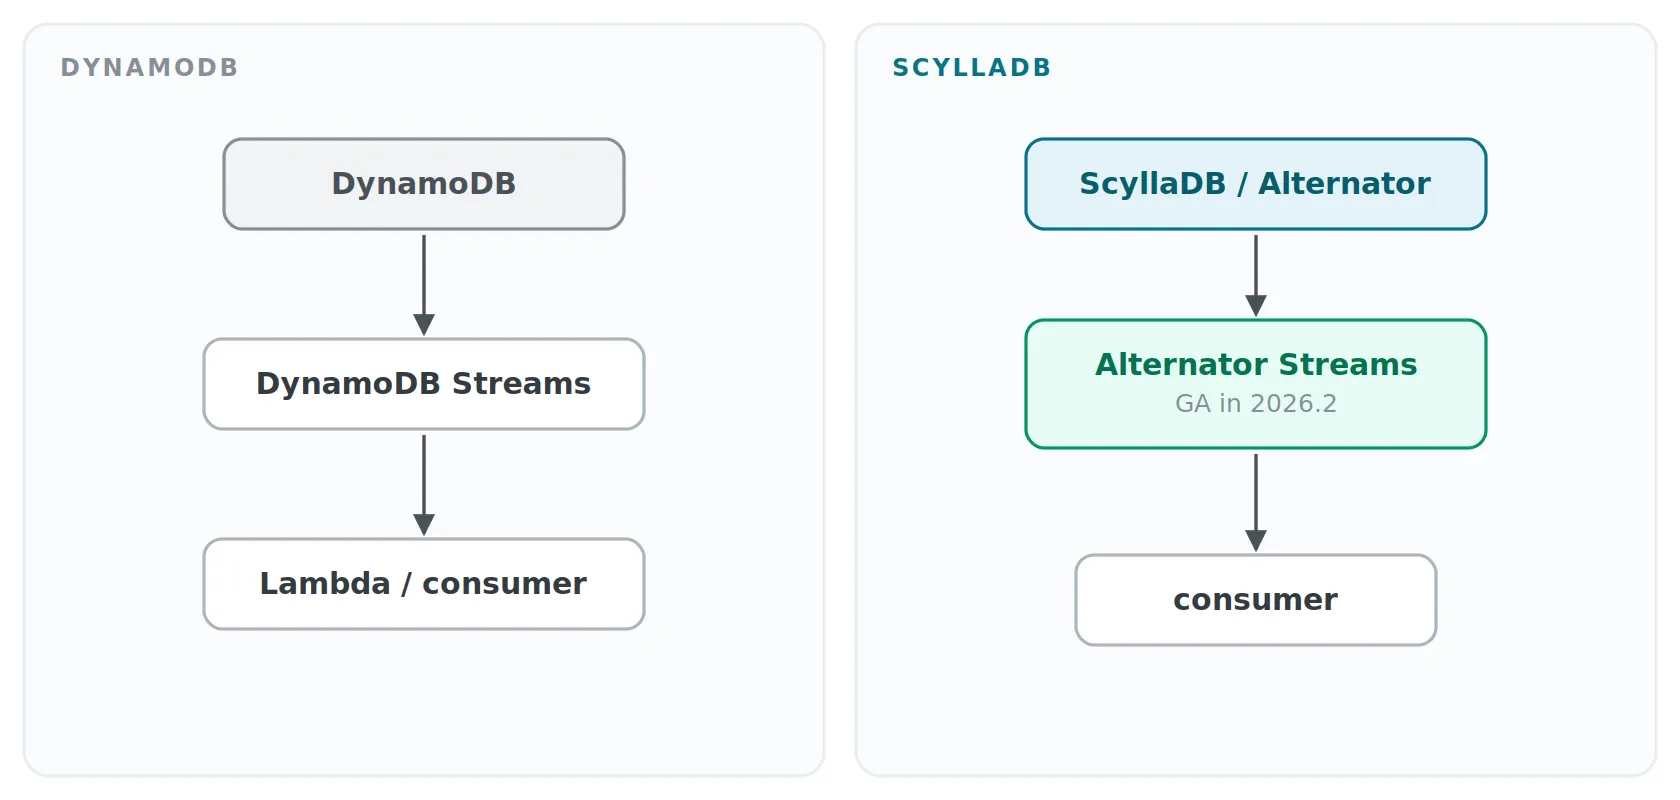
2026.2-ում Alternator Streams-ը հասավ general availability-ի։ Նրանք բացահայտում են item մակարդակի փոփոխությունները հերթականությամբ, ինչը աջակցում է թարմացումներին արձագանքող հավելվածներին։ Սա չպետք է դիտարկել որպես աղյուսակի մասշտաբով գլոբալ հերթականության երաշխիք կամ որպես սպառողների համար end-to-end exactly-once երաշխիք։ Նույն թողարկումը նաև ընդլայնեց DynamoDB-ի հետ համատեղելի API-ն vector search-ով, որը հասանելի է ScyllaDB Cloud-ի միջոցով։
Alternator-ի աղյուսակները նույնպես կարող են օգտագործել tablet-ներ՝ հենվելով տեղաբաշխման և միգրացիայի նույն մեխանիզմի վրա, ինչ CQL աղյուսակները։
Repair-ը դառնում է տվյալների բազայի մաս
Replica-ները դեռ պետք է վերանորոգվեն (repair)։ Tablet-ները և Raft-ով կառավարվող տոպոլոգիան չեն վերացնում այս կարիքը սովորական replicated աղյուսակների համար։
ScyllaDB Manager-ով իրականացվող repair-ից բացի, ScyllaDB-ն առաջարկում է ներկառուցված ավտոմատ repair tablet աղյուսակների համար։ Աստիճանական (incremental) repair-ը նույնպես կապված է tablet ճարտարապետության հետ։
Տվյալների բազան կարող է repair պլանավորել այն միավորների շուրջ, որոնք արդեն հետևում է տեղաբաշխման համար։ Պարզեք, թե որ աղյուսակներն են օգտագործում tablet-ներ, ինչ repair կարգավորումներ ունեն դրանք և ինչպես եք հետևելու ավարտին ու խափանումներին։
Logstor-ը փորձարկում է այլ պահպանման շարժիչ
Logstor-ը փորձարարական key-value backend է, որը գրառումներ է կցում log սեգմենտներին և պահպանում է դրանց գտնվելու վայրի in-memory index։ Compaction-ը կենդանի գրառումները տեղափոխում է այլ տեղ, որպեսզի հին սեգմենտներում տարածքը կարողանա վերականգնվել։ Սա memtable-ներից և SSTable-ներից տարբերվող պահպանման ուղի է, և index-ի օգտագործած հիշողությունը դրա արժեքի մի մասն է։
Այստեղ դիտարկված development snapshot-ը, որը նկարագրված է նաև DeepWiki-ում, պահանջում է փորձարարական feature flag. սա պնդում չէ, թե այն հասանելի է 2026.2-ում։ Ես աչալուրջ կհետևեի դրան այն workload-ների համար, որոնք հիմնականում փոխարինում են արժեքները և փնտրում դրանք key-ով։ Արդյոք այն կստացվի արժանի այլընտրանք՝ կախված է նրանից, թե որ գործողություններն է աջակցում և ինչպես է իրեն պահում չափման դեպքում։
Տվյալների մոդելի սահմանափակումները ծանոթներն են
CQL-ը, partition key-երը, clustering key-երը, replication factor-ները, memtable-ները և SSTable-ները դեռ ScyllaDB-ի հիմքում են։ Cassandra-ն շահագործելու ընթացքում ձեռք բերված գործնական գիտելիքի մեծ մասը շարունակում է արդիական մնալ։
Դուք դեռ պետք է նախագծեք partition key-երը՝ ըստ հասանելիության օրինաչափությունների, վերահսկեք partition-ի չափը, հասկանաք tombstone-ները և compaction-ը և համակարգվածության մակարդակները ընտրեք գիտակցաբար։ Ծանրաբեռնված partition-ը դեռ կարող է ճնշել shard-ը։ Ջնջումների ծանր workload-ը դեռ կարող է առաջացնել read amplification։ Հանգույցներ ավելացնելը ինքնին չի լուծի ոչ մեկ խնդիրը։
Այդ պատճառով միգրացիայի ժամանակ ես Cassandra-ի տվյալների մոդելի փորձառությունը ձեռքի տակ կպահեի՝ միաժամանակ կասկածի տակ դնելով գործառնական ենթադրությունները տեղաբաշխման, դրայվերների, տոպոլոգիայի փոփոխությունների և repair-ի վերաբերյալ։ Ծանոթ CQL-ը կարող է համակարգն ավելի ծանոթ ցույց տալ, քան այն իրականում է։
Լիցենզիան գնահատման մաս է
ScyllaDB-ի այսօրվա տվյալների բազայի թողարկումները source-available են, այլ ոչ թե AGPL open source։ ScyllaDB OSS 6.2.x-ը AGPL-ով վերջին թողարկումն էր։ 2025.1-ով ընկերությունը միավորեց իր Open Source և Enterprise հոսքերը մեկ արտադրանքի գծի մեջ։
Ըստ source-available FAQ-ի՝ անվճար օգտագործումը սահմանափակված է 10 TB ընդհանուր տրամադրված սկավառակային հզորությամբ և 50 vCPU-ով մեկ կազմակերպության համար՝ հաշված կլաստերների վրա։ Սկավառակի սահմանաչափը վերաբերում է հզորությանը, ոչ միայն պահվող հավելվածի տվյալների ծավալին։ Այս սահմանաչափերը համապատասխանության միակ չափանիշը չեն. ընթացիկ լիցենզային համաձայնագիրը նույնպես սահմանում է համապատասխանության և օգտագործման պայմաններ։
Ավելի հին AGPL թողարկումները պահպանում են իրենց լիցենզիաները։ Seastar-ը, դրայվերները և Kubernetes օպերատորը լիցենզավորված են առանձին։ Սակայն ընթացիկ տվյալների բազայի հնարավորություններն օգտագործող նոր տեղակայման համար source-available պայմանները պետք է հաշվի առնվեն որոշման մեջ առաջին իսկ օրվանից։
Ինչ կհամեմատեի հիմա
Եթե ստիպված լինեի նշել այն փոփոխությունը, որն ամենաշատն է ձևավորում ScyllaDB-ի մասին իմ մտածողությունը, կընտրեի tablet-ները։ Shard-per-core-ը որոշում է, թե ինչպես է աշխատանքը բաժանվում սերվերի ներսում։ Tablet-ները ScyllaDB-ին տալիս են ավելի մանրակրկիտ վերահսկողություն կլաստերում տեղաբաշխման վրա, ինչպես նաև մի միավոր, որի վրա կարելի է կառուցել միգրացիան, հավասարակշռումը, repair-ը և այժմ՝ փորձարարական տվյալների կոնսենսուսը։
Cassandra-ի և ScyllaDB-ի գնահատումը հետևաբար պետք է նայի կայուն վիճակի throughput-ից այն կողմ։ Ես կփորձարկեի հանգույցների ավելացումը և փոխարինումը բեռի տակ, կհետևեի latency-ին tablet-ների տեղափոխման ընթացքում, կհաստատեի client-ի routing-ը և կվերանայեի repair-ի ընթացակարգը։ Ես նաև կբաժանեի հասուն ֆունկցիոնալությունը փորձարարական հնարավորություններից՝ նախքան հնարավորությունների ցանկերը համեմատելը։
Կատարման շարժիչը դեռ կարևոր է։ Բայց կլաստերը, որը արագ է պատասխանում query-ներին, և կլաստերը, որը կարող է կանխատեսելի կերպով վերաբաշխել տվյալները, լուծում են գործառնական մարտահրավերի տարբեր ասպեկտներ։ Tablet-ները և Raft-ը երկրորդ ասպեկտը դարձնում են ScyllaDB-ի շուրջ զրույցի շատ ավելի մեծ մաս։
Ահա այն տարբերությունները, որոնք այսօր կդնեի Cassandra – ScyllaDB համեմատության մեջ.