Kafka-ն ծնվել է LinkedIn-ում։ Ի՞նչ փոխեց LinkedIn-ը, երբ Kafka-ն այլևս բավարար չէր
Հայացք LinkedIn-ի Northguard և Xinfra համակարգերին և այն մասին, թե ինչպես են դրանք վերանայում Kafka-ի տիպի լոգերի պահպանումը, ռեպլիկացիան և մետատվյալները՝ հաղթահարելու համար partition-ների հետ կապված մասշտաբավորման սահմանափակումները։
Kafka-ն ստեղծվել է LinkedIn-ում մոտ 2010 թվականին՝ որպես ծառայությունների համար տվյալներ հրապարակելու, դրանք անկախ սպառելու և անհրաժեշտության դեպքում կրկին կարդալու միջոց։ 2025 թվականին LinkedIn-ը հայտնեց, որ ամեն օր մշակում է ավելի քան 32 տրիլիոն գրառում և 17 PB տվյալ՝ տարածված 400 000 topic-ների, 10 000-ից ավելի մեքենաների և մոտ 150 կլաստերների վրա։
Այդ չափի ենթակառուցվածքը գործարկելը պահանջեց հավասարակշռման, վերականգնման և կլաստերների կառավարման հետ զբաղվող ծառայությունների աճող հավաքածու։ LinkedIn-ը պատասխանեց Northguard-ով՝ լոգերի պահպանման նոր համակարգով, և Xinfra-ով՝ վիրտուալիզացիայի շերտով, որը թույլ է տալիս հավելվածներին աշխատել և՛ Kafka-ի, և՛ Northguard-ի հետ։
Northguard-ը պահպանում է producer-ները, consumer-ները, կարգավորված լոգերը, ռեպլիկացիան և replay-ը։ Փոխվում է այն, ինչ գտնվում է մակերեսի տակ. ռեպլիկացիայի ավելի փոքր միավորներ, շարդավորված կառավարման հարթություն (control plane) և topic-ներ, որոնք կարող են տեղաշարժվել պահպանման համակարգերի միջև։
Աղբյուրների մասին. Այս հոդվածը դիտարկում է նախագծման և տեղակայման այն զեկույցը, որը LinkedIn-ը հրապարակել է 2025 թվականի հունիսին։ Այդ պահին Northguard-ը և Xinfra-ն ներքին, փակ կոդով համակարգեր էին. LinkedIn-ը InfoQ-ին ասաց, որ հետագայում կարող է դրանք բաց կոդով դարձնել։ Հոդվածը գրելիս ես որևէ հանրային թողարկում չգտա։ Արդյունքում արտադրողականության և հուսալիության մասին պնդումները գալիս են հենց LinkedIn-ից՝ առանց հանրային իրականացման, որը հնարավոր լինի անկախ ստուգել կամ բենչմարկել։ Թե ինչպես են դրանք պահպանվում այլ բեռների, սարքավորումների և Kafka կոնֆիգուրացիաների դեպքում, չի ստուգվել։
Kafka-ի partition-ները շատ պարտականություններ են կրում
Kafka partition-ը կարգավորված լոգ է, բայց այն նաև կառավարում է ռեպլիկացիան, broker-ների տեղաբաշխումը և այն, թե ինչպես են consumer-ները բաժանում աշխատանքը։ Բազմաթիվ պարտականություններ կիսում են մեկ և նույն սահմանը.
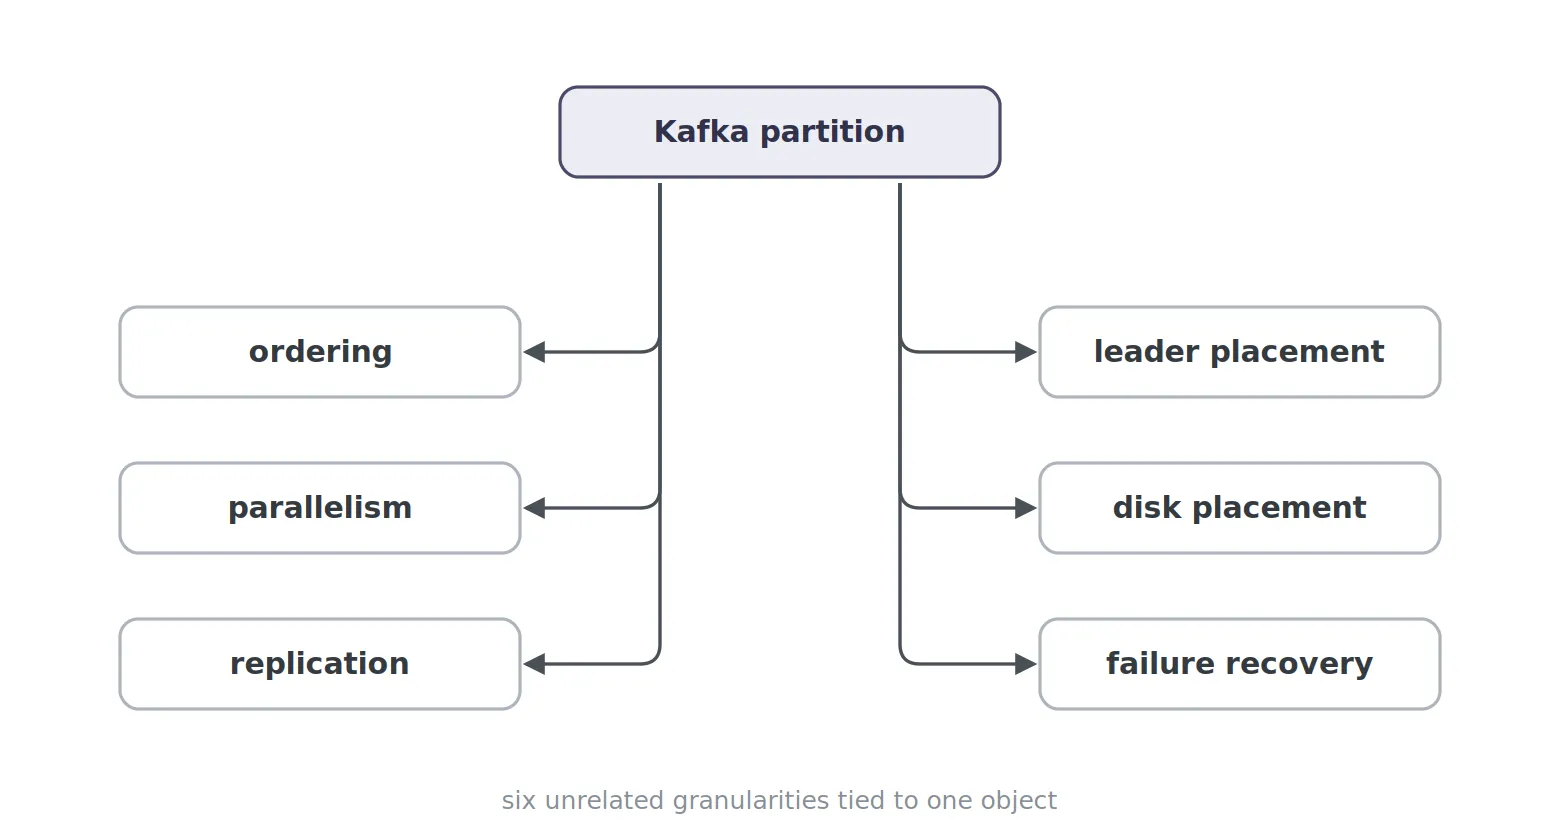
Տասներկու partition-ով topic-ը բաղկացած է տասներկու կարգավորված լոգից։ Նրանցից յուրաքանչյուրն ունի ռեպլիկաների նշանակում, leader, որն ընդունում է գրառումները, և follower-ներ, որոնք պատճենում են տվյալները։ Սովորական consumer group-ում partition-ները նաև սահմանում են, թե որքան մշակման զուգահեռություն է հասանելի։
LinkedIn-ի հոդվածը այս կապակցվածությունը նշում է որպես խնդիր իր մասշտաբում. partition-ը ռեպլիկացիայի ծանր միավոր է, ուստի մեկի տեղափոխումը կամ նորոգումը կարող է ներառել տվյալների մեծ ծավալ։
Broker ավելացնելը նշանակում է գործ ունենալ պատմության հետ
Պատկերացրեք A, B և C երեք broker-ներով կլաստեր, որը մոտենում է իր պահեստի կամ թողունակության սահմանին։ Ավելացնում ենք Broker D։ Այն սկսում է դատարկ. նրա հզորությունը գոյություն ունեցող topic-ներին հասանելի դարձնելը սովորաբար նշանակում է partition-ների որոշ ռեպլիկաների տեղափոխում.
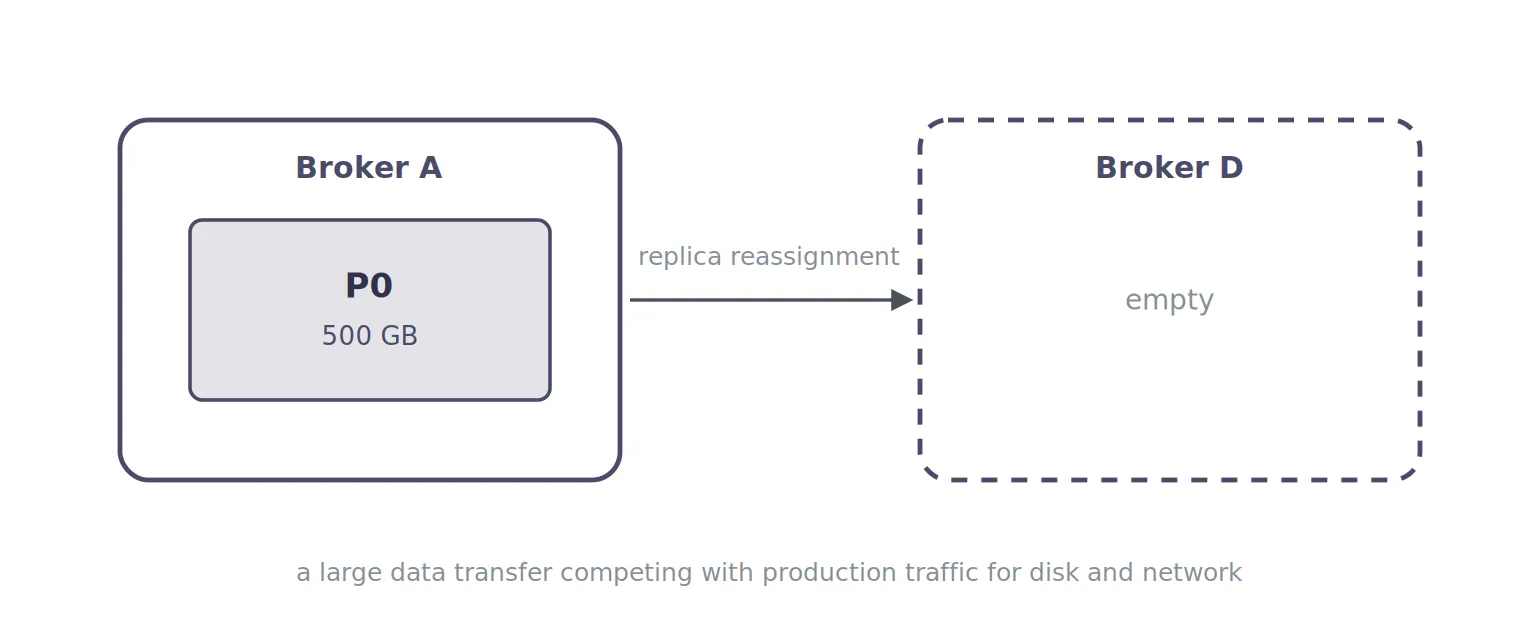
Այս փոխանցումները արտադրական տրաֆիկի հետ մրցում են ցանցի և սկավառակի թողունակության համար։ LinkedIn-ը ստեղծեց Cruise Control՝ partition-ների վերանշանակումը, կլաստերի հավասարակշռումը և ձախողումներից վերականգնումը ավտոմատացնելու համար։ Տվյալները, այնուամենայնիվ, պետք է փոխանցվեն, հաճախ սահմանափակման (throttle) տակ, որը պաշտպանում է աշխատող բեռը։
Northguard-ը փոքրացնում է յուրաքանչյուր ռեպլիկայի նշանակման հետ կապված տվյալների քանակը։
Northguard-ը լոգը անջատում է ռեպլիկացիայի միավորներից
Ընդհանուր գծերով Northguard-ի հիերարխիան այսպիսին է.
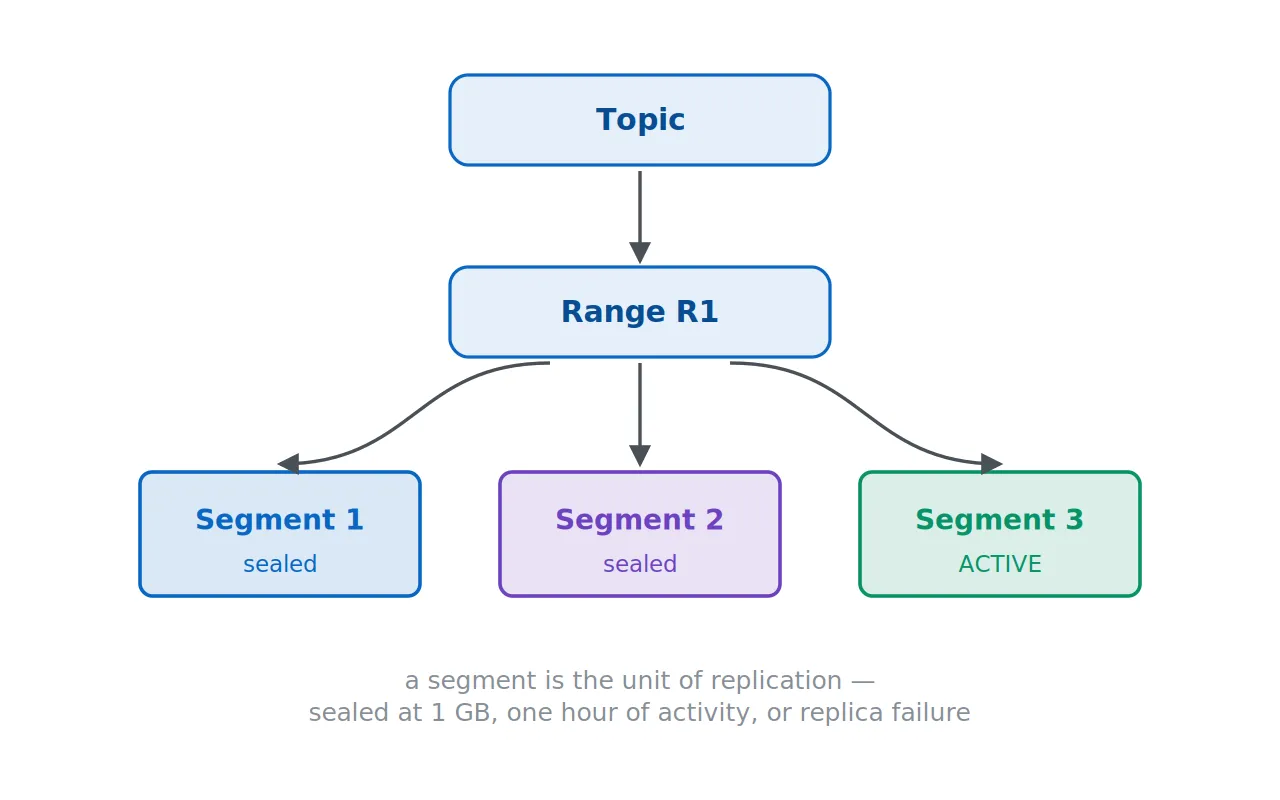
Range-ը ներկայացնում է լոգ, որն ընդգրկում է բանալիների տարածության հաջորդական մասը։ Այն կազմված է segment-ներից, որոնցից յուրաքանչյուրը պահում է գրառումների իր հաջորդականությունը։ Ակտիվ segment-ը ընդունում է գրառումներ. կնքվածը անփոփոխելի է։ Ըստ LinkedIn-ի՝ segment-ը կնքվում է, երբ հասնում է 1 GB-ի, ակտիվ է եղել մեկ ժամից ավելի կամ կորցնում է ռեպլիկա։
Ռեպլիկացիայի միավորը segment-ն է։ Kafka-ն նույնպես partition-ների լոգերը բաժանում է segment ֆայլերի, բայց այդ ֆայլերը սովորաբար հետևում են partition-ի ռեպլիկաների նշանակմանը։ Northguard-ում նույն range-ի հաջորդական segment-ները կարող են ունենալ ռեպլիկաների տարբեր հավաքածուներ.
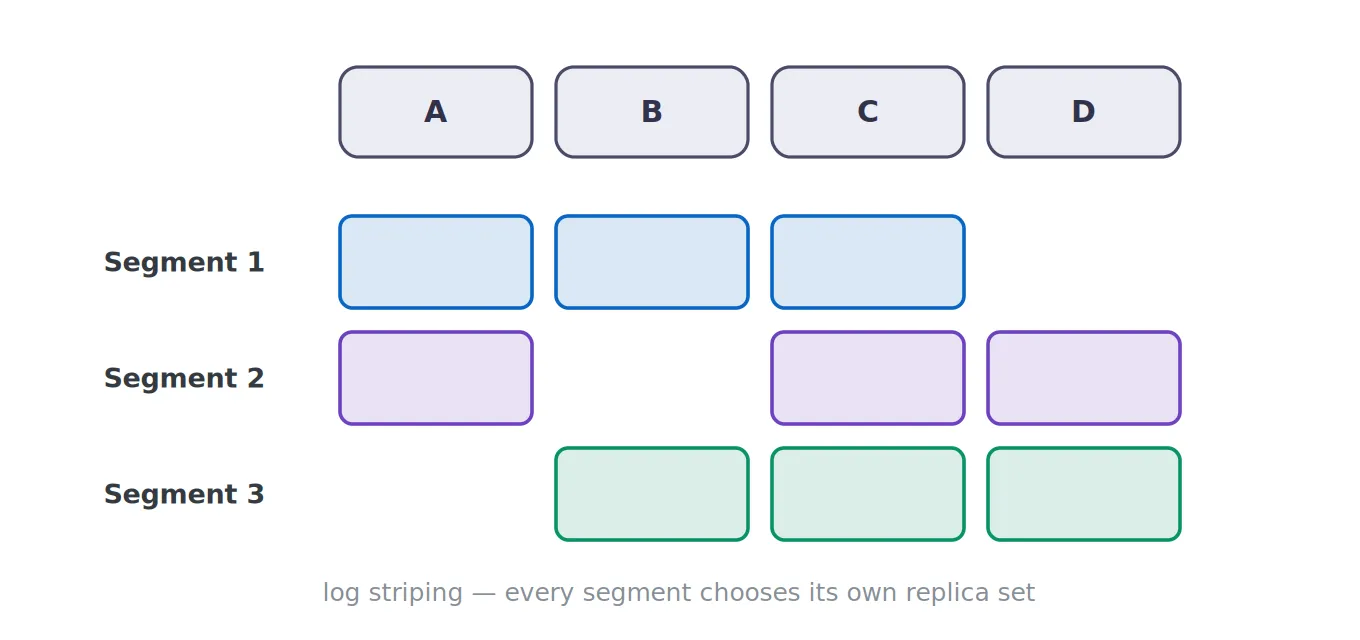
Range-ը պահպանում է տրամաբանական կարգը, իսկ նրա segment-ները տարածված են broker-ների վրա։ LinkedIn-ը սա անվանում է log striping։
Հին տվյալները թողնել իրենց տեղում
Այժմ ավելացնենք Broker E։ Northguard-ը կարող է այն դնել նոր segment-ների ռեպլիկաների հավաքածուներում.
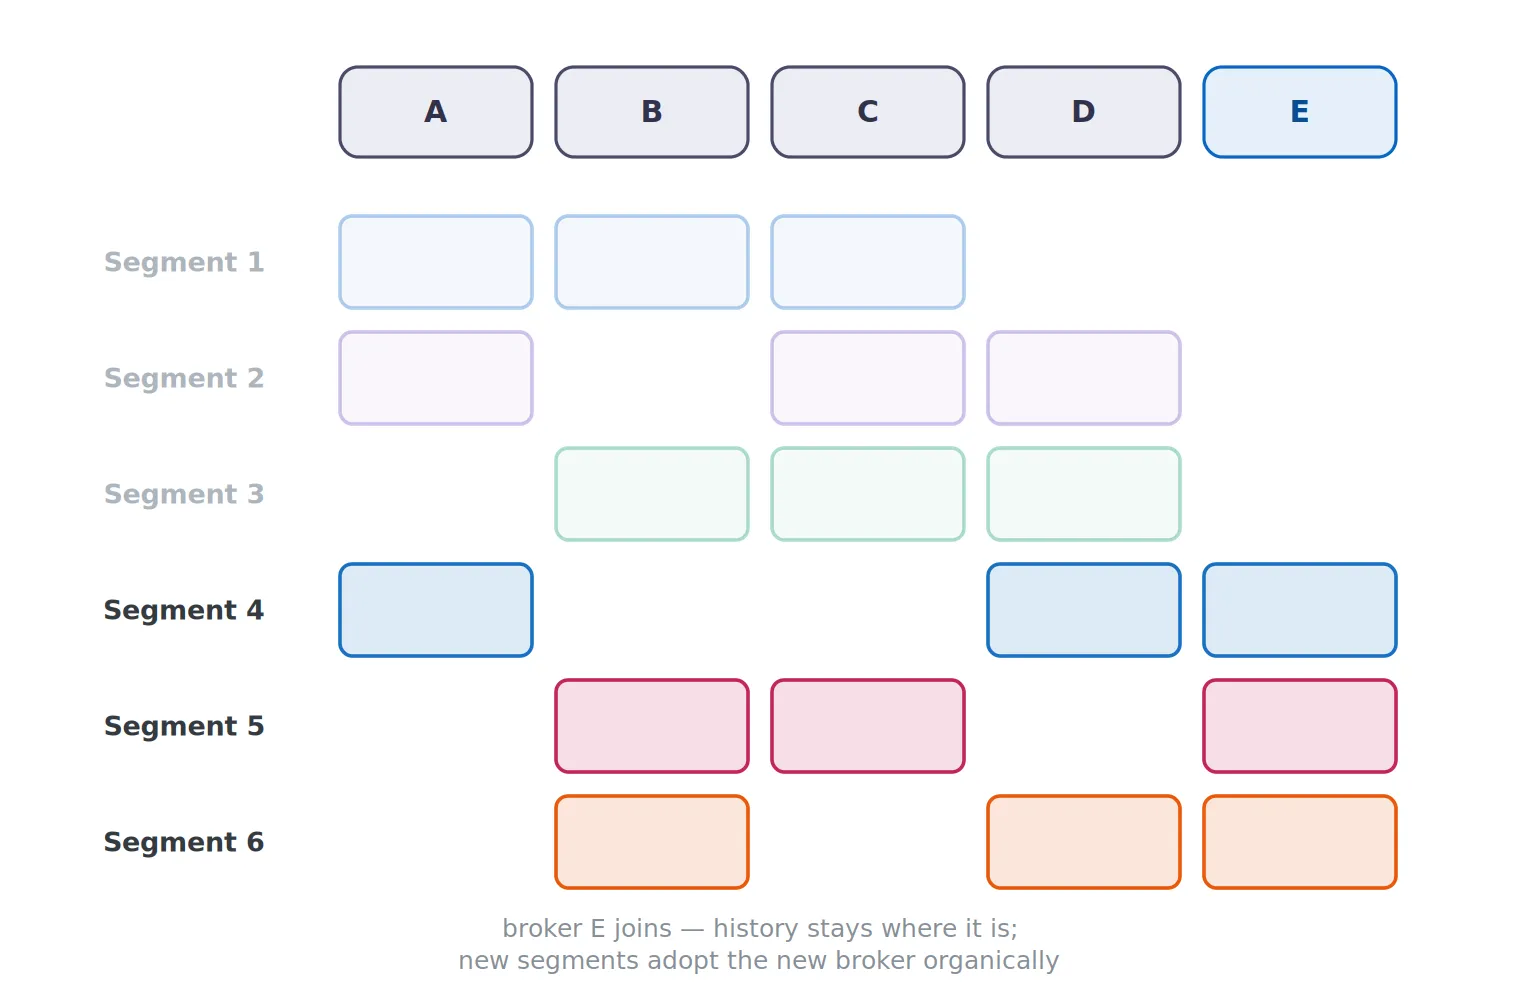
Արդեն գոյություն ունեցող segment-ները կարող են մնալ տեղում։ Երբ ստեղծվում են նոր segment-ներ, allocator-ը նոր գրառումները բաշխում է ընդլայնված կլաստերի վրա։ Այսպիսով նոր broker-ը աշխատանք է ստանում՝ առանց պատմական լոգերը նախապես իր վրա պատճենելու անհրաժեշտության։
Դա նաև allocator-ին հաճախակի հնարավորություններ է տալիս ուղղելու անհավասար տեղաբաշխումը։ Էֆեկտը կուտակվում է segment-ների փոխարինմանը զուգընթաց. broker ավելացնելը պահպանվող տվյալները միանգամից վերաբաշխում չի։ Իմ կարծիքով սա ամենարժեքավոր փոփոխությունն է. նոր հզորությունը կարող է սկսել սպասարկել նոր տրաֆիկը՝ առանց նախապես մեծ վերանշանակման աշխատանք կատարելու։
Ձախողումից վերականգնումը նույնպես այլ է
Պատկերացրեք, որ ակտիվ Segment 42-ը ռեպլիկաներ ունի A, B և C վրա, և Broker C-ն կանգնում է։ Northguard-ը կարող է այդ segment-ը կնքել և ստեղծել Segment 43՝ ռեպլիկաների թարմ հավաքածուով.
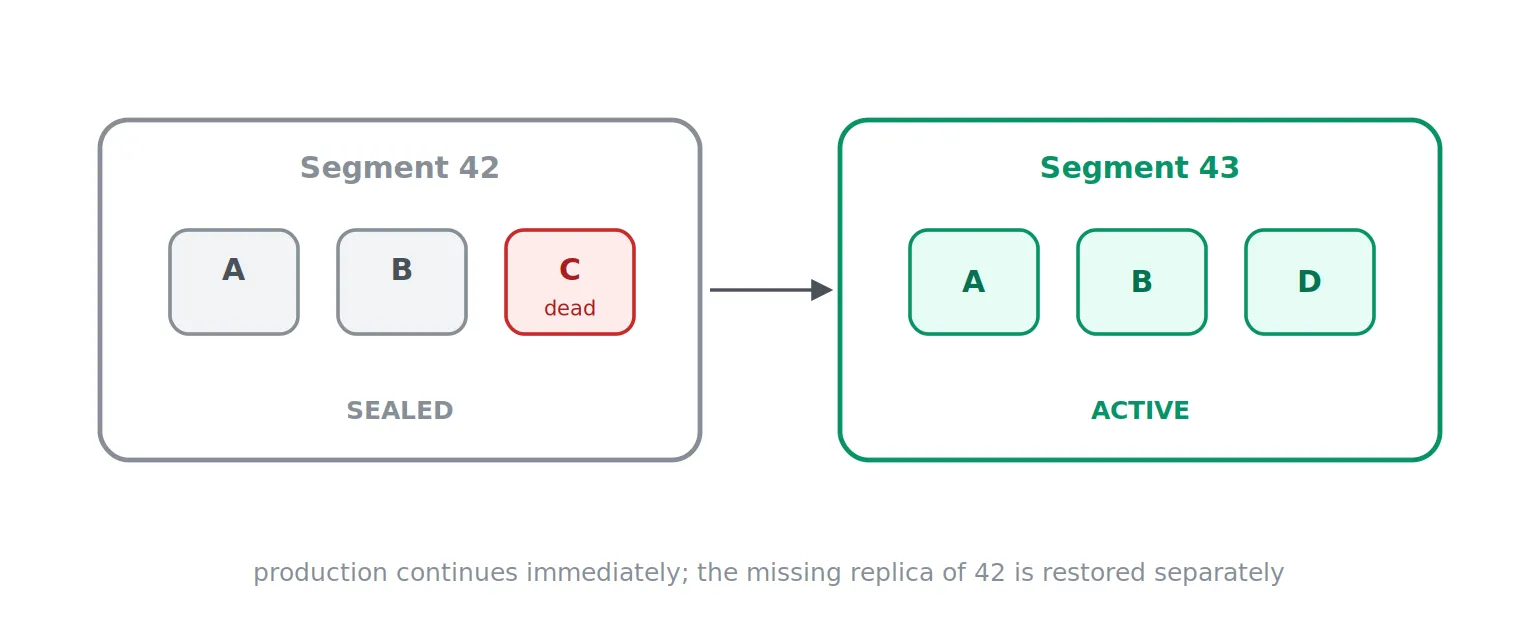
Գրառումները շարունակվում են Segment 43-ում, մինչ կնքված segment-ների ռեպլիկացիան վերակառուցում է Segment 42-ի կորցրած պատճենը։ Հին տվյալների շտկումը անջատված է նոր գրառումների տեղաբաշխումից։
LinkedIn-ը ռեպլիկացիայի այս ավելի փոքր միավորին վերագրում է produce-ը հասանելի պահելու կարողությունը՝ առանց հետևողականության փոխզիջումների, որոնք ընդունել էր իր Kafka կոնֆիգուրացիայում։ Այդ համեմատությունը վերաբերում է LinkedIn-ի սեփական տեղակայման որոշումներին. այն չի ենթադրում, թե Kafka-ն իր էությամբ ստիպում է յուրաքանչյուր անգամ broker-ի ձախողվելիս հրաժարվել հետևողականությունից։
Range-երը փոխարինում են ինդեքսավորված partition-ներին
Kafka-ում partition-ների քանակը նաև ազդում է, թե որտեղ են հայտնվում բանալիները։ hash(key) % number_of_partitions տիպի համապատասխանեցմամբ partition ավելացնելը կարող է տվյալ բանալիի հետագա գրառումները ուղղել այլ partition։ Սա հետևանքներ ունի կարգի, վիճակային մշակման և բանալիներով join-ների համար։
Northguard-ը, ի հակադրություն, բանալիների տարածությունը բաժանում է range-երի, որոնք կարող են հետագայում նորից բաժանվել.
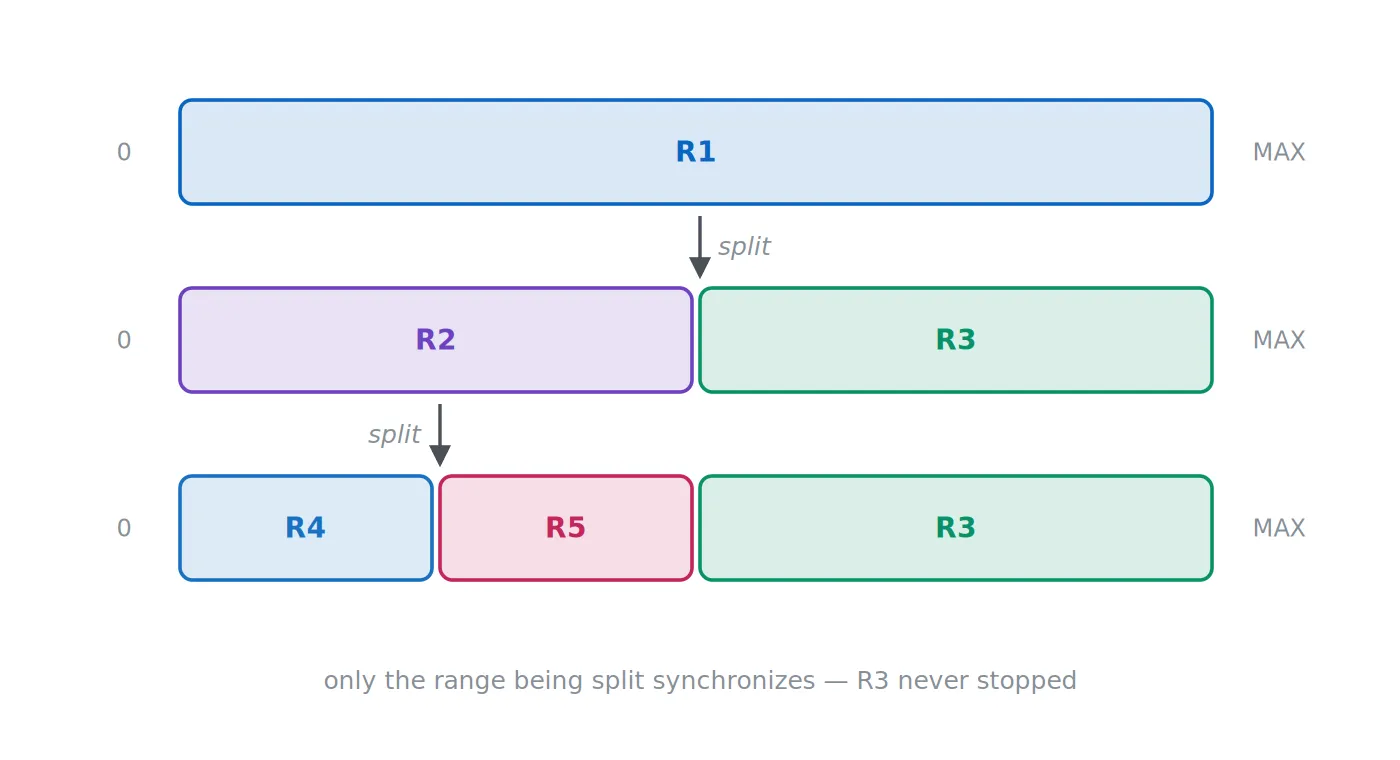
Բաժանվող range-ը ծառայում է որպես համաժամեցման կետ։ Producer-ները, որոնք գրում են առանց կապի range-երում, կարող են շարունակել։ Երբ R1-ը բաժանվում է R2-ի և R3-ի, R1-ի գրառումները գալիս են երկու զավակների գրառումներից առաջ։ Range-երի միավորումը ստեղծում է նմանատիպ կարգի հարաբերություն ծնող range-երի և միավորվածի միջև։
Սա օգուտ է բերում նաև հոսքային մշակմանը։ Վերցնենք orders-ի և customers-ի join՝ ըստ հաճախորդի ID-ի։ Երբ նրանց բանալիների partition-ավորումը համընկնում է, համապատասխան գրառումները կարելի է մշակել միասին։ Եթե մի topic-ն ունի տասը partition, իսկ մյուսը՝ տասնվեց, ֆրեյմվորքը կարող է նախ ստիպված լինել տվյալները վերախառնել։
Northguard-ը հենվում է buddy-ոճի բաժանումների և միավորումների վրա, ուստի range-երն ունեն հավասարեցված բանալիների տարածության սահմաններ topic-ների միջև։ LinkedIn-ը այս ընտրությունը կատարել է մասամբ, որպեսզի մշակման ֆրեյմվորքները կարողանան բաց թողնել այդպիսի վերախառնումները՝ նույն բանալիով հոսքերը join անելիս։
Control plane-ը նույնպես փոփոխություն էր պահանջում
Kafka-ի անցումը ZooKeeper-ից KRaft-ին փոխեց, թե ինչպես են պահվում մետատվյալները, բայց կլաստերը դեռ ունի մեկ տրամաբանական մետատվյալների state machine և մեկ ակտիվ controller։ LinkedIn-ը այդ կենտրոնացված control plane-ը անվանում է խցան, երբ հասնում ես միլիոնավոր partition ռեպլիկաների։
Northguard-ը մետատվյալները տարածում է vnode-երի վրա։ Յուրաքանչյուր vnode առանձին Raft-ով ապահովված state machine է՝ գլխավորված coordinator-ով։ Միասին vnode-երը ընդգրկում են hash օղակ.
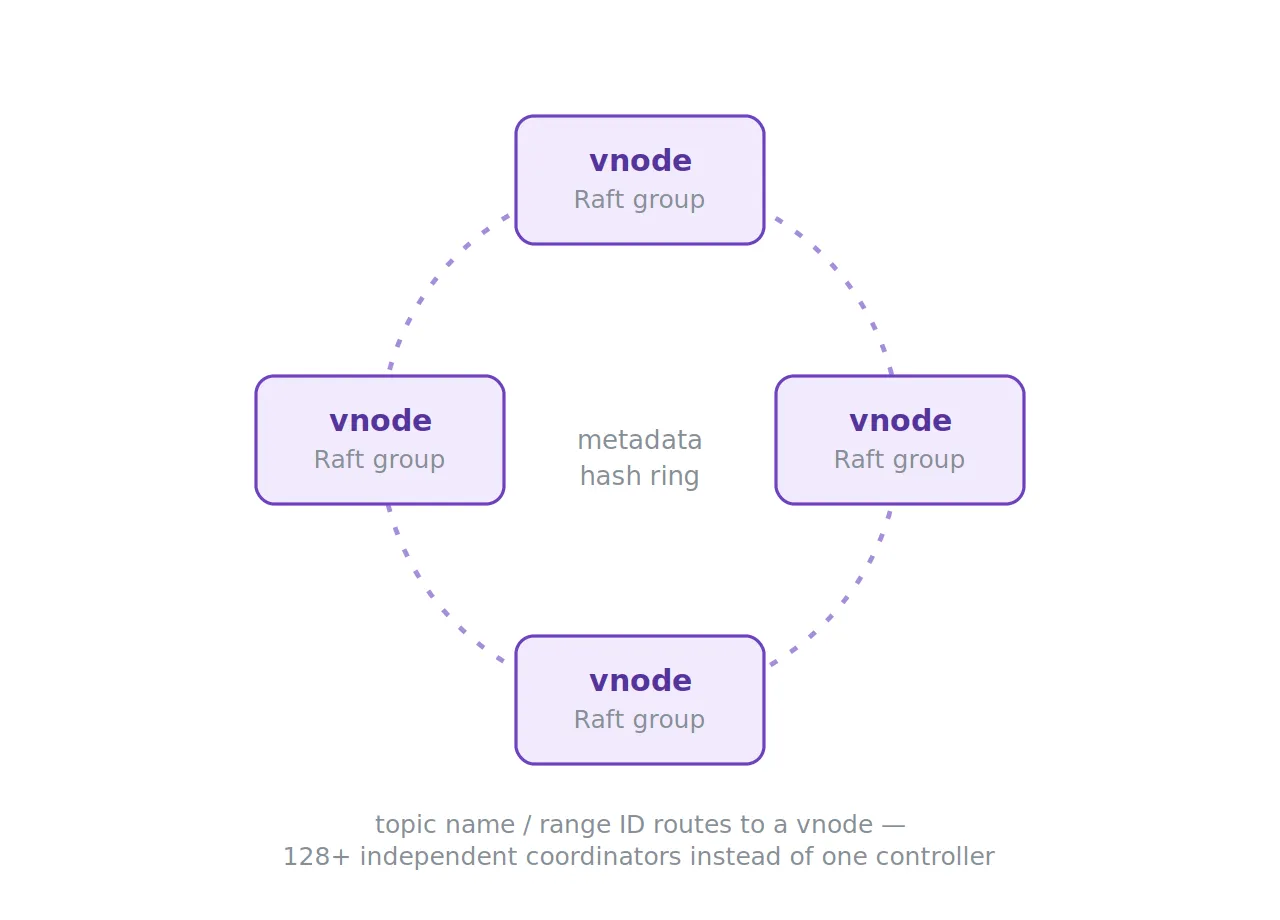
Topic-ի մետատվյալները նշանակվում են ըստ topic-ի անվան, իսկ range-ի և segment-ի մետատվյալները՝ ըստ range-ի ID-ի։ LinkedIn-ը սա անվանում է Dynamically-Sharded Replicated State Machine կամ DS-RSM և հիշատակում է տեղակայումներ, որոնք աշխատում են 128 կամ ավելի coordinator-ներով և state machine-ներով։
Յուրաքանչյուր coordinator մշակում է իր vnode-ին պատկանող մետատվյալները՝ ընդգրկելով range-երի բաժանումներն ու միավորումները, segment-ի վիճակը, ռեպլիկաների նշանակումները և topic-ի ջնջումը։ Այս գործողությունները այլևս բոլորը չպետք է անցնեն մեկ մետատվյալների leader-ի միջով։
Ամբողջ վիճակը չէ, որ անցնում է Raft-ով
Broker-ներին լրացուցիչ անհրաժեշտ են կապի հասցեներ, broker-ի ատրիբուտներ և vnode օղակի բավարար իմացություն՝ հարցումները ուղղորդելու համար։ Northguard-ը այս նվազագույն գլոբալ վիճակը տարածում է gossip-ի միջոցով՝ անդամության և ձախողման հայտնաբերման համար հենվելով SWIM-ի վրա։
Topic-ների, range-երի և segment-ների հեղինակավոր մետատվյալները մնում են Raft-ով ապահովված vnode-երում.
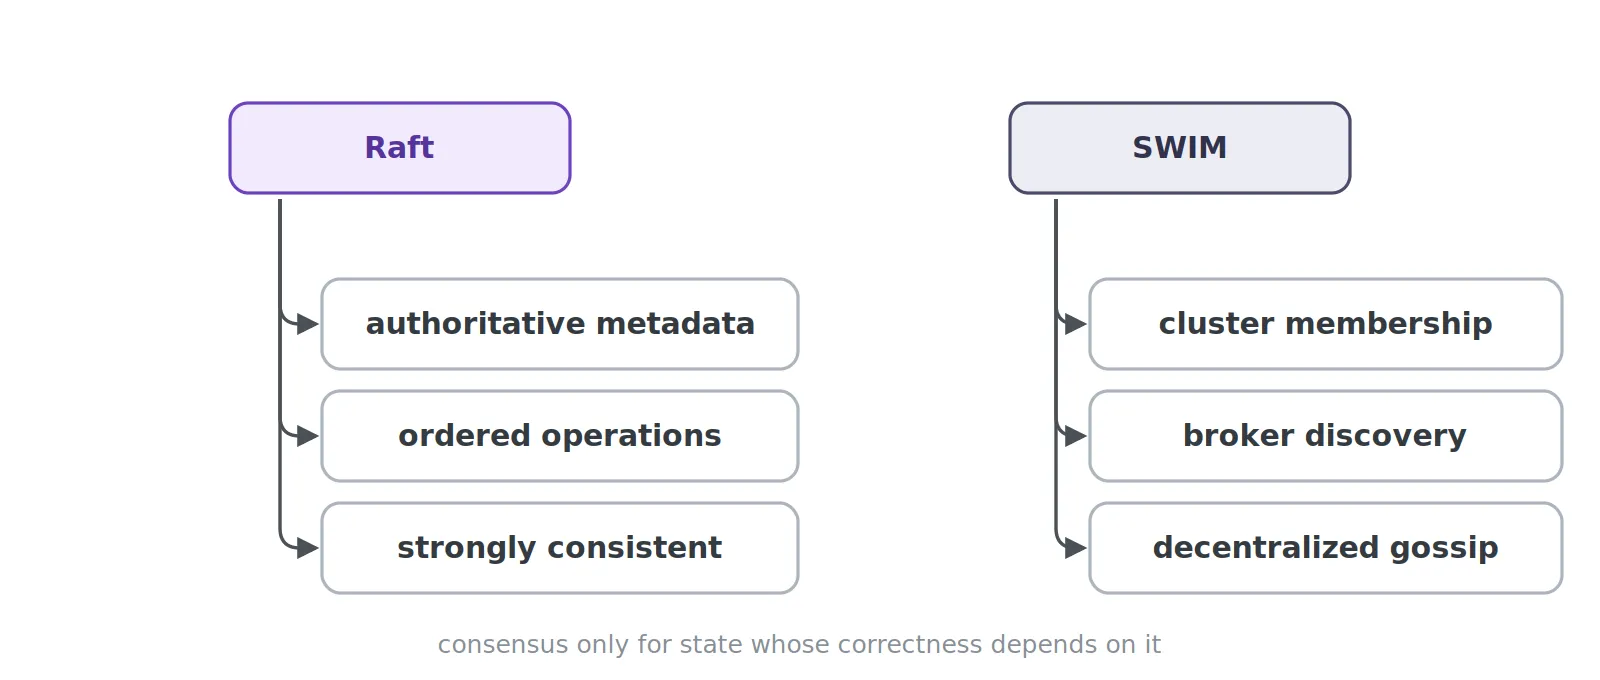
Gossip-ը թույլ է տալիս broker-ին գտնել հարցման համար պատասխանատու coordinator-ը։ Հենց մետատվյալների փոփոխությունը որոշվում է coordinator-ի ռեպլիկացված state machine-ով։ Այսպիսով անդամության տեղեկատվության տարածումը և հեղինակավոր թարմացումները հետևում են տարբեր ուղիներով։
Northguard-ը վերանայում է նաև սկավառակի ուղին
Kafka-ն հնարավորության դեպքում հենվում է հաջորդական I/O-ի, գործառնական համակարգի page cache-ի և zero-copy փոխանցման վրա։ Northguard-ի լռելյայն segment պահոցը՝ fps store-ը, համադրում է WAL, մեկ ֆայլ ամեն segment-ի համար, Direct I/O, RocksDB նոսր ինդեքս և հավելվածի կողմից կառավարվող քեշ։
Պահոցը խմբավորում է append-ները, գրում WAL, գրառումները կցում segment ֆայլերին, կանչում fsync և թարմացնում ինդեքսը։ Direct I/O-ն բաց է թողնում սովորական page-cache բուֆերավորումը. Northguard-ը լցնում է իր սեփական քեշը՝ հիմնվելով ակտիվ consume հոսքերի մասին իր իմացածի վրա։
Սա LinkedIn-ին տալիս է քեշավորման նկատմամբ ավելի հստակ վերահսկողություն։ Տեղական սկավառակները նույնպես մնում են գրելու ուղու մեջ՝ ի տարբերություն diskless Kafka-ի օբյեկտային պահոցի մոտեցման։ Segment պահոցը կարելի է փոխարինել, բայց հրապարակված լռելյայնը LinkedIn-ի հապաղման պահանջները բավարարելու համար հենվում է տեղական սկավառակների վրա գտնվող ռեպլիկացիայի փոքր միավորների վրա։
Երկարակեցության համեմատությունը զգուշություն է պահանջում
LinkedIn-ը իր երկու տեղակայումների համար տալիս է այս կոնֆիգուրացիոն պարամետրերը.
| LinkedIn-ի տեղակայումը | Սկավառակի համաժամեցում | Հաղորդված համաժամեցման/batch շեմեր |
|---|---|---|
| Kafka | Lazy sync | 10 վայրկյան կամ 20 000 գրառում |
| Northguard | fsync յուրաքանչյուր ռեպլիկայի վրա՝ նախքան producer-ին հաստատելը |
10 ms, 20 000 գրառում կամ 10 MB |
Ըստ LinkedIn-ի՝ Northguard-ը հասնում է իր Kafka արտադրողականության SLO-ներին՝ միաժամանակ առաջարկելով սկավառակում պահպանման այդ ավելի ուժեղ երաշխիքները։ Հայտարարությունը չի պարունակում վերարտադրելի բենչմարկի կարգավորում կամ հապաղման պերցենտիլներ, որոնք հիմնավորեն այդ համեմատությունը։
Հաստատված գրառումների երկարակեցության համար Kafka-ն սովորաբար հենվում է ռեպլիկացիայի վրա՝ յուրաքանչյուր հաստատումից առաջ յուրաքանչյուր ռեպլիկայի վրա fsync պահանջելու փոխարեն։ Այստեղ հաղորդվածն այն է, որ պահպանման ուղու վերանախագծումից հետո LinkedIn-ը կարող էր իրեն թույլ տալ ավելի խիստ համաժամեցման պահանջը։ Սա չի ապացուցում, թե Kafka-ն ունի երկարակեցության ներհատուկ սահմանափակում, ոչ էլ որ Northguard-ը ընդհանրապես ավելի արագ է։
Produce-ը հոսք է, այլ ոչ թե անկախ RPC-ների շարք
Մետատվյալների գործողությունները հենվում են սովորական հարցում–պատասխան կանչերի վրա։ Produce-ը, consume-ը և ռեպլիկացիան հենվում են սեսիայավորված հոսքային արձանագրությունների վրա։
Producer-ը handshake է կատարում ակտիվ segment-ի leader-ի հետ, ապա pipeline է անում append-ները պատուհանի ներսում, որը սահմանափակում է թռիչքի մեջ գտնվող տվյալների քանակը։ Broker-ը կարող է մի քանի append միանգամից հաստատել, բայց միայն այն բանից հետո, երբ նրանց գրառումները commit են արվել։ Consume-ը տվյալների հոսքը վարում է հակառակ ուղղությամբ՝ պատուհանը վերահսկում է կլիենտը. ռեպլիկացիան հետևում է նույն հոսքային մոդելին։
Նոր արձանագրությունը նաև միգրացիայի մարտահրավեր է բերում։ Հազարավոր հավելվածներ արդեն հենվում են Kafka կլիենտների վրա և գիտեն, թե որ ֆիզիկական կլաստերն է պահում իրենց topic-ները։ Նրանց անհրաժեշտ է լրացուցիչ աբստրակցիա՝ նախքան ներքևի պահոցը թափանցիկ կերպով փոխելը։
Xinfra-ն վիրտուալիզացնում է Pub/Sub-ը
Xinfra-ն գտնվում է հավելվածների և նրանց ներքևի լոգերի պահոցի միջև.
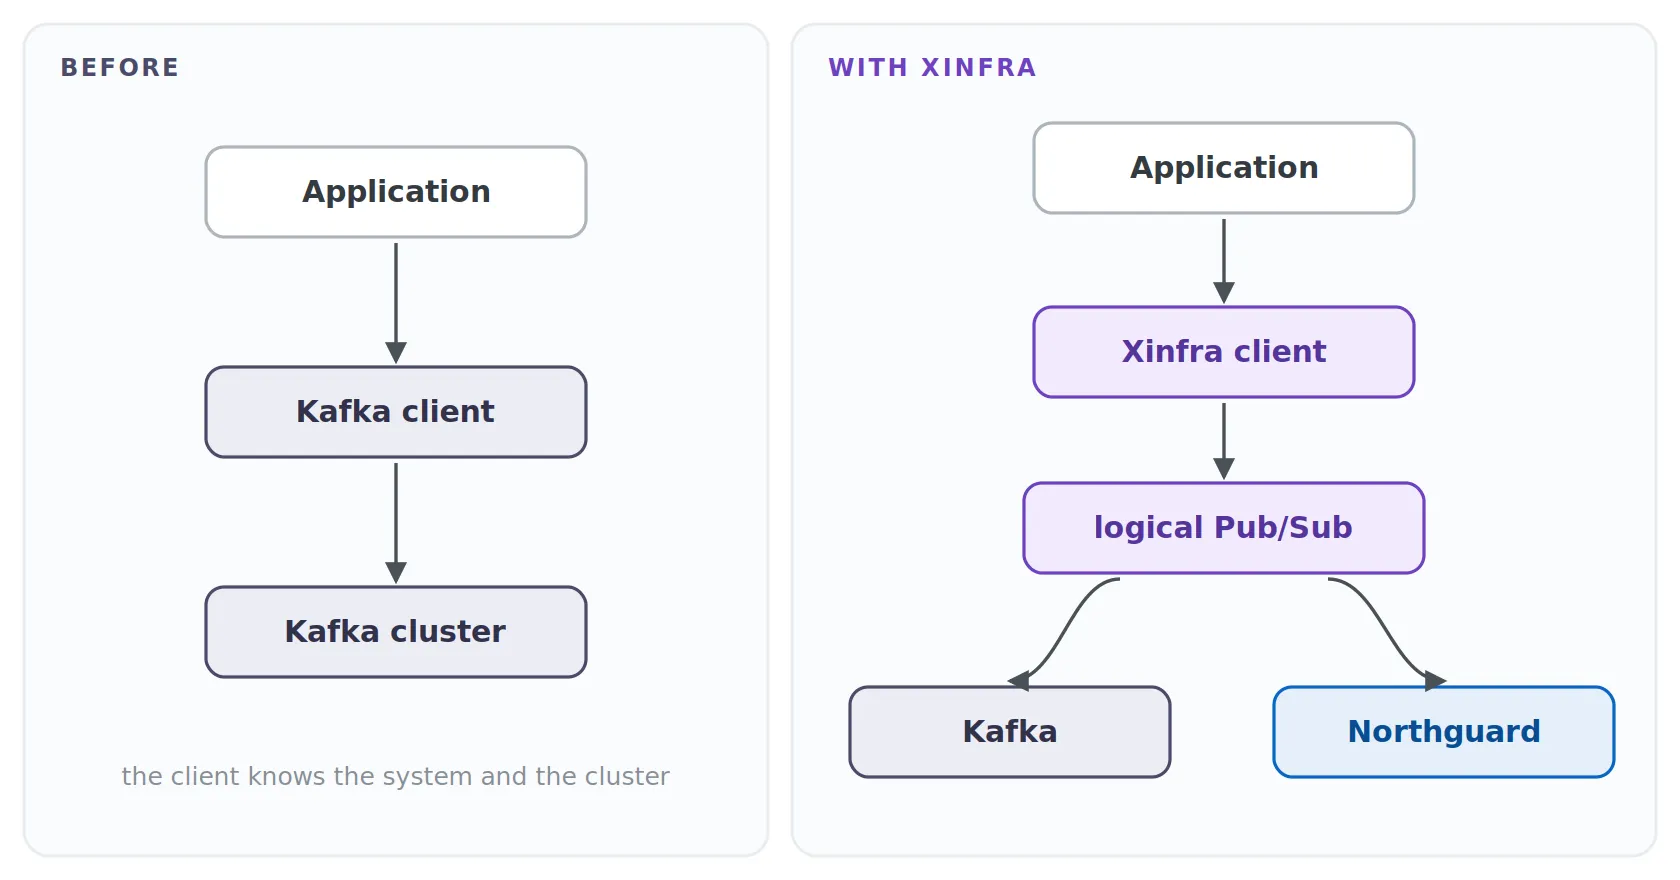
Հավելվածները Xinfra կլիենտների հետ խոսում են միասնական API-ով։ Topic-ը կարելի է տեղափոխել ֆիզիկական կլաստերների միջև կամ Kafka-ի և Northguard-ի միջև՝ պահպանելով իր տրամաբանական անունը։ Սա պահանջում է Xinfra կլիենտի ընդունում. գոյություն ունեցող Kafka կլիենտները այդ անուղղակիության շերտը անվճար չեն ստանում։
2025 թվականի հունիսի հայտարարության պահին LinkedIn-ը ասաց, որ իր հավելվածների ավելի քան 90%-ը օգտագործում է Xinfra կլիենտներ։
Topic-ներն ունեն epoch-ներ
Xinfra topic-ը հետևում է իր ֆիզիկական պահոցի փոփոխություններին epoch-ների միջոցով.
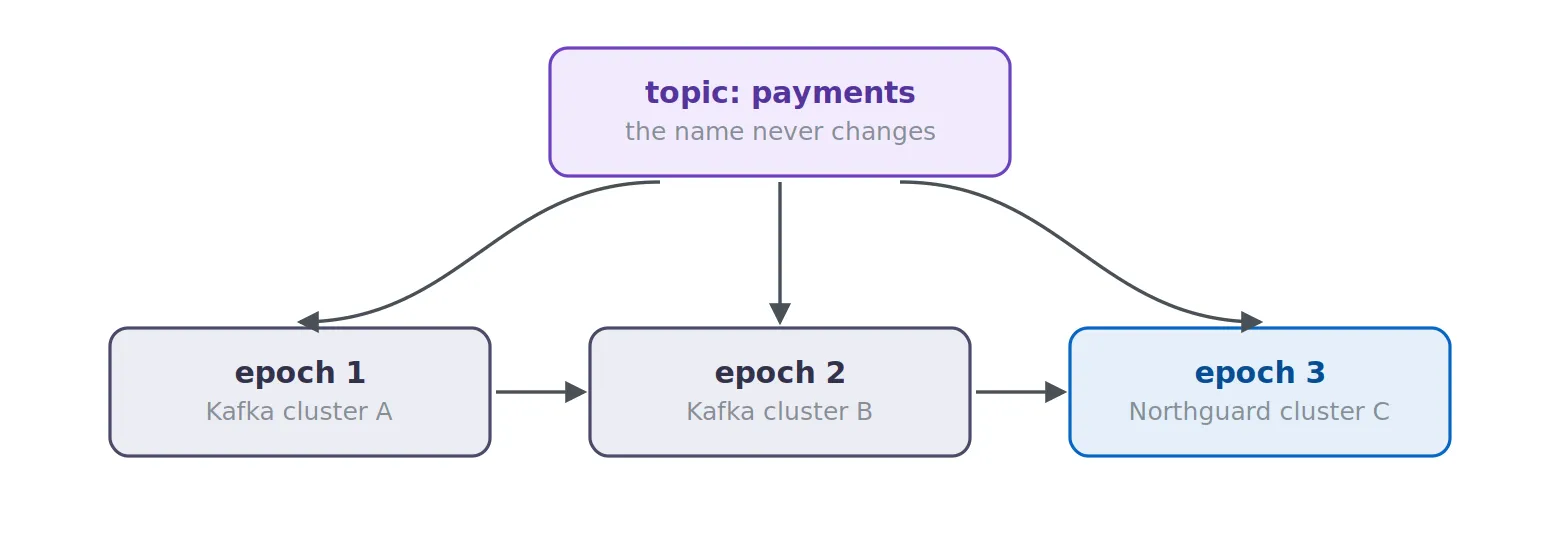
Հավելվածը կարող է շարունակել օգտագործել payments-ը, մինչ մի epoch գտնվում է Kafka-ում, իսկ հաջորդը՝ Northguard-ում։ Յուրաքանչյուր epoch պահում է այն shard-երը, որոնք կազմում են topic-ի այդ տարբերակը։ Կլիենտները ֆիզիկական համապատասխանեցումը ստանում են Xinfra մետատվյալներից, այլ ոչ թե այն կոշտ կոդավորված է հավելվածի կոնֆիգուրացիայում։
Kafka-ից Northguard՝ առանց ամեն ինչ կանգնեցնելու
Xinfra-ն նպատակակետում ստեղծում է նոր epoch։ Producer-ները տեղափոխվում են առաջինը և որոշ ժամանակ գրում են երկու համակարգերում էլ.
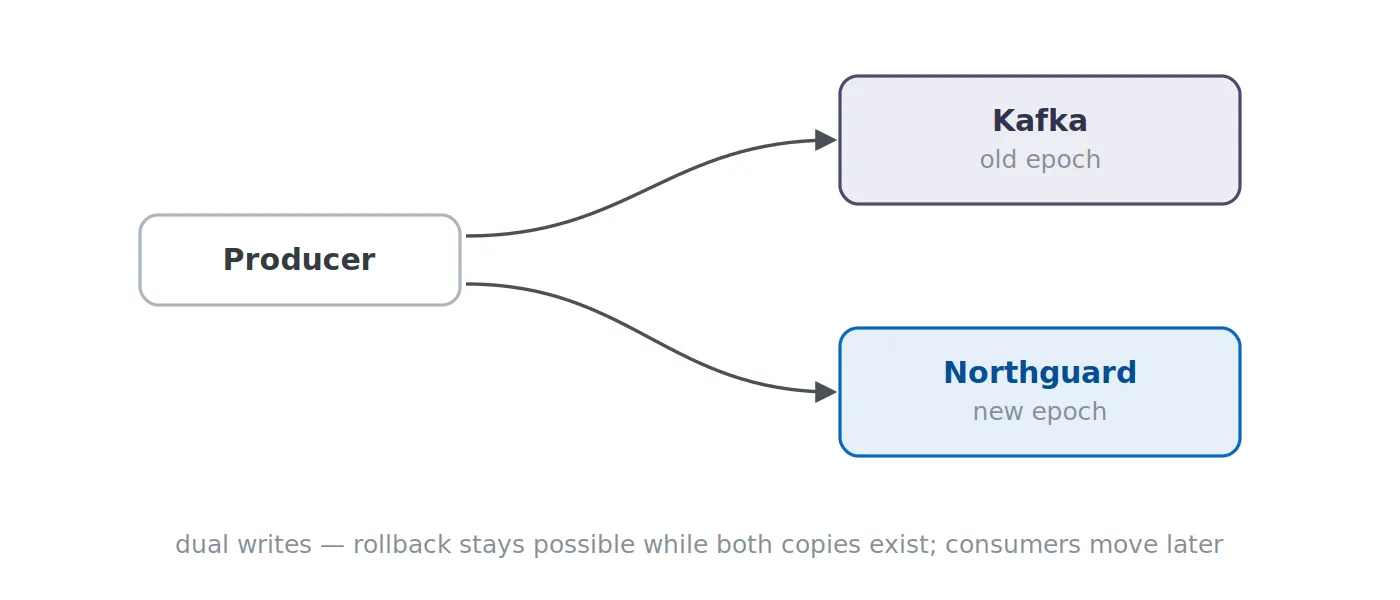
Կրկնակի գրառումների շնորհիվ անհաջող միգրացիան կարելի է հետ գլորել։ Consumer-ները տեղափոխվում են հետո. երբ անցումն ավարտվում է, կրկնակի գրառումները դադարում են։ Consumer-ները դեռ կարող են կարդալ նախորդ epoch-ները, մինչև retention-ը ջնջի դրանց տվյալները։ LinkedIn-ը ասում է, որ հավելվածները շարունակում են աշխատել, և կարգի երաշխիքները պահպանվում են ամբողջ անցման ընթացքում։
2025 թվականի հունիսին LinkedIn-ը ասաց, որ տեղափոխել է հազարավոր topic-ներ, որոնք օրական մշակում են տրիլիոնավոր գրառումներ։ Kafka-ն և Northguard-ը դեռ աշխատում էին զուգահեռ։ Այս թվերը արտացոլում են տարածման վիճակը զեկույցի հրապարակման պահին, այլ ոչ թե Kafka-ի լրիվ փոխարինումը։
Xinfra-ն թաքցնում է նաև կլաստերի սահմանը
Xinfra-ն կարող է տարբեր ֆիզիկական կլաստերներում գտնվող topic-ները խմբավորել մեկ վիրտուալ կլաստերում.
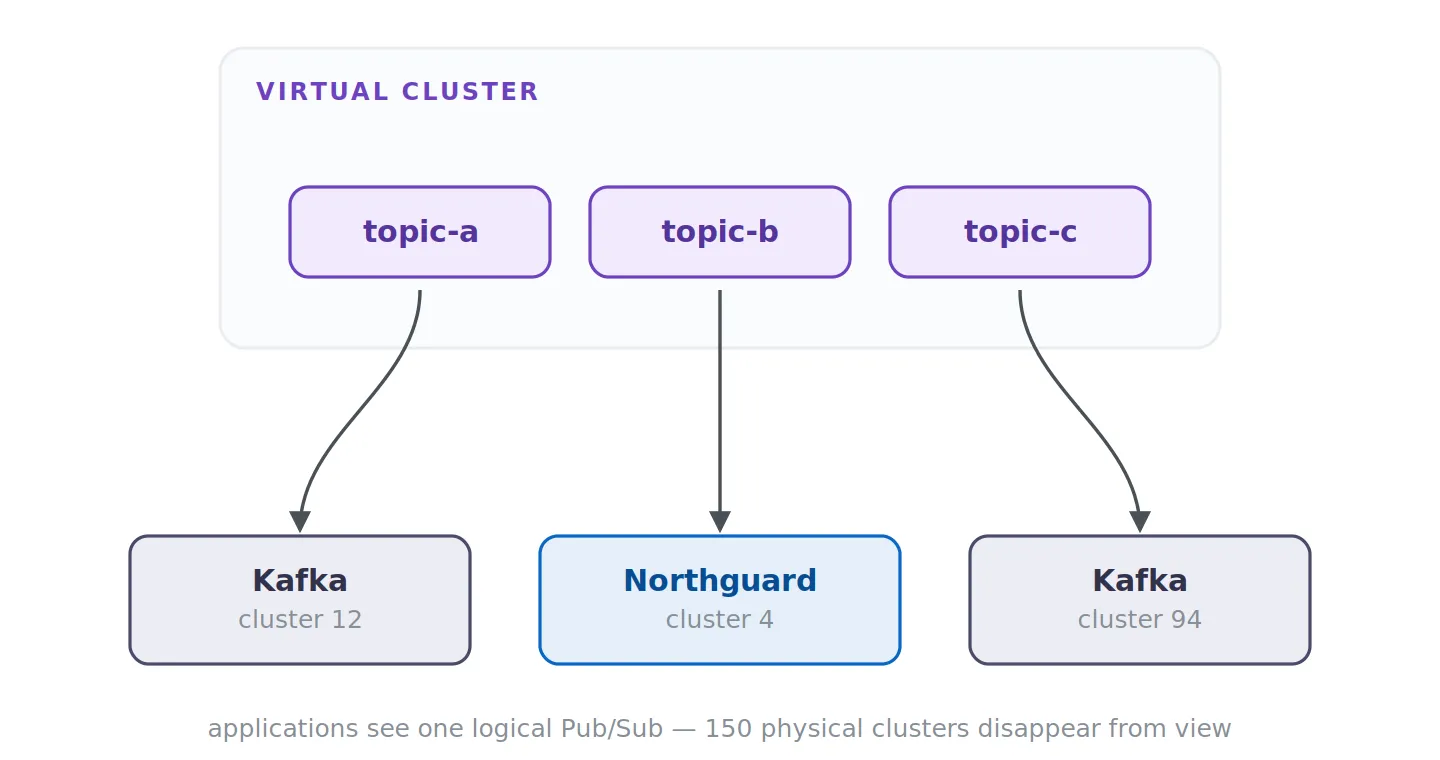
Consumer-ը կարող է բաժանորդագրվել այս topic-ներին նույն տրամաբանական միջավայրի միջոցով, նույնիսկ եթե դրանք պահվում են առանձին համակարգերում։ Սա թույլ է տալիս LinkedIn-ին մշակել մեկ ֆիզիկական կլաստերից մեծ բեռներ և փոխել topic-ների տեղակայումը՝ առանց ստիպելու յուրաքանչյուր հավելվածին հետևել տոպոլոգիային։
Բարդությունը չվերացավ
Հավելվածի API-ն ավելի պարզ է դառնում, բայց Xinfra-ն բերում է լրացուցիչ ենթակառուցվածք, որը պլատֆորմի թիմը պետք է գործարկի.
- MySQL-ը պահում է վիրտուալ և ֆիզիկական topic-ների ու կլաստերների համապատասխանեցումները։
- ZooKeeper-ը հոգ է տանում անդամության, լիդերության և consumer-group-ի բաշխման մասին։
- Vitess-ը պահում է consumer-ի checkpoint-ները, իսկ Couchbase-ը ծառայում է որպես ցածր հապաղմամբ քեշ։
LinkedIn-ի մոտ 150 կլաստերների դեպքում այս աշխատանքի կենտրոնացումը կարող է լավ արդարանալ։ Երկու Kafka կլաստերի դեպքում վիրտուալիզացիայի շերտը գործարկելը կարող է ավելի թանկ նստել, քան այն խնդիրը, որը լուծում է։
Գուցե LinkedIn-ը իրականում դուրս է եկել partition-ի շրջանակներից
Northguard-ը և Xinfra-ն պարտականությունները բաժանում են երեք մակարդակով։ Range-երը որոշում են տրամաբանական բանալիների տարածությունն ու կարգը, իսկ segment-ները՝ ռեպլիկացիան և տեղաբաշխումը։ Առանձին Raft խմբեր կիսում են մետատվյալների կառավարման աշխատանքը։ Xinfra-ն անջատում է հավելվածների տեսած topic-ը այն ֆիզիկական համակարգից, որը պահում է այն.
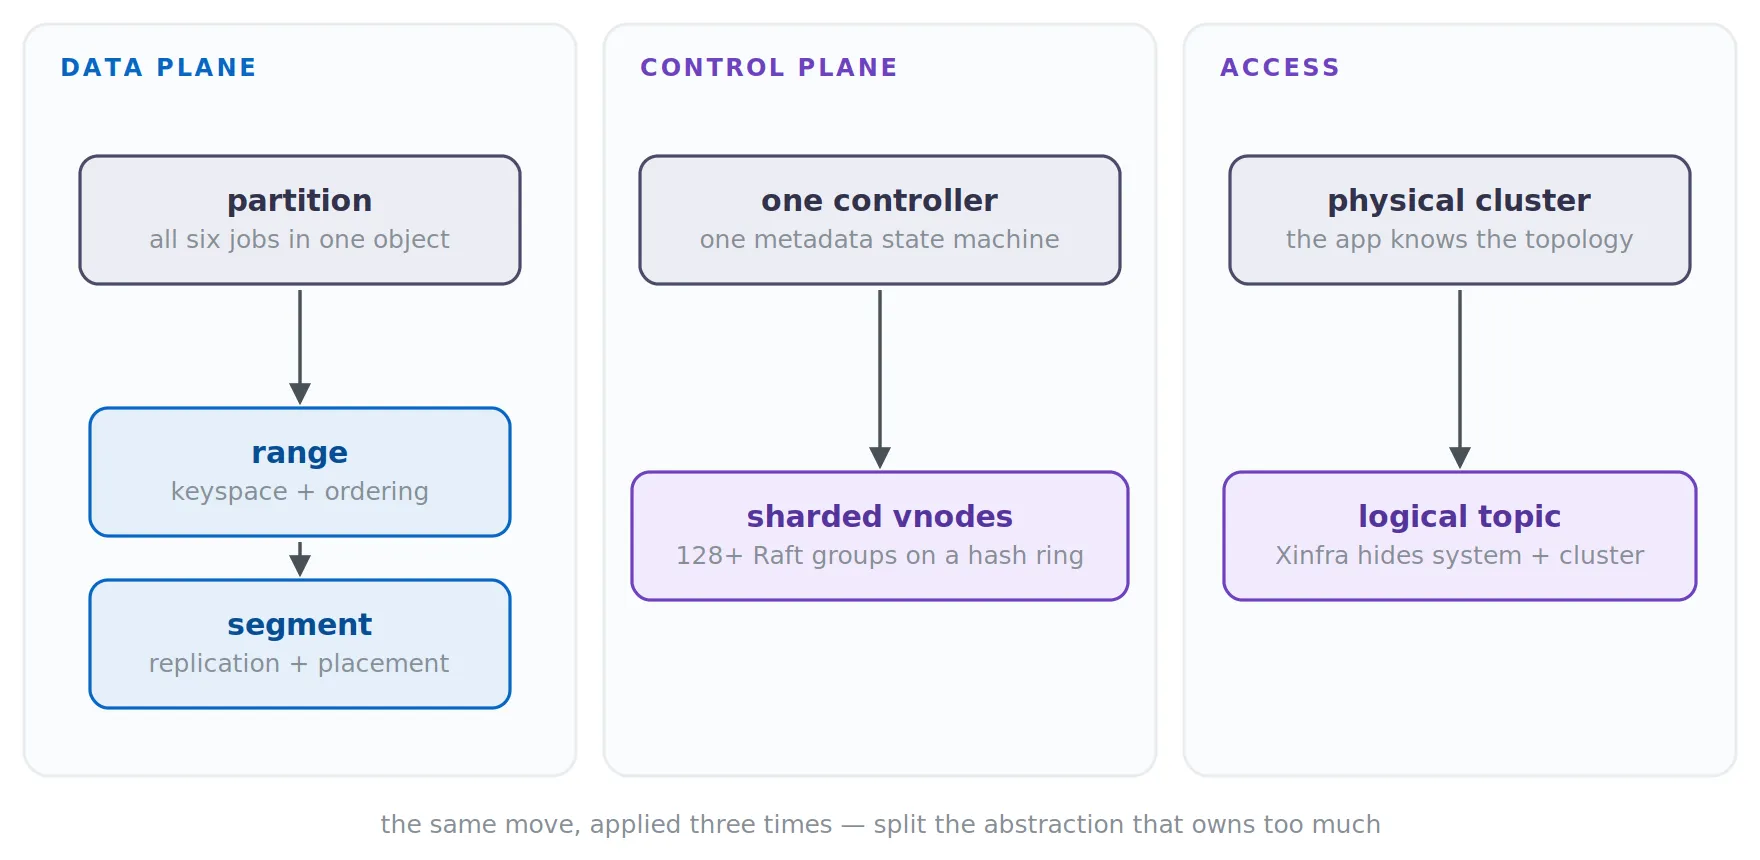
Այն դիտարկելը որպես LinkedIn-ի partition-ից դուրս գալ՝ իմ սեփական մեկնաբանությունն է։ Նրա հոդվածը նշում է մի քանի կոնկրետ խնդիր. ռեպլիկացիայի կոպիտ միավորներ, ինդեքսավորված partition-ներ, հավասարակշռում և կենտրոնացված մետատվյալներ։ Այն, ինչ դրանք կապում է, այն է, թե քանի գործողություն է հենվում նույն տեղաբաշխման և կարգի սահմանների վրա։
Kafka-ն արդեն LinkedIn-ին հասցրել էր ուշագրավ մասշտաբի։ Քառասուն topic-ով և վեց broker-ով կարգավորման համար Northguard-ի և Xinfra-ի կառուցումը առօրյա գործառնական խնդիրներին չափազանց թանկ պատասխան կլիներ։ Արժե հարցնել, թե ձեր սեփական համակարգի որ ծախսերն են բխում բեռից, և որոնք՝ կարգը, ռեպլիկացիան, տեղաբաշխումը և զուգահեռությունը մեկ partition-ի հետ կապելուց։