ScyllaDB-ն Cassandra-ից այն կողմ, մաս 2. որոնում, CDC և պահպանման շերտ
Տեխնիկական հայացք այն մասին, թե ինչով են տարբերվում ScyllaDB-ն և Apache Cassandra-ն երկրորդական index-ների, վեկտորային և full-text որոնման, change data capture-ի և workload-ների առաջնահերթության առումով, ցուցադրված աջակցության տիկետների օրինակով։
Tablet-ները, Raft-ը և ScyllaDB-ի այլ մասեր ավելի ու ավելի անճշգրիտ են դարձնում այն «C++-ով վերագրված Cassandra» անվանելը։
Տարբերությունների երկրորդ խումբը գտնվում է հավելվածին ավելի մոտ։ Ինչպե՞ս query անել սյունակի, որը առաջնային բանալու մաս չէ։ Ինչպե՞ս պահել որոնման index-ը թարմ։ Ինչպե՞ս կատարել backfill՝ առանց ինտերակտիվ տրաֆիկը խեղդելու։ Որքա՞ն սկավառակային տարածք է պահանջում compaction-ը, և արդյո՞ք SSTable-ները պետք է առհասարակ գտնվեն տեղական սկավառակների վրա։
ScyllaDB-ն և Cassandra-ն այս հարցերին պատասխանում են տարբեր եղանակներով։ Պատասխաններից մի քանիսը հասուն հնարավորություններ են, մյուսները եկան ScyllaDB 2026.3-ով։ Դրանք ձևավորում են և՛ query-ները, որոնք կարող եք գրել, և՛ դրանց տակ գտնվող ենթակառուցվածքը։
Երկրորդական index-ներ. CQL-ը նման է, բայց դրա հետևում աշխատանքը՝ ոչ
Պատկերացրեք աջակցության հավելված, որը պահում է տիկետները ID-ի բանալիով։ Մեկ տիկետ ստանալը պարզ է։ Սակայն տիկետները արտաքին հղումով փնտրելը պահանջում է հասանելիության այլ ուղի։
Օրինակ. գտնել CRM-1842-ին կապված տիկետները։
CREATE INDEX tickets_external_ref_idx ON support.tickets (external_ref);

SELECT ticket_id, body FROM support.tickets
WHERE external_ref = 'CRM-1842';
Ներսում ScyllaDB-ի global երկրորդական index-ները կառուցված են materialized view-ների վրա։ Index արժեքը ծառայում է որպես index աղյուսակի partition key։ Query-ն նախ կարդում է այդ աղյուսակը՝ համապատասխան base-աղյուսակի բանալիները գտնելու համար, ապա ստանում է տողերը։ Index-ը թարմ պահելը լրացուցիչ աշխատանք է արժենում, երբ index արժեքները փոխվում են, և index-ի տողերը կարող են գտնվել base տողերից տարբեր հանգույցների վրա։
Cassandra 5-ի Storage-Attached Indexing-ը (SAI) index կառուցվածքները պահում է յուրաքանչյուր replica-ի վրա՝ memtable-ների և SSTable-ների կողքին։ Query-ները հենվում են այս տեղային index-ների վրա՝ այն replica-ների վրա, որոնց հասնում են։ Index արժեքով բաժանված համեմատելի global index աղյուսակ գոյություն չունի։ ScyllaDB-ի ամենամոտ համարժեքը նրա տեղային երկրորդական index-ն է, որը index-ը և base տվյալները տեղադրում է միասին, բայց կարող է սպասարկել միայն այն query-ները, որոնք սահմանափակում են նաև partition key-ը։
Սա ազդում է այն բանի վրա, թե որտեղ են ուղարկվում read-երը, ինչ պետք է թարմացնեն write-երը և ինչպես են ծախսերը փոփոխվում selectivity-ի հետ։ Տասը տող վերադարձնող query-ն պետք է փորձարկվի այլ կերպ, քան աղյուսակի կեսին համապատասխանողը։
Համատեղելիության մեկ մանրուք նույնպես արժե նշել. ScyllaDB-ն վեկտորային index-ների համար ընդունում է Cassandra-ի StorageAttachedIndex դասի անունը և արտապատկերում այն իր սեփական իրականացման վրա։ Այս հայտարարության ընդունումը չի նշանակում, որ ScyllaDB-ն աշխատեցնում է Cassandra-ի SAI շարժիչը։
Վեկտորային որոնումը բերում է այլ տեսակի փնտրում
Տիկետի ID-ն գտնում է մեկ գրառում։ Embedding-ը կարող է օգնել գտնել նույն խնդրի մասին ավելի վաղ հաղորդումները, նույնիսկ եթե դրանք այլ կերպ են ձևակերպված։ «Կապը ձախողվում է վկայականը թարմացնելուց հետո» կարող է կապված լինել «TLS handshake սխալներ վկայականի rotation-ից հետո» հետ։
Cassandra-ն արդեն աջակցում է վեկտորային որոնմանը։ ScyllaDB-ի իրականացումը հետևում է տեղակայման այլ մոդելի։
Նրա Vector and Text Search ծառայությունը առայժմ ScyllaDB Cloud-ի հնարավորություն է։ Վեկտորային որոնումը պահանջում է 2025.4.3 կամ ավելի նոր տարբերակ, իսկ full-text որոնումը՝ 2026.3.0 կամ ավելի նոր։ Երկու դեպքում էլ index-ավորման ծառայությունը պետք է միացված լինի։
Ճարտարապետությունը պահպանման հանգույցները առանձնացնում է index-ավորման հանգույցներից։ ScyllaDB-ն պահում է տողերը՝ իրենց embedding-ների հետ միասին։ Հատուկ հանգույցները պահում են in-memory HNSW index-ներ և օգտագործում են USearch՝ մոտավոր ամենամոտ հարևանների որոնման համար։ CQL query-ն գնում է index-ավորման ծառայություն, որը որոշում է թեկնածու տողերի բանալիները. ScyllaDB-ն այնուհետև օգտագործում է այդ բանալիները՝ համապատասխան տողերը ստանալու համար։ Index-ավորման հզորությունը կարելի է մասշտաբավորել տվյալների բազայի հզորությունից անկախ։
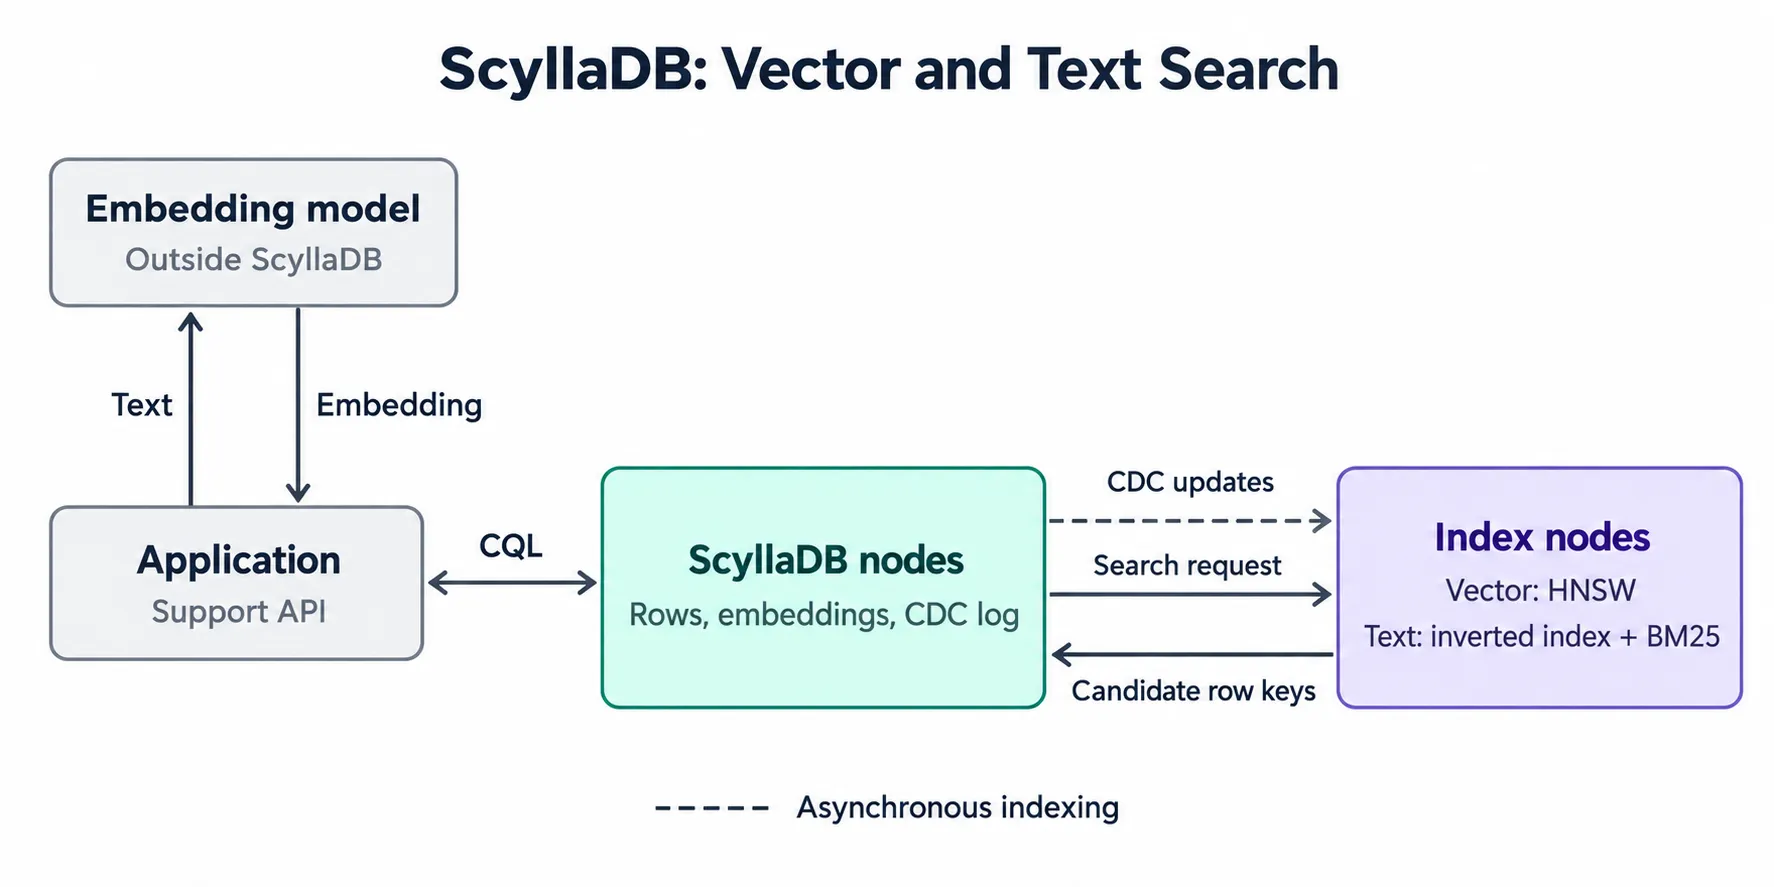
ScyllaDB-ի հանգույցները պահում են տողերը և embedding-ները, իսկ հատուկ index-ավորման հանգույցները վեկտորային և full-text index-ները թարմ են պահում ասինխրոն CDC թարմացումների միջոցով։
Դա նշանակում է ևս մեկ ռեսուրս, որի չափը պետք է հաշվարկել։ Տվյալների բազան կարող է ունենալ բավարար պահոց, մինչդեռ նրա վեկտորային index-ի հիշողությունը չի հերիքում։ Վեկտորների չափողականությունը, գրաֆի կոնֆիգուրացիան և index-ավորված տողերի քանակը բոլորն էլ դեր են խաղում։ Մոտավոր որոնումը նաև բերում է recall/latency փոխզիջում. արագ պատասխանելը և յուրաքանչյուր համապատասխան հարևանին գտնելը երկու տարբեր նպատակներ են։
Embedding-ների ստեղծումը մնում է հավելվածի գործը։ Այն ընտրում է մոդելը, որոշում է, թե ինչպես են տիկետների երկար քննարկումները բաժանվում որոնելի հատվածների, և հոգում է վերաembedding-ը, երբ մոդելը փոխվում է։
Օրինակ. գտնել հինգ նման տիկետ։
Ենթադրենք՝ յուրաքանչյուր տիկետ պահվում է embedding-ի հետ միասին։ Այդ արժեքը գալիս է արտաքին մոդելից, և յուրաքանչյուր մոդել տալիս է ֆիքսված չափի ելք։ 384 արժեք վերադարձնող մոդելի համար, ինչպիսին է all-MiniLM-L6-v2-ը, աղյուսակը ստանում է համապատասխան չափի վեկտորային սյունակ, ինչպես նաև դրա վրա index.
ALTER TABLE support.tickets ADD embedding vector<float, 384>;

CREATE CUSTOM INDEX tickets_embedding_idx ON support.tickets (embedding)
  USING 'vector_index'
  WITH OPTIONS = {'similarity_function': 'COSINE'};
Երբ նոր տիկետ է գալիս («TLS handshake սխալներ վկայականի rotation-ից հետո»), հավելվածը դրա տեքստն ուղարկում է այդ նույն մոդելին՝ լինի դա hosted API, թե տեղում աշխատող, և ի պատասխան ստանում է 384 թիվ։ Այն դրանք query-ին փոխանցում է որպես bind պարամետր։ Query-ի շարահյուսությունը համընկնում է Cassandra 5-ի հետ.
SELECT ticket_id, body FROM support.tickets
ORDER BY embedding ANN OF ?
LIMIT 5;
Full-text որոնումը կառավարում է ձեր մուտքագրած ճշգրիտ բառերը
Երբեմն ամենաօգտակար որոնման տերմինը պարզապես SSLHandshakeException-ն է։ Բացառության անունը, արտադրանքի նույնացուցիչը կամ մեջբերված արտահայտությունը կարող է ավելի ճշգրիտ լինել, քան սեմանտիկ նկարագրությունը։
ScyllaDB 2026.3-ը ներմուծում է full-text որոնում՝ fulltext_index index-ների և BM25 դասակարգման միջոցով։ Տիկետի body սյունակի համար.
Օրինակ. գտնել այն տիկետները, որոնք հիշատակում են SSLHandshakeException։
CREATE CUSTOM INDEX tickets_body_fts ON support.tickets (body)
  USING 'fulltext_index';

SELECT ticket_id, body FROM support.tickets
WHERE BM25(body, 'SSLHandshakeException') > 0
ORDER BY BM25(body, 'SSLHandshakeException')
LIMIT 10;
Վերլուծիչը (analyzer) տեքստը բաժանում է տերմինների և նորմալացնում դրանք։ Index-ը գտնում է համապատասխան փաստաթղթերը և դասակարգում դրանք։ Լեզվին հատուկ վերլուծիչները նաև stemming-ի միջոցով զբաղվում են բառաձևերով։ Աղյուսակը պետք է օգտագործի tablet-ներ, և partition-key սյունակները չեն կարող index-ավորվել։ Full-text index ստեղծելը ավտոմատ կերպով միացնում է CDC-ն base աղյուսակի համար, ինչը ավելացնում է փոփոխությունների log-ի պահոց, որը պետք է նախատեսել բյուջեում։
Query-ները պահանջում են համապատասխան BM25() արտահայտություններ թե՛ WHERE-ում, թե՛ ORDER BY-ում, ինչպես նաև LIMIT։ Paging-ը, խմբավորումը և ագրեգացիան այս պահին չեն աջակցվում։
Ժամկետանցումը արժանի է առանձին դիտարկման։ Սովորական cell մակարդակի TTL-ը CDC իրադարձություններ չի արձակում, ուստի index-ը կարող է պահել գրառումներ այն բանից հետո, երբ հիմքում ընկած արժեքների ժամկետը լրացել է։ Երբ index-ը պետք է հետևի ժամկետանցմանը, փաստաթղթերը խորհուրդ են տալիս per-row TTL, որը ջնջման իրադարձություններ արձակում է։
Full-text index-ները աշխատում են նույն index-ավորման հանգույցների վրա, որոնք հյուրընկալում են վեկտորային index-ները, և երկուսն էլ փոփոխությունները ստանում են ասինխրոն՝ CDC-ի միջոցով։ Արդյունքում տողի թարմացման հաջողվելը և այդ թարմացման որոնելի դառնալը տեղի են ունենում տարբեր ժամանակներ։ Աջակցության հավելվածի համար ես, query-ի latency-ից բացի, կչափեի նաև, թե որքան ժամանակ է պահանջվում, որ նոր ավելացված պատասխանը հայտնվի որոնման մեջ։
Տեքստային և վեկտորային index-ները կարող են գոյակցել մեկ աղյուսակի վրա, բայց հիբրիդային որոնումն այժմ պահանջում է երկու query։ Հավելվածն ինքն է համակցում արդյունքների ցանկերը, օրինակ՝ reciprocal rank fusion-ով, որը միավորում է դրանց դասակարգումները՝ առանց հում միավորների համեմատելի լինելու կարիքի։
Բազմակիրառիչ (multi-tenant) հավելվածներում ավելի կարևոր է այլ սահմանափակում. full-text query-ն չի կարող կրել որևէ լրացուցիչ WHERE սահմանափակում, այդ թվում՝ tenant կամ partition key։ Որոնման FAQ-ը նշում է, որ վեկտորային որոնումը աջակցում է ֆիլտրմանը, մինչդեռ full-text որոնումը՝ ոչ։
Հետևաբար հավելվածում ֆիլտրումը պետք է նախագծվի զգուշությամբ։ Գլոբալ լավագույն 20 համընկնումները ստանալը և հետո այլ tenant-ների տիկետները դեն նետելը կարող է ձեզ թողնել առանց օգտագործելի որևէ բանի։ Թույլտվությունը (authorization) նույնպես պետք է տեղի ունենա նախքան ստացված բովանդակությունը օգտատիրոջը կամ AI գործակալին հասնելը։ Ընդհանուր տիկետների աղյուսակի համար այս սահմանափակումը կարող է որոշել՝ ներկառուցված տեքստային որոնումն առհասարակ տարբերակ է, թե ոչ։
Ավելի քիչ պահանջկոտ որոնման կարիքների համար տողերը, embedding-ները և տեքստային index-ները CQL-ի հետևում պահելը կարող է խնայել առանձին որոնման ինտեգրումը։ Այդուհանդերձ, ես կփորձարկեի իրական query-ները՝ նախքան գոյություն ունեցող որոնման շարժիչը ապամոնտաժելու պլանավորումը։
CDC-ն հավելվածներին տալիս է change log, որը նրանք կարող են query անել
Որոնման ծառայությունը ScyllaDB-ի փոփոխությունների հոսքի միայն մեկ սպառողն է։ Ձեր հավելվածը նույնպես կարող է սպառել այն։
ScyllaDB CDC-ը փոփոխությունները գրում է log աղյուսակներում, որոնք query են արվում CQL-ով։ Գրառումները բաժանված են stream-ների, ուստի սպառողը հետևում է մի քանի stream-ների և պահում է, թե որտեղ է հասել։ Log-ը գրանցում է mutation-ները, բայց կարող եք միացնել ընտրովի preimage-ներ և postimage-ներ՝ տողի լրացուցիչ վիճակ ստանալու համար (լրացուցիչ արժեքով)։
Բնօրինակ Apache Cassandra CDC-ը յուրաքանչյուր հանգույցի վրա բացահայտում է commit-log սեգմենտները, որպեսզի սպառողները մշակեն դրանք։ Սպառողները պատասխանատու են այդ ֆայլերի կառավարման համար, ներառյալ ջնջումը։ Երբ կարգավորված CDC տարածքը լցվում է, CDC միացված աղյուսակներին write-երը կարող են մերժվել։ ScyllaDB-ն առաջարկում է ինտեգրման այլ ինտերֆեյս. client-ները կարդում են տվյալների բազայի աղյուսակներ՝ commit-log ֆայլեր հանգույցներից հավաքելու փոխարեն։ Սա CDC-ի երկու իրականացումների միջև ամենաէական տարբերություններից մեկն է։ Cassandra-ի սպառողները պետք է գործ ունենան յուրաքանչյուր mutation-ի պատճենների հետ՝ առանց հանգույցների միջև որևէ հերթականության, և պետք է հեռացնեն կրկնօրինակները։ ScyllaDB-ի log աղյուսակը կարդացվում է CQL-ով, ուստի սպառողը ստանում է մեկ տրամաբանական գրառում։
Kafka pipeline-ի համար ScyllaDB CDC Source Connector-ը կարդում է այս log աղյուսակները և հրապարակում փոփոխությունները Kafka Connect-ի միջոցով։ Սա կարող է սնել որոնման շարժիչ, քեշ կամ վերլուծական projection։
Մեր տիկետի սցենարում CDC-ն կարող էր նաև գործարկել embedding-ի ստեղծումը ամեն անգամ, երբ տեքստը փոխվում է։ Worker-ը պետք է յուրաքանչյուր embedding կապի տեքստի այն տարբերակին, որը իրականում մշակել է։ Հակառակ դեպքում ավելի հին տարբերակի վրա աշխատող դանդաղ job-ը կարող է վերագրել ավելի նոր տարբերակի embedding-ը։ ScyllaDB-ի վեկտորային index-ը բարեխղճորեն կindex-ավորի ցանկացած վեկտոր, որ գրեք, այդ թվում՝ հնացածները։
Retention-ը պահանջում է նույն զգուշությունը։ CDC գրառումները ապրում են կարգավորելի ժամանակահատված։ Եթե սպառողը հետ է մնում այդ պատուհանից, նրան անհրաժեշտ է վերակառուցման կամ համադրման (reconcile) եղանակ։ Փոփոխությունների հոսքը արժեքավոր է միայն այն դեպքում, եթե հավելվածը գիտի, թե ինչպես վերականգնվել դրա մի մասը բաց թողնելուց հետո։
Backfill-ը կատարեք ավելի ցածր առաջնահերթությամբ
Որոնում ավելացնելը հաճախ ներառում է տարիների գոյություն ունեցող գրառումների մշակում։ Backfill-ը կարդում է տիկետները, կանչում embedding մոդելը և գրում վեկտորները, մինչդեռ աջակցության API-ն շարունակում է սպասարկել օգտատերերին։
ScyllaDB-ի workload prioritization-ը թույլ է տալիս տվյալների բազայի դերերին վերագրել service level-ներ, որոնցից յուրաքանչյուրը ստանում է պլանավորման ռեսուրսների տարբեր մասնաբաժին։ API-ն և backfill-ը կարող են աշխատել առանձին դերերի տակ, ընդ որում API-ին տրվում է ավելի բարձր առաջնահերթություն։
Օրինակ. API հարցումներին նախապատվություն տալ backfill-ի նկատմամբ։ Երկու client-ների օգտագործած գոյություն ունեցող դերերի համար.
CREATE SERVICE_LEVEL interactive WITH SHARES = 1000;
CREATE SERVICE_LEVEL bulk WITH SHARES = 100;
ATTACH SERVICE_LEVEL interactive TO api_role;
ATTACH SERVICE_LEVEL bulk TO backfill_role;
Share-երը սահմանում են հարաբերական առաջնահերթություն, երբ ռեսուրսների համար մրցակցություն է։ Նրանք կարող են ինտերակտիվ հարցումներին առաջնություն տալ backfill աշխատանքի նկատմամբ, բայց ո՛չ սարքավորում են ամրագրում, ո՛չ էլ որևէ կոնկրետ p99 երաշխավորում։
Սա ծածկում է այդ դերերի կատարած տվյալների բազայի գործողությունները։ Ավելի ցածր առաջնահերթությամբ backfill-ը դեռ պետք է ունենա իր սեփական concurrency սահմանաչափերը, և չպետք է ենթադրեք, որ նրա տվյալների բազայի service level-ը կառավարում է առանձին վեկտորային index-ավորման ծառայությունը։ Նրա concurrency-ն կարգավորելիս ես կողք կողքի կմոնիթորինգ անեի API-ի latency-ն, backfill-ի առաջընթացը և index-ավորման ուշացումը։
Compaction-ը փոխում է, թե որքան պահոց է ձեզ պետք
Որոնման հնարավորությունները ավելի շատ ուշադրություն են ստանում, բայց compaction-ը կարող է ավելի ուժեղ ազդել ենթակառուցվածքի հաշվի վրա։
LSM տվյալների բազան ժամանակ առ ժամանակ միավորում է SSTable-ները։ Մինչ մեծ միավորումն ընթացքի մեջ է, մուտքային ֆայլերը և նոր գրված ելքը կարող են գոյություն ունենալ միաժամանակ, ուստի կլաստերին տարածք է պետք կենդանի տվյալների հավաքածուի վրա ավելի։
ScyllaDB-ի Incremental Compaction Strategy-ը (ICS) SSTable run-երը բաժանում է ավելի փոքր հատվածների՝ լռելյայն յուրաքանչյուրը 1 GB։ Compaction-ը աշխատում է այդ հատվածների վրա և աստիճանաբար ազատում է սպառված մուտքը, ուստի այն կարիք չունի պահել մեծ մուտքային ֆայլերի ամբողջ հավաքածուն մինչև ամբողջ գործողության ավարտը։
ICS-ը պահպանում է size-tiered compaction-ի ընդհանուր read/write փոխզիջումները։ Հաճախ թարմացվող տողերը դեռ կարող են տարածվել մի քանի SSTable-ների վրա, և հնացած տարբերակները կարող են տարածք զբաղեցնել, մինչև միավորվեն։ Compaction-ի ժամանակավոր տարածքը կրճատելը չի վերացնում պահոցի ծախսի յուրաքանչյուր տեսակ։
Cassandra-ի կողմում համեմատության համապատասխան կետն այժմ Unified Compaction Strategy-ն է, որը հայտնվեց Cassandra 5-ում և քննարկվել էր նախորդ հոդվածում։ UCS-ն աջակցում է կարգավորելի tiered և leveled վարքագիծ՝ sharded compaction-ի հետ միասին։ Միայն Cassandra-ի ավելի հին size-tiered լռելյայն կարգավորումների հետ համեմատելը կանտեսեր այդ աշխատանքը։
Սկավառակի օգտագործումը փոփոխվում է, երբ թարմացումները կուտակվում են և compaction-ն աշխատում է։ Տվյալների հավաքածուի չափը բեռնումից անմիջապես հետո քիչ բան է ասում այն հզորության մասին, որ ձեզ պետք կլինի վերագրումների, ջնջումների և սպասարկման ամիսներից հետո։
SSTable-ները կարող են գտնվել նաև object storage-ում
ScyllaDB 2026.3-ը բերում է SSTable-ները S3-համատեղելի object storage-ում պահելու preview աջակցություն։ Keyspace-ի STORAGE տարբերակը ընտրում է կարգավորված endpoint-ը և bucket-ը։ Այս օբյեկտները տվյալների բազայի կենդանի SSTable-ներն են, և compaction-ը և read-երը աշխատում են անմիջապես դրանց վրա։
Սա կապվում է պահպանման հարցի հետ, որը հանդես է գալիս նաև diskless Kafka-ի դեպքում. որքա՞ն տվյալ է իրականում պետք ֆիզիկապես պատկանի հաշվողական հանգույցին։ ScyllaDB-ի իրականացումը թույլ է տալիս tablet-ի սեփականությունը տեղափոխել՝ փոխանցելով ընդհանուր օբյեկտների հղումներ, ուստի SSTable-ի բովանդակությունը միգրացիայի ընթացքում պետք չէ պատճենել։
Ներկայիս object-storage փաստաթղթերը ուղղված են արխիվային workload-ներին։ Read-երը զգալիորեն ավելի դանդաղ են, քան տեղական պահոցից, և տեղական սկավառակային քեշ չկա։ Հետևաբար query-ի դիպչած SSTable-ների քանակը, latency-ից բացի, ազդում է հեռավոր հասանելիության ծախսերի վրա։
Preview-ն պահանջում է tablet-ներ, ինչպես նաև փոփոխություններ paging-ում, timeout-ներում և tablet-ների հավասարակշռման մեջ։ Առայժմ այն չի աջակցում երկրորդական index-ներ, materialized view-ներ, CDC, LWT, counter-ներ կամ backup/restore։ Կլաստերները, որոնք համատեղում են տեղական և object-ով ապահովված օգտատիրոջ keyspace-ները, նույնպես չեն աջակցվում։ Արդյունքում՝ վերը քննարկված որոնման և CDC հնարավորությունները չեն կարող օգտագործվել այս պահպանման ռեժիմի հետ միասին։
Object storage-ը նաև ավտոմատ կերպով չի պահուստավորում այդ կենդանի SSTable-ները. ScyllaDB-ն հեռացնում է օբյեկտները, երբ նրանց վերջին հղումը վերանում է, և ScyllaDB Manager-ը չի կարող պահուստավորել այդպիսի keyspace-ներ։ Առանց backup-ի սա հնարավորություն է, որը պետք է փորձարկել մեկանգամյա արխիվային տվյալների հավաքածուների վրա։ Tablet-ի սեփականությունը առանց տվյալները պատճենելու տեղափոխելը հնարավորություն է, որին արժե հետևել, քանի որ իրականացումը հասունանում է։
Ինտերֆեյսը ծանոթ է, ներսը՝ ոչ
CQL-ը և wide-column տվյալների մոդելը դեռ կապում են ScyllaDB-ն Cassandra-ի հետ։ Սակայն մակերևույթի տակ երկու տվյալների բազաները գնում են տարբեր ուղիներով՝ index-ների գտնվելու վայրի, այն բանի, թե ինչպես են հավելվածները սպառում փոփոխությունները, և SSTable-ների դասավորության առումով։ Այս որոշումները ձևավորում են query-ների հնարավորությունները, տվյալների թարմությունը և պահպանման ծախսերը։
Նախորդ հոդվածը վերաբերում էր ScyllaDB-ի կատարման մոդելին և կլաստերի կառավարմանը։ Որոնումը, CDC-ն և պահպանումը այդ տարբերությունը տանում են ավելի հեռու՝ հավելվածի ճարտարապետության մեջ։ ScyllaDB-ն «Cassandra C++-ով» անվանելը բաց է թողնում համակարգի աճող մասը։