Diskless Kafka. Ի՞նչ է փոխվում, երբ տվյալներն այլևս բրոքերներինը չեն
Diskless Kafka ճարտարապետությունների ակնարկ, որը համեմատում է, թե ինչպես են KIP-1150-ը, WarpStream-ը, AutoMQ-ն և Redpanda-ն մոտենում Kafka-ի ակտիվ լոգը օբյեկտային պահոցում պահելուն։
Apache Kafka-ն ստեղծվել է հաջորդական I/O-ից առավելագույնս օգտվելու համար։ Պրոդյուսերները գրառումները խմբավորում են բաթչերի, բրոքերները այդ բաթչերը ավելացնում են կարգավորված լոգ-սեգմենտներին, իսկ կոնսյումերները կարդում են անընդմեջ միջակայքեր։ Kafka-ն նաև հենվում է օպերացիոն համակարգի page cache-ի վրա և, որտեղ հնարավոր է, zero-copy տեխնիկաների վրա, ինչպիսին sendfile-ն է։ Ինչպես բացատրում է Kafka-ի նախագծային փաստաթղթավորումը, սա աշխատում է, որովհետև բաթչինգը շատ մանր գործողությունները վերածում է ավելի մեծ հաջորդական կարդալու և գրելու գործողությունների, որոնք պահոցային սարքերն ու օպերացիոն համակարգերը մշակում են արդյունավետ։
Ամպը առաջարկում է պահոցի մեկ այլ տարբերակ։ Օբյեկտային պահոցը տալիս է դիմացկուն, կրկնօրինակված պահոց, որը անկախ է բրոքերների հաշվողական ռեսուրսներից։ Կարո՞ղ է արդյոք Kafka-ն նման ծառայություն օգտագործել ակտիվ լոգի համար՝ թույլ տալով բրոքերներին մասշտաբավորվել առանց դիմացկուն տվյալների բազմությունը տեղափոխելու։
Սա է diskless Kafka-ի գաղափարը. պահպանել Kafka-ի client API-ն, բայց դիմացկուն payload-ի պահպանումը հանել բրոքերների սեփական պարտիցիաների լոգերից։ Իրականացումը դեռ պետք է պահպանի կարգը, նշանակի օֆսեթներ, հետևի committed գրառումներին և արդյունավետ սպասարկի կարդալը։ Յուրաքանչյուր համակարգ այս պատասխանատվությունները բաժանում է յուրովի, և նրանց հնարավորությունների ընդգրկումը տարբեր է։
Upstream-ի կարգավիճակը, 2026 թվականի օգոստոսի 25. KIP-1150-ը ընդունվել է, բայց native Diskless Topics-ը դեռ ընդհանուր հասանելի չեն Apache Kafka-ում։ KIP-1163-ը և KIP-1164-ը, որոնք սահմանում են հիմնական իրականացումը, դեռ քննարկվում են։
Ինչպես են բրոքերն ու լոգը կապված
Դասական Kafka-ում պարտիցիայի լիդերը ստանում է գրառումները, նշանակում է դրանց օֆսեթները և բաթչերը ավելացնում է տեղական լոգ-սեգմենտներին։ Followers-ները կարդում են լիդերից և նույն բաթչերը ավելացնում են իրենց սեփական պահոցում։ acks=all-ի դեպքում պրոդյուսերը հաջող հաստատում ստանում է միայն այն բանից հետո, երբ պահանջվող կրկնօրինակումը կատարվել է։
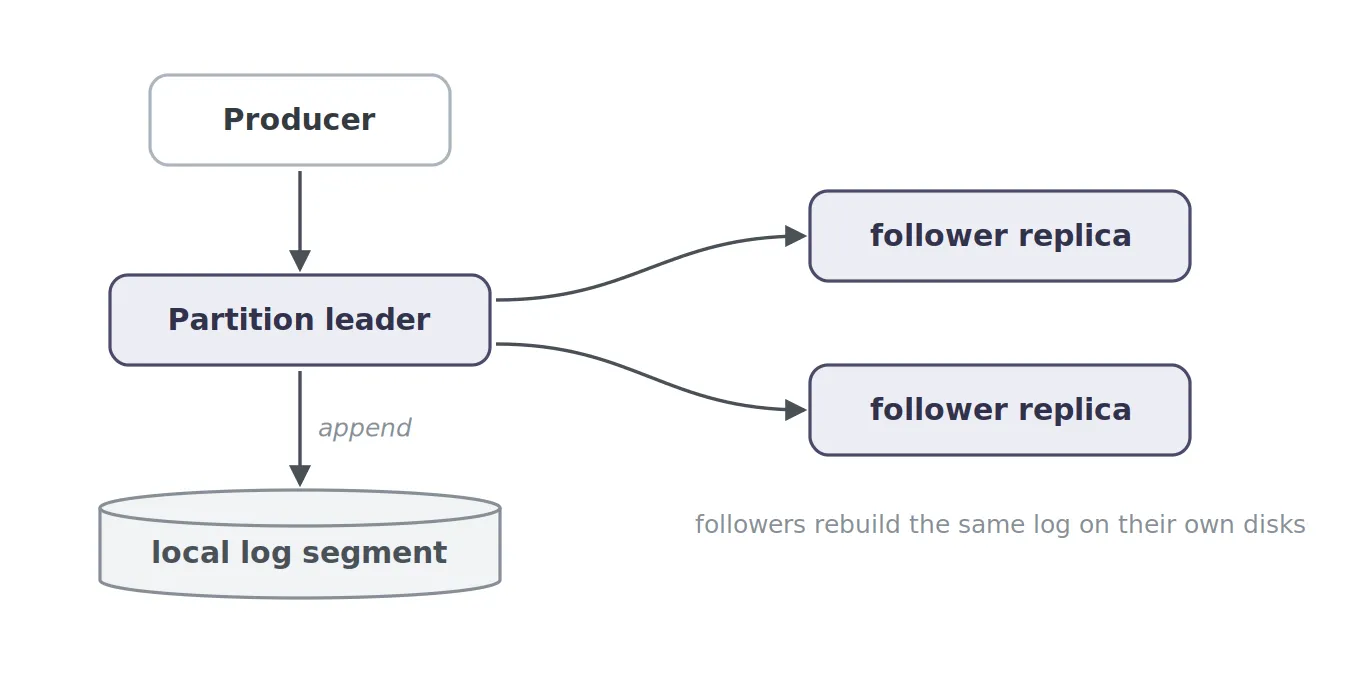
Բաթչինգը կրճատում է ցանցային և համակարգային կանչերի ծանրաբեռնվածությունը, իսկ page cache-ը կարող է սպասարկել վերջին տվյալները՝ առանց ֆիզիկական սկավառակից կարդալու։ Արդյունքում բրոքերը պատասխանատու է և՛ իր պարտիցիաների մշակման, և՛ դրանց տեղական լոգ-սեգմենտների ու replica-ի վիճակի համար։ Ուստի պարտիցիաները այլ տեղ տեղափոխելը հաճախ նշանակում է տեղափոխել նաև դրանց տվյալները։
Ամպը փոխեց պահոցի հավասարումը
Պատկերացրեք կլաստեր, որը ընդգրկում է երեք հասանելիության գոտի (availability zone)։ Լիդերը պահում է յուրաքանչյուր գրառում, և այն պատճենվում է մյուս գոտիներում գտնվող followers-ներին.
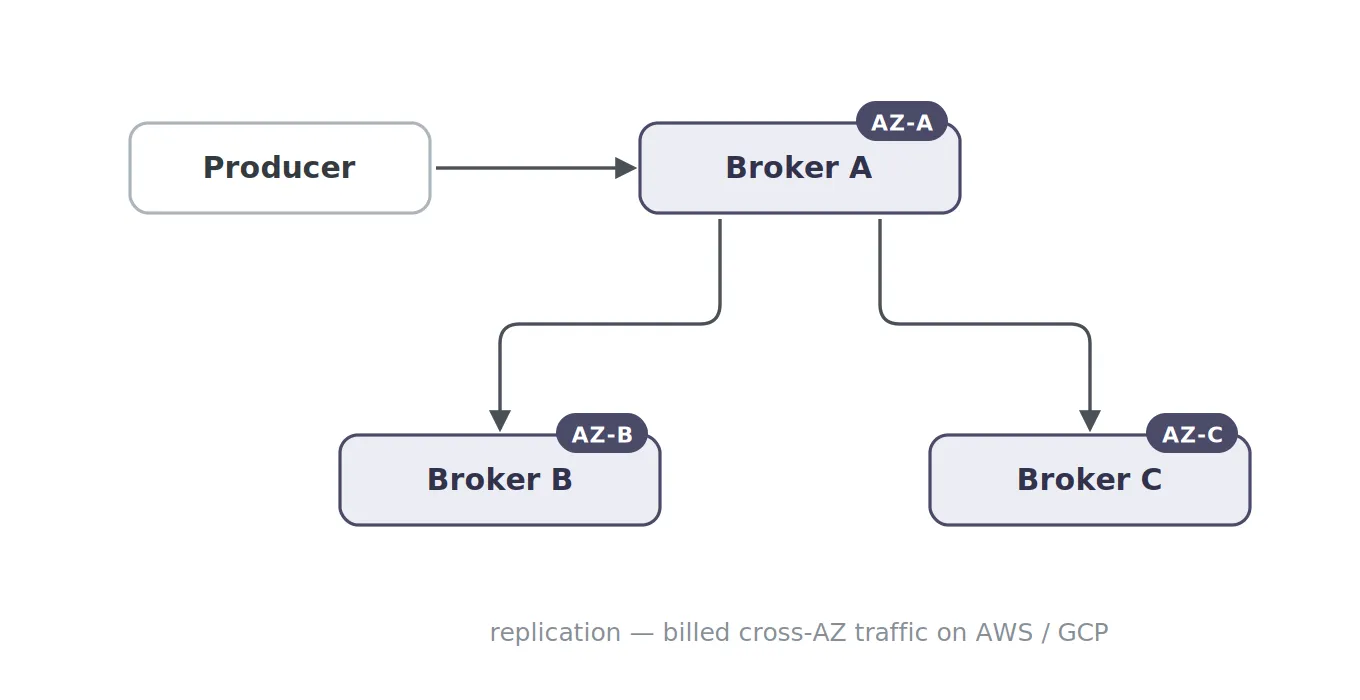
Գոտիների միջև կրկնօրինակումը թույլ է տալիս Kafka-ին դիմանալ գոտու խափանումներին, եթե replica-ների տեղակայումը և հաստատման կարգավորումները դրա համար կոնֆիգուրացված են։ Այն կարող է նաև առաջացնել մեծ քանակությամբ cross-AZ տրաֆիկ, որը KIP-1150-ը նշում է որպես AWS-ի և Google Cloud-ի վրա ծախսերի հիմնական աղբյուր։ Ճշգրիտ տնտեսագիտությունը տարբերվում է ըստ պրովայդերի և ցանցային կարգավորման. payload-ի կրկնօրինակումը ընդհանուր տրաֆիկի հաշվի ընդամենը մեկ բաղադրիչ է։
Յուրաքանչյուր բրոքեր նաև պետք է ունենա բավարար պահոց իրեն հանձնարարված պարտիցիաների համար։ Հզորություն ավելացնելը կարող է ենթադրել պարտիցիաների վերաբաշխում, իսկ կորցրած replica-ի փոխարինումը նշանակում է դրա տվյալների պատճենում։ Տերաբայթավոր պարտիցիոն վիճակ պահող բրոքերը փոխարինելու համար ավելի շատ ժամանակ է պետք, քան այն աշխատողը, որի դիմացկուն վիճակը պահվում է այլ տեղ։ Պահոցի հզորությունն ու տվյալների տեղաշարժը սահմանափակում են, թե որքան արագ կարելի է փոխել հաշվողական հզորությունը։
Amazon S3-ը, Google Cloud Storage-ը և Azure Blob Storage-ը առաջարկում են դիմացկուն պահոց, որը կախված չէ Kafka-ի բրոքերներից։ Համապատասխան տարածաշրջանային պահոցի դասի դեպքում պրովայդերը նաև հոգ է տանում խափանման տիրույթների միջև կրկնօրինակման մասին։ Իմաստալից համեմատությունը այդպիսի ծառայության և Kafka-ի ողջ կրկնօրինակված պահպանման ուղու միջև է։ EBS-ը ինքնին կրկնօրինակում է մեկ հասանելիության գոտու ներսում. Kafka-ի replica-ները կարող են այդ պաշտպանությունը ձգել գոտիների վրա։
KIP-1150-ը առաջարկում է payload-ի դիմացկունությունը հանձնել օբյեկտային պահոցին՝ ակտիվ սեգմենտների կրկնօրինակման և բրոքերների բլոկային պահոցի ծախսը կրճատելու համար։ Փոխվում է այն, թե ով է պատասխանատու կրկնօրինակման համար, և որ տվյալները դեռ պետք է անցնեն Kafka-ի համակարգման մեխանիզմներով։
Diskless Kafka և Tiered Storage
Kafka-ն արդեն օգտագործում է օբյեկտային պահոց Tiered Storage-ի միջոցով։ Ավարտված լոգ-սեգմենտները կարելի է պատճենել հեռավոր պահոց և հետո ջնջել տեղական մակարդակից։ Սակայն ակտիվ սեգմենտը դեռ գտնվում է բրոքերի պահոցում, և followers-ները դեռ կրկնօրինակում են մուտքային գրառումները։
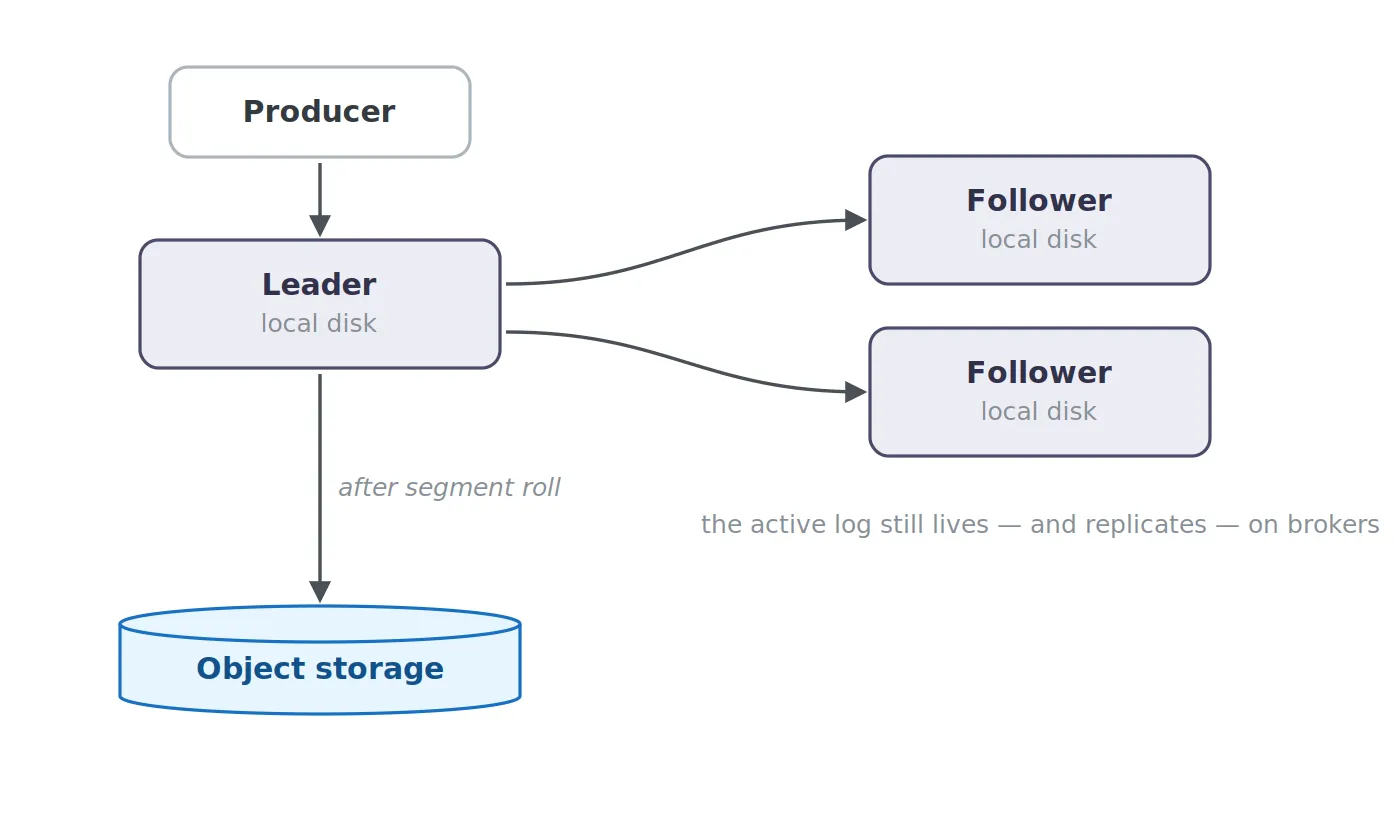
Tiered storage-ը անջատում է պահպանման ժամկետը տեղական սկավառակի հզորությունից, ուստի կլաստերը կարող է պահել ամիսների պատմություն՝ առանց բրոքերների սկավառակները ամբողջ տվյալների համար չափավորելու։ Diskless պահոցը ավելի առաջ է գնում և փոխում է նաև ակտիվ գրելու ուղին.
| Դասական Kafka | Kafka tiered storage-ով | Ուղղակիորեն օբյեկտային պահոց գնացող diskless ուղի | |
|---|---|---|---|
| Ակտիվ payload | Լոգեր բրոքերների վրա | Լոգեր բրոքերների վրա | Ընդհանուր օբյեկտներ |
| Payload-ի կրկնօրինակում | Kafka followers | Kafka followers | Պահոցի պրովայդեր |
| Պատմական payload | Լոգեր բրոքերների վրա | Հեռավոր սեգմենտներ գումարած տեղական մակարդակ | Ընդհանուր օբյեկտներ, հաճախ վերակազմակերպված կարդալու համար |
| Պրոդյուսերի հաստատումը կախված է | Բրոքերի append-ից և կարգավորված հաստատումներից | Նույն ակտիվ ուղուց, ինչ դասական Kafka-ում | Օբյեկտի պահպանումից և մետատվյալների commit-ից |
Որոշ համակարգեր օբյեկտային պահոցի տվյալների բազմության դիմաց դնում են առանձին WAL։ Նման նախագծերում WAL-ը որոշում է, թե երբ կարելի է գրառումը հաստատել. AutoMQ-ի մասին կխոսենք ստորև։
Ինչ է նշանակում «diskless»
Տերմինը փոքր-ինչ մոլորեցնող է։ Diskless-ը պարտադիր չէ նշանակի, որ համակարգում ոչ մի տեղ սկավառակ չկա. նրա իմաստը ավելի նեղ է. բրոքերի տեղական սկավառակը դադարում է օգտատիրոջ տվյալների հիմնական դիմացկուն ճշմարտության աղբյուրը լինել։ KIP-1150-ը լավ է ձևակերպում. diskless-ը «առանց սկավառակների» հետ կապված է մոտավորապես այնպես, ինչպես serverless-ը՝ «առանց սերվերների» հետ։ Սկավառակները դեռ կարող են լինել քեշերի, մետատվյալների կամ ժամանակավոր վիճակի համար, բայց դրանք այլևս այն պահոցային աբստրակցիան չեն, որը օպերատորները պետք է կառավարեն հենց հաղորդագրության payload-ի համար։
Ահա պարզեցված diskless գրելու ուղի.
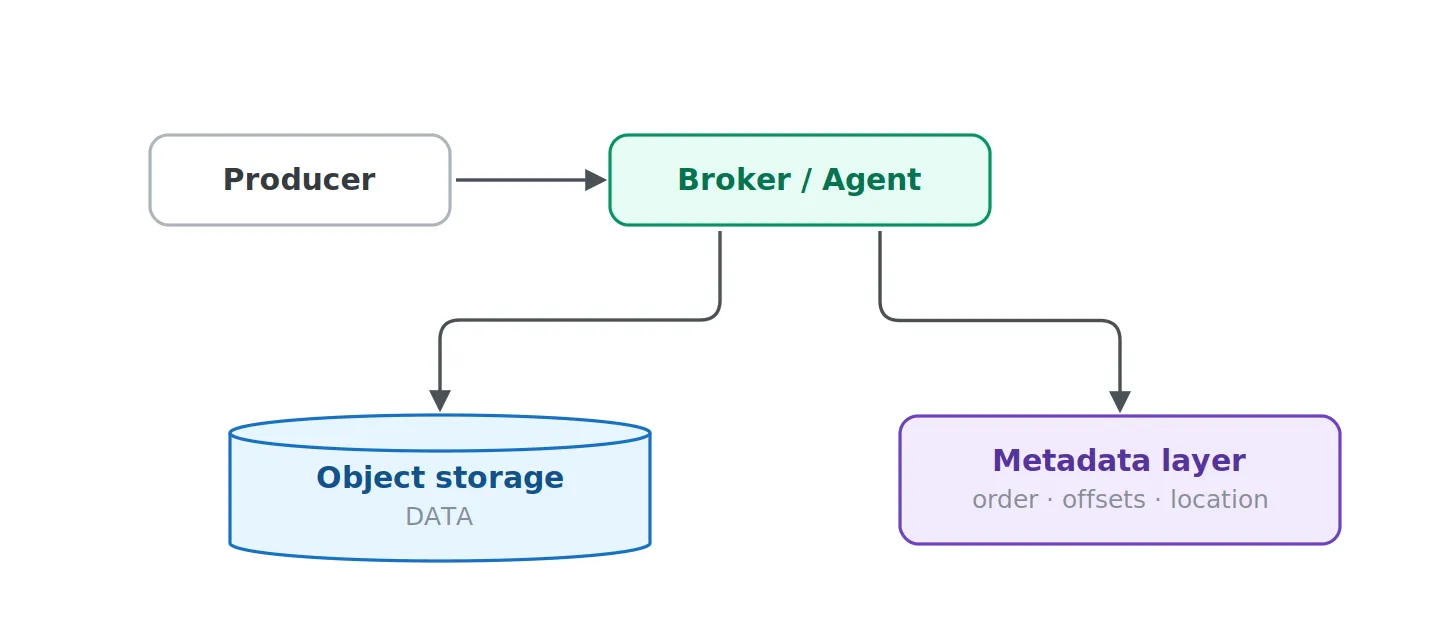
Դասական Kafka-ն payload-ները պահում է իրենց կարգի հետ միասին պարտիցիոն լոգերում։ Diskless համակարգերը երկուսը բաժանում են. օբյեկտային պահոցը պահում է բայթերը, իսկ մետատվյալները որոշում են դրանց կարգը, օֆսեթները և commit-ի կարգավիճակը։
S3-ը Kafka-ի լոգ չէ
Առաջին հայացքից Kafka-ն օբյեկտային պահոցի վրա դնելը թվում է չնչին գործ. վերցրու գրառումը, գրիր S3 և վերջ։ Ցավոք, դա սարսափելի հոսքային ճարտարապետություն կստեղծեր։ Օբյեկտային պահոցները օպտիմիզացված են օբյեկտների, այլ ոչ թե ավելացվող լոգերի համար. սովորաբար ստեղծում ես անփոփոխ օբյեկտներ և հետո վերցնում դրանք. և դրանց գործողությունները գալիս են ոչ աննշան ուշացմամբ և մեկ հարցման արժեքով։
Յուրաքանչյուր Kafka գրառման համար առանձին S3 օբյեկտ գրելը բարձր թողունակության դեպքում շատ արագ կթանկանար։ Մեկ օբյեկտ պրոդյուսերի մեկ բաթչի՞ համար։ Դարձյալ չափազանց շատ օբյեկտներ։ Մեկ օբյեկտ պարտիցիայի համար յուրաքանչյուր մի քանի հարյուր միլիվայրկյանը մեկ։ Այդ դեպքում տասնյակ հազարավոր պարտիցիաներով կլաստերը սկսում է արտադրել փոքրիկ օբյեկտների և PUT գործողությունների տհաճ ծավալ։
Ինչ է նախընտրում օբյեկտային պահոցը.
FEWER
LARGER
OBJECTS
Ինչ է նախընտրում Kafka-ն.
MANY
INDEPENDENT
ORDERED PARTITIONS
Diskless հոսքային մշակումը հետաքրքիր է դառնում հենց այս երկու պահանջների հավաքածուները հաշտեցնելիս։
Ինչպես է diskless Kafka-ն բաթչավորում պարտիցիաների միջև
Diskless Kafka ճարտարապետությունների մեծ մասը հանգում է նույն սկզբնական օպտիմիզացիային. պարտիցիայի համար առանձին օբյեկտ ստեղծելու փոխարեն բաթչավորել բազմաթիվ պարտիցիաների տվյալները միասին։
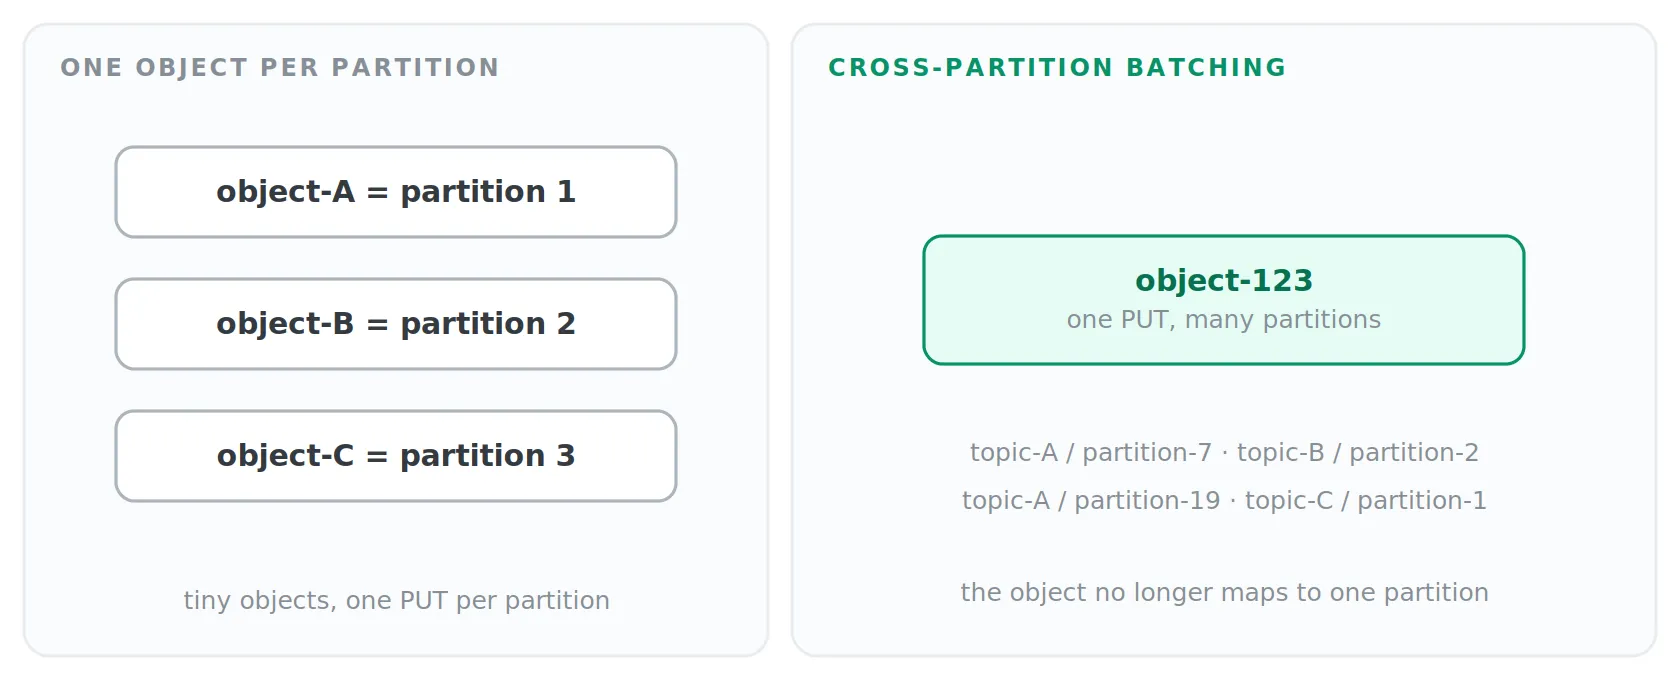
WarpStream-ը դա լավ ցուցադրում է։ Նրա Agents-ները բուֆերացնում են բազմաթիվ client-ներից և պարտիցիաներից եկող պրոդյուսերի տրաֆիկը և այն դատարկում են, երբ հասնում է ժամանակի կամ չափի շեմին. լռելյայն, batch timeout-ը ներկայումս 250 ms է։ Ճշգրիտ լինելու համար, թե ինչ է նշանակում այդ թիվը. դա այն առավելագույն ժամանակն է, որ Agent-ը սպասում է բաթչի լցվելուն, այլ ոչ թե դիմացկուն գրելու ուշացումը. իրական բեռի տակ սովորաբար առաջինը հասնում է չափի շեմին, և պրոդյուսերի հաստատումը նաև պետք է սպասի օբյեկտային պահոցի upload-ին և մետատվյալների commit-ին։ 250 ms-ը ուշացման բյուջեի միայն մի մասն է, որին կվերադառնանք հոդվածում ավելի ուշ։
Մեկ ֆայլը կարող է պարունակել գրառումներ բազմաթիվ տարբեր topic-partition-ներից։ Օբյեկտը նախ պահպանվում է, հետո commit է արվում նրա մետատվյալները, և միայն դրանից հետո է produce հարցումը հաստատվում։ Aiven-ի diskless իրականացումը հետևում է նույն ընդհանուր գաղափարին, իսկ Redpanda Cloud Topics-ը տվյալները տարբեր topic-ների և պարտիցիաների միջև բաթչավորում է այսպես կոչված L0 օբյեկտների մեջ՝ «զրոյական մակարդակ», LSM-tree պահպանման շարժիչներից վերցված անուն չմշակված, նոր ընդունված ֆայլերի համար, նախքան թեթև մետատվյալները Raft-ում պահելը։ Հիշեք այս տերմինը. մակարդակները դեռ կհայտնվեն։
Մի քանի թիմեր այս նախագծին եկան ինքնուրույն, քանի որ պարտիցիաների միջև բաթչինգը օբյեկտային պահոցի գործողության արժեքը բաշխում է արժանի ծավալի տվյալների վրա։ Թերությունն այն է, որ ֆիզիկական օբյեկտն այլևս կոկիկ չի համապատասխանում Kafka-ի պարտիցիային։
Ֆիզիկական Kafka լոգը պարզապես անհետացավ
Դասական Kafka-ում partition-7.log-ը պարունակում է 7-րդ պարտիցիայի գրառումները՝ կարգով։ Ֆիզիկական պահպանման դասավորությունը և տրամաբանական Kafka լոգը սերտորեն կապված են։ Այժմ նայեք մեր diskless օբյեկտին.
object-123

P7 | P2 | P19 | P1 | P7
և այլ բրոքերի վրա, որը գրում է նույն պահին.
object-124

P1 | P7 | P5 | P19
P7-ի ո՞ր բաթչն է առաջինը։ Օբյեկտների անունները չեն կարող ասել, upload-ի ավարտի ժամանակը բավարար չէ, և օբյեկտն ինքն էլ չի կարող ասել։ Օբյեկտային պահոցը պահում է բայթեր, բայց Kafka-ի աբստրակցիան ավելին է պահանջում. topic, պարտիցիա, օֆսեթ, կարգ։ Ուստի diskless համակարգին պետք է լրացուցիչ կառուցվածք, որը տրամաբանական լոգը արտապատկերում է ֆիզիկական պահոցի վրա՝ մոտավորապես այսպես.
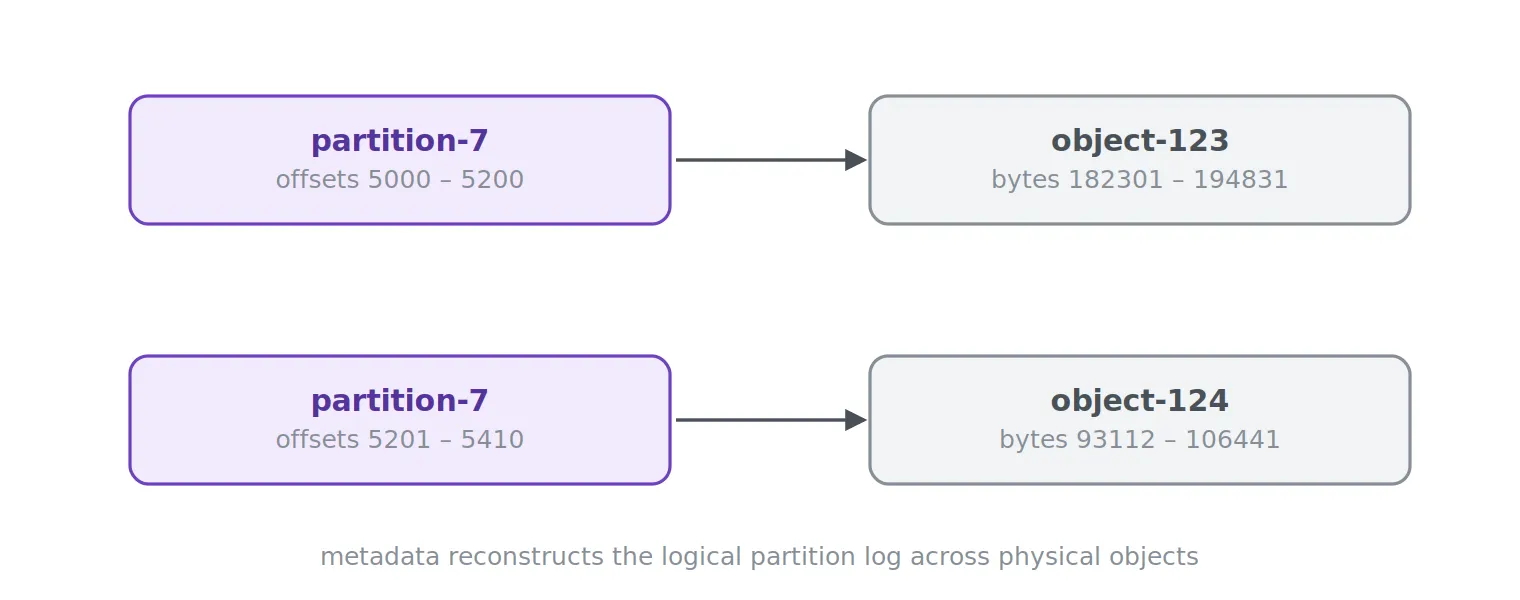
Ֆիզիկական պարտիցիոն լոգը հանելուց հետո մենք այժմ պետք է մետատվյալներից վերակառուցենք տրամաբանական պարտիցիոն լոգ։ Նկատեք, թե ինչ ենք իրականում կառուցում այստեղ. լոգ, որը գոյություն ունի զուտ որպես ուժեղ համահունչ մետատվյալներ ընդհանուր օբյեկտների վրա, այլ խոսքով՝ բաշխված տվյալների բազա, որը խոսում է Kafka-ի արձանագրությամբ։
Մետատվյալները սահմանում են committed լոգը
Կարգը մետատվյալներ են։ Օֆսեթների նշանակումը մետատվյալներ է։ Օֆսեթների և օբյեկտների տեղակայումների արտապատկերումը մետատվյալներ է։ Տրանզակցիաները պահանջում են մետատվյալներ, իդեմպոտենտ պրոդյուսերները պահանջում են վիճակ, retention-ը ի վերջո փոփոխում է մետատվյալները, compaction-ը փոփոխում է մետատվյալները, և աղբի հավաքումը հենվում է վերը նշված բոլորի վրա։ Diskless Kafka իրականացումը կարող է հաղորդագրությունների payload-ների կրկնօրինակումը հանձնել S3-ին, բայց չի կարող Kafka-ի սեմանտիկան հանձնել S3-ին։ Այլ խոսքով՝ diskless Kafka-ն չի վերացնում կոնսենսուսը, այլ այն տեղափոխում է այլ տեղ։ Payload-ի դիմացկունությունը կարող է տեղափոխվել օբյեկտային պահոց, բայց համակարգին դեռ պետք է ուժեղ համահունչ տեղ, որը որոշում է, թե ինչ է գտնվում յուրաքանչյուր օֆսեթում և որ գրառումներն են committed։
Այս պահին ողջամիտ առարկություն է առաջանում. մի՞թե մետատվյալների շերտը պարզապես սկզբնական կրկնօրինակման խնդիրը չէ նոր դիմակով։ Մասամբ՝ այո, և այս նախագծերից ոչ մեկը այլ բան չի պնդում։ Մետատվյալների պահոցը ինքնին կրկնօրինակված, ուժեղ համահունչ համակարգ է, և այն մշակում է commit յուրաքանչյուր բաթչի համար, ուստի համակարգման գործողությունների քանակը մնում է նույնը։ Տարբերվում է յուրաքանչյուր գործողության բովանդակությունը. payload-ի փոխարեն՝ օբյեկտը և նրա օֆսեթների միջակայքերը նկարագրող ցուցիչի չափի գրառում։ Cross-AZ տրաֆիկը գանձվում է ըստ բայթի, այլ ոչ թե ըստ գործողության, ուստի կրկնօրինակվող միավորը գրառումների մեգաբայթերից մեկ մետատվյալների մուտքի իջեցնելը հենց այն է, որտեղից գալիս է խնայողությունը, իսկ պարտիցիաների միջև բաթչինգը commit-ների հաճախականությունը կապում է բաթչերի, այլ ոչ թե առանձին գրառումների հետ։ Diskless Kafka-ն չի խուսափում կրկնօրինակումից. այն սահմանափակում է այն փոքր տվյալներով, որոնք իսկապես կոնսենսուս են պահանջում։ Այս հոդվածում ավելի ուշ Apache Kafka-ի սեփական առաջարկը հանգում է նույն եզրակացության. diskless coordinator-ը պահում է իր վիճակը կրկնօրինակված ներքին Kafka topic-ում։
Տարբեր իրականացումներ, տարբեր սահմաններ
«Diskless Kafka»-ն դառնում է կատեգորիա, այլ ոչ թե մեկ կոնկրետ ճարտարապետություն։ Ստորև բերված յուրաքանչյուր իրականացում payload-ը հանում է Kafka-ի ավանդական կրկնօրինակված տեղական լոգից, բայց դրանք բրոքերներում պահում են վիճակի տարբեր քանակություն և ավելացնում են մետատվյալների տարբեր ուղիներ։
| Համակարգ | Դիմացկուն payload-ի ուղի | Կարգի / մետատվյալների ուղի | Բրոքերի մոդել |
|---|---|---|---|
| WarpStream | Ուղիղ օբյեկտային պահոց | Առանձին, ուժեղ համահունչ մետատվյալների պահոց | Stateless Agents |
| AutoMQ | Նախ WAL, հետո օբյեկտային պահոց | S3Stream / Kafka մետատվյալներ | Stateless բրոքերներ |
| Redpanda Cloud Topics | Օբյեկտային պահոց | Per-partition Raft placeholder-ներ գումարած ընդհանուր metastore | Stateful մետատվյալներ, payload-ը ամպում |
| Confluent Freight | Ուղիղ գրառումներ օբյեկտային պահոց | Kora-ի ներքին մասեր | Կառավարվող իրականացում |
| Aiven Diskless | Օբյեկտային պահոց | Batch Coordinator | Առանց լիդերի տվյալների ուղի |
| Apache Kafka-ի առաջարկ (KIP-1163) | Օբյեկտային պահոցի WAL սեգմենտներ, հետագայում միաձուլվող օբյեկտների մեջ | Առաջարկվող Diskless Coordinator | Պլանավորվող հիբրիդ topic մոդել |
WarpStream. գրել անմիջապես օբյեկտային պահոց
WarpStream-ը, կարելի է ասել, գաղափարն իրականացնում է իր ամենաթողարկ ձևով։ Նրա Kafka-ի հետ համատեղելի Agents-ները տեղական սկավառակներ չեն պահանջում. նրանք գրում են ուղիղ օբյեկտային պահոց, իսկ մետատվյալները պահվում են WarpStream-ի առանձին մետատվյալների շերտում։ Քանի որ ոչ մի Agent չի տիրապետում դիմացկուն պարտիցիոն տվյալների, հաշվողական հանգույցները կարելի է ավելացնել կամ հեռացնել՝ առանց պահված լոգը տեղափոխելու։
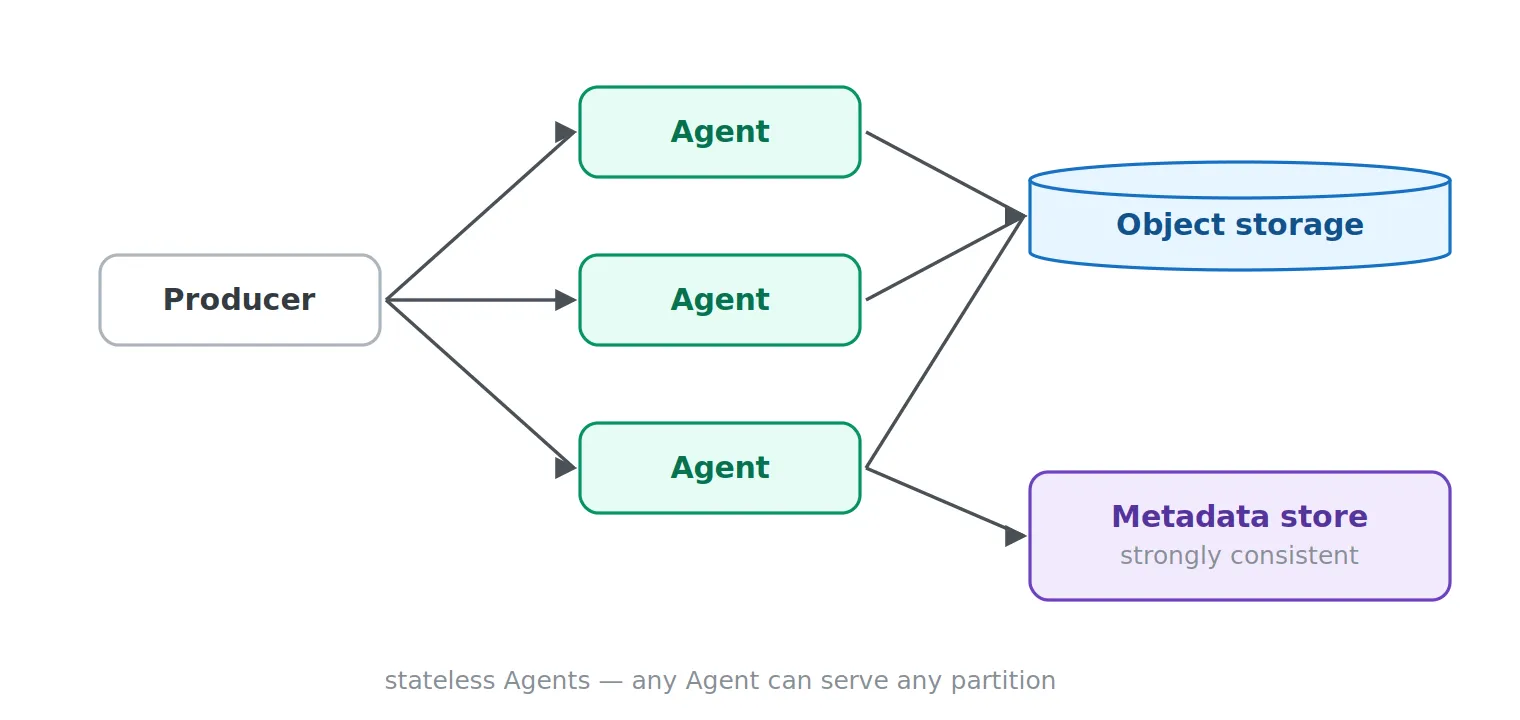
Յուրաքանչյուր Agent կարող է սպասարկել յուրաքանչյուր պարտիցիա, ինչը խզում է պարտիցիայի սեփականության և դիմացկուն պահոցի սովորական կապը։ Փոխզիջումը նույնքան ուղիղ է. օբյեկտային պահոցը հաստատման ուղու մաս է, ուստի ուշացումը և օբյեկտային պահոցի հարցումների տնտեսագիտությունը դառնում են նախագծային հիմնական սահմանափակումներ։ WarpStream-ը նկարագրում է ճարտարապետությունը իր write-path և read-path ուղեցույցներում։
AutoMQ. ավելացնել WAL
AutoMQ-ն ընտրում է այլ փոխզիջում։ Այն ընդունում է, որ օբյեկտային պահոցը պետք է պահի իրական տվյալների բազմությունը, բայց ավելացնում է WAL՝ պահպանումն ու վերականգնումը արագացնելու համար.
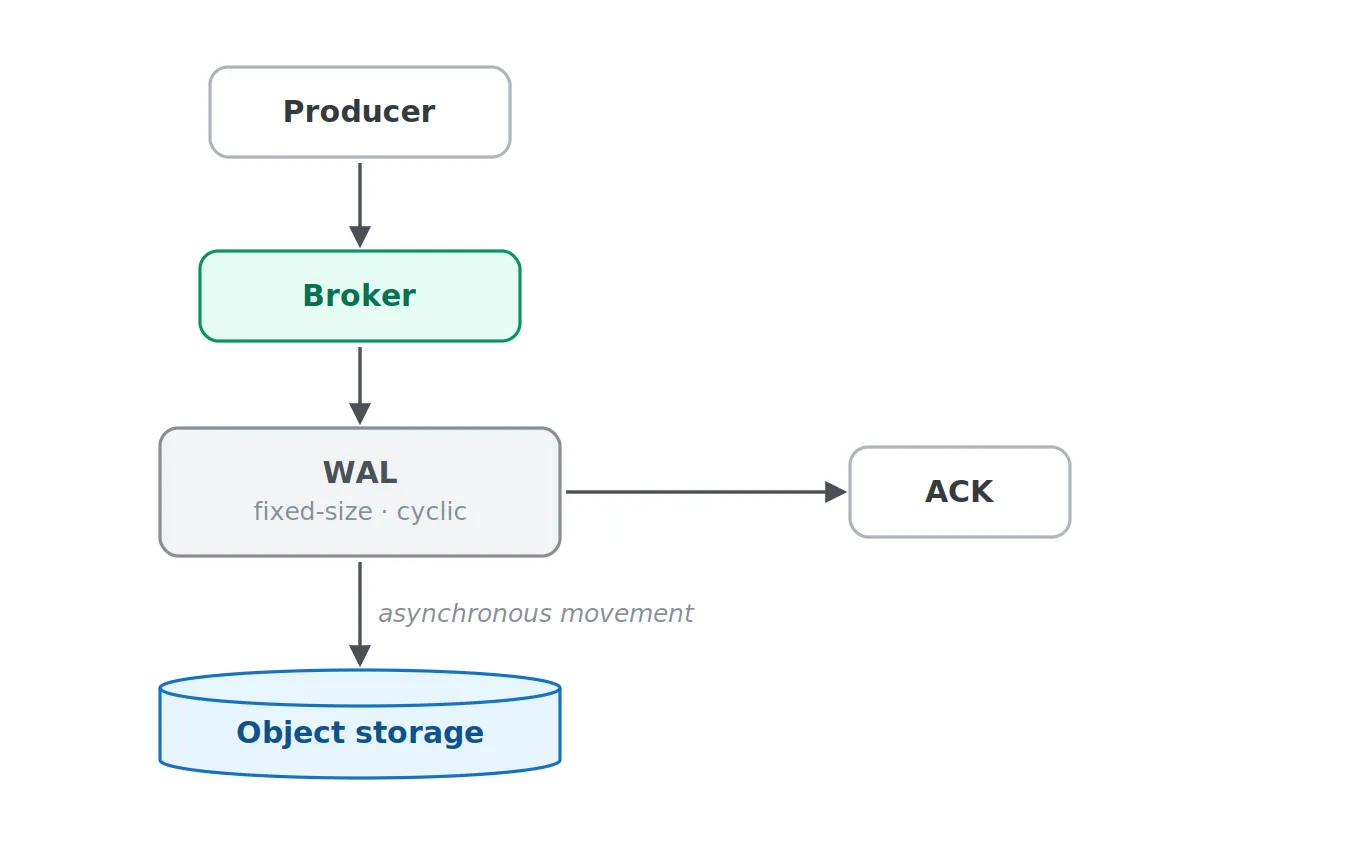
Հետաքրքիր է, որ WAL-ը բաժանվում է բազմաթիվ պարտիցիաների գրառումների միջև՝ Kafka-ի ավանդական per-partition լոգի կառուցվածքը պահպանելու փոխարեն։ AutoMQ-ի խոսքով, այն ֆիքսված չափի է և ցիկլային, օգտագործում է հաջորդական գրառումներ և group commit-ներ։ Այսպիսով, նույնիսկ երբ Kafka-ն հեռացել է բրոքերների սեփական պարտիցիոն լոգերից, նույն օպտիմիզացիան նորից հայտնվում է այլ շերտում։ Օբյեկտային պահոցը փոխում է դիմացկուն տվյալների բազմության գտնվելու վայրը, բայց չի չեղարկում հաջորդական I/O-ի առավելությունները։
Ակնհայտ հաջորդ հարցը այն է, թե ինչպես է կրկնօրինակվում հենց WAL-ը, և պատասխանն այն է, որ AutoMQ-ն դիտավորյալ չի կրկնօրինակում այն։ Նրա հայտարարված նախագծային սկզբունքը դիմացկունության համար հենվել ամպային պահոցի վրա է՝ Raft-ի նման կրկնօրինակման արձանագրություն աշխատեցնելու փոխարեն. EBS-ով ապահովված WAL-ի դեպքում դիմացկունությունը գալիս է volume-ի ներկառուցված կրկնօրինակումից, և եթե բրոքերը խափանվում է, նրա «որբացած» volume-ը պարզապես կցվում է այլ բրոքերի, որը չհասցված WAL գրառումները դատարկում է S3. S3-ով ապահովված WAL-ի դեպքում (բաց կոդով լռելյայն տարբերակ) WAL օբյեկտներն արդեն գտնվում են օբյեկտային պահոցում, ուստի նոր բրոքերը դրանք վերականգնում է ուղղակիորեն։ AutoMQ-ն օգտագործում է կոնսենսուս, բայց միայն այն նույն տեղում, ինչ այս հոդվածի մյուս բոլոր համակարգերը՝ մետատվյալների հարթությունում, որտեղ AutoMQ-ն վերօգտագործում է Kafka-ի KRaft-ը։
Redpanda Cloud Topics. պահպանել per-partition Raft մետատվյալները
Redpanda-ն հետևում է հիբրիդ մոտեցման, որը անվանում է «disk-lite». payload-ները հայտնվում են օբյեկտային պահոցում, մինչդեռ կարևոր մետատվյալները դեռ անցնում են տեղական Raft-ով։
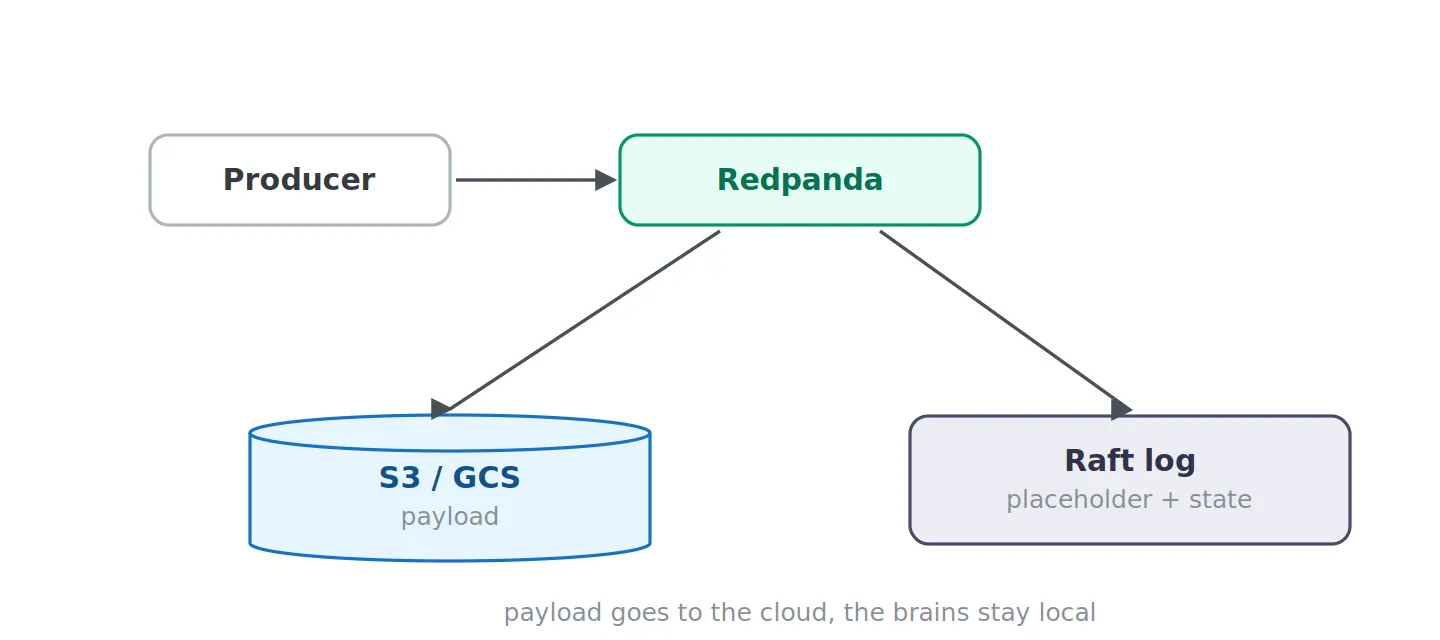
Երբ L0 օբյեկտը դառնում է դիմացկուն, Redpanda-ն placeholder մետատվյալներ է գրում համապատասխան պարտիցիայի Raft լոգում և հետո հաստատում է պրոդյուսերին։ Մտածեք, թե սա ինչ է նշանակում բրոքերի վիճակի համար. placeholder լոգը դեռ per-partition Raft լոգ է, որը հյուրընկալված է կոնկրետ բրոքերների վրա, ուստի յուրաքանչյուր բրոքեր մնում է կոնկրետ Raft խմբերի անդամ և պահում է տեղական մետատվյալների վիճակ, ձայներ և լիդերի դերեր։ Այդ վիճակը փոքր է. ցուցիչներ՝ payload-ների փոխարեն, բայց այն Redpanda-ի բրոքերը դարձնում է ավելի քիչ փոխարինելի, քան WarpStream-ի Agent-ը, քանի որ Agent-ը ոչ մի պարտիցիոն վիճակ չի պահում. նրա մետատվյալները ամբողջությամբ գտնվում են առանձին մետատվյալների ծառայության մեջ։ Սա է նշանակում, որ Redpanda-ի մոդելը ավելի շատ վիճակ է պահում բրոքերներում. դիտավորյալ փոխզիջում, քանի որ մետատվյալների լոգը բրոքերների ներսում պահելը թույլ է տալիս Redpanda-ին վերօգտագործել իր առկա տրանզակցիաների, իդեմպոտենտության և համահունչության մեխանիզմը։ Cloud Topics-ը 2026 թվականին հասել է ընդհանուր հասանելիության Redpanda 26.1-ում և կարող է աշխատել տեղական և tiered պահոցի ռեժիմների կողքին մեկ կլաստերի շրջանակներում։
Confluent Freight. ուղիղ գրառում թողունակության վրա կողմնորոշված բեռների համար
Confluent-ը ինքնուրույն շարժվել է նույն ուղղությամբ։ Freight կլաստերները հենվում են Kora շարժիչի direct-write ռեժիմի վրա, որում payload տվյալները գնում են օբյեկտային պահոց, այլ ոչ թե նախ դիմացկուն կերպով կրկնօրինակվում բրոքերների տեղական պահոցում։ Confluent-ը Freight-ը նպատակաուղղում է բարձր թողունակության բեռների համար, ինչպիսիք են լոգերը, observability-ն և վերլուծական ingestion-ը, դիտավորյալ հրաժարվելով 100 ms-ից ցածր ուշացումից՝ ի փոխարեն գրելու ուղիների, որոնք կարող են տևել մինչև մոտ մեկ կամ երկու վայրկյան։
Aiven Diskless. առանձին Batch Coordinator
Aiven-ը շահագործում է Inkless իրականացումը, որի ներդրողները ներգրավված են նաև upstream diskless KIP-երում։ Նրա payload գրելու ուղին լիդեր չունի. բրոքերները upload են անում բաթչավորված գրառումները, իսկ Batch Coordinator-ը նշանակում է օֆսեթները և հետևում, թե որտեղ են դրանք պահվում։ Այս համակարգման շերտի համար Aiven-ը օգտագործում է PostgreSQL՝ ի տարբերություն upstream-ում առաջարկվող ներքին Kafka topic-ի և տեղական SQLite վիճակի։ Տես Aiven-ի ճարտարապետությունը։
Դասական և diskless topic-ները կարող են գոյակցել նույն Standard Kafka ծառայության մեջ։ Aiven-ը փաստաթղթավորում է սահմանափակ հասանելիություն Aiven Cloud-ում և աջակցություն ընտրված -inkless BYOC պլաններում։ Իրականացումն ունի էական հնարավորությունների սահմանափակումներ. տրանզակցիաները, compacted diskless topic-ները և Kafka Streams state store-երը չեն աջակցվում։ Դասական topic-ը կարելի է փոխարկել diskless-ի փաստաթղթավորված միգրացիայի ուղով, բայց հակառակ փոխարկումը չի աջակցվում։ Տես ակնարկը, սահմանափակումները և միգրացիայի ուղեցույցը։
Ինչ է առաջարկում Apache Kafka-ն
Հավանաբար այն ամենաուժեղ ազդանշանը, որ այս ճարտարապետությունը էական է, KIP-1150. Diskless Topics-ն է։ Apache Kafka համայնքը նրա կարգավիճակը սահմանել է Accepted՝ 2026 թվականի մարտի 2-ին։ Ընդունումը որոշում է այն մասին, թե ուր է գնում Kafka-ն, այլ ոչ թե մատակարարված հնարավորություն. Kafka-ն պետք է աջակցի topic-ների, որոնց օգտատիրոջ payload-ը դիմացկուն կերպով պահվում է օբյեկտային պահոցում՝ բրոքերի բլոկային պահոցի և payload-ի ուղղակի կրկնօրինակման վրա հենվելու փոխարեն։
Իրականացման նախագծումը դեռ ընթացքի մեջ է։ 2026 թվականի օգոստոսի 25-ի դրությամբ և՛ KIP-1163. Diskless Core-ը, և՛ KIP-1164. Diskless Coordinator-ը ունեն Under Discussion կարգավիճակ։ KIP-1165-ը, որը վերաբերում է diskless տվյալների օբյեկտների compaction-ին, ավելի վաղ մերժվել էր, բայց վերաբացվեց 2026 թվականի հուլիսին և կրկին Under Discussion է։ KIP-1176-ը՝ այլընտրանք, որը պահպանում էր դասական կրկնօրինակման ուղու ավելի մեծ մասը, Withdrawn է. KIP-1183-ը՝ AutoMQ-ի ներդրողների առաջ քաշած ընդհանուր պահոցի ավելի լայն աբստրակցիա, դեռ առանձին առաջարկ է՝ Under Discussion։ Առաջարկների այս ողջ ընտանիքի ակնարկը պահվում է համայնքի կողմից Saving Cross-AZ Replication Costs KIPs wiki էջում։
Այս տարբերությունը կարևոր է Apache Kafka-ն ինքնին գնահատող յուրաքանչյուրի համար. KIP-1150-ը ընդունվել է, բայց native upstream Diskless Topics-ը այսօր Kafka 4.3-ի ընդհանուր հասանելի հնարավորություն չեն։
KIP-1163-ը նկարագրում է հետաքրքիր գրելու ուղի. բրոքերները կարող են բուֆերացնել մի քանի diskless պարտիցիաների բաթչերը, հավաքել ընդհանուր WAL սեգմենտ, upload անել օբյեկտային պահոց և հետո coordinator-ին commit անել այդ բաթչերը նկարագրող կոորդինատները. coordinator-ը նշանակում է գլոբալ պարտիցիոն կարգը և օֆսեթները։ Հայեցակարգորեն.
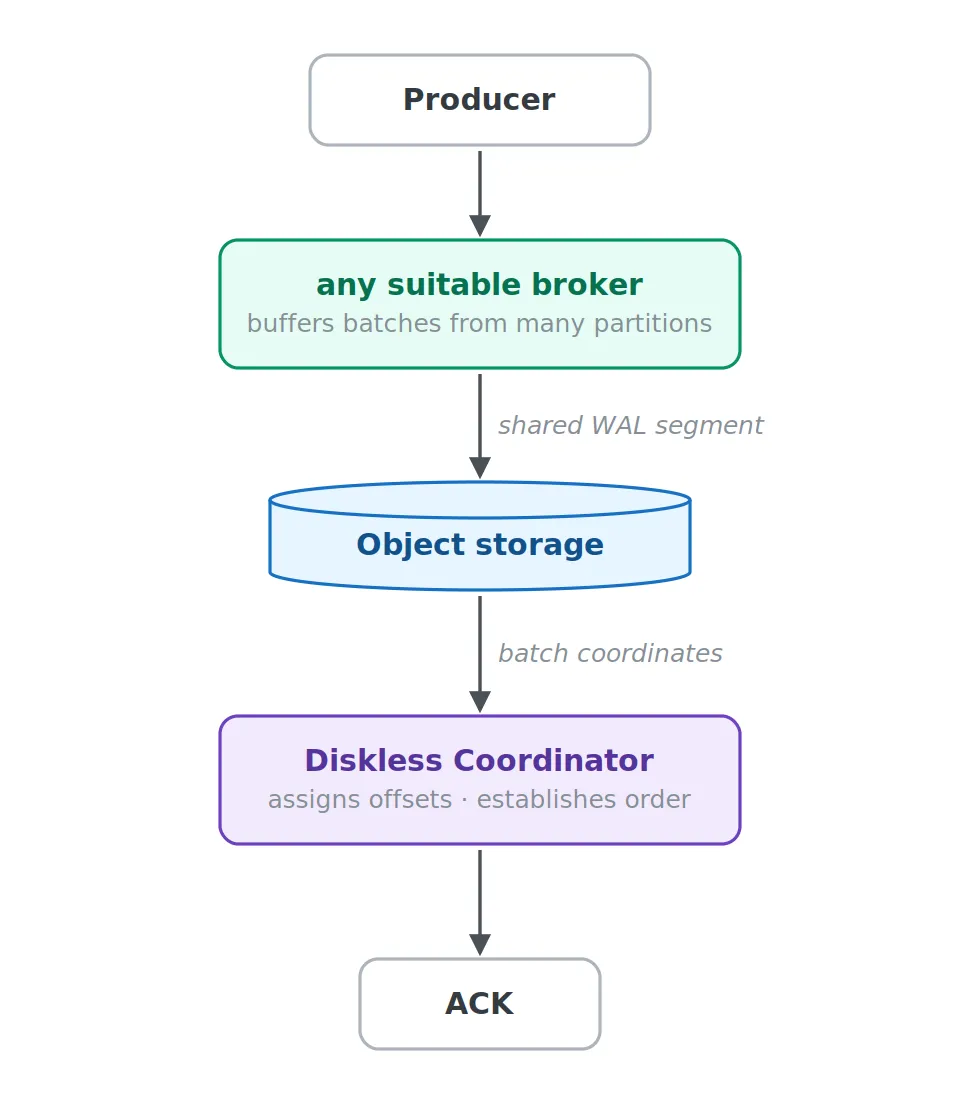
Սրա մեջ կա պատմական հեգնանք։ Kafka-ն սկսվեց գեղեցիկ պարզ պահպանման մոդելով. լոգ ֆայլը հենց լոգն է։ Առաջարկվող diskless ուղում օբյեկտները պահում են բայթերը, իսկ մետատվյալները որոշում են, թե ինչպես են այդ բայթերը կազմում Kafka լոգ։
Ինչու է առաջարկվող coordinator-ը օգտագործում SQLite
KIP-1164-ը ներառում է ողջ diskless Kafka նախագծի ամենաբացահայտող մանրամասներից մեկը։ Առաջարկը ավելացնում է ներքին Kafka topic՝ __diskless_metadata, որը ծառայում է որպես diskless մետատվյալների ճշմարտության աղբյուր։ Ակնկալվում է, որ coordinator-ի վիճակը կհասնի հարյուրավոր մեգաբայթերի կամ նույնիսկ գիգաբայթերի, ուստի այդ ամենը հիշողության մեջ պահելը գրավիչ չէ։ Այդ պատճառով առաջարկը մետատվյալների լոգը materialize է անում տեղական SQLite տվյալների բազայի մեջ՝ ինդեքսավորված մուտք ապահովելու համար։ Kafka-ն մնում է դիմացկուն ճշմարտության աղբյուր, իսկ SQLite-ը տեղական վիճակի պահոց է, որը կարելի է վերակառուցել։
Հնարավոր ապագա Kafka բրոքերը ուստի կարող է այսպիսի տեսք ունենալ.
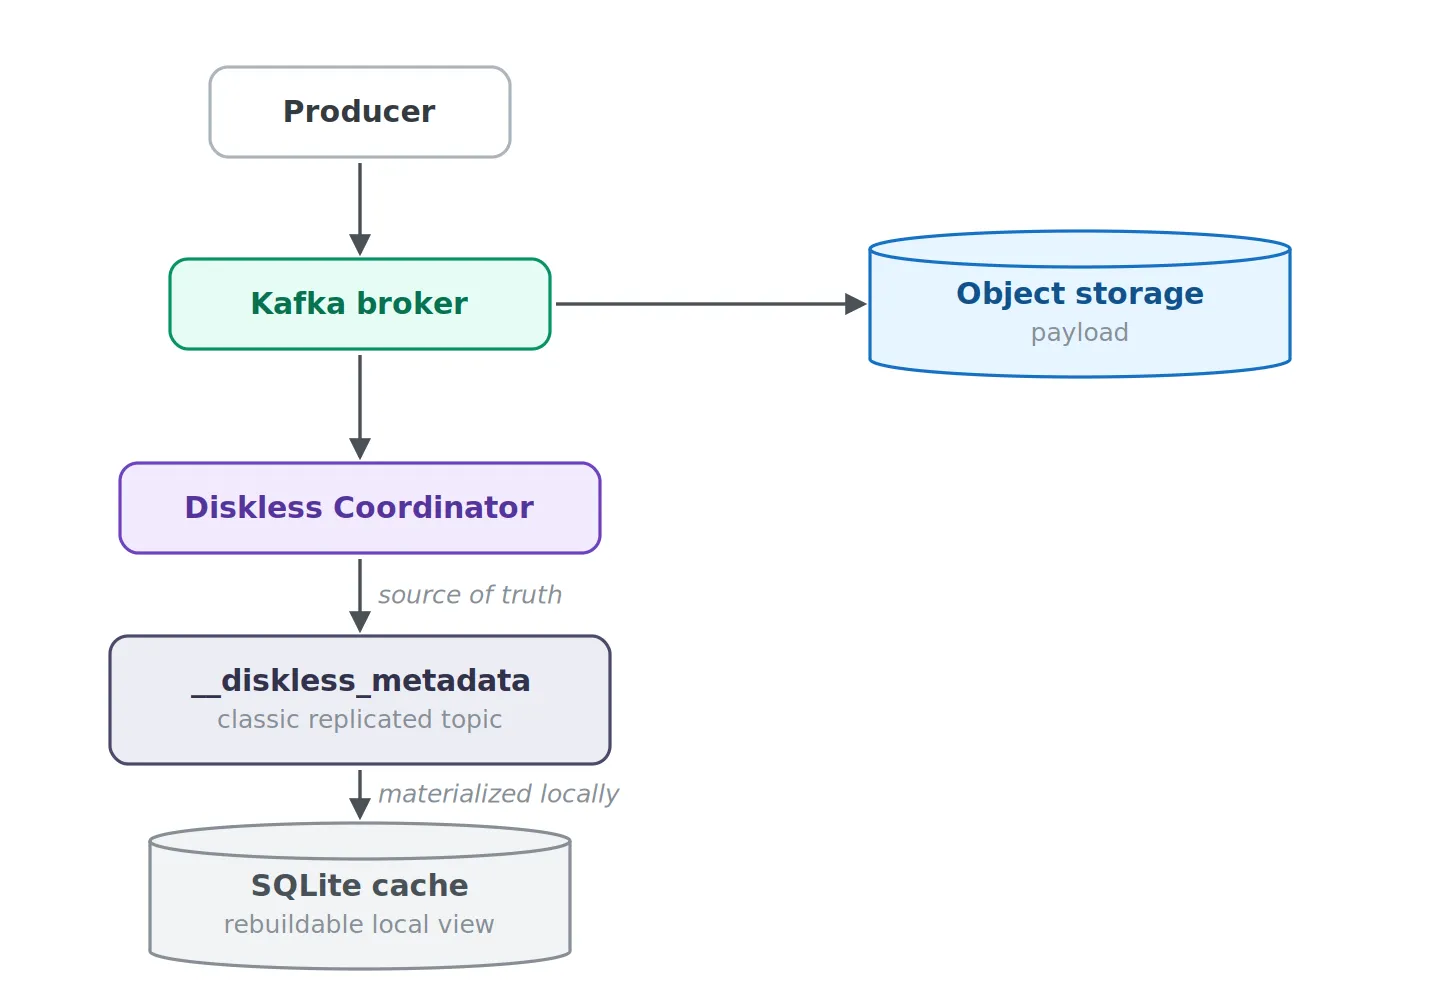
Դիագրամը պահանջում է մեկ պարզաբանում, քանի որ հեշտ է հակառակը ենթադրել. __diskless_metadata-ն ինքը դասական Kafka topic է, որը կրկնօրինակվում է բրոքերների սկավառակների վրա սովորական եղանակով, այլ ոչ diskless topic։ Սա դիտավորյալ է երկու պատճառով։ Diskless topic-ը հենվում է coordinator-ի վրա, ուստի coordinator-ի սեփական պահոցը չպետք է հենվի diskless topic-ների վրա։ Եվ մետատվյալները դասական կրկնօրինակման ուղու վրա պահելը խուսափում է commit-ի ժամանակ օբյեկտային պահոցի լրացուցիչ գրառումից. պրոդյուսերը դեռ սպասում է payload-ի upload-ին։ KIP-ի ռիսկերի վերլուծությունը հստակ նշում է հետևանքը. եթե մետատվյալների topic-ը կորցնում է չափազանց շատ in-sync replica-ներ, diskless գրառումները կանգ են առնում։ Օբյեկտային պահոցը իրոք դեր ունի մետատվյալների պատմության մեջ, բայց օժանդակ. առաջարկը թույլ է տալիս coordinator-ի վիճակի պարբերական snapshot-ները պահել օբյեկտային պահոցում, այնպես որ ներքին topic-ը պետք է պահի միայն վերջին snapshot-ից հետո եղած դելտաները։
Aiven-ի արտադրական իրականացումը ներկայումս ընտրում է այլ կերպ. նրա Batch Coordinator-ը կառուցված է PostgreSQL-ի վրա, մինչդեռ upstream առաջարկը որպես ճշմարտության աղբյուր հենվում է Kafka-ի սեփական ներքին topic-ի վրա, իսկ որպես տեղական materialized վիճակ՝ SQLite-ի։ Մանրամասները տարբերվում են, բայց ուղղությունը նույնն է։ Երբ payload-ի պահոցը էժան է և ընդհանուր, բարդ ինժեներական աշխատանքը տեղափոխվում է մետատվյալներ, կարգ և վերականգնում։
Օբյեկտների վերակազմակերպում կարդալու համար
Պարտիցիաների միջև բաթչինգը լուծում է գրելու ուղին, բայց, ցավոք, վնասում է կարդալու ուղուն։ Ասենք՝ տվյալները ներմուծում ենք նոր գրված level-zero օբյեկտ, ինչպիսին նկարագրվել էր ավելի վաղ.
L0 object

P1 P7 P3 P18 P1 P9 P7 P2 P18 P1
Գրելու համար սա հիանալի է. մեկ, ողջամտորեն մեծ օբյեկտային պահոցի PUT-ը կրում է բազմաթիվ պարտիցիաների տվյալներ։ Սակայն երբ կոնսյումերը ցանկանում է վերարտադրել P7 պարտիցիան, համակարգը կարող է ստիպված լինել գտնել և range-read անել բազմաթիվ առանձին օբյեկտներ՝ պարզապես մեկ պարտիցիայի հաջորդական պատմությունը վերակառուցելու համար։ Ահա թե ինչու diskless համակարգերը հաճախ ներմուծում են ևս մեկ տվյալների բազայի նման հասկացություն՝ ֆոնային վերակազմակերպում։ Այստեղ L0-ի «մակարդակը» արդարացնում է իրեն. Redpanda-ում ֆոնային Reconciler-ը այդ level-zero օբյեկտները վերագրում է ավելի մեծ L1 ֆայլերի մեջ, որտեղ տվյալները տեղակայված են միասին և դասավորված ըստ պարտիցիայի և օֆսեթի։ Հայեցակարգորեն.
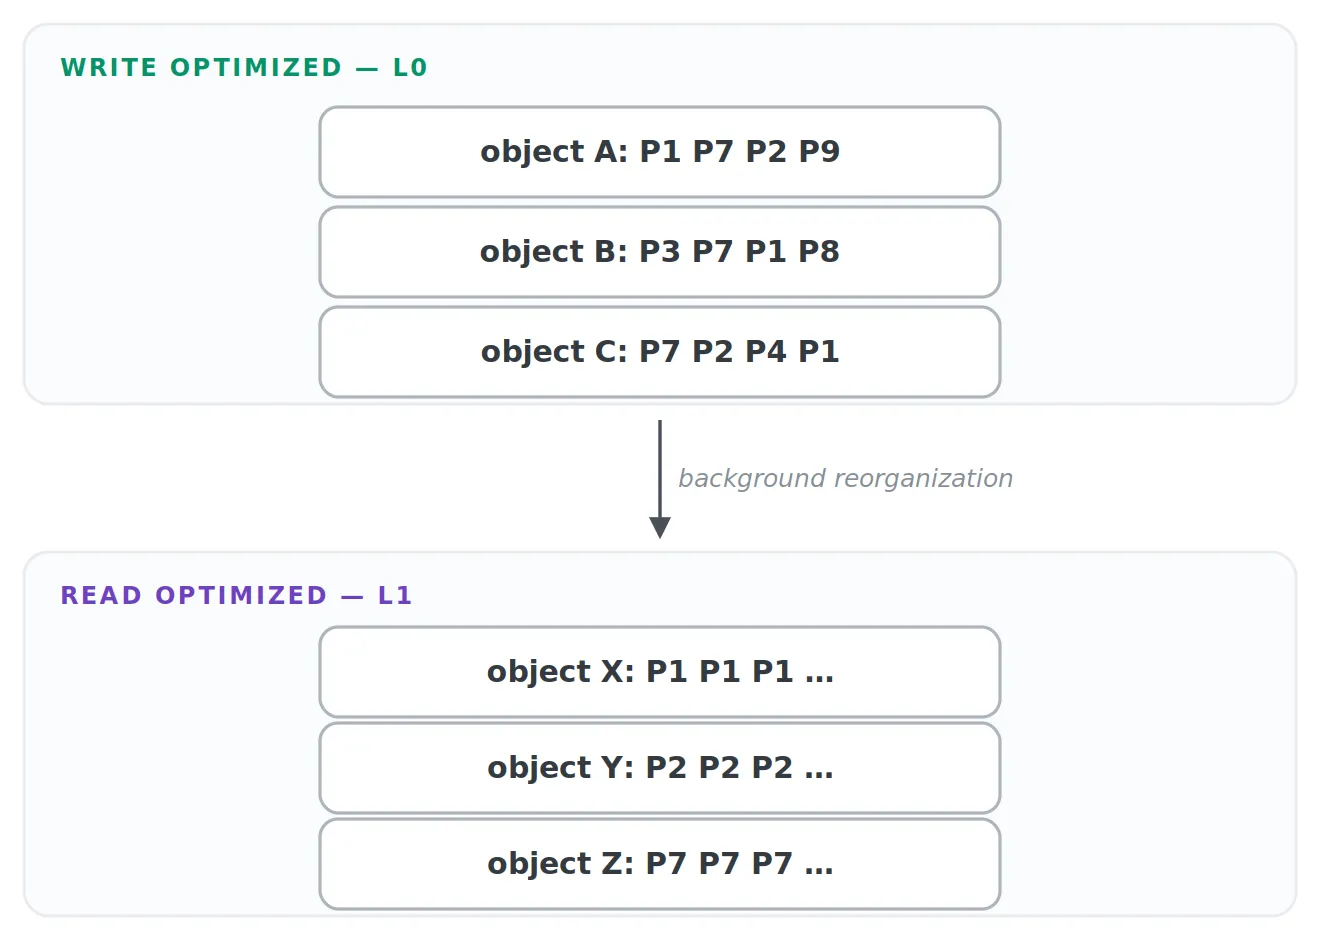
WarpStream-ը ֆոնային ֆայլերի compaction է աշխատեցնում մոտավորապես նույն պատճառով. վերջերս ներմուծված բազմապարտիցիոն ֆայլերը վերակազմակերպվում են պատմական կարդալու համար տեղայնությունը բարելավելու նպատակով։ Kafka-ի KIP-1163-ը պարունակում է միաձուլման ուղի, իսկ վերաբացված KIP-1165-ը ուսումնասիրում է օբյեկտների compaction-ը նույն դասի խնդիրների համար։
LSM tree-ները իմացող յուրաքանչյուրը կնկատի օրինաչափությունը։ Արագ գրառումները ստեղծում են մի դասավորություն. արդյունավետ կարդալը վաղ թե ուշ պահանջում է մեկ այլ։ Diskless հոսքային բրոքերը այսպիսով սկսում է ավելի շատ նմանվել հատուկ նպատակի համար կառուցված պահպանման շարժիչի, քան միայն ավելացվող լոգ ֆայլերի դիրեկտորիայի։
Ուշացումը կախված է հաստատման ուղուց
Օբյեկտային պահոցը թեժ ուղու մեջ դնելը ունի ակնհայտ թերություն՝ ուշացումը։ Դասական Kafka գրառումը կարող է օգտվել տեղական պահոցից և բրոքերների միջև խիստ վերահսկվող կրկնօրինակումից։ Diskless իրականացումը կարող է ստիպված լինել հավաքել բավարար գրառումներ արդյունավետ օբյեկտ կազմելու համար, upload անել այն, սպասել, մինչև պահոցը դա դարձնի դիմացկուն, commit անել ուժեղ համահունչ մետատվյալներ և միայն այդ պահին հաստատել պրոդյուսերին։ Բաթչինգի պատուհանը շատ կարճ դարձրեք, և կստանաք շատ փոքր օբյեկտներ և օբյեկտային պահոցի հարցումների ավելի բարձր արժեք. երկար դարձրեք, և ուշացումը կմեծանա։ Այս լարվածությունը չի կարող կարգավորվել կոնֆիգուրացիայով. այն ճարտարապետությանը ներհատուկ է։
Յուրաքանչյուր համակարգ փոխզիջումը լուծում է յուրովի։ WarpStream-ը լռելյայն օգտագործում է 250 ms batch timeout և ավելի ցածր ուշացման դիմաց կարող է ընդունել օբյեկտային պահոցի ավելի շատ հարցումներ. նրա ներկայիս ցածր ուշացման կոնֆիգուրացիաները հենվում են ավելի կարճ timeout-ների և, AWS-ում, S3 Express-ի վրա։ AutoMQ-ն կարող է օբյեկտային պահոցի դիմաց դնել ավելի արագ WAL, այնպես որ հաստատումը կարող է կախված լինել WAL-ից, այլ ոչ թե ավելի դանդաղ երկարաժամկետ ուղուց։ Redpanda-ն փաստաթղթավորում է ակնհայտորեն ավելի բարձր end-to-end ուշացման սպասումներ հանրային ամպային օբյեկտային պահոցների վրա աշխատող Cloud Topics-ի համար, և Confluent-ը Freight-ը նկարագրում է համադրելի տերմիններով։ Kafka-ի ներկայիս diskless առաջարկը նույնպես բացահայտ նշում է, որ հեռավոր պահոցը դասական topic-ների համեմատ կավելացնի հարցումների և end-to-end ուշացումը։
Սա է ճարտարապետական փոխզիջումը։ Օբյեկտային պահոցը բերում է առաձգականություն և այլ տնտեսագիտություն՝ ավելի բարձր ուշացմամբ դիմացկունության պրիմիտիվի գնով, կամ դրա առջև ավելի արագ WAL ավելացնելու գնով։
Ինչ է փոխվում շահագործման մեջ
Diskless ճարտարապետությունների օգտին փաստարկներից մեկն այն է, որ դրանք Kafka-ն դարձնում են շատ ավելի պարզ։ Շահագործման տեսանկյունից դրանում ինչ-որ բան կա. սկավառակների չափավորումը, replica-ների տեղափոխումը, պարտիցիոն տվյալների վերաբալանսավորումը, սկավառակների փոխարինումը, բրոքերի պահոցի սպառումը և cross-AZ payload կրկնօրինակման մեծ մասը կամ վերանում են, կամ ավելի քիչ կարևոր են դառնում։
Բաշխված համակարգերը, սակայն, հազվադեպ են վերացնում բարդությունը. դրանք այն տեղափոխում են։ Diskless համակարգերը պետք է շատ ավելի ուշադրություն դարձնեն օբյեկտների բաթչինգին, մետատվյալների հաջորդականացմանը, օբյեկտների compaction-ին, աղբի հավաքմանը, քեշի կառավարմանը, range-read արդյունավետությանը, փոքր օբյեկտների տնտեսագիտությանը, մետատվյալների վերականգնմանը և tail-read վարքին։
Դասական Kafka-ն մեծ ինժեներական ջանք է ներդնում կրկնօրինակված ֆիզիկական լոգերը պահպանելու մեջ։ Diskless Kafka-ն ավելի շատ ջանք է ներդնում ընդհանուր պահոցում պահվող տվյալների նկարագրման, քեշավորման և վերակազմակերպման մեջ։ Ճարտարապետությունը պարզ է որոշ շահագործման հարթություններում, այլ ոչ թե ամբողջ ճակատով։
Արդյո՞ք diskless Kafka-ն իսկապես էժանացնում է Kafka-ն
Սովորաբար հենց դրա համար է գոյություն ունենում ճարտարապետությունը։ Ամենամեծ հնարավոր խնայողությունները գալիս են երեք տեղից։ Առաջին՝ ավելի քիչ cross-AZ կրկնօրինակում. բրոքերը կարող է մեկ անգամ գրել տարածաշրջանային օբյեկտային պահոցի ծառայության մեջ, որի դիմացկունությունը կառավարում է ամպային պրովայդերը։ Երկրորդ՝ ավելի էժան պահոց. պահված բայթի հաշվով օբյեկտային պահոցը սովորաբար արժե շատ ավելի էժան, քան մեծ քանակությամբ տրամադրված բարձր արտադրողականության բլոկային պահոցը։ Երրորդ՝ հաշվողական հզորությունը ավելի հեշտ է մասշտաբավորել. երբ բրոքերները չեն տիրապետում դիմացկուն տվյալների, հաշվողական հանգույցներ ավելացնելը և հեռացնելը այլևս չի նշանակում պահված տվյալների համամասնական մասի տեղափոխում։
Բայց «S3-ը էժան է»-ն ամբողջ արժեքային մոդելը չէ։ Դուք դեռ վճարում եք PUT հարցումների, GET հարցումների, range read-երի, մետատվյալների ենթակառուցվածքի, քեշերի, ֆոնային compaction-ի, հաշվողական հզորության և հնարավոր է՝ բարձր արտադրողականության WAL պահոցի համար։ Ահա թե ինչու «90%-ով էժան Kafka» վաճառողների պնդումները համատեքստ են պահանջում. ճարտարապետությունը իսկապես կարող է փոխել տնտեսագիտությունը բարձր թողունակության բեռի համար, բայց դա չի նշանակում, որ Kafka-ի յուրաքանչյուր հաշիվ կիջնի 90%-ով։
Որտեղ է այն տեղավորվում
Diskless Kafka-ն հատկապես գրավիչ է այն բեռների համար, որոնք համատեղում են բարձր թողունակություն, երկար պահպանում և ուշացման նկատմամբ որոշակի հանդուրժողականություն. լոգեր և observability հոսքեր, տելեմետրիա, CDC, clickstream-ներ, data-lake ingestion, ML/AI ingestion և այլ խոշոր վերլուծական իրադարձությունների հոսքեր։
Նման բեռները տեղաշարժում են հսկայական քանակությամբ բայթեր և հաճախ ավելի քիչ են մտահոգվում մի քանի հարյուր միլիվայրկյան՝ կամ նույնիսկ մի ամբողջ վայրկյան՝ լրացուցիչ ուշացմամբ, քան ծառայություն-ծառայություն հրամանների ուղին։ Տեղական պահոցով դասական Kafka-ն դեռ ուժեղ դեպք է ուշացման նկատմամբ զգայուն իրադարձությունների մշակման, հրամանների, շատ թեժ tailing բեռների և ավելի փոքր պահվող տվյալների բազմությունների համար։ Ահա թե ինչու հավանական վերջնական վիճակը չէ պահոցի մեկ ռեժիմ բոլոր topic-ների համար։
Ապագան, հավանաբար, բազմառեժիմ Kafka է
Սա կարող է KIP-1150-ի ամենակարևոր կողմը լինել. diskless-ը առաջարկվում է որպես ընտրություն յուրաքանչյուր topic-ի համար, այլ ոչ թե պարտադիր որպես ամբողջ կլաստերի ինքնություն։ Ապագա Kafka տեղակայումը կարող է այսպես տեսք ունենալ.
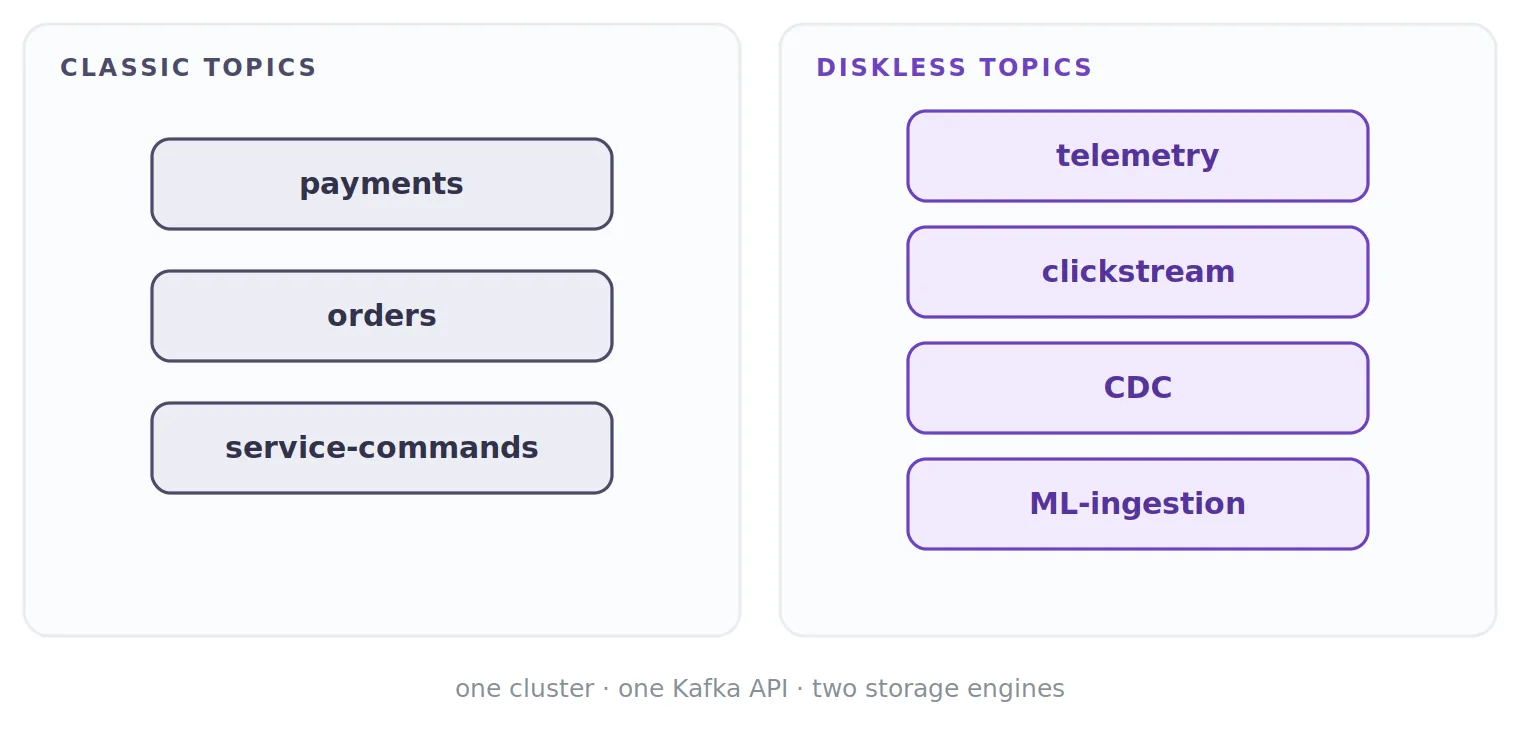
Այսպիսով, մեկ Kafka API-ն և վարչարարական սահմանը կարող են իրենց տակ թաքցնել շատ տարբեր պահպանման շարժիչներ։ Redpanda-ն արդեն աջակցում է տեղական, tiered և ամպային պահոցի ռեժիմներ մեկ շարժիչի շրջանակում։ Aiven-ը թույլ է տալիս դասական և diskless topic-ներին գոյակցել մեկ Standard Kafka ծառայության մեջ. նրա ներկայիս հնարավորությունների սահմանափակումները դեռ բացառում են տրանզակցիաները, compacted diskless topic-ները և Kafka Streams state store-երը։ Դասականից diskless միակողմանի փոխարկումը նույնպես հասանելի է վաղ հասանելիությամբ։ Upstream Kafka-ի KIP-1163-ը բացահայտորեն կանխատեսում է դասական, tiered և diskless topic-ների համատեղ գոյությունը մեկ կլաստերում՝ թույլ տալով հավելվածներին ծախսի/ուշացման փոխզիջումը կատարել յուրաքանչյուր topic-ի, այլ ոչ թե ամբողջ պլատֆորմի համար։
Սա ավելի հետաքրքիր ապագա է, քան պարզապես մտորելը, թե արդյոք «diskless Kafka-ն կփոխարինի Kafka-ին»։ Kafka-ն ինքը կարող է դառնալ բազմառեժիմ։
Kafka արձանագրությունը կարող է գերազանցել Kafka-ի սկզբնական ճարտարապետությունը
Kafka-ի API-ն գերազանցել է Kafka-ի սկզբնական պահպանման նախագիծը։ Հավելվածները աշխատում են topic-ների, պարտիցիաների, օֆսեթների, պրոդյուսերների, կոնսյումերների, consumer group-ների, տրանզակցիաների և Kafka արձանագրության սեմանտիկայի հետ։ Նրանք պարտադիր չէ, որ հոգան, թե արդյոք ներքևի բայթերը պահվում են՝
ext4
XFS
NVMe
EBS
S3
GCS
Azure Blob
Սա է թույլ տվել WarpStream-ին, AutoMQ-ին, Redpanda-ին և այլոց մնալ Kafka-ի հետ համատեղելի՝ միևնույն ժամանակ համարձակորեն փորձարկելով արձանագրության սահմանից ներքև, և այժմ հենց Apache Kafka-ն է սկսում շարժվել նույն ուղղությամբ։ Kafka-ն նախագծվել է այն նախադրյալով, որ հաջորդական սկավառակային I/O-ն կարող է դիմացկուն բաշխված լոգը դարձնել չափազանց արագ։ Այդ նախադրյալը ճիշտ էր, և diskless Kafka-ն այն չի հերքում։ Ավելի նոր հարցն այն է, թե արդյոք Kafka-ն ամպում աշխատեցնելը առհասարակ դեռ պահանջում է, որ բրոքերը տիրապետի դիմացկուն լոգին։
Պատասխանը ծնում է ճարտարապետություններ, որոնք ավելի շատ նման են ժամանակակից ամպային տվյալների բազաներին, քան 2010-ականների Kafka կլաստերներին.
stateless-ish compute
       +
shared object storage
       +
strongly consistent metadata
       +
caching
       +
background compaction
Այսպիսով, diskless Kafka-ն ապագա՞ն է
Ոչ բոլոր topic-ների համար։ Սակայն ամպում բարձր թողունակության հոսքային մշակման համար միտումը դժվար է անտեսել։
Ավանդական Kafka ճարտարապետությունը դեռ տալիս է գերազանց հատկություններ ուշացման նկատմամբ զգայուն բեռների համար։ Տեղական հաջորդական պահոցը արագ է, իսկ սերտ ինտեգրված լիդերը՝ կրկնօրինակված լոգով, դեռ պարզ, բայց հզոր աբստրակցիա է։ Այստեղ քննարկված համակարգերն արդեն տալիս են մի շարք diskless նախագծեր։ Իրական տեղակայման համար արժե համեմատել հաստատման ուշացումը, վերականգնման վարքը, հնարավորությունների աջակցությունը և տվյալ բեռի համար ընդհանուր արժեքը։