Apache Kafka vs Apache Iggy. Մեկ log, երկու շարժիչ
Apache Kafka-ի և Apache Iggy-ի համեմատություն, որը դիտարկում է դրանց պահպանման մոդելները, դիմացկունության երաշխիքները, benchmark-ների պնդումները և replication-ի հասունության աստիճանը։
Արդյո՞ք Apache Iggy-ը պարզապես ավելի արագ Apache Kafka է։
Նրանցից յուրաքանչյուրը հաղորդագրությունները պահում է բաժանված (partitioned), միայն ավելացման (append-only) log-երում։ Երկուսն էլ ունեն offset-ներ, retention քաղաքականություններ, consumer group-եր և replay։ Apache Iggy-ն իրականացված է Rust-ով՝ io_uring-ի վրա հիմնված thread-per-core ճարտարապետությամբ, մինչդեռ Kafka-ն աշխատում է JVM-ի վրա։ Benchmark-ը կարող է համեմատել դրանց արդյունավետությունը, եթե նախ համոզվենք, որ փորձարկվող կոնֆիգուրացիաները նույն երաշխիքներն են տալիս։
Եթե դեռ չեք լսել. Iggy-ն Rust-ով գրված հաղորդագրությունների streaming պլատֆորմ է, որը Apache Incubator-ից ավարտական փուլ անցավ և 2026 թվականի օգոստոսին դարձավ Apache-ի բարձրագույն մակարդակի նախագիծ։
Ի՞նչ է ճշգրտորեն նշանակում հաջող գրառում։ Հաղորդագրությունը պատճենվե՞լ է հիշողության buffer-ի մեջ։ Գրվե՞լ է օպերացիոն համակարգի page cache-ում։ Flush արվե՞լ է տեղական սկավառակին։ Replicate արվե՞լ է այլ մեքենայի։ Replicate արվե՞լ է այլ տվյալների կենտրոն։ Եվ ի՞նչ է լինում, եթե մեքենան, ռեքը կամ ամբողջ տվյալների կենտրոնը անհետանում է հենց այն բանից հետո, երբ producer-ը ստանում է հաստատում (acknowledgement)։
Թողարկման թարմացում. Apache Iggy 0.9.0-ը թողարկվեց 2026 թվականի սեպտեմբերի 18-ին։ Այն ներառում է VSR-ի վրա հիմնված կլաստերային սերվերը, որը նախկինում հասանելի էր միայն մշակման build-երում։
Երիտասարդ նախագիծ, որը արագ է զարգանում
Նախ՝ մի փոքր նախապատմություն Iggy-ի մասին։ Նրա հեղինակը այն սկսել է 2023 թվականի սկզբին՝ Rust սովորելու համար՝ իրական բան կառուցելով. անունը իտալական գրեյհաունդ (Italian Greyhound) բառերի հապավումն է՝ փոքր, բայց ուշագրավ արագ շուն։ Նախագիծը միացավ Apache Incubator-ին 2025 թվականի սկզբին և 2026 թվականի օգոստոսին ավարտեց միաձայն քվեարկությամբ՝ գրեթե հենց այն պահին, երբ replication-ի վրա երկարատև աշխատանքը մոտենում էր առաջին կլաստերային թողարկմանը։ Այդ աշխատանքը այժմ 0.9.0 թողարկման մաս է։
Նրանք համաձայն են տվյալների հիմնական մոդելի շուրջ
Iggy-ն չի փորձում log-ը փոխարինել որևէ այլ աբստրակցիայով։ Kafka օգտագործած յուրաքանչյուր ոք նրա պահպանման մոդելը ծանոթ կգտնի։ Iggy-ի Stream-ը topic-ների վերևում գտնվող լրացուցիչ անվանատարածք է։ Դրանից բացի, հիերարխիան սերտորեն արտացոլում է Kafka-ինը։ Partition-ը segment-ներից կազմված կարգավորված, append-only log է։ Հաղորդագրությունները կրում են offset-ներ։ Consumer-ները կարող են սկսել հստակ offset-ից, timestamp-ից, log-ի սկզբից կամ վերջից, կամ շարունակել սերվերում պահված consumer offset-ից։
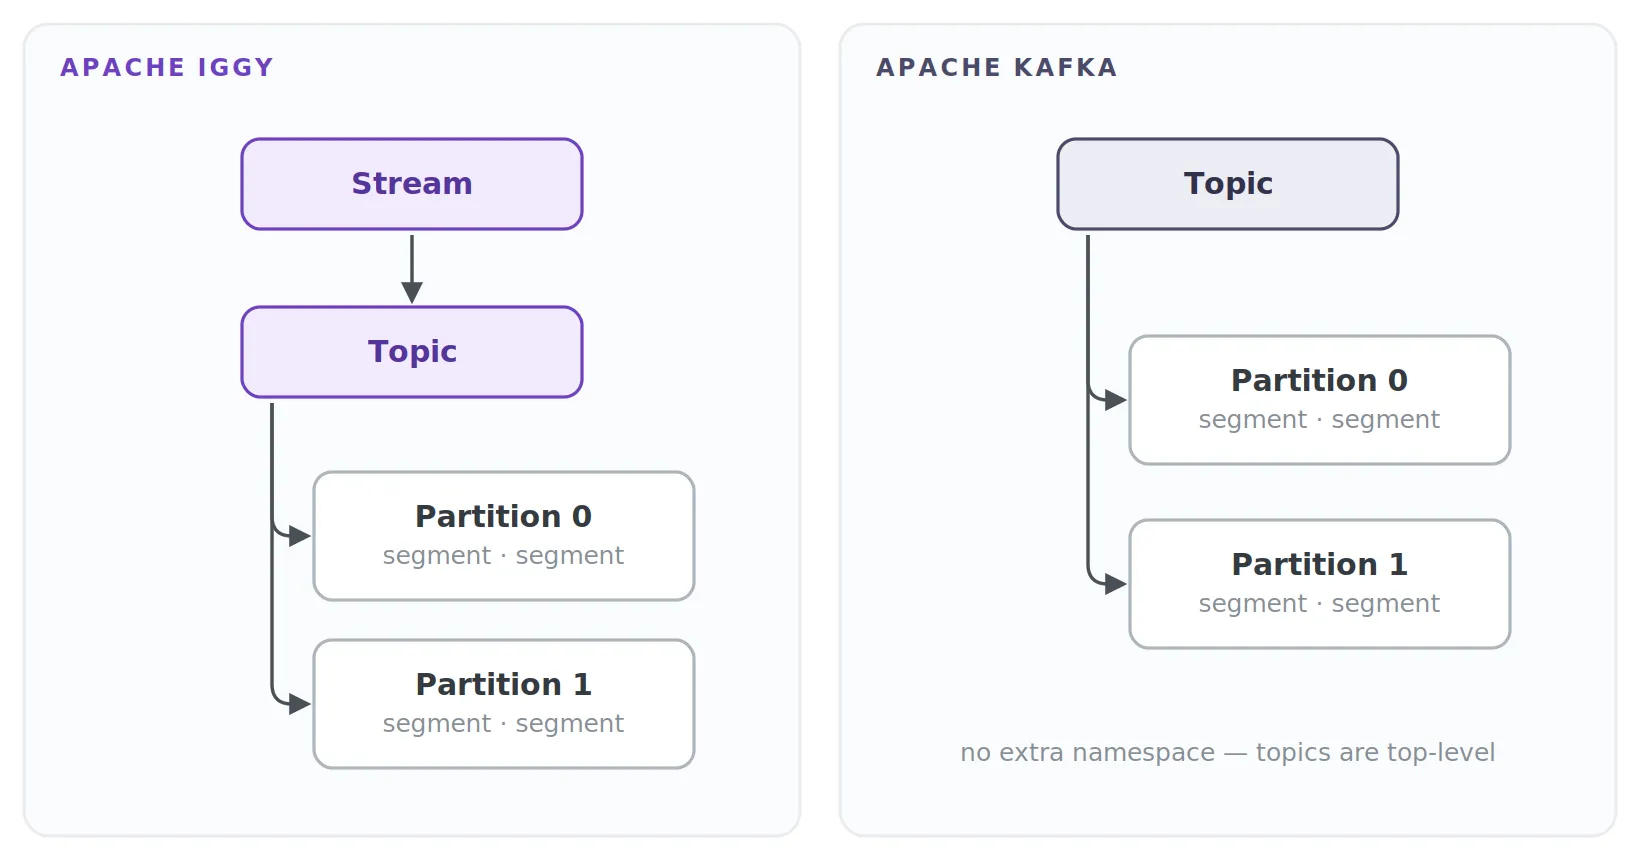
Սա այս համեմատությունը տարբերում է այն համակարգերի հետ համեմատությունից, որոնք իրադարձությունների log-ը փոխարինում են տվյալների բազայով կամ streaming աղյուսակով, ինչպիսին է Apache Fluss-ը։ Iggy-ն պահպանում է partitioned log-ը և փոխարենը փոխում է կատարման շարժիչը, հիշողության կառավարումը և I/O ուղին։
Որտեղ է Iggy-ն իրականում տարբերվում
Kafka-ն ունեցել է շատ ժամանակ իր պահպանման ուղին կարգավորելու համար։ Այն գրում է հաջորդաբար, ուժեղ կերպով batch-եր է կազմում, հենվում է օպերացիոն համակարգի page cache-ի վրա և կարող է օգտագործել zero-copy փոխանցում՝ տվյալները consumer-ներին առաքելիս։ Batching-ը և հաջորդական I/O-ն կրճատում են մեկ հաղորդագրության համար անհրաժեշտ աշխատանքը։
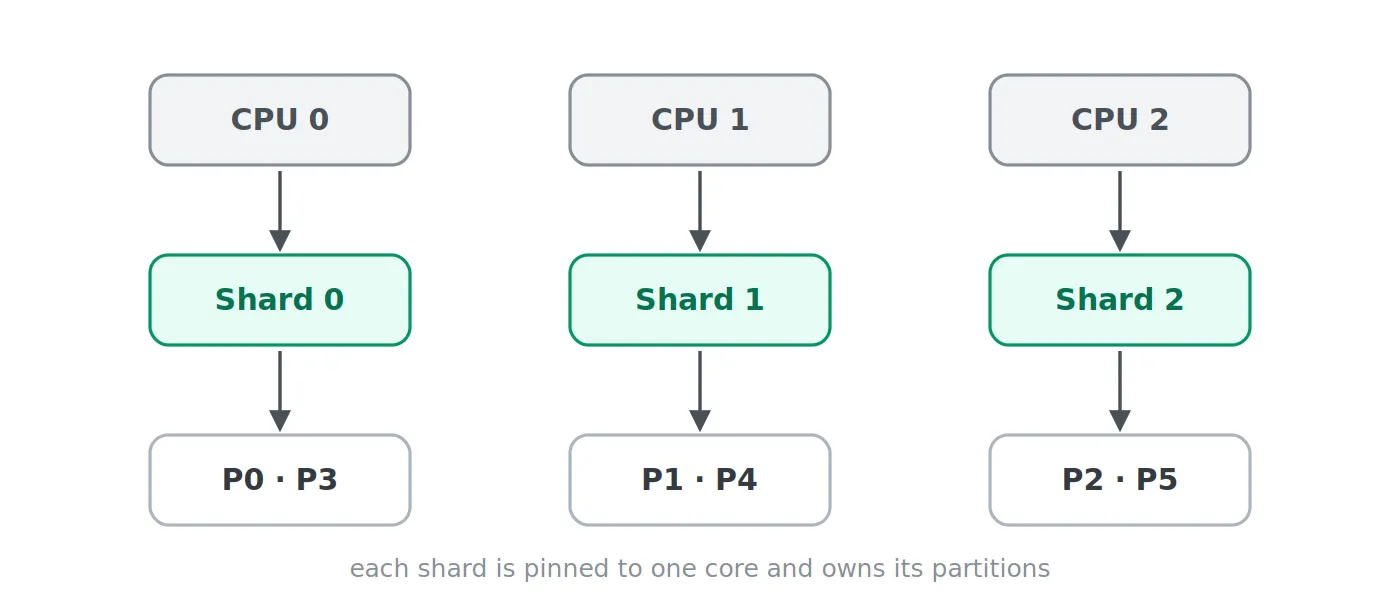
Iggy-ն ավելի ակտիվ մոտեցում է ցուցաբերում runtime-ի կառավարմանը։ 0.6.0 տարբերակից սկսած՝ սերվերը Tokio-ի վրա հիմնված մոդելից անցավ thread-per-core ճարտարապետության՝ հիմնված compio runtime-ի վրա, որը Linux-ում հենվում է io_uring-ի վրա։ Partition-ները map են արվում CPU-ին ամրացված shard-երին. work-stealing executor-ի փոխարեն, որը առաջադրանքները տեղափոխում է thread-երի միջև, յուրաքանչյուր shard տիրապետում է աշխատանքային բեռի մի հատվածի և այն կատարում է որոշակի CPU միջուկի վրա։
Բացի այդ, Iggy-ն կառավարում է իր սեփական նախապես հատկացված հիշողության pool-ը և օգտագործում է vectored I/O՝ հաղորդագրությունների buffer-ների խմբաքանակները սկավառակին գրելու համար։ Նպատակը հիմնականում կանխատեսելիությունն է. thread-per-core մոդելում թեժ partition-ը չի շարունակում թռչկոտել worker thread-երի միջև, և տվյալների ուղու վրա ավելի քիչ սինքրոնիզացիա կա, ավելի քիչ cache-ի անվավերացում և ավելի քիչ հատկացումներ։ Նախագիծը այս վերաշարադրումից հաղորդում է tail latency-ի մեծ բարելավումներ, ինչը մի ոլորտ է, որտեղ work-stealing runtime-ները կարող են խնդիրներ առաջացնել։
JVM-ի և Rust-ի տարբերությունը բացատրում է նախագծի միայն մի մասը։ Kafka-ն տիպային հավելված չէ, որը շարունակաբար հատկացնում և փոխակերպում է հաղորդագրությունների օբյեկտներ իր թեժ ուղու վրա. նրա արդյունավետության մեծ մասը բխում է նրանից, որ payload-ին հնարավորինս քիչ է դիպչում և քեշավորումն ու հաջորդական I/O-ն թողնում է օպերացիոն համակարգին։ Ավելի իմաստալից տարբերությունն այն է, որ Kafka-ն պահպանման քեշավորման մեծ մասը հանձնում է ՕՀ-ին, մինչդեռ Iggy-ն փորձում է ինքնուրույն վերահսկել կատարման և հիշողության ուղու ավելի մեծ մասը։
Ի՞նչ է լինում, երբ producer-ը հաղորդագրություն է գրում
Մեկ հանգույցի (node) վրա Iggy-ի գրառման ուղին մոտավորապես այսպիսի տեսք ունի.
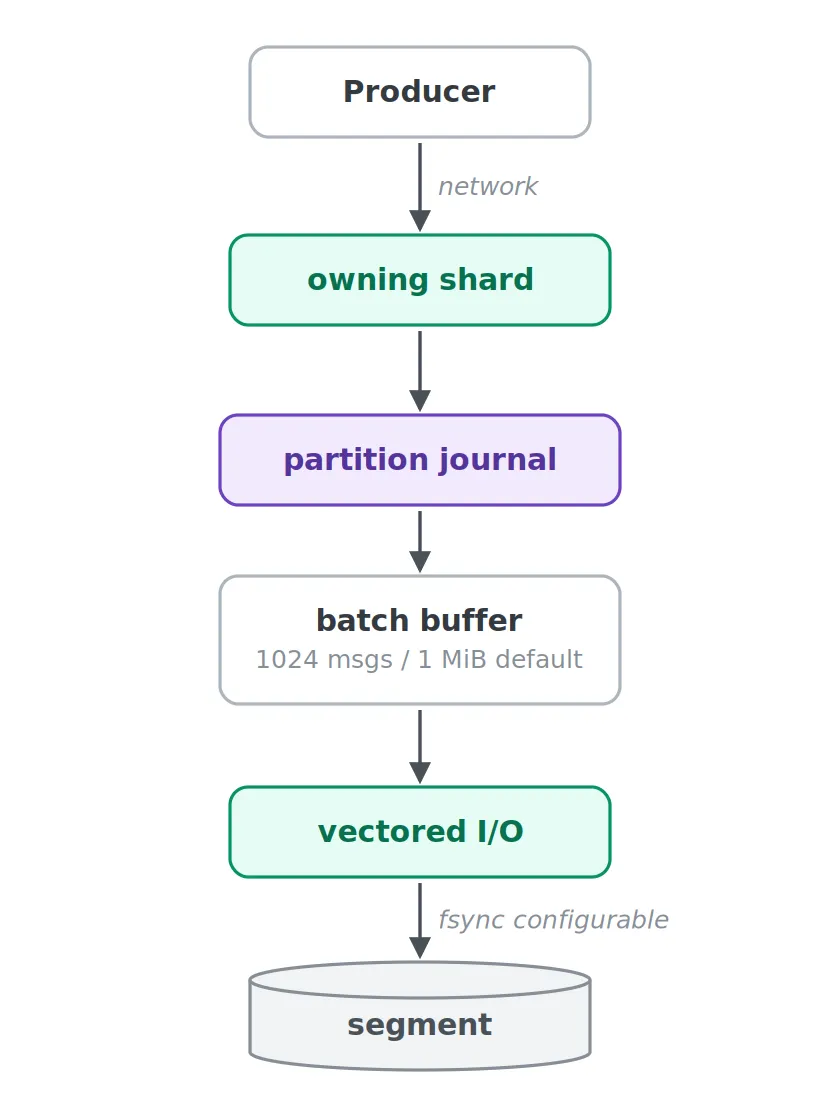
Հաղորդագրությունները պահվում են buffer-ում, մինչև հասնեն կարգավորվող քանակի կամ չափի սահմանին. գրելու պահին լռելյայնը 1024 հաղորդագրություն կամ 1 MiB է. և fsync-ը կարելի է կարգավորել յուրաքանչյուր topic-ի համար։ Հաստատումը պարտադիր չէ նշանակի, որ տվյալները գտնվում են դիմացկուն պահոցում։ Iggy-ի փաստաթղթերը բացահայտորեն նշում են, որ լռելյայն մեկ հանգույցանոց կարգավորումը թույլ դիմացկունության երաշխիքներ է տալիս, և խափանումը կամ հոսանքի անջատումը կարող է հաղորդագրություններ կորցնել, եթե դիմացկունության կարգավորումները չճշգրտվեն. սերվերը տրամադրում է enforce_fsync և flush-ի շեմեր՝ այս փոխզիջումը կառավարելու համար։
Kafka-ն բախվում է նույն հիմնարար խնդրին, բայց լուծում է այն այլ կերպ։ Kafka-ն նույնպես սովորաբար չի անում fsync յուրաքանչյուր առանձին հաղորդագրության համար։ Փոխարենը production-ում դիմացկունությունը սովորաբար հենվում է replication-ի վրա.
| Կարգավորում | Արժեք |
|---|---|
| Topic-ի replication factor-ը | 3 |
Topic-ի min.insync.replicas-ը |
2 |
Producer-ի acks-ը |
all |
Kafka-ն հետևում է ISR-ին՝ համաժամեցված replica-ների բազմությանը։ acks=all-ի դեպքում հաջող հաստատումը սպասում է համաժամեցված replica-ներին. min.insync.replicas-ը սահմանում է ISR-ի նվազագույն չափը, որն անհրաժեշտ է գրառման հաջողության համար։ Դա չի նշանակում, որ այս կոնֆիգուրացիայում Kafka-ն միշտ սպասում է ճիշտ երկու replica-ի։
Այս տարբերությունը վճռորոշ է latency-ն համեմատելիս։ Iggy-ի producer-ը, որը սպասում է տեղական գրառմանը, և Kafka-ի producer-ը, որը սպասում է երկրորդ մեքենայի վրա replication-ին, նույն բանը չեն չափում։ Նույնը վերաբերում է տեղական buffer-ավորված գրառմանը, տեղական fsync-ին և երկու տվյալների կենտրոնների վրա replicate արված գրառմանը։ Նախքան թվերը համեմատելը պետք է սահմանենք, թե որ խափանումը պետք է դիմանա հաստատված հաղորդագրությունը։
Իրականում ի՞նչ են չափում հրապարակված թվերը
Ես միտումնավոր չեմ անցկացնում Kafka-ի և Iggy-ի իմ սեփական benchmark-ը այս հոդվածի համար, բայց Iggy նախագծի հրապարակած թվերը, այնուամենայնիվ, արժե ուշադրությամբ դիտել՝ նախորդ բաժինը հիշելով։
Նախագծի FAQ-ը ասում է, որ միայն thread-per-core-ին անցումը տվել է մինչև 92% ավելի լավ P9999 tail latency, ինչպես նաև 18% թողունակության աճ՝ fsync-ը միացված վիճակում։ Նախագծի կայքը խոստանում է վայրկյանում միլիոնավոր հաղորդագրություններ՝ մեկ հանգույցի վրա միլիվայրկյանից ցածր tail latency-ներով, և repository-ն ներառում է սեփական iggy-bench գործիքը՝ նշելով, որ լռելյայն կոնֆիգուրացիան կարգավորված է արդյունավետության համար։ Սրանք նախագծի հաղորդած արդյունքներն են մեկ հանգույցանոց շարժիչի համար՝ փորձարկված հաստատման կարգավորումների պայմաններում։
Մեկ հանգույցանոց Iggy-ն Kafka-ի հետ համեմատելը հնարավոր է։ Iggy-ի առևտրային մատակարարի հրապարակած broker-only benchmark-ը հաղորդում է ավելի բարձր թողունակություն և ավելի ցածր tail latency։ Այդ արդյունքների վրա հենվելուց առաջ ստուգեք դիմացկունության կարգավորումները, հաղորդագրության չափը, batching-ը և սարքավորումները։ Replicated համեմատությունը պետք է լրացուցիչ նշի փորձարկված ճշգրիտ թողարկումը կամ մշակման build-ը։
Հաղորդված P9999 բարելավումը համեմատում է Iggy-ն thread-per-core վերաշարադրումից առաջ և հետո։ Դա Kafka-ի հետ չափում չէ։ Շահույթը ճարտարապետությանը վերագրելու համար պետք է ստուգել երկու փորձարկումներում օգտագործված աշխատանքային բեռը և կոնֆիգուրացիան։
Մեկ հանգույցանոց Iggy-ն հաճելիորեն պարզ է
Սերվերը native binary է, որը ներառում է սեփական CLI-ն և Web UI-ը. այն տրամադրում է Prometheus մետրիկաներ և OpenTelemetry ինտեգրացիա, աջակցում է մի քանի transport-ներ և կարիք չունի ո՛չ JVM-ի, ո՛չ առանձին մետատվյալների սերվիսի։ Եթե ինձ պետք է մեկ հզոր սերվերի վրա տեղական NVMe պահոցով մշտական իրադարձությունների log, Iggy-ն շատ բան է առաջարկում բավականին քիչ ենթակառուցվածքի դիմաց։
Kafka-ն, իհարկե, կարող է աշխատել որպես փոքր կլաստեր, բայց production Kafka տեղակայումը հիմնված է այլ ենթադրության վրա. մեքենաները խափանվում են, ուստի partition-ները replica-ներ ունեն, իսկ կլաստերի մետատվյալները՝ քվորում։ Այս ամբողջ լրացուցիչ մեխանիզմն արժե ունի, և հենց դա է թույլ տալիս Kafka-ին դիմանալ այնպիսի խափանումների, որոնց մեկ Iggy պրոցեսը չի կարող։ Տեղակայումները համեմատելիս հաշվի առեք ջանքը, որն անհրաժեշտ է հանգույցի անջատվելուց հետո սերվիսը հասանելի պահելու համար։
Replication-ը 0.9.0-ում
Viewstamped Replication-ի (VSR) վրա հիմնված բազմահանգույց կլաստերավորումը արդեն կա նոր սերվերի կոդում։ 2026 թվականի օգոստոսին server-ng-ն բարձրացվեց հիմնական iggy-server-ի կարգավիճակի, և սկսեցին հայտնվել 0.9.0-edge build-եր։ Նախագիծը սերվերային կողմը նկարագրում է որպես հիմնականում ավարտված. view change-երը, state transfer-ը, leader forwarding-ը, client-session recovery-ն, հանգույցների նույնականացումը, TLS-ը հանգույցների միջև և խափանումների, ուշացումների, վերագործարկումների ու ցանցային բաժանումների դետերմինիստական սիմուլյացիոն թեստավորումը բոլորն իրականացված են. FAQ-ը կլաստերավորումը բնութագրում է որպես production պատրաստության ուղղությամբ հասունացող։ Տեղակայման համար ստուգեք, որ ընտրած SDK տարբերությունը աջակցում է կլաստերային սերվերին և նրա VSR wire պրոտոկոլին։
0.9.0 թողարկումը փոխարինում է 0.8.0-ին և ներառում է կլաստերային սերվերը։ Դրա հասանելիության դեպքում replicated աշխատանքային բեռները կարելի է փորձարկել պաշտոնական թողարկման վրա։
Kafka-ի replication մոդելն աշխատում է production-ում ավելի քան մեկ տասնամյակ։ Յուրաքանչյուր partition ունի leader և follower replica-ներ՝image
Follower-ները պատճենում են leader-ի log-ը, Kafka-ն օգտագործում է ISR-ը հետևելու համար, թե որ replica-ները բավականաչափ մոտ են համաժամացված, և producer-ի հաստատման իմաստաբանությունը կարող է կապվել այդ բազմության հետ։ Օպերատորներն ունեն լավ փաստաթղթավորված ընթացակարգեր replica-ների խափանումների, ISR-ի փոփոխությունների և վերականգնման համար։
Iggy-ի դետերմինիստական սիմուլյացիոն թեստերը խափանումների հաջորդականություններ են անցնում տեղակայումից առաջ։ Այդուհանդերձ, ես կուզենայի գործառնական ապացույցներ replicated աշխատանքային բեռներից. վերականգնման ժամանակներ, rolling upgrade-ներ և latency՝ replica-ների հասնելու ընթացքում։
Տվյալների կենտրոնի կորստից փրկվելը
Որոշ համակարգեր պետք է դիմանան ամբողջ տվյալների կենտրոնի կորստին։ Replica-ների տեղաբաշխումը և controller-ների քվորումները պետք է հաշվի առնեն այդ խափանումը։
Kafka-ի broker.rack կարգավորումը սահմանափակված չէ ֆիզիկական սերվերային ռեքով. նրա արժեքը կարող է ներկայացնել availability zone կամ խափանման որևէ այլ դոմեն, և Kafka-ի replica-ների տեղաբաշխումը partition-ի replica-ները բաշխում է այդ դոմենների միջև։ Երեք մոտ տվյալների կենտրոնների դեպքում, եթե յուրաքանչյուրում լինի յուրաքանչյուր partition-ի մեկ replica, acks=all և համապատասխան min.insync.replicas, producer-ի հաստատումը կարող է հենվել տեղական տվյալների կենտրոնից դուրս գտնվող replica-ների վրա։ Թե սա ինչպես է տարբերվում ասինխրոն աղետից վերականգնումից, առավել պարզ երևում է կողք կողքի ցույց տալիս.
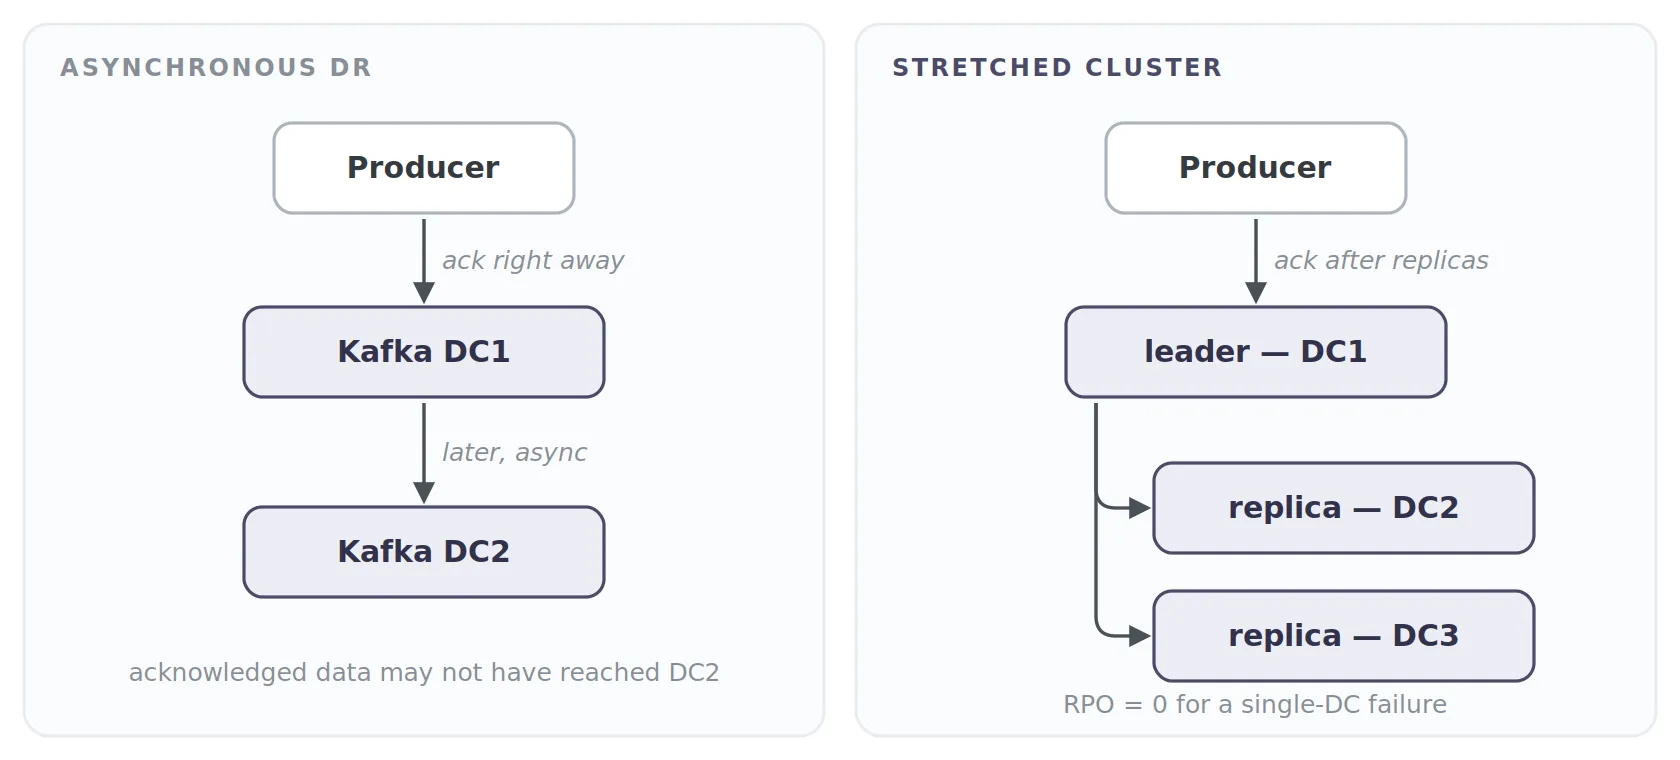
MirrorMaker 2-ի նման ասինխրոն միջկլաստերային replication-ի դեպքում աղբյուրը կարող է հաստատել հաղորդագրությունները նախքան դրանց երկրորդ կլաստեր հասնելը։ Ձգված (stretched) կլաստերը կարող է պահանջել հաստատված պատճեն տեղական DC-ից դուրս՝ DC-ների միջև գրառման latency-ի գնով։ Replica-ների տեղաբաշխումը, controller քվորումը և վերականգնման կարգավորումները բոլորը պետք է աջակցեն ձեր պլանավորած խափանման սցենարին։
Եթե պահանջը հաստատված տվյալների զրոյական կորուստն է կայքի խափանումից հետո, ես կընտրեի Kafka տեղակայում, որը կարգավորված և փորձարկված է հենց դա ապահովելու համար։ Iggy-ի կլաստերավորման աշխատանքը դեռ չի առաջարկում համադրելի multi-DC կարգավորում, որը փաստաթղթավորված լինի production-ի համար։
Ավելի մանրամասն տոպոլոգիաները ներառում են Confluent Platform Multi-Region Clusters-ը։
Consumer group-երը շատ ավելի ծանոթ են թվում
Iggy-ն առաջարկում է սերվերային consumer offset-ներ և consumer group-եր. խմբի մի քանի consumer-ներ իրար միջև բաժանում են topic-ի partition-ները, և partition-ները վերաբաշխվում են անդամների գալուն-գնալուն զուգընթաց։ Iggy-ն օգտագործում է համագործակցային վերաբալանսավորում pending-revocation փուլով, որպեսզի սեփականությունը կտրուկ չփոխվի, մինչ consumer-ը դեռ ավարտում է իր աշխատանքը։
Մտային մոդելը ուժեղ կերպով հիշեցնում է Kafka-ինը.
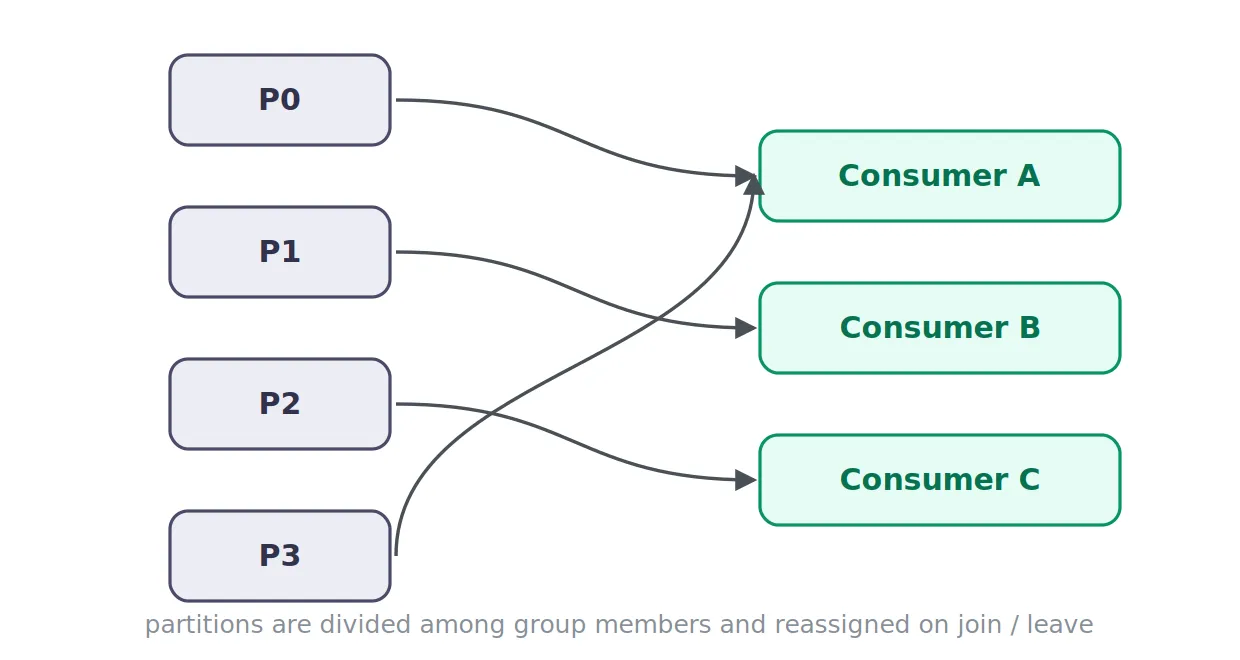
Consumer group-երը համակարգում են, թե ով որ partition-ին է տիրապետում անդամակցության փոփոխվելիս, այնպես որ consumer-ները կարող են կիսել աշխատանքը, այլ ոչ թե յուրաքանչյուրը կարդա ամբողջ topic-ը։
Exactly-once-ը շատ ավելի մեծ տարբերություն է
Exactly-once մշակման համար պետք է նշենք, թե որ գործողությունները պետք է commit արվեն միասին։
Iggy-ն աջակցում է consumer offset-ների ավտոմատ կամ ձեռքով կառավարմանը, ինչպես նաև հաղորդագրությունների ID-ների վրա հիմնված ընտրովի deduplication-ի։ Նրա փաստաթղթերը exactly-once-ը ներկայացնում են որպես հավելվածի մակարդակի deduplication, սերվերային deduplication cache-ով, որը օգնում է զտել կրկնվող ID-ները։ Դա կարող է հարմար լինել, բայց դա Kafka-ի transaction-ներից տարբեր մեխանիզմ է։
Kafka-ն աջակցում է idempotent producer-ներ և transaction-ներ, որոնք կարող են ատոմարար համադրել գրառումների արտադրումը ընթերցված offset-ների commit-ի հետ։ Սա կարևոր է consume-process-produce հավելվածի համար.
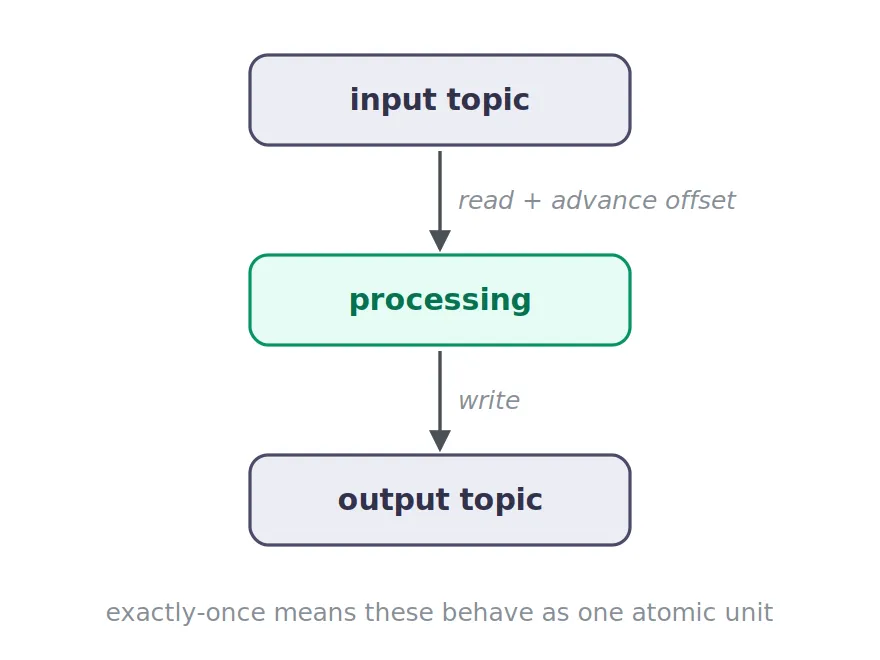
Kafka transaction-ը կարող է ատոմարար commit անել ելքային գրառումները ընթերցված offset-ների հետ միասին։ Հետագա consumer-ներին պետք է read_committed՝ ընդհատված ելքը զտելու համար։ Արտաքին HTTP կանչերը կամ տվյալների բազայի թարմացումները դուրս են այդ transaction-ից։
Iggy-ն այս համակարգման ավելի մեծ մասը դնում է հավելվածի վրա։ Եթե հավելվածը կախված է Kafka transaction-ներից, հաղորդագրությունների ID-ով deduplication-ը ինքնին չի կարող դրանք փոխարինել։
Compaction-ը ևս մեկ տարբերություն է
Kafka-ի retention-ը չի սահմանափակվում հին տվյալները տարիքով կամ ընդհանուր չափով հեռացնելով։ Compacted topic-ը կարող է պահել յուրաքանչյուր key-ի ամենավերջին արժեքը.
user-1 -> Alice
user-2 -> Bob
user-1 -> Alice
և ինչ-որ պահի դեն նետել ավելի հին user-1 -> Alice գրառումը՝ միևնույն ժամանակ պահելով բավարար պատմություն ընթացիկ վիճակը վերակառուցելու համար։ Այս հնարավորությունը կարևոր է changelog topic-ների, Kafka Streams-ի վիճակի վերականգնման, CDC տիպի տվյալների հավաքածուների և կոնֆիգուրացիայի հոսքերի համար։
Iggy-ի ներկայիս պահպանման փաստաթղթերը ներառում են փակված segment-ների ժամանակի և չափի վրա հիմնված retention. այս պահին այն Kafka-ի key-ի վրա հիմնված log compaction-ին համարժեք ոչինչ չի առաջարկում։ Զուտ իրադարձությունների պատմության համար դա անտեղի է։ Log-ը որպես materialized վիճակի դիմացկուն հենակետ օգտագործելու համար դա էական է։
Iggy-ի հաղորդագրությունները իսկապես ստանում են սեփական ինքնությունը
Ես գնահատում եմ, որ Iggy-ի record մոդելը ներառում է message ID։ Kafka-ում record-ի բնական ինքնությունը սովորաբար (topic, partition, offset) եռյակն է։ Iggy-ի հաղորդագրությունները լրացուցիչ կրում են 128-բիթանոց message ID, որն օգտագործվում է ընտրովի deduplication մեխանիզմի կողմից և գոյություն ունի անկախ այն բանից, թե հաղորդագրությունը ֆիզիկապես որտեղ է գտնվում partition-ում։ Այն չի փոխարինում transaction-ային իմաստաբանությանը, բայց հարմար պրիմիտիվ է, որ ներդրված լինի հաղորդագրության մոդելում։
Պրոտոկոլի ընտրությունը գիտակցված է
Iggy-ն ներկայումս չի աջակցում Kafka պրոտոկոլը։ Այն ունի սեփական binary պրոտոկոլ, հասանելի TCP-ով, QUIC-ով և WebSocket-ով, ինչպես նաև առանձին HTTP API, ընդ որում TCP-ն այն ուղին է, որը նախատեսված է ամենացածր latency-ի համար։ Սա թույլ է տալիս Iggy թիմին պրոտոկոլը զարգացնել պահպանման շարժիչի կողքին. օրինակ՝ 0.8.0 թողարկումը բերեց իր wire ձևաչափի խոշոր վերաշարադրում և համախմբում։ Kafka-ն չի կարող դա թեթևակի անել, քանի որ նրա պրոտոկոլը կազմում է հսկայական համատեղելիության մակերեսի մաս, որի վրա հենվում են բազմաթիվ լեզուներով գրված կլիենտներն ու արտադրանքները։
Iggy-ն ներկայումս առաջարկում է SDK-ներ մի քանի լեզվով, բայց Rust կլիենտը ծառայում է որպես հղման իրականացում, և հնարավորությունների ընդգրկումը լեզվից լեզու տարբերվում է։ Kafka wire-protocol proxy-ն Iggy-ի roadmap-ում է և, ըստ նախագծի, մշակվում է. եթե այն հասունանա, կարող է գոյություն ունեցող Kafka producer-ներին ու consumer-ներին միացնել Iggy-ին և զգալիորեն փոխել միգրացիայի պատկերը։ Մինչ այդ Kafka-ից Iggy-ին անցնելը հավելվածի միգրացիա է, այլ ոչ թե broker-ների փոխարինման հարց։
Նույնը վերաբերում է connector-ներին
Iggy-ն արդեն ունի իր connector-ների runtime-ը՝ source-երով և sink-երով այնպիսի համակարգերի համար, ինչպիսիք են տվյալների բազաները, որոնողական համակարգերը, օբյեկտային պահոցը և Iceberg-ը։ Միգրացիան, այնուամենայնիվ, պահանջում է connector-ները մեկ առ մեկ համեմատել Kafka Connect-ի հետ. մատակարարներն ու բաց կոդով նախագծերը տարիներ են ունեցել Kafka-ի API-ի և պրոտոկոլի շուրջ կառուցելու համար, և ինտեգրացիաների այդ շրջանակը արտադրանքի մաս է, թեև այդ կոդից ոչ մեկը Kafka broker-ում չէ։ Վերանայեք հավելվածի վրա հենվող յուրաքանչյուր connector-ի աշխատանքը, առաքման երաշխիքները և վերականգնման վարքագիծը։
Այսպիսով, Iggy-ն Kafka-ի փոխարինո՞ղ է
Որոշ աշխատանքային բեռների համար, հնարավոր է։ Այսօրվա յուրաքանչյուր Kafka աշխատանքային բեռի համար՝ ոչ։
Եթե ձեզ պետք է մշտական տեղական իրադարձությունների log շատ ցածր latency-ով, պարզ տեղակայմամբ և բարձր թողունակությամբ մեկ մեքենայի վրա, Iggy-ն վստահելի և տեխնիկապես հետաքրքիր տարբերակ է։ 0.9.0 տարբերակը նաև առաջարկում է պաշտոնական թողարկում replicated տեղակայումները գնահատելու համար։ Նրա իրականացումը արժանի է ուսումնասիրության՝ անկախ նրանից, կտեղակայենք այն, թե ոչ. thread-per-core կատարումը, shard-երի հստակ սեփականությունը, io_uring-ը, NUMA-ի իմացությունը և հիշողության հատուկ կառավարումը ցույց են տալիս, թե ինչպիսին կարող է լինել streaming log-ը, երբ կառուցված է զրոյից ժամանակակից Linux-ի վրա՝ համատեղելիության սահմանափակումներից ազատ։
Գոյություն ունեցող Kafka հավելվածի համար ես կստուգեի, թե արդյոք այն հենվում է.
- transaction-ների և ատոմար offset commit-ների վրա;
- key-ի վրա հիմնված log compaction-ի վրա;
- կլիենտ գրադարանների և connector-ների վրա;
- rolling upgrade-ների և վերականգնման ընթացակարգերի վրա;
- multi-DC հասանելիության և տվյալների կորստի երաշխիքների վրա։
Այս պահանջները կարող են բացառել միգրացիան նույնիսկ նախքան թողունակությունը հաշվի առնելը։
Ինչ կփորձարկեի հաջորդը
Հաջորդը ես Iggy-ի replicated ուղին բեռի տակ կդնեի. գրառման ընթացքում կանջատեի հանգույցը, կկտրեի replica-ների միջև կապը և կչափեի վերականգնման ժամանակը և tail latency-ն։ Դրանից հետո կհաստատեի, թե ընտրված կոնֆիգուրացիայի դեպքում որ հաստատված հաղորդագրություններն են գոյատևում։
Kafka-ի միգրացիայի համար ես նույն հավելվածի աշխատանքային հոսքը կաշխատեցնեի երկու համակարգերի վրա, ներառյալ կրկնվող փորձերը (retries) և consumer-ների վերագործարկումները։ Դա կբացահայտեր, թե արդյոք Iggy-ն բավարարում է աշխատանքային բեռի երաշխիքները ընդունելի latency-ով և գործառնական արժեքով։