TigerBeetle-ի և PostgreSQL-ի performance-ի համեմատություն. benchmark harness և ամպային թեստեր
Խորը performance benchmark, որը հակադրում է TigerBeetle-ը և PostgreSQL-ը բազմահանգույց Google Cloud Platform միջավայրում։ Այն քննում է երկակի հաշվապահության (double-entry bookkeeping) բեռնվածքները հարցումների տարբեր հաճախականությունների և հաշիվների մրցակցության մակարդակների դեպքում (Zipf բաշխում)՝ դիտարկելով այնպիսի մետրիկաներ, ինչպիսիք են միջին թողունակությունը, latency-ի պերցենտիլները և կորցրած հարցումների մասնաբաժինը։
Մի քանի ամիս առաջ մենք փորձարկեցինք TigerBeetle-ի և PostgreSQL-ի performance-ը տեղական benchmark-ներով։ Թեստը վերարտադրում էր TigerBeetle-ի կիրառման դեպքի բնորոշ աշխատանքային հոսքը՝ transfer-ների ստեղծում երկակի հաշվապահության միջոցով։
Տեղականորեն TigerBeetle-ը պարզվեց գրեթե 3 անգամ ավելի արագ, քան PostgreSQL-ի ամենաարագ մոտեցումը, սակայն բաց հարց մնաց, թե արդյոք նույնը ճիշտ է նվիրված սերվերների վրա կլաստերային տեղակայման համար։ Հենց դրան էլ փորձեցինք պատասխանել այստեղ։
Կարճ վերհուշ. PostgreSQL-ի սխեման
TigerBeetle-ը գալիս է ֆիքսված սխեմայով, որը նախագծված է բացառապես երկակի հաշվապահության համար։ Այն ունի երեք հիմնական entity՝ ledger-ներ, account-ներ և transfer-ներ։ Յուրաքանչյուր transfer ներառում է երկու account. մեկը կրեդիտավորվում է, մյուսը՝ դեբետավորվում։ Ինչպես նշվել է վերևում, transfer ստեղծելը տվյալների բազայի հիմնական գործողությունն է։ Ստորև ներկայացված է համադրելի սխեման, որը մենք օգտագործում ենք այս թեստի համար PostgreSQL-ում.
CREATE TABLE IF NOT EXISTS accounts (
    id BIGINT PRIMARY KEY,
    balance BIGINT NOT NULL DEFAULT 0,
    CONSTRAINT balance_non_negative CHECK (balance >= 0)
);

CREATE TABLE IF NOT EXISTS transfers (
    id BIGSERIAL PRIMARY KEY,
    source_id BIGINT NOT NULL REFERENCES accounts(id),
    dest_id BIGINT NOT NULL REFERENCES accounts(id),
    amount BIGINT NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT NOW(),
    CONSTRAINT amount_positive CHECK (amount > 0),
    CONSTRAINT different_accounts CHECK (source_id != dest_id)
);

CREATE INDEX IF NOT EXISTS idx_transfers_source ON transfers(source_id);
CREATE INDEX IF NOT EXISTS idx_transfers_dest ON transfers(dest_id);
CREATE INDEX IF NOT EXISTS idx_transfers_created_at ON transfers(created_at);
Մենք կփորձարկենք PostgreSQL-ում transfer-ներ ստեղծելու 2 ռազմավարություն (անուղղակի lock և բացահայտ lock)։ Քանի որ դրանք արդեն նկարագրվել են նախկինում, դրանց նորից չենք անդրադառնա։
Performance benchmark-ի աշխատեցումն ամպում
Նախկինում ամեն ինչ աշխատեցնում էինք տեղականորեն՝ մեկ տվյալների բազայի օրինակով և մեկ կլիենտով։ Իրական պայմաններին ավելի մոտենալու համար այս անգամ յուրաքանչյուր տվյալների բազայի համար աշխատեցնում ենք կլաստեր և 5 կլիենտ օրինակ։ TigerBeetle-ը խորհուրդ է տալիս վեց հանգույց, տարածված երեք ամպային մատակարարների վրա. այս թեստի համար մենք օգտագործեցինք երեքը՝ PostgreSQL-ի կարգավորմանը համապատասխանեցնելու համար, որը կարգավորված է իր ստանդարտ leader + 2 replica consensus-ով։ Նմանապես, PostgreSQL-ն աշխատում էր մեկ primary-ով և երկու synchronous standby-ով (quorum commit, այսինքն՝ տրանզակցիան հաստատվում է միայն այն բանից հետո, երբ այն դիմացկուն է primary-ի և առնվազն մեկ standby-ի վրա)։
Benchmark-ները աշխատեցին Google Cloud Platform-ում։ Վերը նշված կլիենտ և տվյալների բազայի օրինակներից բացի, ևս մեկ հանգույց հոսթում է մեր մոնիթորինգի ստեկը Prometheus-ով և Grafana-ով։
Կլիենտները աշխատում էին n2-standard-2 (2 vCPU, 8 GB RAM) օրինակների վրա, իսկ տվյալների բազաները՝ n2-highmem-4 (4 vCPU, 32 GB RAM) օրինակների վրա։
Ինչ ենք չափում և ինչ ենք փոփոխում
Մեթոդաբանության և արդյունքների մեջ մտնելուց առաջ անցնենք, թե ինչ ենք ուզում չափել և որ փոփոխականներն ենք վերահսկում։ Նախ՝ փոփոխականները.
target_rate-ը transfer-ների ընդհանուր քանակն է մեկ վայրկյանում, որ բոլոր օրինակների կլիենտները փորձում են կատարել։ Հարցումները ուղարկվում են՝ անկախ նրանից, թե որքան արագ է պատասխանում տվյալների բազան։max_concurrency-ն սահմանափակում է, թե քանի ընթացքի մեջ գտնվող հարցում կարող է միաժամանակ ունենալ կլիենտը։ Մենք նկատեցինք, որ կլիենտները երբեմն կորցնում էին transfer-ներ չափազանց շատ ընթացքի մեջ գտնվող հարցումների պատճառով, այլ ոչ թե այն պատճառով, որ տվյալների բազան չի պատասխանել։ Այս կարգավորումն օգտագործեցինք առաստաղը բարձրացնելու և ավելի շատ հարցումներ թույլ տալու համար։
Ինչ ենք չափում.
- միջին թողունակություն
- p50, p95, p99, p999 latency
- սխալների մակարդակ
- կորցրած հարցումներ.
max_concurrency-ի պատճառով կորցրած հարցումներ, այսինքն՝ չափազանց շատ ընթացքի մեջ գտնվող հարցումներ
Թեստերի աշխատեցում և համակարգում
Coordinator կոդը հոգ է տանում կլիենտ կոդը բաշխելու, տվյալների բազան գործարկելու, account-ները սկզբնավորելու և benchmark-ը աշխատեցնելու մասին։ Տվյալների բազան դեռ տեղակայում ենք Docker-ով, բայց քանի որ host-ը ընդհանուր չէ, io_uring-ը միացնելու համար օգտագործում ենք --security-opt seccomp=unconfined։
Ինչ վերաբերում է կլիենտ կոդին, մենք չէինք ուզում օրինակների վրա տեղադրել ամբողջական Rust և Zig toolchain-ները՝ ընդամենը երկուական ֆայլը կառուցելու համար։ Փոխարենը կլիենտի երկուական ֆայլը cross-compile ենք անում cargo zigbuild-ով և պատճենում VM օրինակներ։
Թեստերի արդյունքներ
Հիմա արդյունքների մասին։ Յուրաքանչյուր թեստ աշխատում է 5 րոպե՝ 2 րոպեանոց warm-up-ից հետո, 3 իտերացիայով։ Մենք երկու թեստ աշխատեցրինք TigerBeetle-ի և 6-ը՝ PostgreSQL-ի համար, քանի որ PostgreSQL-ը աջակցում է 2 տարբեր ռազմավարության։ Երկու տվյալների բազաները համեմատելուց հետո աշխատեցրինք նաև մի քանի այլ benchmark՝ պարզելու, թե որքան հեռու կարելի է մղել TigerBeetle-ը։ Մենք նաև սահմանեցինք account-ների մրցակցության 2 տեսակ, որոնք նկարագրվում են Zipf-ի ցուցիչով և ստեղծում են «թեժ կետ» (hotspot) account-ներ։
Առաջին թեստը աշխատեցնում է վայրկյանում 5k հարցում fixed_rate ռեժիմում։
| Մետրիկա | TigerBeetle | PostgreSQL Standard (FOR UPDATE) | PostgreSQL Atomic |
|---|---|---|---|
| Fixedrate (zipfian=1.0) | |||
| Թեստի ռեժիմ | fixed_rate |
fixed_rate |
fixed_rate |
| Միջին թողունակություն | 4,097 TPS | 2,890 TPS | 3,068 TPS |
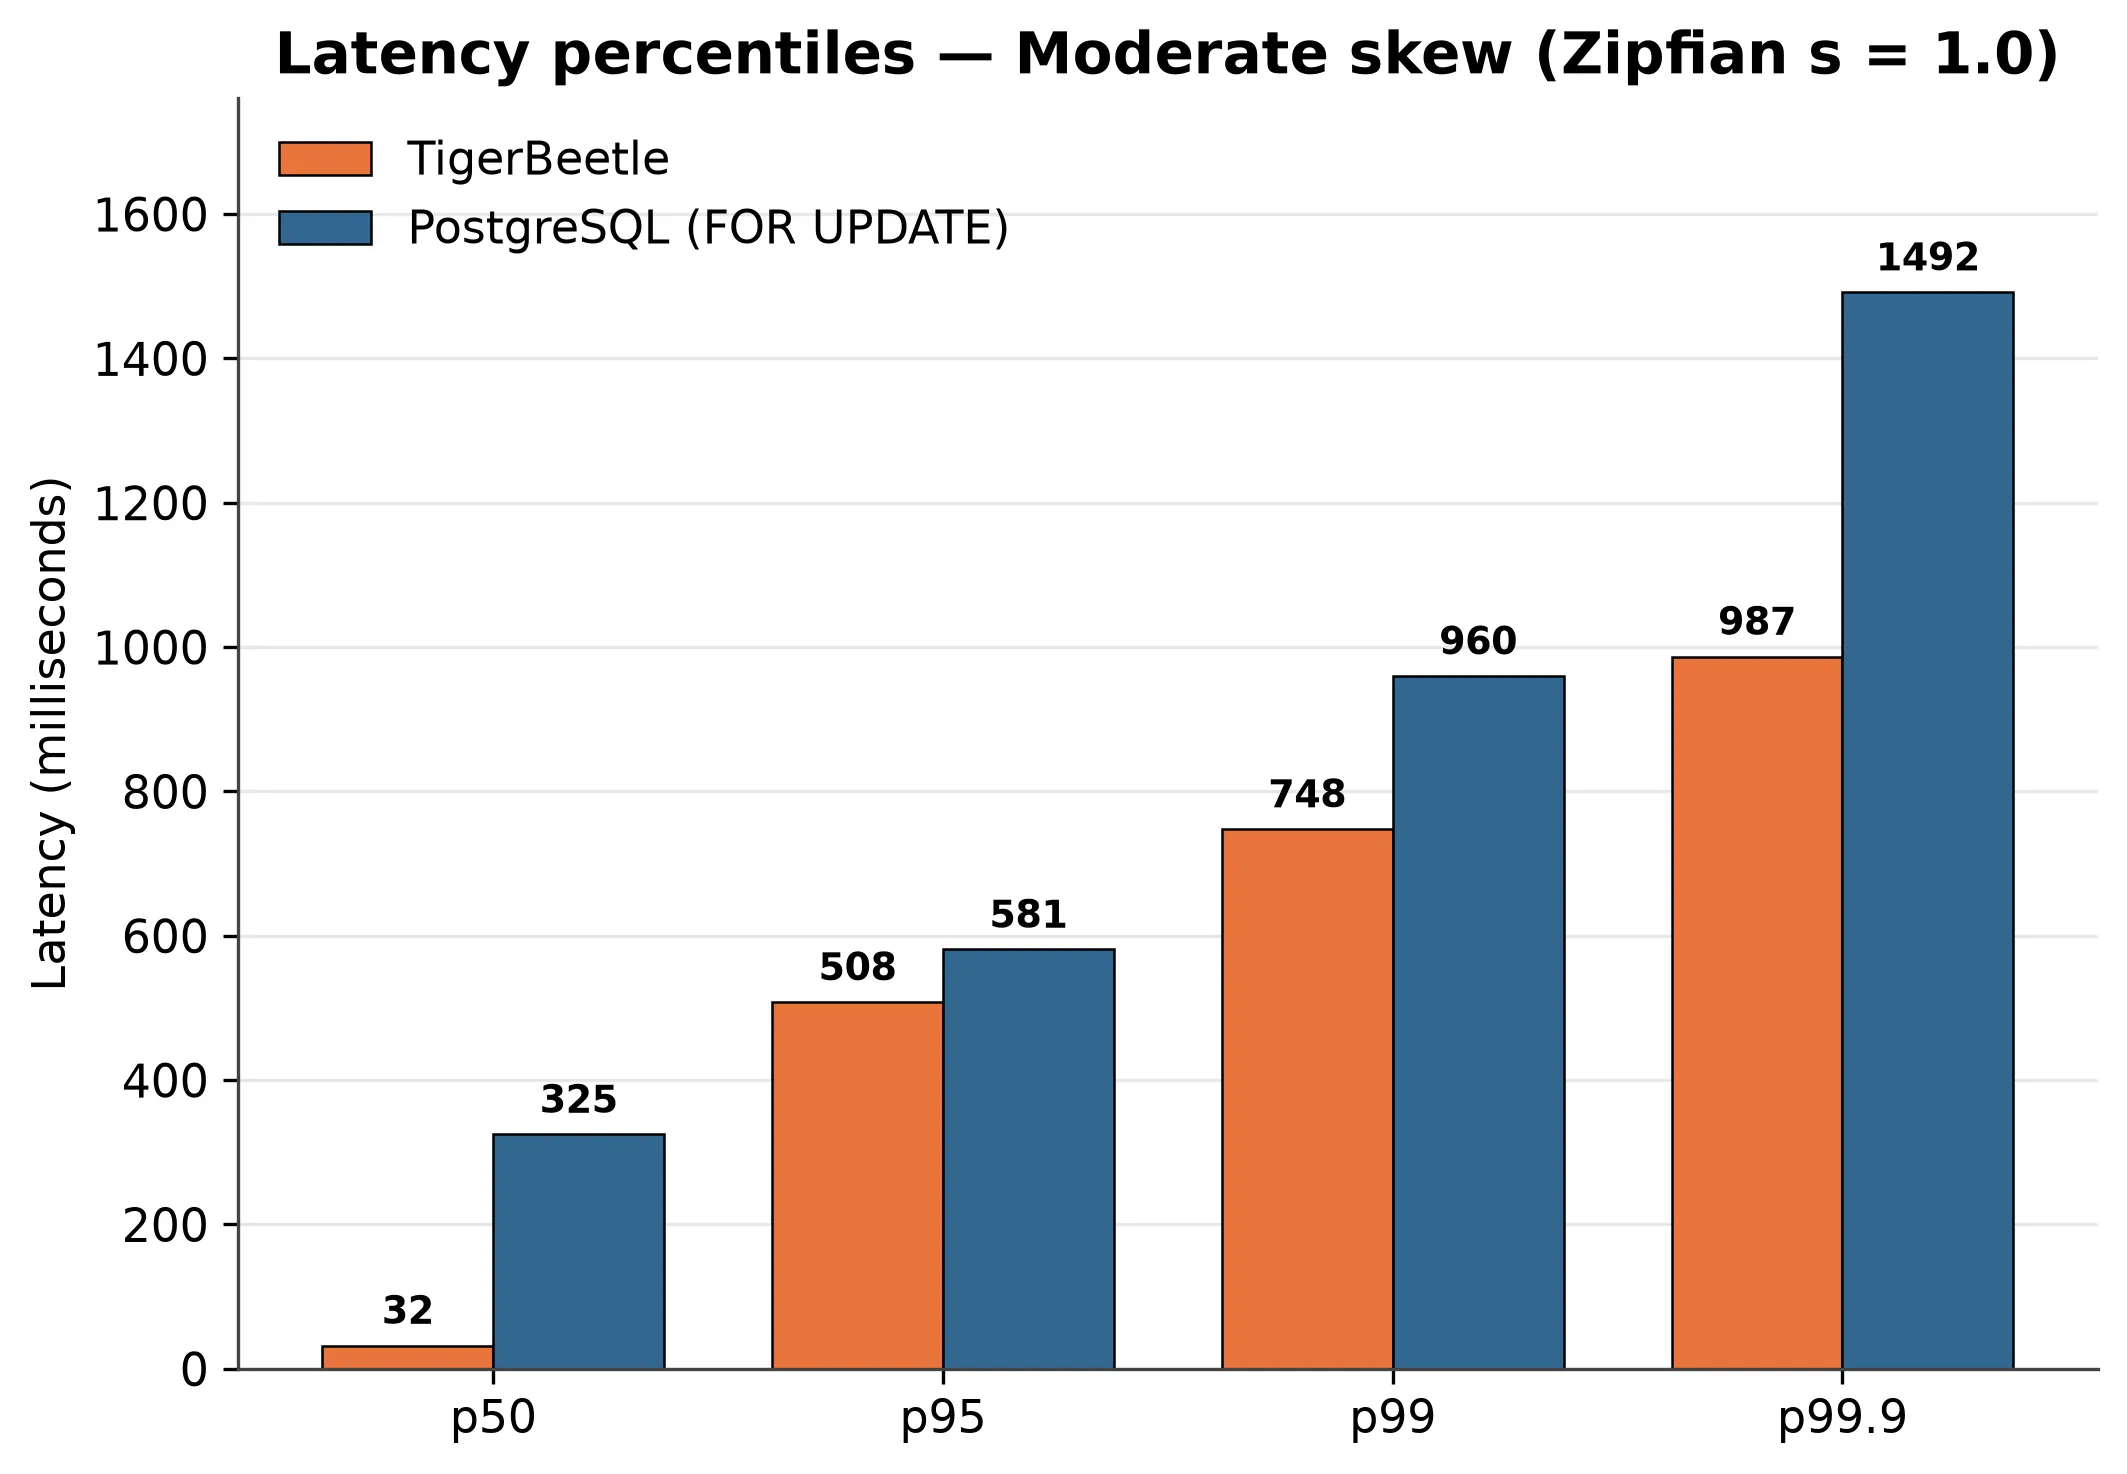
| p50 latency | 32.3 ms | 324.7 ms | 303.7 ms |
| p95 latency | 508 ms | 581 ms | 556 ms |
| p99 latency | 748 ms | 960 ms | 927 ms |
| p999 latency | 987 ms | 1,492 ms | 1,473 ms |
| Սխալների մակարդակ | 0% | 0% | 0% |
| Balance-ը ստուգված | 3/3 | 3/3 | 3/3 |
| Hotspot (zipfian=2.0) | |||
| Թեստի ռեժիմ | fixed_rate |
fixed_rate |
fixed_rate |
| Միջին թողունակություն | 4,461 TPS | 753 TPS | 977 TPS |
| p50 latency | 32.1 ms | 1,306 ms | 1,001 ms |
| p95 latency | 358 ms | 1,890 ms | 1,472 ms |
| p99 latency | 560 ms | 2,123 ms | 1,821 ms |
| p999 latency | 726 ms | 2,916 ms | 3,138 ms |
| Սխալների մակարդակ | 0% | 0% | 0% |
| Balance-ը ստուգված | 3/3 | 3/3 | 3/3 |
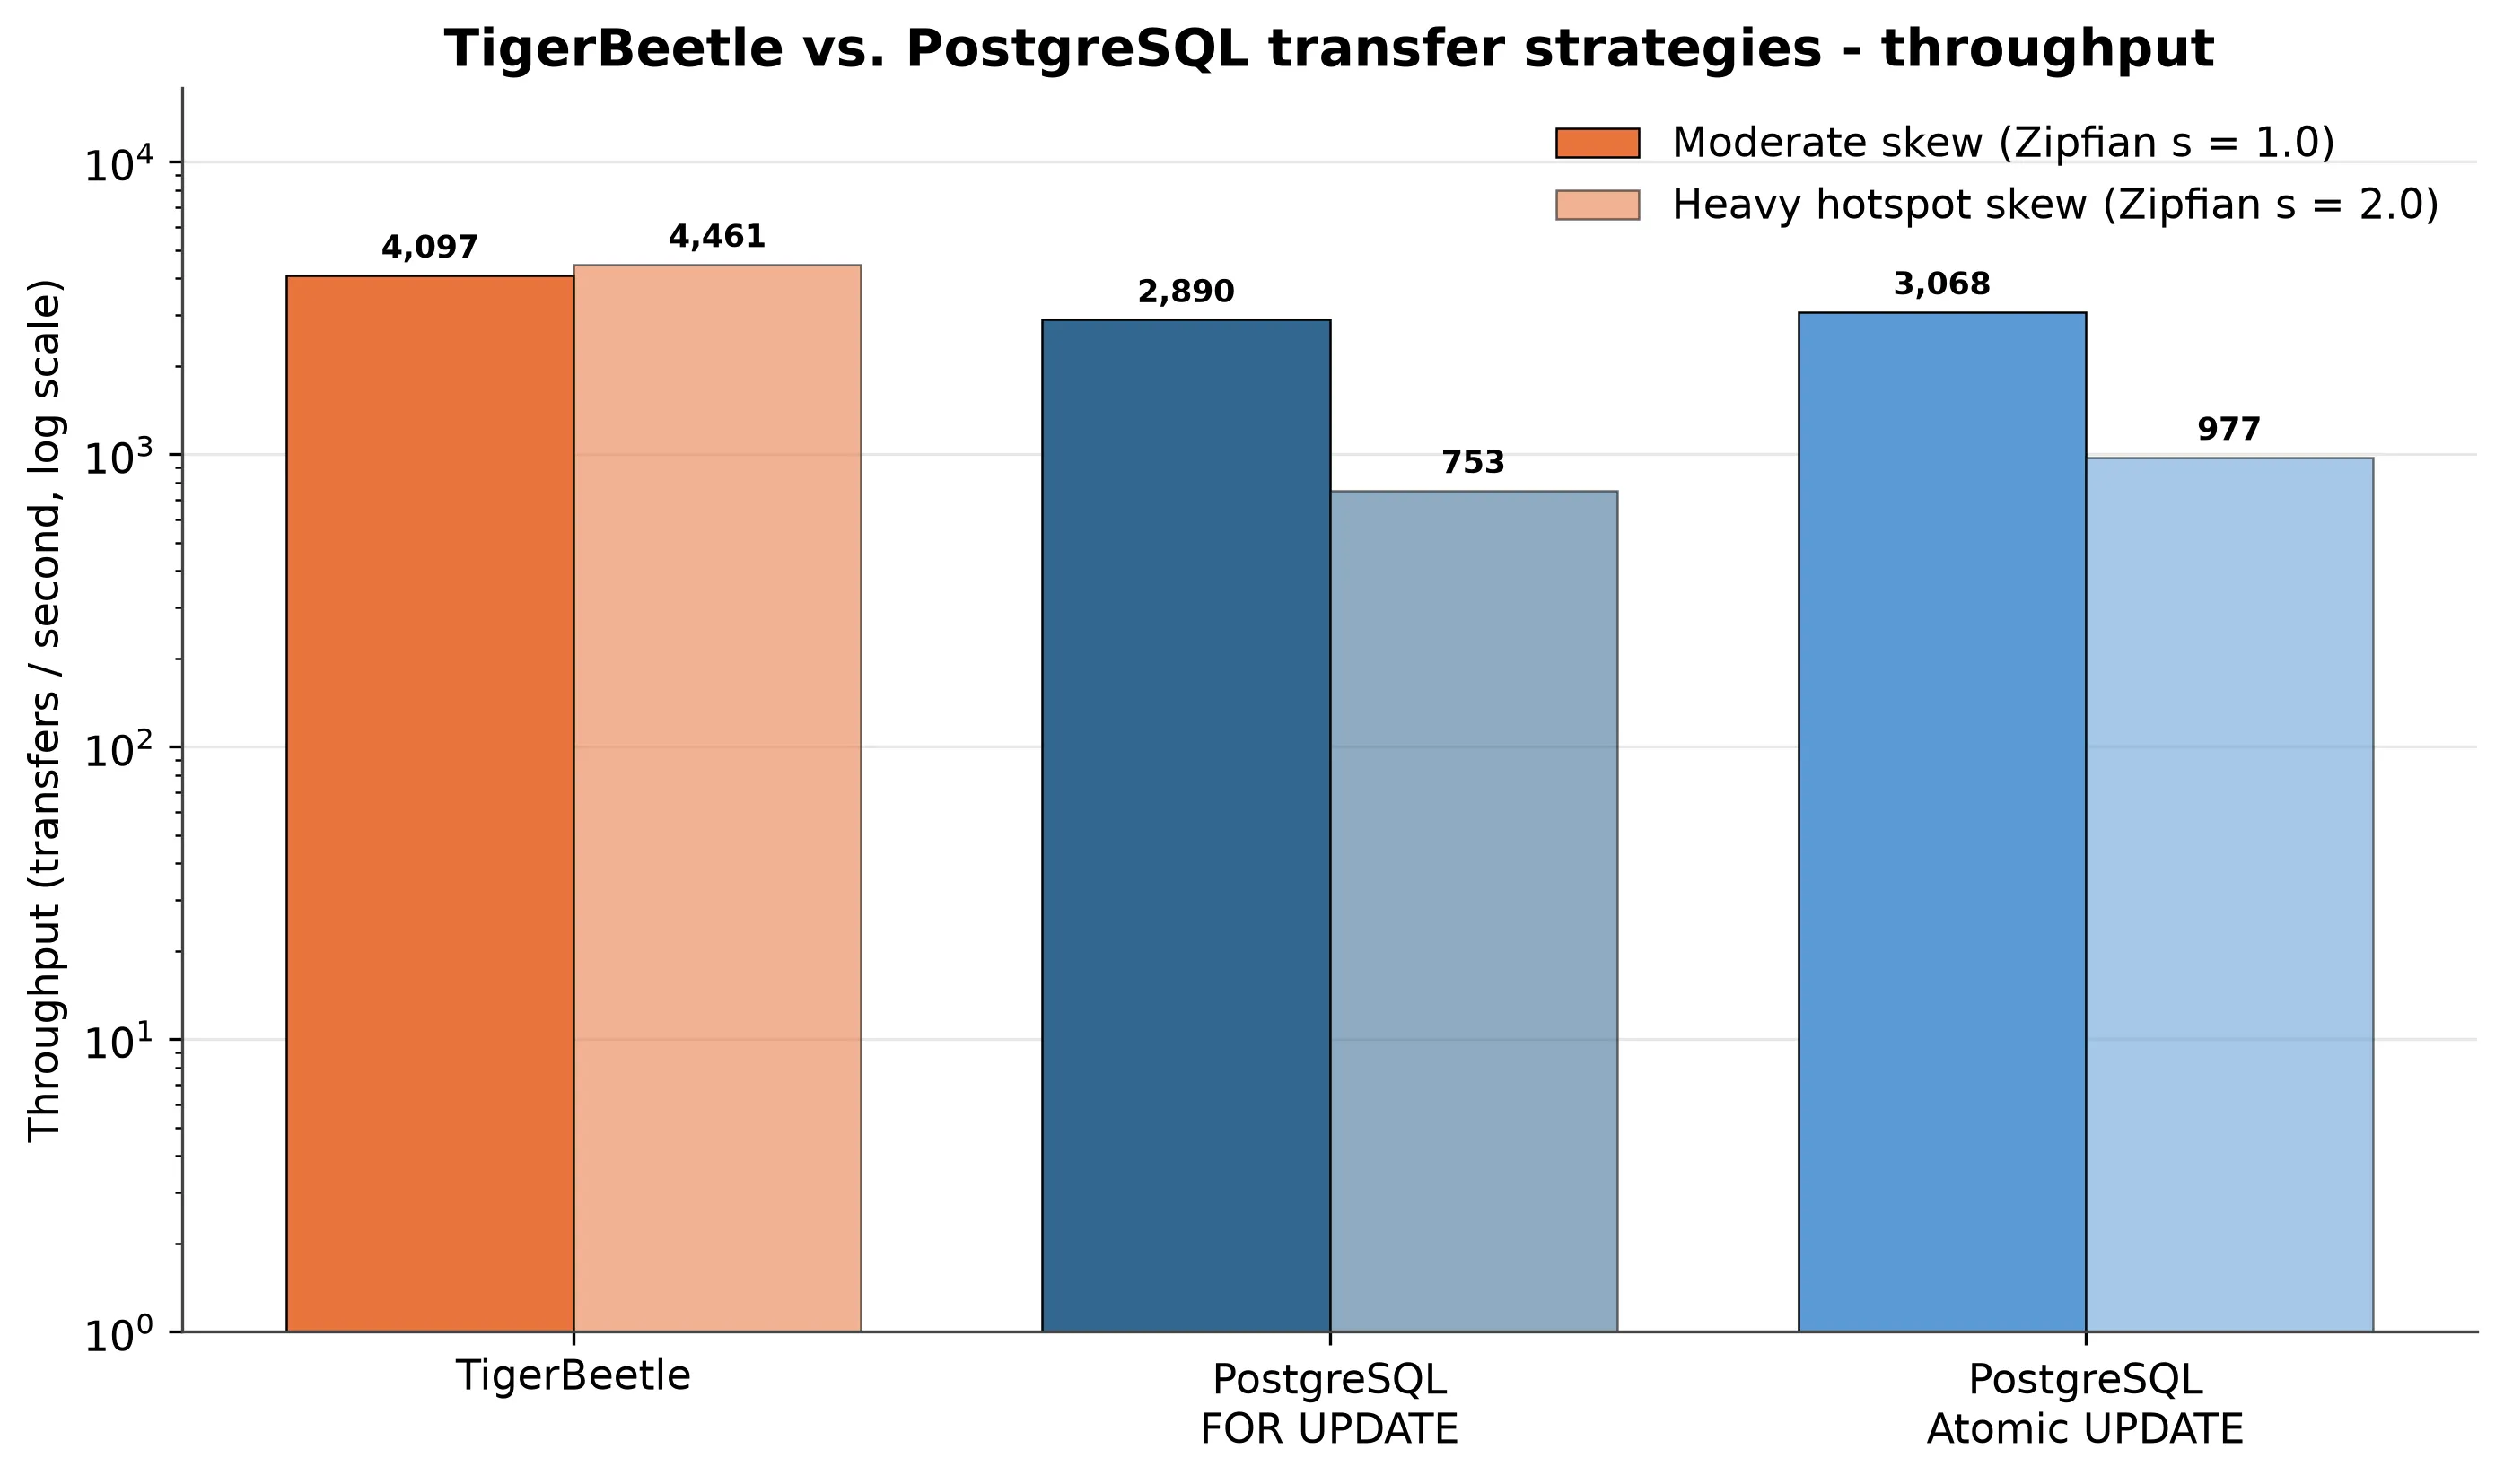
TigerBeetle-ը ապահովում է մոտ 33%-ով ավելի շատ թողունակություն, քան PostgreSQL-ի լավագույն ռազմավարությունը։ Մենք նաև տեսնում ենք, որ երբ շեղումը մեծանում է և ավելի շատ account-ներ դառնում են «թեժ», TigerBeetle-ը պահպանում է իր performance-ը, մինչդեռ PostgreSQL-ի row-locking մոտեցումը զգալիորեն դանդաղում է։ TigerBeetle-ում մեկ միջուկը transfer-ները մշակում է հաջորդաբար, ուստի մրցակցություն չկա, մինչդեռ PostgreSQL-ում կապերը պետք է սպասեն, երբ դրանցից մի քանիսը փորձում են թարմացնել նույն տողը։ TigerBeetle-ը մոտենում է թիրախային արագության հագեցմանը։ Հաջորդ benchmark-ներում կտեսնենք, թե ինչպես այն իրականում հասնում է թիրախային արագությանը։ Մենք դրան հասնում ենք՝ թույլ տալով ավելի շատ ընթացքի մեջ գտնվող հարցումներ, որպեսզի կլիենտները դադարեն կորցնել այն հարցումները, որոնք այլապես կարող էին սպասարկվել։
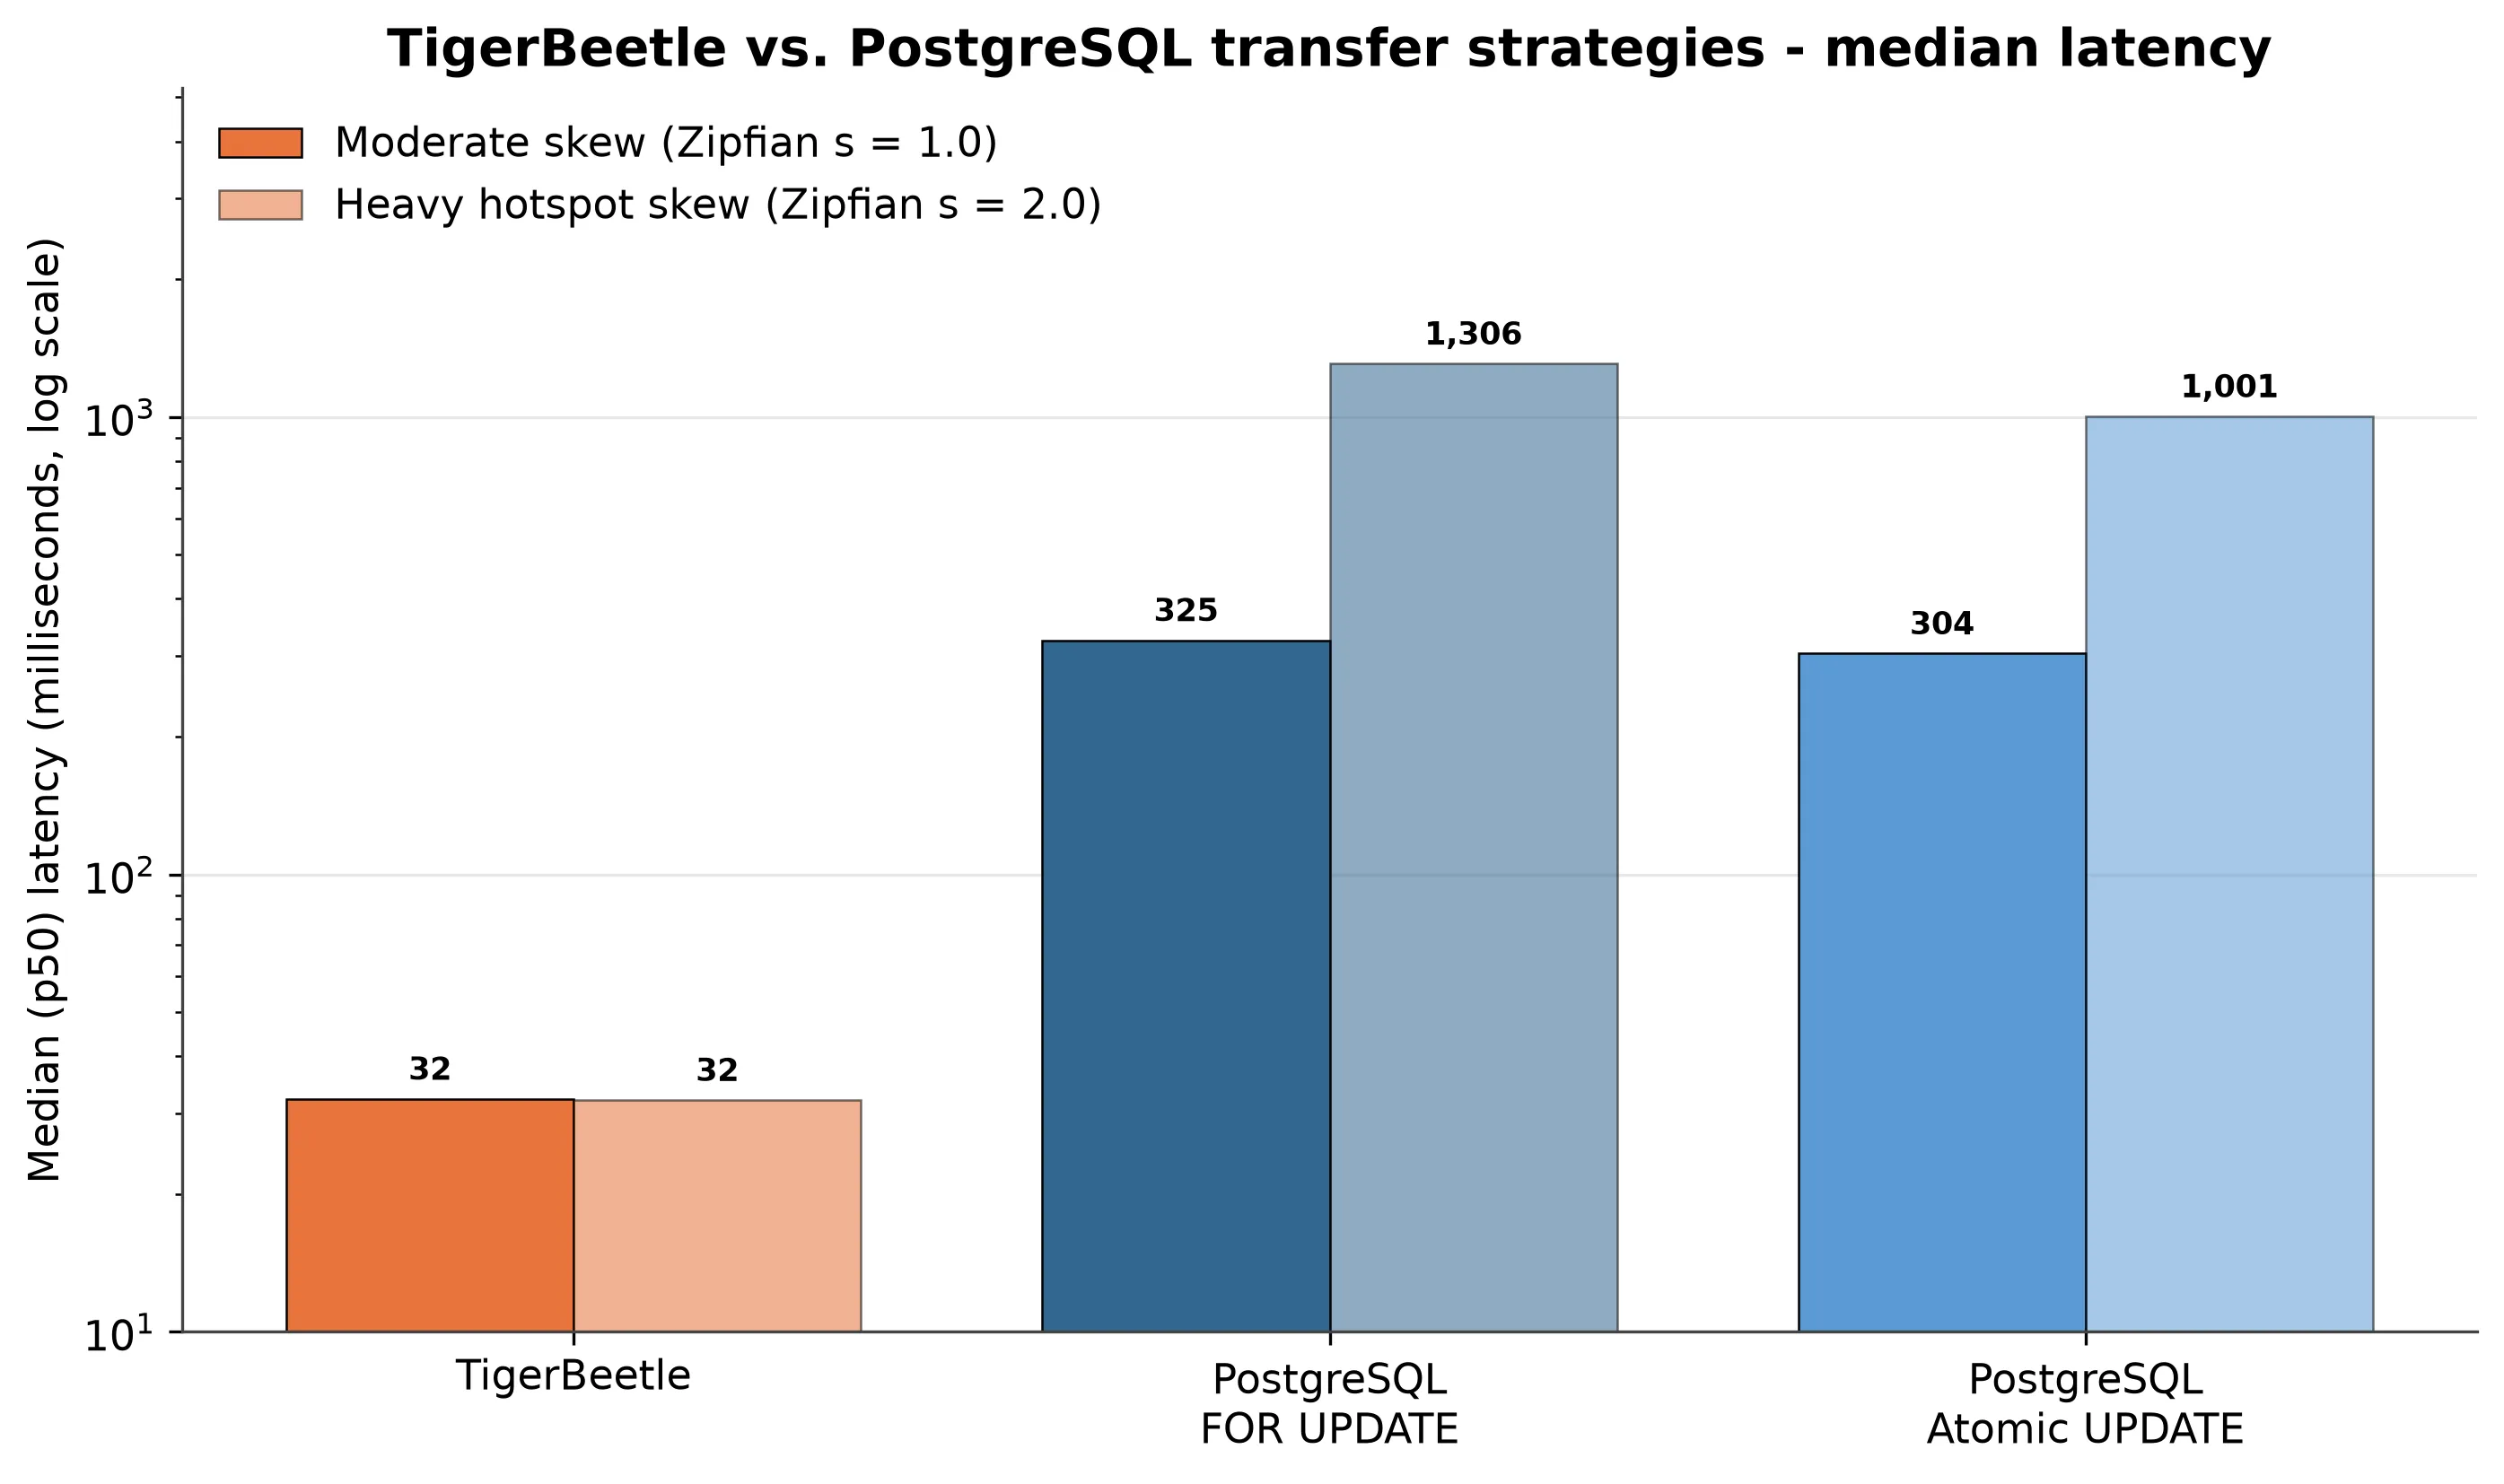
Latency-ի գրաֆիկը ցույց է տալիս ավելի սուր հակադրություն։ TigerBeetle-ը մնում է կայուն՝ անկախ նրանից, թե որքան հաճախ են դիպչում նույն account-ներին, մինչդեռ PostgreSQL-ը պետք է սպասի lock-երին՝ տողը թարմացնելուց առաջ, ինչը հանգեցնում է ընդհանուր առմամբ ավելի բարձր latency-ի և պարբերական մեծ թռիչքների։ Եկեք համեմատենք պերցենտիլները PostgreSQL-ի FOR UPDATE-ի հետ չափավոր շեղման դեպքում։
Եկեք ստուգենք նաև ավելի բարձր շեղումը, որտեղ PostgreSQL-ը սկսում է զգալիորեն դանդաղել։
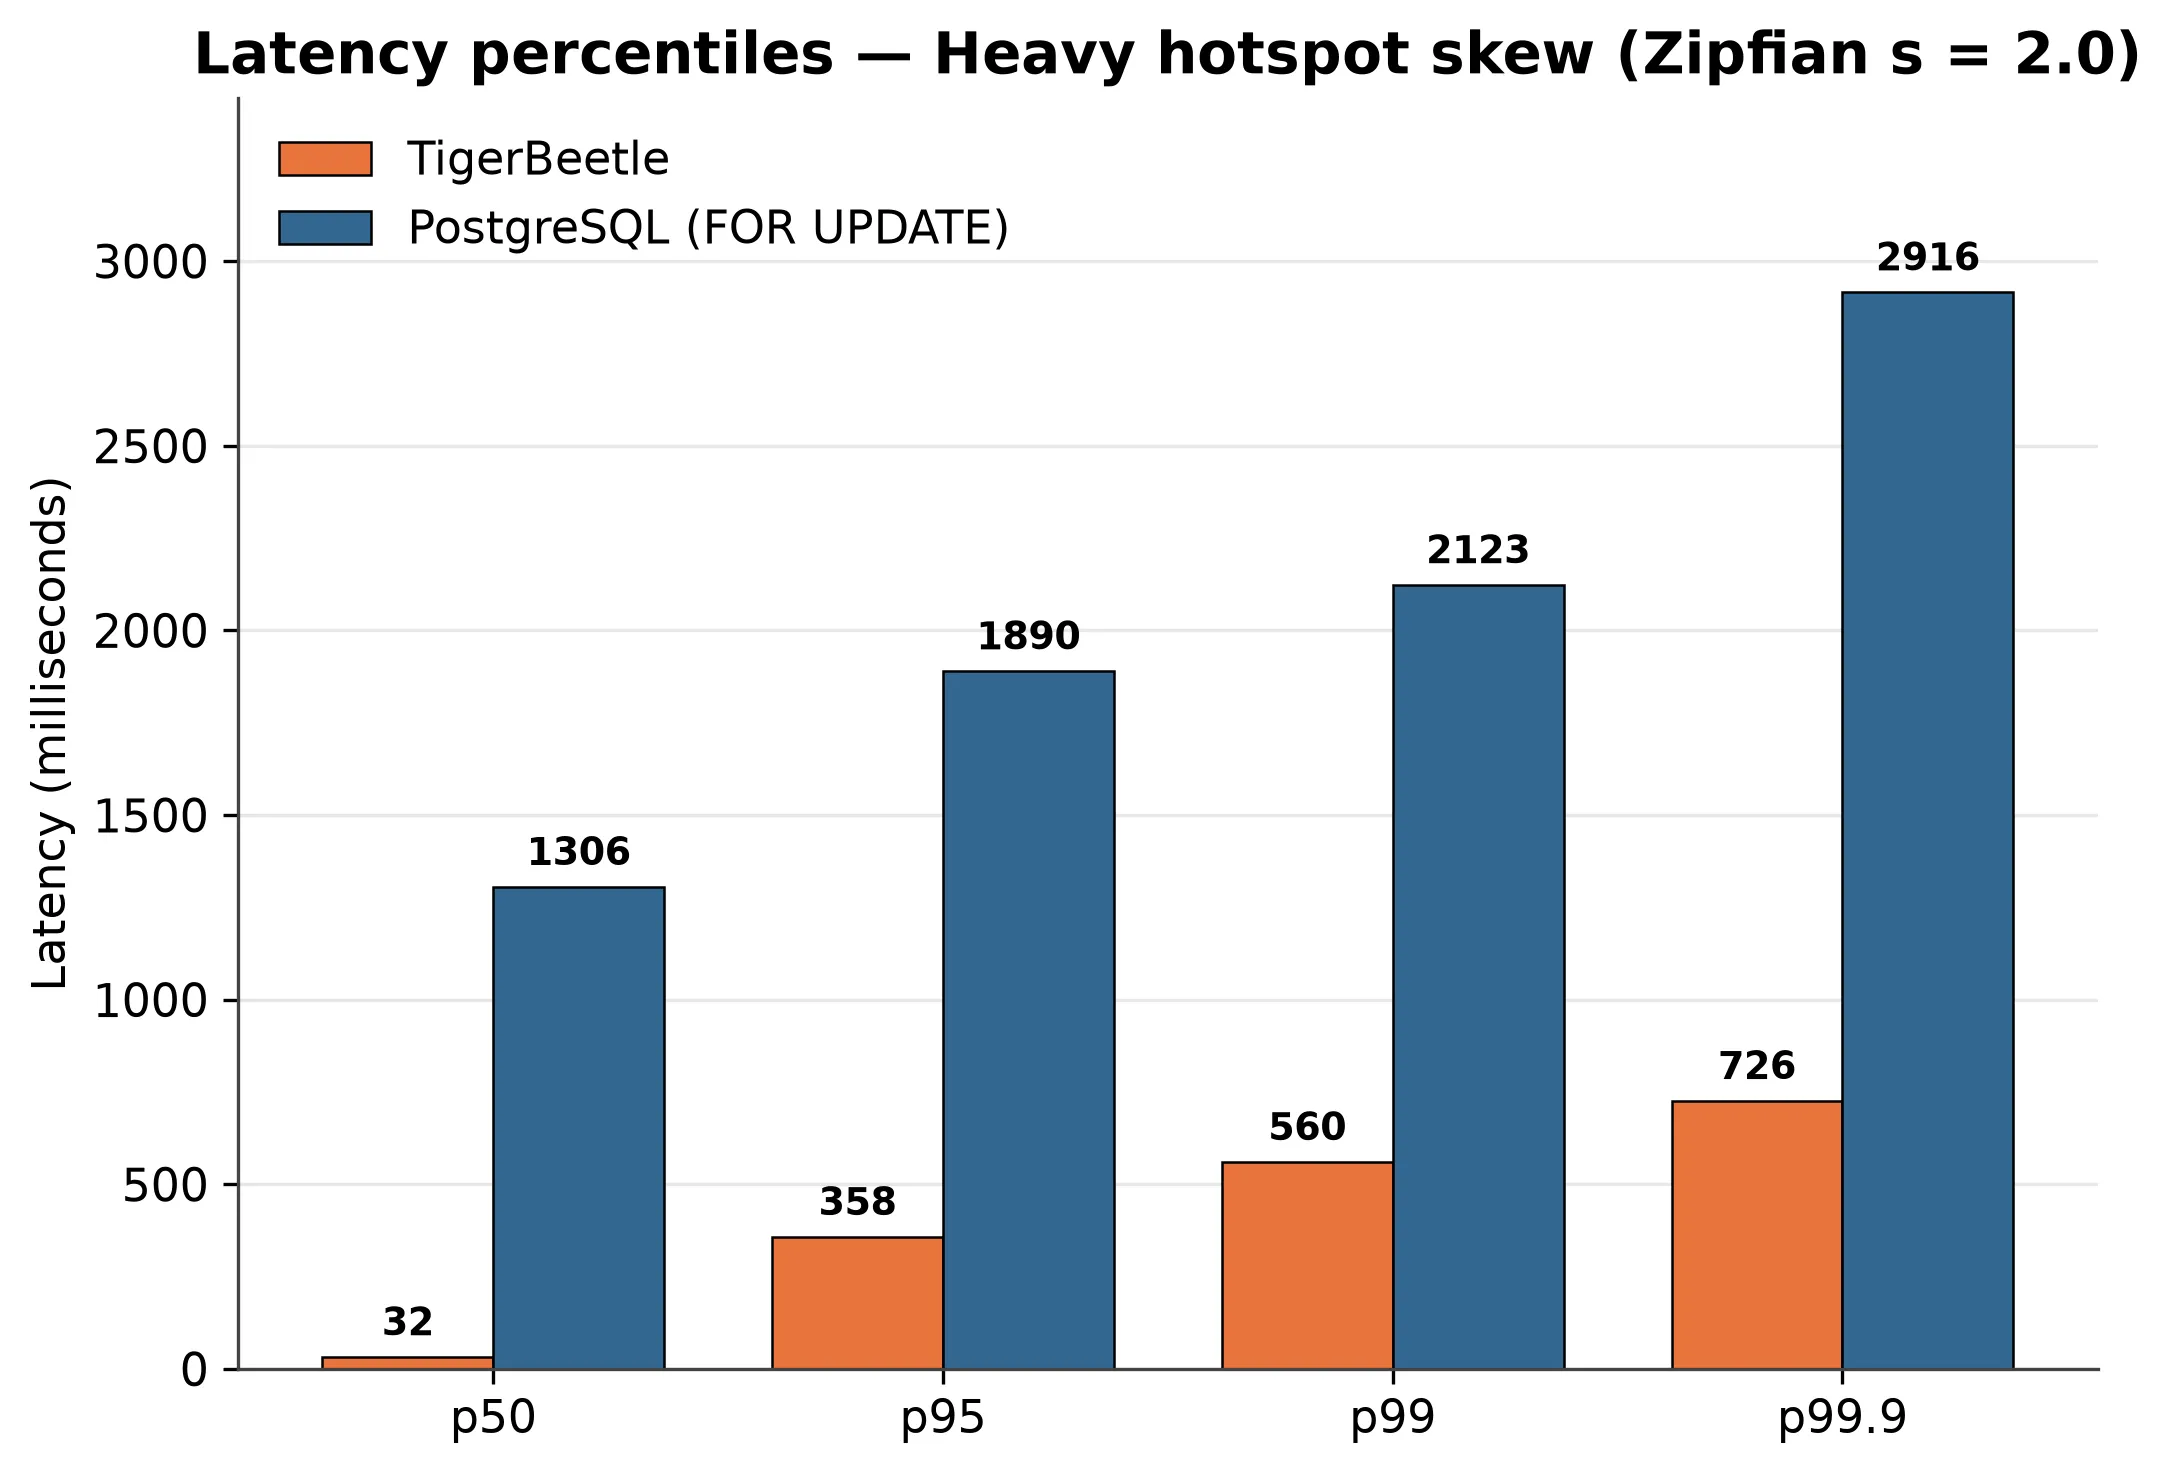
Ակնհայտ է, որ lock-երը իդեալական ընտրություն չեն. քանի որ ավելի շատ account-ներ դառնում են «թեժ», latency-ը շարունակում է աճել, մինչդեռ TigerBeetle-ում այն իրականում նվազում է։
Հիմնական եզրակացություններ
- TigerBeetle-ը առաջ է անցնում բոլոր մետրիկաներով շեղման երկու սցենարներում։ Նրա թողունակությունը 40%-ով բարձր է չափավոր շեղման դեպքում և ~4.6 անգամ բարձր՝ ուժեղ hotspot շեղման դեպքում, իսկ latency-ը շատ ավելի ցածր է՝ 4-ից 40 անգամ։
- Ավելի բարձր շեղման դեպքում TigerBeetle-ը իրականում դարձավ ավելի արագ (և՛ ավելի բարձր թողունակություն, և՛ ավելի ցածր latency)։ Ավելի շատ հարցումներ արագ մերժվում են (անբավարար balance-ի պատճառով)՝ lock-ի վրա սպասելու փոխարեն։ PostgreSQL-ի երկու ռեժիմներն էլ վատ աշխատեցին hotspot շեղման դեպքում։
- Ճշտությունը պահպանվեց ամբողջ ընթացքում։ Յուրաքանչյուր սցենարի յուրաքանչյուր թեստ բավարարում է երկակի հաշվապահության invariant-ը. տարբերությունները միայն performance-ում են։
Թեև TigerBeetle-ը չի թվում ճնշման տակ, մենք դեռ չենք հասնում 5k թողունակության։ Պատճառը նախկինում նշված max_concurrency կարգավորումն է. չափազանց շատ ընթացքի մեջ գտնվող հարցումներ կային, ուստի որոշները կորան։ PostgreSQL-ի դեպքում թողունակության առաստաղը և latency-ը, կարծես, բխում են lock-երից, ինչը TigerBeetle-ի դեպքում այդպես չէ։ Հաջորդիվ կփորձենք որոշել TigerBeetle-ի սահմանը այս կարգավորմամբ՝ ուժեղ hotspot շեղման դեպքում, նրան ավելի շատ տեղ տալով max_concurrency-ի ավելի մեծ արժեքով։
TigerBeetle-ը իր սահմանին հասցնելը
Մենք max_concurrency-ն սահմանեցինք թիրախային հարցումներ-վայրկյանում արագության 2.5 անգամ։ Դա պետք է կլիենտին թույլ չտա հարցումներ կորցնել, մինչդեռ տվյալների բազան դեռ կարող է դրանք մշակել։ Այս թեստերը օգտագործում են hotspot account-ներ (Zipfian = 2.0), քանի որ դա, կարծես, ավելի մոտ է իրական պայմաններին։
| Մետրիկա | TigerBeetle | PostgreSQL Standard | PostgreSQL Atomic |
|---|---|---|---|
| concurrency5k | |||
| Միջին թողունակություն | 5,060 TPS | 683 TPS | 878 TPS |
| Կորցրած հարցումներ | 0 | 3.9M | 3.8M |
| rate10k | |||
| Միջին թողունակություն | 9,431 TPS | 703 TPS | 867 TPS |
| Կորցրած հարցումներ | 598K (~9%) | 8.5M | 8.4M |
| rate20k | |||
| Միջին թողունակություն | 20,257 TPS | չի փորձարկվել | չի փորձարկվել |
| Կորցրած հարցումներ | 0 | - | - |
| rate40k | |||
| Միջին թողունակություն | 40,388 TPS | չի փորձարկվել | չի փորձարկվել |
| Կորցրած հարցումներ | 0 | - | - |
| rate80k | |||
| Միջին թողունակություն | 81,171 TPS | չի փորձարկվել | չի փորձարկվել |
| Կորցրած հարցումներ | 0 | - | - |
| rate90k | |||
| Միջին թողունակություն | 91,165 TPS | չի փորձարկվել | չի փորձարկվել |
| Կորցրած հարցումներ | 0 | - | - |
| rate100k | |||
| Միջին թողունակություն | 101,497 TPS | չի փորձարկվել | չի փորձարկվել |
| Կորցրած հարցումներ | 0 | - | - |
| rate120k | |||
| Միջին թողունակություն | 107,112 TPS – առաջարկված բեռի ընդամենը 89%-ը | չի փորձարկվել | չի փորձարկվել |
| Կորցրած հարցումներ | առաջարկված բեռի ~12%-ը | - | - |
| rate160k | |||
| Միջին թողունակություն | 107,858 TPS – առաջարկված բեռի ընդամենը 67%-ը | չի փորձարկվել | չի փորձարկվել |
| Կորցրած հարցումներ | առաջարկված բեռի ~34%-ը | - | - |
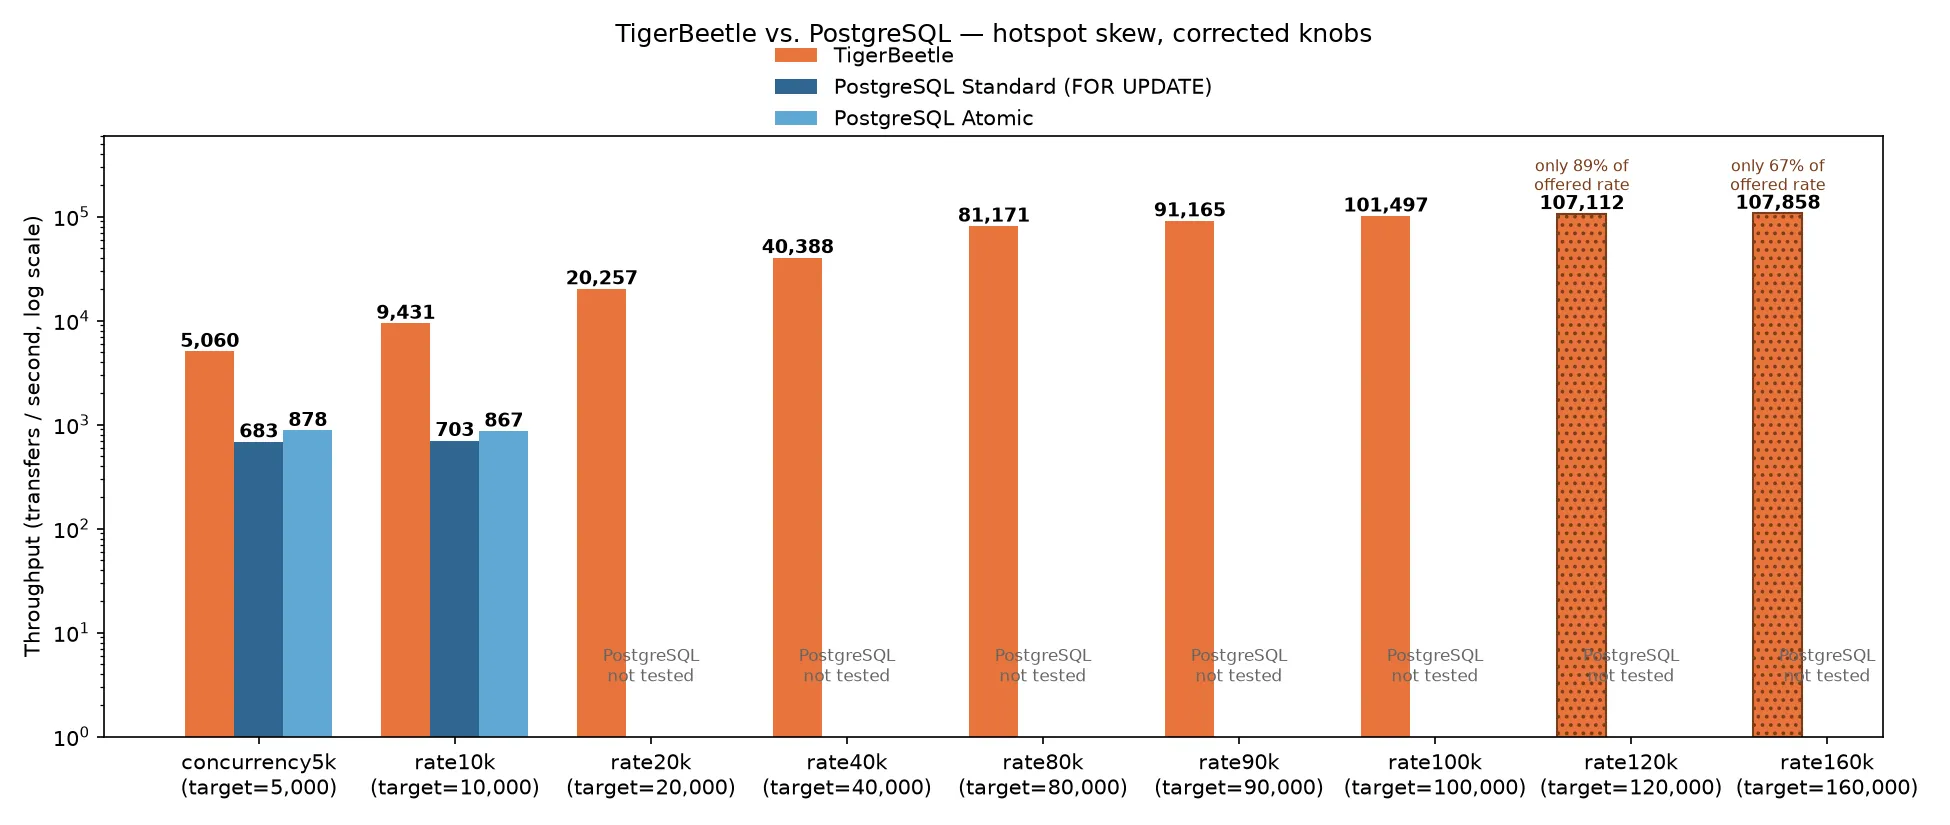
Ավելի շատ միաժամանակյա ընթացքի մեջ գտնվող հարցումներ թույլ տալը մեզ հնարավորություն է տալիս հասնել թիրախային արագության։ PostgreSQL-ը նշանակալի փոփոխություն չցուցաբերեց։ Այս կարգավորմամբ մեզ հաջողվեց TigerBeetle-ը մղել վայրկյանում 100k հարցումից վեր, ինչը ցույց է տալիս, թե որքան մեծ տարբերություն կարող է ստեղծել մասնագիտացված ճարտարապետությունը։ Ստուգենք նաև latency-ը, քանի որ max_concurrency-ի ավելի բարձր արժեքը կարող է նշանակել ավելի բարձր latency։
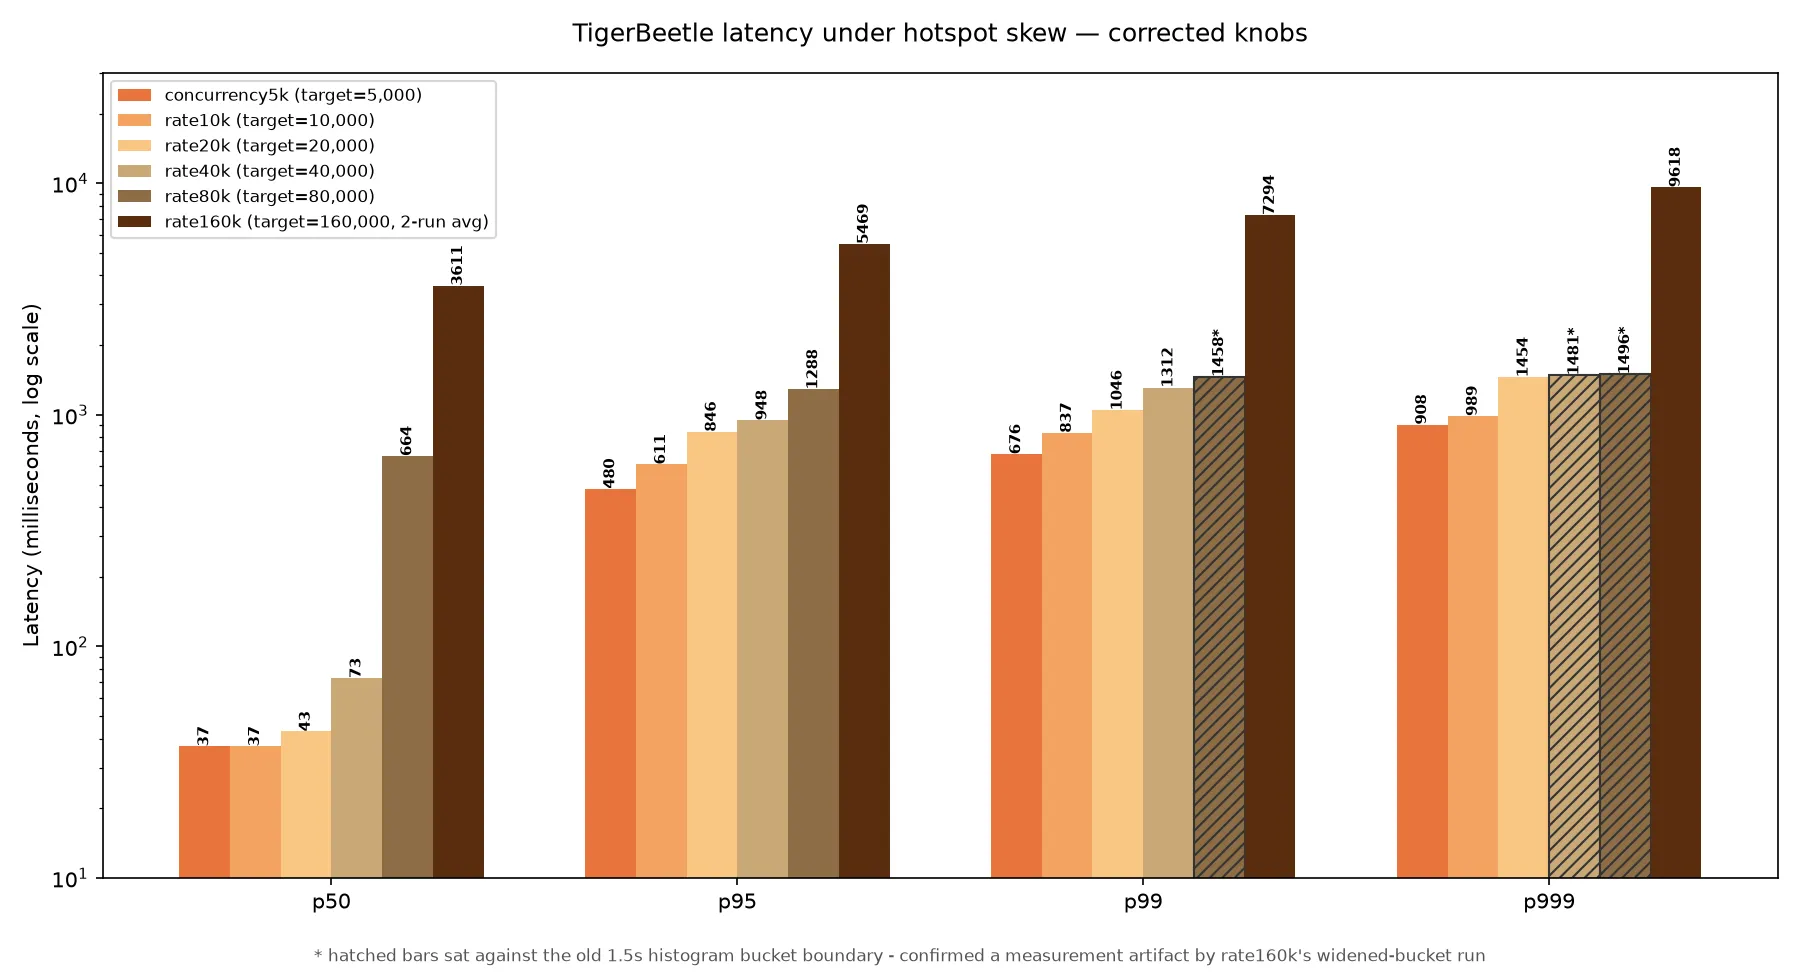
Նշում հատկապես rate160k-ի թվերի մասին. դրանք պլանավորված 3 գործարկումներից 2-ի միջինն են։ Coordinator գործընթացը դադարեցվեց այն գործարկող ֆոնային առաջադրանքի վրա դրված ~24.5 րոպեանոց խիստ սահմանաչափով։ Սա տեղի ունեցավ մի քանի փորձի ժամանակ, ամեն անգամ հենց այն պահին, երբ սկսվում էր երրորդ գործարկման balance-ի ստուգումը, երբ առաջին երկու գործարկումներն արդեն ավարտվել էին և ամեն անգամ մաքուր անցել էին balance-ի ստուգումը։
Աստղանիշով նշված շտրիխավորված սյուները ընկան կլիենտի հիստոգրամի bucket-ների սահմաններից մեկից հենց ներքևում՝ 1.5 s 40k, 80k և 90k արագությունների համար և 4 s՝ 120k արագության համար։ Քանի որ Prometheus-ը ինտերպոլացիա է անում վերջավոր bucket-ի ներսում, և այդ սահմաններից վերև bucket-ները կային, բայց մնացին դատարկ, այս արժեքները վերին սահմաններ են։
Ամփոփում
Մեր benchmark-ներում TigerBeetle-ը, կարծես, արդարացնում է իր խոստումը։ Վայրկյանում 40k հարցումների ծանր տրաֆիկի դեպքում տվյալների բազան latency-ը պահում է խելամիտ 70 ms-ի վրա։ Միևնույն ժամանակ այն հասնում է PostgreSQL-ից ավելի քան 5 անգամ բարձր թողունակության մեր 5k թեստում և 10 անգամ բարձր՝ 10k թեստում։ TigerBeetle-ը կարող է նույնիսկ ապահովել 100 անգամ բարձր թողունակություն latency-ի հաշվին, և այնուհանդերձ վայրկյանում 100k հարցման դեպքում նրա latency-ը դեռ ավելի ցածր է, քան PostgreSQL-ինը, որը սպասարկում է ընդամենը 5k հարցում վայրկյանում։ Մենք ձգտեցինք վերստեղծել ավելի իրատեսական միջավայր և բեռնվածք երկու տվյալների բազաները փորձարկելու համար, և տարբերությունները դեռ հստակ են. TigerBeetle-ն առաջարկում է ավելի ցածր latency, ավելի բարձր թողունակություն և ավելի կայուն վարք՝ չնայած տարբեր բեռնվածքին։