Սկսել լոգո՞վ, թե՞ աղյուսակով. Apache Kafka, Fluss և streaming աղյուսակներ
Ճարտարապետական մակարդակում համեմատվում են log-first ստրիմինգային համակարգերը (Apache Kafka) և table-first պահպանման աբստրակցիաները (Apache Fluss)՝ դիտարկելով CDC բեռնվածությունները, կրկնօրինակված վիճակը և lakehouse-ի հետ ինտեգրումը։
Ստրիմինգային ճարտարապետության համար Apache Kafka-ն ակնհայտ մեկնարկային կետն է։ Հավելվածները իրադարձություններ են հրապարակում Kafka-ում, մյուս հավելվածները կարդում են դրանք, իսկ տվյալները, որոնք պետք է պահվեն ավելի երկար, վաղ թե ուշ հայտնվում են օբյեկտային պահոցում։ Բավականին տարածված կարգավորումը հենվում է Kafka Connect-ի վրա՝ S3 sink connector-ով, ինչպես Confluent-ի Amazon S3 Sink Connector-ը, որպեսզի ավելի հին տվյալները տեղափոխվեն Amazon S3.
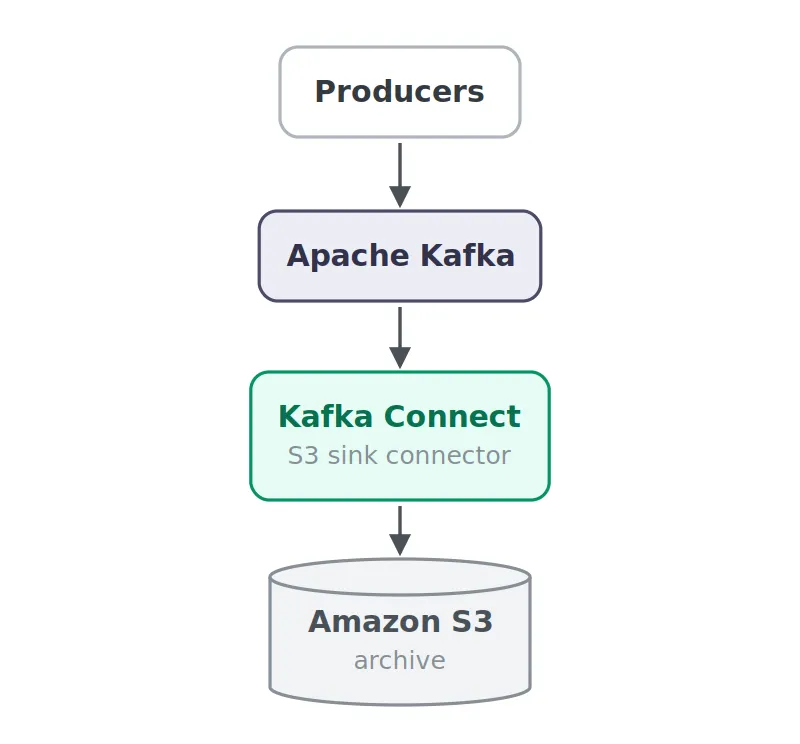
Kafka-ն հոգ է տանում իրական ժամանակի ուղու մասին, S3-ը առաջարկում է էժան, դիմացկուն պահոց պատմական տվյալների համար, և արխիվացման նպատակով դա հաճախ բավական է։ Դժվարությունները սկսվում են, երբ S3-ի տվյալները պետք է արդեն ոչ թե արխիվի, այլ տվյալների բազայի աղյուսակի պես աշխատեն։
Պատկերացրեք Kafka topic, որը պահում է հաճախորդների թարմացումները.
customer-123 -> { name: "Alice", status: "active" }
customer-456 -> { name: "Bob",   status: "active" }
customer-123 -> { name: "Alice", status: "blocked" }
Այս գրառումները Parquet-ի մեջ թափելը պարզ է։ Հարցերի մեկ այլ խմբի պատասխանելը շատ ավելի դժվար է.
- Ի՞նչ տեսք ունի յուրաքանչյուր հաճախորդը հենց հիմա։
- Ինչպե՞ս ներկայացնել թարմացումներն ու ջնջումները։
- Ո՞ր ֆայլերն են կազմում տվյալների հավաքածուի համահունչ տարբերակը։
- Ի՞նչ է տեղի ունենում, երբ սխեման զարգանում է։
- Ինչպե՞ս խուսափել հազարավոր մանր ֆայլերի ստեղծումից։
- Ինչպե՞ս կարող են մի քանի հարցման շարժիչներ նույն տվյալների հավաքածուն անվտանգ կարդալ այն թարմացվելու ընթացքում։
S3-ը մեզ ֆայլեր է տալիս։ Աղյուսակը այն է, ինչ նա չի տրամադրում։
Ֆայլերից՝ աղյուսակներ
Այս բացը լրացնում են բաց աղյուսակային ձևաչափերը, ինչպես Apache Iceberg-ը և Apache Paimon-ը։ Դրանք ֆայլերը փաթաթում են մետատվյալների մեջ՝ սխեմա, snapshot-ներ, բաժանումներ, տվյալների ֆայլեր և փոփոխությունները մի տարբերակից մյուսը։ Այդ դեպքում ճարտարապետությունն ավելի շատ այսպիսին է.
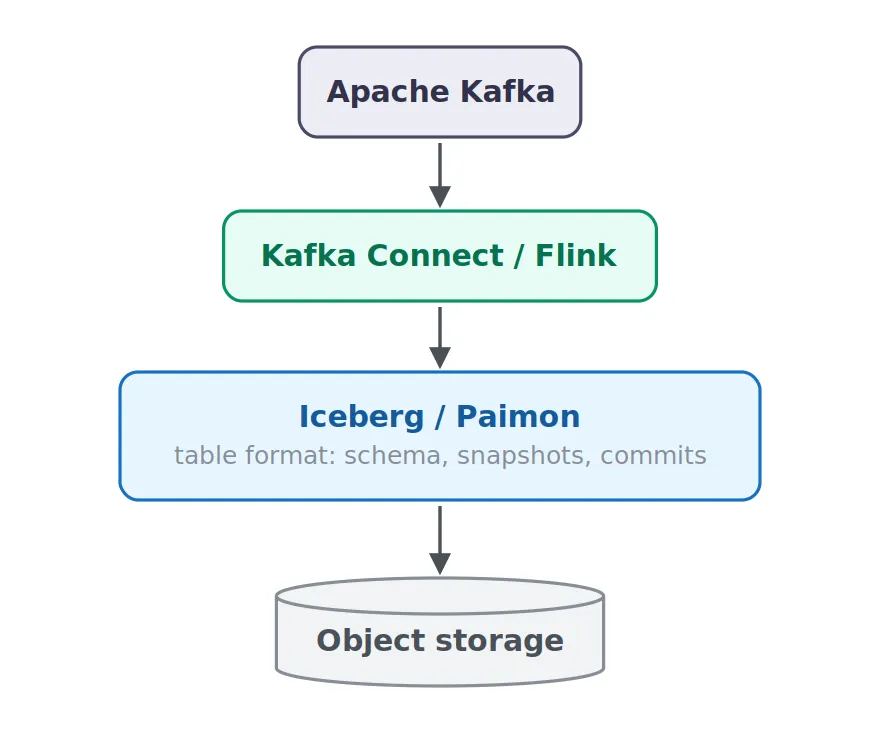
Փոխվում է ոչ միայն ֆայլերի դասավորությունը։ Մենք այլևս պարզապես ֆայլեր չենք գրում, այլ աղյուսակ ենք պահպանում։ Հարցումները կարող են կատարվել համահունչ snapshot-ի դեմ, սխեմայի փոփոխությունները կարելի է հետևել, իսկ տվյալների ֆայլերը կարող են սեղմվել (compact) կամ փոխարինվել՝ առանց ընթերցողներին երբևէ կիսով չափ թարմացված վիճակ ցույց տալու։
Այնուհանդերձ, ինչ-որ մեկը պետք է Kafka-ի հոսքը վերածի այդ աղյուսակի։ Գործնականում դա նշանակում է շահագործել ևս մեկ ենթակառուցվածք՝ Kafka Connect, Apache Flink, Spark Structured Streaming, AWS Glue կամ սեփական ingestion ծառայություն։ Եվ այս ծառայությունը շատ ավելի շատ գործ ունի, քան բայթերը Kafka-ից S3 տեղափոխելը։ Այն կարող է ստիպված լինել հասկանալ սխեմաները, CDC գրառումները փոխարկել insert-ների, update-ների և delete-ների, ստեղծել աղյուսակի commit-ներ, վերահսկել ֆայլերի չափերը, սեղմել մանր ֆայլերը և գրանցել մետատվյալները կատալոգում։
Այս խողովակաշարը պարզեցնելու երկու նշանակալի մոտեցում կա։ Confluent-ի Tableflow-ը Kafka-ից lakehouse materialization-ը դարձնում է Confluent Cloud-ի կառավարվող հնարավորություն. դրան կվերադառնանք ավելի ուշ։ Apache Fluss-ը այլ ճանապարհով է գնում և հարցնում է, թե արդյոք ստրիմինգային շերտը ընդհանրապես պետք է լոգ լինի։ Նախքան Fluss-ին անցնելը՝ արժե հստակ ձևակերպել, թե ինչ է առաջարկում Kafka-ն։
Kafka-ն մնում է լոգ
Kafka-ի partition-ը կարգավորված լոգ է։ Յուրաքանչյուր գրառում ունի offset, producer-ները ավելացնում են գրառումներ, իսկ consumer-ները առաջանում են լոգով և կարող են հետ գնալ՝ ավելի հին տվյալները կրկին կարդալու համար։
Այս մոդելը միտումնավոր պարզ է։ Kafka-ին պետք չէ իմանալ՝ գրառումը ներկայացնում է հաճախորդ, հաշիվ-ապրանքագիր, տվյալների բազայի տող, թե HTTP հարցում. broker-ի համար գրառման արժեքը հիմնականում անթափանց բայթային հաջորդականություն է։ Սա Kafka-ի ուժեղ կողմերից մեկն է և պատճառը, թե ինչու է այն այդքան լավ աշխատում որպես ընդհանուր նշանակության իրադարձությունների ողնաշար։ Բայց դա նաև նշանակում է, որ Kafka-ի պահպանման աբստրակցիան, իր էությամբ, լոգ է։
Վերցնենք compacted topic.
offset 100: customer-123 -> active
offset 101: customer-456 -> active
offset 102: customer-123 -> blocked
Ինչ-որ պահի լոգի compaction-ը կարող է հեռացնել customer-123-ի ավելի հին արժեքը և պահել նորը։ Սա compacted topic-ը նմանեցնում է key-value պահոցի, բայց միայն հեռվից նայելիս։ Kafka-ն պահում է բավարար տեղեկություն՝ վերջին վիճակը վերակառուցելու համար, բայց այդ վիճակը աղյուսակի տեսքով չի բացահայտում։ Ոչ մի broker գործողություն չի համապատասխանում հետևյալին.
SELECT *
FROM customers
WHERE customer_id = 'customer-123';
Consumer-ը կարող է կարդալ լոգը և կառուցել այդպիսի ներկայացում, բայց այդ ներկայացումը գտնվում է այլ տեղ։ Kafka Streams-ը կառուցում է տեղային state store-եր, իսկ ksqlDB-ն, որը գտնվում է Kafka Streams-ի վրա, առաջարկում է հենց այս պատերնը՝ որպես SQL աղյուսակներ, որոնք անընդհատ materialize են արվում topic-ներից։ Flink-ը պահում է operator state, սովորաբար RocksDB-ի աջակցությամբ։ Հավելվածները նաև Kafka-ի տվյալները materialize են անում Redis-ի, Cassandra-ի, PostgreSQL-ի, Elasticsearch-ի կամ այլ տվյալների բազայի մեջ։
Kafka-ի վրա հիմնված նախագծերում ես անընդհատ հանդիպում եմ նույն պատկերի տարբերակներին. հաճախորդների կամ ապրանքների տվյալների հավաքածու, որը պահվում է որպես Flink state՝ հարստացման join-ների համար, կրկնօրինակված Redis-ում, որպեսզի ծառայությունները կարողանան հարցումներ անել ցածր latency-ով, և գրված lakehouse-ում՝ անալիտիկայի համար։ Յուրաքանչյուր պատճենի գոյության հիմնավոր պատճառ կա։ Սակայն միասին վերցրած՝ դա երեք-չորս stateful համակարգ է, որոնք պահում են նույն տրամաբանական աղյուսակը.
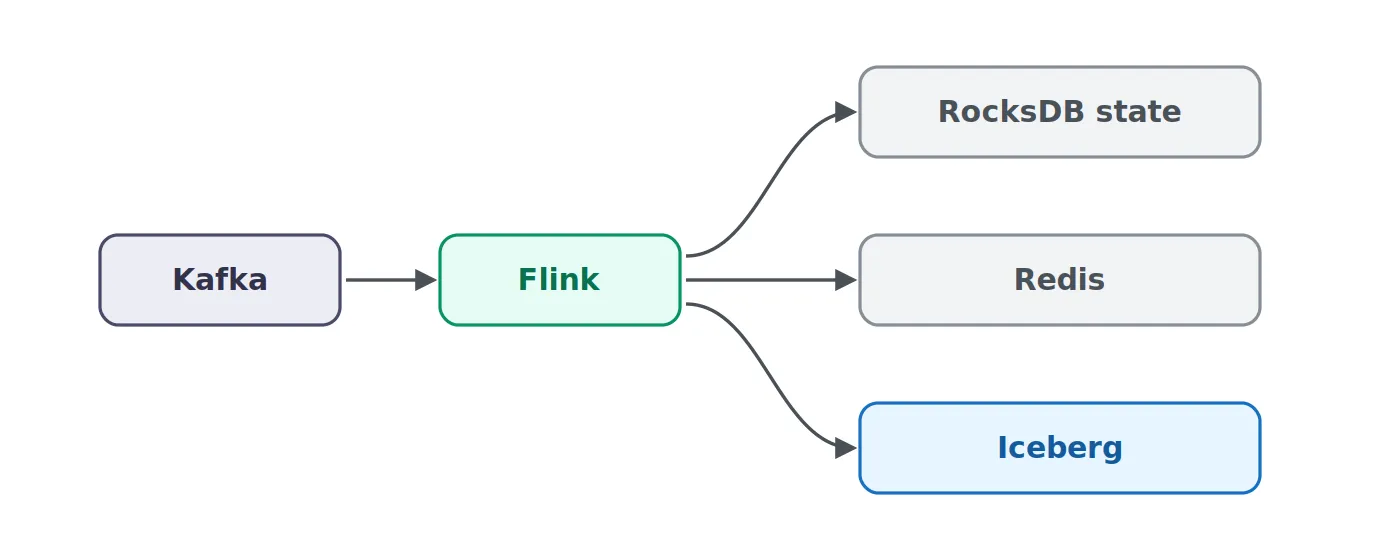
Kafka-ն պահում է changelog-ը, state store-ը մատուցում է ամենավերջին արժեքը, իսկ lakehouse-ը պահում է պատմական տվյալները անալիտիկ հարցումների համար։ Այս պարտականությունների բաժանումն ունի իր արժանիքները, բայց դա նաև նշանակում է, որ թարմացումների թվացյալ պարզ հոսքը պատճենվում է մի քանի stateful համակարգերում, որոնցից յուրաքանչյուրն ունի իր պատմությունը՝ համահունչության, հզորության և շահագործման առումով։
Fluss-ը թիրախավորում է հենց այս կրկնօրինակումը։
Fluss-ը սկսվում է աղյուսակից
Սկզբում՝ մի փոքր նախապատմություն նախագծի մասին, քանի որ այն երիտասարդ է։ Fluss-ը ծնվել է Alibaba-ում, 2025-ին միացել է Apache Incubator-ին և 2026-ի օգոստոսին դարձել է Apache Top-Level Project։ Գրելու պահին ամենանոր կայուն թողարկումը 0.9.1-ն է. նրա artifact-ը դեռ ունի Incubating պիտակը, քանի որ թողարկումը տեղի է ունեցել ավարտելուց առաջ։ Flink-ը դեռ ամենալիարժեք հաշվողական ինտեգրումն է, բայց Fluss-ը այժմ տրամադրում է նաև Java, Rust, Python և C++ կլիենտներ. ոչ-Java կլիենտները կառուցված են ընդհանուր Rust միջուկի վրա և իրենց առաջին 0.1.0 թողարկումն ունեցել են 2026-ին, ուստի հնարավորությունների ընդգրկումը լեզուների միջև դեռ տարբերվում է։ Էկոհամակարգը երիտասարդ է, և ընդունման ցանկացած որոշում պետք է դա հաշվի առնի։
Fluss-ը աշխատում է append-only հոսքերի հետ, բայց դա չէ, որ նրան տարբերում է Kafka-ից։ Ավելի հետաքրքիր աբստրակցիան Primary Key Table-ն է։ Fluss աղյուսակը կարելի է հայտարարել բանալիով.
CREATE TABLE customers (
    customer_id STRING,
    name STRING,
    status STRING,
    PRIMARY KEY (customer_id) NOT ENFORCED
);
Նայենք նորից նույն թարմացումների շարքին.
customer-123 -> Alice, active
customer-456 -> Bob, active
customer-123 -> Alice, blocked
Աղյուսակի ընթացիկ վիճակը հետևյալն է.
customer-123 -> Alice, blocked
customer-456 -> Bob, active
Միևնույն ժամանակ, ներքևի streaming consumer-ները դեռ կարող են տեսնել փոփոխությունները։ Սա է վճռորոշ տարբերությունը։ Kafka-ում լոգը հիմնական պահպանման աբստրակցիան է, և ընթացիկ վիճակը սովորաբար ածանցվում է դրանից։ Fluss-ի Primary Key Table-ում և՛ changelog-ը, և՛ ընթացիկ վիճակը պատկանում են պահպանման աբստրակցիային։
Ներսում Fluss-ը վիճակի խնդիրը չի վերացնում։ Primary Key Table-ները պահում են և՛ լոգի բաղադրիչ, և՛ key-value բաղադրիչ՝ ընթացիկ վիճակի համար օգտագործելով RocksDB.
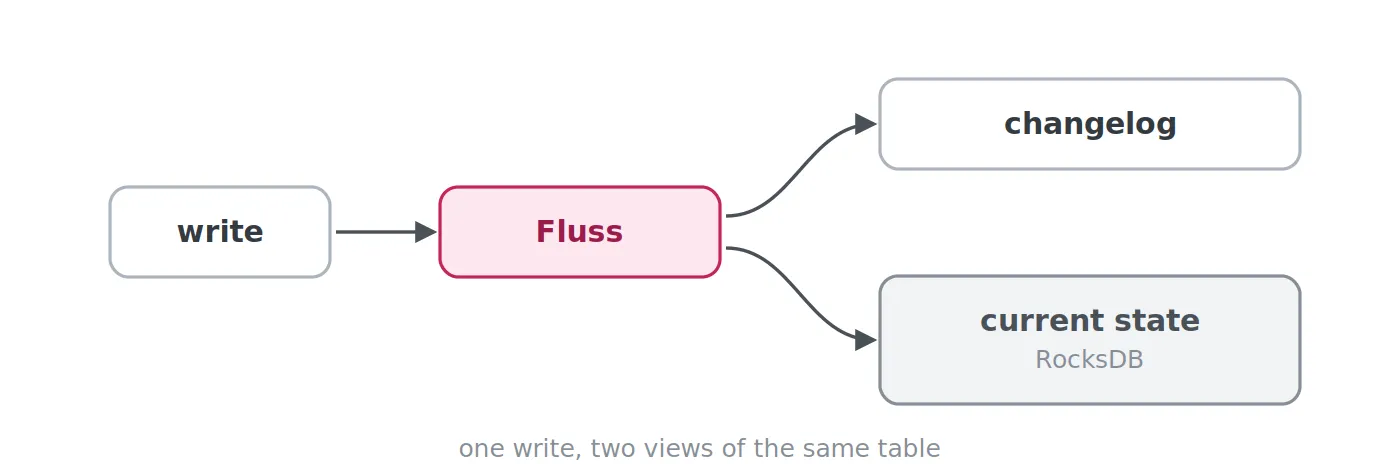
Այսպիսով, Fluss-ը չի ազատվում RocksDB-ից, այլ տեղափոխում է դրա սեփականությունը։ Այն փոխարեն, որ յուրաքանչյուր մշակող հավելված առանձին պահի նույն վիճակի իր սեփական պատճենը, պահպանման շերտը այն պահում է մեկ անգամ և հասանելի է դարձնում շատ consumer-ների։ CDC տվյալների հավաքածուների, lookup join-ների և լայնորեն վերաօգտագործվող տեղեկատու տվյալների համար սա կարող է վերացնել կրկնօրինակված վիճակի զարմանալիորեն մեծ քանակություն։
Compacted լոգը primary-key աղյուսակ չէ
Kafka-ի compaction-ը և primary-key աղյուսակը կարող են նման թվալ, քանի որ երկուսն էլ մշակում են նույն բանալիին կապված բազմաթիվ արժեքներ, սակայն դրանք պատասխանում են տարբեր հարցերի։ Kafka-ի compaction-ը հիմնականում պատասխանում է.
Հնարավո՞ր է պահել վերարտադրելի լոգ՝ առանց յուրաքանչյուր բանալու յուրաքանչյուր պատմական արժեքը հավերժ պահելու։
Primary-key աղյուսակը պատասխանում է.
Ի՞նչ արժեք ունի այս բանալին այս պահին։
Այս պահանջները կապված են, բայց հանգեցնում են տարբեր պահպանման նախագծերի։ Kafka-ն մնում է օպտիմալացված կարգավորված սպառման համար. primary-key աղյուսակին լրացուցիչ պետք է վիճակին արդյունավետ հասանելիություն։
Kafka Streams-ը այս տարբերությունը լավ պատկերում է։ Streams հավելվածը կարող է կարդալ compacted topic և պահել տեղային RocksDB store. Kafka-ն ապահովում է դիմացկուն changelog-ը, իսկ RocksDB-ն՝ materialize արված վիճակին արդյունավետ հասանելիությունը։ Fluss-ը այդ materialization-ը քաշում է հենց պահպանման համակարգի մեջ։
Արդյոք սա օգնում է, կախված է բեռնվածությունից։ Մեկ հավելվածի մշակման հատուկ վիճակի համար տեղային վիճակը կարող է լինել հենց այն, ինչ պետք է. Kafka Streams հավելվածը կարող է պահել վիճակ, որը գոյություն ունի բացառապես իր մշակման տրամաբանության պատճառով, և այն ընդհանուր տվյալների բազա տեղափոխելն ընդհանրապես իմաստ չէր ունենա։ Բայց պատկերացրեք հաճախորդների կամ ապրանքների մեծ տվյալների հավաքածու, որը կարդում են տասը տարբեր Flink job-եր։ Եթե յուրաքանչյուր job-ին lookup join-ների համար պետք է նույն վերջին վիճակը, դրա տասը պատճեն վերակառուցելն ու պահպանելը շատ ավելի քիչ ակնհայտ լավ գաղափար է, և ընդհանուր streaming աղյուսակը սկսում է գրավիչ թվալ։
Տաք շերտը նույնպես կարող է սյունակային լինել
Կա ևս մեկ տարբերություն, որը հեշտ է չնկատել. նախագծով Kafka-ն չի հասկանում հաղորդագրության արժեքի կառուցվածքը։ Ասենք՝ իրադարձությունն ունի հիսուն սյունակ.
customer_id
name
email
address
country
currency
segment
device
browser
...
Flink job-ին կարող է պետք լինել միայն customer_id-ն և country-ն։ Kafka-ի դեպքում consumer-ը դեռ քաշում է ամբողջ սերիալիզացված արժեքը կրող գրառումները, և սյունակները ընտրվում են միայն այն բանից հետո, երբ գրառումը հասել է consumer-ին և դեսերիալիզացվել։
Fluss-ը այլ կերպ է աշխատում։ Նրա լոգի ներկայացումը կարող է հենվել Apache Arrow-ի վրա, ուստի պահպանման շերտը տեղյակ է սյունակների մասին։ Հետևյալի նման հարցումը.
SELECT customer_id, country
FROM customers;
կարող է իր projection-ը ներքև հրել պահպանման շերտ, այնպես որ ցանցով ուղարկվեն միայն անհրաժեշտ սյունակները։ Սյունակների կրճատման մասին մենք սովորաբար մտածում ենք data lake-ի Parquet ֆայլերի համատեքստում, այլ ոչ թե թարմ ստրիմինգային տվյալներ սպասարկող համակարգում. այստեղ տաք ստրիմինգային ուղին որոշ չափով սկսում է նմանվել անալիտիկ պահպանման շարժիչի։ Եվ սյունակային դասավորությունը հատուցում է ոչ միայն տվյալների փոխանցման մեջ. մեկ սյունակի արժեքները հիշողության մեջ պահվում են իրար կողքի, ինչը հենց այն դասավորությունն է, որի վրա բարգավաճում է ագրեգացիան. թվային սյունակի գումարումը Arrow batch-երի վրա շատ տարբեր գործողություն է, քան առանձին դեսերիալիզացված գրառումներից մեկ դաշտ քաղելը։ Կրկին՝ սա բխում է հիմքի աբստրակցիայից։
Kafka-ն տեսնում է գրառումներ։ Fluss-ը տեսնում է տողեր։
Պատմության համար lakehouse-ը դեռ հաղթում է
Տաք շերտը հարցումներ անելու հնարավորությունը չի նշանակում, որ այն պետք է պահի տարիների տվյալներ։ Օբյեկտային պահոցը դեռ շատ ավելի էժան է, և անալիտիկ համակարգերը գերազանցում են այնտեղ պահվող մեծ սյունակային տվյալների հավաքածուները սկանավորելու մեջ։ Այդ իսկ պատճառով Fluss-ը աջակցում է ավելի հին տվյալների tiering-ը lakehouse աղյուսակների, ինչպես Paimon-ը կամ Iceberg-ը.
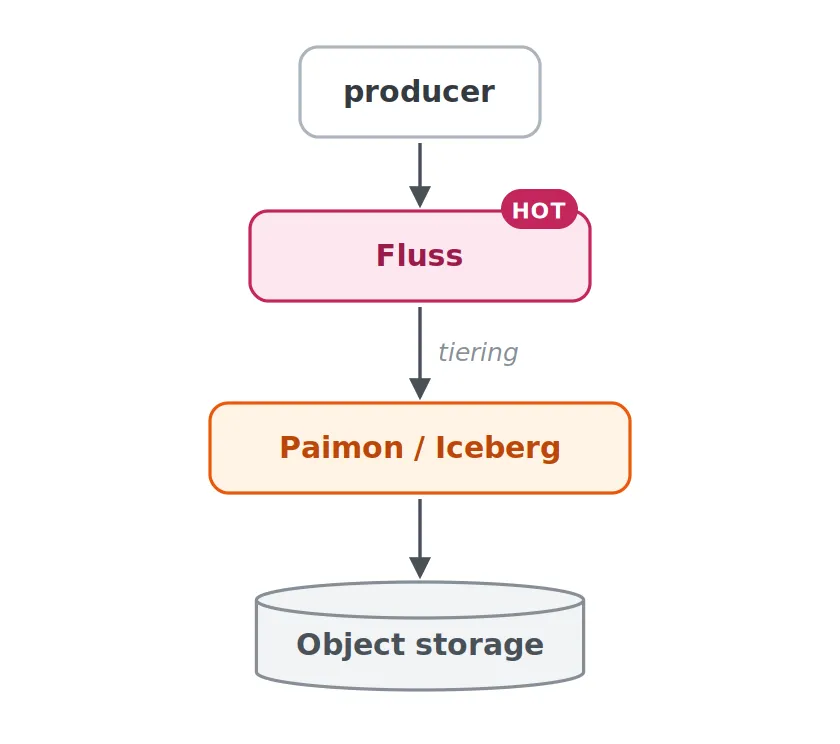
Նույն տրամաբանական աղյուսակն այժմ ձգվում է պահպանման երկու աստիճանների վրա. Fluss-ը սպասարկում է տաք մասը, իսկ lakehouse-ը պահում է պատմությունը։ Բարդ մասը այդ սահմանի վրայով հարցումներ կատարելն է։
Ասենք՝ lakehouse-ը պահում է ամեն ինչ մինչև 12:00:00-ը commit արվածը, մինչդեռ երեսուն վայրկյանի ավելի նոր տվյալներ դեռ միայն Fluss-ում են։ 12:00:30-ին միայն lake-ի դեմ հարցումը վերադարձնում է հնացած արդյունք։ Լուծումը ոչ էլ այն է, որ յուրաքանչյուր իրադարձություն ակնթարթորեն տեսանելի դառնա Iceberg-ում կամ Paimon-ում. lakehouse ձևաչափերը աշխատում են ֆայլերի և snapshot-ների հետ, և շատ հաճախակի commit-ները ստեղծում են հենց այն մանր ֆայլերի և մետատվյալների խնդիրները, որոնք այս համակարգերը գոյություն ունեն զսպելու համար։ Շատ թարմացումներով հոսքերի համար փոխզիջումը դառնում է նույնիսկ ավելի սուր. copy-on-write-ի դեպքում յուրաքանչյուր commit վերագրում է տվյալների ֆայլերը, ուստի գրառումները կրում են ծախսը. merge-on-read-ի դեպքում գրառումները մնում են էժան, բայց ընթերցողները ստիպված են միավորել ջնջման ֆայլերի աճող կույտը, մինչև compaction-ը հասնի, ուստի արագ ընթերցումները պահանջում են աղյուսակի հաճախակի compaction։ Commit-ների հաճախականությունը բավականաչափ բարձրացրեք, և մի կողմը կամ մյուսը ստիպված կլինի զիջել։
Fluss-ը սա լուծում է՝ համադրելով կայուն պատմական snapshot-ը տաք պոչի հետ.
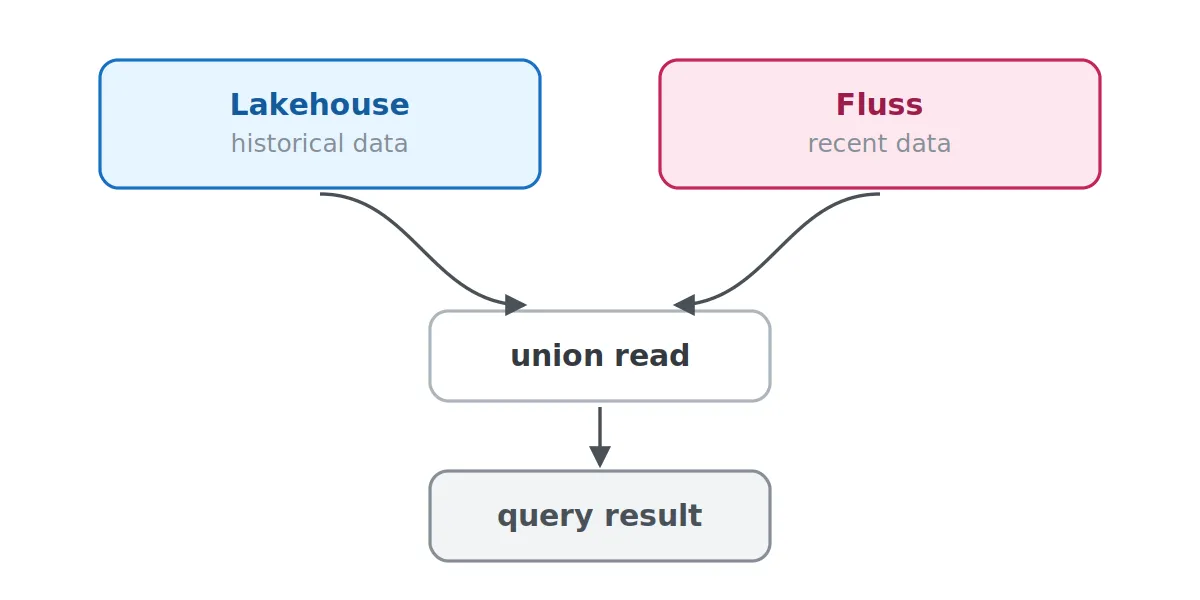
Ամբողջական տրամաբանական աղյուսակը ֆիզիկապես պետք չէ պահվի մեկ տեղում։ Ավելի հին տվյալները կարող են էժան նստել օբյեկտային պահոցում, մինչդեռ թարմ տվյալները մնում են ցածր latency-ով ստրիմինգային պահոցում։ Մտածեք, թե սա ինչպես է ազդում վերը նկարագրված Iceberg-ի փոխզիջման վրա. union read-ը copy-on-write-ը կամ merge-on-read-ը էժան չի դարձնում, բայց վերացնում է դրանք ստրիմինգային հաճախականությամբ աշխատեցնելու անհրաժեշտությունը. lakehouse-ը կարող է commit և compact անել այն տեմպով, որը աղյուսակը պահում է լավ վիճակում, քանի որ թարմությունը գալիս է Fluss-ից, այլ ոչ թե քամվում է Iceberg-ից։
Fluss-ը միակ համակարգը չէ այս տաք/սառը բաժանմամբ։ Confluent Cloud-ը այժմ տրամադրում է նման ուղի՝ կառուցված Kafka-ի վրա։
Ինչն է տարբեր Confluent Cloud-ում. Tableflow
Confluent Tableflow-ը այն եղանակն է, որով Confluent-ը լուծում է Kafka-ից lakehouse խողովակաշարը։ Հիմնական վերապահումը. Tableflow-ը Confluent Cloud ծառայություն է։ Այն Apache Kafka-ի մաս չէ և հասանելի չէ նաև ինքնակառավարվող Confluent Platform-ում։ Ուստի այս բաժնի ամեն ինչ նկարագրում է կառավարվող Confluent Cloud ճարտարապետություն, այլ ոչ թե Kafka-ի ներսում նոր պահպանման պրիմիտիվ։
Այս սահմաններում Tableflow-ը կարող է անընդհատ materialize անել Kafka topic-ը Iceberg կամ Delta Lake աղյուսակի մեջ.
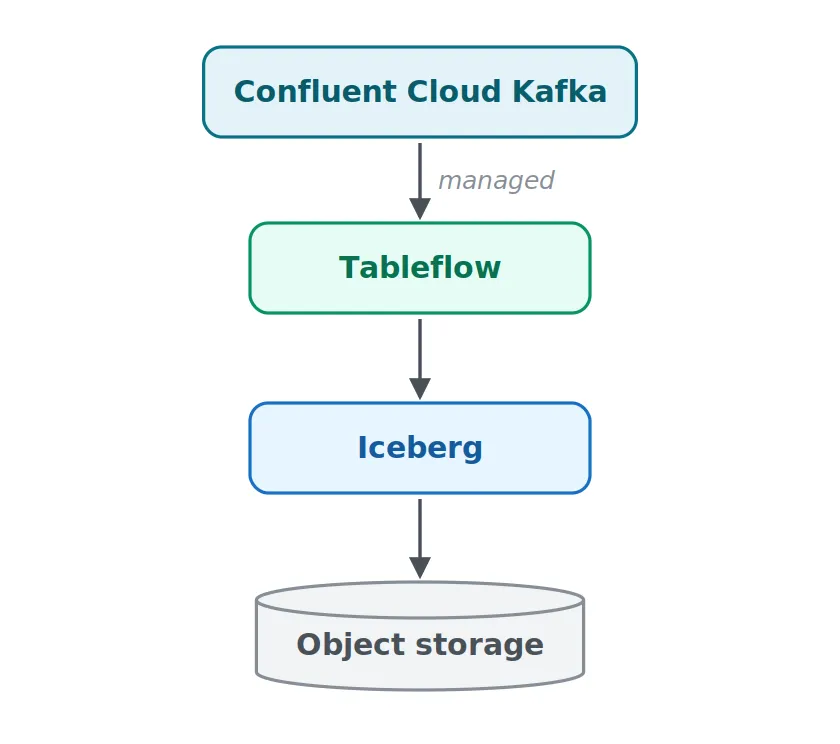
Խողովակաշարը, որին նախկինում պետք էին Connect, Flink կամ սեփական հավելվածի կոդ, դառնում է հարթակի մաս։ Append-only topic-ների համար համապատասխանեցումը բավականին պարզ է. գրառումները դառնում են տողեր և գրվում են աղյուսակում։ Ավելի հետաքրքիրն այն է, որ Tableflow-ը առաջարկում է նաև upsert տիպի materialization compacted topic-ների համար, այնպես որ փոփոխությունների հոսքը կարող է վերածվել ընթացիկ վիճակն արտացոլող աղյուսակի։
Ստացված տաք/սառը բաժանումը զարմանալիորեն նման է Fluss-ի tiering դիագրամին։ Kafka-ն պահում է թարմ իրադարձությունները, Iceberg-ը՝ materialize արված պատմական աղյուսակը, և Confluent-ի Flink ինտեգրումը կարող է միավորել Tableflow snapshot-ը այն գրառումների հետ, որոնք դեռ չեն հասել materialize արված աղյուսակ.
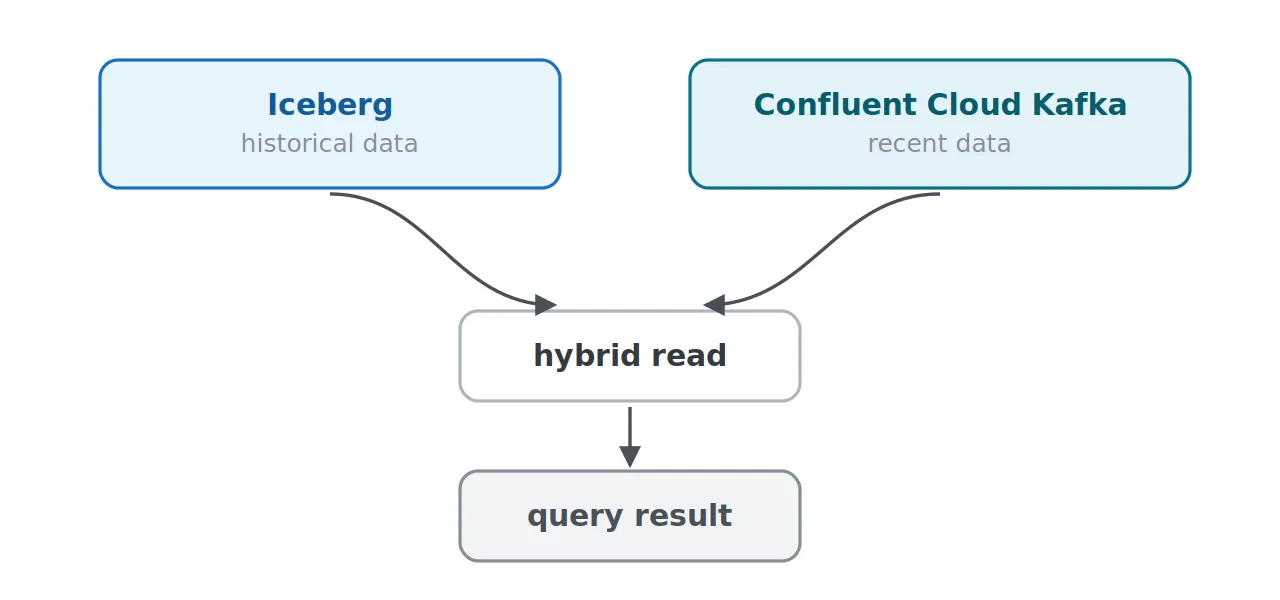
Սեմանտիկան և իրականացումը նույնը չեն, ինչ Fluss-ի union read-երը, բայց հիմքի հնարքը նույնական է. մի ստիպեք lakehouse-ին ապահովել միլիվայրկյանային թարմություն։ Կարդացեք կայուն մասը lake-ից, իսկ պոչը՝ ստրիմինգային համակարգից։ Թեև երկու ստեկերը սկսվում են տարբեր աբստրակցիաներից, նրանք հանգում են նմանատիպ տաք/սառը դասավորության։
Tableflow-ը զգալիորեն նեղացնում է բացը Kafka-ն ընդդեմ Fluss համեմատության մեջ։ Ինքնակառավարվող Apache Kafka-ի դեպքում topic-ը պահպանվող lakehouse աղյուսակի վերածելը սովորաբար նշանակում է աշխատեցնել ևս մեկ խողովակաշար։ Confluent Cloud-ում Tableflow-ը այդ սանտեխնիկայի մեծ մասը վերացնում է։ Մնում է տարբերությունը տաք շերտում։ Եթե հավելվածներին լրացուցիչ պետք է ընթացիկ վիճակին ցածր latency-ով հասանելիություն, ճարտարապետությունը դեռ պահանջում է ևս մեկ ճյուղ, մինչդեռ Fluss-ի դեպքում այդ վիճակը կարող է ապրել պահպանման շերտում.
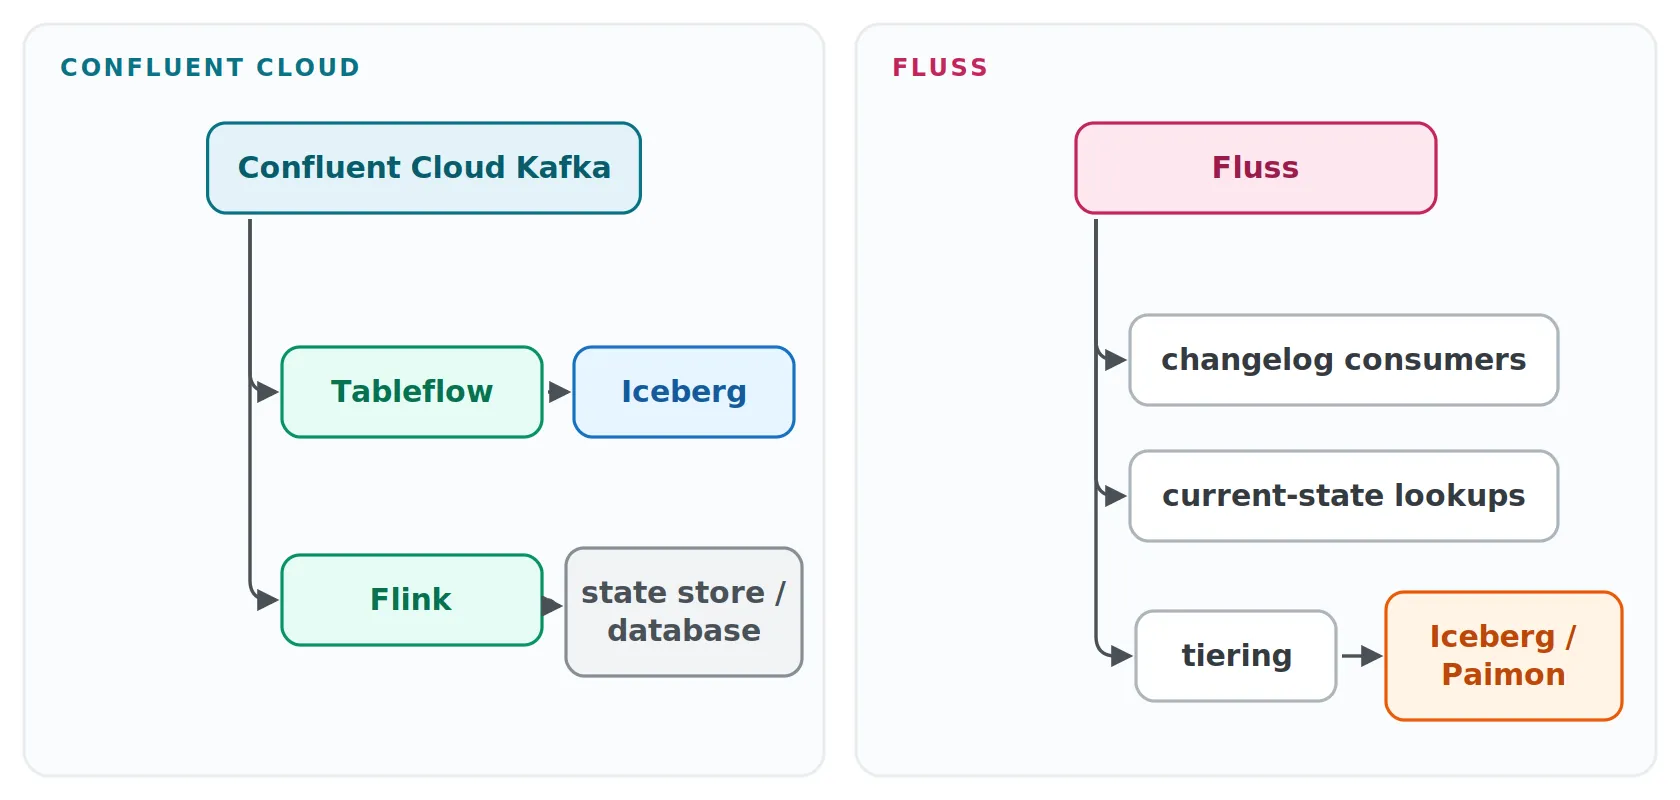
Սա մեզ թողնում է ավելի արժեքավոր հարցի առջև, քան «կարո՞ղ է Fluss-ը ստրիմինգային տվյալները Iceberg հասցնել ավելի արդյունավետ, քան Kafka-ն». արդյոք մեզ դեռ պետք է ընթացիկ վիճակի առանձին materialization, եթե ստրիմինգային պահոցը կարող է այն ուղղակիորեն բացահայտել։
Kafka-ի սեմանտիկան դեռ ներթափանցում է աղյուսակ
Tableflow-ի upsert ռեժիմը նաև բացահայտում է, թե ինչ է տեղի ունենում, երբ աղյուսակը ածանցվում է լոգից։ Kafka-ն երաշխավորում է կարգը և compaction-ը յուրաքանչյուր partition-ի համար, ուստի բաժանման մոդելը անխուսափելիորեն դառնում է ստացված աղյուսակի սեմանտիկայի մաս։
Ասենք՝ բանալին սկզբում համապատասխանեցվում է մեկ partition-ի.
partition 3:
customer-123 -> active
Ավելի ուշ, երբ topic-ի partition-ների քանակը փոխվել է, նույն բանալին կարող է հայտնվել այլ տեղ.
partition 8:
customer-123 -> blocked
Բիզնեսի տերմիններով սա դեռ մեկ հաճախորդ է։ Kafka-ն տեսնում է երկու առանձին partition պատմություն։ Repartitioning-ը այն եզրային դեպքերից է, երբ հիմքի աբստրակցիան հանկարծ երևում է. լոգից ածանցված աղյուսակը այնքան էլ նույնը չէ, ինչ պահպանման համակարգը, որի տվյալների մոդելը աղյուսակ է։
Որտե՞ղ է Paimon-ը
Paimon-ը մի փոքր անհարմար է տեղավորվում «Kafka ընդդեմ Fluss ընդդեմ Paimon» վերնագրի մեջ, քանի որ այն անդրադառնում է խնդրի այլ շերտի։ Fluss-ը կարող է օգտագործել Paimon-ը իր lakehouse պահոցի համար, բայց Iceberg-ը նույնպես աշխատում է։ Այսպիսով, իրականում կան երկու անկախ ընտրություն. տաք շերտը (Kafka, թե՞ Fluss) և lakehouse ներկայացումը (Iceberg, թե՞ Paimon)։
Paimon-ը սկսվել է Flink համայնքի ներսում որպես Flink Table Store, նախքան դառնալը top-level Apache նախագիծ, և այս ժառանգությունը երևում է նրա նախագծում։ Ներսում Paimon աղյուսակի յուրաքանչյուր bucket կառուցված է որպես LSM ծառ. կառուցվածք, որը նախագծված է շարունակական գրառումներ և թարմացումներ կլանելու, այլ ոչ թե պատահական batch ավելացումների համար։ Նրա primary key աղյուսակները առաջարկում են կարգավորվող merge engine-ներ, որոնք որոշում են՝ ինչ է տեղի ունենում, երբ մեկ բանալու համար մի քանի գրառում է գալիս. deduplicate-ը պահում է ամենանոր տողը, partial-update-ը թույլ է տալիս առանձին գրողներին լրացնել մեկ տողի տարբեր սյունակները, իսկ aggregation-ը մուտքային արժեքները համակցում է ագրեգատների։ Paimon-ը կարող է նաև արձակել պատշաճ changelog ստորին հոսքի ընթերցողների համար՝ մի քանի changelog-producer ռեժիմներով, որոնք հավասարակշռում են գրառման ծախսը և changelog-ի ամբողջականությունը։
Paimon-ը նախագծված է այն ենթադրությամբ, որ «աղյուսակի փոփոխությունների հոսքը» սովորական բեռնվածություն է, այլ ոչ եզրային դեպք։ Սա այն դարձնում է բնական համապատասխանություն CDC-ով հարուստ խողովակաշարերի համար և օգնում է բացատրել, թե ինչու է այն այդքան լավ աշխատում Fluss-ի հետ, որը ծագել է նույն Flink էկոհամակարգից։
Iceberg-ը գալիս է որոշ չափով այլ անկյունից և բերում է իր սեփական մեծ առավելությունը՝ էկոհամակարգի ընդունումը։ Անալիտիկ շարժիչներն ու ամպային տվյալների հարթակները լայնորեն աջակցում են այն, ինչը այն դարձնում է բնական փոխհամագործակցության շերտ։ Արդյունքում Fluss + Iceberg-ը նույնպես կարող է լիովին խելամիտ ճարտարապետություն լինել։ Fluss-ին սահմանողը Paimon-ի օգտագործումը չէ. դա տաք շերտի streaming աղյուսակն է։
Kafka Tiered Storage-ը լուծում է այլ խնդիր
Kafka-ն ինքն էլ աջակցում է Tiered Storage-ին, ինչը կարող է շփոթեցնել տերմինաբանությունը։ Եթե Kafka-ն կարող է հին լոգի սեգմենտները տեղափոխել օբյեկտային պահոց, ինչու՞ նեղություն կրել տվյալները Iceberg-ի կամ Paimon-ի վերածելու համար։ Որովհետև վերջնական արդյունքը տարբեր է։
Հեռավոր ֆայլերը մնում են Kafka-ի լոգի մաս։ Kafka-ի consumer-ները կարող են կարդալ դրանք Kafka-ի սեմանտիկայով, բայց դրանք չեն վերածվում աղյուսակի, որը Spark-ը, Trino-ն կամ այլ շարժիչ կարող է ինքնուրույն հարցել՝ ինչպես Iceberg-ը։ Tableflow-ը և Fluss-ի lakehouse tiering-ը այլ բան են անում.
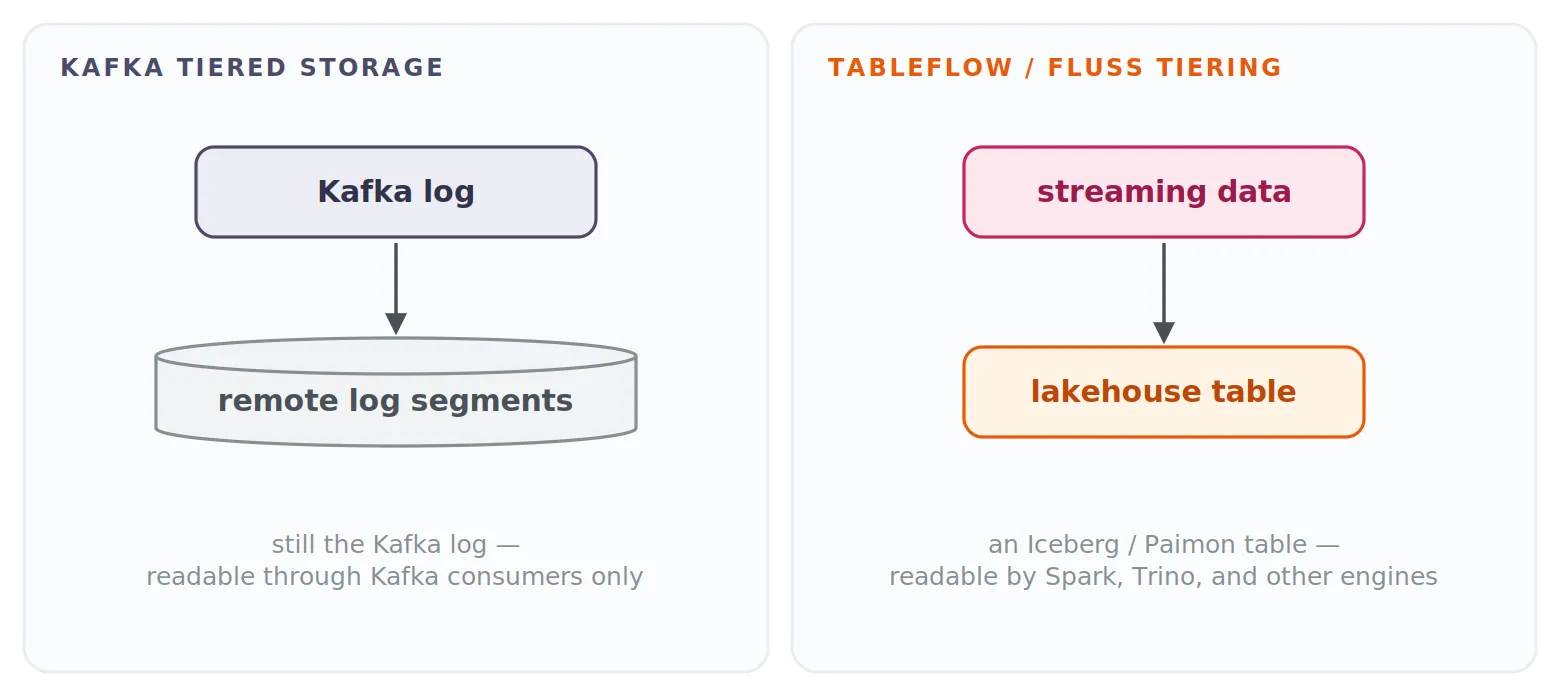
Երկուսն էլ հենվում են օբյեկտային պահոցի վրա։ Միայն մեկն է փոխում, թե ինչպես են ներկայացվում տվյալները։
Fluss-ը Kafka-ի փոխարինո՞ղ է
Ոչ բառի սովորական իմաստով։ Kafka-ն շատ ավելին է, քան պահպանման շարժիչ։ Production Kafka տեղակայումը գալիս է կլիենտ գրադարաններով, Kafka Connect connector-ներով, Schema Registry ինտեգրումներով, Kafka Streams հավելվածներով, մոնիթորինգով, շահագործման գործիքակազմով, կառավարվող ծառայություններով և տարիների ընթացքում կուտակված ճարտարագիտական գիտելիքով։ Շատ ճարտարապետություններ նաև Kafka-ին հենվում են որպես կազմակերպության մասշտաբով ինտեգրման ողնաշարի վրա, և այդպիսի բեռնվածության համար Kafka-ի փոխարինումը վերաբերում է ոչ թե այն բանին, թե արդյոք այլ համակարգը կարող է գրառումներ ավելացնել և կրկնօրինակել, այլ շրջակա էկոհամակարգը գոնե նույնքան կարևոր է։
Fluss-ը նաև Kafka-ի հետ համատեղելի broker չէ, որը կարելի է դնել գոյություն ունեցող producer-ների և consumer-ների տակ։ Kafka արձանագրության համատեղելիությունը քննարկվել է Fluss համայնքում և հանվել է նախագծի ճանապարհային քարտեզից. փաստարկներից մեկն այն էր, որ Kafka արձանագրությունը կբացահայտեր միայն այն ամենի մի մասը, ինչի ընդունակ են Fluss աղյուսակները։ Այս որոշումը շատ բան է բացահայտում այն մասին, թե ուր է գնում նախագիծը։ Fluss-ը չի նպատակադրվում լինել ավելի արագ Kafka՝ տարբեր պահպանման շարժիչով։
Այդուհանդերձ, ուղղակի փոխարինումը գուցե նույնիսկ չէ այն միգրացիան, որի մասին արժե մտածել։ Դիտարկեք համակարգ, որը աստիճանաբար վերածվել է.
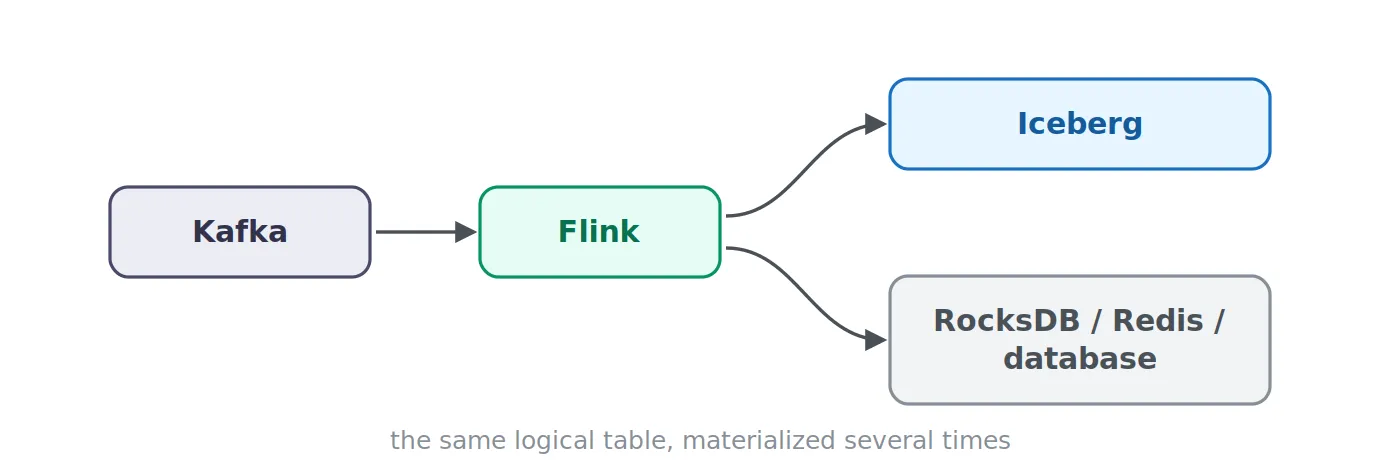
Այդ դիագրամի յուրաքանչյուր բաղադրիչ կարող է լիովին հիմնավորված լինել։ RocksDB state-ը կարող է հատուկ լինել հավելվածին. Redis-ը կարող է սպասարկել այլ latency-ի կամ հասանելիության թիրախ. Iceberg-ը այնտեղ է անալիտիկայի համար։ Սակայն երբեմն պատճենները գոյություն ունեն ավելի հիմնարար պատճառով. ստրիմինգային համակարգը բացահայտում է լոգ, մինչդեռ consumer-ներին պետք է աղյուսակ։ Սա այն սցենարն է, որի համար ստեղծված է Fluss-ը։
Սկսել լոգո՞վ, թե՞ աղյուսակով
Kafka-ն բաշխված լոգը դարձրեց ժամանակակից ստրիմինգային համակարգերի ստանդարտ հիմք, և այդ մոդելը բացառիկ լավն է անփոփոխ փաստերը անկախ consumer-ների միջև տեղափոխելու համար։ Միևնույն ժամանակ ստրիմինգային բեռնվածությունների աճող մասը իրականում աղյուսակների փոփոխությունների հոսքեր են։ CDC-ն դասական օրինակն է. INSERT customer, UPDATE customer, DELETE customer իրադարձությունները արժեքավոր են որպես լոգ, բայց այն, ինչ շատ consumer-ներ ի վերջո իրականում ուզում են, customers աղյուսակն է. ընթացիկ վիճակը՝ անմիջապես հասանելի, և ավելի հին տարբերակները՝ հասանելի, երբ պետք է։
Lakehouse էկոհամակարգը պատմական պահոցը արդեն մղել է այդ ուղղությամբ։ Iceberg-ը և Paimon-ը օբյեկտային պահոցը վերածում են աղյուսակների. Confluent Cloud-ում Tableflow-ը կարող է այդպիսի աղյուսակը ածանցել անմիջապես Kafka-ից։ Fluss-ը նույն հարցը տալիս է մեկ շերտ ավելի վաղ. ինչու՞ տաք պահոցը դեռ պետք է բացահայտի միայն լոգ։
Սա մեզ տալիս է երկու առանձին մեկնարկային կետ՝ log-first ճարտարապետություն և table-first ստրիմինգային ճարտարապետություն.
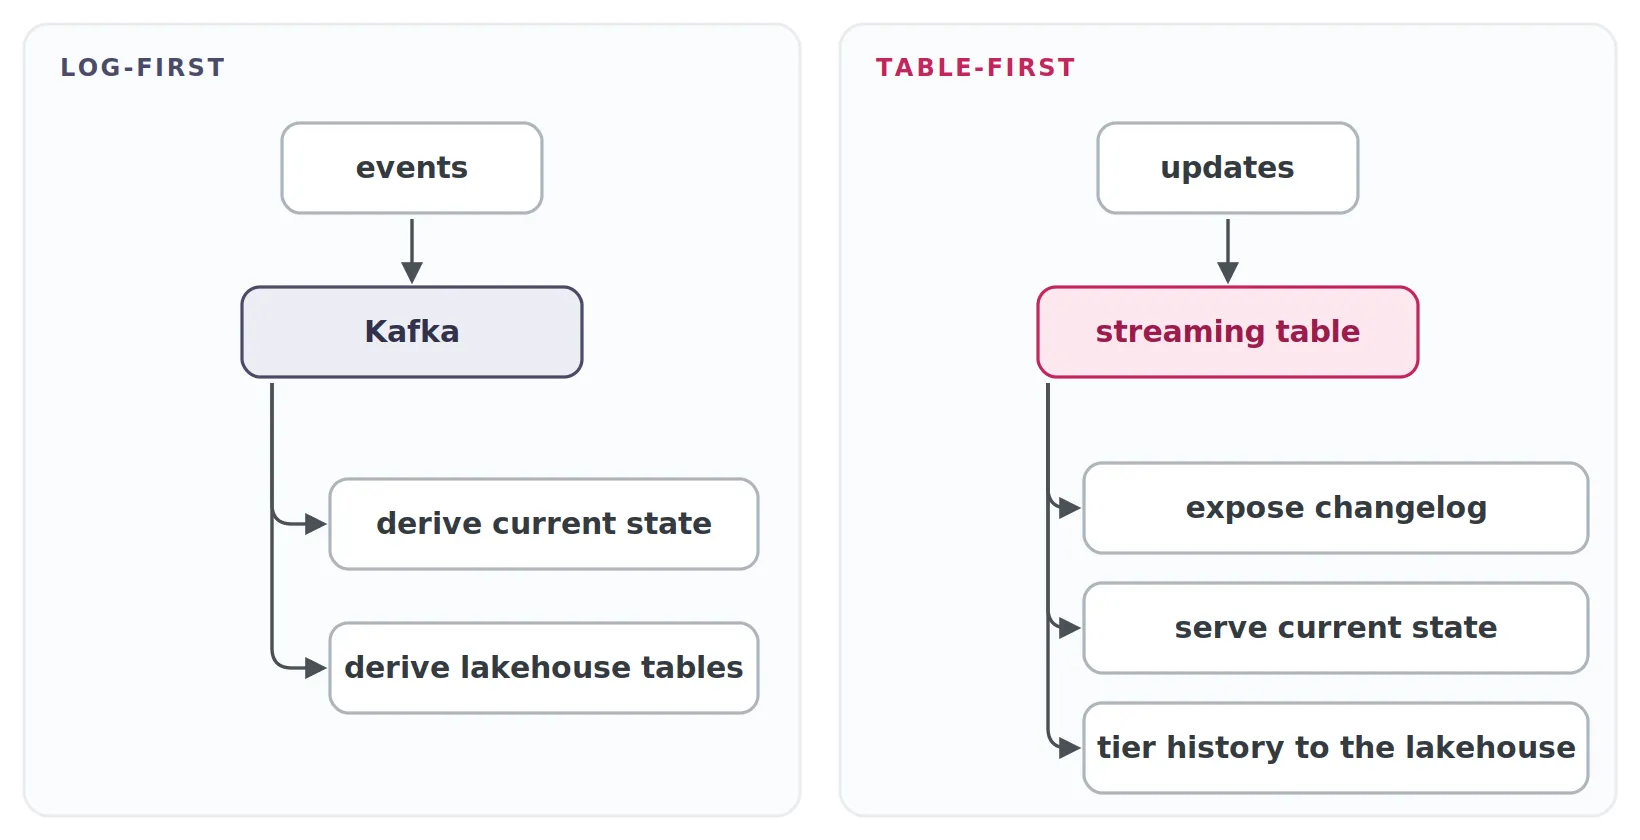
Ես չեմ սպասում, որ streaming աղյուսակները Kafka-ն հնացած կդարձնեն։ Ավելի հավանական արդյունքն այն է, որ դրանք կնեղացնեն այն բեռնվածությունների շրջանակը, որոնց համար լոգը պետք է ծառայի որպես հիմնական պահպանման աբստրակցիա։ Եվ դա հետաքրքիր հարցը դարձնում է շատ ավելի քիչ դրամատիկ, քան «Fluss-ը կփոխարինի՞ Kafka-ին», և շատ ավելի օգտակար.
Եթե մեր ստրիմինգ արած տվյալները, ի վերջո, աղյուսակ են, պե՞տք է սկսենք լոգից և հետո վերակառուցենք աղյուսակը, թե՞ պահենք streaming աղյուսակը սկզբից։