نبدأ بسجل أم بجدول؟ Apache Kafka وFluss والجداول المتدفقة
مقارنة على مستوى المعمارية بين أنظمة البث التي تبدأ بالسجل (Apache Kafka) وتجريدات التخزين التي تبدأ بالجدول (Apache Fluss)، مع النظر في أحمال CDC والحالة المكررة والتكامل مع lakehouse.
عند بناء معمارية بث، يكون Apache Kafka نقطة البداية البديهية. تنشر التطبيقات الأحداث إلى Kafka، وتقرؤها تطبيقات أخرى، أما البيانات التي يجب الاحتفاظ بها لمدة أطول فينتهي بها المطاف عاجلًا أم آجلًا في تخزين الكائنات (object storage). وهناك إعداد شائع جدًا يعتمد على Kafka Connect مع موصّل S3 sink – مثل Amazon S3 Sink Connector من Confluent – لنقل البيانات الأقدم إلى Amazon S3:
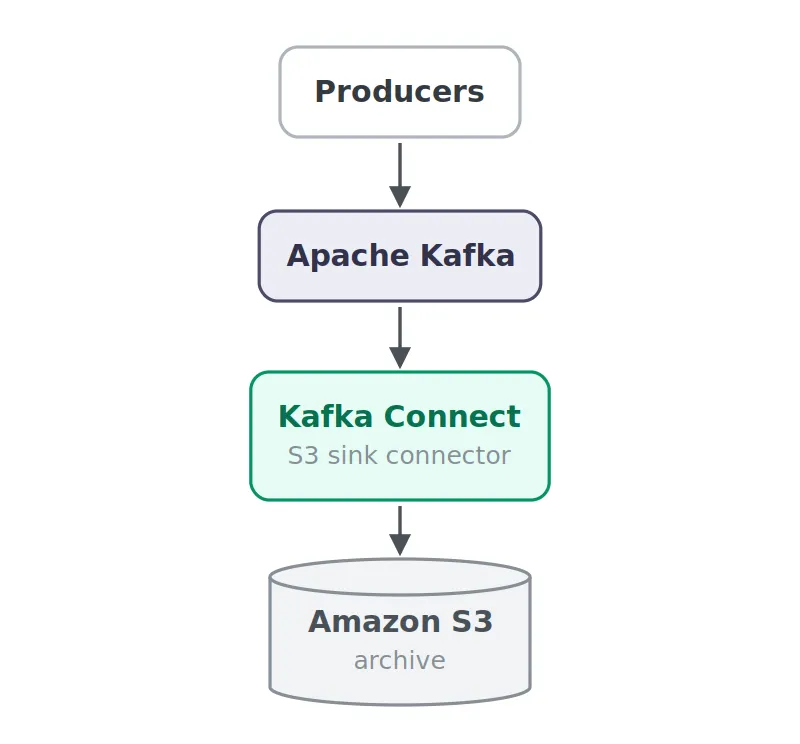
يتولى Kafka المسار الآني، ويوفّر S3 تخزينًا رخيصًا ومتينًا للبيانات التاريخية، وللأغراض الأرشيفية يكون ذلك كافيًا في الغالب. تبدأ المشكلة عندما يُفترض بالبيانات في S3 أن تعمل بصورة أقل كأرشيف وأكثر كجدول في قاعدة بيانات.
تخيّل موضوع Kafka يحتوي تحديثات العملاء:
customer-123 -> { name: "Alice", status: "active" }
customer-456 -> { name: "Bob",   status: "active" }
customer-123 -> { name: "Alice", status: "blocked" }
تفريغ هذه السجلات في Parquet أمر بسيط. أما مجموعة مختلفة من الأسئلة فالإجابة عنها أصعب بكثير:
- كيف يبدو كل عميل الآن؟
- كيف نمثّل التحديثات وعمليات الحذف؟
- أي الملفات تشكّل نسخة متسقة من مجموعة البيانات؟
- ماذا يحدث عندما يتطور المخطط (schema)؟
- كيف نتجنب توليد آلاف الملفات الصغيرة؟
- كيف يمكن لعدة محركات استعلام أن تقرأ مجموعة البيانات نفسها بأمان أثناء تحديثها؟
يقدّم لنا S3 ملفات. أما الجدول فليس شيئًا يوفره.
من الملفات إلى الجداول
تسدّ هذه الفجوة صيغ الجداول المفتوحة مثل Apache Iceberg وApache Paimon. فهي تغلّف الملفات ببيانات وصفية: المخطط واللقطات (snapshots) والأقسام وملفات البيانات والتغييرات من نسخة إلى التالية. وتبدو المعمارية عندئذ أقرب إلى ما يلي:
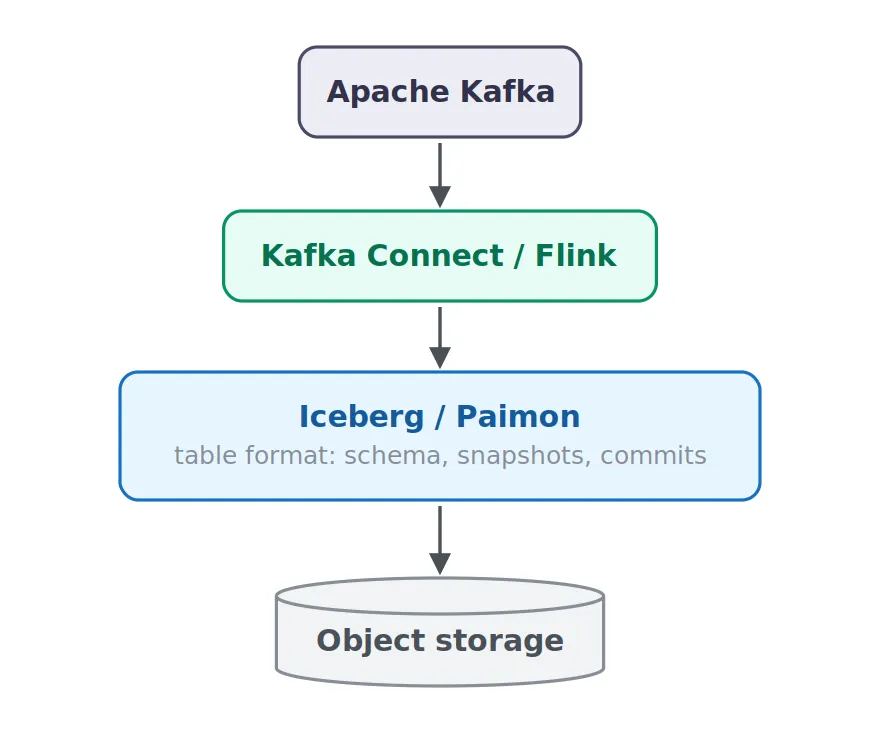
ما يتغير يتجاوز طريقة تخطيط الملفات. فنحن لم نعد نكتب ملفات فحسب – بل نصون جدولًا. يمكن تشغيل الاستعلامات على لقطة متسقة، ويمكن تتبع تغييرات المخطط، ويمكن ضغط ملفات البيانات أو استبدالها دون أن يرى القرّاء حالة محدّثة جزئيًا.
ومع ذلك، لا بد من أن يحوّل أحدٌ تدفق Kafka إلى ذلك الجدول. وعمليًا يعني ذلك تشغيل جزء آخر من البنية التحتية: Kafka Connect أو Apache Flink أو Spark Structured Streaming أو AWS Glue أو خدمة إدخال مخصصة. وهذه الخدمة عليها أعباء أكثر بكثير من مجرد نقل البايتات من Kafka إلى S3. فقد يتعين عليها فهم المخططات، وتحويل سجلات CDC إلى عمليات إدراج وتحديث وحذف، وإنتاج عمليات تثبيت (commits) للجدول، والتحكم في أحجام الملفات، وضغط الملفات الصغيرة، وتسجيل البيانات الوصفية في كتالوج.
هناك نهجان جديران بالذكر لتبسيط هذا المسار. فخدمة Tableflow من Confluent تحوّل تجسيد Kafka إلى lakehouse إلى ميزة مُدارة في Confluent Cloud؛ وسنعود إليها لاحقًا. أما Apache Fluss فيسلك طريقًا مختلفًا ويتساءل عمّا إذا كان ينبغي أن تكون طبقة البث سجلًا من الأساس. وقبل أن نصل إلى Fluss، من المفيد توضيح ما يقدمه Kafka بالضبط.
Kafka يبقى سجلًا
قسم Kafka هو سجل مرتّب. لكل سجلّ (record) إزاحة (offset)، وتُلحِق المنتِجات (producers) السجلات، ويتقدم المستهلكون عبر السجل ويمكنهم الرجوع للخلف لإعادة تشغيل بيانات أقدم.
هذا النموذج بسيط عن قصد. فلا يحتاج Kafka إلى معرفة ما إذا كان السجل يمثل عميلًا أو فاتورة أو صفًا في قاعدة بيانات أو طلب HTTP – فبالنسبة للوسيط تكون قيمة السجل في معظمها سلسلة بايتات معتمة. وهذه إحدى نقاط قوة Kafka وسبب نجاحه الكبير عمودًا فقريًا عامًا للأحداث. لكن هذا يعني أيضًا أن تجريد التخزين في Kafka هو في جوهره سجل.
لنأخذ موضوعًا مضغوطًا (compacted topic):
offset 100: customer-123 -> active
offset 101: customer-456 -> active
offset 102: customer-123 -> blocked
في مرحلة ما، قد يُسقِط ضغط السجل القيمة الأقدم للمفتاح customer-123 ويُبقي الأحدث. وهذا يجعل الموضوع المضغوط يشبه مخزن مفتاح-قيمة، لكن ذلك فقط عند النظر إليه من بعيد. يحتفظ Kafka بمعلومات كافية لإعادة بناء أحدث حالة؛ لكنه لا يعرض تلك الحالة كجدول. ولا توجد عملية في الوسيط تقابل:
SELECT *
FROM customers
WHERE customer_id = 'customer-123';
يمكن للمستهلك قراءة السجل وبناء تمثيل كهذا، لكن ذلك التمثيل يقيم في مكان آخر. يبني Kafka Streams مخازن حالة محلية - ويقدّم ksqlDB، الذي يعمل فوق Kafka Streams، هذا النمط تحديدًا في صورة جداول SQL تُجسَّد باستمرار من المواضيع. ويحتفظ Flink بحالة المشغّلات (operator state)، وعادةً ما يدعمها RocksDB. كما تجسّد التطبيقات بيانات Kafka في Redis أو Cassandra أو PostgreSQL أو Elasticsearch أو قاعدة بيانات أخرى.
في المشاريع المبنية على Kafka، أصادف مرارًا وتكرارًا صيغًا من الصورة نفسها: مجموعة بيانات للعملاء أو المنتجات محفوظة كحالة Flink لعمليات الربط الإثرائية، ومكررة في Redis لتتمكن الخدمات من الاستعلام عنها بزمن استجابة منخفض، ومكتوبة إلى lakehouse للتحليلات. ولكل نسخة سبب وجيه لوجودها. لكنها مجتمعةً تعني ثلاثة أو أربعة أنظمة ذات حالة تحتفظ بالجدول المنطقي نفسه:
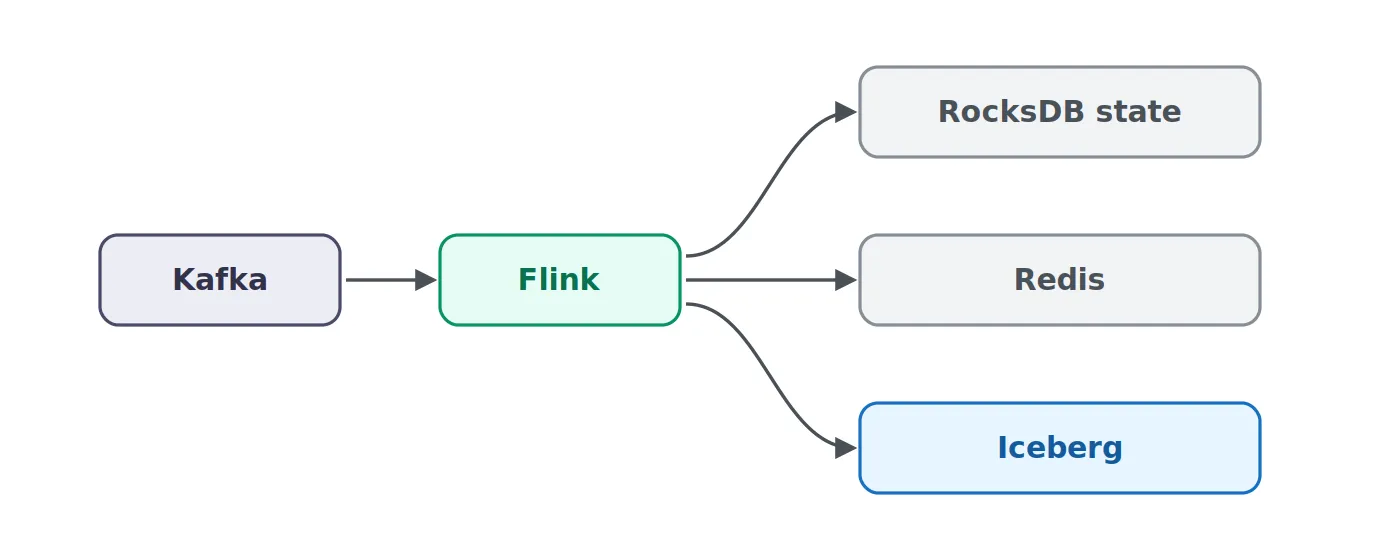
يحتفظ Kafka بسجل التغييرات (changelog)، ويقدّم مخزن الحالة أحدث قيمة، ويحتفظ lakehouse بالبيانات التاريخية للاستعلامات التحليلية. لتقسيم هذه المسؤوليات مزاياه، لكنه يعني أيضًا أن تدفق تحديثات يبدو بسيطًا يُنسخ إلى عدة أنظمة ذات حالة – لكل منها قصته الخاصة في الاتساق والسعة والتشغيل.
Fluss يستهدف هذا التكرار تحديدًا.
Fluss يبدأ بجدول
أولًا، بعض الخلفية عن المشروع، لأنه فتيّ. وُلد Fluss في Alibaba، وانضم إلى Apache Incubator في 2025، وأصبح مشروعًا رفيع المستوى في Apache في أغسطس 2026. وفي وقت كتابة هذا المقال، أحدث إصدار مستقر هو 0.9.1؛ ولا يزال ملف الإصدار يحمل الوسم Incubating، لأن الإصدار صدر قبل التخرج. ما زال Flink هو أكمل تكامل حسابي، لكن Fluss يوفّر الآن أيضًا عملاء بلغات Java وRust وPython وC++ – وغير Java منها مبنية على نواة Rust مشتركة وشهدت إصدارها الأول 0.1.0 في 2026، لذا لا يزال تغطية الميزات تختلف بين اللغات. المنظومة فتيّة، وينبغي أن يأخذ أي قرار تبنٍّ ذلك في الحسبان.
يتعامل Fluss مع التدفقات الملحقة فقط (append-only)، لكن هذا ليس ما يميزه عن Kafka. التجريد الأكثر إثارة للاهتمام هو جدول المفتاح الأساسي (Primary Key Table). يمكن تعريف جدول Fluss بمفتاح:
CREATE TABLE customers (
    customer_id STRING,
    name STRING,
    status STRING,
    PRIMARY KEY (customer_id) NOT ENFORCED
);
لنلقِ نظرة مجددًا على السلسلة نفسها من التحديثات:
customer-123 -> Alice, active
customer-456 -> Bob, active
customer-123 -> Alice, blocked
الحالة الحالية للجدول هي:
customer-123 -> Alice, blocked
customer-456 -> Bob, active
وفي الوقت نفسه، لا يزال بإمكان المستهلكين اللاحقين في التدفق رؤية التغييرات. وهذا هو الفرق الجوهري. ففي Kafka يكون السجل هو تجريد التخزين الرئيسي، وتُشتق الحالة الحالية منه عادةً. أما في جدول المفتاح الأساسي في Fluss فينتمي كل من سجل التغييرات والحالة الحالية إلى تجريد التخزين.
وفي الباطن، لا يجعل Fluss مشكلة الحالة تختفي. تحتفظ جداول المفتاح الأساسي بمكوّن سجل ومكوّن مفتاح-قيمة معًا، وتستخدم RocksDB للحالة الحالية:
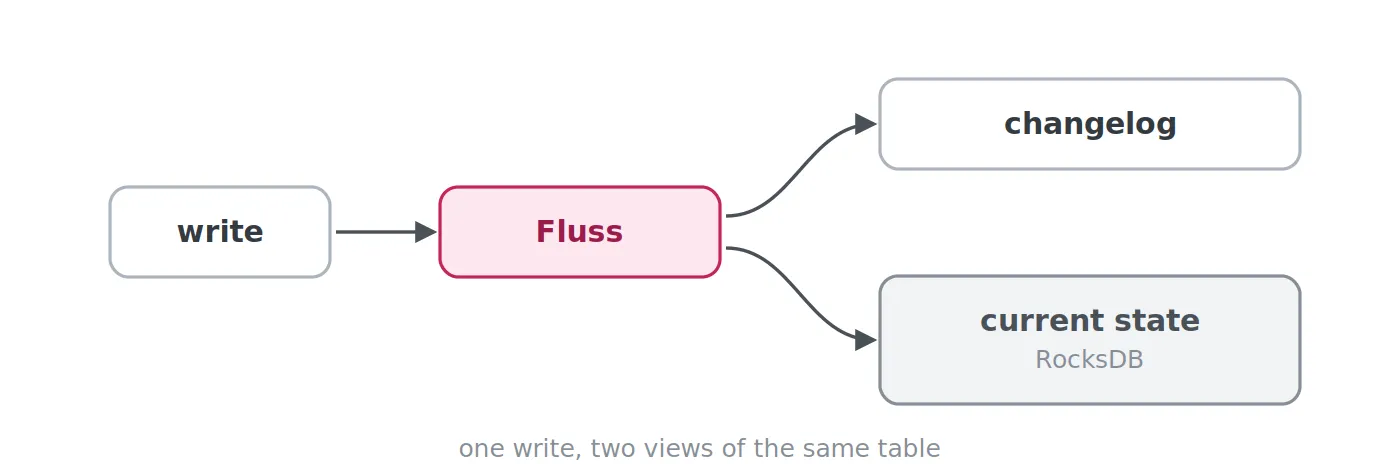
إذًا لا يتخلص Fluss من RocksDB – بل ينقل ملكيته. فبدلًا من أن يحتفظ كل تطبيق معالجة بنسخته الخاصة من الحالة نفسها، تحتفظ بها طبقة التخزين مرة واحدة وتتيحها لمستهلكين كثيرين. وفي مجموعات بيانات CDC وعمليات الربط بالبحث (lookup joins) وبيانات المرجع المعاد استخدامها على نطاق واسع، يمكن أن يزيل هذا قدرًا مدهشًا من الحالة المكررة.
السجل المضغوط ليس جدول مفتاح أساسي
قد يبدو ضغط Kafka وجدول المفتاح الأساسي متشابهين، إذ يتعامل كلاهما مع قيم متعددة مرتبطة بالمفتاح نفسه، لكنهما يعالجان أسئلة مختلفة. يعالج ضغط Kafka في الأساس:
هل يمكن الاحتفاظ بسجل قابل لإعادة التشغيل دون الاحتفاظ بكل قيمة تاريخية لكل مفتاح إلى الأبد؟
أما جدول المفتاح الأساسي فيعالج:
ما هي قيمة هذا المفتاح في الوقت الحالي؟
هذان المتطلبان مرتبطان، لكنهما ينتجان تصميمَي تخزين مختلفين. يظل Kafka محسَّنًا للاستهلاك المرتب؛ أما جدول المفتاح الأساسي فيحتاج بالإضافة إلى ذلك إلى وصول فعّال إلى الحالة.
يوضح Kafka Streams هذا الفرق بشكل جميل. يمكن لتطبيق Streams قراءة موضوع مضغوط والاحتفاظ بمخزن RocksDB محلي: يوفّر Kafka سجل التغييرات المتين، ويوفّر RocksDB الوصول الفعّال إلى الحالة المجسَّدة. أما Fluss فيسحب هذا التجسيد إلى نظام التخزين نفسه.
وإفادة ذلك تتوقف على الحمل. فبالنسبة إلى حالة المعالجة الخاصة بتطبيق واحد، قد تكون الحالة المحلية هي الأنسب تمامًا – فقد يحتفظ تطبيق Kafka Streams بحالة لا وجود لها إلا بسبب منطق معالجته، ولن يكون نقلها إلى قاعدة بيانات مشتركة منطقيًا. لكن تخيّل مجموعة بيانات كبيرة للعملاء أو المنتجات تقرؤها عشر مهام Flink مختلفة. إذا كانت كل مهمة تحتاج إلى أحدث حالة نفسها لعمليات الربط بالبحث، فإن إعادة بناء عشر نسخ منها وصيانتها أقل وضوحًا بكثير كفكرة جيدة، وتبدأ الجداول المتدفقة المشتركة بالظهور جذابة.
الطبقة الساخنة يمكن أن تكون عمودية أيضًا
هناك فرق آخر يسهل إغفاله: بحكم التصميم، لا يفهم Kafka بنية قيمة الرسالة. لنفترض أن حدثًا يحتوي خمسين عمودًا:
customer_id
name
email
address
country
currency
segment
device
browser
...
قد لا تحتاج مهمة Flink إلا إلى customer_id وcountry. ومع Kafka، يظل المستهلك يسحب سجلات تحمل القيمة المسلسلة بالكامل، ولا تُختار الأعمدة إلا بعد أن يصل السجل إلى المستهلك ويُفكّ تسلسله.
يعمل Fluss بشكل مختلف. يمكن لتمثيله للسجل الاعتماد على Apache Arrow، فتكون طبقة التخزين على دراية بالأعمدة. فاستعلام مثل:
SELECT customer_id, country
FROM customers;
يمكن دفع الإسقاط (projection) فيه إلى طبقة التخزين، بحيث لا تُرسل عبر الشبكة سوى الأعمدة المطلوبة. نفكر عادةً في تقليم الأعمدة في سياق ملفات Parquet في data lake، لا في نظام يقدّم بيانات بث طازجة – وهنا يبدأ مسار البث الساخن بمشابهة محرك تخزين تحليلي إلى حد ما. ولا تقتصر فائدة التخطيط العمودي على نقل البيانات: فقيم العمود الواحد تُخزَّن متجاورة في الذاكرة، وهذا بالضبط التخطيط الذي تزدهر عليه عمليات التجميع – فجمع عمود رقمي عبر دفعات Arrow عملية مختلفة تمامًا عن استخراج حقل واحد من كل سجل فُكّ تسلسله على حدة. ومرة أخرى، هذا نابع من التجريد الأساسي.
Kafka يرى سجلات. أما Fluss فيرى صفوفًا.
للتاريخ، يظل lakehouse هو الأفضل
القدرة على الاستعلام عن الطبقة الساخنة لا تعني أنه ينبغي أن تحتفظ ببيانات سنوات. فتخزين الكائنات ما زال أرخص بكثير، والأنظمة التحليلية تتفوق في مسح مجموعات البيانات العمودية الكبيرة المخزنة فيه. ولهذا يدعم Fluss نقل البيانات الأقدم على طبقات (tiering) إلى جداول lakehouse مثل Paimon أو Iceberg:
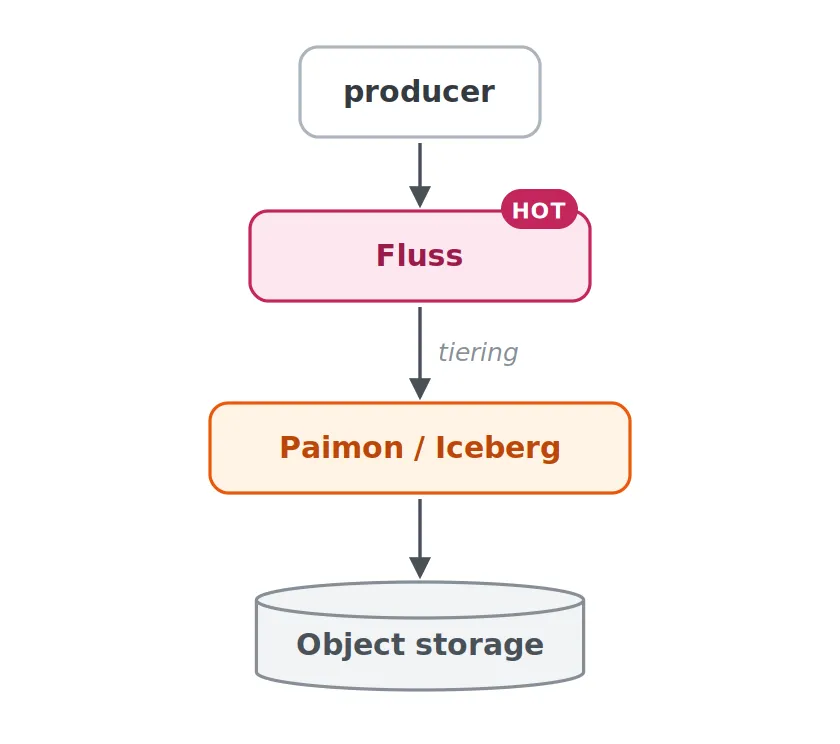
يمتد الجدول المنطقي نفسه الآن عبر طبقتي تخزين: يخدم Fluss الجزء الساخن، ويحتفظ lakehouse بالتاريخ. والجزء الصعب هو تشغيل الاستعلامات عبر تلك الحدود.
لنفترض أن lakehouse يحتوي كل ما ثُبّت حتى 12:00:00، بينما لا تزال ثلاثون ثانية من البيانات الأحدث موجودة في Fluss فقط. في 12:00:30 يُرجع استعلام على البحيرة وحدها نتيجة قديمة. وجعل كل حدث مرئيًا فورًا في Iceberg أو Paimon ليس الحل أيضًا – فصيغ lakehouse تعمل بالملفات واللقطات، وعمليات التثبيت المتكررة جدًا تنتج بالضبط مشكلات الملفات الصغيرة والبيانات الوصفية التي وُجدت هذه الأنظمة لإبقائها تحت السيطرة. وفي التدفقات الكثيرة التحديث تزداد المفاضلة حدّة: فمع النسخ عند الكتابة (copy-on-write)، تعيد كل عملية تثبيت كتابة ملفات البيانات، فتتحمل الكتابة الكلفة؛ ومع الدمج عند القراءة (merge-on-read)، تظل الكتابة رخيصة، لكن على القرّاء دمج كومة متنامية من ملفات الحذف إلى أن يلحق الضغط بها – لذا تتطلب القراءة السريعة ضغطًا متكررًا للجدول. وإذا رفعت تكرار التثبيت بما يكفي، فلا بد أن يتنازل أحد الطرفين.
يعالج Fluss هذا بدمج اللقطة التاريخية المستقرة مع الذيل الساخن:
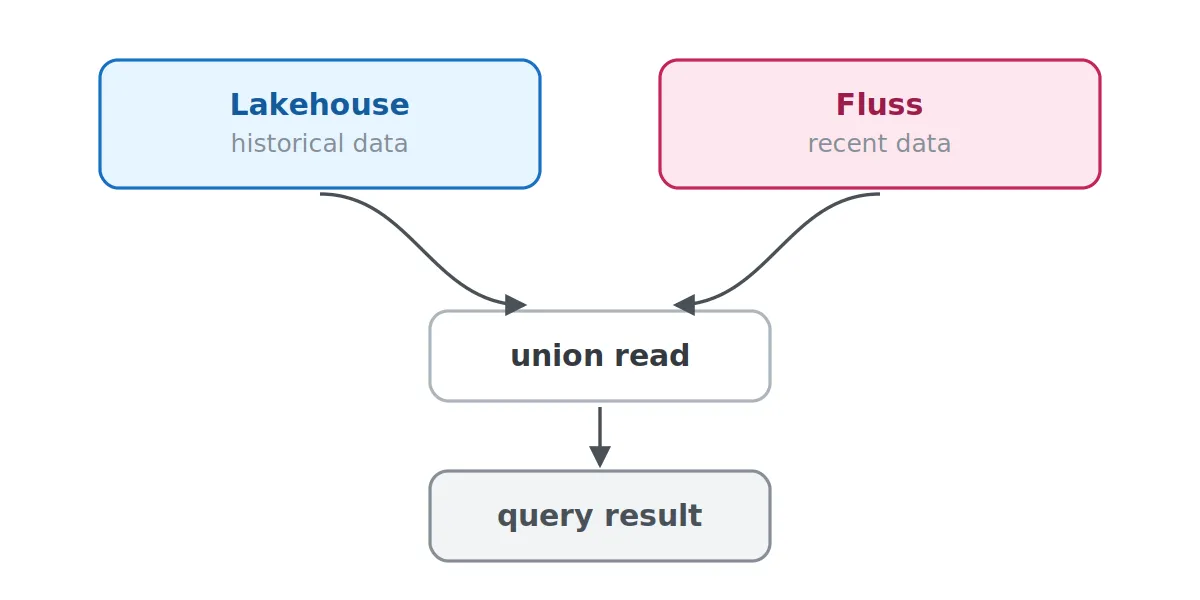
لا يلزم الاحتفاظ بالجدول المنطقي الكامل فعليًا في مكان واحد. يمكن أن تقيم البيانات الأقدم بكلفة منخفضة في تخزين الكائنات، بينما تبقى البيانات الطازجة في تخزين بث منخفض زمن الاستجابة.تأمل كيف يؤثر ذلك في مفاضلة Iceberg الموصوفة أعلاه: فالقراءة الموحَّدة (union read) لا تجعل copy-on-write أو merge-on-read أرخص، لكنها تلغي الحاجة إلى تشغيلهما بتردد البث أصلًا – إذ يمكن لـ lakehouse التثبيت والضغط بالوتيرة التي تُبقي الجدول بحالة جيدة، لأن الطزاجة تأتي من Fluss بدلًا من انتزاعها من Iceberg.
وFluss ليس النظام الوحيد بهذا الفصل بين الساخن والبارد. فتوفر Confluent Cloud الآن مسارًا مشابهًا مبنيًا على Kafka.
ما الفرق في Confluent Cloud: Tableflow
Confluent Tableflow هو طريقة Confluent في معالجة مسار Kafka إلى lakehouse. والتحفظ الأساسي: Tableflow خدمة في Confluent Cloud. فهي ليست جزءًا من Apache Kafka، كما أنها غير متاحة في Confluent Platform المُدار ذاتيًا. وبالتالي فإن كل ما في هذا القسم يصف معمارية مُدارة في Confluent Cloud، لا بدائية تخزين جديدة داخل Kafka نفسه.
ضمن هذه الحدود، يمكن لـ Tableflow تجسيد موضوع Kafka باستمرار في جدول Iceberg أو Delta Lake:
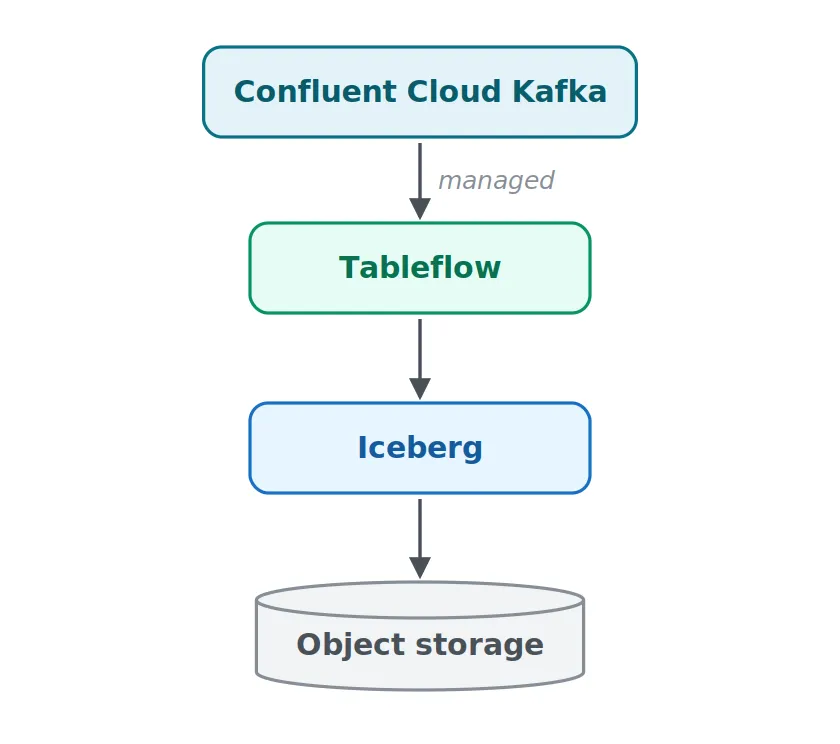
المسار الذي كان يحتاج Connect أو Flink أو شيفرة تطبيق مخصصة يصبح جزءًا من المنصة. وبالنسبة للمواضيع الملحقة فقط، فالمطابقة بسيطة نسبيًا: تصبح السجلات صفوفًا وتُكتب في الجدول. والأكثر إثارة أن Tableflow يوفّر أيضًا تجسيدًا بأسلوب upsert للمواضيع المضغوطة، بحيث يمكن لتدفق التغييرات أن يتحول إلى جدول يعكس الحالة الحالية.
ويبدو الفصل الناتج بين الساخن والبارد شبيهًا بشكل لافت بمخطط تقسيم Fluss إلى طبقات. يحتفظ Kafka بالأحداث الطازجة، ويحتفظ Iceberg بالجدول التاريخي المجسَّد، ويمكن لتكامل Flink من Confluent دمج لقطة Tableflow مع السجلات التي لم تصل بعد إلى الجدول المجسَّد:
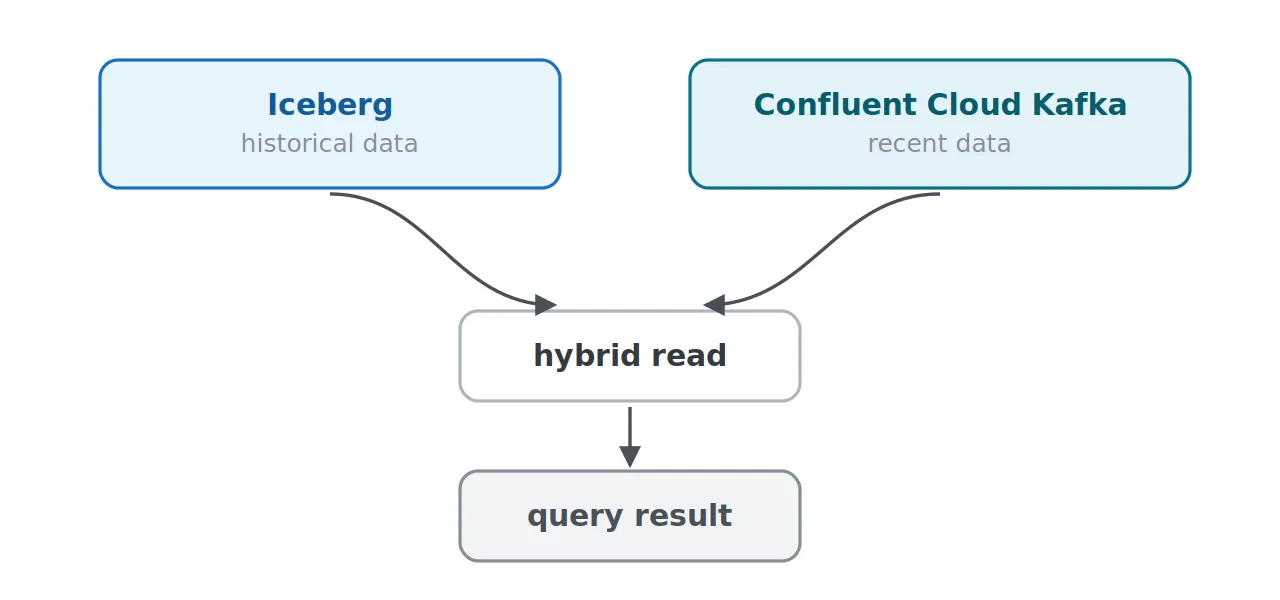
الدلالات والتنفيذ ليسا نفسيهما كما في القراءات الموحّدة في Fluss، لكن الحيلة الأساسية متطابقة: لا تطلب من lakehouse أن يوفّر طزاجة بالميلي ثانية. اقرأ الجزء المستقر من البحيرة والذيل من نظام البث. وعلى الرغم من أن المكدّسين ينطلقان من تجريدين مختلفين، فإنهما يصلان إلى تخطيط ساخن/بارد متشابه.
يضيّق Tableflow الفجوة كثيرًا في المقارنة بين Kafka وFluss. فمع Apache Kafka المُدار ذاتيًا، يعني تحويل موضوع إلى جدول lakehouse مصون عادةً تشغيل مسار آخر. وفي Confluent Cloud، يزيل Tableflow معظم هذه الوصلات. وما يتبقى هو الفرق في الطبقة الساخنة. فإذا احتاجت التطبيقات بالإضافة إلى ذلك إلى وصول منخفض زمن الاستجابة إلى الحالة الحالية، فلا تزال المعمارية تتطلب فرعًا آخر، بينما مع Fluss يمكن أن تقيم تلك الحالة في طبقة التخزين:
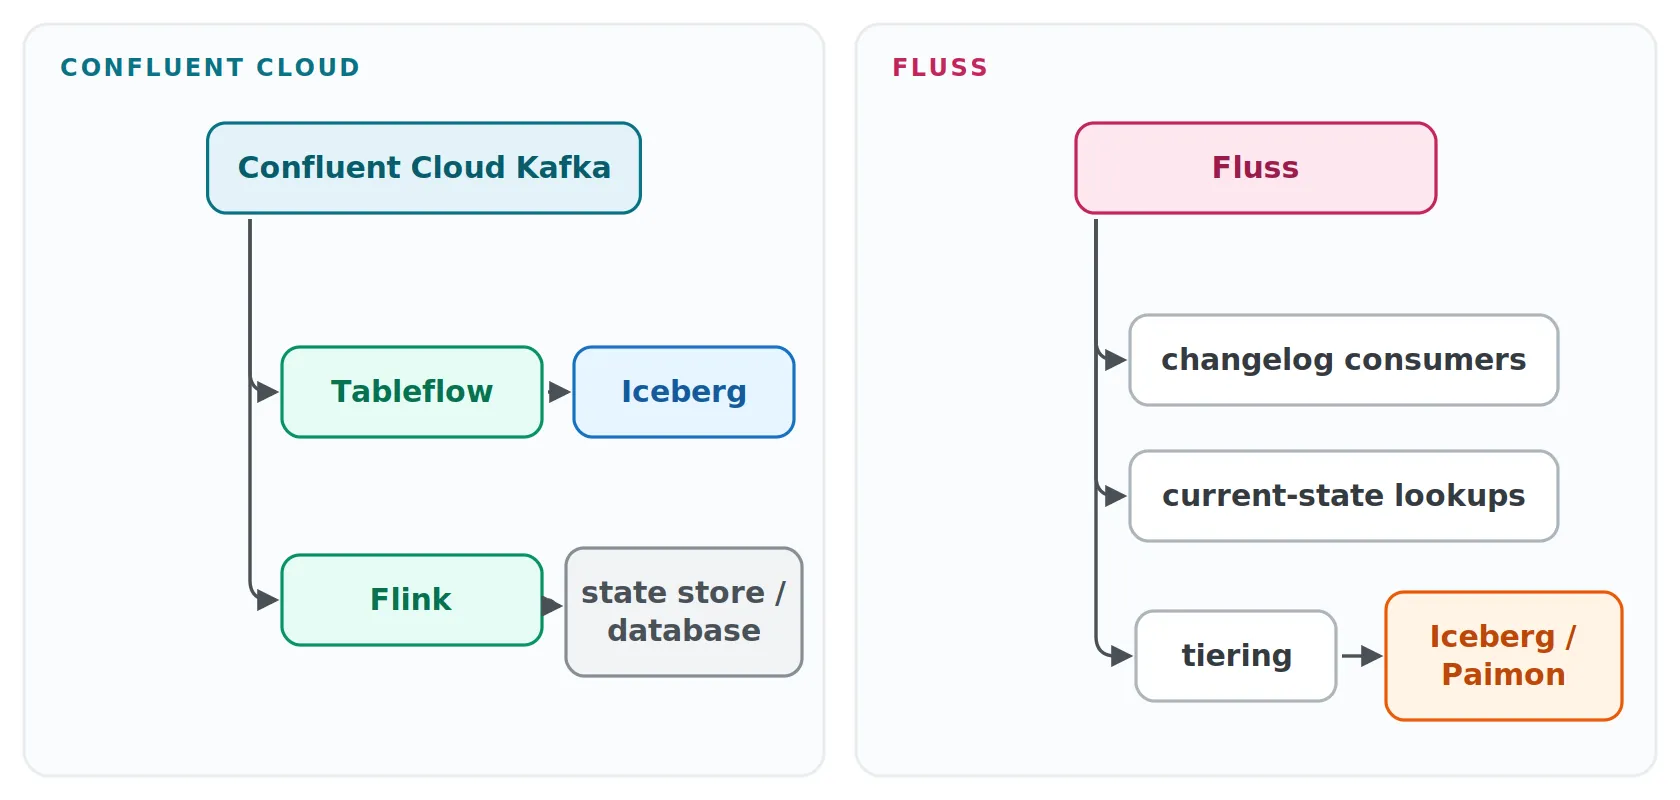
وهذا يتركنا أمام سؤال أكثر قيمة من “هل يستطيع Fluss إدخال بيانات البث إلى Iceberg بكفاءة أكبر من Kafka؟”: هل ما زلنا بحاجة إلى تجسيد منفصل للحالة الحالية إذا كان تخزين البث قادرًا على عرضها مباشرة؟
دلالات Kafka تتسرب إلى الجدول
يكشف وضع upsert في Tableflow أيضًا ما يحدث عندما يُشتق جدول من سجل. يضمن Kafka الترتيب والضغط لكل قسم، لذا يصبح نموذج التقسيم حتمًا جزءًا من دلالات الجدول الناتج.
لنفترض أن مفتاحًا يُربط أولًا بقسم واحد:
partition 3:
customer-123 -> active
لاحقًا، بعد تغيّر عدد أقسام الموضوع، قد يهبط المفتاح نفسه في مكان آخر:
partition 8:
customer-123 -> blocked
من الناحية التجارية، لا يزال عميلًا واحدًا. أما Kafka فيرى تاريخين منفصلين للأقسام. إعادة التقسيم من تلك الحالات الحدّية التي يظهر فيها التجريد الأساسي فجأة: فالجدول المشتق من سجل ليس تمامًا مثل نظام تخزين نموذج بياناته جدول.
أين يأتي Paimon؟
يتناسب Paimon بشيء من الإحراج مع عنوان مثل “Kafka مقابل Fluss مقابل Paimon”، لأنه يعالج طبقة مختلفة من المشكلة. يمكن لـ Fluss استخدام Paimon لتخزين lakehouse الخاص به، لكن Iceberg يعمل أيضًا. فهناك في الواقع خياران مستقلان: الطبقة الساخنة (Kafka أم Fluss؟) وتمثيل lakehouse (Iceberg أم Paimon؟).
بدأ Paimon داخل مجتمع Flink باسم Flink Table Store قبل أن يصبح مشروعًا رفيع المستوى في Apache، وهذا الإرث ظاهر في تصميمه. داخليًا، يُبنى كل bucket في جدول Paimon كشجرة LSM – وهي بنية مصممة لاستيعاب الكتابة والتحديثات المستمرة بدلًا من الإلحاقات الدفعية العرضية. وتوفر جداول المفتاح الأساسي فيه محركات دمج قابلة للضبط تحدد ما يحدث عند وصول عدة سجلات للمفتاح نفسه: deduplicate يُبقي الصف الأحدث، وpartial-update يتيح لكتّاب منفصلين ملء أعمدة مختلفة من صف واحد، وaggregation يجمع القيم الواردة في تجميعات. كما يستطيع Paimon إصدار سجل تغييرات مناسب لقرّاء البث اللاحقين، مع عدة أوضاع changelog-producer توازن بين كلفة الكتابة واكتمال سجل التغييرات.
صُمم Paimon على افتراض أن “تدفق تغييرات على جدول” حمل عادي لا حالة حدّية. وهذا يجعله مناسبًا بطبيعته لمسارات CDC الكثيفة، ويساعد في تفسير سبب نجاحه الكبير مع Fluss، الذي نشأ من منظومة Flink نفسها.
يأتي Iceberg من زاوية مختلفة نوعًا ما ويحمل ميزة كبيرة خاصة به: تبنّي المنظومة. فتدعمه المحركات التحليلية ومنصات البيانات السحابية على نطاق واسع، مما يجعله طبقة تشغيل بيني طبيعية. ونتيجة لذلك، يمكن أن تكون Fluss + Iceberg معمارية معقولة تمامًا أيضًا. فما يحدد Fluss ليس استخدام Paimon – بل الجدول المتدفق في الطبقة الساخنة.
Kafka Tiered Storage يعالج مشكلة مختلفة
يدعم Kafka أيضًا Tiered Storage بذاته، وهذا قد يلبّد المصطلحات. فإذا كان Kafka قادرًا على نقل مقاطع السجل القديمة إلى تخزين الكائنات، فلماذا نتكبد عناء تحويل البيانات إلى Iceberg أو Paimon؟ لأن ما تحصل عليه في النهاية مختلف.
تبقى الملفات البعيدة جزءًا من سجل Kafka. يمكن لمستهلكي Kafka قراءتها بدلالات Kafka، لكنها لا تتحول إلى جدول يستطيع Spark أو Trino أو محرك آخر الاستعلام عنه بمفرده كما هو الحال مع Iceberg. أما Tableflow وتقسيم lakehouse إلى طبقات في Fluss فيفعلان شيئًا مختلفًا:
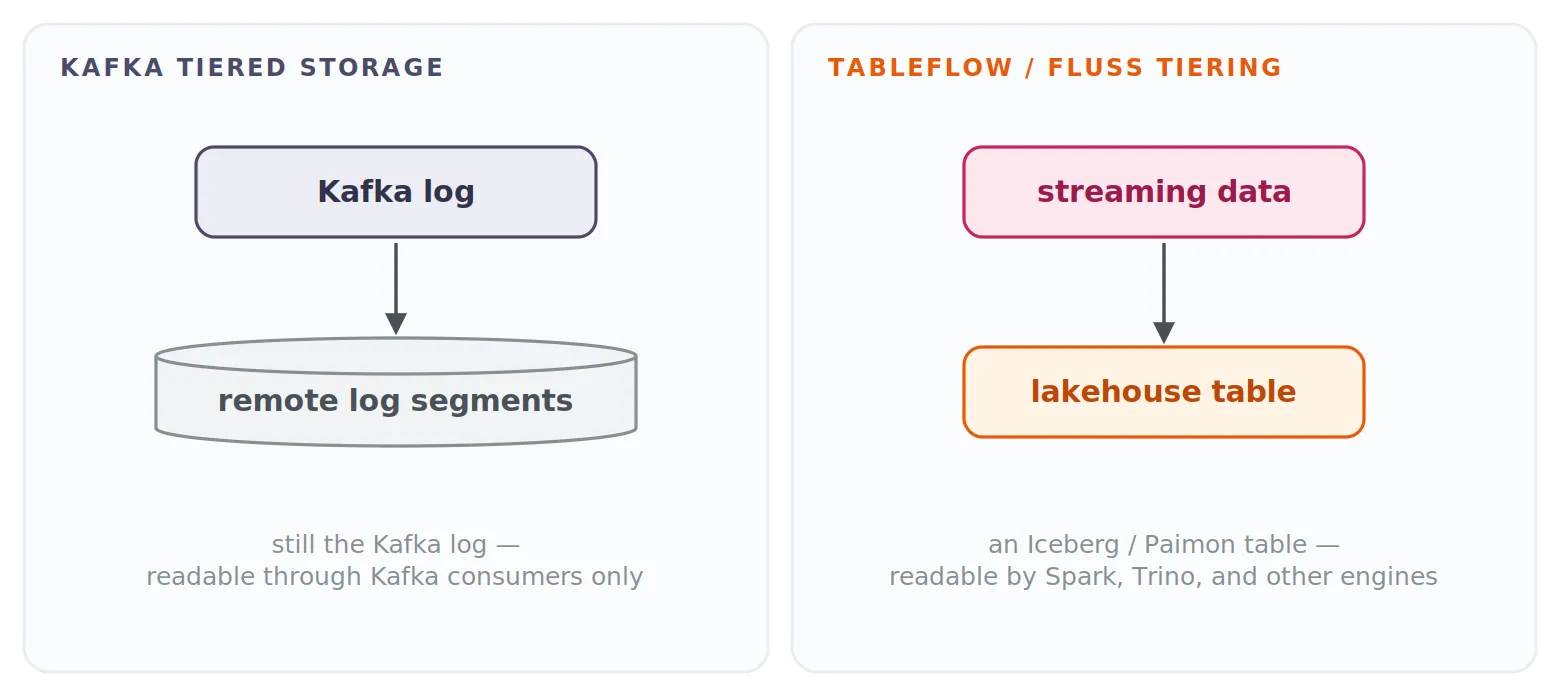
كلاهما يعتمد على تخزين الكائنات. لكن واحدًا منهما فقط يغيّر طريقة تمثيل البيانات.
هل Fluss بديل لـ Kafka؟
ليس بالمعنى المعتاد للكلمة. فـ Kafka أكثر بكثير من محرك تخزين. يأتي نشر Kafka الإنتاجي مع مكتبات عملاء وموصّلات Kafka Connect وتكاملات Schema Registry وتطبيقات Kafka Streams والمراقبة وأدوات التشغيل والخدمات المُدارة وسنوات من الخبرة الهندسية المتراكمة. وتعتمد معماريات كثيرة أيضًا على Kafka عمودًا فقريًا للتكامل على مستوى المؤسسة، وفي حمل كهذا لا يتعلق استبدال Kafka بما إذا كان نظام آخر قادرًا على إلحاق السجلات وتكرارها – فالمنظومة المحيطة تُحتسب بقدر ذلك على الأقل.
كما أن Fluss ليس وسيطًا متوافقًا مع Kafka يمكنك وضعه تحت المنتِجين والمستهلكين الحاليين. فقد نوقش توافق بروتوكول Kafka في مجتمع Fluss وأُسقط من خارطة طريق المشروع؛ وكانت إحدى الحجج أن بروتوكول Kafka سيكشف جزءًا فقط مما تستطيعه جداول Fluss. ويكشف هذا القرار الكثير عن الوجهة التي يسير إليها المشروع. فـ Fluss لا يهدف إلى أن يكون Kafka أسرع بمحرك تخزين مختلف.
ومع ذلك، قد لا يكون الاستبدال المباشر هو الترحيل الذي يستحق التفكير فيه أصلًا. تأمّل نظامًا نما تدريجيًا حتى صار:
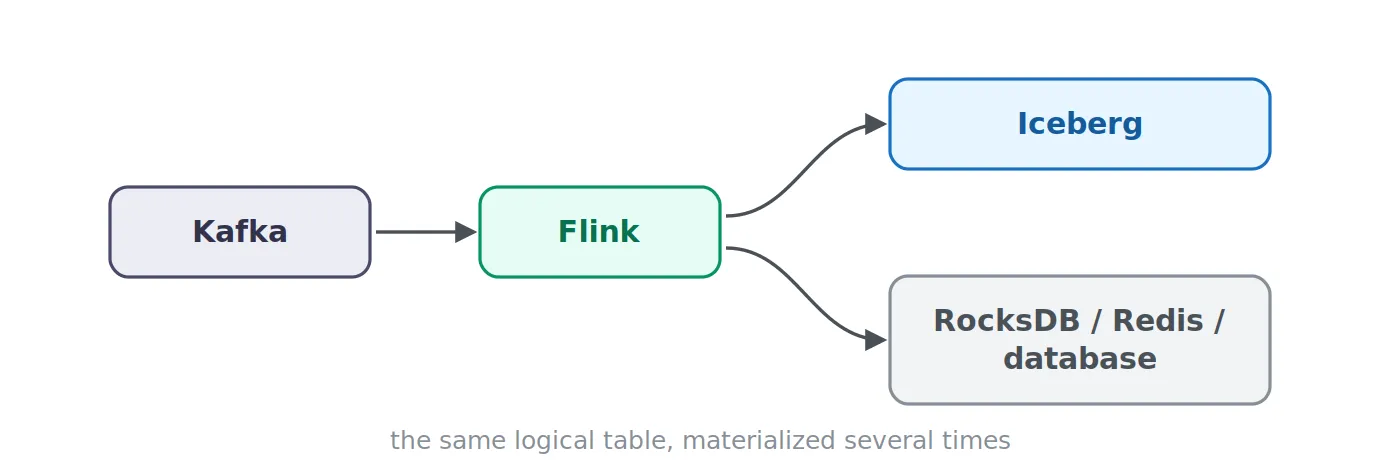
قد يكون كل مكوّن في ذلك المخطط مبررًا. فقد تكون حالة RocksDB خاصة بالتطبيق؛ وقد يخدم Redis هدفًا مختلفًا لزمن الاستجابة أو التوافر؛ ويوجد Iceberg للتحليلات. لكن في بعض الأحيان توجد النسخ لسبب أكثر جوهرية: يعرض نظام البث سجلًا، بينما يحتاج المستهلكون إلى جدول. وهذا هو السيناريو الذي بُني Fluss من أجله.
السجل أولًا أم الجدول أولًا؟
حوّل Kafka السجل الموزع إلى الأساس القياسي لأنظمة البث الحديثة، وهذا النموذج ممتاز بشكل استثنائي في نقل الحقائق غير القابلة للتغيير بين مستهلكين مستقلين. وفي الوقت نفسه، فإن حصة متنامية من أحمال البث هي في الواقع تدفقات تغييرات على جداول. وCDC هو المثال الأوضح: فأحداث INSERT customer وUPDATE customer وDELETE customer قيّمة كسجل، لكن ما يريده كثير من المستهلكين فعلًا في النهاية هو جدول customers – الحالة الحالية متاحة فورًا، والنسخ الأقدم متاحة عند الحاجة.
لقد دفعت منظومة lakehouse التخزين التاريخي في هذا الاتجاه بالفعل. فـ Iceberg وPaimon يحوّلان تخزين الكائنات إلى جداول؛ وفي Confluent Cloud يمكن لـ Tableflow اشتقاق جدول كهذا مباشرة من Kafka. ويطرح Fluss السؤال نفسه قبل ذلك بطبقة: لماذا ينبغي أن يظل التخزين الساخن لا يعرض سوى سجل؟
وهذا يعطينا نقطتي انطلاق متمايزتين: معمارية تبدأ بالسجل ومعمارية بث تبدأ بالجدول:
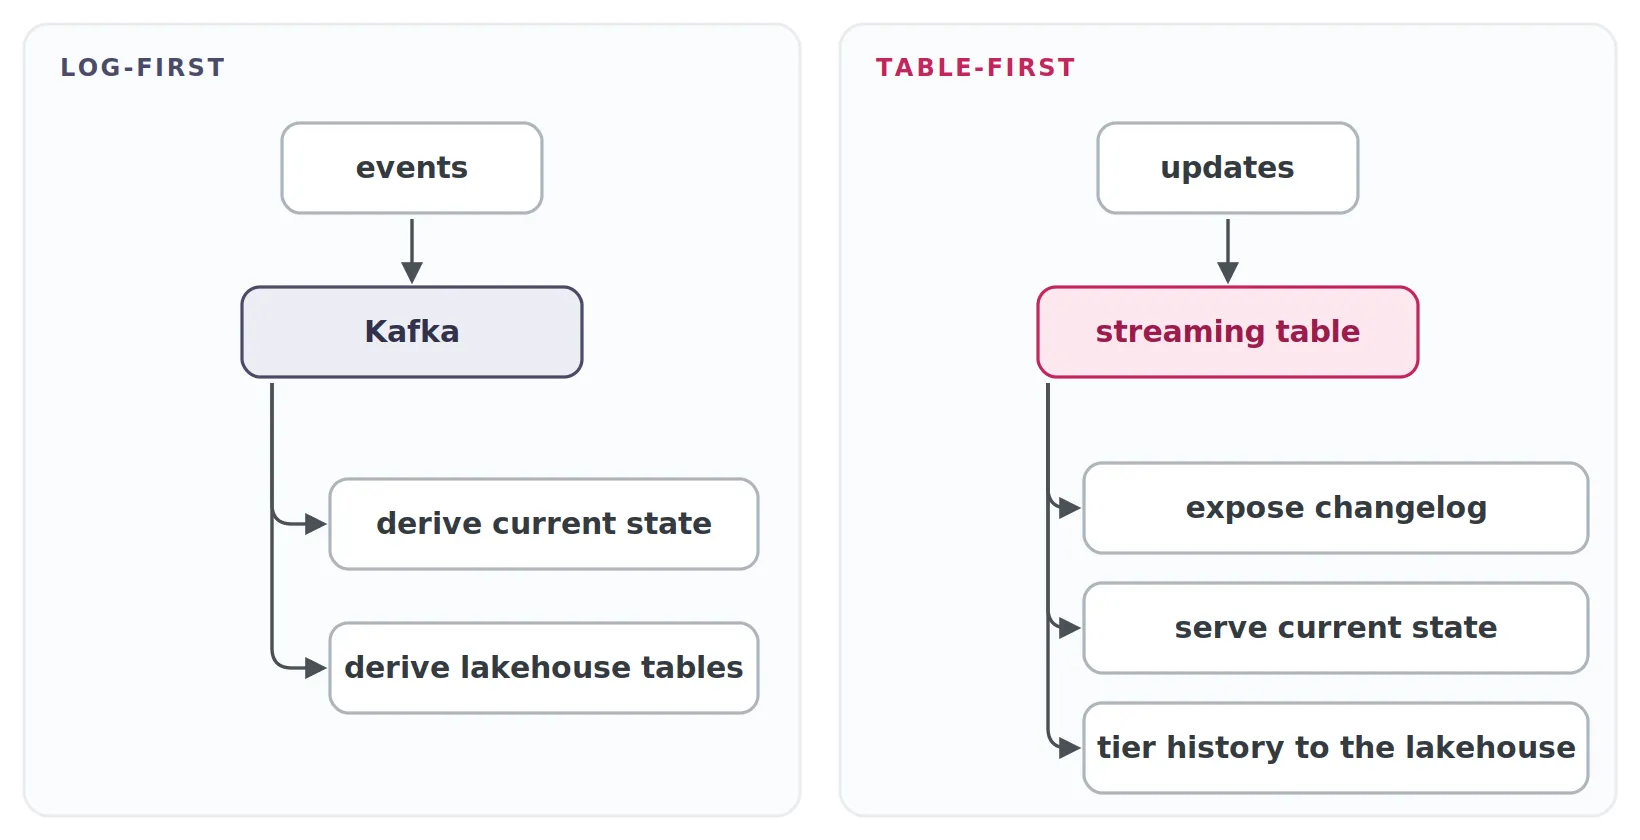
لا أتوقع أن تجعل الجداول المتدفقة Kafka متقادمًا. فالنتيجة الأرجح أنها تقلّص مجموعة الأحمال التي يجب أن يكون فيها السجل هو تجريد التخزين الأساسي. وهذا يجعل السؤال المثير للاهتمام أقل درامية بكثير من “هل سيحل Fluss محل Kafka؟” – وأكثر فائدة بكثير:
إذا كانت البيانات التي نبثّها، في النهاية، جدولًا، فهل ينبغي أن نبدأ بالسجل ونعيد بناء الجدول بعد ذلك، أم نخزّن الجدول المتدفق من البداية؟