Apache Kafka مقابل Apache Iggy: سجل واحد ومحرّكان
مقارنة بين Apache Kafka وApache Iggy تتناول نماذج التخزين وضمانات المتانة وادعاءات اختبارات الأداء ومدى نضج التكرار (replication) فيهما.
هل Apache Iggy ببساطة نسخة أسرع من Apache Kafka؟
يخزّن كل منهما الرسائل في سجلات مقسّمة (partitioned) تُلحَق بها البيانات فقط (append-only). ولكل منهما offsets وسياسات احتفاظ (retention) ومجموعات مستهلكين (consumer groups) وإعادة تشغيل (replay). ينفَّذ Apache Iggy بلغة Rust بمعمارية خيط لكل نواة (thread-per-core) مبنية على io_uring، بينما يعمل Kafka على JVM. يمكن لاختبار أداء أن يقارن بينهما، شريطة أن نتأكد أولاً من أن الإعدادات المختبَرة تقدم الضمانات نفسها.
إن لم تكن قد سمعت به: Iggy منصة بث رسائل مكتوبة بلغة Rust، تخرّجت من حاضنة Apache لتصبح مشروعاً رئيسياً (top-level) في Apache في أغسطس 2026.
ما الذي يعنيه تحديداً أن تكون الكتابة ناجحة؟ هل نُسخت الرسالة إلى مخزن مؤقت في الذاكرة؟ أم كُتبت في ذاكرة الصفحات المؤقتة لنظام التشغيل (page cache)؟ أم فُرغت (flush) إلى قرص محلي؟ أم تكررت إلى جهاز آخر؟ أم إلى مركز بيانات آخر؟ وماذا يحدث إذا اختفى الجهاز أو الرف أو مركز البيانات بأكمله مباشرة بعد أن يتلقى المنتِج (producer) إشعار التأكيد؟
تحديث الإصدار: صدر Apache Iggy 0.9.0 في 18 سبتمبر 2026. ويتضمن الخادم العنقودي المبني على VSR الذي لم يكن متاحاً سابقاً إلا في إصدارات التطوير.
مشروع فتي يتحرك بسرعة
أولاً، نبذة عن خلفية Iggy. أطلقه مبتكره في أوائل 2023 لتعلّم Rust ببناء شيء حقيقي؛ والاسم اختصار لـ Italian Greyhound – كلب صغير لكنه سريع بصورة لافتة. انضم المشروع إلى حاضنة Apache في أوائل 2025 وتخرّج بتصويت بالإجماع في أغسطس 2026، في اللحظة نفسها تقريباً التي كان فيها جهده الطويل في التكرار يقترب من أول إصدار عنقودي. وقد أصبح هذا الجهد الآن جزءاً من إصدار 0.9.0.
يتفقان على نموذج البيانات الأساسي
لا يحاول Iggy استبدال السجل بتجريد آخر. وكل من استخدم Kafka سيجد نموذج التخزين فيه مألوفاً. فـ Stream في Iggy مساحة أسماء إضافية تقع فوق الـ topics. وما عدا ذلك، يطابق التسلسل الهرمي عن كثب ما في Kafka. الـ partition سجل مرتّب تُلحَق به البيانات فقط ويتألف من مقاطع (segments). وتحمل الرسائل offsets. ويمكن للمستهلكين البدء من offset صريح أو طابع زمني أو بداية السجل أو نهايته، أو الاستئناف من offset مستهلك مخزَّن على الخادم.
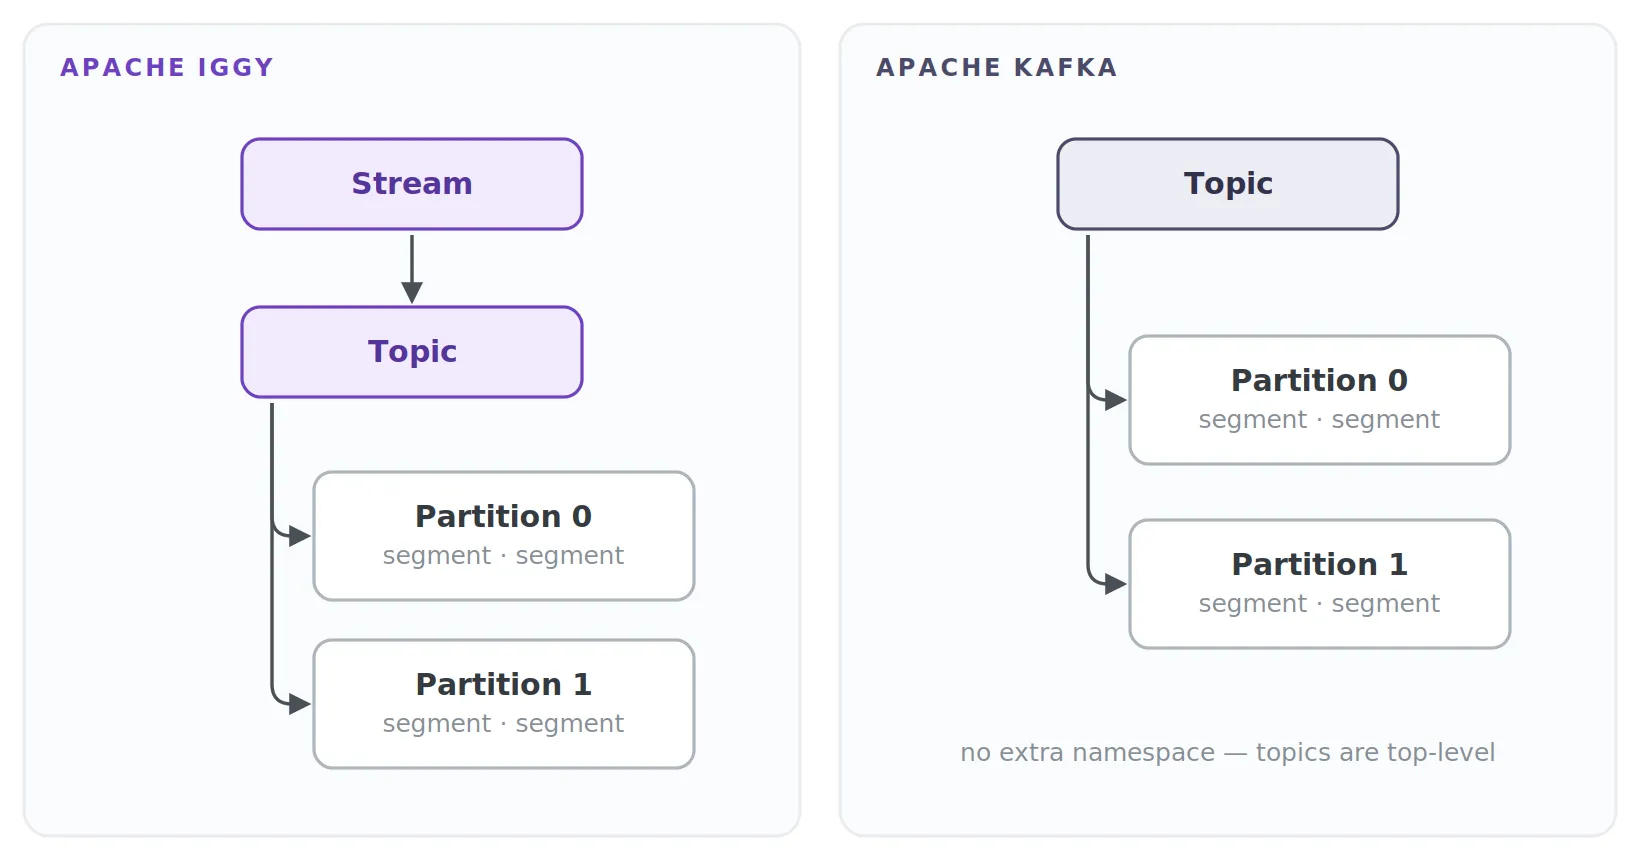
وهذا يجعل هذه المقارنة مختلفة عن المقارنة مع أنظمة تستبدل سجل الأحداث بقاعدة بيانات أو جدول بث، مثل Apache Fluss. فـ Iggy يحتفظ بالسجل المقسّم ويغيّر بدلاً من ذلك محرّك التنفيذ وإدارة الذاكرة ومسار الإدخال والإخراج.
أين يختلف Iggy فعلاً
أتيح لـ Kafka وقت طويل لضبط مسار التخزين فيه. فهو يكتب تسلسلياً، ويجمّع في دفعات بكثافة، ويعتمد على ذاكرة الصفحات المؤقتة لنظام التشغيل، ويمكنه استخدام النقل بلا نسخ (zero-copy) عند تسليم البيانات إلى المستهلكين. فالتجميع في دفعات والإدخال والإخراج التسلسلي يقللان العمل اللازم لكل رسالة.
أما Iggy فيتبع نهجاً أكثر مباشرة في التحكم ببيئة التشغيل. فمنذ الإصدار 0.6.0 فصاعداً، انتقل الخادم من نموذج قائم على Tokio إلى معمارية خيط لكل نواة مبنية على بيئة التشغيل compio، التي تعتمد على io_uring في Linux. وتُربط الـ partitions بشظايا (shards) مثبّتة على أنوية المعالج: فبدلاً من منفّذ يسرق المهام (work-stealing) ويبدّلها بين الخيوط، تملك كل شظية جزءاً من عبء العمل وتشغّله على نواة معالج محددة.
وإضافة إلى ذلك، يدير Iggy مجمّع ذاكرة محجوزاً مسبقاً خاصاً به ويستخدم الإدخال والإخراج المتجهي (vectored I/O) لكتابة دفعات من مخازن الرسائل إلى القرص. والهدف إلى حد كبير هو إمكانية التنبؤ: ففي نموذج خيط لكل نواة، لا يظل الـ partition النشط يقفز بين الخيوط العاملة، ويقل التزامن على مسار البيانات، ويقل إبطال ذاكرة التخزين المؤقت للمعالج (cache invalidation)، وتقل عمليات التخصيص. ويفيد المشروع بمكاسب كبيرة في زمن الذيل (tail latency) من إعادة الكتابة هذه، وهو مجال واحد يمكن أن تسبب فيه بيئات التشغيل التي تسرق المهام مشكلات.
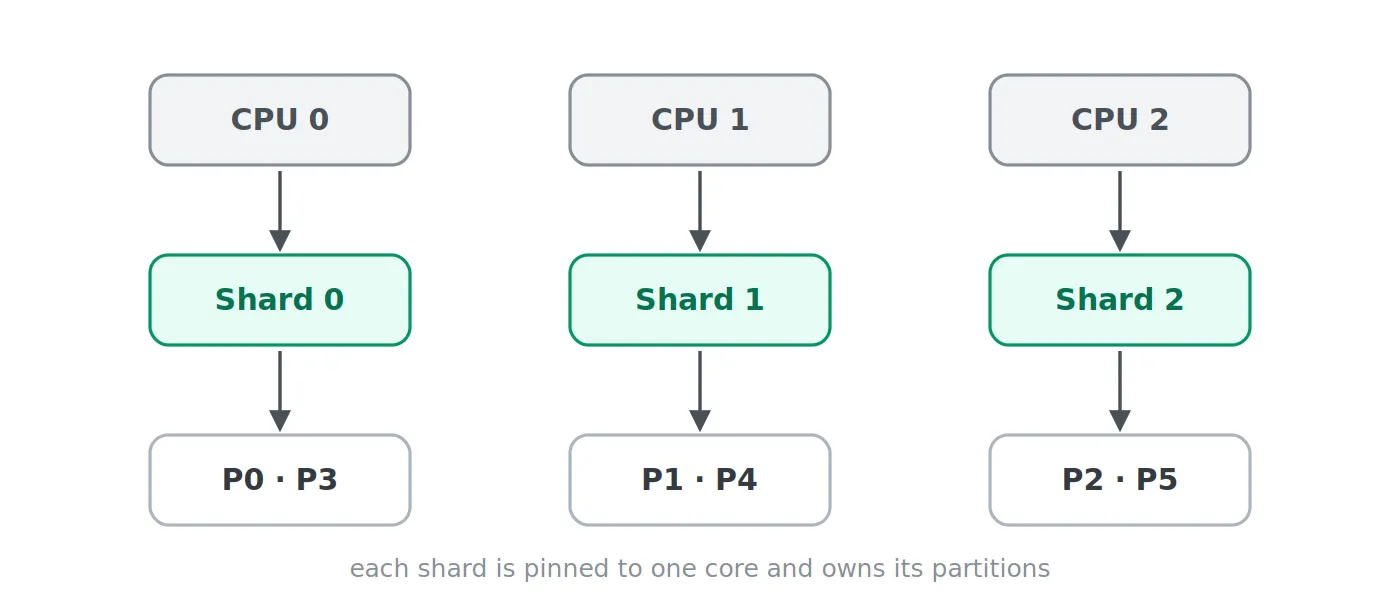
لا يفسر الفرق بين JVM وRust سوى جزء من التصميم. فـ Kafka ليس تطبيقاً عادياً يواصل تخصيص كائنات الرسائل وتحويلها على مساره الساخن؛ فجزء كبير من أدائه ينبع من لمس الحمولة (payload) أقل ما يمكن وترك التخزين المؤقت والإدخال والإخراج التسلسلي لنظام التشغيل. والفرق الأهم أن Kafka يسلّم جانباً كبيراً من التخزين المؤقت للتخزين إلى نظام التشغيل، بينما يحاول Iggy التحكم بجزء أكبر من مسار التنفيذ والذاكرة بنفسه.
ماذا يحدث عندما يكتب منتِج رسالة؟
على عقدة واحدة، يبدو مسار الكتابة في Iggy تقريباً كما يلي:
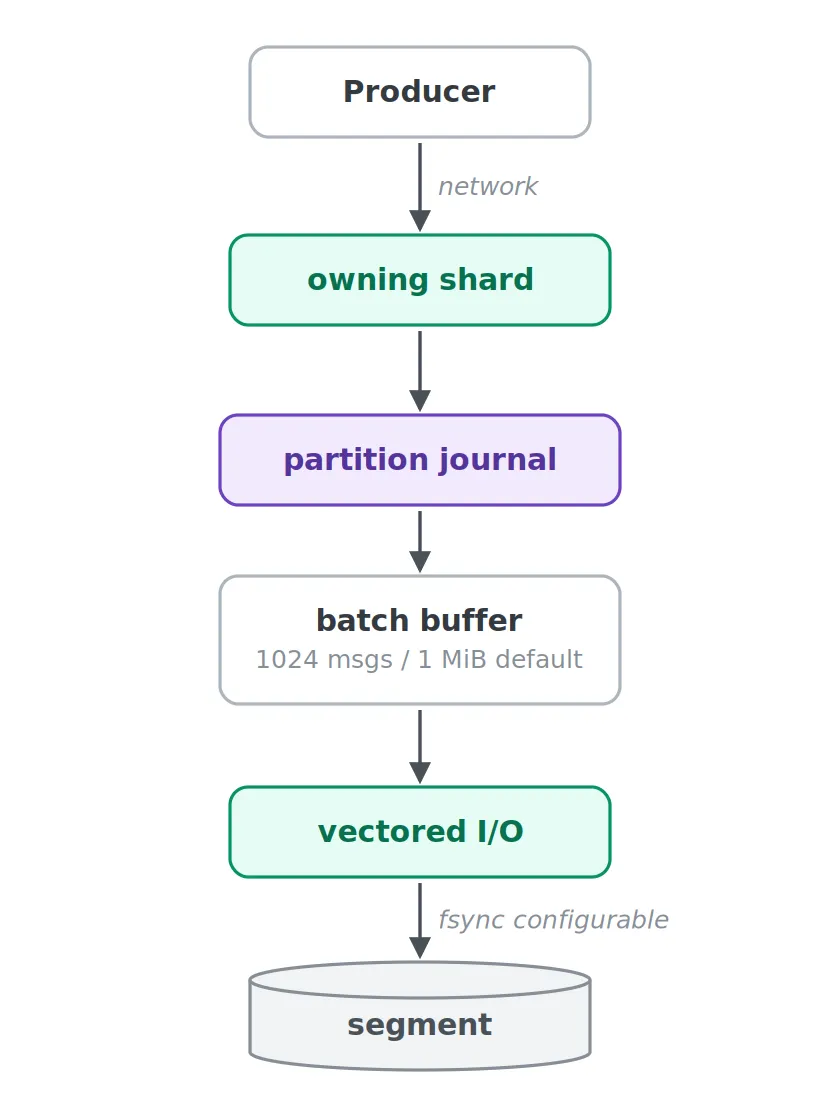
تُحتجز الرسائل في مخزن مؤقت إلى أن يُبلَغ حد عدد أو حجم قابل للضبط – وقت كتابة هذا المقال القيم الافتراضية هي 1024 رسالة أو 1 MiB – ويمكن ضبط fsync لكل topic. ولا يعني الإشعار بالتأكيد بالضرورة أن البيانات في تخزين متين. وتذكر وثائق Iggy بوضوح أن الإعداد الافتراضي لعقدة واحدة يقدم ضمانات متانة ضعيفة وأن عطلاً أو انقطاعاً للكهرباء قد يفقد الرسائل ما لم تُضبط إعدادات المتانة؛ ويوفر الخادم enforce_fsync وعتبات التفريغ (flush) لإدارة هذه المفاضلة.
يواجه Kafka المشكلة الأساسية نفسها لكنه يعالجها بطريقة أخرى. فـ Kafka عادةً لا ينفّذ fsync لكل رسالة على حدة أيضاً. بل تعتمد المتانة في الإنتاج عموماً على التكرار (replication):
| الإعداد | القيمة |
|---|---|
| عامل التكرار للـ topic | 3 |
min.insync.replicas للـ topic |
2 |
acks للمنتِج |
all |
يتتبع Kafka مجموعة ISR، أي مجموعة النسخ المتزامنة. ومع acks=all، ينتظر الإشعار بالنجاح النسخ المتزامنة؛ ويحدد min.insync.replicas أصغر حجم لـ ISR مطلوب لنجاح الكتابة. ولا يعني ذلك أن Kafka في هذا الإعداد ينتظر دائماً نسختين بالضبط.
هذا الفرق حاسم عند مقارنة زمن الاستجابة. فمنتِج Iggy الذي ينتظر كتابة محلية ومنتِج Kafka الذي ينتظر التكرار إلى جهاز ثانٍ لا يقيسان الشيء نفسه. ولا كذلك الكتابة المخزّنة مؤقتاً محلياً وfsync محلي وكتابة مكررة عبر مركزَي بيانات. وقبل أن نقارن الأرقام، علينا تحديد أي عطل يُتوقع أن تصمد أمامه رسالة جرى تأكيدها.
ماذا تقيس الأرقام المنشورة فعلاً؟
لا أجري عمداً اختبار أداء خاصاً بي بين Kafka وIggy لهذا المقال، لكن الأرقام التي نشرها مشروع Iggy تستحق النظر مع إبقاء القسم السابق في الذهن.
تذكر الأسئلة الشائعة للمشروع أن الانتقال إلى خيط لكل نواة وحده حقق تحسناً يصل إلى 92% في زمن الذيل P9999، إضافة إلى زيادة 18% في الإنتاجية مع تشغيل fsync. ويعد موقع المشروع بملايين الرسائل في الثانية بأزمنة ذيل أقل من ميلي ثانية على عقدة واحدة، ويتضمن المستودع أداة iggy-bench الخاصة به، مشيراً إلى أن الإعداد الافتراضي مضبوط للأداء. وهذه نتائج أبلغ عنها المشروع لمحرّك العقدة الواحدة تحت إعدادات الإشعار التي اختُبرت.
مقارنة Iggy على عقدة واحدة مع Kafka ممكنة. فـاختبار أداء للوسيط (broker) فقط نشره مورّد تجاري لـ Iggy يفيد بإنتاجية أعلى وزمن ذيل أقل. وقبل الاعتماد على هذه النتائج، تحقق من إعدادات المتانة إضافة إلى حجم الرسالة والتجميع في دفعات والعتاد. وينبغي أن تسمي المقارنة المتكررة (replicated) أيضاً الإصدار أو بناء التطوير المحدد الذي اختُبر.
يقارن تحسن P9999 المُبلَغ عنه بين Iggy قبل إعادة كتابة خيط لكل نواة وبعدها. وهو ليس قياساً مقابل Kafka. ونسبة المكسب إلى المعمارية تتطلب التحقق من عبء العمل والإعداد المستخدمين في التشغيلين.
Iggy على عقدة واحدة بسيط بصورة لطيفة
الخادم ملف تنفيذي أصلي (native) يضم واجهة سطر الأوامر وواجهة الويب الخاصة به؛ ويعرض مقاييس Prometheus وتكامل OpenTelemetry، ويدعم عدة وسائل نقل، ولا يحتاج إلى JVM ولا إلى خدمة بيانات وصفية منفصلة. فإذا كان ما أحتاجه سجل أحداث دائماً على خادم واحد قوي بتخزين NVMe محلي، فإن Iggy يقدم الكثير مقابل بنية تحتية قليلة نسبياً.
يمكن بالطبع تشغيل Kafka عنقوداً صغيراً، لكن نشر Kafka في الإنتاج يقوم على افتراض مختلف: الأجهزة تفشل، لذا فللـ partitions نسخ متكررة وللبيانات الوصفية للعنقود نصاب (quorum). وكل هذه الآلية الإضافية لها كلفة – وهي أيضاً ما يتيح لـ Kafka تحمل أعطال لا تستطيع عملية Iggy الواحدة تحملها. وعند مقارنة عمليات النشر، ضع في الحساب الجهد اللازم لإبقاء الخدمة متاحة بعد سقوط عقدة.
التكرار في 0.9.0
يوجد بالفعل في شيفرة الخادم الجديد تجميع متعدد العقد مبني على Viewstamped Replication (VSR). وفي أغسطس 2026 رُقّي server-ng ليصبح iggy-server الرئيسي، وبدأت تظهر إصدارات 0.9.0-edge. ويصف المشروع جانب الخادم بأنه مكتمل في معظمه: فتغييرات العرض (view changes) ونقل الحالة وإعادة توجيه القائد واستعادة جلسات العملاء ومصادقة العقد وTLS بين العقد والاختبار المحاكي الحتمي للأعطال والتأخيرات وإعادات التشغيل وانقسامات الشبكة كلها منفّذة – وتصف الأسئلة الشائعة التجميع بأنه ينضج نحو الجاهزية للإنتاج. وفي أي عملية نشر، تحقق من أن إصدار SDK الذي تختاره يدعم الخادم العنقودي وبروتوكول VSR السلكي.
ويحل إصدار 0.9.0 محل 0.8.0 ويتضمن الخادم العنقودي. ومع توفره، يمكن اختبار أعباء العمل المتكررة مقابل إصدار رسمي.
أما نموذج التكرار في Kafka فيعمل في الإنتاج منذ أكثر من عقد. لكل partition قائد (leader) ونسخ تابعة (followers):image
تنسخ النسخ التابعة سجل القائد، ويستخدم Kafka ISR لتتبع النسخ التي لحقت بالقائد عن قرب كاف، ويمكن ربط دلالات إشعار المنتِج بتلك المجموعة. وللمشغّلين إجراءات موثقة جيداً لأعطال النسخ وتغييرات ISR والاستعادة.
وتجري اختبارات المحاكاة الحتمية في Iggy تسلسلات أعطال قبل النشر. ومع ذلك أود الحصول على أدلة تشغيلية من أعباء عمل متكررة: أزمنة الاستعادة والترقيات المتدرجة وزمن الاستجابة أثناء لحاق النسخ.
النجاة من فقدان مركز بيانات
بعض الأنظمة يجب أن تنجو من فقدان مركز بيانات كامل. ويجب أن يأخذ وضع النسخ المتكررة ونصاب المتحكمات (controller quorums) هذا العطل في الحسبان.
إن إعداد broker.rack في Kafka غير مقتصر على رف خوادم مادي: فقيمته قد تمثل منطقة توافر (availability zone) أو نطاق عطل آخر، ويوزع وضع النسخ المتكررة في Kafka نسخ الـ partition على تلك النطاقات. ومع ثلاثة مراكز بيانات متقاربة، ونسخة واحدة من كل partition في كل منها، وacks=all، وmin.insync.replicas مناسب، يمكن لإشعار المنتِج أن يعتمد على نسخ خارج مركز البيانات المحلي. ويتضح كيف يختلف هذا عن التعافي من الكوارث غير المتزامن أكثر حين يُعرض جنباً إلى جنب:
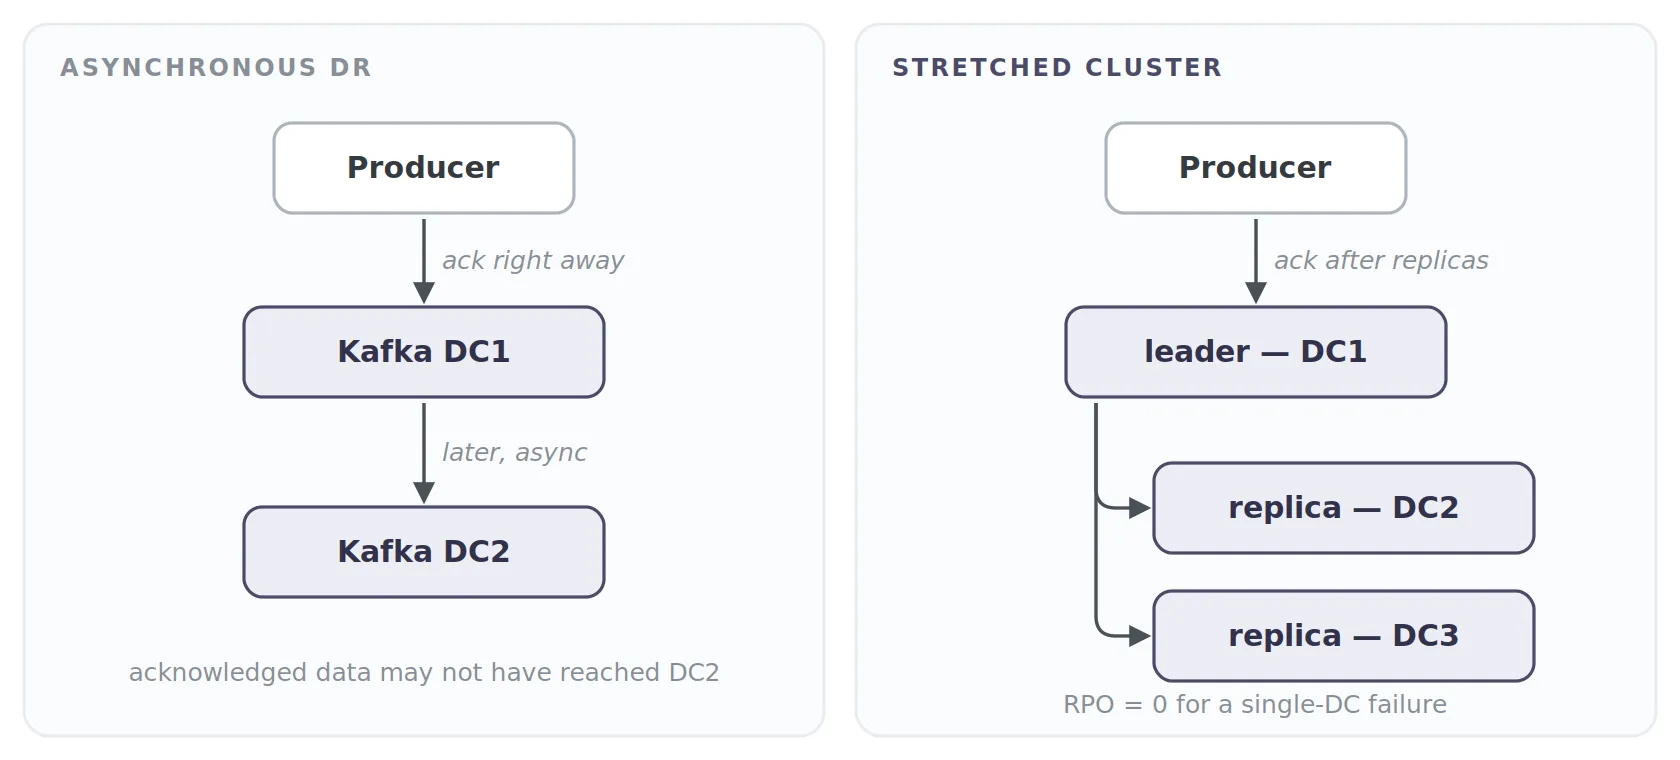
ومع التكرار غير المتزامن بين العناقيد مثل MirrorMaker 2، يمكن للمصدر أن يؤكد الرسائل قبل وصولها إلى العنقود الثاني. أما العنقود الممتد (stretched cluster) فيمكنه أن يشترط نسخة مؤكدة خارج مركز البيانات المحلي، على حساب زمن الكتابة بين مراكز البيانات. ويجب أن يدعم وضع النسخ المتكررة ونصاب المتحكم وإعدادات الاستعادة سيناريو العطل الذي تخطط له.
وإذا كان المتطلب عدم فقدان أي بيانات مؤكدة بعد عطل موقع كامل، فسأختار نشر Kafka مضبوطاً ومُختبَراً ليقدم ذلك بالضبط. فعمل Iggy في التجميع لا يقدم بعد إعداداً مماثلاً متعدد مراكز البيانات موثقاً للإنتاج.
وتشمل البنى الأكثر تفصيلاً العناقيد متعددة المناطق في Confluent Platform.
تبدو مجموعات المستهلكين أكثر ألفة بكثير
يقدم Iggy offsets للمستهلكين ومجموعات مستهلكين على جانب الخادم: يقتسم عدة مستهلكين في مجموعة partitions الـ topic بينهم، وتُعاد إسناد الـ partitions كلما انضم الأعضاء أو غادروا. ويستخدم Iggy إعادة موازنة تعاونية (cooperative rebalancing) بمرحلة سحب معلّق (pending-revocation)، فلا يلزم أن تنتقل الملكية فجأة بينما لا يزال المستهلك يُنهي عمله.
والنموذج الذهني يذكّر بقوة بـ Kafka:
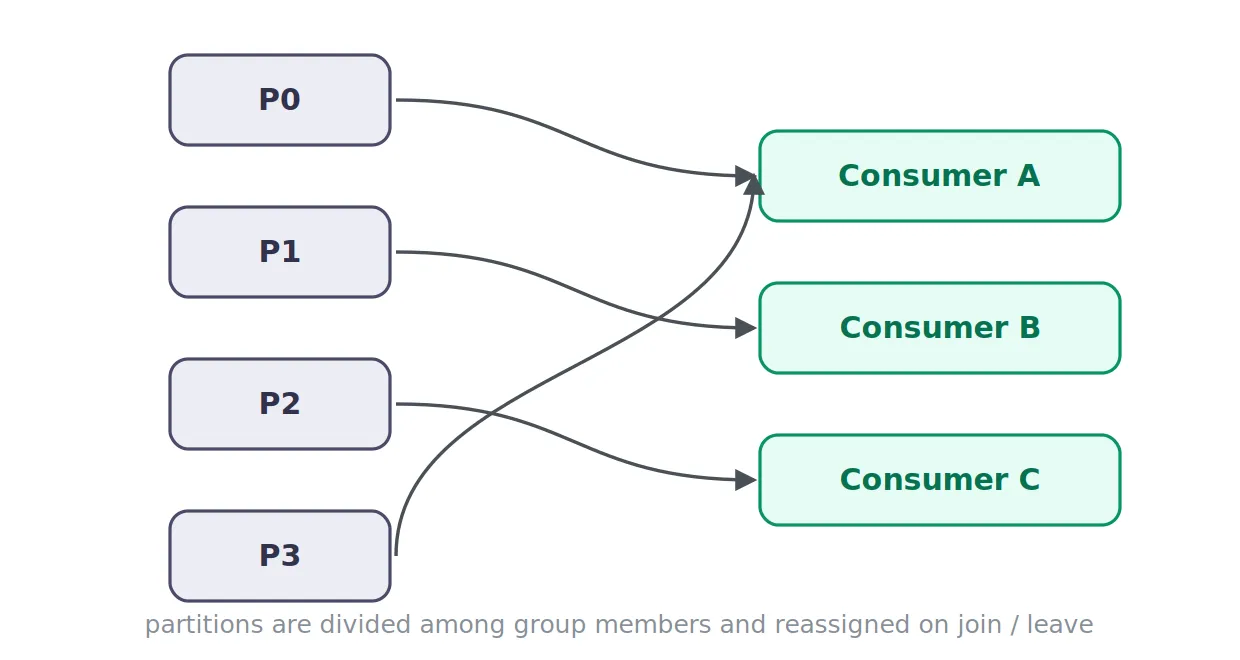
تنسق مجموعات المستهلكين من يملك أي partition مع تغير العضوية، فيستطيع المستهلكون اقتسام العمل بدلاً من أن يقرأ كل منهم الـ topic بأكمله.
الدلالة «مرة واحدة بالضبط» فرق أكبر بكثير
للمعالجة «مرة واحدة بالضبط» (exactly-once)، علينا تحديد العمليات التي يجب أن تُلتزم (commit) معاً.
يدعم Iggy الإدارة التلقائية أو اليدوية لـ offsets المستهلكين، إضافة إلى إزالة تكرار اختيارية للرسائل بناءً على معرّفات الرسائل. وتصوغ وثائقه exactly-once بوصفها إزالة تكرار على مستوى التطبيق، مع ذاكرة مؤقتة لإزالة التكرار على جانب الخادم تساعد في ترشيح المعرّفات المكررة. وقد يكون ذلك مفيداً، لكنه آلية مختلفة عن معاملات Kafka.
يدعم Kafka المنتِجين المتماثلين (idempotent) والمعاملات التي يمكنها الجمع ذرياً بين إنتاج السجلات والتزام offsets المستهلَكة. وهذا مهم لتطبيق استهلاك–معالجة–إنتاج:
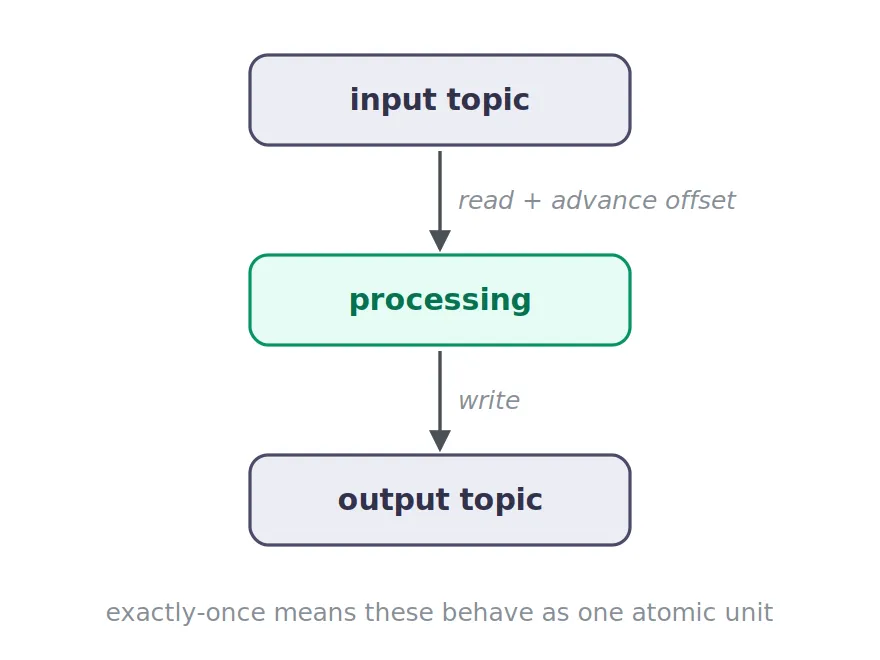
يمكن لمعاملة Kafka أن تلتزم سجلات المخرجات مع offsets المستهلَكة ذرياً. ويحتاج المستهلكون اللاحقون إلى read_committed لترشيح المخرجات الملغاة. أما استدعاءات HTTP الخارجية أو تحديثات قواعد البيانات فتقع خارج تلك المعاملة.
ويدفع Iggy بجزء أكبر من هذا التنسيق إلى التطبيق. وإذا كان التطبيق يعتمد على معاملات Kafka، فلا تستطيع إزالة التكرار بمعرّف الرسالة وحدها أن تحل محلها.
الضغط (compaction) فرق آخر
لا يقتصر الاحتفاظ في Kafka على إزالة البيانات القديمة بحسب العمر أو الحجم الكلي. فـالـ topic المضغوط يمكنه الاحتفاظ بأحدث قيمة لكل مفتاح:
user-1 -> Alice
user-2 -> Bob
user-1 -> Alice
وفي مرحلة ما إسقاط السجل الأقدم user-1 -> Alice، مع الاحتفاظ بتاريخ كاف لإعادة بناء الحالة الحالية. وتهم هذه القدرة topics سجل التغييرات (changelog) واستعادة حالة Kafka Streams ومجموعات البيانات على نمط CDC وتدفقات الإعدادات.
وتغطي وثائق التخزين الحالية في Iggy الاحتفاظ المبني على الزمن والحجم للمقاطع المغلقة؛ ولا يقدم في الوقت الحالي ما يعادل ضغط السجل المبني على المفاتيح في Kafka. وبالنسبة إلى تاريخ الأحداث المجرد فهذا غير ذي صلة. أما استخدام السجل مخزناً داعماً متيناً للحالة المتحققة (materialized) فهو أمر مهم.
رسائل Iggy تحصل على هوية خاصة بها
أقدّر أن نموذج السجل في Iggy يتضمن معرّف رسالة. ففي Kafka، الهوية الطبيعية للسجل هي عادةً الثلاثية (topic, partition, offset). أما رسائل Iggy فتحمل إضافة إلى ذلك معرّف رسالة من 128 بت، تستخدمه آلية إزالة التكرار الاختيارية ويوجد بصورة مستقلة عن موضع الرسالة الفعلي في الـ partition. وهو لا يحل محل دلالات المعاملات، لكنه عنصر أساسي مفيد أن يكون مدمجاً في نموذج الرسالة.
اختيار البروتوكول متعمد
لا يدعم Iggy حالياً بروتوكول Kafka. بل له بروتوكول ثنائي خاص به، متاح عبر TCP وQUIC وWebSocket، إضافة إلى واجهة HTTP منفصلة، وTCP هو المسار المقصود لأقل زمن استجابة. وهذا يتيح لفريق Iggy تطوير البروتوكول جنباً إلى جنب مع محرّك التخزين – فإصدار 0.8.0 مثلاً جلب إعادة كتابة كبرى ودمجاً لصيغته السلكية. ولا يستطيع Kafka فعل ذلك بسهولة، لأن بروتوكوله جزء من سطح توافق ضخم تعتمد عليه عملاء ومنتجات مكتوبة بلغات كثيرة.
يوفر Iggy حالياً SDKs بعدة لغات، لكن عميل Rust هو التنفيذ المرجعي، وتختلف تغطية الميزات من لغة إلى أخرى. ووكيل بروتوكول Kafka السلكي مدرج في خارطة طريق Iggy ويجري تطويره بحسب المشروع – وإن نضج فقد يربط منتِجي Kafka ومستهلكيه الحاليين بـ Iggy ويغير صورة الترحيل تغييراً كبيراً. وإلى أن يحدث ذلك، فإن الانتقال من Kafka إلى Iggy هو ترحيل تطبيقات لا مسألة استبدال وسطاء.
وينطبق الأمر نفسه على الموصّلات
لدى Iggy بالفعل بيئة تشغيل موصّلات خاصة به مع مصادر ومصارف (sources and sinks) لأنظمة مثل قواعد البيانات ومحركات البحث وتخزين الكائنات وIceberg. ولا يزال الترحيل يستدعي مقارنة الموصّلات واحداً واحداً مع Kafka Connect: فقد أتيحت للمورّدين والمشاريع مفتوحة المصدر سنوات للبناء حول واجهة Kafka وبروتوكوله، وهذا النطاق من التكاملات جزء من المنتج رغم أن أياً من الشيفرة لا يعيش في وسيط Kafka نفسه. راجع التشغيل وضمانات التسليم وسلوك الاستعادة لكل موصّل يعتمد عليه التطبيق.
فهل Iggy بديل لـ Kafka؟
لبعض أعباء العمل، ربما. أما لكل أعباء Kafka اليوم، فلا.
إذا كان ما تحتاجه سجل أحداث محلياً دائماً بزمن استجابة منخفض جداً ونشر مباشر وإنتاجية عالية على جهاز واحد، فإن Iggy خيار موثوق ومثير تقنياً. ويقدم الإصدار 0.9.0 أيضاً إصداراً رسمياً لتقييم عمليات النشر المتكررة. وتنفيذه يستحق الدراسة سواء انتهى بنا الأمر إلى نشره أم لا: فالتنفيذ بخيط لكل نواة وملكية الشظايا الصريحة وio_uring والوعي بـ NUMA وإدارة الذاكرة المخصصة تُظهر كيف يمكن أن يبدو سجل بث حين يُبنى من الصفر على Linux الحديث، متحرراً من قيود التوافق.
وبالنسبة إلى تطبيق Kafka قائم، سأتحقق مما إذا كان يعتمد على:
- المعاملات والتزام offsets الذري؛
- ضغط السجل المبني على المفاتيح؛
- مكتبات العملاء والموصّلات؛
- الترقيات المتدرجة وإجراءات الاستعادة؛
- التوافر متعدد مراكز البيانات وضمانات عدم فقدان البيانات.
يمكن لهذه المتطلبات أن تستبعد الترحيل قبل أن تدخل الإنتاجية في الحسبان أصلاً.
ما الذي سأختبره لاحقاً
بعد ذلك، سأضع مسار التكرار في Iggy تحت الحمل: أوقف عقدة في منتصف الكتابة، وأقطع الاتصال بين النسخ، وأقيس زمن الاستعادة وزمن الذيل. ثم أتأكد من الرسائل المؤكدة التي تنجو بالإعداد المختار.
وبالنسبة إلى ترحيل Kafka، سأشغّل سير عمل التطبيق نفسه على النظامين، بما في ذلك إعادة المحاولات وإعادة تشغيل المستهلكين. وسيكشف ذلك ما إذا كان Iggy يفي بضمانات عبء العمل بزمن استجابة وكلفة تشغيلية مقبولين.