Kafka بلا أقراص: ماذا يتغير حين لا تعود البيانات ملكًا للوسطاء؟
نظرة على معماريات Kafka بلا أقراص، تقارن كيف تتعامل KIP-1150 وWarpStream وAutoMQ وRedpanda مع إبقاء السجل النشط لـ Kafka في تخزين الكائنات.
بُني Apache Kafka للاستفادة الكاملة من الإدخال والإخراج المتسلسل. يجمّع المنتجون السجلات في دفعات، ويلحق الوسطاء هذه الدفعات بمقاطع سجل مرتبة، ويقرأ المستهلكون نطاقات متصلة. كما يعتمد Kafka على ذاكرة التخزين المؤقت للصفحات في نظام التشغيل، وحيثما أمكن على تقنيات النسخ الصفري مثل sendfile. وكما توضح وثائق تصميم Kafka، يعمل هذا لأن التجميع في دفعات يحوّل كثيرًا من العمليات الصغيرة إلى عمليات قراءة وكتابة متسلسلة أكبر تتعامل معها أجهزة التخزين وأنظمة التشغيل بكفاءة.
توفر السحابة خيار تخزين آخر. فمخزن الكائنات يقدم تخزينًا متينًا ومتماثلًا مستقلًا عن حوسبة الوسطاء. فهل يمكن لـ Kafka استخدام خدمة كهذه للسجل النشط، بما يتيح للوسطاء التوسع دون الحاجة إلى نقل مجموعة البيانات المتينة؟
هذا هو المفهوم وراء Kafka بلا أقراص: الإبقاء على واجهة Kafka البرمجية للعملاء مع إخراج تخزين الحمولة المتين من سجلات الأقسام التي يملكها الوسطاء. ولا يزال على التنفيذ أن يحافظ على الترتيب، ويسند الإزاحات، ويتتبع الكتابات المثبَّتة، ويخدم القراءات بكفاءة. ويوزع كل نظام هذه المسؤوليات بطريقته، وتختلف تغطيته للميزات.
حالة المشروع الأصلي، 25 أغسطس 2026: قُبلت KIP-1150، لكن المواضيع بلا أقراص (Diskless Topics) الأصلية لم تُتح بعد للجميع في Apache Kafka. وما زالت KIP-1163 وKIP-1164، اللتان تحددان التنفيذ الأساسي، قيد النقاش.
كيف يرتبط الوسيط بالسجل
في Kafka التقليدي، يتلقى قائد القسم السجلات ويسند لها إزاحات ويلحق الدفعات بمقاطع السجل المحلية. ويجلب التابعون من القائد ويلحقون الدفعات نفسها بتخزينهم الخاص. ومع acks=all، لا يحصل المنتج على إقرار ناجح إلا بعد حدوث النسخ المتماثل المطلوب.
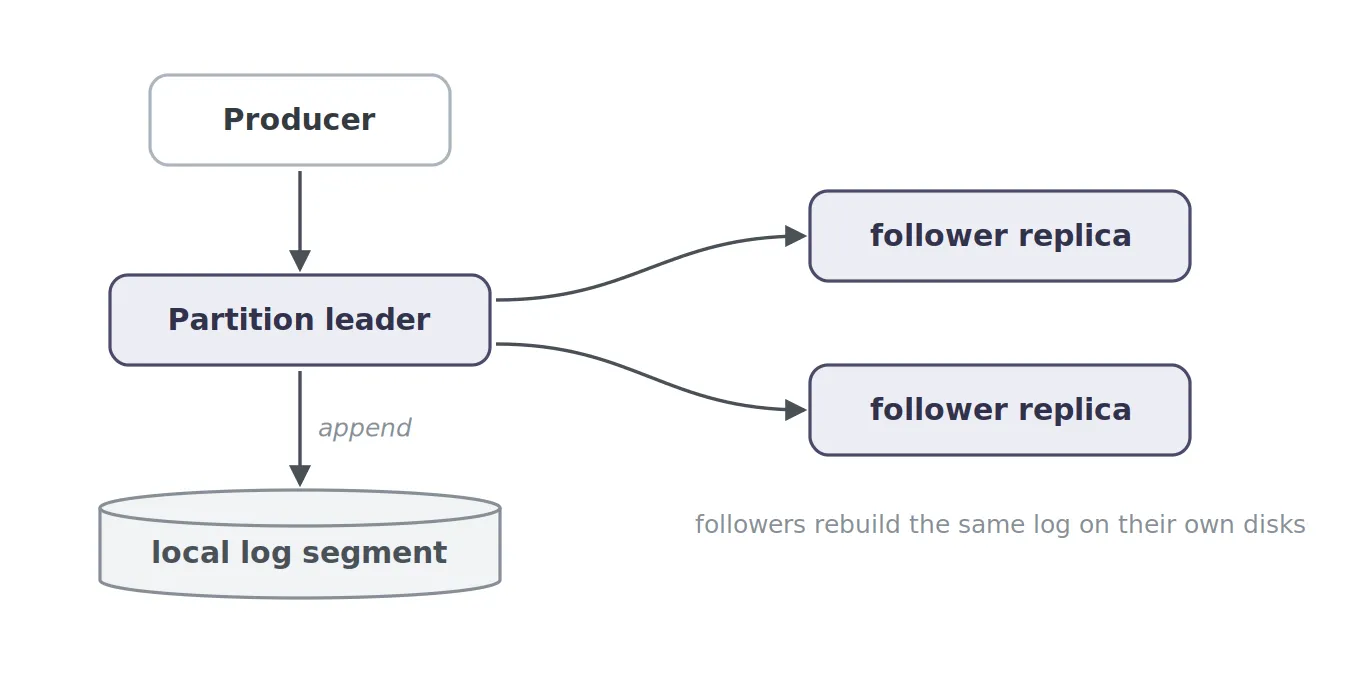
يخفض التجميع في دفعات عبء الشبكة واستدعاءات النظام، وتستطيع ذاكرة التخزين المؤقت للصفحات خدمة البيانات الحديثة دون القراءة من القرص الفعلي. ونتيجة لذلك يكون الوسيط مسؤولًا عن معالجة أقسامه وعن مقاطع سجلها المحلية وحالة النسخ المتماثلة. ولذلك فإن نقل الأقسام إلى مكان آخر يعني في أحيان كثيرة نقل بياناتها أيضًا.
السحابة غيّرت معادلة التخزين
تخيّل عنقودًا يمتد عبر ثلاث مناطق توافر. يخزّن القائد كل سجل، ويُنسخ إلى التابعين الموجودين في المناطق الأخرى:
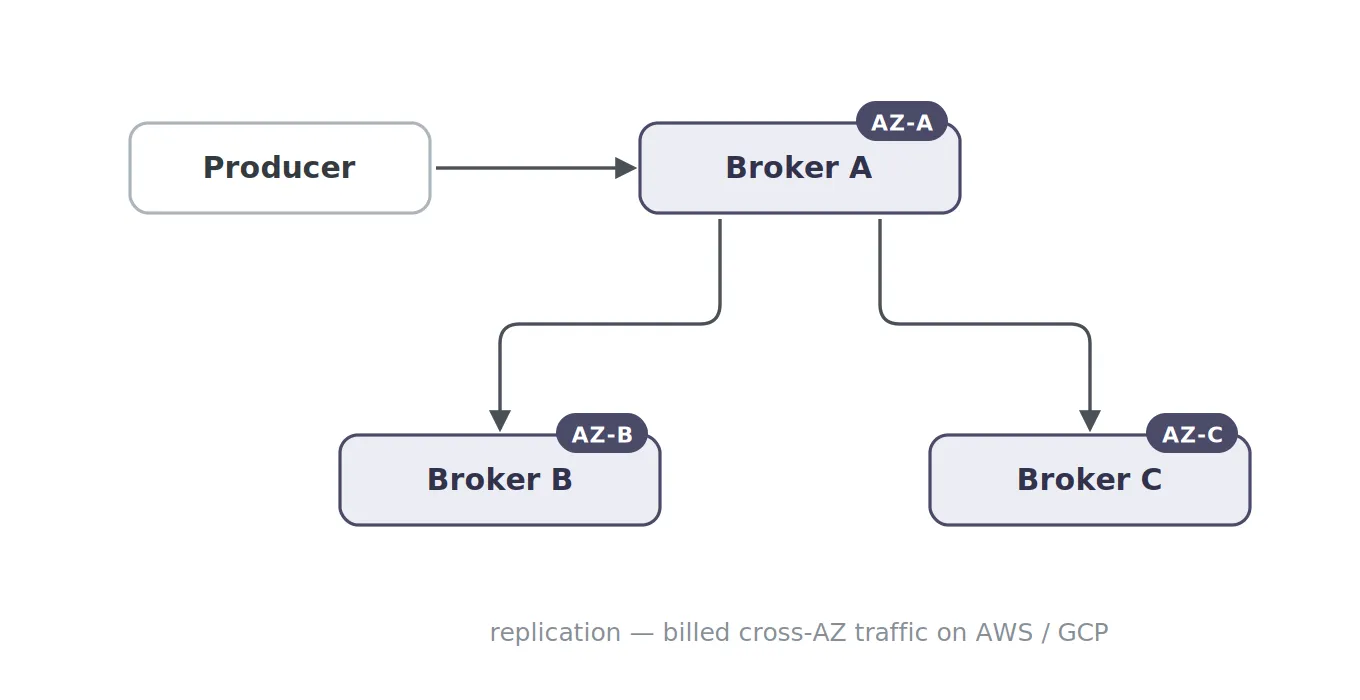
يتيح النسخ عبر المناطق لـ Kafka النجاة من أعطال المناطق، شريطة أن يكون توزيع النسخ المتماثلة وإعدادات الإقرار مهيأة لذلك. كما يمكن أن يولّد قدرًا كبيرًا من حركة البيانات بين مناطق التوافر، وهو ما تسميه KIP-1150 مصدرًا رئيسيًا للتكلفة على AWS وGoogle Cloud. وتختلف الاقتصاديات الدقيقة بحسب المزوّد وإعداد الشبكة؛ ونسخ الحمولة ليس سوى مكوّن واحد من فاتورة الحركة الإجمالية.
ويحتاج كل وسيط كذلك إلى تخزين كافٍ للأقسام المسندة إليه. وقد تتضمن زيادة السعة إعادة إسناد الأقسام، كما أن استبدال نسخة متماثلة مفقودة يعني نسخ بياناتها. والوسيط الذي يحمل تيرابايتات من حالة الأقسام يستغرق استبداله وقتًا أطول من عامل تُحفظ حالته المتينة في مكان آخر. وبذلك تحدّ سعة التخزين وحركة البيانات من سرعة تغيير الحوسبة.
تقدّم Amazon S3 وGoogle Cloud Storage وAzure Blob Storage تخزينًا متينًا لا يعتمد على وسطاء Kafka. ومع فئة تخزين إقليمية مناسبة، يتولى المزوّد أيضًا النسخ المتماثل عبر نطاقات الأعطال. والمقارنة ذات المعنى هي بين خدمة كهذه ومسار التخزين المتماثل الكامل في Kafka. فـ EBS وحده ينسخ داخل منطقة توافر واحدة؛ أما نسخ Kafka المتماثلة فيمكنها مدّ هذه الحماية عبر المناطق.
تقترح KIP-1150 تسليم متانة الحمولة إلى تخزين الكائنات لخفض تكلفة نسخ المقاطع النشطة وتكلفة تخزين الكتل للوسطاء. والذي يتغير هو من يتولى مسؤولية النسخ المتماثل، وأي بيانات لا تزال بحاجة إلى المرور عبر آليات التنسيق في Kafka.
Kafka بلا أقراص مقابل التخزين متعدد الطبقات
يستخدم Kafka تخزين الكائنات بالفعل عبر التخزين متعدد الطبقات (Tiered Storage). إذ يمكن نسخ مقاطع السجل المنتهية إلى تخزين بعيد ثم حذفها من الطبقة المحلية. أما المقطع النشط فلا يزال على تخزين الوسيط، ولا يزال التابعون ينسخون السجلات الواردة.
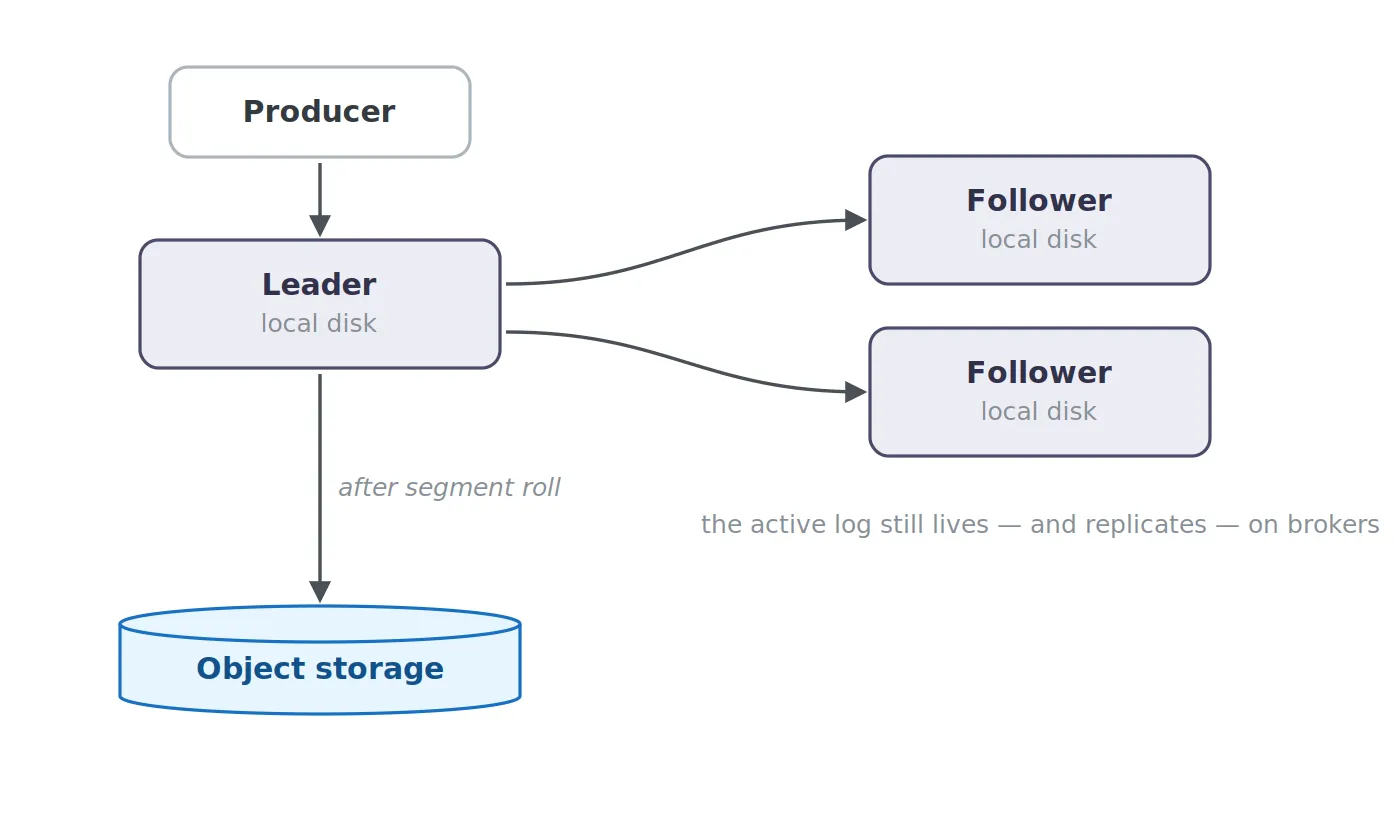
يفصل التخزين متعدد الطبقات الاحتفاظ بالبيانات عن سعة القرص المحلي، بحيث يمكن للعنقود الاحتفاظ بتاريخ أشهر دون تحديد أحجام أقراص الوسطاء لمجموعة البيانات كلها. أما التخزين بلا أقراص فيذهب أبعد ويغيّر مسار الكتابة النشط أيضًا:
| Kafka التقليدي | Kafka مع التخزين متعدد الطبقات | مسار بلا أقراص مباشر إلى تخزين الكائنات | |
|---|---|---|---|
| الحمولة النشطة | سجلات على الوسطاء | سجلات على الوسطاء | كائنات مشتركة |
| نسخ الحمولة | تابعو Kafka | تابعو Kafka | مزوّد التخزين |
| الحمولة التاريخية | سجلات على الوسطاء | مقاطع بعيدة مع طبقة محلية | كائنات مشتركة، كثيرًا ما يُعاد تنظيمها للقراءة |
| يعتمد إقرار المنتج على | إلحاق الوسيط والإقرارات المهيأة | المسار النشط نفسه كما في Kafka التقليدي | حفظ الكائن وتثبيت البيانات الوصفية |
تضع بعض الأنظمة WAL منفصلًا أمام مجموعة بيانات تخزين الكائنات. وفي هذه التصاميم يقرر الـ WAL متى يجوز إقرار الكتابة؛ وسنتناول AutoMQ أدناه.
ما معنى «بلا أقراص»
المصطلح مضلل بعض الشيء. فلا يعني «بلا أقراص» بالضرورة غياب أي قرص في النظام؛ بل معناه أضيق: لم يعد القرص المحلي للوسيط المصدر الأساسي المتين لحقيقة بيانات المستخدم. وتصوغ KIP-1150 ذلك جيدًا: فعبارة «بلا أقراص» ترتبط بـ«لا أقراص» تقريبًا كما ترتبط «بلا خوادم» بـ«لا خوادم». قد تبقى الأقراص موجودة للتخزين المؤقت أو البيانات الوصفية أو الحالة المؤقتة، لكنها لم تعد تجريد التخزين الذي على المشغّلين إدارته لحمولة الرسائل نفسها.
إليك مسار كتابة مبسّط بلا أقراص:
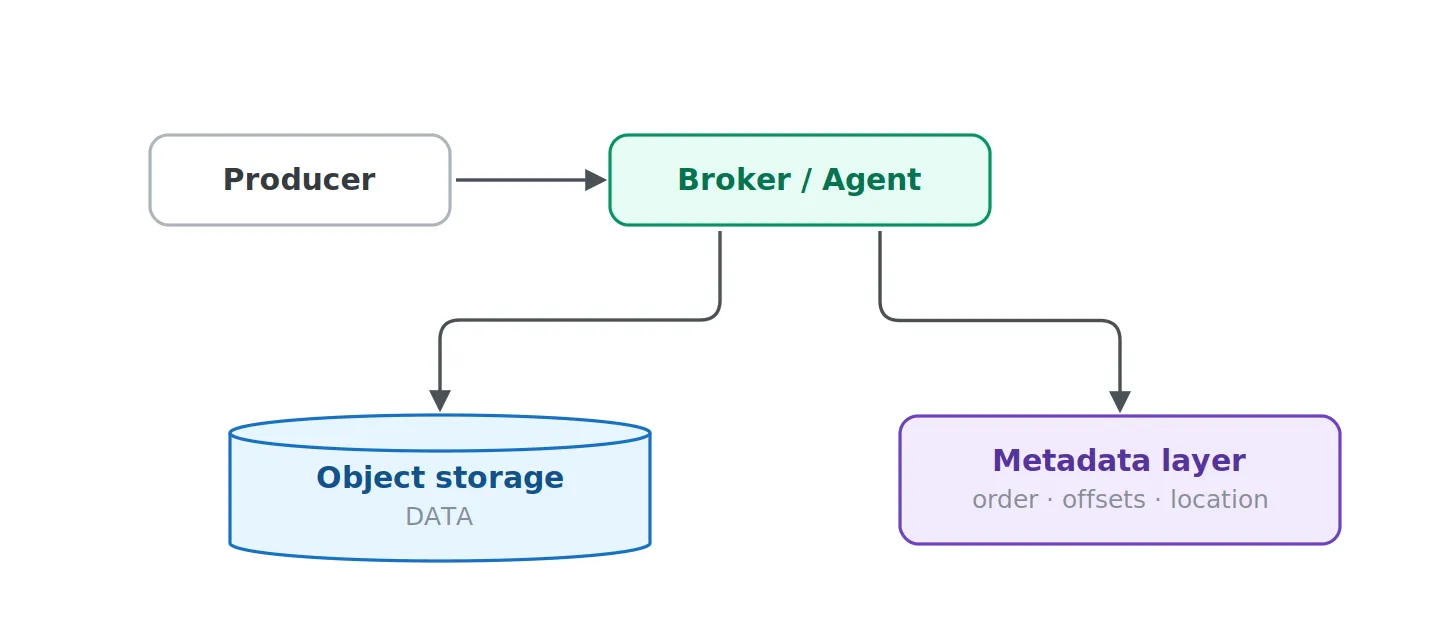
يخزّن Kafka التقليدي الحمولات مع ترتيبها في سجلات الأقسام. أما الأنظمة بلا أقراص فتفصل بينهما: يحتفظ تخزين الكائنات بالبايتات، وتحدد البيانات الوصفية ترتيبها وإزاحاتها وحالة تثبيتها.
S3 ليس سجل Kafka
للوهلة الأولى يبدو وضع Kafka فوق تخزين الكائنات أمرًا تافهًا: خذ سجلًا واكتبه في S3 وانتهى الأمر. لكن هذا، للأسف، سيجعل معمارية البث سيئة. فمخازن الكائنات محسّنة للكائنات لا للسجلات القابلة للإلحاق – عادةً تنشئ كائنات غير قابلة للتغيير وتجلبها لاحقًا – وتأتي عملياتها بزمن استجابة غير هيّن وتكلفة لكل طلب.
كتابة كائن S3 منفصل لكل سجل Kafka ستصبح مكلفة جدًا بسرعة عند الإنتاجية العالية. وكائن لكل دفعة منتج؟ لا تزال كائنات كثيرة جدًا. وكائن لكل قسم كل بضع مئات من الملّي ثانية؟ عندها يبدأ عنقود فيه عشرات الآلاف من الأقسام بإنتاج حجم مزعج من الكائنات الصغيرة وعمليات PUT.
ما يفضله تخزين الكائنات:
FEWER
LARGER
OBJECTS
ما يفضله Kafka:
MANY
INDEPENDENT
ORDERED PARTITIONS
يصبح البث بلا أقراص مثيرًا للاهتمام تحديدًا في التوفيق بين هاتين المجموعتين من الاحتياجات.
كيف يجمّع Kafka بلا أقراص الدفعات عبر الأقسام
تصل معظم معماريات Kafka بلا أقراص إلى التحسين الأولي نفسه: بدلًا من إنشاء كائن لكل قسم، تُجمَّع بيانات أقسام كثيرة معًا.
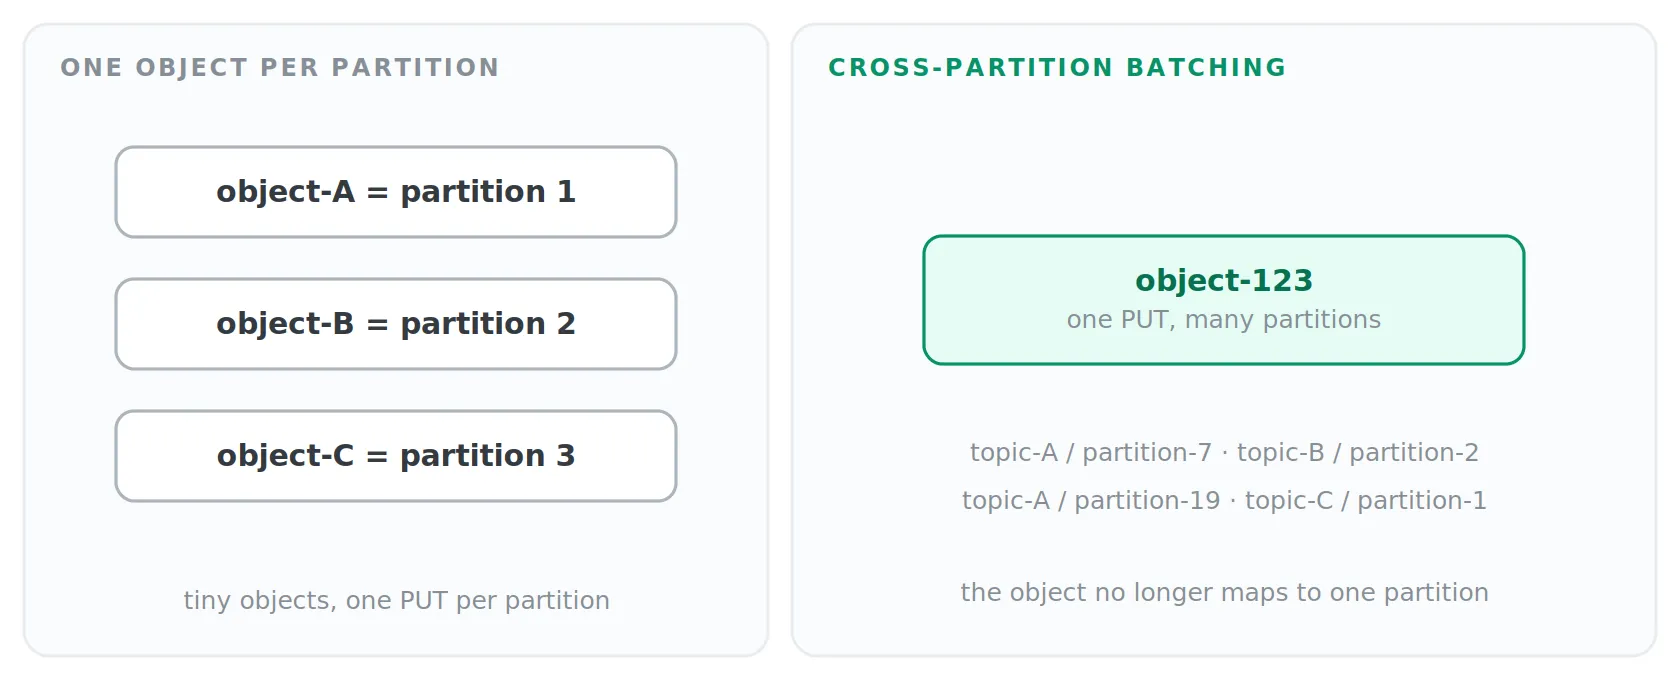
توضح WarpStream ذلك جيدًا. تخزّن وكلاؤها (Agents) حركة المنتجين القادمة من عملاء وأقسام كثيرة مؤقتًا وتفرغها عند بلوغ عتبة زمنية أو حجمية؛ وافتراضيًا تبلغ مهلة الدفعة حاليًا 250 ms. ولتوخي الدقة بشأن معنى هذا الرقم: إنه أقصى وقت ينتظره الوكيل لامتلاء الدفعة، وليس زمن الكتابة المتينة – ففي ظل حمل حقيقي تُبلغ عتبة الحجم عادةً أولًا، كما أن إقرار المنتج عليه أيضًا انتظار رفع الكائن إلى تخزين الكائنات وتثبيت البيانات الوصفية. والـ 250 ms جزء واحد من ميزانية زمن استجابة سنعود إليها لاحقًا في المقال.
قد يحمل ملف واحد سجلات من أقسام مواضيع مختلفة كثيرة. يُحفظ الكائن أولًا، ثم تُثبَّت بياناته الوصفية، وبعد ذلك فقط يُقَرّ طلب الإنتاج. وتتبع تنفيذ Aiven للتخزين بلا أقراص الفكرة العامة نفسها، وتجمّع مواضيع Redpanda السحابية (Cloud Topics) البيانات عبر المواضيع والأقسام فيما يسمى كائنات L0 – «المستوى صفر»، وهو اسم مأخوذ من محركات تخزين أشجار LSM للملفات الخام الحديثة الإدخال – قبل تخزين بيانات وصفية خفيفة في Raft. تذكّر هذا المصطلح؛ فالمستويات ستظهر مجددًا.
وصلت فرق عدة إلى هذا التصميم بمفردها لأن التجميع عبر الأقسام يوزع تكلفة عملية تخزين الكائنات على قدر جدير بالاهتمام من البيانات. والجانب السلبي هو أن الكائن الفعلي لم يعد يقابل قسم Kafka بدقة.
السجل الفعلي لـ Kafka اختفى للتو
في Kafka التقليدي، يحتوي partition-7.log سجلات القسم 7 بالترتيب. فتخطيط التخزين الفعلي وسجل Kafka المنطقي مرتبطان ارتباطًا وثيقًا. انظر الآن إلى كائننا بلا أقراص:
object-123

P7 | P2 | P19 | P1 | P7
وإلى وسيط آخر يكتب في الوقت نفسه:
object-124

P1 | P7 | P5 | P19
أي دفعة P7 هي الأولى؟ لا تخبرنا أسماء الكائنات، ولا يكفي وقت اكتمال الرفع، ولا يخبرنا الكائن نفسه أيضًا. يحتفظ تخزين الكائنات بالبايتات، لكن تجريد Kafka يتطلب أكثر: الموضوع والقسم والإزاحة والترتيب. لذلك يحتاج النظام بلا أقراص إلى بنية إضافية تربط السجل المنطقي بالتخزين الفعلي – تقريبًا على هذا النحو:
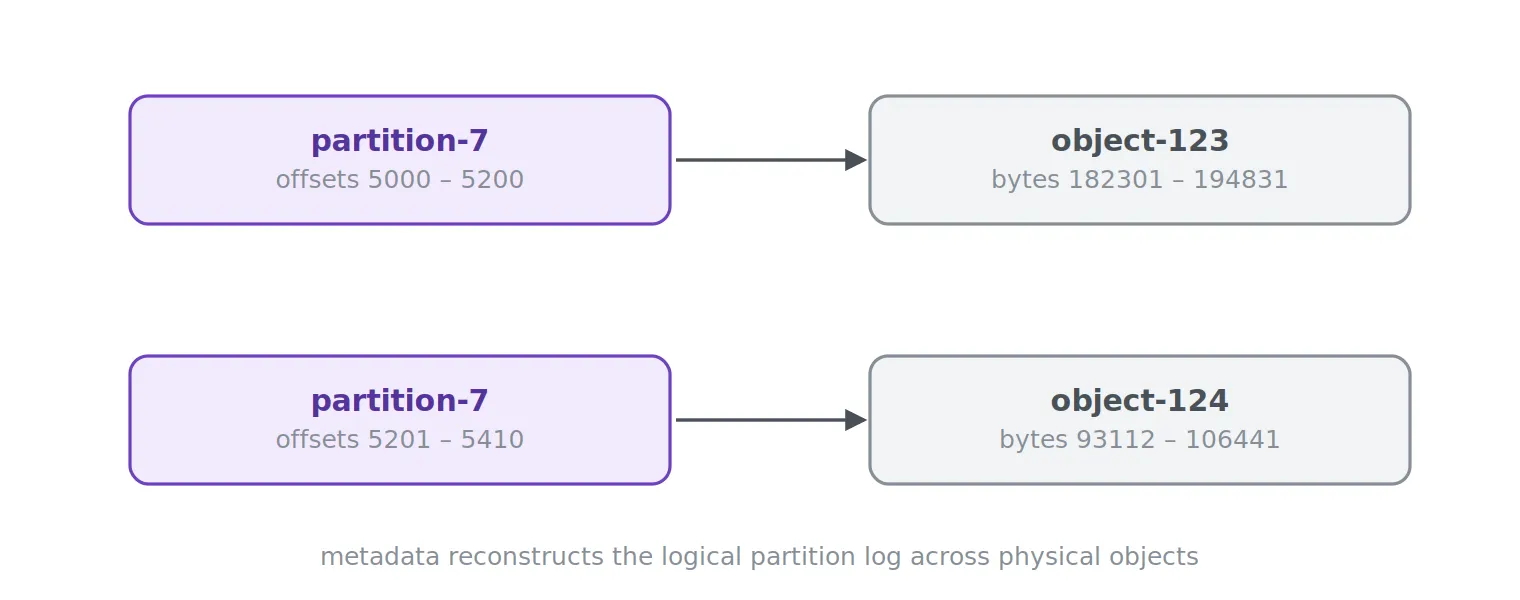
بعد إزالة سجل القسم الفعلي، علينا الآن إعادة بناء سجل قسم منطقي من البيانات الوصفية. لاحظ ما نبنيه فعلًا هنا: سجل موجود حصرًا كبيانات وصفية متسقة بقوة فوق كائنات مشتركة – أي قاعدة بيانات موزعة تتحدث بروتوكول Kafka.
البيانات الوصفية تحدد السجل المثبَّت
الترتيب بيانات وصفية. وإسناد الإزاحات بيانات وصفية. والربط بين الإزاحات ومواقع الكائنات بيانات وصفية. تتطلب المعاملات بيانات وصفية، وتتطلب المنتجات متساوية الأثر (idempotent) حالة، ويغيّر الاحتفاظ البيانات الوصفية في النهاية، ويغيّرها الضغط (compaction)، ويعتمد جمع المهملات على كل ما سبق. يمكن لتنفيذ Kafka بلا أقراص أن يسلّم نسخ حمولات الرسائل إلى S3، لكنه لا يستطيع تسليم دلالات Kafka إلى S3. وبعبارة أخرى، لا يلغي Kafka بلا أقراص الإجماع (consensus) – بل ينقله إلى مكان آخر. قد تنتقل متانة الحمولة إلى تخزين الكائنات، لكن النظام لا يزال بحاجة إلى مكان متسق بقوة يقرر ما يوجد عند كل إزاحة وأي الكتابات مثبَّتة.
يبرز هنا اعتراض معقول: أليست طبقة البيانات الوصفية مجرد مشكلة النسخ المتماثل الأصلية في ثوب جديد؟ جزئيًا، نعم – ولا يدّعي أي من هذه التصاميم خلاف ذلك. فمخزن البيانات الوصفية نظام متماثل ومتسق بقوة بحد ذاته، ويعالج تثبيتًا لكل دفعة، لذلك يبقى عدد عمليات التنسيق كما هو. ما يختلف هو محتوى كل عملية: سجل بحجم مؤشر يصف كائنًا ونطاقات إزاحاته بدلًا من الحمولة. تُحتسب حركة البيانات بين المناطق لكل بايت لا لكل عملية، لذا فإن تقليص الوحدة المنسوخة من ميغابايتات من السجلات إلى مُدخل بيانات وصفية واحد هو بالضبط مصدر التوفير – ويبقي التجميع عبر الأقسام معدل التثبيت مرتبطًا بالدفعات لا بالسجلات الفردية. لا يتجنب Kafka بلا أقراص النسخ المتماثل؛ بل يحصره في البيانات الصغيرة التي تتطلب إجماعًا حقًا. وفي موضع لاحق من هذا المقال يصل اقتراح Apache Kafka نفسه إلى الاستنتاج ذاته: إذ يخزّن منسّق التخزين بلا أقراص حالته في موضوع Kafka داخلي متماثل.
تنفيذات مختلفة، حدود مختلفة
أصبح «Kafka بلا أقراص» فئة وليس معمارية واحدة بعينها. تنقل كل التنفيذات أدناه الحمولة خارج سجل Kafka المحلي المتماثل التقليدي، لكنها تحتفظ بقدر متفاوت من الحالة في الوسطاء وتضيف مسارات بيانات وصفية مختلفة.
| النظام | مسار الحمولة المتين | مسار الترتيب / البيانات الوصفية | نموذج الوسيط |
|---|---|---|---|
| WarpStream | مباشرة إلى تخزين الكائنات | مخزن بيانات وصفية مخصص ومتسق بقوة | وكلاء بلا حالة |
| AutoMQ | WAL أولًا، ثم تخزين الكائنات | S3Stream / بيانات Kafka الوصفية | وسطاء بلا حالة |
| مواضيع Redpanda السحابية | تخزين الكائنات | عناصر نائبة Raft لكل قسم مع مخزن بيانات وصفية مشترك | بيانات وصفية ذات حالة، والحمولة في السحابة |
| Confluent Freight | كتابات مباشرة إلى تخزين الكائنات | البنية الداخلية لـ Kora | تنفيذ مُدار |
| Aiven Diskless | تخزين الكائنات | Batch Coordinator | مسار بيانات بلا قائد |
| اقتراح Apache Kafka (KIP-1163) | مقاطع WAL في تخزين الكائنات، تُدمج لاحقًا في كائنات | منسّق Diskless Coordinator المقترح | نموذج مواضيع هجين مخطط له |
WarpStream: الكتابة مباشرة إلى تخزين الكائنات
يمكن القول إن WarpStream تنفذ الفكرة في أنقى صورها. فوكلاؤها المتوافقون مع Kafka لا يحتاجون أقراصًا محلية: بل يكتبون مباشرة إلى تخزين الكائنات، وتُحفظ البيانات الوصفية في طبقة البيانات الوصفية المنفصلة لدى WarpStream. وبما أنه لا يملك أي وكيل بيانات أقسام متينة، يمكن إضافة عقد الحوسبة أو إزالتها دون نقل السجل المخزّن.
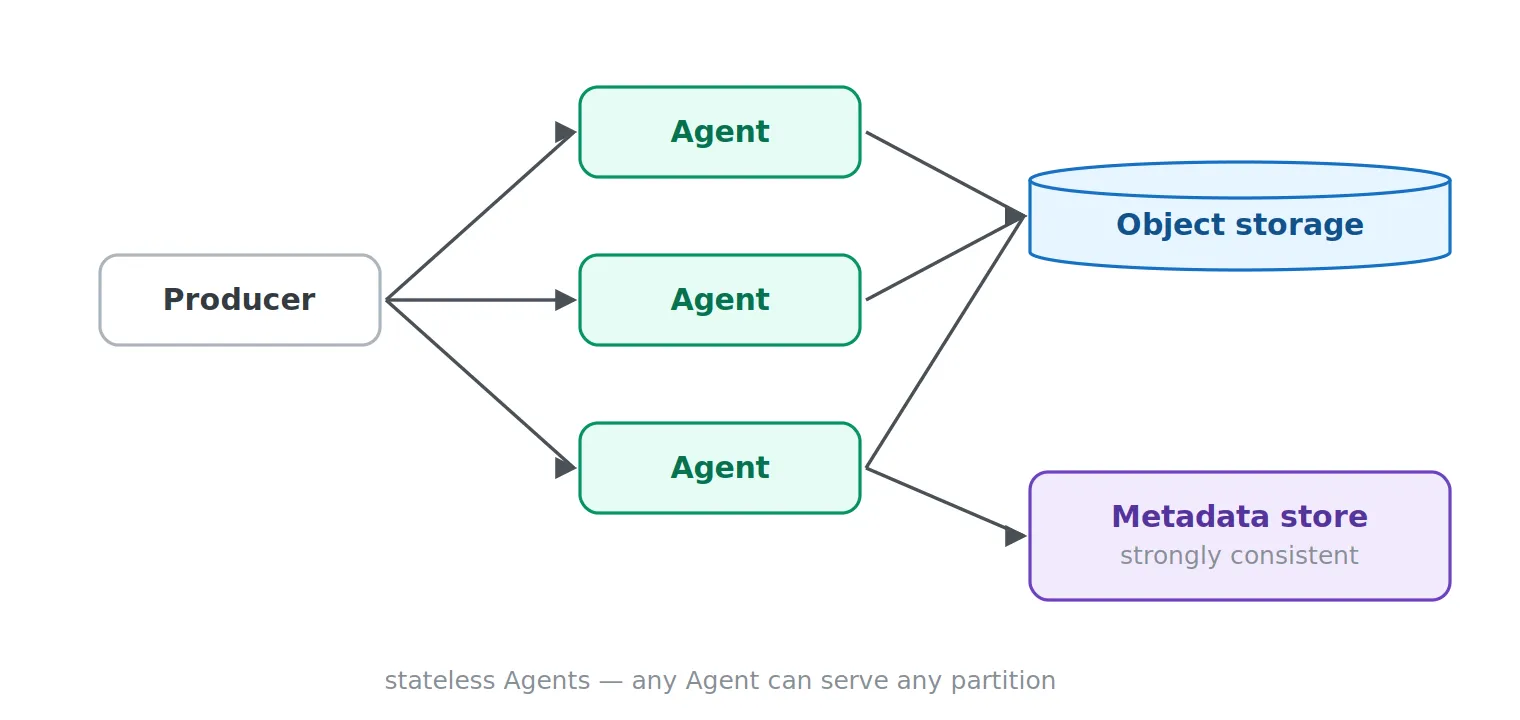
يستطيع كل وكيل خدمة كل قسم، وهذا يكسر الصلة المعتادة بين ملكية القسم والتخزين المتين. والمقايضة بسيطة بالقدر نفسه: تخزين الكائنات جزء من مسار الإقرار، لذا يصبح زمن الاستجابة واقتصاديات طلبات مخزن الكائنات قيودًا تصميمية أساسية. وتصف WarpStream المعمارية في دليلَي مسار الكتابة ومسار القراءة.
AutoMQ: إضافة WAL
تختار AutoMQ حلًا وسطًا مختلفًا. فهي تقبل أن يحتفظ تخزين الكائنات بمجموعة البيانات الفعلية، لكنها تضيف WAL لتسريع الحفظ والاسترداد:
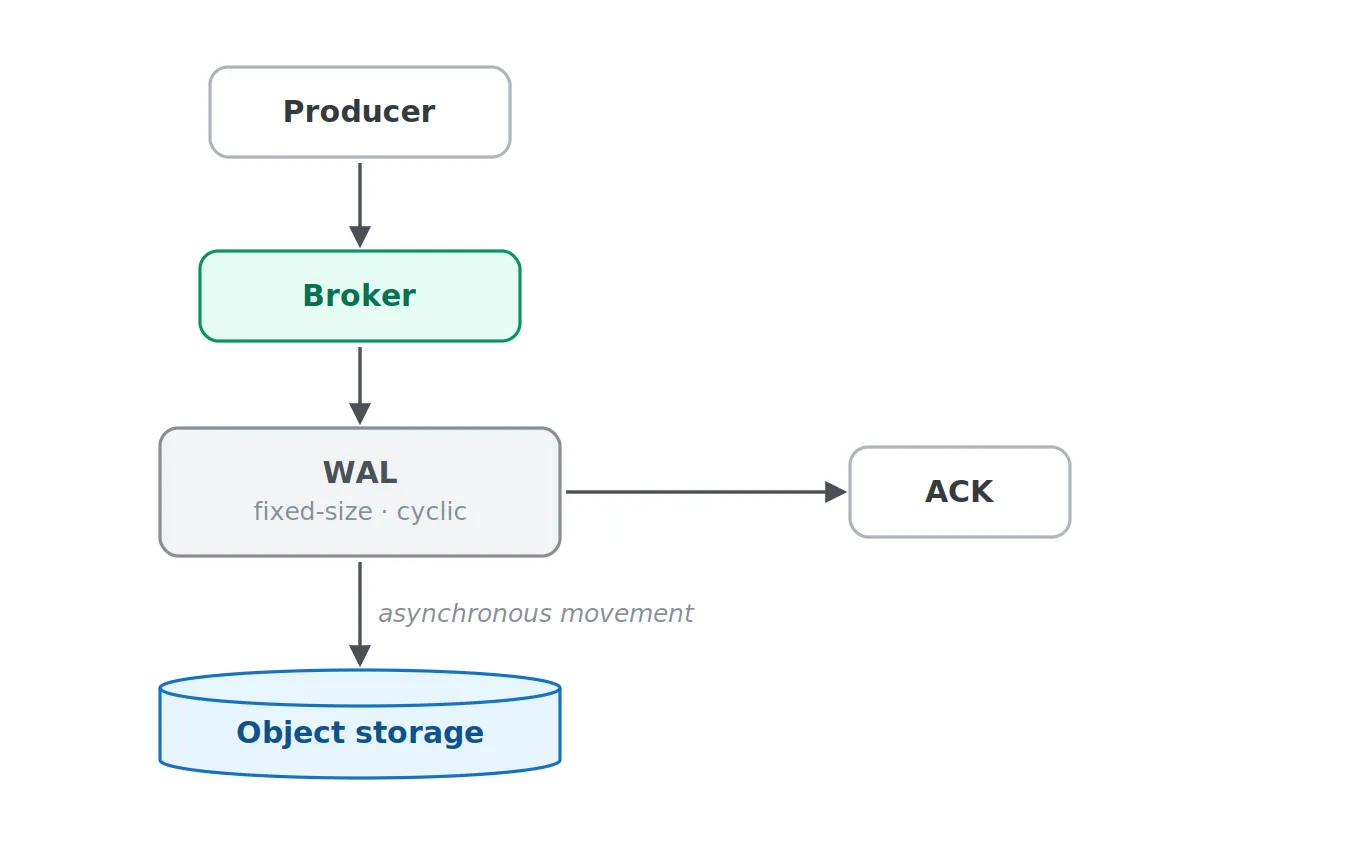
والمثير للاهتمام أن الـ WAL مشترك بين كتابات أقسام كثيرة بدلًا من الحفاظ على بنية السجل التقليدية لكل قسم في Kafka. ووفق AutoMQ، فهو ثابت الحجم ودوري، ويستخدم كتابات متسلسلة وتثبيتات جماعية. أي أنه حتى بعد ابتعاد Kafka عن سجلات الأقسام التي يملكها الوسطاء، يعود التحسين نفسه للظهور في طبقة مختلفة. فتخزين الكائنات يغيّر موقع مجموعة البيانات المتينة؛ لكنه لا يلغي فوائد الإدخال والإخراج المتسلسل.
السؤال التالي البديهي هو كيف يُنسخ الـ WAL نفسه – والجواب أن AutoMQ لا تنسخه عمدًا. فمبدؤها التصميمي المعلن هو الاعتماد على التخزين السحابي للمتانة بدلًا من تشغيل بروتوكول نسخ مثل Raft: ففي حالة WAL مدعوم بـ EBS، تأتي المتانة من النسخ المدمج في الوحدة، وإذا تعطل وسيط فإن وحدته اليتيمة تُرفق ببساطة بوسيط آخر يفرغ مُدخلات الـ WAL المعلقة إلى S3؛ وفي حالة WAL مدعوم بـ S3 (الافتراضي في المصدر المفتوح)، تكون كائنات الـ WAL موجودة أصلًا في تخزين الكائنات، فيستردها الوسيط الجديد مباشرة. تستخدم AutoMQ الإجماع بالفعل – لكن في المكان نفسه الذي تستخدمه كل الأنظمة الأخرى في هذا المقال: مستوى البيانات الوصفية، حيث تعيد AutoMQ استخدام KRaft من Kafka.
مواضيع Redpanda السحابية: الإبقاء على بيانات Raft الوصفية لكل قسم
تتبع Redpanda نهجًا هجينًا تسميه «disk-lite»: تهبط الحمولات في تخزين الكائنات، بينما تمر البيانات الوصفية الحرجة عبر Raft محلي.
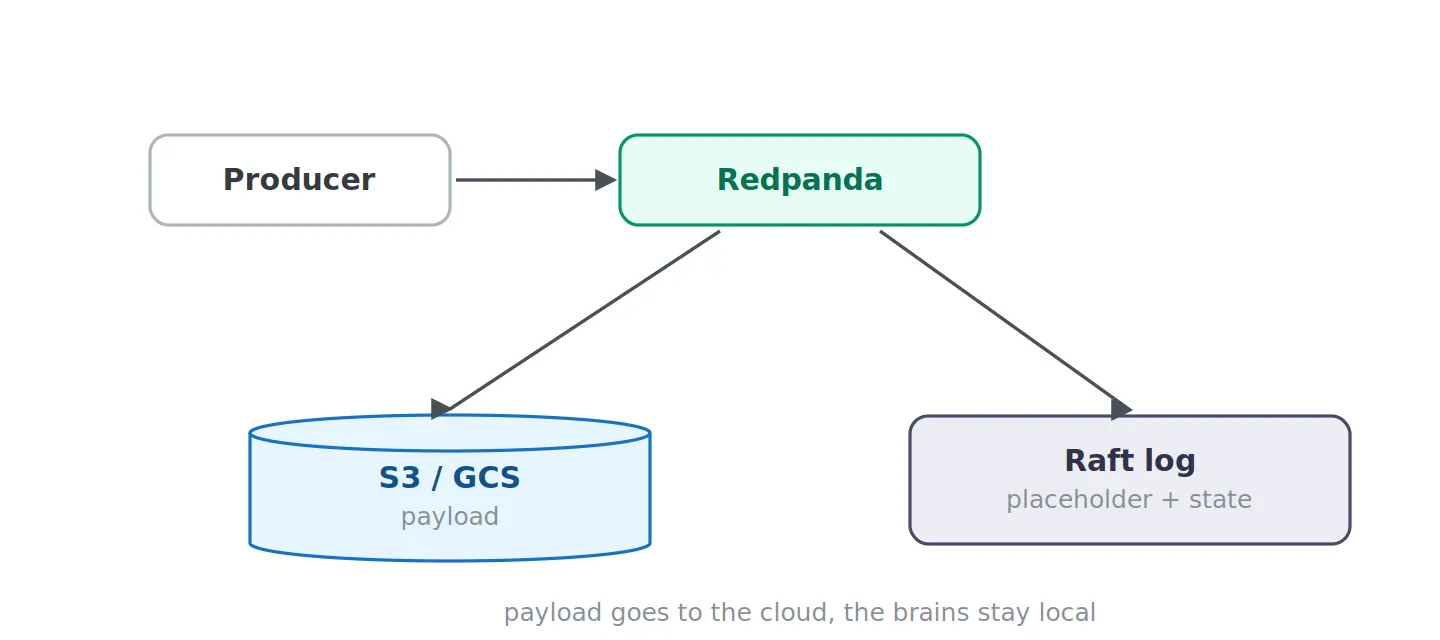
حين يصبح كائن L0 متينًا، تكتب Redpanda بيانات وصفية نائبة في سجل Raft للقسم المعني ثم تقرّ للمنتج. تأمل ما يعنيه هذا لحالة الوسيط: فسجل العناصر النائبة لا يزال سجل Raft لكل قسم تستضيفه وسطاء بعينهم، لذا يبقى كل وسيط عضوًا في مجموعات Raft محددة ويحتفظ بحالة بيانات وصفية محلية وأصوات وأدوار قيادة. هذه الحالة صغيرة – مؤشرات بدلًا من حمولات – لكنها تجعل وسيط Redpanda أقل قابلية للاستبدال من وكيل WarpStream، إذ لا يحمل الوكيل أي حالة أقسام على الإطلاق؛ فبياناته الوصفية موجودة كليًا في خدمة البيانات الوصفية المنفصلة. وهذا معنى أن نموذج Redpanda يحتفظ بمزيد من الحالة في الوسطاء – مقايضة مقصودة، إذ إن إبقاء سجل البيانات الوصفية داخل الوسطاء يتيح لـ Redpanda إعادة استخدام آلياتها القائمة للمعاملات ومتساوية الأثر والاتساق. وقد بلغت Cloud Topics التوافر العام في Redpanda 26.1 في 2026 ويمكنها العمل جنبًا إلى جنب مع أنماط التخزين المحلي والمتعدد الطبقات ضمن عنقود واحد.
Confluent Freight: كتابة مباشرة لأحمال العمل الموجهة للإنتاجية
اتجهت Confluent بشكل مستقل في الاتجاه نفسه. تعتمد عناقيد Freight على وضع كتابة مباشرة في محرك Kora، تذهب فيه بيانات الحمولة إلى تخزين الكائنات بدلًا من نسخها أولًا بشكل متين عبر تخزين الوسطاء المحلي. وتستهدف Confluent بـ Freight أحمال العمل عالية الإنتاجية مثل السجلات والمراقبة وإدخال البيانات التحليلية، متخلية عمدًا عن زمن استجابة دون 100 ms مقابل مسارات كتابة قد تستغرق نحو ثانية أو ثانيتين.
Aiven Diskless: منسّق دفعات منفصل
تشغّل Aiven تنفيذ Inkless، الذي يشارك مساهموه أيضًا في KIPs التخزين بلا أقراص في المشروع الأصلي. ولا قائد في مسار كتابة حمولتها: يرفع الوسطاء السجلات المجمّعة، ويسند Batch Coordinator الإزاحات ويتتبع أماكن تخزينها. وتستخدم Aiven PostgreSQL لطبقة التنسيق هذه، بخلاف موضوع Kafka الداخلي وحالة SQLite المحلية المقترحين في المشروع الأصلي. انظر معمارية Aiven.
يمكن أن تتعايش المواضيع التقليدية والمواضيع بلا أقراص في خدمة Kafka القياسية نفسها. وتوثّق Aiven توافرًا محدودًا على Aiven Cloud ودعمًا لخطط BYOC المختارة -inkless. وللتنفيذ قيود كبيرة على الميزات: فالمعاملات والمواضيع المضغوطة بلا أقراص ومخازن حالة Kafka Streams غير مدعومة. يمكن تحويل موضوع تقليدي إلى بلا أقراص عبر مسار الترحيل الموثّق، لكن التحويل العكسي غير مدعوم. انظر النظرة العامة والقيود ودليل الترحيل.
ما الذي يقترحه Apache Kafka
لعل أقوى إشارة إلى أهمية هذه المعمارية هي KIP-1150: Diskless Topics. فقد وضع مجتمع Apache Kafka حالتها على مقبولة في 2 مارس 2026. والقبول قرار بشأن الاتجاه الذي يسير نحوه Kafka لا ميزة مُسلَّمة: ينبغي أن يدعم Kafka مواضيع تُخزَّن حمولة المستخدم فيها بشكل متين في تخزين الكائنات بدلًا من الاعتماد على تخزين كتل الوسيط ونسخ الحمولة المباشر.
ما زال تصميم التنفيذ قيد التقدم. ففي 25 أغسطس 2026، كلتا KIP-1163: Diskless Core وKIP-1164: Diskless Coordinator حالتهما قيد النقاش. أما KIP-1165، التي تتناول ضغط الكائنات لبيانات التخزين بلا أقراص، فكانت قد أُهملت سابقًا لكنها أُعيد فتحها في يوليو 2026 وهي قيد النقاش مرة أخرى. وKIP-1176، وهي بديل أبقى على جزء أكبر من مسار النسخ التقليدي، مسحوبة؛ وKIP-1183، وهي تجريد تخزين مشترك أوسع طرحه مساهمو AutoMQ، لا تزال اقتراحًا منفصلًا قيد النقاش. ويحتفظ المجتمع بنظرة عامة على هذه العائلة من الاقتراحات في صفحة ويكي Saving Cross-AZ Replication Costs KIPs.
هذا الفرق مهم لكل من يقيّم Apache Kafka نفسه: فقد قُبلت KIP-1150، لكن المواضيع بلا أقراص الأصلية في المشروع الأصلي ليست ميزة متاحة للجميع في Kafka 4.3 اليوم.
تحدد KIP-1163 مسار كتابة مثيرًا: يمكن للوسطاء تخزين دفعات من عدة أقسام بلا أقراص مؤقتًا، وتجميع مقطع WAL مشترك، ورفعه إلى تخزين الكائنات، ثم تثبيت الإحداثيات التي تصف تلك الدفعات لدى المنسّق؛ ويسند المنسّق الترتيب العام للأقسام والإزاحات. مفاهيميًا:
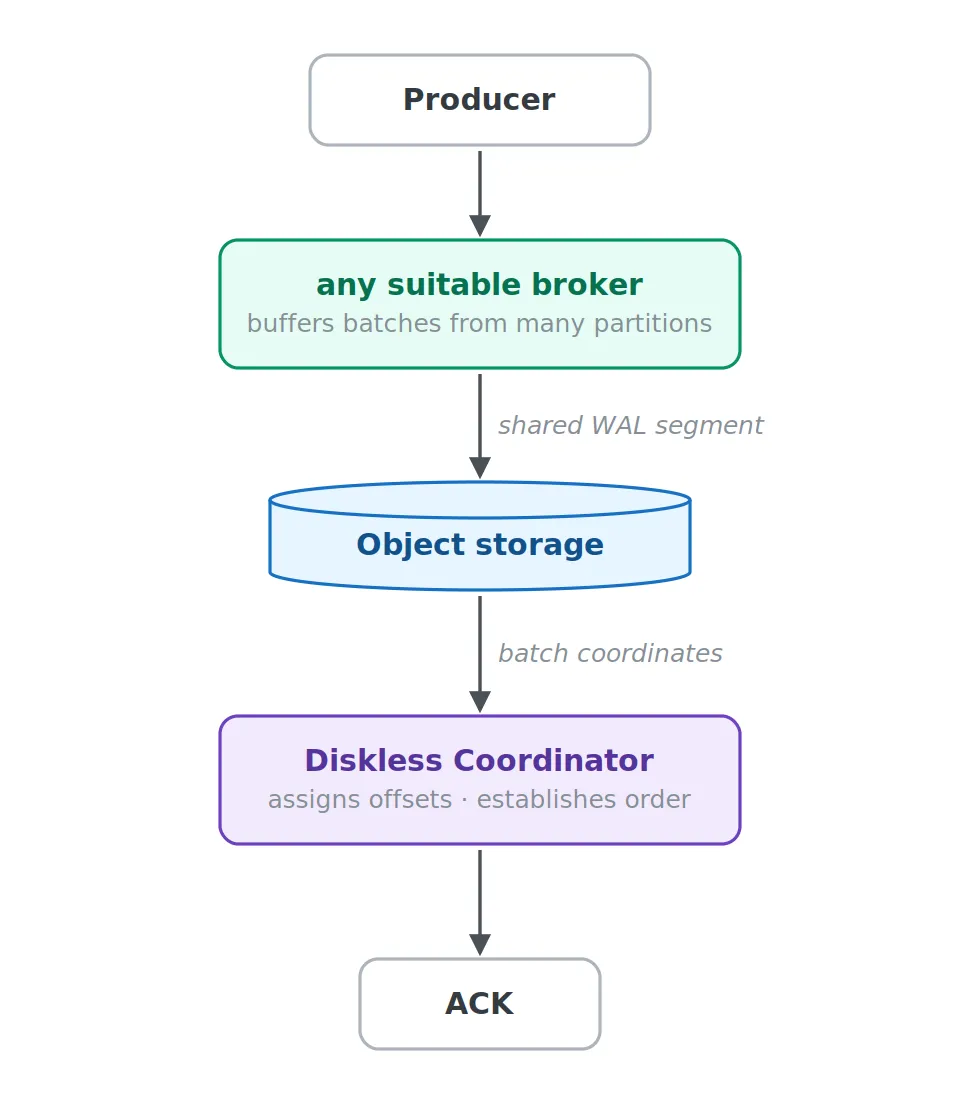
وفي هذا مفارقة تاريخية. فقد بدأ Kafka بنموذج تخزين بسيط بديع: ملف السجل هو السجل. وفي المسار المقترح بلا أقراص، تحتفظ الكائنات بالبايتات، وتحدد البيانات الوصفية كيف تشكّل هذه البايتات سجل Kafka.
لماذا يستخدم المنسّق المقترح SQLite
تتضمن KIP-1164 أحد أكثر التفاصيل دلالة في تصميم Kafka بلا أقراص بأكمله. يضيف الاقتراح موضوع Kafka داخليًا هو __diskless_metadata، يعمل مصدرًا للحقيقة للبيانات الوصفية بلا أقراص. ومن المتوقع أن تصل حالة المنسّق إلى مئات الميغابايتات أو حتى غيغابايتات، لذا فإن الاحتفاظ بها كلها في الذاكرة غير جذاب. ولهذا السبب يجسّد الاقتراح سجل البيانات الوصفية في قاعدة بيانات SQLite محلية للسماح بالوصول المفهرس. ويبقى Kafka مصدر الحقيقة المتين، بينما SQLite مخزن حالة محلي يمكن إعادة بنائه.
وقد يبدو وسيط Kafka مستقبلي محتمل على النحو التالي:
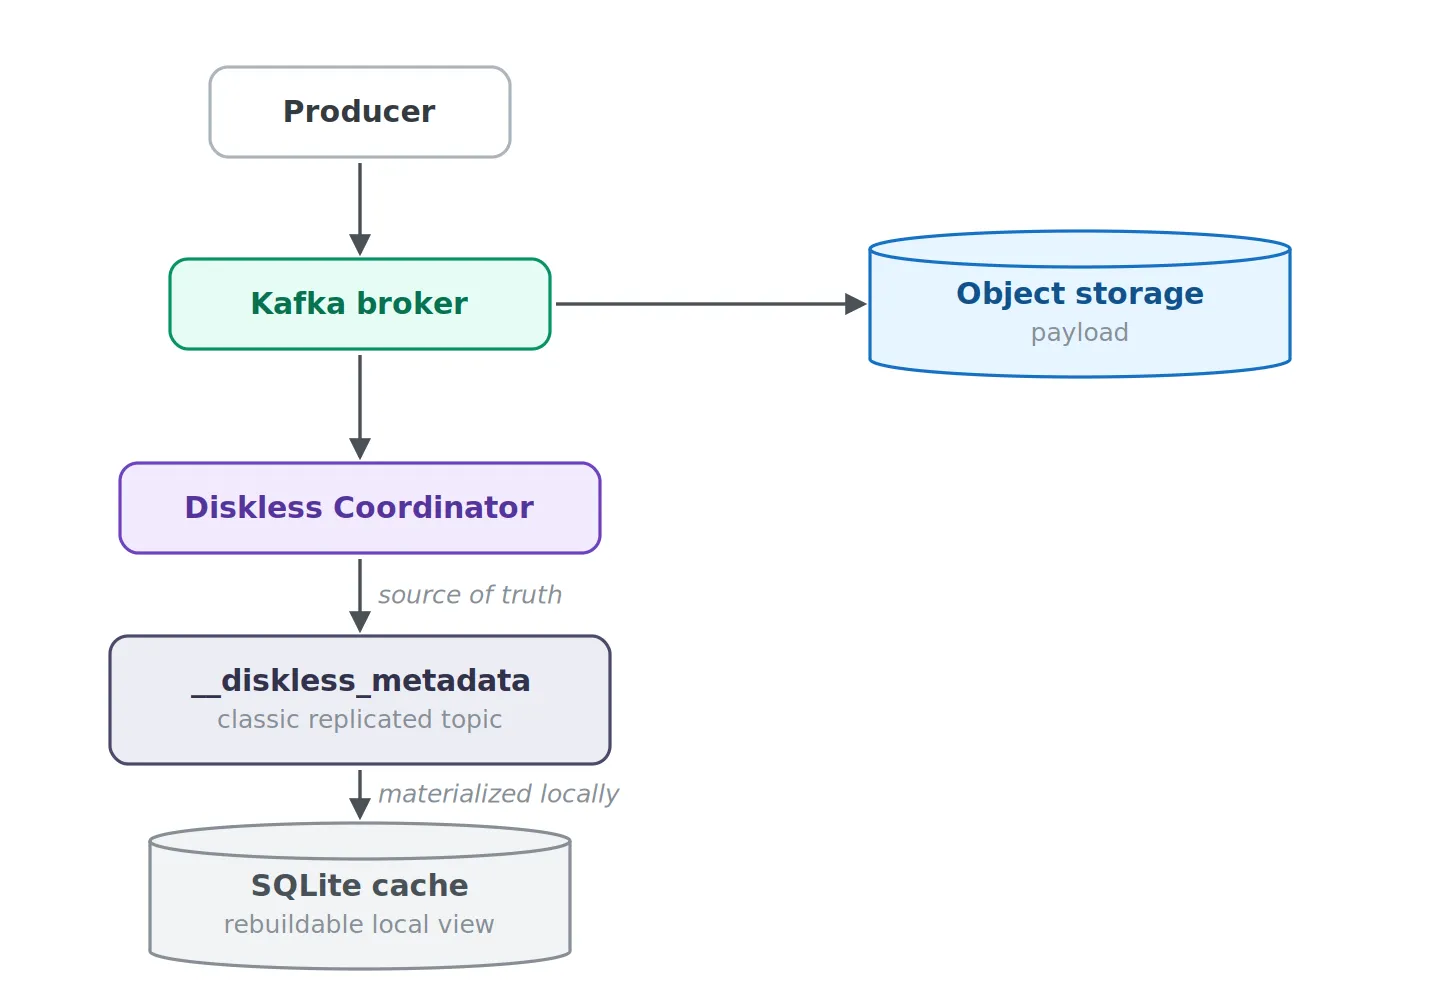
يحتاج المخطط إلى توضيح، إذ من السهل افتراض العكس: __diskless_metadata هو نفسه موضوع Kafka تقليدي، متماثل عبر أقراص الوسطاء بالطريقة المعتادة – وليس موضوعًا بلا أقراص. وهذا مقصود لسببين. فالموضوع بلا أقراص يعتمد على المنسّق، لذا يجب ألا يعتمد تخزين المنسّق نفسه على مواضيع بلا أقراص. كما أن إبقاء البيانات الوصفية على مسار النسخ التقليدي يتجنب كتابة إضافية إلى تخزين الكائنات أثناء التثبيت؛ ولا يزال المنتج ينتظر رفع الحمولة. ويوضح تحليل المخاطر في الـ KIP العاقبة: إذا فقد موضوع البيانات الوصفية عددًا كبيرًا جدًا من النسخ المتماثلة المتزامنة، تتوقف الكتابات بلا أقراص. ويؤدي تخزين الكائنات دورًا في قصة البيانات الوصفية، لكنه دور مساند – إذ يسمح الاقتراح بحفظ لقطات دورية من حالة المنسّق في تخزين الكائنات، بحيث لا يحتاج الموضوع الداخلي إلا إلى الاحتفاظ بالفروقات منذ آخر لقطة.
يختار تنفيذ Aiven الإنتاجي حاليًا خيارًا مختلفًا: فمنسّق الدفعات لديها مبني على PostgreSQL، بينما يعتمد الاقتراح الأصلي على موضوع Kafka الداخلي مصدرًا للحقيقة وعلى SQLite حالة مجسّدة محلية. تختلف التفاصيل، لكن الاتجاه واحد. فحين يصبح تخزين الحمولة رخيصًا ومشتركًا، ينتقل العمل الهندسي الصعب إلى البيانات الوصفية والترتيب والاسترداد.
إعادة تنظيم الكائنات للقراءة
يحل التجميع عبر الأقسام مسار الكتابة، لكنه للأسف يضر بمسار القراءة. لنفترض أننا نُدخل البيانات في كائن جديد من المستوى صفر مثل الذي وُصف سابقًا:
L0 object

P1 P7 P3 P18 P1 P9 P7 P2 P18 P1
بالنسبة للكتابات هذا ممتاز – عملية PUT واحدة كبيرة بشكل معقول إلى تخزين الكائنات تحمل بيانات من أقسام كثيرة. لكن حين يريد مستهلك إعادة تشغيل القسم P7، قد يضطر النظام إلى تحديد مواقع كائنات منفصلة كثيرة وقراءة نطاقات منها لمجرد إعادة بناء التاريخ المتسلسل لقسم واحد. ولهذا تُدخل الأنظمة بلا أقراص في أحيان كثيرة مفهومًا آخر شبيهًا بقواعد البيانات: إعادة التنظيم في الخلفية. وهنا يؤدي «المستوى» في L0 وظيفته: ففي Redpanda، يعيد Reconciler يعمل في الخلفية كتابة تلك الكائنات من المستوى صفر إلى ملفات L1 أكبر تُجمَّع فيها البيانات وتُرتَّب حسب القسم والإزاحة. مفاهيميًا:
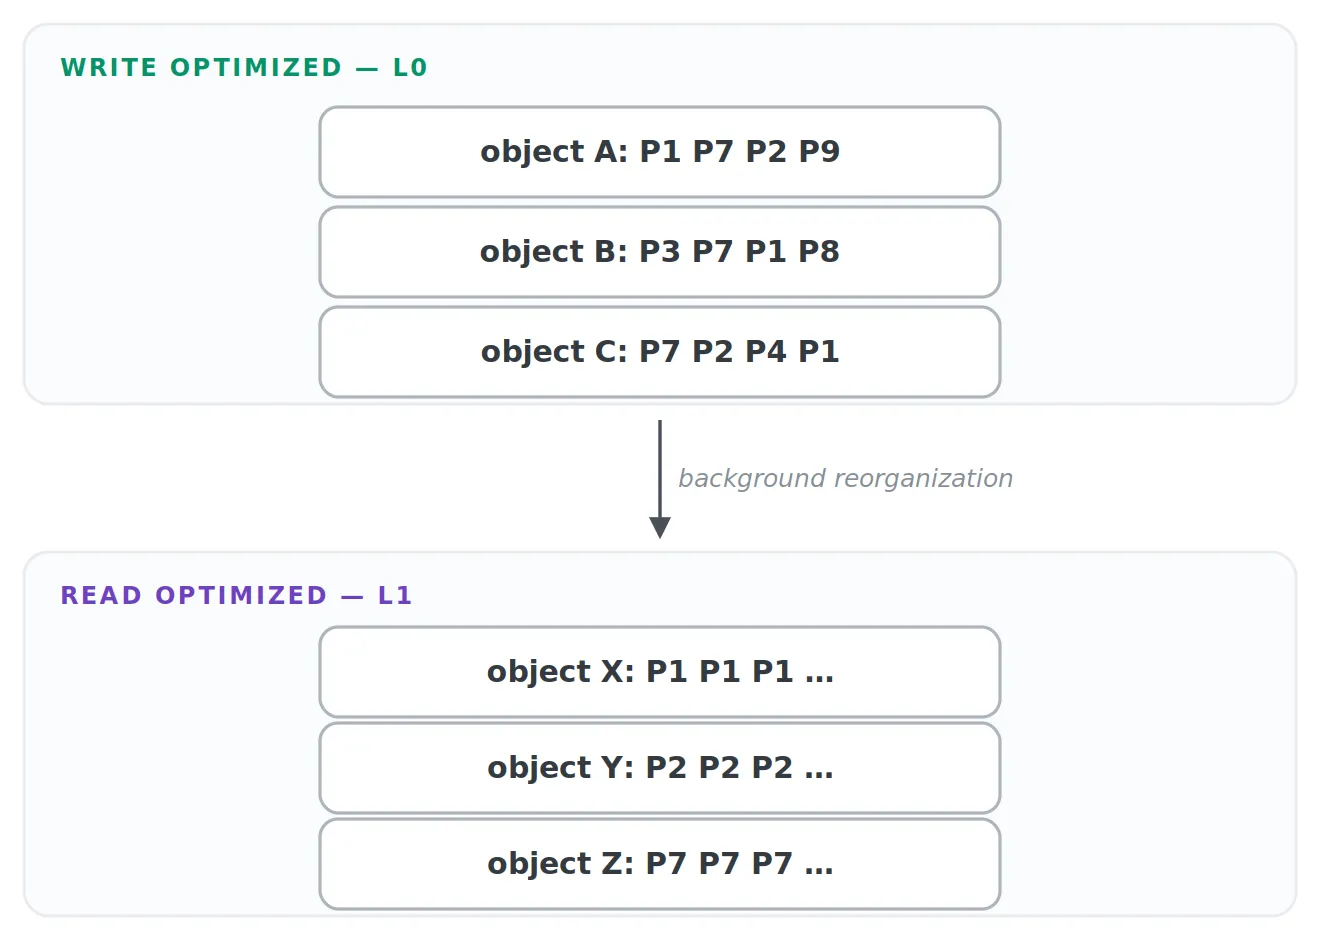
تشغّل WarpStream ضغط ملفات في الخلفية للسبب نفسه تقريبًا: تُعاد تنظيم الملفات متعددة الأقسام الحديثة الإدخال لتحسين التموضع المكاني للقراءات التاريخية. وتحتوي KIP-1163 في Kafka على مسار دمج، وتبحث KIP-1165 المُعاد فتحها ضغط الكائنات للفئة نفسها من المشكلات.
أي شخص يعرف أشجار LSM سيلاحظ النمط. الكتابات السريعة تنتج تخطيطًا؛ والقراءات الفعالة تتطلب عاجلًا أم آجلًا تخطيطًا آخر. وهكذا يبدأ وسيط البث بلا أقراص بالشبه بمحرك تخزين مصمم لغرض محدد أكثر من شبهه بمجلد من ملفات السجل الملحقة فقط.
زمن الاستجابة يعتمد على مسار الإقرار
لوضع تخزين الكائنات في المسار الحرج عيب واضح: زمن الاستجابة. فكتابة Kafka التقليدية قد تستفيد من التخزين المحلي والنسخ المحكم بين الوسطاء. أما التنفيذ بلا أقراص فقد يضطر إلى تجميع سجلات كافية لتكوين كائن فعّال، ورفعه، وانتظار أن يجعله التخزين متينًا، وتثبيت بيانات وصفية متسقة بقوة، وعندها فقط إقرار المنتج. اجعل نافذة التجميع قصيرة جدًا فتحصل على كائنات صغيرة كثيرة وتكلفة أعلى لطلبات مخزن الكائنات؛ واجعلها طويلة فيرتفع زمن الاستجابة. ولا يمكن إزالة هذا التوتر بالإعدادات – فهو متأصل في المعمارية.
يعالج كل نظام هذه المقايضة بطريقته. تضبط WarpStream مهلة دفعة افتراضية قدرها 250 ms ويمكنها قبول مزيد من طلبات مخزن الكائنات مقابل زمن استجابة أقل؛ وتعتمد إعداداتها الحالية منخفضة الزمن على مهل أقصر، وعلى AWS على S3 Express. ويمكن لـ AutoMQ وضع WAL أسرع أمام تخزين الكائنات، بحيث قد يتوقف الإقرار على الـ WAL لا على المسار الأبطأ طويل الأمد. وتوثّق Redpanda توقعات زمن استجابة شامل أعلى بوضوح لـ Cloud Topics التي تعمل على مخازن كائنات سحابية عامة، وتصف Confluent خدمة Freight بعبارات مماثلة. كما ينص اقتراح Kafka الحالي للتخزين بلا أقراص صراحةً على أن التخزين البعيد سيرفع زمن الطلب وزمن الاستجابة الشامل مقارنة بالمواضيع التقليدية.
هذه هي المقايضة المعمارية. يجلب تخزين الكائنات المرونة واقتصاديات مختلفة، بثمن أولية متانة ذات زمن استجابة أعلى – أو بإضافة WAL أسرع أمامه.
ما الذي يتغير تشغيليًا
من الحجج المؤيدة للمعماريات بلا أقراص أنها تجعل Kafka أبسط بكثير. ومن الناحية التشغيلية، في ذلك شيء من الصحة: فتحديد أحجام الأقراص، ونقل النسخ المتماثلة، وإعادة موازنة بيانات الأقسام، واستبدال الأقراص، ونفاد تخزين الوسيط، وجزء كبير من نسخ الحمولة بين المناطق، كلها إما تختفي أو تقل أهميتها.
لكن الأنظمة الموزعة نادرًا ما تزيل التعقيد – بل تنقله. وعلى الأنظمة بلا أقراص أن تولي اهتمامًا أكبر بكثير لتجميع الكائنات، وترتيب البيانات الوصفية، وضغط الكائنات، وجمع المهملات، وإدارة ذاكرة التخزين المؤقت، وكفاءة قراءة النطاقات، واقتصاديات الكائنات الصغيرة، واسترداد البيانات الوصفية، وسلوك قراءة الذيل.
يستثمر Kafka التقليدي جهدًا هندسيًا كبيرًا في صيانة سجلات فعلية متماثلة. أما Kafka بلا أقراص فيستثمر جزءًا أكبر منه في وصف البيانات المحفوظة في تخزين مشترك وتخزينها مؤقتًا وإعادة تنظيمها. المعمارية أبسط في بعض الأبعاد التشغيلية، لا في جميعها.
هل يجعل Kafka بلا أقراص Kafka أرخص فعلًا؟
عادةً، هذا هو سبب وجود المعمارية أصلًا. تأتي أكبر وفورات محتملة من ثلاثة مصادر. أولًا، نسخ أقل بين المناطق – إذ يستطيع الوسيط الكتابة مرة واحدة إلى خدمة تخزين كائنات إقليمية يدير مزوّد السحابة متانتها. ثانيًا، تخزين أرخص: فلكل بايت محتفظ به، يكلّف تخزين الكائنات عادةً أقل بكثير من كميات كبيرة من تخزين الكتل عالي الأداء المحجوز. ثالثًا، الحوسبة أسهل في التوسع: فحين لا يملك الوسطاء بيانات متينة، لا تعني إضافة عقد الحوسبة وإزالتها نقل حصة متناسبة من مجموعة البيانات المحتفظ بها.
ومع ذلك فإن «S3 رخيص» ليس نموذج التكلفة بأكمله. فلا تزال تدفع مقابل طلبات PUT وطلبات GET وقراءات النطاقات وبنية البيانات الوصفية والتخزين المؤقت والضغط في الخلفية والحوسبة، وربما تخزين WAL عالي الأداء. ولهذا تحتاج ادعاءات الموردين بـ«Kafka يكلّف أقل بنسبة 90%» إلى سياق: فبإمكان المعمارية بالتأكيد تغيير الاقتصاديات لحمل عمل عالي الإنتاجية، لكن هذا لا يعني أن كل فاتورة Kafka ستنخفض بنسبة 90%.
أين تناسب
يجذب Kafka بلا أقراص بصفة خاصة أحمال العمل التي تجمع بين إنتاجية عالية واحتفاظ طويل وقدر من تحمّل زمن الاستجابة: السجلات وتدفقات المراقبة والقياس عن بعد وCDC وتدفقات النقرات وإدخال بحيرات البيانات وإدخال تعلّم الآلة / الذكاء الاصطناعي وغيرها من تدفقات الأحداث التحليلية الكبيرة.
تنقل مثل هذه الأحمال أعدادًا هائلة من البايتات وغالبًا ما تقلق أقل من بضع مئات من الملّي ثانية – أو حتى ثانية كاملة – من زمن الاستجابة الإضافي مقارنةً بمسار أوامر بين الخدمات. ولا يزال Kafka التقليدي على تخزين محلي يقدم حجة قوية لمعالجة الأحداث الحساسة لزمن الاستجابة والأوامر وأحمال القراءة الساخنة جدًا في الذيل ومجموعات البيانات المحتفظ بها الأصغر. ولهذا فإن الحالة النهائية المرجحة ليست نمط تخزين واحدًا لكل المواضيع.
المستقبل على الأرجح هو Kafka متعدد الأنماط
قد يكون هذا أهم جانب في KIP-1150: يُقترح التخزين بلا أقراص خيارًا يُتخذ لكل موضوع، لا هوية للعنقود بأكمله بالضرورة. وقد يبدو نشر Kafka مستقبلي على هذا النحو:
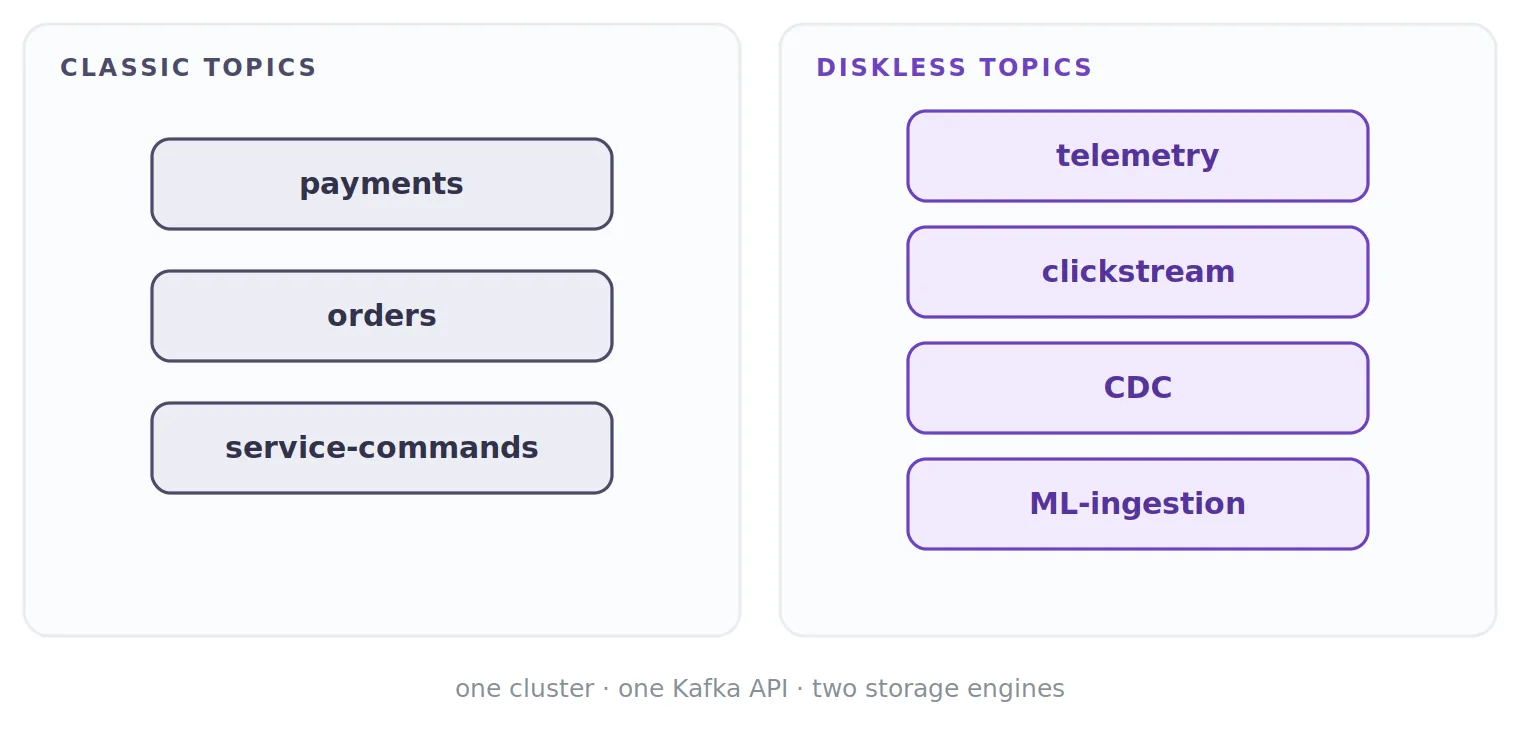
وهكذا يمكن لواجهة Kafka برمجية واحدة وحدّ إداري واحد أن يُخفيا تحتهما محركات تخزين مختلفة جدًا. فتدعم Redpanda بالفعل أنماط التخزين المحلي والمتعدد الطبقات والسحابي ضمن محرك واحد. وتتيح Aiven تعايش المواضيع التقليدية والمواضيع بلا أقراص في خدمة Kafka قياسية واحدة؛ ولا تزال حدود ميزاتها الحالية تستبعد المعاملات والمواضيع المضغوطة بلا أقراص ومخازن حالة Kafka Streams. كما يتوفر تحويل باتجاه واحد من التقليدي إلى بلا أقراص في توافر مبكر. وتتوقع KIP-1163 في Kafka الأصلي صراحةً أن تتشارك المواضيع التقليدية والمتعددة الطبقات وبلا أقراص عنقودًا واحدًا، بما يتيح للتطبيقات اتخاذ مقايضة التكلفة/زمن الاستجابة لكل موضوع بدلًا من كل منصة.
هذا مستقبل أكثر إثارة من مجرد التساؤل عما إذا كان «Kafka بلا أقراص سيحل محل Kafka». فقد يصبح Kafka نفسه متعدد الأنماط.
قد يعيش بروتوكول Kafka أطول من معمارية Kafka الأصلية
لقد تجاوزت واجهة Kafka البرمجية تصميم تخزين Kafka الأصلي. فالتطبيقات تتعامل مع المواضيع والأقسام والإزاحات والمنتجين والمستهلكين ومجموعات المستهلكين والمعاملات ودلالات بروتوكول Kafka. ولا تهتم بالضرورة بما إذا كانت البايتات الأساسية مخزّنة في:
ext4
XFS
NVMe
EBS
S3
GCS
Azure Blob
هذا ما أتاح لـ WarpStream وAutoMQ وRedpanda وغيرها البقاء متوافقة مع Kafka مع التجريب الجريء تحت حدود البروتوكول – والآن يبدأ Apache Kafka نفسه بالتوجه في الاتجاه نفسه. فقد صُمم Kafka على فرضية أن الإدخال والإخراج المتسلسل للقرص يمكن أن يجعل سجلًا موزعًا دائمًا سريعًا للغاية. وكانت هذه الفرضية صحيحة، ولا ينفيها Kafka بلا أقراص. أما السؤال الأحدث فهو ما إذا كان تشغيل Kafka في السحابة لا يزال يتطلب أن يملك الوسيط السجل المتين أصلًا.
وتنشأ عن الجواب معماريات تشبه قواعد البيانات السحابية الحديثة أكثر من عناقيد Kafka في العقد الثاني من الألفية:
stateless-ish compute
       +
shared object storage
       +
strongly consistent metadata
       +
caching
       +
background compaction
إذن، هل Kafka بلا أقراص هو المستقبل؟
ليس لكل المواضيع. لكن بالنسبة للبث عالي الإنتاجية في السحابة، يصعب تجاهل هذا الاتجاه.
لا تزال معمارية Kafka التقليدية تقدم خصائص ممتازة لأحمال العمل الحساسة لزمن الاستجابة. فالتخزين المتسلسل المحلي سريع، ولا يزال القائد المتكامل بإحكام مع سجل متماثل تجريدًا بسيطًا وقويًا. وتوفر الأنظمة التي ناقشناها هنا عددًا من التصاميم بلا أقراص بالفعل. وما يستحق المقارنة في نشر حقيقي هو زمن الإقرار وسلوك الاسترداد ودعم الميزات والتكلفة الإجمالية لحمل العمل المعني.