Քեշավորումը միկրոսերվիսային ճարտարապետությունում
Քեշավորումն ինքնին շատ լայն հասկացություն է։ Այն կարող է նշանակել հակադարձ պրոքսի, որը քեշավորում է HTTP պատասխանները հավելվածի առջևում, կամ տվյալների բազայի կանչերի քեշավորում խորը բեքենդում։ Եկեք այս թեման ավելի մանրամասն քննարկենք։
Թվում է՝ քեշավորման մասին ոչ մի տեքստ առանց Համակարգչային գիտության երկու դժվար խնդիրների մասին հայտնի մեջբերման լիարժեք չէ, ուստի ես էլ դրանով կսկսեմ։
Համակարգչային գիտության մեջ կա ընդամենը երկու դժվար խնդիր՝ քեշերի անվավերացումը և անվանումների ընտրությունը։
– Phil Karlton
Եթե քեշավորումը ճիշտ կազմակերպելն այդքան ցավոտ է, ապա ինչո՞ւ առհասարակ զբաղվել դրանով։ Գուցե պարզապես ամեն գնով խուսափե՞նք դրանից։ Ցավոք, ամեն ինչ այդքան պարզ չէ, մանավանդ երբ նպատակ ունենք միկրոսերվիսային ճարտարապետության։ Առանց որևէ քեշի արագ բաշխված համակարգ ստեղծելը կարող է իսկապես դժվար լինել։
Քեշավորումն ինքնին շատ լայն հասկացություն է։ Այն կարող է նշանակել հակադարձ պրոքսի, որը քեշավորում է HTTP պատասխանները հավելվածի առջևում, կամ տվյալների բազայի կանչերի քեշավորում խորը բեքենդում։ Եկեք այս թեման ավելի մանրամասն քննարկենք։
Ինչու է քեշավորումը կարևոր
Միկրոսերվիսը ծրագրային համակարգի ինքնամփոփ մաս է, որը պարփակում է նրա տրամաբանության մի հատվածը։ Սովորաբար այն նաև պատասխանատու է համակարգի տվյալների որոշ ենթաբազմության համար (օրինակ՝ հետևում է, որ սխալ թարմացումները չվնասեն դրանք)։ Սերվիսի այս պարտականությունը հաճախ անվանում են տվյալների սեփականություն (data ownership)։ Այդուհանդերձ, համակարգի տարբեր սերվիսները պետք է կիսվեն իրենց պատկանող տվյալներով։ Ամենից հաճախ դրանք հասանելի են դարձնում հանրային սինքրոն ինտերֆեյսներով, ինչպիսիք են REST կամ gRPC API-ները։
Սինքրոն հարցումը միշտ ենթադրում է կանչ ցանցով։ Նույնիսկ արագ ներքին ցանցում տվյալների ուղարկումը զգալիորեն ավելի երկար է տևում, քան մոնոլիտ հավելվածի մեկ լոկալ պրոցեսի ներսում դրանք փոխանակելը։ Բացի այդ, ցանցային կանչերը ստեղծում են ժամանակային կապակցվածություն (temporal coupling)՝ հարցվող սերվիսը և հարցնողը պետք է երկուսն էլ հասանելի մնան կանչի ամբողջ տևողության ընթացքում։ Սա կարող է վնասել համակարգի ընդհանուր հասանելիությանը։
Կապի այս ոճը նաև իր առավելություններն ունի։ Առաջին հերթին, մենք միշտ ստանում ենք տվյալների բավականին թարմ պատճեն հարցվող սերվիսից, ինչը կարևոր է, երբ հնացած տվյալներով աշխատելն անթույլատրելի է։
Հիշեք, որ նույնիսկ սինքրոն կապը տվյալների համաձայնեցվածության (consistency) որևէ երաշխիք չի տալիս։ Սերվիսին պատկանող տվյալները կարող են փոխվել պատասխանն ուղարկելուց անմիջապես հետո։ Եթե մեզ անհրաժեշտ են ուժեղ, ատոմար երաշխիքներ, փոփոխությունները պետք է կատարվեն մեկ սերվիսի ներսում։
Սակայն սինքրոն կապի հիմնական թուլությունն այն է, որ դժվար է այն մասշտաբավորել՝ պահպանելով ընդունելի արտադրողականություն։ Բարեբախտաբար, ճիշտ քեշավորումը թույլ է տալիս ավելի լավ անել։
Քեշավորման ռազմավարություններ
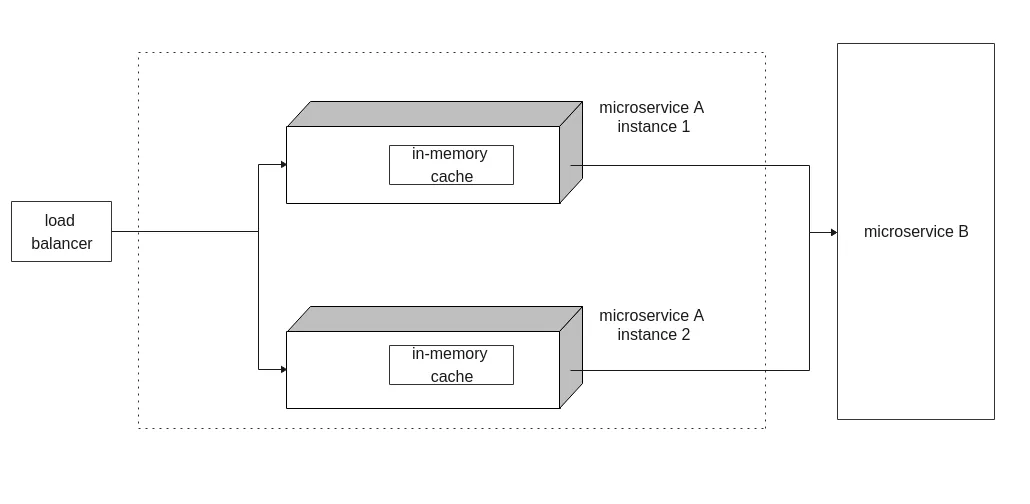
Բավականին հաճախ պատահում է, որ մի սերվիս անընդհատ նույն տեղեկությունն է խնդրում մյուսից։ Ավելորդ ցանցային կանչերից խուսափելու համար կարող ենք այդ տվյալները պահել հիշողության մեջ՝ պրոցեսի ներսի քեշում։ Երբ առաջին կանչը բերել է տվյալները, հետագա հարցումները պարզապես կարող են կարդալ քեշավորված օբյեկտը։ Քանի որ կարդալիս տվյալներն անցնում են քեշի միջով, այս ռազմավարությունը կոչվում է read-through։
Քեշավորումը կտրուկ կրճատում է տվյալներին հետագա դիմումների ժամանակը, բայց հենց առաջին ընթերցումը դեռ պահանջում է դանդաղ կանչ ցանցով։ Պետք է նաև մտածել, թե ինչպես պարզել՝ քեշավորված տվյալները դեռ ակտուալ են, թե ոչ։ Այս մասին կխոսենք ավելի ուշ։
Քեշը կարող է թարմացվել նաև այն ժամանակ, երբ տվյալներ ենք ուղարկում մեկ այլ սերվիս կամ պահպանում ենք տվյալների պահոցում։ Ինտուիտիվ կերպով սա շատ տրամաբանական է. նոր ստեղծված կամ փոփոխված բանը շատ հավանական է՝ շուտով նորից կկարդվի։ Երբ քեշի պարունակությունը թարմացվում է հարցումից հետո (կամ դրա հետ զուգահեռ), այդ մոտեցումը կոչում ենք write-through։ Write-back ռազմավարությունը նախ թարմացնում է քեշը և միայն դրանից հետո ուղարկում է հարցումը, որը թարմացնում է օբյեկտը մյուս սերվիսում։
Երկու մոտեցումներն էլ աշխատում են միայն այն դեպքում, երբ ամեն փոփոխություն անցնում է սերվիսի մեկ ինստանսով։ Եթե գրառումները կատարվում են տարբեր ռեպլիկաներում, քեշերը շատ արագ կդադարեն համաձայնեցված լինել։ Այն գաղափարը, որ օբյեկտների տրված խմբերը (շարդերը) թարմացնելու համար պատասխանատու է միայն մեկ հանգույց, հայտնի է որպես Single Writer Principle (SWP)։ SWP իրականացնող ֆրեյմվորքի հայտնի օրինակ է Akka Cluster-ը։
Քեշի անվավերացում
Տվյալները պրոցեսի ներսի քեշում պահելը մեծացնում է սերվիսի հիշողության պահանջները։ Անսահմանափակ չափով քեշը, որից երբեք ոչինչ չի հեռացվում, շուտով կհանգեցնի հիշողության սպառման սխալների։ Այդ պատճառով քեշերը սովորաբար սահմանափակ չափ ունեն և լցվելիս կիրառում են հեռացման (eviction) որևէ ռազմավարություն.
- Least-recently-used (LRU) ամենատարածված ռազմավարություններից է։ Երբ քեշը պետք է մի տարր դեն նետի, ընտրում է այն, որին ամենաերկար ժամանակ չեն դիմել։ Այն հիմնվում է գործնական դիտարկման վրա. վերջերս օգտագործված տարրը շատ հավանական է՝ նորից կպահանջվի։ Համակարգչային գիտության մեջ այս երևույթը կոչվում է ժամանակային հղումների լոկալություն։
- LRU-ի թուլությունն այն է, որ այն կարող է դեն նետել նույնիսկ հաճախ օգտագործվող տարրերը, երբ միանգամից շատ նոր տարրեր են քեշավորվում։ Եթե այդ նոր գրառումներին այլևս ոչ ոք չդիմի էլ, միևնույն է, դրանք կկարողանան քեշից դուրս մղել մյուս «տաք» գրառումները։ LFU-ն (least frequently used) լուծում է սա՝ հեռացնելով միայն ամենաքիչ օգտագործված տարրերը։
Գոյություն ունեն նաև շատ այլ մոտեցումներ (օրինակ՝ most recently used - MRU կամ first-in-first-out - FIFO), և դրանք կարող են լավ տեղավորվել առանձին դեպքերում։
Մենք միշտ պետք է մետրիկաներով ստուգենք, որ ընտրված քեշավորման ռազմավարությունը ճիշտ է։
Քեշի արդյունավետության լավագույն չափանիշներից մեկը հիթերի (քեշից հաջողությամբ տրված տվյալներ) և միսերի հարաբերակցությունն է։
Միսերի մեծ քանակը կարող է ազդանշան լինել, որ հեռացման ռազմավարությունը հարմար չէ։
Սառը և տաք քեշ
Նոր գործարկված պրոցեսի հիշողության մեջ գտնվող քեշը սկզբում դատարկ է (սառը)։ Այն լցվում է միայն այն բանից հետո, երբ հավելվածը կատարել է որոշ ընթերցումներ և գրառումներ։ Սա է, որ կոչվում է քեշի տաքացում։ Արդյունքում սերվիսը գործարկումից անմիջապես հետո կարող է փոքր-ինչ դանդաղ լինել և իր լավագույն արտադրողականությանը հասնել միայն որոշ ժամանակ անց։ Նրբագեղ լուծում է նախնական տաքացումը (pre-warming)՝ քեշը ասինքրոն լցնելը սերվիսի գործարկումից անմիջապես հետո։ Խնդիրն այն է, որ միշտ չէ, որ կարելի է նախապես իմանալ, թե որ տվյալներն արժե քեշավորել։
Այլ խնդիր է առաջանում, երբ սերվիսը մասշտաբավորվում է մի քանի ինստանսների։ Հավելվածի յուրաքանչյուր աշխատող պրոցես պահում է իր առանձին քեշը, ուստի անխուսափելիորեն որոշ օբյեկտներ քեշավորվում են մի ինստանսում, բայց մյուսում՝ ոչ։ Ամեն անգամ, երբ հարցումը հայտնվում է սխալ ինստանսում, արդյունքում քեշի miss է լինում։ Դրանից խուսափելուն կարող են օգնել sticky sessions-ը կամ շարդինգը consistent hashing-ով։ Առանձին (standalone) քեշն ավելի լավ տարբերակ է։
Առանձին քեշ
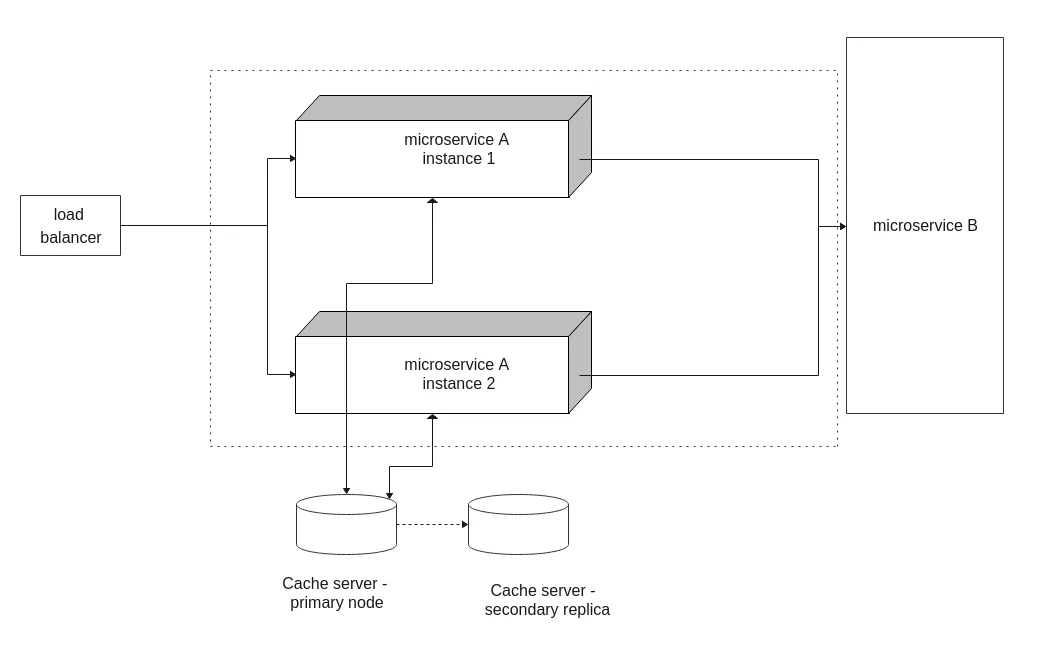
Առանձին քեշը նվիրված ենթակառուցվածքային բաղադրիչ է, որը կիսում են հավելվածի ինստանսները։ Այն լուծում է նախորդ բաժնում նշված որոշ խնդիրներ։ Քանի որ քեշը գտնվում է հավելվածից դուրս, նրա պարունակությունը պահպանվում է վերագործարկումներից հետո։ Եվ քանի որ հավելվածի յուրաքանչյուր ինստանս կիսում է քեշավորված ամբողջ տվյալները, ճիշտ հանգույցին հասնելը դադարում է մտահոգություն լինել։
Redis-ը և Memcached-ը առանձին քեշի տարածված ընտրություններ են։ Գոյություն ունեն նաև ավելի մասնագիտացված տարբերակներ, օրինակ՝ in-memory-data-grid-երը (ասենք՝ Hazelcast կամ Apache Ignite), որոնք կարող են պահվող տվյալների վրա կատարել նաև բաշխված հաշվարկներ։
Երբեմն քեշավորել ցանկացած տվյալների ծավալը շատ անգամ գերազանցում է այն, ինչ կարող է պահել մեկ մեքենան։ Շարդինգի շնորհիվ տերաբայթավոր տվյալներ կարելի է պահել բազմաթիվ հանգույցների հիշողության մեջ։ Հավելվածի համար շարդինգի այս տեսակն անտեսանելի է. հենց քեշն է հարցումները ուղղորդում այն ինստանսին, որը պահում է տվյալ գրառումը։
Երբ առանձին քեշն աշխատում է որպես մեկ ինստանս, այն կարող է դառնալ խափանման միակ կետ։ Որպեսզի համակարգը բարձր հասանելի լինի, քեշի բաղադրիչը պետք է կամ աշխատի որպես բաշխված կլաստեր, կամ ունենա պահուստային (failover) հանգույցներ։ Օրինակ՝ Redis-ն աջակցում է և՛ կլաստերավորում (Redis Cluster), և՛ հիմնական հանգույցի խափանման դեպքում ռեպլիկաների առաջխաղացում (Redis Sentinel)։
Առանձին քեշը պարտադիր չէ տեղակայել որպես անկախ բաղադրիչ։ Կոնտեյներացված համակարգերում (օրինակ՝ Kubernetes-ով կառավարվողներում) այն կարող է աշխատել նաև որպես sidecar։ Sidecar կոնտեյները կապված է կոնկրետ ինստանսի հետ և կիսում է նրա կյանքի ցիկլը (ճիշտ ինչպես պրոցեսի ներսի քեշը)։ Միևնույն ժամանակ այն տրամադրում է քեշ համակարգերի առաջարկած բոլոր հնարավորությունները։ Պարզ ասած՝ այն գտնվում է լիարժեք բաշխված քեշ սերվերի և հիշողության քեշի միջև։
Առանձին բաղադրիչով աշխատող քեշի թերությունն այն է, որ նրան պետք է դիմել ցանցով, ուստի այն երբեք չի կարող հավասարվել հիշողության տարբերակի արագությանը։ Հետաքրքիր է, որ հիշողության քեշերը նույնպես կարող են բաշխված լինել։ Հիանալի օրինակ է Hazelcast IMDG-ն։ Այն կարող է աշխատել որպես լոկալ քեշ առանձին JVM պրոցեսների ներսում՝ միաժամանակ տվյալները կրկնօրինակելով մյուս ինստանսներում։ Արդյունքում յուրաքանչյուր ընթերցում սպասարկվում է հիշողության քեշից, և միայն գրառումներն են կրում կրկնօրինակման համար անհրաժեշտ ցանցային կանչերի լրացուցիչ գինը։
Քեշի ժամկետի ավարտ և անվավերացում
Վաղ թե ուշ քեշի տվյալները կշեղվեն իրենց աղբյուրից։ Երբեմն սա պարզապես շփոթեցնում է օգտատերերին, օրինակ՝ երբ նրանք թարմացում են արել, բայց դեռ տեսնում են քեշից տրվող հին տարբերակը։ Ավելի լուրջ դեպքերում դա կարող է սխալներ առաջացնել և տվյալները վնասել։
Քեշից հնացած տարրերը հեռացնելու ամենապարզ եղանակը հիմնվում է ժամանակի վրա։ Մեզ պարզապես պետք է քեշ դրվող տարրերի համար սահմանել TTL (time to live)։ Երբ TTL-ը լրանում է, տարրը հեռացվում է։ Երբ տարրը նորից պահանջվում է, այն կրկին բերվում է աղբյուրից և նորից քեշավորվում։ Այս ամբողջ գործընթացը հայտնի է որպես քեշի eviction։
Այս մեթոդն իր թերություններն ունի։ Երբ հարցվող տվյալները փոխվում են անկանխատեսելի կերպով (որոշ օբյեկտներ ավելի դինամիկ են, մյուսները՝ ստատիկ), հարմար TTL ընտրելը կարող է դժվար լինել։ Չափից բարձր TTL-ի դեպքում հաճախ կտրամադրենք հնացած տվյալներ, իսկ չափից կարճի դեպքում տարրերը քեշից կհեռացնենք անհրաժեշտից շուտ։ Ավելին, երբ տարրը լքել է քեշը, դրա հաջորդ հարցումը պետք է կատարի հնարավոր է դանդաղ ցանցային կանչ՝ այն նորից ստանալու համար։
Սա կանխելու համար պլանավորված աշխատանքը (scheduled job) կարող է քեշավորված գրառումները թարմացնել կանոնավոր ընդմիջումներով։ Սա հիանալի միջոց է խուսափելու «տաք» քեշի տարրը հեռացնելուց առաջացող լատենտության թռիչքներից։ Այս տեխնիկան հայտնի է որպես refresh-ahead։ Նրա թերությունն այն է, որ երբ տվյալները հազվադեպ են փոխվում, մենք վերջանում ենք բազմաթիվ ավելորդ հարցումներով։
Կարող ենք նաև քեշը թարմացնելու տրամաբանությունը մի փոքր ավելի խելացի դարձնել։ Սկզբից՝ հարցվող սերվիսը պետք է հետ ուղարկի իր վերադարձրած տվյալներից հաշվարկված հեշ կոդ։ Կանչողը կարող է այդ տվյալները քեշում պահել հեշի հետ միասին և հեշը կցել նույն տարրի յուրաքանչյուր հաջորդ հարցմանը։ Այդ դեպքում հարցվող սերվիսը կարող է դրա միջոցով ստուգել՝ տվյալները փոխվե՞լ են։ Եթե ոչինչ չի փոխվել, սերվիսը կարող է պարզապես դատարկ պատասխան ուղարկել։ Եթե գրառումը փոփոխվել է, պետք է պատասխանի տվյալներով։ Այս եղանակով մենք դեռ պետք է ցանցային կանչ կատարենք, բայց այն սովորաբար շատ թեթև կլինի։ HTTP ստանդարտն այս տեսակի «լավատեսական» քեշավորման համար նվիրված մեխանիզմ է առաջարկում (ETag header-ը), թեև այն հեշտ է իրականացնել նաև կապի այլ ուղիներով, օրինակ՝ gRPC-ով։
Մյուս կողմից, եթե գրառումների ժամանակ թարմացնում ենք հիշողության քեշը, ընթերցումները երաշխավորված վերադարձնում են տարրի վերջին տարբերակը, բայց միայն այն ինստանսում, որը կատարում է պահպանումը (single writer)։ Ընթերցող հանգույցները դեռ պետք է իրենց պարունակությունն անվավեր դարձնեն այլ կերպ։ Բաշխված քեշի դեպքում սա նույնպես խնդիր չէ. յուրաքանչյուր ինստանս տեսնում է վերջին թարմացումները։ Պետք է հիշել, որ ինչ-որ բան տվյալների բազայում պահպանելը (կամ հարցում ուղարկելը) և քեշը թարմացնելը մեկ ատոմար գործողություն չեն կազմում։ Եթե սերվիսը թարմացման կեսին խափանվի, քեշը և սկզբնական տվյալները կարող են դուրս գալ համաձայնությունից։
Վերջնական համաձայնեցվածություն
Քեշավորումն անխուսափելիորեն համակարգը բերում է վիճակի, երբ նրա որոշ մասեր տեսնում են հնացած տվյալներ։ Այդ մասերն այլևս չեն պահպանում համաձայնեցվածության ուժեղ երաշխիքներ և դառնում են վերջնականորեն համաձայնեցված (eventually consistent)։ Սա ավելի լավ արտադրողականության և դիմակայունության գինն է։
Միկրոսերվիսային ճարտարապետությունում լավ կանոն է վերջնական համաձայնեցվածությունն ընդունել ամենուր, որտեղ դա գործնական է։ Ուժեղ, սինքրոն կապակցվածությունը պետք է վերապահել այն վայրերին, որտեղ դա իսկապես անհրաժեշտ է։
Տարրերը կարելի է անվավեր դարձնել նաև իրադարձություններին ի պատասխան։ Սա բավականին նրբագեղ մոտեցում է, մասնավորապես իրադարձություններով ղեկավարվող (event-driven) ճարտարապետությունում։ Երբ սկզբնական տարրը փոխվում է, տվյալների սեփականատերը կարող է հրապարակել հաղորդագրություն, որը ծանուցում է բոլոր քեշավորող սերվիսներին, և նրանք վերջնականորեն թարմացնում են իրենց քեշերը։
Այլ սերվիսների պատասխանները «ինչպես կան» քեշավորելը երբեմն լավագույն ընտրությունը չէ։ Միկրոսերվիսները փոխարենը կարող են կառուցել բարդ տվյալների մոդելներ, որոնք ածանցվում են արտաքին տվյալների աղբյուրներից։ Նրանք կարող են տեղեկության կտորներ հավաքել համակարգի տարբեր մասերից և դրանց ապանորմալացված տարբերակը պահել լոկալ տվյալների պահոցում։ Իրադարձություններով ղեկավարվող մոտեցման դեպքում ասինքրոն հաղորդագրություններն այստեղ նույնպես կարելի է օգտագործել՝ ազդարարելու, որ սկզբնական տվյալները փոխվել են։ Սա կարելի է դիտարկել որպես քեշավորման ևս մեկ ձև, միայն թե տվյալները մշտապես պահվում են հարցնող սերվիսի տվյալների բազայում։
Ամփոփում
Այս հոդվածը նախատեսված է որպես քեշավորման հետ կապված տարբեր տեխնիկաների ներածական ակնարկ։ Ես միայն թեթևակի շոշափել եմ այս բարդ թեման և խորը ուսումնասիրությունը թողնում եմ ձեզ։ Հիմնական եզրակացությունն այն է, որ քեշավորումը կարող է զգալիորեն բարձրացնել մեր համակարգի արտադրողականությունը։
Սա հզոր գործիք է, բայց սխալ օգտագործելու դեպքում կարող է հանգեցնել դժվար հայտնաբերվող սխալների։
Հուսով եմ՝ այս հոդվածը օգտակար էր ձեզ համար։ Հաջողություն։