Մարդու դիրքի գնահատում․ ուղեցույց 2023 թվականի համար
Այս հոդվածն անդրադառնում է մարդու դիրքի գնահատման թեմաների լայն շրջանակի՝ հիմնական սահմանումներից և կիրառման օրինակներից մինչև մետրիկաներ և տվյալների հավաքածուներ։
Ի՞նչ է մարդու դիրքի գնահատումը
Մարդու դիրքի գնահատումը (Human Pose Estimation) Համակարգչային տեսողության (Computer Vision) հայտնի խնդիր է, որի պատմությունը ձգվում է ավելի քան 20 տարի։ Այս ոլորտը զբաղվում է մարդու մարմնի հոդերի (օրինակ՝ ծնկների և դաստակների), այսպես կոչված առանցքային կետերի տեղորոշմամբ նկարներում կամ տեսանյութերում։
Մարդու ամբողջ մարմինը ներկայացնելու երեք տարբեր եղանակ կա․
- կմախքային մոդել (կոչվում է նաև կինեմատիկական մոդել)
- եզրագծային մոդել (կոչվում է նաև հարթ մոդել)
- ծավալային մոդել (կոչվում է նաև վոլյումետրիկ մոդել)
ա) կմախքային, բ) եզրագծային, գ) ծավալային | Աղբյուր՝ «A comprehensive survey on human pose estimation»
Մարդու դիրքի գնահատման նպատակն է նախ կառուցել կմախքային ներկայացում, իսկ հետո մշակել այն այնպես, ինչպես պահանջում է կոնկրետ կիրառությունը։ Այսուհետ կխոսենք կմախքային տվյալների հավաքածուների, մետրիկաների և լուծումների մասին։ Կենտրոնանում ենք 2D դիրքի գնահատման վրա, քանի որ 3D մոտեցումները հաճախ սկսվում են 2D ալգորիթմներից և միայն դրանից հետո արդյունքները ռեգրեսիայով տեղափոխում եռաչափ տարածություն։
Ինչո՞ւ է դա բարդ
Մարդու դիրքի գնահատման հիմնական դժվարությունները կապված են հետևյալի հետ․
- ծածկումներ (օկլյուզիաներ),
- մարդու անսովոր դիրքեր (տե՛ս ստորև նկարը),
- առանցքային կետեր, որոնք տեսանելի չեն,
- տարբեր լուսավորություն և հագուստ։
Այս խնդիրները հաղթահարելու համար մասնագետները կամ նոր մեթոդներ են մշակում, կամ ստեղծում են բարդ տվյալների հավաքածուներ, որպեսզի ստացված մոդելները կայուն լինեն նման խնդիրների նկատմամբ։ Ավելի ուշ կդիտարկենք մի քանի լուծում, որոնք այս խնդիրները լուծում են ավելի բարդ ճարտարապետությունների միջոցով։
Աջ ձեռքի և ձախ ոտքի առանցքային կետերը սխալ են կանխատեսվել անսովոր դիրքի պատճառով, Աղբյուր՝ TU Delft
Կիրառման օրինակներ
Արհեստական բանականությամբ անձնական մարզիչներ
Համակարգչային տեսողության վերջին առաջընթացի և ամիսներով փակ մարզասրահների համադրության շնորհիվ տնային մարզումներին օգնող հավելվածները շատ ավելի տարածված դարձան։ Ներքուստ այս բոլոր հավելվածներն օգտագործում են մարդու դիրքի գնահատման մոդել՝ օգտատիրոջ շարժումներին հետևելու, կրկնությունները հաշվելու և տեխնիկայի ուղղումներ առաջարկելու համար։
Kaia health բջջային հավելվածը՝ kaiahealth.de
Լրացված իրականություն և CGI
Լրացված իրականության (Augmented Reality) և CGI-ի համար տվյալներ հավաքելը թանկ է և դանդաղ (օրինակ՝ motion capture տեխնոլոգիա կիրառելիս), ուստի մարդու դիրքի գնահատման մոդելները հաճախ օգտագործվում են ֆիլմերի կամ AR հավելվածների համար ավելի էժան, բայց դեռևս ճշգրիտ ավատարներ ստանալու համար։ Disney Research-ը ուսումնասիրում է, թե ինչպես ստեղծել ավատարներ մարդու դիրքի գնահատման հիման վրա, որպեսզի AR հավելվածներն ավելի մոտ լինեն իրական կյանքին։
Աղբյուր՝ AR Poser
Ինտերակտիվ խաղային փորձառություն
Խաղերն ավելի ընկղմող դարձնելու համար ներկայացվել են մարմնի շարժումները հետևող մի քանի տեսախցիկներ։ Օրինակ՝ Microsoft Kinect-ը ներքուստ օգտագործում է 3D դիրքի գնահատում՝ խաղացողի շարժումներին հետևելու և դրանք խաղի հերոսի գործողությունների վերածելու համար։ Ստորև նկարում փոքրիկ երեխան խաղում է թռչունի պես թռչելու մասին խաղ։
Փոքրիկը խաղում է թռչունի թռիչքի մասին խաղ, Աղբյուր՝ Towards Data Science
Առանց գանձապահի խանութներ
Առանց գանձապահի խանութները, ինչպիսին Amazon GO-ն է, իրենց աճը պարտական են մարդու դիրքի գնահատման առաջընթացին։ Գնորդներին վերլուծելն ու հետևելը թույլ է տալիս որոշել, թե գնորդը որ ապրանքները և քանի հատ է դրել զամբյուղի մեջ։ Արդյունքում մարդիկ կարող են դուրս գալ խանութից՝ առանց վճարելու համար երկար հերթ կանգնելու։
Amazon Go-ն Սիեթլում՝ առանց գանձապահի խանութի նախատիպ։ Աղբյուր՝ Wikipedia
Ագրեսիվ վարքի մոնիթորինգ
Մարդու դիրքի գնահատումը հնարավորություն է տալիս քաղաքներում հայտնաբերել բռնի և վտանգավոր վարքագիծ։ Կարլսրուեի տեխնոլոգիական ինստիտուտը և Մանհայմի ոստիկանության գլխավոր վարչությունը համագործակցում են, և նրանց լուծումը իրական պայմաններում կփորձարկվի 2023 թվականին։
Փողոցային կռիվների հայտնաբերում մարդու դիրքի գնահատմամբ։ Աղբյուր՝ «Where are we with Human Pose Estimation in Real-World Surveillance?»
Տվյալների հավաքածուներ
MPII
MPII հավաքածուն պարունակում է մարդկանց 40 հազար օրինակ, որոնցից յուրաքանչյուրը նշագրված է 16 հոդով։ Ուսուցման և վալիդացիայի հավաքածուները պարունակում են համապատասխանաբար 22 հազար և 3 հազար օրինակ։
COCO
COCO հավաքածուն պարունակում է 200 հազար պատկեր՝ մարդկանց 250 հազար օրինակով, որոնք նշագրված են 17 առանցքային կետով։
Ստորև կարող եք տեսնել, թե ինչով են տարբերվում MPII-ի և COCO-ի մարմնի հոդերի նշագրումները։
Աղբյուր՝ TU Delft
OCHuman
Այս հավաքածուն կենտրոնանում է բարդ, ծածկված օրինակների վրա։ Այն ներկայացվել է 2019 թվականին «Pose2Seg: Detection Free Human Instance Segmentation» հոդվածի հետ։ Այն պարունակում է 5081 պատկեր՝ մարդկանց 10375 օրինակով, որոնցից յուրաքանչյուրը խիստ ծածկված է (MaxIOU >0.5)։
Մետրիկաներ
PCK – ճիշտ առանցքային կետերի տոկոսը (Percentage of Correct Keypoints)
MPII հավաքածուն օգտագործում է այս մետրիկան․ հայտնաբերված հոդը համարվում է ճիշտ, եթե դրա կանխատեսված և իրական դիրքերի միջև հեռավորությունը փոքր է տրված շեմից։ Շեմը մարմնի չափին կապելու համար այն սովորաբար արտահայտվում է գլխի հատվածի երկարության մասով։ MPII հավաքածուի հիմնական մետրիկան PCK@0.5-ն է, ինչը նշանակում է, որ ճիշտ հայտնաբերված են համարվում միայն այն հոդերը, որոնք իրական դիրքից գտնվում են 0.5 ∗ ℎ𝑒𝑎𝑑_𝑏𝑜𝑛𝑒_𝑙𝑒𝑛𝑔ℎ𝑡 հեռավորության սահմաններում։
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mi>O</mi>
<mi>K</mi>
<mi>S</mi>
<mo>=</mo>
<mfrac>
<mrow>
<munder>
<mo data-mjx-texclass="OP">∑</mo>
<mi>i</mi>
</munder>
<mi>e</mi>
<mi>x</mi>
<mi>p</mi>
<mo stretchy="false">(</mo>
<mo>−</mo>
<mfrac>
<msubsup>
<mi>d</mi>
<mi>i</mi>
<mn>2</mn>
</msubsup>
<mrow>
<mn>2</mn>
<msup>
<mi>s</mi>
<mn>2</mn>
</msup>
<mo>∗</mo>
<msubsup>
<mi>k</mi>
<mi>i</mi>
<mn>2</mn>
</msubsup>
</mrow>
</mfrac>
<mo stretchy="false">)</mo>
<mo>∗</mo>
<mi>δ</mi>
<mo stretchy="false">(</mo>
<msub>
<mi>v</mi>
<mi>i</mi>
</msub>
<mo>></mo>
<mn>0</mn>
<mo stretchy="false">)</mo>
</mrow>
<mrow>
<munder>
<mo data-mjx-texclass="OP">∑</mo>
<mi>i</mi>
</munder>
<mi>δ</mi>
<mo stretchy="false">(</mo>
<msub>
<mi>v</mi>
<mi>i</mi>
</msub>
<mo>></mo>
<mn>0</mn>
<mo stretchy="false">)</mo>
</mrow>
</mfrac>
</math>OKS – առարկայի առանցքային կետերի նմանություն (Object Keypoint Similarity)
OKS-ը COCO հավաքածուի հիմնական մետրիկան է։ Այստեղ d-ն i առանցքային կետի կանխատեսված և իրական դիրքերի միջև հեռավորությունն է, v-ն i առանցքային կետի տեսանելիության դրոշակն է, s-ը օբյեկտի մասշտաբն է, իսկ k-ն յուրաքանչյուր առանցքային կետի համար հաստատուն է, որը կառավարում է նվազման արագությունը (հաշվարկվել է COCO հավաքածուի հեղինակների կողմից)։
Պարզ ասած՝ OKS-ը նմանության չափի դեր է կատարում, ինչպես IOU-ն՝ Object Detection-ում և Image Segmentation-ում։ Այս մետրիկան սովորաբար ներկայացվում է միջին ճշգրտության (Average Precision՝ AP@50, AP@75 և @50-ից @95 միջակայքի 10 քայլերի միջինը) և միջին ամբողջականության (Recall, նույն քայլերով, ինչ AP-ն) միջոցով։
Խորը ուսուցման մոդելներ
Մարդու դիրքի գնահատման պատմության ընթացքում շատ լուծումներ կառուցվել են դասական համակարգչային տեսողության հիման վրա՝ կենտրոնանալով մարմնի մասերի, գույնի և կոնտրաստի տարբերությունների վրա։ Սակայն վերջին տարիներին ոլորտում գերիշխող են դարձել խորը ուսուցման լուծումները, ուստի հաջորդ բաժինը կենտրոնանում է դրանց վրա։
Խորը ուսուցման լուծումները բաժանվում են երկու ընտանիքի․
- վերևից ներքև (top-down)՝ նախ հայտնաբերել մարդուն, ապա ընտրված սահմանային շրջանակի (bounding box) ներսում ռեգրեսիայով գտնել առանցքային կետերը։
- ներքևից վերև (bottom-up)՝ գտնել առանցքային կետերը՝ առանց դրանք կոնկրետ անձանց վերագրելու, ապա խմբավորել դրանք առանձին մարդկանց համար։
Վերևից ներքև մոտեցումներ
Ինչպես նշվեց, top-down ընտանիքը ներառում է լավ արդյունքներով բազմաթիվ օրինակներ։ Դրանք բոլորը սովորում են առանցքային կետերի դիրքերի ջերմային քարտեզներից (heatmaps), այլ ոչ թե բուն կոորդինատներից։ Պարզվեց, որ այս մոտեցումը տալիս է զգալիորեն ավելի լավ և կայուն արդյունքներ։ Այստեղ կսահմանափակվենք դիրքի գնահատման 3 ճարտարապետությամբ, որոնք ամենամեծ ազդեցությունն են ունեցել և ձևավորել են մոտեցումների այս ընտանիքը։
Hourglass կառուցվածքի ընդհանուր պատկերը՝ նույնատիպ Hourglass մոդուլների շղթա, որոնք հաջորդաբար նվազեցնում (քայլով կոնվոլյուցիաների միջոցով) և ապա մեծացնում (մոտակա հարևանի ապսեմփլինգով) են լուծաչափը։ Աղբյուր՝ բնօրինակ հոդվածը։
Hourglass մոտեցումն իրականում իրար վրա է դնում մի քանի մոդուլ, որոնք ունեն ճիշտ նույն կառուցվածքը։ Յուրաքանչյուր մոդուլ կատարում է դաունսեմփլինգ և ապսեմփլինգ (ինչի շնորհիվ այն ավազի ժամացույցի տեսք ունի)։ Այս կառուցվածքը որսում է և՛ տեղային համատեքստը (օրինակ՝ որտեղ է դաստակը), և՛ գլոբալ համատեքստը (օրինակ՝ ինչպես է կողմնորոշված մարմինը)։ Ուսուցումը բարելավելու համար յուրաքանչյուր մոդուլից հետո կիրառվում է միջանկյալ վերահսկողություն (intermediate supervision)՝ կանխատեսված ջերմային քարտեզները համեմատելով իրական դիրքերի հետ։
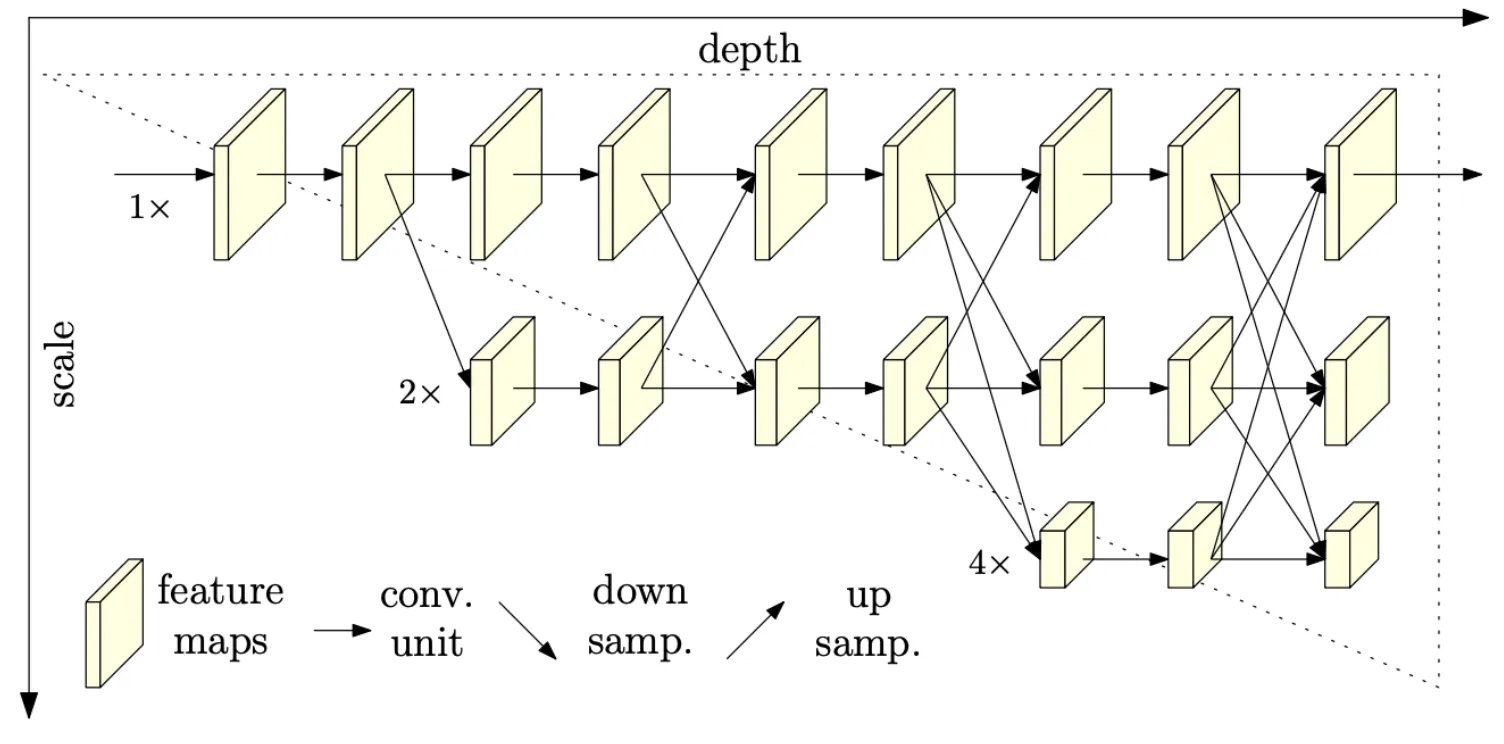
HRNet ճարտարապետությունը․ սլաքը նշանակում է կոնվոլյուցիա, դեպի ներքև սլաքը՝ քայլով կոնվոլյուցիա, իսկ դեպի վերև սլաքը՝ ապսեմփլինգ։ Աղբյուր՝ բնօրինակ հոդվածը
Նախորդ լուծումները շարժվում էին բարձրից դեպի ցածր և կրկին դեպի բարձր լուծաչափ, մինչդեռ այս ճարտարապետությունը փորձում է բարձր լուծաչափը պահպանել ամբողջ ընթացքում, ինչպես ցույց է տրված վերևի նկարում։ Այն սկսում է բարձր լուծաչափից և խորության յուրաքանչյուր քայլում ավելացնում է ավելի շատ զուգահեռ մասշտաբներ, որոնցից յուրաքանչյուրը տեղեկատվություն է ստանում նախորդ քայլերի ավելի բարձր, հավասար կամ ավելի ցածր լուծաչափերից։ Քանի որ բարձր լուծաչափի հատկանիշները հասանելի են յուրաքանչյուր քայլում, HRNet-ը մնացել է HPE-ի մրցակցային աղյուսակների մեծ մասի գագաթին։
(ա) ViTPose ֆրեյմվորքը։ (բ) Տրանսֆորմերի բլոկը։ (գ) Դասական դեկոդերը։ (դ) Պարզ դեկոդերը։ (ե) Դեկոդերներ մի քանի տվյալների հավաքածուի համար, Աղբյուր՝ բնօրինակ հոդվածը
Երբ հայտնվեցին տեսողական տրանսֆորմերները (vision transformers) և տարածում գտան համակարգչային տեսողության մեջ, միայն ժամանակի հարց էր, թե երբ կառաջարկվի «տրանսֆորմեր դիրքի գնահատման համար»։ Այս լուծումը կառուցված է TransformerBlock-ների շարքից (յուրաքանչյուրը համատեղում է Layer Normalization, Multi Headed Self Attention և Feed Forward Network) և դեկոդերի մոդուլից։ Երբ էնկոդերը դուրս է բերում հատկանիշները, կիրառվում է բավականին պարզ դեկոդեր (երկու անգամ՝ Deconvolution շերտ, որին հաջորդում են Batch Normalization և Relu, ապա՝ գծային կանխատեսող շերտ)։ Ցանցը հեշտությամբ մասշտաբավորվում է և չի պահանջում կոնվոլյուցիոն շերտերի խնամքով հավաքում՝ պարամետրերի հաշվարկված քանակով, բայց և այնպես տալիս է շատ ուժեղ արդյունքներ։
Թվում է՝ այն լավ է աշխատում նաև ուժեղ ծածկումներով բազմանձ դիրքի գնահատման դեպքում (այժմ այն առաջատարն է OCHuman հավաքածուում)։
Ներքևից վերև մոտեցումներ
Ինչպես նշվեց, bottom-up մոտեցումները մեկ անցումով ստեղծում են մի քանի կմախք, ինչի շնորհիվ դրանք սովորաբար ավելի արագ են և ավելի հարմար իրական ժամանակի լուծումների համար, ինչպես նաև ավելի լավ են աշխատում մարդաշատ տեսարաններում բազմանձ դիրքի գնահատման ժամանակ։
Ինչպես է OpenPose-ը տրված պատկերի համար ստեղծում մարդկանց կմախքներ՝ մշակման շղթան, Աղբյուր՝ բնօրինակ հոդվածը
OpenPose-ը, հավանաբար, bottom-up մոտեցման ամենահայտնի մոդելն է, քանի որ այն հրապարակվել է որպես բաց կոդով գրադարան 2018 թվականին։ Դրա հանրաճանաչության մի մասը պայմանավորված է նաև նրանով, որ այն առաջին իրական ժամանակի լուծումներից էր, որն առաջարկում էր հուսալի և լայնորեն կիրառելի մարդու դիրքի գնահատում։
Ահա թե ինչպես է աշխատում ճարտարապետությունը․
- նախ առաջին մի քանի շերտերը դուրս են բերում հատկանիշները
- Այնուհետև գալիս են կոնվոլյուցիոն շերտերի երկու ճյուղ․ առաջինը ստեղծում է 18 վստահության քարտեզ (confidence maps), որոնցից յուրաքանչյուրը ներկայացնում է մարդու դիրքի կմախքի որոշակի մաս, իսկ երկրորդը՝ 38 Part Affinity Fields (PAFs), որոնք արտահայտում են մասերի միջև կապի ուժը (առանցքային կետերի միջև կապերի երկկողմանի գրաֆ)։
- Ցածր վստահությամբ կետից կետ կապերը հեռացվում են․ PAF-ները թույլ են տալիս հեռացնել այն կապերը, որոնք, հավանաբար, չեն պատկանում նույն մարդուն։
- Հեռացումից հետո ռեգրեսիայով ստացվում են մարդկանց մի քանի դիրք։
Այս հատկությունները լուծումը դարձնում են լավ ընտրություն իրական ժամանակում բազմանձ դիրքի գնահատման համար։
Omnipose հոդված
Omnipose ճարտարապետությունը, Աղբյուր՝ բնօրինակ հոդվածը
Omnipose-ը ներկայումս bottom-up մոտեցման լավագույն արդյունքներ ցուցաբերող ճարտարապետությունն է, և դրա կառուցվածքը բավականին պարզ է։ Այն սկսվում է երկու 3x3 կոնվոլյուցիայով և ResnetBottleneck բլոկով։ Դրանց հաջորդում են 3 HRNet բլոկներ, որոնցից յուրաքանչյուրը հարստացված է գաուսյան ջերմային քարտեզի մոդուլյացիայով (ներկայացվել է Dark հոդվածում)։ Այս բարելավումը փոխում է առանցքային կետի ճշգրիտ դիրքի որոշման եղանակը․ առավելագույն արժեքը որոնելու փոխարեն (ինչպես անում էին նախորդ լուծումները) այն ենթադրում է, որ տվյալ կետի ջերմային քարտեզը հետևում է գաուսյան բաշխմանը, և փորձում է գտնել այդ բաշխման կենտրոնը։
Omnipose ճարտարապետության հիմնական ներդրումը Waterfall Atrous Spatial Pyramid մոդուլն է (WASPv2), որը ներկայացված է ստորև։
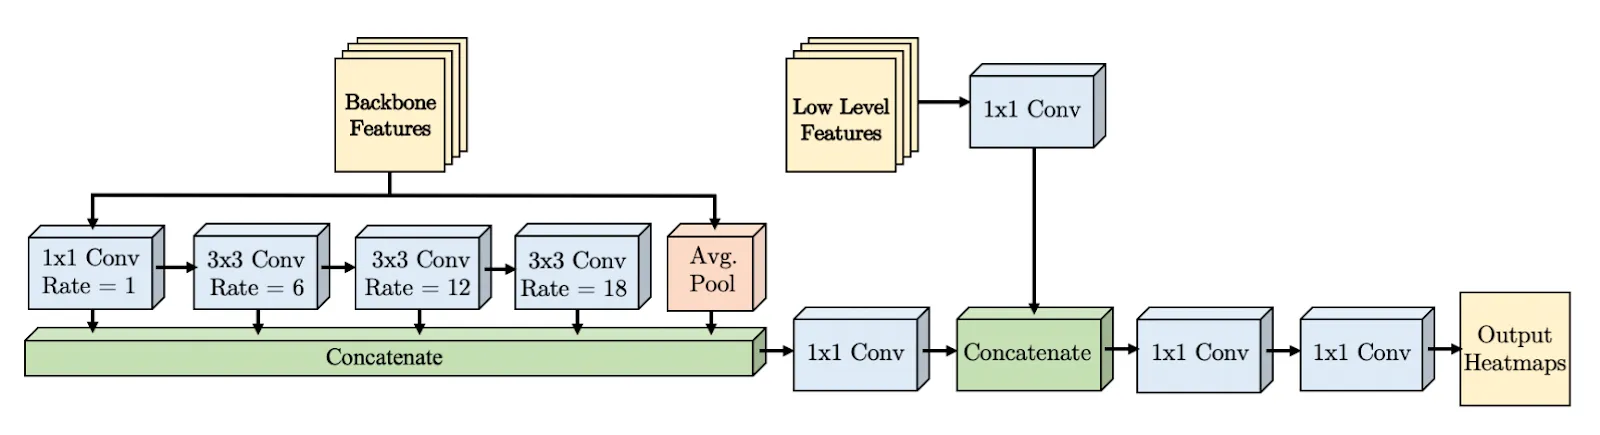
Waterfall Atrous Spatial Pyramid մոդուլը, Աղբյուր՝ բնօրինակ հոդվածը
Մոդուլը մասամբ հիմնված է WASPv1 մոդուլի վրա (առաջին անգամ ներկայացվել է Unipose հոդվածում), բայց ավելացնում է backbone-ի հատկանիշները ցածր մակարդակի հատկանիշների հետ միավորելու գաղափարը։ Այս բոլոր բարելավումների շնորհիվ ճարտարապետությունն այժմ լավագույն արդյունքներ ցուցաբերողների թվում է։
MoveNet հոդված
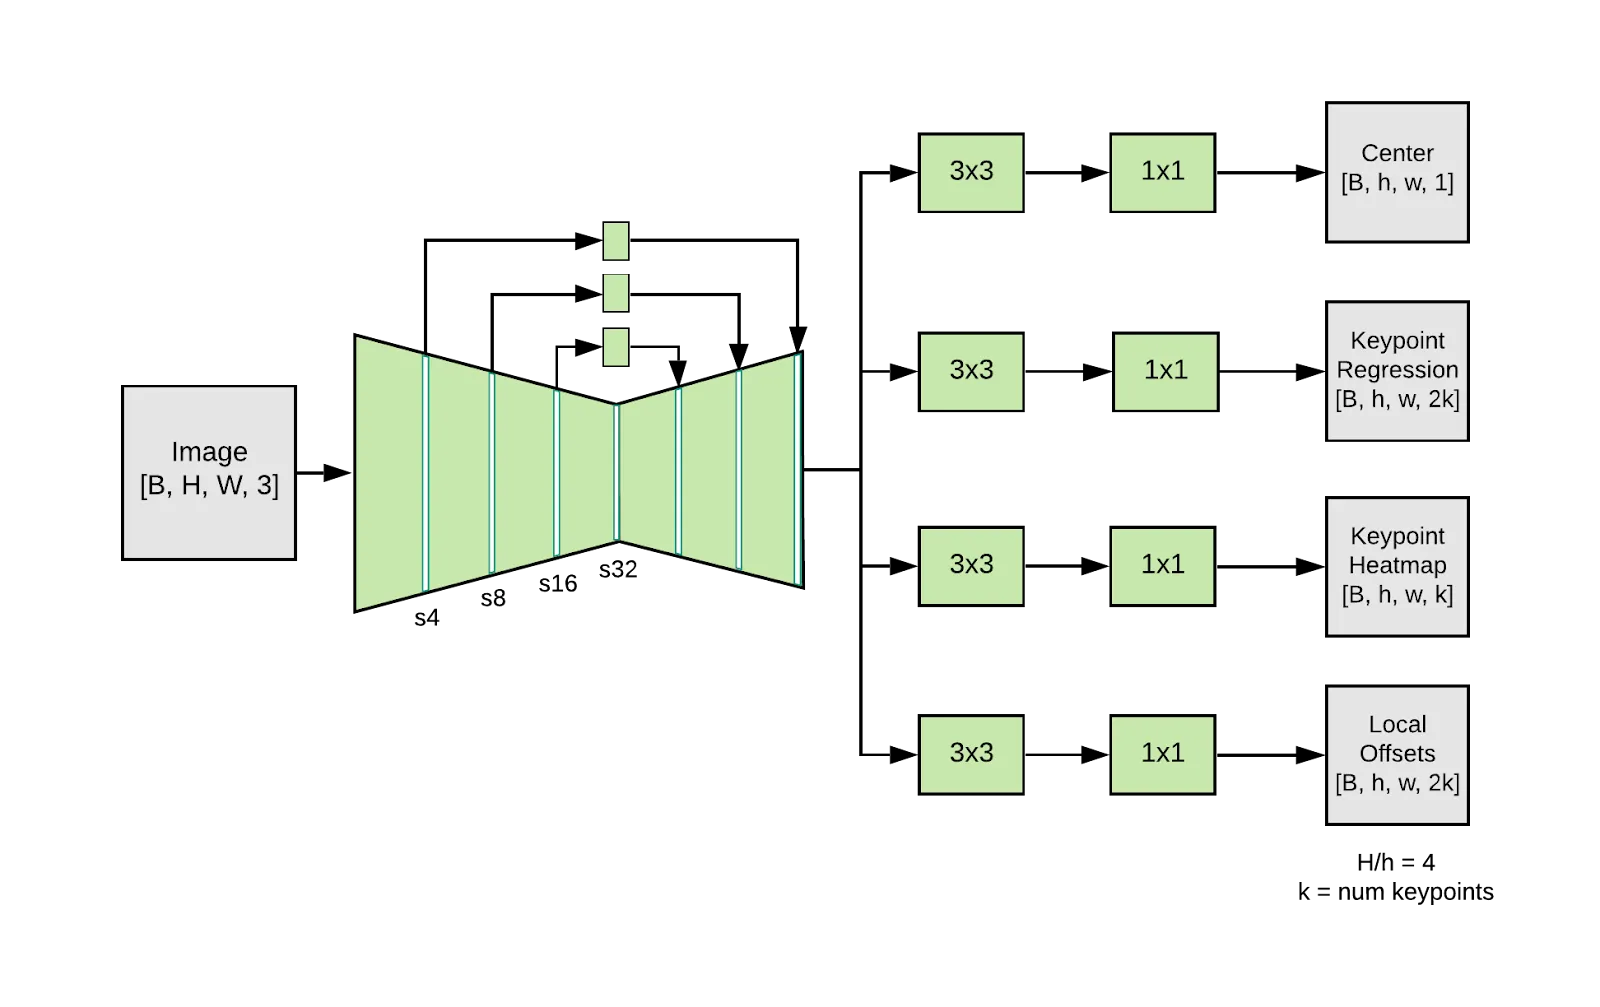
MoveNet ճարտարապետությունը, Աղբյուր՝ Tensorflow բլոգ
MoveNet-ը լայնորեն կիրառվող bottom-up մոտեցման մոդել է, որը մարդու առանցքային կետերը ճշգրիտ որոշելու համար հենվում է ջերմային քարտեզների վրա։ Դրա ճարտարապետությունը բաղկացած է հետևյալից․
- հատկանիշներ դուրս բերող մոդուլ (feature extractor)՝ ըստ էության MobileNetV2՝ համակցված հատկանիշների բուրգային ցանցի (FPN) հետ
- կանխատեսող գլխիկների (prediction heads) հավաքածու՝ CenterNet-ից ոգեշնչված սխեմայի հիման վրա, որը փոքր-ինչ փոփոխված է արագությունն ու ճշգրտությունը բարձրացնելու համար։
4 կանխատեսող գլխիկներն են․
- մարդու կենտրոնի ջերմային քարտեզ,
- առանցքային կետերի ռեգրեսիայի դաշտ, որը կանխատեսում է մարդու առանցքային կետերը,
- մարդու առանցքային կետերի ջերմային քարտեզ, որը կանխատեսում է բոլոր առանցքային կետերը՝ անկախ նրանից, թե որ մարդուն են դրանք պատկանում,
- յուրաքանչյուր առանցքային կետի 2D շեղման դաշտ, որը կանխատեսում է ելքային հատկանիշների քարտեզի յուրաքանչյուր պիքսելից մինչև յուրաքանչյուր առանցքային կետի դիրքը եղած շեղումը։
Activity հավաքածուի պատկերների օրինակներ։ Աղբյուր՝ Tensorflow բլոգ
Ճարտարապետությունը ուսուցանվել է CocoDataset-ի վրա, որը լրացվել է Activity-ով՝ Google-ի փակ հավաքածուով, որը կենտրոնացած է բարդ ֆիթնես և յոգայի դիրքերի վրա։ Նոր ճարտարապետությունը և ուսուցման հուսալի տվյալները միասին այս լուծումը դարձնում են բավականին կայուն ծածկումների և անծանոթ դիրքերի նկատմամբ։ Google-ի թիմը այն հրապարակել է որպես պատրաստի լուծում tf-js-ով։ Մոդելն ունի երկու տարբերակ՝ «lightning»՝ օպտիմալացված արագության համար, և «thunder»՝ ավելի բարձր ճշգրտության համար (միաժամանակ պահպանելով 30+FPS)։ Նրանց կայքում հասանելի է կենդանի դեմո։
Մեր ML թիմի առաջարկած մոդելները
Ակնհայտ է, որ ընտրության համար կան բազմաթիվ լուծումներ։ Մեր առաջարկություններն են․
- Եթե շատ տվյալներ ունեք և կարող եք աշխատել օֆլայն, առաջին ընտրությունը պետք է լինի VIT-ը, Omnipose-ը կամ HRNet-ը։
- Իրական ժամանակի կամ մարդաշատ տեսարանների կիրառությունների համար դիտարկեք MoveNet-ը կամ OpenPose-ը։
- Երբ տվյալները քիչ են, ավելի փոքր մոդելները, հավանաբար, ավելի լավ կաշխատեն (օրինակ՝ MoveNet «lightning», HRNet-32 կամ OmniPose-Lite), կամ ավելի մեծ տարբերակները՝ խնամքով և լայնածավալ աուգմենտացիաների հետ համատեղ։
Ամփոփում
Մարդու դիրքի գնահատումը պահանջկոտ, բայց հետաքրքրաշարժ ոլորտ է, որը հաճախ կիրառվում է սպորտում և խաղերում։ Այս հոդվածն անդրադարձավ թեմաների լայն շրջանակի՝ հիմնական սահմանումներին և մարտահրավերներին, կիրառման մի քանի օրինակի, մոդելները գնահատելու համար օգտագործվող մետրիկաներին և տվյալների հավաքածուներին, ինչպես նաև top-down և bottom-up ամենաազդեցիկ մոտեցումներին, այդ թվում՝ ներկայումս SOTA համարվողներին։