دليل 2023 لتقدير وضعية الإنسان
يتناول هذا المقال مجموعة واسعة من المواضيع حول تقدير وضعية الإنسان – من التعريفات الأساسية، مرورًا بأمثلة الاستخدام، وصولًا إلى المقاييس ومجموعات البيانات.
ما هو تقدير وضعية الإنسان؟
تقدير وضعية الإنسان (Human Pose Estimation) مهمة معروفة في الرؤية الحاسوبية (Computer Vision) يمتد تاريخها لأكثر من 20 عامًا. يتعلق المجال بتحديد مواقع مفاصل جسم الإنسان (مثل الركبتين والمعصمين)، وتسمى النقاط المفتاحية، في الصور أو مقاطع الفيديو.
هناك ثلاث طرق مختلفة لتمثيل جسم الإنسان بالكامل:
- نموذج قائم على الهيكل العظمي (ويُعرف أيضًا بالنموذج الحركي)
- نموذج قائم على الحدود الخارجية (ويُعرف أيضًا بالنموذج المستوي)
- نموذج قائم على الحجم (ويُعرف أيضًا بالنموذج الحجمي)
a) قائم على الهيكل العظمي، b) قائم على الحدود الخارجية، c) قائم على الحجم | المصدر: ” A comprehensive survey on human pose estimation”
هدف تقدير وضعية الإنسان هو بناء تمثيل قائم على الهيكل العظمي أولًا، ثم معالجته بالطريقة التي يتطلبها التطبيق المستهدف. ومن هنا فصاعدًا سنتحدث عن مجموعات البيانات والمقاييس والحلول القائمة على الهيكل العظمي. ونركّز على تقدير الوضعية ثنائي الأبعاد، لأن الأساليب ثلاثية الأبعاد كثيرًا ما تبدأ من خوارزميات ثنائية الأبعاد ثم تُسقط النتائج لاحقًا في الفضاء ثلاثي الأبعاد.
لماذا هو صعب؟
تدور الصعوبات الرئيسية في تقدير وضعية الإنسان حول:
- الحجب (occlusions)،
- الوضعيات غير المعتادة للإنسان (انظر الصورة أدناه)،
- النقاط المفتاحية غير المرئية،
- اختلاف الإضاءة والملابس.
وللتعامل مع هذه المشكلات، يصمّم الممارسون أساليب جديدة أو يبنون مجموعات بيانات صعبة، حتى تتمكن النماذج الناتجة من الصمود أمامها. وسنستعرض لاحقًا عدة حلول تعالج هذه المشكلات عبر معماريات أكثر تطورًا.
النقاط المفتاحية للذراع اليمنى والساق اليسرى جرى التنبؤ بها خطأً بسبب وضعية غير معتادة، المصدر: TU Delft
حالات الاستخدام
مدربون شخصيون مدعومون بالذكاء الاصطناعي
بفضل التقدم الأخير في الرؤية الحاسوبية، ومع إغلاق الصالات الرياضية لأشهر، ازدادت شعبية التطبيقات التي تدعم ممارسة الرياضة في المنزل. وفي الخلفية، يعتمد كل واحد من هذه التطبيقات على نموذج لتقدير وضعية الإنسان لمتابعة حركات المستخدم وعدّ التكرارات واقتراح تصحيحات لأسلوبه.
تطبيق Kaia health للهاتف المحمول: kaiahealth.de
الواقع المعزز والصور المولّدة حاسوبيًا (CGI)
جمع البيانات للواقع المعزز (Augmented Reality) وCGI مكلف وبطيء (مثلًا عند استخدام تقنية التقاط الحركة)، لذلك تُطبَّق نماذج تقدير وضعية الإنسان كثيرًا للحصول على شخصيات رمزية (avatars) أرخص وأدق للأفلام أو تطبيقات الواقع المعزز. وتبحث Disney Research في كيفية توليد شخصيات رمزية انطلاقًا من تقدير وضعية الإنسان لجعل تطبيقات الواقع المعزز أقرب إلى الواقع.
المصدر: AR Poser
تجربة الألعاب التفاعلية
طُرحت عدة كاميرات لتتبع الجسم لجعل الألعاب أكثر انغماسًا. فمثلًا يعتمد Microsoft Kinect داخليًا على تقدير وضعية الإنسان ثلاثي الأبعاد لمتابعة حركات اللاعب وتحويلها إلى أفعال بطل اللعبة. وتُظهر الصورة أدناه طفلًا صغيرًا يلعب لعبة عن الطيران مثل طائر.
طفل صغير يلعب لعبة الطيران مثل طائر، المصدر: Towards Data Science
المتاجر بلا أمين صندوق
تدين المتاجر التي لا تحتاج إلى أمين صندوق، مثل Amazon GO، بنموّها إلى التقدم في تقدير وضعية الإنسان. فتحليل المتسوقين وتتبعهم يتيح تحديد المنتجات التي وضعها الزبون في سلته وعددها. ونتيجة لذلك يستطيع الناس مغادرة المتجر دون الوقوف في طابور طويل للدفع.
Amazon Go في سياتل – نموذج أولي لمتجر بلا أمين صندوق. المصدر: Wikipedia
رصد السلوكيات العدوانية
يتيح تقدير وضعية الإنسان رصد السلوك العنيف والخطير في المدن. يتعاون معهد كارلسروه للتكنولوجيا (Karlsruhe Institute of Technology) ومقر شرطة مانهايم، ومن المنتظر اختبار حلّهما في ظروف واقعية عام 2023.
رصد الشجارات في الشوارع بتقدير وضعية الإنسان. المصدر: “Where are we with Human Pose Estimation in Real-World Surveillance?”
مجموعات البيانات
MPII
تحتوي مجموعة بيانات MPII على 40 ألف شخص، لكل منهم 16 مفصلًا موسومًا. وتضم مجموعتا التدريب والتحقق 22 ألفًا و3 آلاف شخص على التوالي.
COCO
تحتوي مجموعة بيانات COCO على 200 ألف صورة تضم 250 ألف شخص موسومين بـ 17 نقطة مفتاحية.
يمكنك أدناه رؤية الفرق بين وسم مفاصل الجسم في MPII وCOCO.
المصدر: TU Delft
OCHuman
تركّز هذه المجموعة على الأمثلة الصعبة المحجوبة. عُرضت عام 2019 مع الورقة “Pose2Seg: Detection Free Human Instance Segmentation”. وتحتوي على 5081 صورة تضم 10375 شخصًا، وكل واحد منهم محجوب بشدة (MaxIOU >0.5).
المقاييس
PCK - نسبة النقاط المفتاحية الصحيحة
تستخدم مجموعة بيانات MPII هذا المقياس: يُعدّ المفصل المكتشف صحيحًا إذا كانت المسافة بين موقعه المتنبَّأ به وموقعه الحقيقي أقل من عتبة معينة. ولربط العتبة بحجم الجسم، يُعبَّر عنها عادةً بكسر من طول مقطع الرأس. والمقياس الرئيسي لمجموعة MPII هو PCK@0.5، أي أن المفاصل الواقعة ضمن 0.5 ∗ ℎ𝑒𝑎𝑑_𝑏𝑜𝑛𝑒_𝑙𝑒𝑛𝑔ℎ𝑡 من الموقع الحقيقي فقط تُعامل على أنها مكتشفة بشكل صحيح.
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mi>O</mi>
<mi>K</mi>
<mi>S</mi>
<mo>=</mo>
<mfrac>
<mrow>
<munder>
<mo data-mjx-texclass="OP">∑</mo>
<mi>i</mi>
</munder>
<mi>e</mi>
<mi>x</mi>
<mi>p</mi>
<mo stretchy="false">(</mo>
<mo>−</mo>
<mfrac>
<msubsup>
<mi>d</mi>
<mi>i</mi>
<mn>2</mn>
</msubsup>
<mrow>
<mn>2</mn>
<msup>
<mi>s</mi>
<mn>2</mn>
</msup>
<mo>∗</mo>
<msubsup>
<mi>k</mi>
<mi>i</mi>
<mn>2</mn>
</msubsup>
</mrow>
</mfrac>
<mo stretchy="false">)</mo>
<mo>∗</mo>
<mi>δ</mi>
<mo stretchy="false">(</mo>
<msub>
<mi>v</mi>
<mi>i</mi>
</msub>
<mo>></mo>
<mn>0</mn>
<mo stretchy="false">)</mo>
</mrow>
<mrow>
<munder>
<mo data-mjx-texclass="OP">∑</mo>
<mi>i</mi>
</munder>
<mi>δ</mi>
<mo stretchy="false">(</mo>
<msub>
<mi>v</mi>
<mi>i</mi>
</msub>
<mo>></mo>
<mn>0</mn>
<mo stretchy="false">)</mo>
</mrow>
</mfrac>
</math>OKS - تشابه النقاط المفتاحية للكائن
OKS هو المقياس الأساسي لمجموعة بيانات COCO. هنا d هي المسافة بين الموقع المتنبَّأ به والموقع الحقيقي للنقطة المفتاحية i هي علامة ظهور النقطة المفتاحية i، وs هو مقياس الكائن، وهناك ثابت لكل نقطة مفتاحية يتحكم في معدل التناقص (حسبه مؤلفو مجموعة COCO).
ببساطة، يؤدي OKS دور مقياس التشابه، تمامًا مثل IOU في اكتشاف الكائنات (Object Detection) لتجزئة الصور. ويُعرض هذا المقياس عادةً عبر متوسط الدقة (AP@50 وAP@75 والمتوسط على 10 خطوات بين @50 و@95) ومتوسط الاستدعاء (باستخدام الخطوات نفسها كما في AP).
نماذج التعلّم العميق
عبر تاريخ تقدير وضعية الإنسان، بُنيت حلول كثيرة على الرؤية الحاسوبية الكلاسيكية، مركّزة على أجزاء الجسم وعلى الاختلافات في اللون والتباين. أما في السنوات الأخيرة فقد سيطرت حلول التعلّم العميق على المجال، لذا يركّز الجزء التالي عليها.
هناك عائلتان من حلول التعلّم العميق:
- من الأعلى إلى الأسفل (top-down): اكتشاف الشخص أولًا، ثم انحدار النقاط المفتاحية داخل الإطار المحيط المحدد.
- من الأسفل إلى الأعلى (bottom-up): إيجاد النقاط المفتاحية دون تحديد هوية أصحابها، ثم تجميعها في أشخاص منفردين.
أساليب من الأعلى إلى الأسفل
كما ذُكر سابقًا، تضم عائلة top-down أمثلة كثيرة بنتائج جيدة. وتتعلم جميعها من خرائط حرارية (heatmaps) لمواقع النقاط المفتاحية بدلًا من مواقع النقاط المفتاحية نفسها. وقد تبيّن أن هذا النهج يعطي نتائج أفضل وأكثر متانة بشكل ملحوظ. وهنا نقتصر على 3 معماريات لتقدير الوضعية كان لها أكبر تأثير وشكّلت هذه العائلة من الأساليب.
نظرة عامة على بنية Hourglass – سلسلة من وحدات Hourglass المتطابقة البناء التي تخفض الدقة (بالالتفافات ذات الخطوة) ثم ترفعها (بالتكبير بأقرب جار) مرارًا. من: الورقة الأصلية.
يكدّس نهج hourglass في الواقع عدة وحدات تشترك في البنية نفسها تمامًا. تجري كل وحدة تصغيرًا وتكبيرًا للدقة (مما يجعلها تبدو كساعة رملية). ويلتقط هذا التصميم السياق المحلي (مثل موضع المعصم) والسياق العام (مثل اتجاه الجسم). ولتحسين التعلّم، يُطبَّق إشراف وسيط بعد كل وحدة، تُقارن فيه الخرائط الحرارية المتنبَّأ بها بالمواقع الحقيقية.
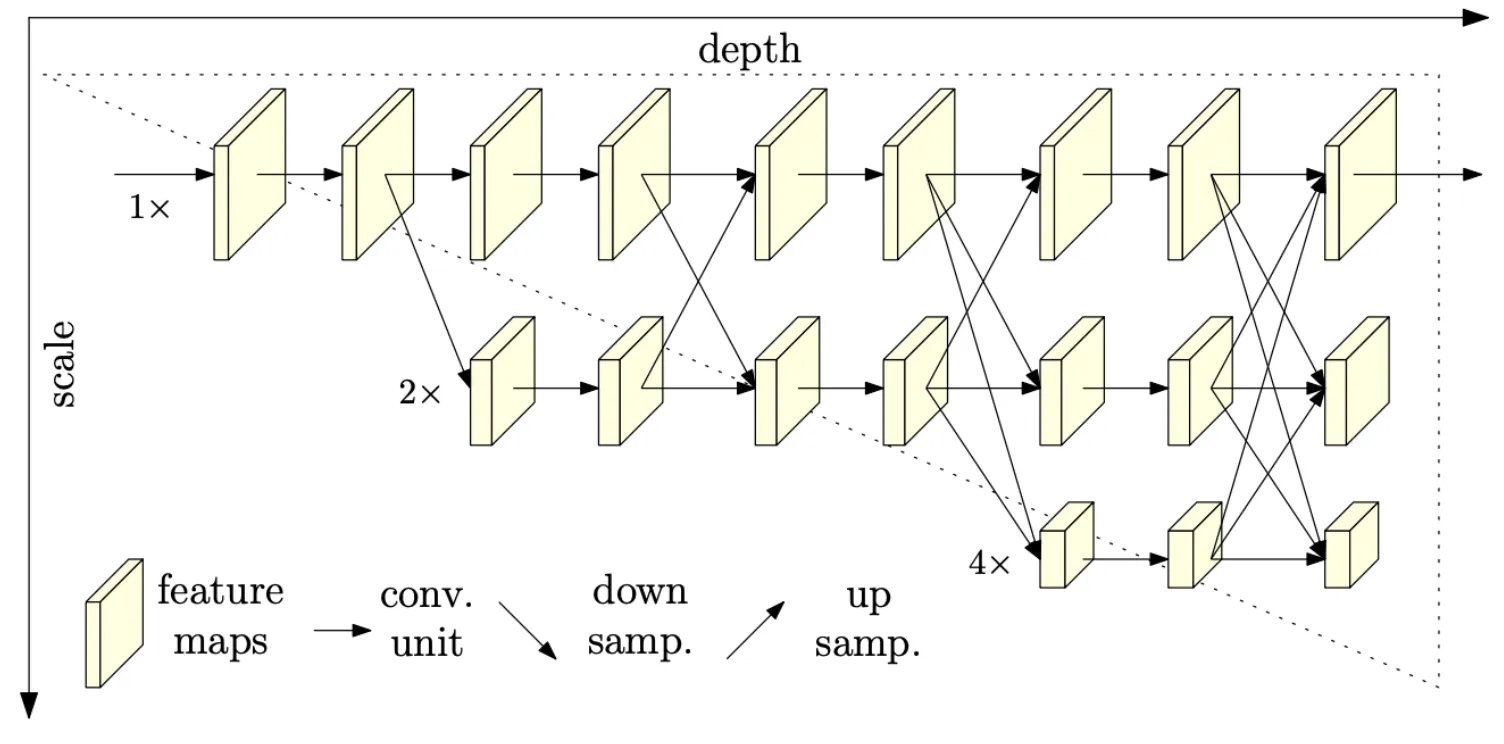
بنية HRNet: السهم يدل على الالتفاف، والسهم الهابط على التفاف بخطوة، والسهم الصاعد على التكبير. المصدر: الورقة الأصلية
انتقلت الحلول السابقة من دقة عالية إلى منخفضة ثم إلى عالية مجددًا، أما هذه المعمارية فتحاول الحفاظ على الدقة العالية طوال العملية، كما يوضح الشكل أعلاه. تبدأ بدقة عالية، وعند كل خطوة عمق تضيف مقاييس متوازية أكثر، يستقبل كل منها معلومات من الدقة الأعلى أو المساوية أو الأدنى في الخطوات السابقة. ولأن الميزات عالية الدقة متاحة في كل خطوة، بقي HRNet في صدارة معظم لوحات المتصدرين في HPE.
(a) إطار ViTPose. (b) كتلة المحوّل (transformer). (c) فك الترميز الكلاسيكي. (d) فك الترميز البسيط. (e) وحدات فك الترميز لعدة مجموعات بيانات، المصدر: الورقة الأصلية
بعد ظهور محوّلات الرؤية (vision transformers) وانتشارها في الرؤية الحاسوبية، كان اقتراح “Transformer for Pose Estimation” مسألة وقت فقط. يتكوّن هذا الحل من مجموعة من TransformerBlocks (تجمع كل منها بين Layer Normalization وMulti Headed Self Attention وFeed Forward Network) إضافة إلى وحدة فك ترميز. وبعد أن يستخرج المرمِّز الميزات، يُطبَّق فك ترميز بسيط نسبيًا (مرتين: طبقة Deconvolution تليها Batch Normalization وRelu، ثم طبقة تنبؤ خطية). تتوسع الشبكة بسهولة ولا تحتاج إلى تجميع طبقات الالتفاف بعناية بعدد محسوب من المعاملات، ومع ذلك تحقق نتائج قوية جدًا.
ويبدو أيضًا أنها تؤدي جيدًا في تقدير وضعية عدة أشخاص مع حجب شديد (فهي تتصدر حاليًا مجموعة بيانات OCHuman).
أساليب من الأسفل إلى الأعلى
كما ورد سابقًا، تولّد أساليب bottom-up عدة هياكل عظمية في تمريرة واحدة، مما يجعلها عادةً أسرع وأنسب للحلول الفورية، كما أنها تتفوق في المشاهد المزدحمة لتقدير وضعية عدة أشخاص.
كيف ينتج OpenPose الهياكل العظمية للإنسان من صورة معينة – خط المعالجة، المصدر: الورقة الأصلية
يُعدّ OpenPose على الأرجح أشهر نموذج بأسلوب bottom-up، إذ نُشر كمكتبة مفتوحة المصدر عام 2018. ويعود جزء من شعبيته أيضًا إلى كونه من أوائل الحلول الفورية التي قدمت تقديرًا موثوقًا وواسع التطبيق لوضعية الإنسان.
هكذا تعمل المعمارية:
- تُستخرج الميزات أولًا بواسطة الطبقات الأولى
- ثم يأتي فرعان من طبقات الالتفاف: الأول ينتج 18 خريطة ثقة، تمثل كل منها جزءًا محددًا من هيكل وضعية الإنسان، والثاني ينتج 38 حقل ارتباط للأجزاء (Part Affinity Fields – PAFs)، تعبّر عن قوة ارتباط الأجزاء (رسم بياني ثنائي الأطراف لوصلات نقطة مفتاحية بنقطة مفتاحية) .
- تُقلَّم وصلات النقطة بالنقطة منخفضة الثقة: تتيح PAFs حذف الوصلات بين النقاط المفتاحية التي يستبعد انتماؤها إلى الشخص نفسه.
- بعد انتهاء التقليم، تُستنتج عدة وضعيات بشرية بالانحدار.
تجعل هذه الخصائص الحل مناسبًا لتقدير وضعية عدة أشخاص في الزمن الفعلي.
Omnipose الورقة
معمارية Omnipose، المصدر: الورقة الأصلية
Omnipose حاليًا أفضل معمارية أداءً بأسلوب bottom-up، وبنيتها بسيطة نسبيًا. تبدأ بالتفافين 3x3 وكتلة ResnetBottleneck. تليها 3 كتل HRNet، تُثرى كل منها بتعديل الخريطة الحرارية الغاوسي (الذي عُرض في ورقة Dark). يغيّر هذا التحسين طريقة تحديد الموقع الدقيق للنقطة المفتاحية: فبدلًا من البحث عن القيمة القصوى (كما فعلت الحلول السابقة)، يفترض أن الخريطة الحرارية لنقطة مفتاحية معينة تتبع توزيعًا غاوسيًا ويحاول تحديد مركز ذلك التوزيع.
والمساهمة الرئيسية لمعمارية Omnipose هي وحدة Waterfall Atrous Spatial Pyramid (WASPv2) الموضحة أدناه.
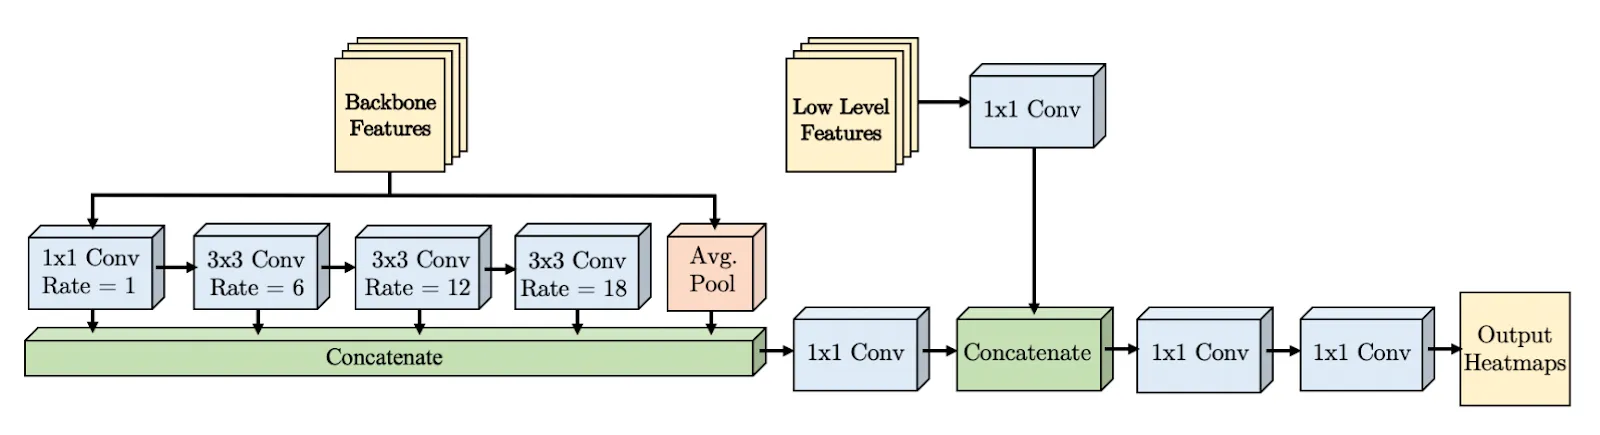
وحدة Waterfall Atrous Spatial Pyramid، المصدر: الورقة الأصلية
تستفيد الوحدة جزئيًا من وحدة WASPv1 (التي عُرضت أول مرة في ورقة Unipose)، لكنها تضيف فكرة دمج ميزات الشبكة الأساسية (backbone) مع الميزات منخفضة المستوى. ومع كل هذه التحسينات، تُصنَّف المعمارية حاليًا بين الأفضل أداءً.
MoveNet الورقة
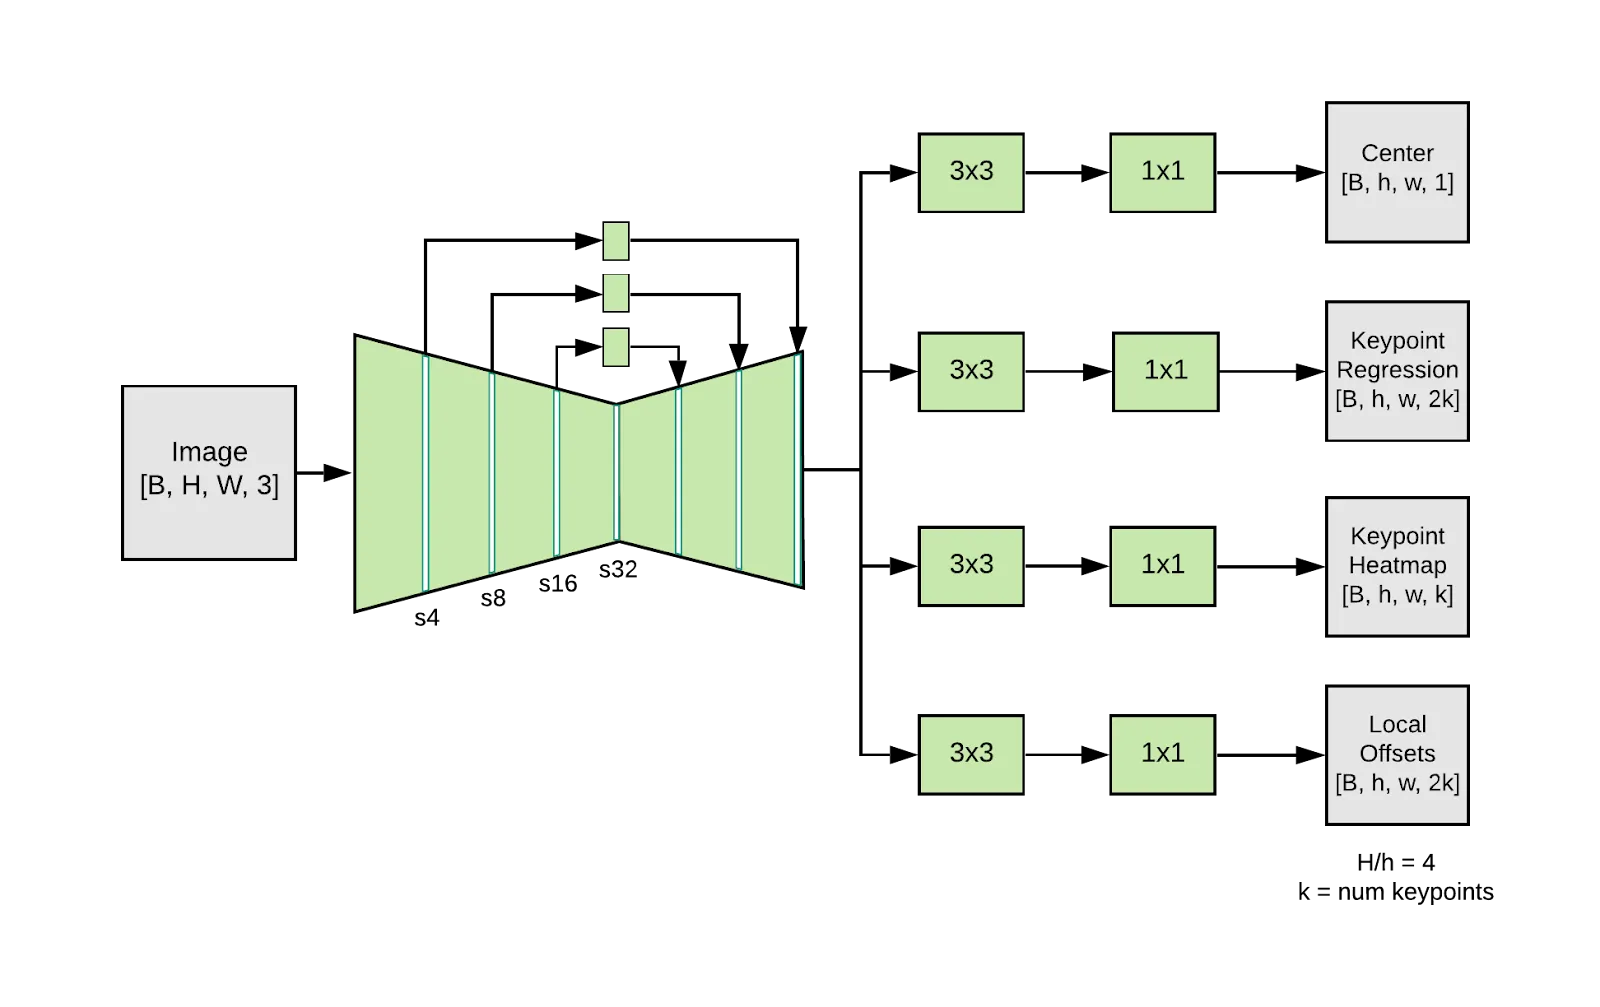
معمارية MoveNet، المصدر: مدونة Tensorflow
MoveNet نموذج واسع الاستخدام بأسلوب bottom-up يعتمد على الخرائط الحرارية لتحديد النقاط المفتاحية للإنسان بدقة. وتتكوّن معماريته من:
- مستخرج ميزات - هو أساسًا MobileNetV2 مع شبكة هرم الميزات (FPN)
- مجموعة رؤوس تنبؤ - مبنية على مخطط مستوحى من CenterNet، معدّل قليلًا لزيادة السرعة والدقة.
رؤوس التنبؤ الأربعة هي:
- خريطة حرارية لمركز الشخص،
- حقل انحدار للنقاط المفتاحية يتنبأ بالنقاط المفتاحية للشخص،
- خريطة حرارية للنقاط المفتاحية للشخص تتنبأ بكل نقطة مفتاحية بغض النظر عن الشخص الذي تنتمي إليه،
- حقل إزاحة ثنائي الأبعاد لكل نقطة مفتاحية يتنبأ بالإزاحة من كل بكسل في خريطة الميزات الناتجة إلى موقع كل نقطة مفتاحية.
صور من مجموعة بيانات Activity. المصدر: مدونة Tensorflow
دُرّبت المعمارية على CocoDataset الموسّعة بـ Activity، وهي مجموعة بيانات خاصة من Google تركّز على وضعيات اللياقة واليوغا الصعبة. وتجعل المعمارية الجديدة مع بيانات التدريب القوية هذا الحل مقاومًا نسبيًا للحجب والوضعيات غير المألوفة. وقد نشره فريق Google كحل جاهز للاستخدام مع tf-js. ويأتي النموذج بنسختين: “lightning” المحسّنة للسرعة، و“thunder” التي تستهدف دقة أفضل (مع الحفاظ على 30+FPS). ويتوفر عرض حي على موقعهم.
اقتراحات فريق تعلّم الآلة لدينا حول النماذج
من الواضح أن هناك مجموعة من الحلول للاختيار بينها. وتوصياتنا كالتالي:
- عند توفر بيانات كثيرة وإمكانية العمل دون اتصال، ينبغي أن يكون VIT أو Omnipose أو HRNet خيارك الأول.
- للتطبيقات الفورية أو المزدحمة، انظر إلى MoveNet أو OpenPose.
- عندما تكون البيانات شحيحة، فالأرجح أن تؤدي النماذج الأصغر أداءً أفضل (مثل MoveNet “lightning” أو HRNet-32 أو OmniPose-Lite)، أو النسخ الأكبر مع تعزيزات بيانات (augmentations) دقيقة وواسعة.
الخلاصة
تقدير وضعية الإنسان مجال صعب لكنه شيّق، ويُطبَّق عادةً في الرياضة والألعاب. وقد تناول هذا المقال مجموعة واسعة من المواضيع: التعريفات الأساسية والتحديات، وعدة حالات استخدام، والمقاييس ومجموعات البيانات المستخدمة لتقييم النماذج، وأكثر أساليب top-down وbottom-up تأثيرًا، بما فيها تلك التي تمثل حاليًا أحدث ما توصل إليه المجال (SOTA).