Տվյալների մշակման արդյունավետ pipeline-ների կառուցումը Elixir-ով և Broadway-ով
Ի՞նչ է Broadway-ը Elixir-ում։ Բացահայտեք, թե ինչ կարող է անել այս Elixir գրադարանը. այն թույլ է տալիս ընդունել տվյալներ և կառուցել դրանց մշակման pipeline-ներ։
Այս հոդվածում ես կդիտարկեմ, թե ինչ կարող է անել Broadway-ը. դա Elixir-ի մոտեցումն է տվյալների ընդունման և մշակման pipeline-ներ կառուցելու համար։
Broadway-ը թույլ է տալիս մշակողներին կառուցել և կառավարել տվյալների pipeline-ներ՝ GenStage-ի վրա բարդ տոպոլոգիաներ կազմելով։ Ըստ էության, Broadway-ը GenStage-ի վրա ավելացնում է ևս մեկ աբստրակցիայի շերտ, որը մեծապես պարզեցնում է GenStage-ի բարդ տոպոլոգիաները (մասնավորապես՝ backpressure, batching և graceful shutdown)։ Այն աջակցում է բազմաթիվ աղբյուրներից եկող տվյալների զուգահեռ, բազմափուլ մշակում, օրինակ՝ հաղորդագրությունների հերթերից, հոսքային պլատֆորմներից և ամպային սերվիսներից։ Broadway-ը ձեր փոխարեն հոգ է տանում pipeline-ի օրկեստրացիայի, զուգահեռականության, սխալակայունության և back-pressure-ի մասին։ Այն ստեղծվել է տվյալների ընդունման և մշակման աշխատանքների համար մասշտաբավորվող, հուսալի և օգտագործման մեջ պարզ լինելու նպատակով։
Broadway-ի հիմնական ներկառուցված հնարավորություններն են.
- Back pressure
- Ավտոմատ հաստատում (acknowledgment)
- Սխալակայունություն
- Graceful shutdown
- Ներկառուցված թեստավորում
- Ձախողումների սեփական մշակում
- Ստատիկ և դինամիկ batching
- Դասավորում և պարտիցիոնավորում
- Rate Limiting
- Մետրիկաներ
Այս հնարավորություններից մի քանիսը ուսումնասիրելու համար կկառուցենք մի փոքր Phoenix հավելված, որը հաղորդագրություններ է ստանում Google PubSub subscription-ից և անցկացնում դրանք մեր pipeline-ով։ Այն կներառի հաղորդագրությունների batch նախամշակում, առանձին հաղորդագրությունների մշակում, ստատիկ batch մշակում, ձախողումների սեփական մշակում և պարտիցիոնավորում։ Վերջում կմիացնենք Broadway Dashboard-ը, որը թույլ է տալիս իրական ժամանակում տեսնել pipeline-ը և նկատել հնարավոր խցանումներն ու հաղորդագրությունների թողունակությունը։
Հիմնական կարգավորում
GCP Credentials և PubSub Subscription
Եթե ցանկանում եք կոդի օրինակներին հետևել, նախ պետք է Google IAM-ով ստեղծել Google Service Account։ Service account-ը պետք է Նյու Յորքի տաքսիների իրադարձություններով հանրությանը հասանելի թոփիքի subscription ստեղծելու համար։ Այստեղ չեմ բացատրի, թե ինչպես այն կարգավորել Google console-ում։ Պարզապես հետևեք subscription ստեղծելու քայլերին։
Եթե արդեն ծանոթ եք Google GCP-ին, հիմնական քայլը առկա թոփիքին subscription ստեղծելն է՝ projects/pubsub-public-data/topics/taxirides-realtime։
Նկատի ունեցեք, որ ձեր subscription-ը հսկայական թվով հաղորդագրություններ կստանա, ուստի խստորեն խորհուրդ եմ տալիս փորձարկումներն ավարտելուց հետո ջնջել այս ձեռնարկի համար ստեղծված բոլոր ռեսուրսները։
Երբ ունենաք subscription-ի անունը և service account-ի credentials-ով .json ֆայլը, կարող եք շարունակել։
Phoenix հավելված
Սկսում ենք հիմնական Phoenix հավելվածից։ Broadway pipeline-ներին Phoenix պարտադիր չէ, բայց այսպես կարգավորելը Phoenix Dashboard-ի օգտագործումը շատ ավելի պարզ է դարձնում։
Այս ձեռնարկում չեն օգտագործվում html view-եր և տվյալների բազաներ, ուստի ecto չկա։
Երբ կմախքային հավելվածը գեներացվի, պետք է ավելացնել անհրաժեշտ կախվածությունները։ Ավելացրեք հետևյալը ձեր mix.exs ֆայլում.
և գործարկեք mix deps.get, որպեսզի ձեր Phoenix հավելվածը ներբեռնի իրեն անհրաժեշտ կախվածությունները։
Տվյալների ընդունման հիմնական pipeline
Broadway behaviour-ի տիպային իրականացումը (որը կարող եք գտնել նաև Broadway-ի github էջերում) այսպիսին է.
start_link-ում կարգավորվում է ձեր producer-ը և սահմանվում է ձեր մշակման pipeline-ի ամբողջ տոպոլոգիան։ Կարող եք կա՛մ գրել սեփական producer, կա՛մ ընտրել առկա կոնեկտորներից մեկը.
- Amazon SQS
- Apache Kafka
- Google Pub/Sub
- RabbitMQ
Այստեղ մենք կօգտագործենք Google Pub/Sub-ի պաշտոնական Broadway կոնեկտորը։
Երբ օգտագործում եք լռելյայն producer-ը և batcher-ը՝ concurrency-ն 1-ի հավասար,
վերը նշված կոնֆիգուրացիայի համար ձեր pipeline-ի տոպոլոգիան այսպիսին է.
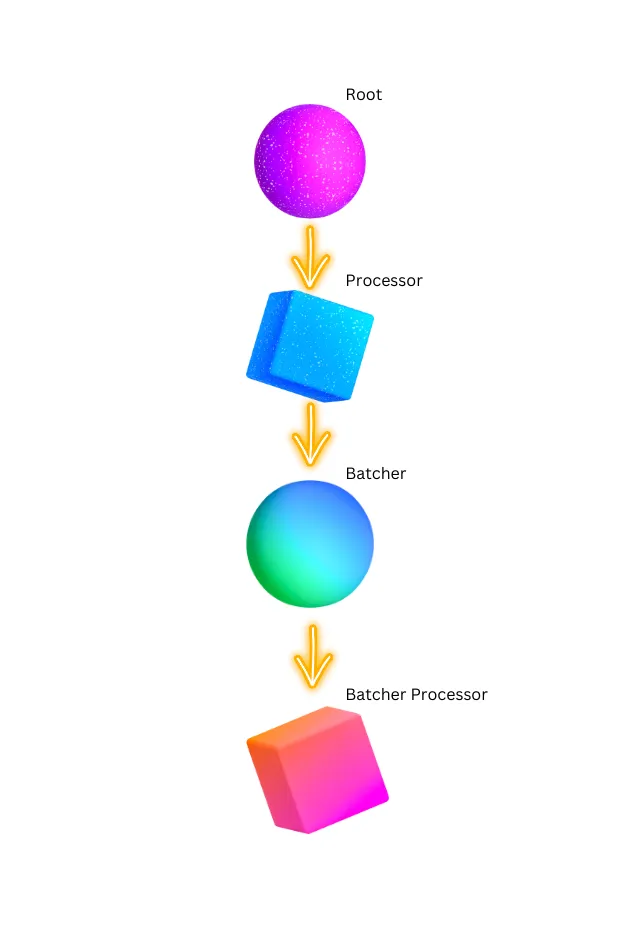
Այսքան պարզ supervision tree-ն ըստ էության ձեզ տալիս է մեկ processor և մեկ batcher, որոնք անցկացնում են ձեր pipeline-ը։ Ցանկացած տրամաբանություն, որ դնում եք handle_message-ում, կատարվում է ձեր processor actor-ի ներսում, իսկ handle_batch-ում արածը մշակվում է supervision tree-ի ավելի ներքևում՝ ձեր batcher-ի կողմից։ Batcher-ի վերադարձրած յուրաքանչյուր հաղորդագրություն հաստատվում է ավտոմատ, թեև այս վարքը կարելի է վերասահմանել. դրան կանդրադառնանք ավելի ուշ։
Բնականաբար, այսպիսի տոպոլոգիան չի օգտագործում մեր տրամադրության տակ եղած լավագույն գործիքը՝ Elixir-ի և GenStage-ի տրամադրած զուգահեռականությունը։ Broadway-ը հիանալի է նրանով, որ շատ ավելի բարդ տոպոլոգիաներ կարելի է սահմանել՝ պարզապես փոխելով start_link-ի կոնֆիգուրացիան։ Ստորև ներկայացված է այն տոպոլոգիան, որը կկառուցենք այս ձեռնարկում.
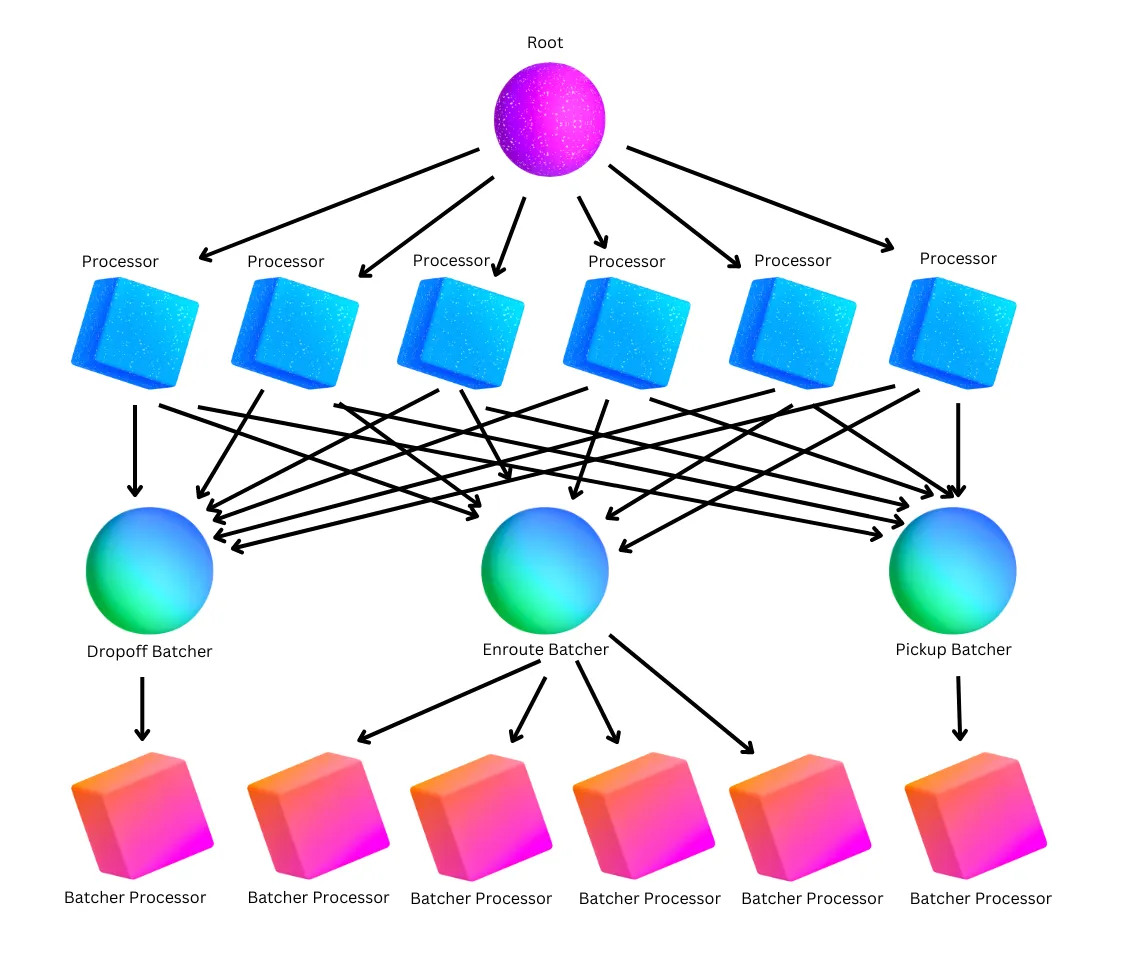
Դիագրամը ընթեռնելի պահելու համար դրանից դուրս են թողնված սխալների սեփական մշակումը և պարտիցիոնավորումը, որոնք կավելացնենք նախագծին. այդուհանդերձ, սկսենք նկարագրելով, թե ինչ ենք կառուցելու։
Տվյալները
Սկզբում, պարզության և հղման համար, ահա թե ինչպիսի տեսք ունի Google subscription-ից եկող մեկ օրինակային հաղորդագրությունը.
Մեր pipeline-ը կանի հետևյալը.
- Շարդավորում processor-ի մակարդակում ըստ
ride_id-ի, որպեսզի տրված ride_id-ն միշտ հայտնվի նույն processor ինստանսի վրա։ - Հաղորդագրությունների նախամշակում հատուկ
prepare_messages(messages, _context)մեթոդով, որը մեր դեպքում JSON տողը վերլուծում է Elixir map-ի։ - Յուրաքանչյուր հաղորդագրության ուղարկում ճիշտ batcher-ին՝ ըստ նրա
ride_status-ի - Սեփական սխալների մշակում
handle_failed(messages, _context)-ով, երբride_status-ը անհայտ է - Արդյունքների տպում յուրաքանչյուր batcher-ում և հաղորդագրության հաստատում։
Մեր տոպոլոգիայի բացատրությունը
Ինչպես ցույց է տալիս նախորդ նկարը, մենք մեր հաղորդագրությունները մշակող processor-ների թիվը բարձրացրինք մինչև 6, այնուհետև յուրաքանչյուր հաղորդագրություն ուղղվում է որոշակի batcher-ի՝ ըստ իր պարունակության։ Google Pub/Sub-ը մեզ ուղարկում է հաղորդագրությունների 3 տեսակ.
- Pickup իրադարձություն
- Enroute իրադարձություն
- Dropoff իրադարձություն
Յուրաքանչյուր տեսակի batch-երը մշակվում են առանձին batcher-ներում։
Կարևոր կետն այն է, որ batching-ը թույլ է տալիս թողունակությունն էլ ավելի բարձրացնել՝ շատ տվյալներ մեկ գործողությամբ մշակելով, օրինակ՝ մի քանի հաղորդագրություն միանգամից տվյալների բազա ավելացնելով այն բանից հետո, երբ processor-ը դրանք մշակել և պատրաստել է handle_message-ում։ Այս ձեռնարկում մենք պարզապես տպում ենք մշակված հաղորդագրությունների պարունակությունը և հաստատում դրանք։
Մենք գիտենք, որ Google-ից եկող հոսքում հաղորդագրությունների մեծ մասը enroute են, ուստի pickup-ը և dropoff-ը շատ batch processor-ների կարիք չունեն, քանի որ նրանք աշխատանքի միայն փոքր մասն են կատարում. դրա համար pickup և dropoff batcher-ների concurrency-ն դրված է 1։ enroute batcher-ը իր աշխատանքի համար ստանում է 4 առանձին processor։
Կոնֆիգուրացիան շատ պարզ է. ինչպես նշվեց, կան 6 processor-ներ, որոնք տվյալներ են ստանում Pub/Sub producer-ներից, և 3 առանձին batch-եր՝ յուրաքանչյուրն իր processor-ների քանակով։ Կարող եք ազատորեն փոխել այս թվերը և Broadway Dashboard-ում դիտել pipeline-ը կենդանի, որպեսզի արագ նկատեք հնարավոր խցանումները և անհրաժեշտության դեպքում վերաձևեք ձեր տոպոլոգիան։
Կոդի բացատրությունը
Թեև pipeline-ը բավական բարդ է, դրա տրամաբանությունն իրականացնելու համար պահանջվեց Elixir-ի միայն մի քանի մեթոդ։ Նախքան հենց Elixir կոդին անցնելը, տեսնենք, թե ինչպես է կարգավորվում միացումը մեր Google Pub/Sub subscriber-ին.
Նախամշակում
prepare_messages մեթոդով Broadway-ը թույլ է տալիս հաղորդագրությունները նախամշակել batch-երով։ Այստեղ կարող եք վերլուծել հաղորդագրությունը կամ հարստացնել այն լրացուցիչ տվյալներով, նախքան այն մշակման ծառի միջով փոխանցելը processor-ին, օրինակ՝ ավելացնելով տվյալների բազայից բեռնված օգտատիրոջ տվյալները։
prepare_messages-ի կարևոր կողմն այն է, որ այն աշխատում է հաղորդագրությունների batch-ի վրա, այլ ոչ թե մեկ հաղորդագրության, ինչը կարող է բարձրացնել թողունակությունը, եթե կարողանանք տվյալների բազայից շատ գրառումներ բեռնել մեկ կանչով։ Ուշադրության արժանի ևս մեկ տող է Broadway.Message.update_data-ն, որը թարմացնում է Broadway message struct-ի data դաշտը։ prepare_message-ից վերադարձված հաղորդագրությունները անցնում են processor-ներին, որտեղ նրանցից յուրաքանչյուրի համար աշխատում է handle_message-ը։
Jason.decode-ը կարող է վերադարձնել տարբեր տեսակի արժեքներ (կա՛մ :ok, կա՛մ :error), և դրանք մշակվում են handle_message-ի առանձին իրականացումներով՝ Elixir-ի հզոր pattern matching-ի շնորհիվ։
Handle message
Մենք իրականում սահմանեցինք handle_message-ի 2 տարբերակ, և որն աշխատի, կախված է նրանից, թե ինչ է վերադարձրել prepare_messages-ի տրամաբանությունը։ Երբ JSON-ի վերլուծությունը հաջողվում է, հաղորդագրությունն ուղղվում է համապատասխան batcher-ին. հակառակ դեպքում մենք օգտվում ենք Broadway-ի սեփական սխալների մշակումից և հաղորդագրությունը նշում ենք որպես ձախողված։ Ձախողված հաղորդագրությունները մշակվում են լրացուցիչ մեթոդով, որը նկարագրված է ստորև։
Handle failed
Մեր իրականացումը պարզապես ընտրում է ‘invalid-data’ նշագրված ձախողված հաղորդագրությունները, տպում և հաստատում է դրանք։ Այսպես կարող եք կառուցել սեփական սխալների մշակում և ընտրել, թե ինչ տեղի ունենա սխալի յուրաքանչյուր տեսակի դեպքում, օրինակ՝ հաստատել, նորից ուղարկել կամ պահել հետագա վերլուծության համար։
Handle batch
Երբ handle_message-ը մշակում է հաղորդագրությունները, դրանք նորից խմբավորվում են batch-երի և մշակվում ծառի ավելի ներքևում՝ batcher-ներում։ Այստեղ մենք օգտագործեցինք ստատիկ batching. batcher-ների անունները թվարկված են կոնֆիգուրացիայում, և յուրաքանչյուր batcher executor ունի իր մեթոդը։ Batcher-ներից վերադարձված հաղորդագրությունները հաստատվում են ավտոմատ։
Պարտիցիոնավորում
Մի քիչ ավելի հետաքրքիր դարձնելու համար մենք ավելացրինք պարտիցիոնավորման մի ձև։ Պարտիցիոնավորումը կարելի է սահմանել producer-ների և batcher-ների համար. կա՛մ երկու առանձին մեթոդ երկուսի համար կամ միայն մեկի համար, կա՛մ մեկ partition մեթոդ, որը դրվում է ձեր կոնֆիգում processor-ների և batcher-ների կոնֆիգուրացիայից հետո, և երկուսն էլ օգտագործում են այն։ Վերջին դեպքում հիշեք, որ partition-ում ստացած հաղորդագրությունը սկզբում producer-ի մեջ մտնողն է, իսկ հետո՝ batcher-ի մեջ մտնողը, ուստի զգույշ եղեք, եթե handle_message մեթոդում հաղորդագրությունները փոփոխում եք թռիչքի ժամանակ։
partition մեթոդը պետք է վերադարձնի ամբողջ թիվ. եթե ձեր հաղորդագրության մարմնում օգտագործելու համար այդպիսին չկա, կարող եք տողը հեշավորել Erlang-ի ներկառուցված :erlang.phash2 մեթոդով։
Broadway-ի ինտեգրացիա
Երբ մեր մոդուլի բոլոր մեթոդներն իրականացված են, կարող ենք այն միացնել մեր Phoenix հավելվածին։ Գեներացված Phoenix ֆայլերում պահանջվում են մի քանի փոփոխություններ՝ սկսած application.ex-ից
Մեր սեփական Broadway մոդուլը՝ BroadwayPubSubSimple-ը, պետք է ավելացվի որպես child Phoenix հավելվածի children ցուցակում։
Broadway Dashboard
Ինչպես սկզբում ասվեց, մենք ավելացնում ենք Broadway Dashboard՝ մեր pipeline-ի տոպոլոգիան պատկերացնելու համար։ Եթե կախվածությունն ավելացրել եք վերը նկարագրածի պես, ձեզ մնում է միայն փոխել route.ex-ը և Phoenix-ի ներկառուցված live dashboard-ին ավելացնել additional_pages։ Արդյունքում ձեր սովորական Phoenix dashboard-ում հայտնվում է նոր ներդիր, որտեղ կարող եք հետևել ձեր pipeline-ներին։
Հավելվածի գործարկումը
Երբ մեր Broadway մոդուլն իրականացված է և ավելացված Phoenix-ին, ինչպես նաև Broadway Dashboard-ի համար մի փոքր լրացուցիչ կոնֆիգուրացիա կա, կարող եք գործարկել հավելվածը և կենդանի դիտել, թե ինչպես է pipeline-ը հաղորդագրություններ մշակում։
Նախ Google Pub/Sub-ի credentials-ը հասանելի դարձրեք որպես միջավայրի փոփոխական՝ արտահանելով այն ձեր shell-ում, ապա գործարկեք Phoenix հավելվածը.
Subscription-ից հաղորդագրությունների մշակումը սկսվում է անմիջապես։ Բացեք ձեր Phoenix dashboard-ը և անցեք Broadway pipelines ներդիր՝ մեր տոպոլոգիայի աշխատանքը դիտելու համար։
Պարտիցիոնավորման աշխատանքը ցույց տալու համար ես լոգերը ֆիլտրեցի մեկ ride_id-ով (այստեղ ”732c74e0-d54c-439c-b950-340f30c201c3”)
Քանի որ լոգի յուրաքանչյուր տող ներառում է PID, մենք տեսնում ենք, որ տրված ride_id-ն միշտ մշակվում է նույն processor-ի կողմից։ Պարտիցիոնավորումը կարգավորված է միայն processor-ի մակարդակում, ուստի երբ հաղորդագրություններն ծառի միջով իջնում են batcher-ի շերտ, պարտիցիաներն այլևս նշանակություն չունեն, և նույն ride_id-ն մշակվում է տարբեր batch actor-ների կողմից։
Վերջին նկատառումներ
Broadway-ը նրբագեղ կերպով լուծում է supervision tree-ների կառուցվածքի հարցը՝ զուգահեռականությունը, սխալակայունությունը և նախկինում նշված մյուս հնարավորությունները տալով պատրաստի վիճակում։ Թեև մեր կառուցած pipeline-ը բավական պարզ է և ցուցադրում է Broadway-ի հիմնական ֆունկցիոնալությունը, մենք չանդրադարձանք շատ կարևոր հնարավորությունների, օրինակ՝ դինամիկ batching, graceful shutdown և rate limiting՝ թվարկելով միայն մի քանիսը։ Դրանք կսպասեն Broadway-ի հետ իմ հետաքրքիր արկածի հետագա հոդվածներին։