Ծախսերի կրճատում ավելի քան 90%-ով՝ Google API-ները LLM-ի վրա հիմնված միկրոսերվիսով փոխարինելով
Թանկարժեք Google API-ները LLM միկրոսերվիսով փոխարինելը ծախսերը կրճատեց 90%-ով. տեսեք, թե ինչպես Gemini AI-ն դա հնարավոր դարձրեց։
Մենք Google-ի երկու առանձին սերվիսների օգտագործումը փոխարինեցինք մեկ փոքր միկրոսերվիսով, որը գործում է LLM-ի՝ Gemini AI-ի (որը նույնպես Google-ից է) վրա։ Արդյունքը՝ ծախսերը նվազեցին ավելի քան 90%-ով, իսկ ճկունությունը աճեց՝ ընդամենը մի քանի օրվա աշխատանքից հետո։
Ներածություն
Մեր հաճախորդի GCP billing հաշվի սովորական վերանայման ժամանակ ուշադիր նայեցի Google-ի մի քանի պատրաստի API-ների, որոնցից մենք օգտվում ենք լեզուների թարգմանության (Cloud Translation API) և տրամադրության վերլուծության (sentiment analysis, Cloud Natural Language API) համար։ Բիզնես տրամաբանության որոշ մասերի վերջին փոփոխությունները, ինչպես նաև այն հնարավորությունները, որոնք մտադիր էինք ստեղծել ամռանը, նշանակում էին, որ այդ սերվիսների արժեքը կտրուկ կաճի, և ես պետք է գնահատեի, թե որքանով, որպեսզի ավելի լավ պատրաստված լինեինք այսպես կոչված «բիզնեսի» հետ արտադրանքի քննարկումներին։
Սկզբում Google-ի երկու API-ների հետ մեր աշխատանքային հոսքը պարզ էր. օգտատիրոջ տեքստը թարգմանել անգլերեն, ապա դրա վրա կատարել տրամադրության ստուգում։ Թարգմանությունը կար միայն այն պատճառով, որ sentiment API-ն չէր աջակցում տեքստի բնօրինակ լեզուն։ Երբ տեքստը կասկածելի էր թվում (վիրավորական, անպարկեշտ կամ կասկածելիորեն փայլեցված), այն նշում էինք մարդկանց թիմի կողմից վերանայման համար։
Հետագայում մենք մտադիր էինք Translation API-ն օգտագործել շատ ավելի շատ վայրերում, և այս սերվիսների կանչերի ծավալը պետք է էքսպոնենցիալ աճեր։ Մենք ուզում էինք բարելավել UX-ը՝ թարգմանելով 12 լեզվով՝ պահպանելով sentiment analysis-ը։ Սա կնշանակեր օրական հազարավոր API կանչեր միայն թարգմանությունների համար (մենք քեշավորում ենք արդյունքները և թարմացնում դրանք միայն երբ սկզբնական տեքստը փոխվում է)։
Երբ վերլուծեցինք ներկայիս և սպասվող կանչերի ծավալները, հասկացանք, որ մեկ LLM-ի վրա հիմնված սերվիս կարող է փոխարինել երկու API-ներին էլ։ Ես պետք է արագ Proof-of-Concept (PoC) հավաքեի՝ տեսնելու, թե ինչ կարժենա նույն ֆունկցիոնալությունը ստանալ API-ով պարզ LLM կանչերի միջոցով։
Նոր PoC միկրոսերվիսի բիզնես պահանջները պարզ էին.
- աջակցել 12 լեզվի,
- իրականացնել sentiment analysis (նախընտրելի է մեկ կանչով՝ երկուսի փոխարեն),
- համեմատել ծախսերը ընթացիկ կառուցվածքի հետ։
Նախապատմություն և նախկին կառուցվածքը
Միգրացիայից առաջ ճարտարապետությունը աննշան էր։ Մեր միկրոսերվիսներից մեկը ստանում էր հաղորդագրություն ստուգվելիք տեքստով, կանչում էր Google Translation API-ն՝ տեքստի անգլերեն տարբերակը ստանալու համար, ապա երկու անգամ կանչում էր Cloud Natural Language API-ն՝ մեզ հետաքրքրող տրամադրության վերլուծության տարբեր արդյունքներ ստանալու համար։
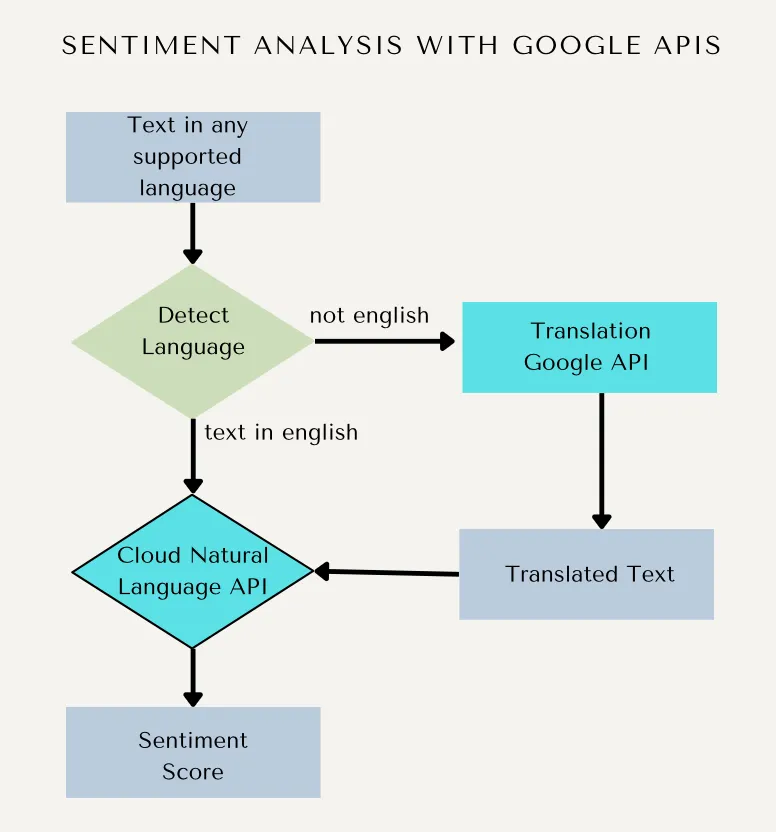
Նոր հնարավորությունները պահանջում էին տեքստը թարգմանել 11 լեզվով, որոշել սկզբնաղբյուր լեզուն, երբ այն հայտնի չէ, և շարունակել sentiment analysis-ը։
Արդյունքում գոյություն ունեցող API-ին հարցումների թիվը պետք է մի քանի անգամ բազմապատկվեր, և դա դեռ ամենը չէր։ Ամռանը նախատեսված հնարավորությունները ներառում էին փոփոխություններ, որոնց պատճառով շատ ավելի շատ (հարյուրավոր անգամ ավելի) տեքստեր պետք է նախապես թարգմանվեին։ Ընդհանուր առմամբ՝ API-ի օգտագործումը մոտ ապագայում պետք է հարյուրապատիկ աճեր։
Նախքան հաշվելը, թե գոյություն ունեցող կառուցվածքով սերվիսների համար ինչ կվճարենք կամ ինչ կարժենա LLM-ը, կարող էինք պարզ փորձ անցկացնել. մենք մոտավորապես գիտեինք, թե որքան հաճախ ենք կանչում Google Services-ը, քանի որ գիտեինք, թե քանի տեքստ է անցնում մեր Pub/Sub հաղորդագրությունների համակարգով։ Եթե նոր նախագիծը արագ տարածեինք, և այդ միկրոսերվիսը մշակեր մոտավորապես նույն քանակի հաղորդագրություններ, հին մոտեցման հետ համեմատելը հեշտ կլիներ։ Հենց այդ էլ արեցինք։ Մեկ օրվա ընթացքում մենք Python-ով ստեղծեցինք շատ պարզ, մեկ ֆայլանոց միկրոսերվիս՝ գրված ամբողջությամբ vibe coding-ով cursor-ով, տեղակայեցինք այն մեր Kubernetes կլաստերում և Google-ին ուղղված API կանչերը վերահղեցինք մեր միկրոսերվիսին։ Արդյունքները (առանց ճշգրիտ թվերի) կգտնեք ստորև՝ Ծախսերի համեմատություն բաժնում։
Ինչու նայեցինք LLM-ի վրա հիմնված լուծմանը
LLM-ի համար տեքստը թարգմանելը կամ որոշակի լեզվով հայհոյանքներ պարունակելու ստուգումը հեշտ աշխատանք է թվում։ Նույնիսկ ChatGPT-ի ամենավաղ տարբերակները ինձ տպավորեցին թարգմանության հետ իրենց վարվելակերպով։ Երկու խնդիրներն էլ իդեալական են LLM-երի համար։ Միակ անհայտը արժեքն էր։ Քանի որ գրեթե ամեն ամիս նոր մոդելներ են թողարկվում, ընտրելու շատ բան կա։ Ինչպես պարզվեց, Gemini-ի ամենաէժան մոդելներից մեկը մեր խնդիրը կատարյալ կերպով լուծեց։
Ծախսերի գնահատումը հաճախ դժվար է նույնիսկ ամենապարզ ամպային սերվիսների համար (անկախ մատակարարից), և LLM-ները բացառություն չեն։ Գինը կախված է հիմնականում token-ների ծավալից և մոդելի բարդությունից։ Իհարկե, կարելի է կոպիտ գնահատական անել, բայց իմ կարծիքով, եթե կարող եք կառուցել փոքր նախագիծ և մեկ-երկու շաբաթ աշխատեցնել production-ում՝ իրական ծախսերը տեսնելու համար, ապա դա է ճիշտ ճանապարհը (թեև, բնականաբար, դա միշտ հնարավոր կամ գործնական չէ)։
Այսպիսով, մենք գիտեինք, որ արժեքը վճռորոշ գործոն կլինի նախքան վերջնական լուծումը ընտրելը, բայց LLM-ի օգտին կային նաև այլ կարևոր պատճառներ։
LLM-ը տալիս է հսկայական առավելություն. կարող եք խնդրել և ստանալ ցանկացած պատասխան, որ ուզում եք։ Դա թույլ է տալիս ձեր API-ն դարձնել այնքան ճկուն, որքան ցանկանում եք. կարող եք միանգամից մի քանի բան խնդրել կամ, եթե նախընտրում եք առավելագույն պարզությունը, օգտագործել մեկ կանչ՝ օգտագործվող token-ները նվազեցնելու համար։ Նաև sentiment analysis-ի համար ոչինչ նախապես թարգմանելու կարիք չկա. բավական է փոխել prompt-ը, որպեսզի LLM-ը հայտնաբերի լեզուն, թարգմանի տեքստի հատվածը, գտնի հայհոյանքներ և այլն։
Ի վերջո, LLM-ի վրա հիմնված լուծումը պարզվեց շատ ավելի էժան։ Մեր թարգմանած տեքստերը սովորաբար կարճ են (1-2 պարբերություն, կամ երբեմն ընդամենը մեկ բառ), ուստի token-ների օգտագործումը նույնպես ցածր է մնում։ Մենք նաև փորձեցինք մի քանի հասանելի մոդել և պարզեցինք, որ ամենաէժաններից մեկը մեր խնդիրների համար ուշագրավ լավ է աշխատում։
Դրա վրա ավելանում է այն, որ լավ կառուցվածքով LLM prompt-ները թույլ են տալիս որոշ խնդիրներ կատարել մեկ հարցմամբ՝ մի քանիսի փոխարեն, ինչպես անհրաժեշտ էր առանձին Google API-ների դեպքում, ինչը նվազեցրեց production համակարգի ընդհանուր latency-ն։
Արժե ընդգծել, որ թեև մենք ընտրեցինք Gemini AI-ը, այսօրվա ցանկացած հայտնի LLM մոդել, ամենայն հավանականությամբ, կկատարեր աշխատանքը։ Ես նույնիսկ դիտարկեցի մեր ֆունկցիոնալության իրականացումը Ollama-ով, որը հոսթ կլիներ մեր սերվերներից մեկի վրա, բայց նույնիսկ ամենափոքր հասանելի մոդելները աշխատեցնելու համար բավական հզոր սերվեր 24/7 պահելը ավելի թանկ կնստեր, քան Gemini API-ի կանչերը, ուստի այդ գաղափարը թողեցինք (գոնե առայժմ)։
Մի խոսքով (TL;DR)
Ինչու՞ ընտրել LLM։
- Ծախսերի օպտիմալացում. Կարճ տեքստերը, որ մենք սովորաբար թարգմանում ենք, պարզվում է՝ շատ քիչ token են օգտագործում։
- Ճկունություն. Մեկ prompt-ը կարող է մեկ կանչով կատարել լեզվի հայտնաբերում, թարգմանություն և տրամադրության ստուգում։
- Ավելի արագ իտերացիա. Ելքային սխեմաները (JSON/enum/գնահատականներ) սահմանում ենք մենք, այլ ոչ թե դրանք թելադրում է երրորդ կողմի API-ն։
- LLM մատակարարի ընտրություն. Մենք ընտրեցինք Gemini-ը, բայց մյուս հիմնական LLM-ները նույնքան լավ կաշխատեին։
Ինչպես նախագծեցինք նոր միկրոսերվիսը
Ինչպես ասացի, այս միկրոսերվիսը ես կառուցել եմ երկու անգամ։ Առաջին տարբերակը արագ ու կոպիտ PoC էր՝ գրված Python-ով ամբողջությամբ AI-ի կողմից։ Gemini API-ի հետ շփումը բավականին պարզ է. պետք է միայն API բանալի։ Երկրորդ անգամ միկրոսերվիսը վերագրեցինք Scala-ով, որպեսզի այն հետևի մեր կոդի բազայի մյուս միկրոսերվիսների ոճին, և աշխատեցրինք մեր կլաստերում։ Python-ով սկսելը խելամիտ էր թվում vibe-coded լուծում արագ ստանալու համար, բայց հետադարձ հայացքով սերվիսն այնքան պարզ է, որ կարող էինք այդ քայլը լիովին բաց թողնել, այն ուղղակի Scala-ով գրել և մի քանի մարդ-ժամ խնայել. դե, ապրես ու սովորես։
Կա մեկ endpoint լեզուն հայտնաբերելու համար, երկուսը՝ թարգմանությունների համար (մի լեզվից մյուսը, և մի լեզվից մյուս բոլորը միանգամից), endpoint, որը ստուգում է գերադրական աստիճանների չարաշահումը, և ևս մեկը՝ հայհոյանքների համար։ /healthcheck-ը և /api/languages-ը օժանդակ endpoint-ներ են. առաջինը ծառայում է Kubernetes-ի healthcheck մեխանիզմին, իսկ երկրորդը պարզապես թվարկում է մեր աջակցած լեզուները։
Նոր լուծման հետաքրքիր կողմն այն է, որ այս API-ների ելքը կարողացանք ձևավորել ճիշտ այնպես, ինչպես ուզում էինք։ Փաստաթղթերում փորփրելու կարիք չկար՝ հասկանալու համար, թե ինչու է Google-ը մի տեքստի համար մի գնահատական վերադարձնում, իսկ մեկ այլ օրինակի համար՝ այլ։ LLM-ի հետ կարող ենք պարզապես ասել agent-ին, թե ինչ վերադարձնի. օրինակ՝ 0-ից 1 արժեք, կամ գուցե enum՝ «good»/«bad». սահմանափակում չկա։
Ցույց տալու համար, թե որքան պարզ է տեքստի թարգմանության հարցումը մշակելը, /api/translate API-ն ընդունում է հետևյալ json հարցումը.
{
  "text": String,
  "source_lang": Option[String],
  "target_lang": String
}
source_lang դաշտը ընտրովի է։ Երբ մեր միկրոսերվիսը ստանում է նման հարցում, մենք պարզապես ճշգրտում ենք Gemini AI-ին ուղարկվող prompt-ը.
val prompt: String = req.source_lang match {
         case Some(src) =>
           s"""Translate the following text from ${LanguageUtils.nameFor(src)} (${src.code}) to ${LanguageUtils
               .nameFor(req.target_lang)} (${req.target_lang.code}).

Text: "${req.text}"

Provide only the translated text without any additional explanations or formatting."""
         case None      =>
           s"""Detect the language of the following text and translate it to ${LanguageUtils.nameFor(
               req.target_lang
             )} (${req.target_lang.code}).

Text: "${req.text}"

First, detect the language and provide the language code, then provide the translation. Format your response as:
Detected language: [language_code]
Translation: [translated_text]"""
       }
Մենք հստակ ասում ենք՝ կա՛մ թարգմանել տեքստը և վերադարձնել միայն թարգմանությունը, երբ source_lang-ը նշված է, կա՛մ ինքնուրույն հայտնաբերել լեզուն և վերադարձնել հայտնաբերված լեզուն թարգմանված տեքստի հետ միասին։
Այս պարզ օրինակը լավ ցույց է տալիս, թե ինչ կարող են անել LLM-ները և որքան ճկուն են դրանք՝ համեմատած REST API-ներով տրամադրվող մի քանի տարբեր 3rd-party սերվիսների վրա հենվելու հետ։
Ահա մեկ այլ օրինակ, այս անգամ գերադրականների հայտնաբերման համար.
val prompt = s"""Analyze the following English text for excessive use of superlatives (words like "best", "worst", "most", "least", "greatest", "amazing", "incredible", "fantastic", "terrible", "horrible", etc.).

Text: "${req.text}"

You must respond with ONLY valid JSON in this exact format:
{
   "score": <number from 1-10 where 1=no superlatives, 10=excessive superlatives>,
   "analysis": "<brief explanation of the score>",
   "detected_superlatives": ["<list of detected superlative words/phrases>"]
}

Do not include any text before or after the JSON. Only the JSON object."""
Այս prompt-ը ենթադրում է, որ տեքստը անգլերեն է (ինչը հեշտացրեց այն տեղադրել այս ֆունկցիոնալության նախորդ տարբերակի փոխարեն, որպեսզի կարողանայինք այն տաք փոխարինել prod-ում քիչ փոփոխություններով), բայց այն ցույց է տալիս ընդհանուր գաղափարը։ Մենք Gemini-ին ասում ենք վերադարձնել միայն JSON, տալիս ենք օրինակելի կառուցվածք և բացատրում, թե ինչպես հաշվել գնահատականը։ Պարզ է։
Ի վերջո, լուծումը իրականացվեց որպես մեկ controller, որը բացահայտում է վերը նկարագրված endpoint-ները, գումարած ևս մեկը՝ Kubernetes pod-ների առողջության ստուգումների համար։ Այս ամենը փոքր է, սահուն և արագ՝ http4s-ի և այլ բաց կոդով գրադարանների շնորհիվ, որոնք նաև մշակում են Gemini AI-ի կանչերը։
Երբ տեքստը թարգմանվում է մյուս 11 լեզուներով, մենք արդյունքները պահում ենք ռելացիոն տվյալների բազայում doobie-ով, որպեսզի նույն տեքստը նորից ու նորից թարգմանելու կարիք չլինի (իհարկե, սկզբնական տեքստի փոփոխությունները հայտնաբերող պարզ մեխանիզմով)։
Տեղակայման և մասշտաբավորման մոտեցումը
Gemini-ի վրա հիմնված LLM սերվիսին անցնելու մեկ թերությունն այն է, որ այժմ մենք պետք է այն ինքներս աշխատեցնենք։ Մեզ համար դա խնդիր չէ, քանի որ մեր բոլոր միկրոսերվիսներն արդեն սահուն աշխատում են Kubernetes կլաստերում, և ևս մեկը չի վնասում։ Նվազագույն ռեսուրսներով մեկ pod իրականում բավարար կլիներ, բայց rolling update-ներ թույլ տալու համար մեզ անհրաժեշտ են նույն instance-ի առնվազն երկու pod, որոնք աշխատում են և մշակում հարցումներ։
Այն գործարկելու համար միակ լրացուցիչ աշխատանքը healthcheck endpoint-ն էր, որը Kubernetes կլաստերն ինքը կարող էր օգտագործել։
Քանի որ սերվիսը հոսթ ենք անում ինքներս, ստանում ենք GCP-native լիարժեք դիտարկելիություն. կարող ենք հեշտությամբ տեսնել, թե ինչ է ճշգրտորեն անում սերվիսը և որքան ռեսուրս է օգտագործում, դիտել լոգերը, կարգավորել ահազանգեր՝ ինչ-որ բան սխալ գնալու դեպքում, և արագ արձագանքել, ճիշտ ինչպես մեր տեղակայած յուրաքանչյուր այլ միկրոսերվիսի դեպքում։
Ծախսերի համեմատություն. առաջ և հետո
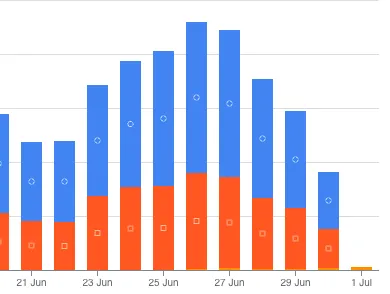
Հաճախորդի գաղտնիության պատճառով կարող ենք կիսվել միայն տոկոսներով, ոչ թե բացարձակ թվերով։ Ինչպես գուցե կռահել եք առաջին պատկերից, Google Services-ին հարցումներ անելու արժեքը նվազել է առնվազն 90%-ով։ Սա, բնականաբար, կոպիտ գնահատական է։ Մի կողմից, այն դուրս է թողնում մեր կլաստերում pod-ներն աշխատեցնելու լրացուցիչ ծախսը (որը փոքր է), մյուս կողմից, տարբերությունը շատ ավելի մեծ կլիներ, եթե համեմատեինք ներկայիս օգտագործումը, երբ 12 լեզվով թարգմանություններին առնչվող նոր հնարավորություններն արդեն գործում են, և մենք ամեն օր հարյուրավոր անգամ ավելի շատ հարցումներ ենք ուղարկում։
Կարմիրը և կապույտը ներկայացնում են Google-ի թարգմանության և sentiment սերվիսները, իսկ նարնջագույնը՝ այն, ինչ արժե Gemini AI-ն նույն աշխատանքի համար։ Ինչպես ցույց է տալիս գծապատկերը, հուլիսի առաջինին մենք հեռացրեցինք երկու նախորդ API-ներին կանչերը։
Իհարկե, սա ընդամենը արագ PoC էր, ցույց տալու (հիմնականում մեզ) եղանակ, որ LLM լուծումը գոնե նույնքան լավ է աշխատում, որքան Google-ի առաջարկած պատրաստի API-ները։
Մի խոսքով (TL;DR)
Երբ տրաֆիկը երկու կառավարվող API-ներից տեղափոխվեց LLM միկրոսերվիս, այս աշխատանքային բեռի ամսական հաշիվը նվազեց >90%-ով։
Առաջին արդյունքները և դրանց ազդեցությունը
Երբ մեր PoC-ի առաջին Python տարբերակը պատրաստ էր, պարզեցինք, որ թարգմանությունները շատ ճշգրիտ են (գոնե այն լեզուներով, որ մենք խոսում ենք)։ Մնացածները պահանջում էին որոշ ստուգում 3rd-party թարգմանչական գործակալությունների կողմից, բայց ընդհանուր առմամբ թարգմանության մասը լավ ստացվեց։
Sentiment analysis-ը նույնիսկ ավելի մեծ հաջողություն էր՝ գերազանցելով մեր սպասելիքները։ Հիմնական պատճառն այն էր, որ Google API-ի դեպքում մենք պետք է խորությամբ վերլուծեինք մեր տվյալների համար վերադարձվող գնահատականները և պարզեինք ճշգրիտ շեմը, որը մեզ համար «բավական լավ» էր։ LLM լուծման դեպքում, ընդհակառակը, կարող էինք հեշտությամբ գրել բազմաթիվ թեստեր իրական օրինակներով և ճշգրտել LLM prompt-ը, մինչև այն իրեն պահեր ինչպես ուզում էինք։ Ավելին, կարող էինք մշակել գնահատման սեփական ելքը, որը շատ ավելի հեշտ էր օգտագործել մեր բիզնես տրամաբանության մեջ։
Շատ լեզուներով թարգմանությունը կարող է որոշ ժամանակ տևել, ուստի որոշեցինք այն դարձնել լիովին ասինխրոն՝ օգտագործելով արդեն առկա հաղորդագրությունների լուծումը։ Ուստի թարգմանության հարցումները չեն անցնում REST API endpoint-ով. փոխարենը դրանք փաթաթվում են Pub/Sub հաղորդագրության մեջ, և երբ Gemini AI-ը պատրաստում է թարգմանությունները, ստեղծվում է նոր հաղորդագրություն և ուղարկվում մեր կլաստերի շահագրգիռ կողմերին։
Ընդհանուր առմամբ, շահույթները մեծ էին՝ համեմատած աշխատանքի փոքր ծավալի հետ։ Մենք նաև ցույց տվեցինք բիզնեսին, որ AI-ի ինտեգրումը դժվար չէ, այնպես որ նրանք կարող են սկսել մտածել նոր կիրառությունների մասին՝ իրենց պլատֆորմում ավելի ու ավելի շատ AI օգտագործելու համար։
Եթե սկսենք LLM-ներն ավելի շատ օգտագործել և աշխատեցնել ներքին միջավայրում, մեկ այլ օգուտ կլինի այն, որ տվյալները մնում են մեզ մոտ և պարտադիր չէ գնան որևէ 3rd-party սերվիսի, եթե ինքներս չուզենք. սա կարևոր չէ այս դեպքի համար, բայց կարող է կարևոր լինել մյուսների համար։
Մի խոսքով (TL;DR)
- Թարգմանության որակ. Բարձր է աջակցվող բոլոր լեզուներով (անհրաժեշտության դեպքում մարդկանց կողմից ընտրովի ստուգված)։
- Sentiment և քաղաքականություն. Ավելի հեշտ է կարգավորել, այլևս չկա հենվելու կարիք մատակարարի ֆիքսված գնահատման վրա
- Latency. Ավելի քիչ ցանցային անցումներ՝ քայլերը մեկ կանչերի մեջ համատեղելու շնորհիվ։
- Թողունակություն. Pub/Sub-ի միջոցով ասինխրոն թարգմանությունը պահում է UX-ը արձագանքող։
Ինչ սովորեցինք
Երբ առաջացավ թարգմանությունները LLM-ներին վստահելու գաղափարը, շուտով տեսանք, որ դա հեշտ իրագործելի նպատակ է, և նաև «բիզնեսին» ցույց տալու եղանակ, թե LLM-ներն ինչ կարող են անել մեզ համար և որքան արագ ու հեշտ է դրանց ինտեգրումը։
Թեև ողջ իրականացումը տևեց ընդամենը մի քանի օր, ճանապարհին վերցրինք շատ «քաղած դասեր»։
Նախ՝ PoC-ը vibe-coding-ով գրելը հիանալի է, բայց զգույշ եղեք, որ ամեն ինչ չբարդացնեք։ PoC-ը գոյություն ունի ապացուցելու համար, որ ինչ-որ բան հնարավոր է և աշխատում է։ Սկզբում մենք ավելորդ կերպով փորձեցինք այն հնարավորինս արագ անել Python-ով, մինչդեռ ամբողջ լուծումն այնքան պարզ էր, որ կարող էինք անմիջապես Scala-ով գրել՝ առանց վերագրումների։ PoC-ը vibe-coding-ով գրելը, իհարկե, հիանալի գաղափար էր, բայց ի վերջո, միևնույն է, պետք է հետևել գեներացվածին և կոդը ճշգրտել այն ստանդարտներին, որոնց ուզում եք, որ ձեր կոդի բազան հետևի։
LLM-երի prompt-ները միշտ չէ, որ առաջին փորձից սպասվածի պես են աշխատում։ Դրանք ճշգրտում են պահանջում, ինչը կարող է մի քանի իտերացիա տևել։
LLM-երի դեպքում, մեր հին API-ների հարցումների քանակին հետևելու փոխարեն, այժմ պետք է հետևենք token-ների օգտագործմանը, ինչը նոր կողմեր է բերում, որոնք մշակողները պետք է սովորեն (համատեքստ, մշակվող տվյալների չափը և ինչ պետք է վերադարձվի)։
Մի խոսքով (TL;DR)
Ինչը լավ աշխատեց.
- Ավելի պարզ ճարտարապետություն → ավելի հեշտ սպասարկում։
- Prompt-ները կարելի է ճկուն թարմացնել՝ առանց կոդին դիպչելու։
Դժվարություններ.
- Prompt-ների ճշգրտումը մի քանի իտերացիա պահանջեց։
- Token-ների օգտագործումը անսպասելիորեն թռավ, երբ կարծիքները ներառում էին HTML կամ տարօրինակ ձևավորում։
Խորհուրդ.
- Միշտ պարտադրեք JSON schema LLM-ի ելքի վրա։
- Հետևեք յուրաքանչյուր հարցման արժեքին token-ներով։
- Concurrency-ն պահեք ցածր, մինչև վստահեք կայունությանը։
Ապագայի պլանները
Երբ PoC-ը գրվեց, տեղական թեստավորվեց և production թողարկվեց որպես լրացուցիչ սերվիս՝ հասանելի այլ միկրոսերվիսների հետ կոնկրետ տվյալների հոսքերի համար, ակնհայտ դարձավ, որ LLM-ի վրա հիմնված սերվիսի աշխատեցումը շատ ավելի քիչ կարժենա։ Սա բացեց մեր թիմի շատերի աչքերը, քանի որ այժմ կարող ենք նոր գաղափարներին մոտենալ «բիզնեսի» հետ միասին լրիվ այլ կերպ։ Շատերը ոգևորվեցին, և նոր գաղափարներ անշուշտ կհետևեն։
Գոյություն ունեցող թարգմանության և sentiment analysis-ի ծախսերի կրճատումը ընդամենը փոքր մաս էր այն ընդհանուր հաջողության և ազդեցության, որ այս փոքր PoC-ն ունեցավ մեր թիմի և այն ընկերության վրա, որի համար աշխատում ենք։
Եզրակացություն
PoC-ը մի քանի օրում vibe-coding-ով գրելը կարող է մեծ աշխատանք կամ պարծենալու բան չհնչել, բայց դրա ընդհանուր ազդեցությունը պարզվեց ավելի մեծ, քան սպասում էինք։ Մենք լիովին վերացրինք երկու թանկ Google API-ների հետ փոխազդեցությունը և օգտագործումը։ Նույնիսկ նրանց ուղարկած հարցումների բավականին համեստ քանակի դեպքում մենք կրճատեցինք ծախսերը 90%-ով և ստացանք հավասար կամ ավելի լավ որակ և շատ ավելի ճկուն լուծում։
Եթե դուք մշակող եք, CTO կամ մենեջեր, կխնդրեի մի պահ կանգ առնել և մտածել, թե LLM-ներն ինչպես կարող են օգնել արդեն կատարվող աշխատանքին։ Գուցե պարզվի, որ կարող եք այն տասն անգամ էժանացնել, ձեր ծրագրային լուծումը հասցնել բոլորովին նոր մակարդակի և մի փոքր փոխել ձեր թիմի մտածելակերպը, որպեսզի AI-ի շարժմանը միանաք և առավելագույնս օգտվեք դրանից՝ նախքան ձեր մրցակիցները։
Եթե այդպես է, և եթե սրանցից որևէ բան ծանոթ է հնչում, մենք պատրաստ ենք օգնել։